이 글에서 다룰 주제
- 탐색 단위: 키를 찾는 것과 페이지 범위를 건너뛰는 것은 어떻게 다른가?
- 분할 단위: 파티셔닝은 인덱스와 어떻게 함께 쓰이는가?
- 검증: 데이터 순서와 실행 계획에서 무엇을 확인할 것인가?
주요 단어 · B-tree · BRIN · Correlation · Operator Class · Partition Pruning · Sharding
큰 테이블을 빠르게 읽으려면 먼저 어디에서 읽을 대상을 줄일지 정해야 한다. B-tree는 키를 따라가고, BRIN은 물리적 페이지 범위를 요약하며, 파티션 Pruning은 조건과 무관한 파티션을 제외한다. 세 가지는 서로 대체하는 제품 목록이 아니라 다른 크기의 탐색 단위를 다루는 도구다.
BRIN은 인접한 블록 범위를 요약하는 인덱스이고, Partition Pruning은 조회 조건과 무관한 파티션을 실행 대상에서 제외하는 최적화다.
자료와 예제 기준 — PostgreSQL 18을 중심으로 개인 학습 노트를 재구성했다. SQL·실행 계획·설정값은 설명 및 재현용 예제이며 이 글을 위해 운영 DB에서 새로 측정한 결과는 아니다. DDL/DML 예제는 독립적인 테스트 환경에서 사용한다.
1. B-tree와 BRIN이 읽는 단위
서로 다른 문제를 해결한다
| 기술 | 핵심 질문 | 해결 범위 | 남는 문제 |
|---|---|---|---|
| 파티셔닝 | 어느 데이터 구역인가? | 테이블 관리·Pruning | 단일 서버 자원 한계 |
| 샤딩 | 어느 DB 노드인가? | 데이터·부하 수평 확장 | 분산 운영·조인·트랜잭션 |
| B-tree | 어떤 키의 행인가? | 정렬된 키 탐색 | 인덱스 크기·변경 비용 |
| BRIN | 어디를 안 읽어도 되는가? | 페이지 구간 제외 | 후보 행 재검사·배치 의존 |
세 가지 분할·검색 기술은 배타적이지 않다. 파티션 안에 B-tree와 BRIN을 모두 둘 수도 있지만 각 인덱스가 해결할 쿼리와 쓰기 비용을 따져야 한다.
B-tree의 내부 직관
루트와 내부 노드는 탐색할 하위 범위를 안내한다. 리프에는 키와 heap 행 위치 정보가 있으며 범위 검색은 리프를 이어서 탐색할 수 있다. 실제 PostgreSQL 구현은 중복 키 처리 등 최적화가 있으므로 모든 행이 반드시 독립적인 같은 크기의 리프 항목 하나를 갖는다는 뜻은 아니다.
인덱스 키의 정렬과 heap 물리적 순서는 별개다. Index Only Scan이 가능한 경우에도 필요한 컬럼과 visibility map 등의 조건이 관련되며, B-tree 사용 자체가 heap 접근 0회를 보장하지 않는다.
| 조회 | 설계 후보 |
|---|---|
| request_id 하나 조회 | request_id B-tree |
| 고객별 최신 20건 | (customer_id, created_at DESC) B-tree |
| 범위·정렬·제한 건수 | 쿼리 정렬과 맞는 B-tree |
| 유일성 | UNIQUE B-tree |
BRIN의 내부 직관
BRIN은 인접한 heap 페이지 구간마다 요약을 저장한다. 대표적인 minmax는 최솟값과 최댓값이다. 조건에 맞을 가능성이 없는 구간을 제외하고, 남은 페이지의 실제 행을 재검사한다.
| 구간 | 시간 요약 | 9월 20일 조건 |
|---|---|---|
| A | 9월 1~5일 | 제외 |
| B | 9월 6~10일 | 제외 |
| C | 9월 11~15일 | 제외 |
| D | 9월 16~21일 | 후보, 실제 행 재확인 |
요약만 보면 D에 20일이 반드시 있다는 보장은 없다. BRIN은 행 위치 목록을 주는 방식이 아니므로 Bitmap Heap Scan과 재검사가 자연스럽다. lossy는 후보가 넓다는 뜻이며 최종 결과가 틀린다는 뜻이 아니다.
물리적 상관관계
시간순 append 데이터라면 각 구간의 시간 폭이 좁아 minmax가 효과적일 수 있다. 반면 모든 구간에 1월부터 12월까지 섞이면 9월 조회에서 대부분을 읽게 된다. 과거 데이터 backfill과 UPDATE도 분포를 바꿀 수 있다.
ANALYZE api_request_history_202609;
SELECT attname, correlation
FROM pg_stats
WHERE schemaname = 'public'
  AND tablename = 'api_request_history_202609'
  AND attname = 'created_at'
  AND inherited = false;
correlation은 -1~1의 통계이며 절댓값이 크면 순서의 연관이 강하다. 이것은 BRIN 합격 점수가 아니다. 구간 내 군집과 operator class에 따라 결과가 달라지므로 실제 읽기량을 측정한다. bloom에는 minmax와 동일한 물리적 정렬 전제를 적용하지 않는다.
B-tree와 BRIN 비교
| 항목 | B-tree | BRIN |
|---|---|---|
| 요약 단위 | 키와 행 위치 중심 | 여러 페이지 구간 |
| 단건 조회 | 일반적으로 우선 검토 | 후보 페이지 재검사 부담 가능 |
| 큰 시간 범위 | 선택도·배치에 따라 판단 | 배치가 맞으면 유리한 후보 |
| 정렬 결과 | 인덱스 순서 활용 가능 | 정렬 순서 제공 용도 아님 |
| 공간 | 데이터·키 수 영향 큼 | 보통 작지만 설정·클래스에 좌우 |
| 쓰기 | 인덱스 항목 유지 비용 | 요약 갱신·요약 생성 비용 |
BRIN이 작다고 모든 범위 쿼리가 B-tree보다 빠르지는 않다. 결과가 테이블 대부분이면 Seq Scan이 더 효율적일 수도 있다.
2. BRIN의 요약 방식과 설정
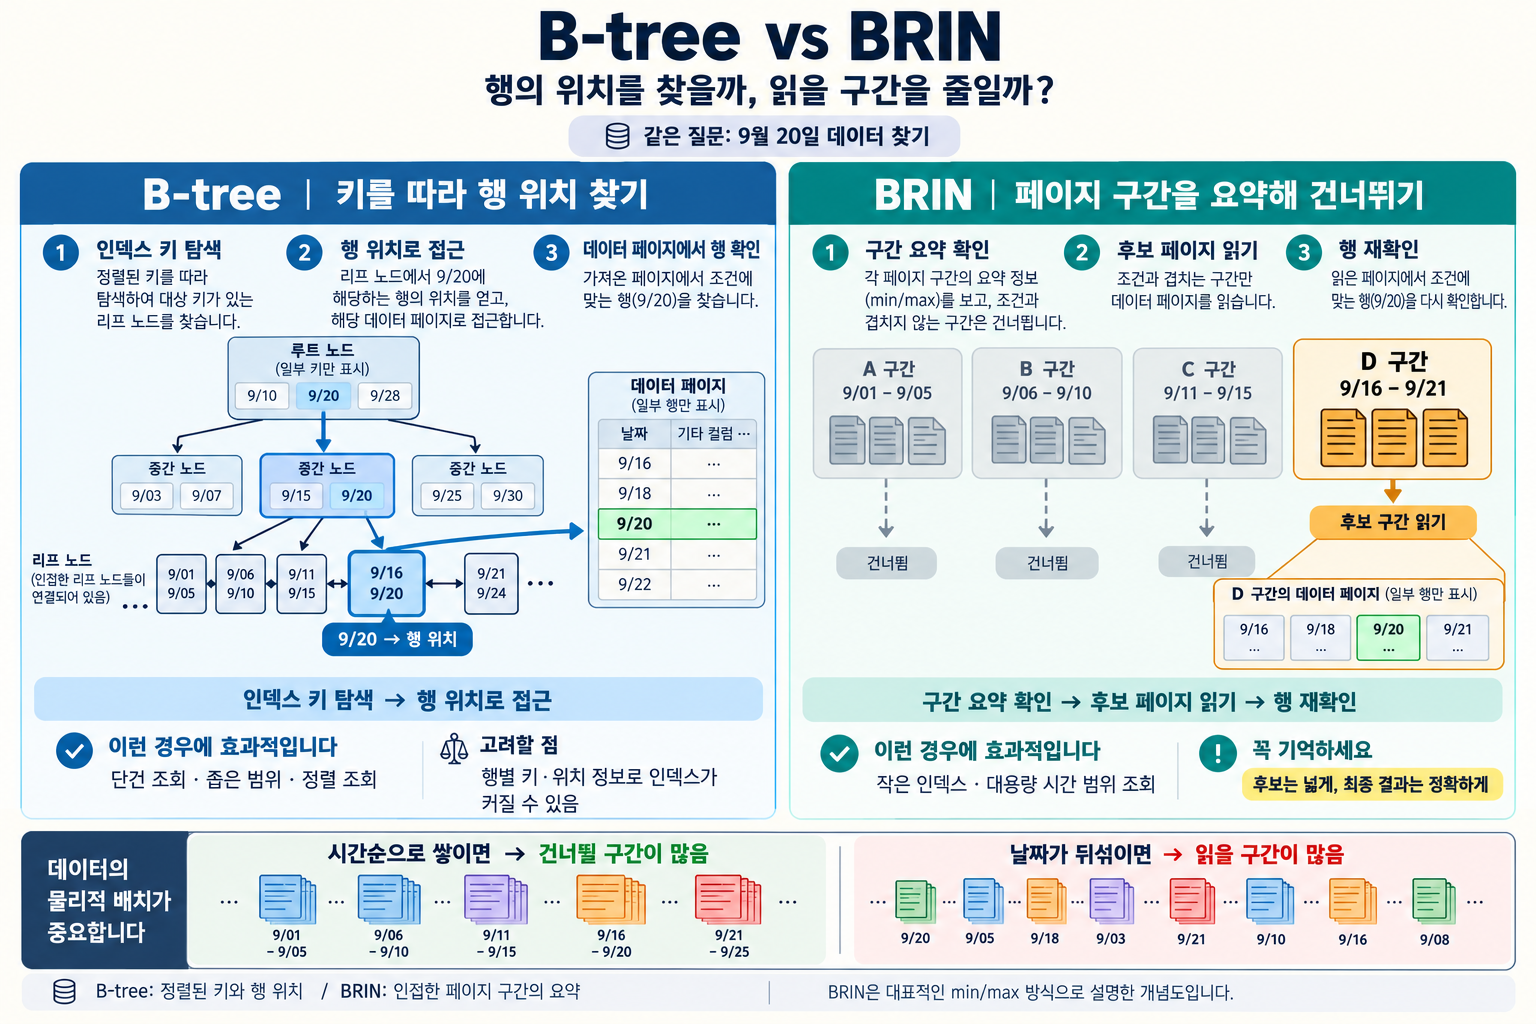
학습 자료의 개념도 — B-tree와 BRIN의 탐색 단위. 세부 조건은 본문 설명을 함께 읽는다.
오퍼레이터 클래스란?
인덱스가 특정 자료형을 어떤 방식으로 표현하고 어떤 연산을 처리할지 정의한다. BRIN에서는 ‘구간을 어떻게 요약하는가’와 ‘어떤 비교로 후보를 제외하는가’를 함께 결정한다. BRIN에는 inclusion 계열도 있지만 여기서는 학습한 minmax·minmax-multi·bloom 세 종류에 집중한다.
같은 데이터로 비교
한 물리적 페이지 구간에 10, 11, 12, 90, 91, 92가 있고 value = 50을 찾는다고 가정한다.
| 클래스 | 개념 요약 | 50 조회 |
|---|---|---|
| minmax | [10, 92] | 범위 안이므로 읽고 재확인 |
| minmax-multi | 예: [10,12], [90,92] | 이 요약이라면 제외 가능 |
| bloom | 값들을 해시한 비트 배열 | 확실히 없음이면 제외, 가능성이 있으면 재확인 |
minmax-multi 표는 가능한 개념 예시다. 구현이 항상 두 구간으로 만들거나 모든 빈 공간을 정확히 보존한다는 뜻은 아니다. bloom 비트도 예시 값만으로 임의 확정하지 않는다.
minmax
한 구간의 최솟값과 최댓값으로 요약한다. 단순하고 작은 표현이지만, 값들이 멀리 떨어져 있으면 중간의 비어 있는 영역까지 후보가 된다. 값의 물리적 정렬이 잘 유지되는 시간·순번 데이터가 전형적인 후보다.
10~12에 1,000이라는 값 하나가 추가되면 큰 범위가 10~1,000으로 늘어날 수 있다. 범위 안의 값이 실제로 존재하는지는 heap을 읽어야 한다. 동등 및 순서 비교 연산에 활용된다.
minmax-multi
여러 작은 구간 또는 개별 값으로 분포를 표현해 이상값의 영향을 줄이는 방식이다. 물리적 페이지를 여러 개로 분할하거나 데이터를 정렬하는 기능이 아니다.
요약 공간은 제한된다. 값이 복잡하게 분산되면 구간이 병합되어 후보가 넓어질 수 있다. 따라서 ‘minmax의 항상 더 빠른 상위 호환’으로 생각하지 말고 요약 크기와 읽기 감소의 균형을 측정한다.
values_per_range는 저장할 값 표현의 예산이다. 하나의 값은 점이나 구간 경계가 될 수 있다. 32로 설정했다고 32개 구간이 생기는 것은 아니다. PostgreSQL 18 기준 기본 32, 범위 8~256이다.
bloom
페이지 구간의 값들을 해시해 Bloom filter로 요약한다. 검색값에 필요한 비트 중 하나라도 0이면 해당 값은 없다고 판정한다. 모두 1이면 실제로 있을 수도, 다른 값의 해시가 비트를 채운 오탐일 수도 있으므로 실제 행을 확인한다.
| 판정 | 의미 | 다음 작업 |
|---|---|---|
| 확실히 없음 | 요약된 구간에 검색값 없음 | 구간 제외 |
| 있을 수 있음 | 존재 또는 오탐 | 페이지 읽고 검사 |
정상적으로 유지되는 필터에서 false positive는 가능하지만 false negative는 없다. 요약되지 않은 BRIN 구간은 안전하게 후보로 처리되어 정답 누락이 아니라 추가 읽기 문제가 된다.
bloom 클래스는 = 검색용이며 <, >, BETWEEN을 직접 지원하는 범위 인덱스가 아니다. 물리적 순서가 약한 데이터에도 후보가 될 수 있지만 모든 구간에 검색값이 실제 존재하거나 구간별 고유값이 많으면 읽기 감소가 제한된다. 랜덤 UUID라고 무조건 B-tree보다 좋지는 않다.
또한 USING brin (... uuid_bloom_ops)와 별도 bloom 확장의 USING bloom은 서로 다른 인덱스 방식이다.
파라미터를 구분하자
| 파라미터 | 위치 | 의미 | 조정 효과 |
|---|---|---|---|
| pages_per_range | BRIN 인덱스 | 한 요약이 담당하는 heap 페이지 수 | 작으면 세밀하지만 항목 증가 |
| autosummarize | BRIN 인덱스 | 새 구간 요약 요청 자동화 | 즉시·동기 완료 보장 아님 |
| values_per_range | minmax-multi 클래스 | 값·경계를 저장할 예산 | 크면 표현력과 크기 증가 가능 |
| n_distinct_per_range | bloom 클래스 | 구간별 예상 고유값 수 | 필터 크기 산정에 사용 |
| false_positive_rate | bloom 클래스 | 목표 오탐률 | 낮게 잡으면 더 큰 필터 필요 |
PostgreSQL 18의 bloom 목표 오탐률 기본값은 0.01, 허용 범위는 0.0001~0.25다. 이것은 인덱스 설계 입력값이며 실제 업무 쿼리의 관측 오탐률을 보증하지 않는다. 구간별 distinct 추정이 틀리면 예상과 다를 수 있다.
생성 예시
아래 인덱스는 같은 컬럼에서 비교할 대안이다. 운영에서 전부 생성하라는 뜻은 아니다. v는 bigint라고 가정한다.
-- 기본 minmax
CREATE INDEX idx_events_minmax
ON events USING brin (v int8_minmax_ops)
WITH (pages_per_range = 128, autosummarize = on);

-- 여러 값·경계 요약
CREATE INDEX idx_events_multi
ON events USING brin (
    v int8_minmax_multi_ops (values_per_range = 64)
) WITH (pages_per_range = 128, autosummarize = on);

-- 존재 가능성 요약: 숫자는 설명용이며 실제 distinct로 조정
CREATE INDEX idx_events_bloom
ON events USING brin (
    v int8_bloom_ops (
        n_distinct_per_range = 1000,
        false_positive_rate = 0.01
    )
) WITH (pages_per_range = 128, autosummarize = on);
bigint에는 int8_*, integer에는 int4_*처럼 자료형에 맞는 이름을 사용한다. 설치된 서버에서 확인할 수 있다.
SELECT opc.opcname,
       opc.opcintype::regtype AS input_type,
       opc.opcdefault
FROM pg_opclass opc
JOIN pg_am am ON am.oid = opc.opcmethod
WHERE am.amname = 'brin'
ORDER BY input_type::text, opc.opcname;
유지보수
새 구간의 초기 요약은 VACUUM·autovacuum 또는 요약 함수로 수행된다. autosummarize를 켜도 요청 큐와 worker 일정 때문에 지연될 수 있다.
SELECT brin_summarize_new_values('idx_events_minmax'::regclass);이 함수는 미요약 구간을 처리한다. 이미 지나치게 넓어진 모든 요약을 자동 축소하는 명령은 아니다. 변경·삭제 후 요약의 품질이 나쁘다면 대상 구간의 desummarize 후 재요약이나 재구성을 별도 검토한다. 재요약해도 실제 물리적 데이터 분포가 나쁘면 근본 문제가 해결되지 않는다.
선택 기준
- 시간순 데이터가 깔끔하게 누적됨: minmax부터 검토.
- 대부분 질서가 있으나 이상값·군집이 섞임: minmax-multi 비교.
- 동등 검색이며 물리적 정렬이 약함: bloom과 B-tree 비교.
- 최신 N건·정렬·단건 지연이 중요함: B-tree를 먼저 검토.
출처: BRIN 본문과 operator class parameters. 파라미터 기본값과 허용 범위는 PostgreSQL 18 기준.
3. 파티셔닝으로 조회·관리 단위 나누기
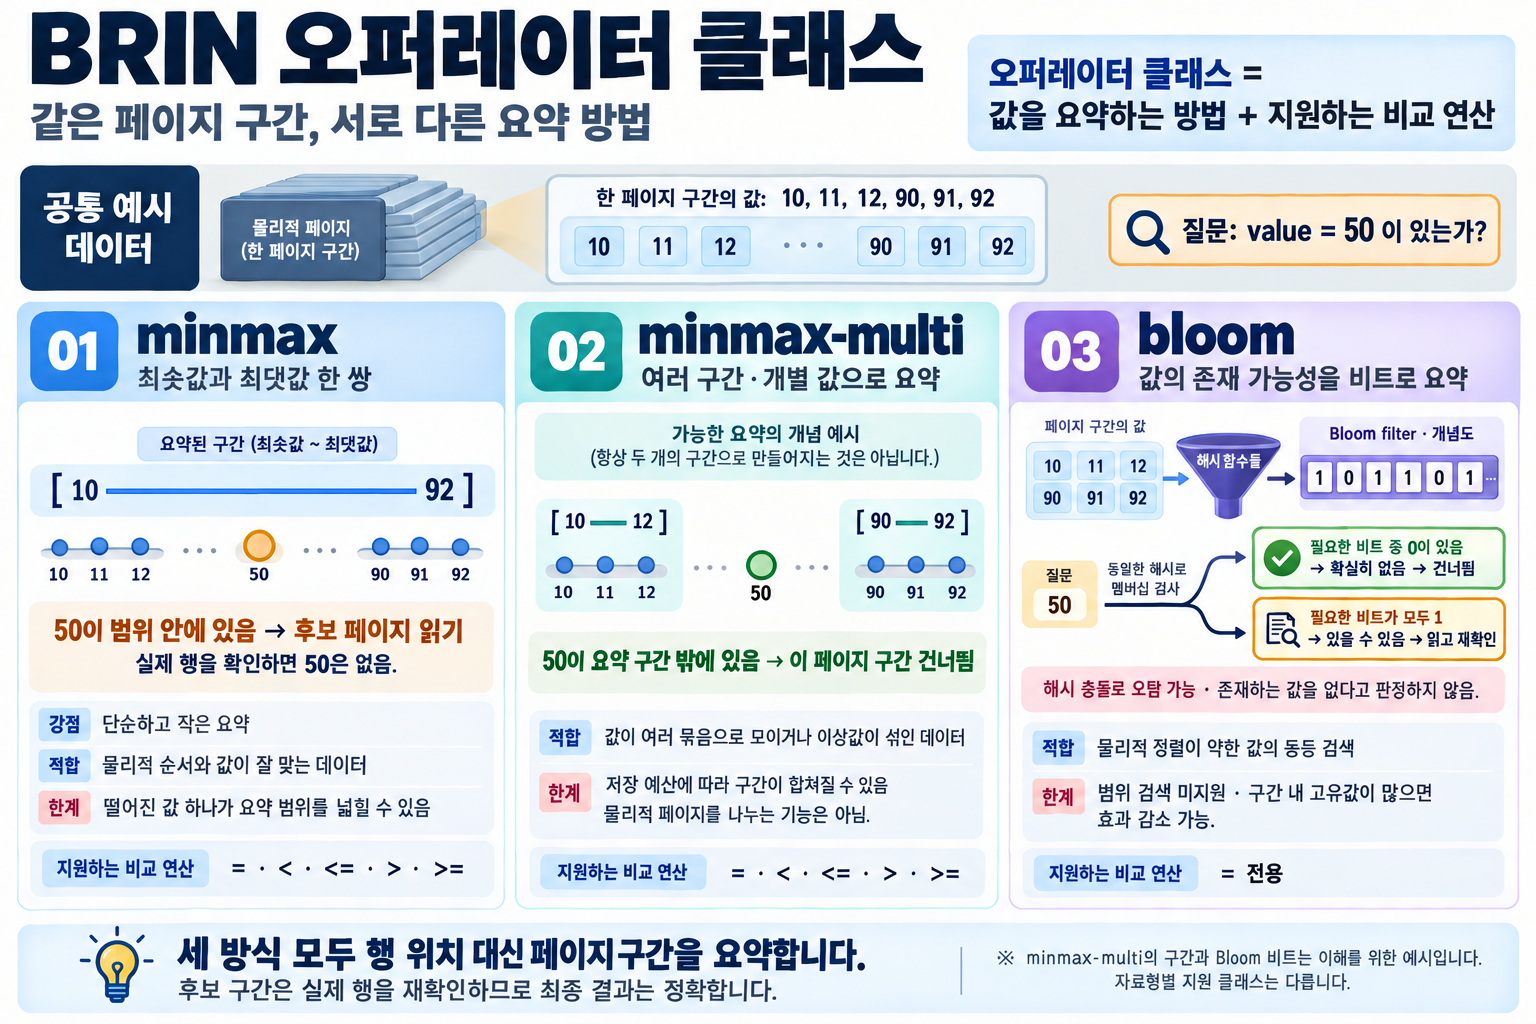
학습 자료의 개념도 — BRIN 요약 방식 비교. 세부 조건은 본문 설명을 함께 읽는다.
정의와 필요성
파티셔닝은 논리적으로 하나의 테이블을 여러 물리적 구역으로 나누는 기능이다. 애플리케이션은 부모 테이블을 조회하고, 실제 행은 리프 파티션에 저장된다. 부모는 자체 행 저장 공간을 갖지 않는다.
핵심 목적은 조회 대상 축소와 데이터 관리 단위 분리다. 예를 들어 하루 1,000만 건이면 365일에 36억 5,000만 건이다. 최근 며칠을 조회하고 오래된 월별 데이터를 지우는 요구가 있다면, 월별 구역을 나누는 것이 관리에 도움이 될 수 있다. 이 수치는 규모를 설명하기 위한 예이며 도입 기준은 아니다.
대량 DELETE는 행을 하나씩 처리하고 MVCC상 정리 가능한 이전 버전이 남는다. WAL과 복제 부하, VACUUM 부담도 고려해야 한다. 일반 VACUUM은 주로 내부 공간 재사용을 가능하게 하며 파일 전체를 자동으로 압축하는 작업과 다르다.
분할 방식
| 방식 | 기준 | 적용 후보 | 주의 |
|---|---|---|---|
| RANGE | 시간·숫자 범위 | 이벤트·이력·정산 | 하한 포함, 상한 제외 |
| LIST | 명시적 값 목록 | 국가·업무 분류 | 그룹 증가·쏠림 관리 |
| HASH | 키 해시값의 나머지 | 고객 키 중심 접근 | 단일 DB 내부 HASH는 샤딩과 다름 |
RANGE의 9월 구간은 [9월 1일, 10월 1일)이다. 10월 1일 0시는 10월에 속한다. HASH는 원래 ID를 단순히 나눈 값이 아니라 PostgreSQL의 키 해시를 사용한다. 하나의 대형 고객은 같은 키로 묶이므로 쏠림이 남을 수 있다.
생성과 저장 위치 확인
다음 예제는 UTC 월 경계다. 업무 기준이 한국 시간이면 모든 경계와 쿼리의 시간대 정의를 일관되게 바꾼다.
CREATE TABLE api_request_history (
    request_id bigint NOT NULL,
    created_at timestamptz NOT NULL,
    service_id bigint NOT NULL,
    status_code integer NOT NULL,
    latency_ms integer,
    PRIMARY KEY (created_at, request_id)
) PARTITION BY RANGE (created_at);

CREATE TABLE api_request_history_202609
PARTITION OF api_request_history
FOR VALUES FROM ('2026-09-01 00:00:00+00')
           TO   ('2026-10-01 00:00:00+00');

CREATE TABLE api_request_history_202610
PARTITION OF api_request_history
FOR VALUES FROM ('2026-10-01 00:00:00+00')
           TO   ('2026-11-01 00:00:00+00');

CREATE INDEX idx_history_service_time
ON api_request_history (service_id, created_at);

INSERT INTO api_request_history VALUES
(1001, '2026-09-27 03:00:00+00', 10, 200, 125);

SELECT tableoid::regclass AS physical_table, request_id, created_at
FROM api_request_history;
저장 위치는 9월 파티션이다. 부모 인덱스 선언에 대응하는 실제 인덱스도 파티션에 생성된다. 범위에 맞는 파티션이 없고 DEFAULT도 없다면 INSERT는 실패한다. 미래 파티션 생성은 별도 자동화 작업이다.
Pruning과 인덱스의 관계
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM api_request_history
WHERE service_id = 10
  AND created_at >= TIMESTAMPTZ '2026-09-20 00:00:00+00'
  AND created_at <  TIMESTAMPTZ '2026-09-21 00:00:00+00';
Pruning은 결과가 존재할 수 없는 파티션을 제거한다. 이후 남은 파티션에서 Index Scan, Bitmap Scan, Seq Scan 등을 비용에 따라 선택한다. Pruning 자체는 인덱스를 요구하지 않는다.
| 관찰 대상 | 의미 |
|---|---|
| 실행 계획의 파티션 이름 | 어떤 구역이 조회되었는가 |
| Subplans Removed | 실행 초기 Pruning의 단서 |
| loops, never executed | 실행 중 Pruning 등을 해석할 단서 |
| Planning Time | 분할 수에 따른 계획 비용도 점검 |
| Buffers | 접근 페이지 수 관찰 |
파라미터가 실행 시 알려져도 Pruning이 가능한 경우가 있다. 단, never executed 하나만으로 Pruning을 확정하지 말고 전체 계획을 본다.
시간 키로 분할했는데 WHERE request_id = 1001만 제공하면 어느 달인지 알 수 없어 여러 파티션을 탐색할 수 있다. 또한 date_trunc('month', created_at)처럼 키를 함수로 감싼 조건보다 원래 키에 직접 반개방 범위를 주는 것이 명확하다.
PRIMARY KEY와 전역 유일성
부모 테이블의 UNIQUE/PRIMARY KEY에는 파티션 키의 모든 컬럼이 포함되어야 한다. 이 제약을 사용하는 경우 파티션 키의 표현식·함수 사용에도 제한이 있다.
PRIMARY KEY (created_at, request_id)는 두 값의 조합을 보장한다. 다음 두 행은 서로 다른 키다.
| created_at | request_id |
|---|---|
| 2026-09-27 | 1001 |
| 2026-10-03 | 1001 |
따라서 request_id 단독의 전역 유일성을 보장한 것이 아니다. 시퀀스나 UUID 발급 정책과 DB 제약은 구분한다. 외래 키로 ID 하나만 참조할 필요가 크다면 다음 구성을 검토한다.
| 테이블 | 책임 |
|---|---|
| requests | 요청 ID의 유일성, 현재 상태, 참조 기준 |
| request_events | 시간별 상세 이력과 보관 기간 |
일별·월별 선택
| 요구 | 판단 예시 |
|---|---|
| 최근 15일 보관 | 일별 파티션이 만료 처리에 잘 맞음 |
| 월 단위 정산·보관 | 월별 후보 |
| 하루 데이터가 매우 큼 | 더 작은 관리 단위 검토 |
| 작은 데이터 장기 보관 | 과도한 세분화 지양 |
월별 파티션에서 월 중간의 만료일을 정확히 지키려면 경계 파티션에서 DELETE가 필요할 수 있다. 또는 보관 정책이 허용하는 경우 더 오래 보관한다. 일별도 정확한 초 단위 rolling retention과 완전히 같지는 않다.
제거·분리·연결
아래는 운영 절차 설명이며 보관 정책상 만료된 파티션에만 적용한다.
-- 부모 조회에서 분리하되 독립 테이블로 보존
ALTER TABLE api_request_history
DETACH PARTITION api_request_history_202609;

-- 백업 및 삭제 결정이 완료된 뒤에만 별도로 실행
-- DROP TABLE api_request_history_202609;
직접 DROP이나 일반 DETACH에는 부모 잠금 영향을 고려한다. DETACH CONCURRENTLY는 잠금 수준을 낮추지만 트랜잭션 블록에서 사용할 수 없고 DEFAULT 파티션이 있으면 사용할 수 없는 등 제약이 있다.
대량 적재는 독립 테이블에 적재·검증 후 ATTACH하는 방법도 있다. 경계에 맞는 유효한 CHECK 제약이 있으면 ATTACH 검증 스캔을 피하는 데 도움이 된다. CHECK가 없거나 DEFAULT 검증이 필요하면 스캔·잠금 비용이 커질 수 있다.
운영 함정
- DEFAULT는 범위 밖 입력을 받을 수 있지만, 미래 파티션 생성 실패를 숨길 수 있다. 행 수와 유입을 감시한다.
- DEFAULT에 이미 들어간 행은 새 파티션을 만들었다고 자동 이동하지 않는다.
- 파티션 키 UPDATE로 경계를 넘으면 행 이동이 발생할 수 있다. 안정적인 키가 운영에 유리하다.
- 파티션별 UPDATE·DELETE에는 여전히 VACUUM이 필요하다. 오래된 파티션도 freezing 등 유지보수에서 완전히 제외하지 않는다.
- 부모 통계는 autovacuum의 자동 ANALYZE 대상이 아니므로 데이터 분포 변화에 따라
ANALYZE api_request_history;를 운영한다. - 부모에 CREATE INDEX CONCURRENTLY를 직접 적용할 수 없다. 리프에서 concurrently 생성 후 부모 인덱스에 연결하는 절차를 검토한다.
- 일반 테이블을 설정 한 줄로 파티션 부모로 바꾸지는 못한다. 새 구조, 백필, 변경분 동기화, 전환·롤백 계획이 필요하다.
4. 샤딩을 검토하는 경계
샤딩을 검토할 때
쿼리·인덱스 최적화 이후에도 단일 노드 CPU, I/O, 저장 용량, 쓰기 처리량이 요구를 감당하지 못하는지 먼저 측정한다. 샤딩은 데이터를 여러 서버에 나누어 추가 자원을 사용할 수 있게 하지만 네트워크와 분산 실행 비용을 도입한다.
고객 ID로 분산한다면 주문과 주문 항목도 같은 고객 기준으로 함께 배치하는 co-location이 유리할 수 있다. 고객 단위 쿼리는 적은 노드에서 끝나지만 전 고객 집계나 다른 분산 키의 조인은 여러 노드 작업이 된다.
Citus는 PostgreSQL 확장 기반 구현 사례다. 코디네이터가 워커에 쿼리를 전달하고 결과를 모은다. 지원 SQL·제약은 구현과 버전에 따라 다르다. 샤딩은 복제·고가용성과 별개이며 각 샤드의 백업과 장애 복구도 필요하다.
조합 구조
샤딩은 노드, 파티셔닝은 데이터 관리 단위, 인덱스는 내부 읽기 방식을 다룬다. 이 흐름은 개념 구조이며 특정 분산 제품의 모든 조합 지원을 보장하지 않는다.
실무 선택표
| 상황 | 우선 검토 |
|---|---|
| 단건·최신 N건 조회 지연 | B-tree와 쿼리 조건·정렬 |
| 시간순 대용량 기간 조회 | BRIN과 B-tree 실측 비교 |
| 만료 데이터 DELETE 부담 | 시간 파티셔닝 |
| 기간 검색 + 보관 정책 | 파티셔닝과 인덱스 조합 |
| 읽기만 증가 | 인덱스·캐시·읽기 복제본도 비교 |
| 단일 노드 쓰기·용량 한계 | 샤딩 및 분산 키 설계 |
번역 실행 이력·Agent 실행 이력에는 시간 파티셔닝을, 현재 작업 상태와 사용자 설정에는 일반 테이블·B-tree를 먼저 검토하는 설계가 가능하다. 데이터 규모와 실제 쿼리를 확인하기 전의 출발점이지 확정 처방은 아니다.
출처: Index Types, BRIN, pg_stats, Citus 개념, 분산 키.
5. 같은 조건에서 비교하는 실습
실습 원칙
아래 SQL은 격리된 테스트 DB용이며 이 문서 작성 과정에서 실행하지 않았다. 운영 DB에 그대로 적용하지 않는다. 읽기·쓰기 부하와 저장 공간을 감당할 수 있는 작은 데이터부터 시작한다. 성능 숫자를 미리 단정하지 않고 실행 계획으로 가설을 확인하는 것이 목표다.
같은 테이블에 후보 인덱스를 한 번에 여러 개 만들면 planner가 그중 하나를 선택해 비교가 어려워진다. 이 실습은 하나씩 생성·관찰·제거한다. 실습 대상의 이름은 전용 schema 아래로 제한한다.
순서가 있는 데이터 만들기
CREATE SCHEMA brin_study;

CREATE TABLE brin_study.events (
    id bigint NOT NULL,
    created_at timestamptz NOT NULL,
    v bigint NOT NULL,
    payload text NOT NULL
);

INSERT INTO brin_study.events
SELECT g,
       TIMESTAMPTZ '2026-09-01 00:00:00+00'
         + g * INTERVAL '1 second',
       g,
       repeat('x', 100)
FROM generate_series(1, 500000) AS s(g)
ORDER BY g;

ANALYZE brin_study.events;
약 50만 행의 순서 있는 입력이다. 실제 저장 크기는 환경에 따라 다르다. 먼저 인덱스 없이 아래 쿼리의 baseline을 기록한다.
EXPLAIN (ANALYZE, BUFFERS)
SELECT sum(length(payload))
FROM brin_study.events
WHERE v >= 200000 AND v < 205000;
payload를 읽어 heap 접근을 포함시키려는 예다. 별도로 count만 조회하면 B-tree의 Index Only Scan 가능성 등 비교 조건이 달라질 수 있다.
B-tree와 BRIN을 하나씩 비교
CREATE INDEX events_v_btree ON brin_study.events (v);

EXPLAIN (ANALYZE, BUFFERS)
SELECT sum(length(payload)) FROM brin_study.events
WHERE v >= 200000 AND v < 205000;

SELECT pg_size_pretty(pg_relation_size('brin_study.events_v_btree'));

DROP INDEX brin_study.events_v_btree;

CREATE INDEX events_v_brin
ON brin_study.events USING brin (v int8_minmax_ops)
WITH (pages_per_range = 32, autosummarize = on);

EXPLAIN (ANALYZE, BUFFERS)
SELECT sum(length(payload)) FROM brin_study.events
WHERE v >= 200000 AND v < 205000;

SELECT pg_size_pretty(pg_relation_size('brin_study.events_v_brin'));
구간 폭을 1건·5천 건·10만 건으로 바꾸며 관찰한다. 32페이지가 최적이라는 뜻은 아니다. 128 등 다른 값은 인덱스를 재생성해 같은 쿼리로 비교한다. 클래스 비교는 기존 events_v_brin을 제거한 뒤 앞의 BRIN 요약 방식 절에 나온 구문에서 테이블·인덱스 이름을 바꾸어 한 개씩 생성한다.
순서가 약한 입력과 비교
CREATE TABLE brin_study.events_mixed
(LIKE brin_study.events INCLUDING ALL);

INSERT INTO brin_study.events_mixed
SELECT * FROM brin_study.events ORDER BY random();

ANALYZE brin_study.events_mixed;
LIKE INCLUDING ALL은 기존 인덱스도 복사할 수 있다. 비교 전 인덱스 목록을 확인하고 동일 조건을 맞춘다. random 정렬 자체에 비용이 있으며 이 코드는 교육용 데이터 배치다. 운영 데이터에 이런 재배치를 수행하는 것이 아니다.
minmax는 분포가 섞이면 페이지 제외가 줄어들 가능성이 크다. bloom은 순서가 약해도 없는 값의 equality에서 구간을 제외할 수 있으나 목표값이 존재하는 여러 구간을 피할 수는 없다. ‘없을 수도 있는 값’과 ‘많이 반복되는 값’을 나눠 비교해야 한다.
실행 계획 체크포인트
| 항목 | 질문 |
|---|---|
| Index Scan / Bitmap Heap Scan / Seq Scan | 어떤 접근법을 선택했나? |
| Index Cond | 인덱스 단계에서 사용된 조건은? |
| Recheck Cond | heap에서 다시 검증하는 조건은? |
| Rows Removed by Index Recheck | 후보지만 실제로 제외된 행은? |
| Heap Blocks exact/lossy | bitmap이 얼마나 상세한가? |
| Buffers shared hit/read | 버퍼 적중과 읽기 접근량은? |
| 추정 rows와 actual rows | 통계 추정이 현실과 맞나? |
| Planning / Execution Time | 계획 비용과 실행 비용은? |
Bitmap Heap Scan의 lossy는 BRIN에서 자연스럽지만, 다른 인덱스의 bitmap도 메모리 상황에 따라 lossy해질 수 있다. 따라서 lossy만 보고 BRIN이라고 단정하지 않는다. shared read 역시 OS 캐시를 통과한 물리 디스크 읽기 횟수와 완전히 같지는 않다.
한 번의 실행 시간으로 결론 내리지 않는다. 첫 실행과 반복 실행의 캐시 조건, 반환 행 수, 병렬성, 디스크 상태가 다를 수 있다. 인덱스 사용을 강제로 유도한 결과와 기본 planner 선택은 구분한다.
운영 도입 기록 양식
| 항목 | 기록 |
|---|---|
| 테이블·인덱스 크기 | |
| 일일 증가량·쓰기 패턴 | |
| 대표 쿼리 3개와 선택도 | |
| 보관·삭제 주기 | |
| 파티션 키 또는 분산 키 | |
| 후보 인덱스와 설정 | |
| 접근 페이지·실행 시간 | |
| 삽입·UPDATE 부하 변화 | |
| 잠금·배포·롤백 계획 |
오해와 교정
| 오해 | 교정 |
|---|---|
| 큰 테이블은 무조건 샤딩 | 병목이 삭제라면 파티셔닝, 읽기라면 인덱스가 먼저일 수 있음 |
| 월별 파티션이면 ID 조회도 한 곳만 읽음 | 날짜 조건이 없으면 여러 파티션 탐색 가능 |
| BRIN은 조회가 부정확함 | 후보 재확인 후 정확한 결과 반환 |
| minmax-multi는 페이지를 나눔 | 같은 구간의 요약 표현을 풍부하게 함 |
| values_per_range는 페이지 수 | 값·경계 표현 예산이며 pages_per_range와 다름 |
| bloom은 BETWEEN을 지원 | 해당 BRIN bloom 클래스는 equality용 |
| bloom 오탐이 결과에 포함 | heap 재검사에서 걸러짐 |
| B-tree는 데이터를 정렬 저장 | 인덱스 키 순서와 heap 순서는 별개 |
| 샤딩하면 HA까지 해결 | 샤드별 복제·복구 필요 |
자료 기준과 참고 문서
개인 PostgreSQL 학습 노트를 바탕으로 정리했다. 첨부 그림은 제공된 학습 자료를 사용했으며, 버전이나 설정에 따른 조건은 본문에 덧붙였다.