이 글에서 다룰 주제
- 역색인: 요소 하나로 행 위치를 어떻게 찾는가?
- 실행 계획: exact·lossy와 재검사는 무엇을 뜻하는가?
- JSONB: 전체 문서·일부 필드·스칼라 값 중 무엇을 인덱싱할 것인가?
주요 단어 · GIN · GiST · Posting List/Tree · Pending List · Bitmap Scan · Recheck · JSONB
JSONB 컬럼에 GIN을 만들었다고 모든 JSON 쿼리가 빨라지는 것은 아니다. 인덱스가 어떤 값을 추출하고 어떤 연산을 지원하는지, SQL 표현식이 그 구조와 맞는지를 함께 봐야 한다. 읽기 경로를 이해한 다음에는 같은 인덱스가 UPDATE에 더하는 비용까지 살펴본다.
GIN은 요소에서 그 요소를 포함한 행 위치로 연결하는 역색인이다. Operator Class는 자료형과 연산자에 맞춰 인덱스가 무엇을 저장하고 어떤 비교를 지원하는지 정한다.
자료와 예제 기준 — PostgreSQL 18을 중심으로 개인 학습 노트를 재구성했다. SQL·실행 계획·설정값은 설명 및 재현용 예제이며 이 글을 위해 운영 DB에서 새로 측정한 결과는 아니다. DDL/DML 예제는 독립적인 테스트 환경에서 사용한다.
1. GIN의 내부 구조와 실행 계획
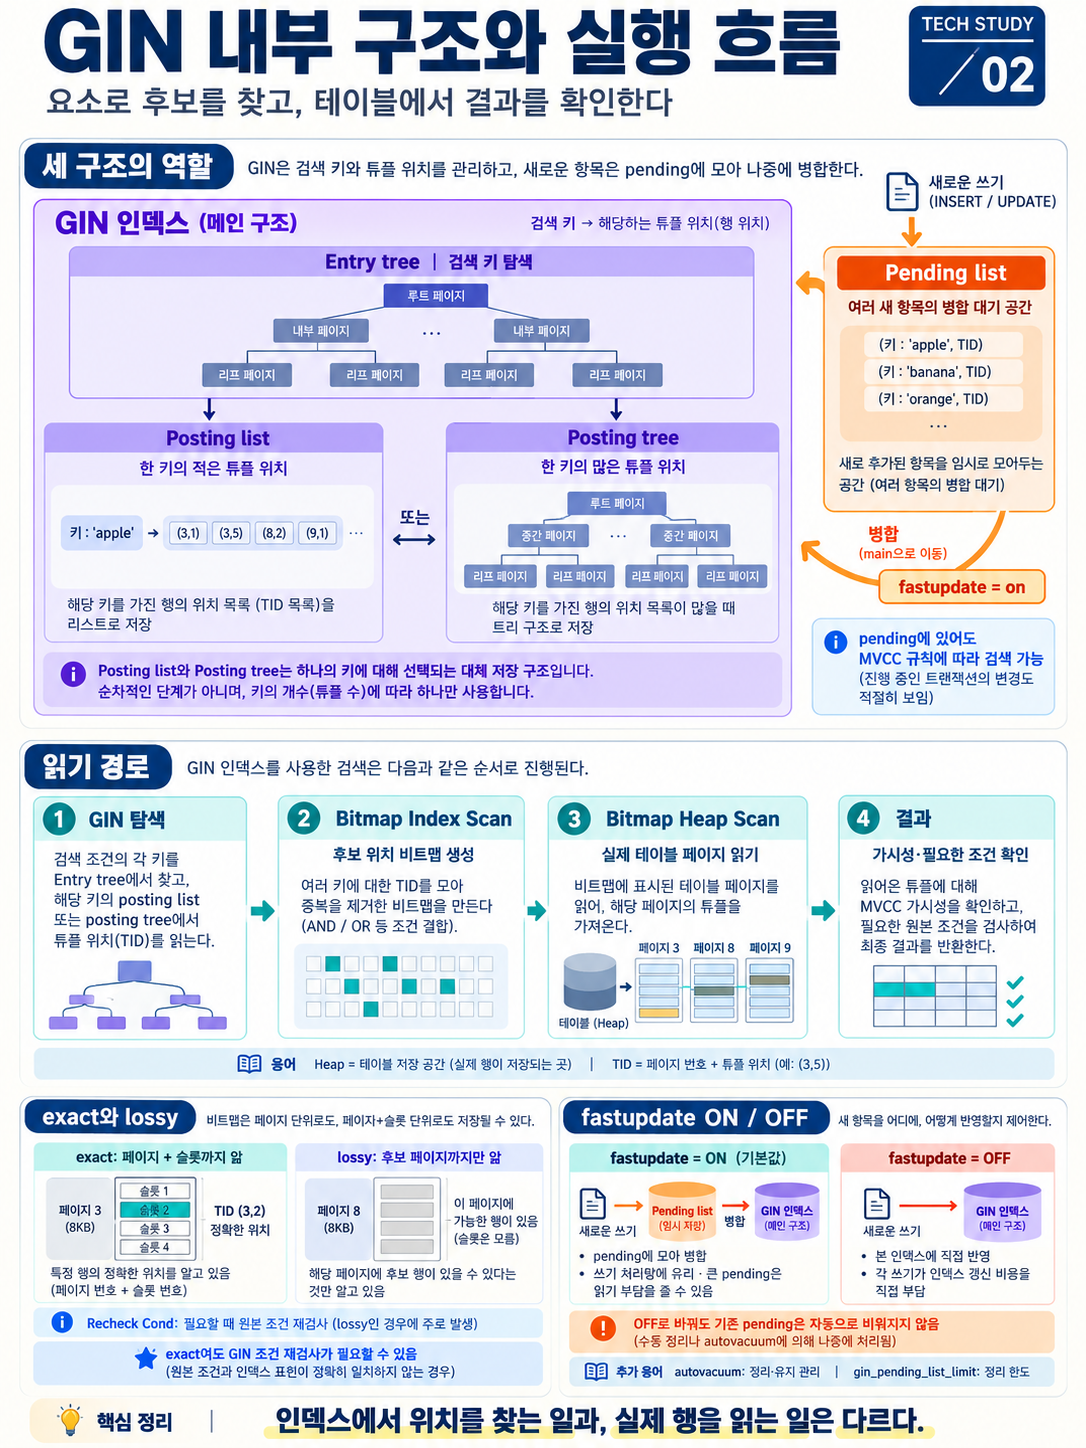
학습 자료의 개념도 — GIN 구조와 실행 흐름. 세부 조건은 본문 설명을 함께 읽는다.
역색인 원리
| 문서 | tags |
|---|---|
| D1 | postgres, monitoring |
| D2 | kubernetes, infra |
| D3 | postgres, backup |
| 검색 키 | 포함 문서 |
|---|---|
| postgres | D1, D3 |
| monitoring | D1 |
| backup | D3 |
문서 ID는 설명용 표기다. 실제 GIN은 테이블 튜플의 물리적 위치인 TID를 사용한다. TID는 페이지 번호와 페이지 안의 튜플 위치로 이해하면 된다.
CREATE INDEX posts_tags_gin ON posts USING gin (tags);
-- text[] 컬럼을 가정
SELECT * FROM posts WHERE tags @> ARRAY['postgres', 'monitoring'];
SELECT * FROM posts WHERE tags && ARRAY['postgres', 'backup'];@>는 오른쪽 요소를 모두 포함, &&는 공통 요소가 하나 이상 존재한다는 뜻이다. 여러 키의 목록 조합은 GIN 내부에서 처리될 수 있으므로 키가 여러 개라고 반드시 실행계획에 BitmapAnd가 나타나는 것은 아니다.
Posting list·Posting tree·Pending list
| 구조 | 내용 | 역할 |
|---|---|---|
| Entry tree | 추출한 키 | 키를 찾는 B-tree 구조 |
| Posting list | 한 키에 딸린 비교적 작은 TID 목록 | 키와 함께 목록 저장 |
| Posting tree | 한 키에 딸린 큰 TID 목록 | 별도 트리로 여러 페이지에서 관리 |
| Pending list | 본 인덱스에 합치지 않은 새 항목 | fastupdate의 쓰기 모으기 |
Posting list와 posting tree는 순차 단계가 아니다. 한 키에 딸린 TID 목록의 크기에 따라 사용하는 저장 방식이다. 전체 인덱스의 서로 다른 키 개수만으로 결정되는 것이 아니다.
Pending은 미커밋이라는 뜻이 아니다. 검색은 pending도 확인하고, 실제 가시성은 MVCC가 결정한다. 다른 트랜잭션의 미커밋 변경을 읽는다는 의미가 아니다. 같은 트랜잭션의 자기 변경은 일반적인 PostgreSQL 가시성 규칙에 따른다.
Bitmap Index Scan과 Bitmap Heap Scan
| 실행 단계 | 읽는 대상 | 결과 |
|---|---|---|
| Bitmap Index Scan | 인덱스 | 후보 튜플 위치를 나타내는 임시 비트맵 |
| Bitmap Heap Scan | 테이블 페이지 | 가시성과 필요한 조건을 확인한 실제 행 |
비트맵은 저장된 posting list와 다른, 이번 쿼리의 실행 중 자료구조다. 페이지별 접근으로 후보를 읽으며, 인덱스의 값 정렬 순서를 유지하지 않으므로 ORDER BY에는 별도 정렬이 필요할 수 있다. 읽을 페이지가 shared buffers에 있으면 디스크 읽기가 필요하지 않을 수 있다.
exact·lossy·Recheck Cond
| 개념 | 뜻 |
|---|---|
| exact 페이지 | 후보의 페이지와 슬롯 위치를 기억 |
| lossy 페이지 | 후보가 있는 페이지까지만 기억 |
| Recheck Cond | 필요할 때 원본 값에 다시 적용할 인덱스 조건 |
| Filter | 인덱스 조건 외에 실행 단계에서 적용하는 추가 조건 |
비트맵 메모리 예산이 부족하면 일부 페이지의 슬롯 정보 대신 페이지 단위 정보만 남길 수 있다. 이 경우 페이지 안의 가시적인 튜플을 확인하며 조건을 재검사한다.
별개로 GIN 오퍼레이터 클래스 자체가 원본 재검사를 요구할 수 있다. 따라서 exact=위치가 정확함이지 조건이 확정됨이 아니다. Heap Blocks: lossy=0이어도 조건 재검사가 생길 수 있다.
Bitmap Heap Scan on posts
  Recheck Cond: (tags @> '{postgres}'::text[])
  Heap Blocks: exact=2
  -> Bitmap Index Scan on posts_tags_gin
       Index Cond: (tags @> '{postgres}'::text[])
위 계획은 설명용이다. Recheck Cond가 출력됐다는 사실만으로 모든 튜플을 재검사했다고 해석하지 않는다. Rows Removed by Index Recheck는 재검사 총량이 아니라 재검사에서 탈락한 행 수다. MVCC 가시성 확인은 조건 재검사와 다른 작업이다.
fastupdate의 트레이드오프
| 항목 | on: 기본값 | off |
|---|---|---|
| 새 항목 처리 | pending에 모았다가 병합 | 본 인덱스로 직접 반영 |
| 평소 쓰기 | 묶음 처리로 유리할 수 있음 | 쓰기마다 갱신 비용 부담 |
| 읽기 | pending도 확인 | 기존 pending이 비워졌다면 그 부담 제거 |
| 지연 변동 | 한도 초과를 일으킨 쓰기가 정리 비용 부담 가능 | pending 정리로 인한 변동 제거 |
| 운영 고려 | autovacuum·pending 크기 | 직접 갱신의 처리량·경합 |
OFF도 I/O·페이지 분할·경합 지연을 제거하지는 않는다. ON은 최신 결과를 포기하는 옵션이 아니다.
병합 계기는 VACUUM, autoanalyze, gin_clean_pending_list, gin_pending_list_limit 초과 등이다. 한도를 높이면 정리 빈도를 줄일 수 있지만 검색 부담과 한 번의 정리량이 커질 수 있다.
ALTER INDEX posts_tags_gin SET (fastupdate = off);
-- OFF는 기존 pending을 비우지 않는다. 필요할 때 별도로 정리한다.
SELECT gin_clean_pending_list('posts_tags_gin'::regclass);
ALTER INDEX posts_tags_gin SET (fastupdate = on);
쓰기량이 많으면 ON으로 시작하고, 검색 p99가 pending 크기와 함께 악화되는지 확인한다. 읽기 응답시간이 중요한 환경은 정리 운영을 개선한 뒤 OFF와 비교한다. 짧은 INSERT 테스트만으로 결론을 내리지 말고 병합 주기를 포함한다.
-- 확장 설치·함수 실행에는 적절한 권한 필요
CREATE EXTENSION IF NOT EXISTS pgstattuple;
SELECT * FROM pgstatginindex('posts_tags_gin'::regclass);
관찰 대상: pending_pages, pending_tuples, 검색·쓰기 p50/p95/p99, CPU, I/O, WAL, autovacuum 실행 시점.
2. JSONB의 인덱스 대안
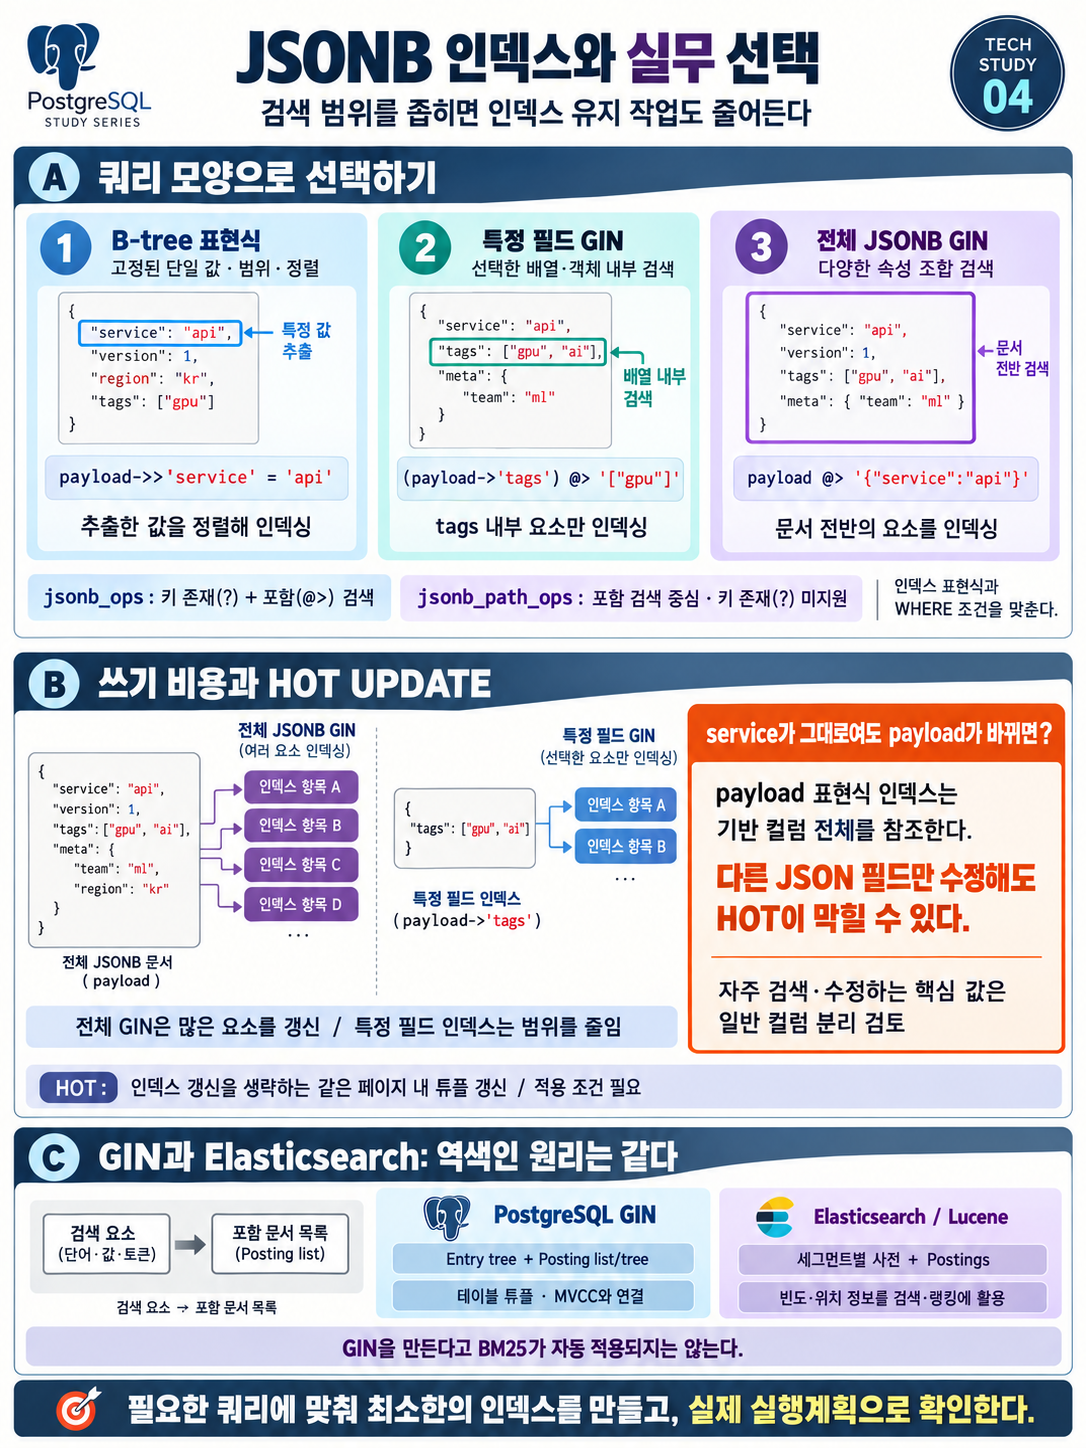
학습 자료의 개념도 — JSONB 인덱스 선택. 세부 조건은 본문 설명을 함께 읽는다.
예제 데이터
{
  "service": "translation-api",
  "severity": "error",
  "latency_ms": 1200,
  "tags": ["gpu", "timeout"],
  "metadata": {"region": "kr"}
}
세 가지 선택
| 검색 | 인덱스 | 이유 |
|---|---|---|
| service가 특정 값 | B-tree 표현식 | 추출된 문자열 동등 검색 |
| latency_ms 범위·정렬 | 숫자로 캐스팅한 B-tree 표현식 | 숫자 순서에 따른 검색 |
| tags의 특정 요소 포함 | tags에 대한 표현식 GIN | 필요한 배열 내부만 인덱싱 |
| 다양한 JSON 속성 조합 | 전체 JSONB GIN | 문서 전반의 포함 조건 |
-- 각각 독립적인 설계 예시다.
CREATE INDEX events_service_expr ON events ((payload ->> 'service'));
SELECT * FROM events WHERE payload ->> 'service' = 'translation-api';

CREATE INDEX events_latency_expr ON events (((payload ->> 'latency_ms')::integer));
SELECT * FROM events
WHERE (payload ->> 'latency_ms')::integer > 1000
ORDER BY (payload ->> 'latency_ms')::integer DESC LIMIT 20;

CREATE INDEX events_tags_gin ON events USING gin ((payload -> 'tags'));
SELECT * FROM events WHERE (payload -> 'tags') @> '["timeout"]'::jsonb;

CREATE INDEX events_payload_gin ON events USING gin (payload);
SELECT * FROM events
WHERE payload @> '{"service":"translation-api","severity":"error"}'::jsonb;->는 JSONB 값을, ->>는 text를 반환한다. 숫자 범위 검색에 text 순서를 사용하면 의도와 달라질 수 있다. 숫자 캐스팅 인덱스는 변환 불가능한 값이 들어오면 생성·쓰기 오류가 생길 수 있으므로 데이터 규칙을 관리한다.
다음 두 식의 검색 의도가 비슷해도 인덱스 매칭을 자동으로 같다고 생각하지 않는다.
WHERE payload @> '{"tags":["timeout"]}'::jsonb
WHERE (payload -> 'tags') @> '["timeout"]'::jsonb
전자는 전체 payload GIN, 후자는 (payload -> 'tags') GIN의 대표 대상이다.
jsonb_ops vs jsonb_path_ops
| 항목 | jsonb_ops | jsonb_path_ops |
|---|---|---|
| 기본값 | 예 | 아니오 |
| 키 존재 ?, ?|, ?& | 지원 | 미지원 |
| 포함 @> | 지원 | 지원 |
| JSONPath @?, @@ | 지원 | 지원 |
| 추출 특성 | 키·값을 각각 인덱싱 | 경로와 값을 결합한 해시 중심 |
| 크기·검색 | 유연성에 유리 | 일반적으로 작은 크기·포함 검색에 유리 |
CREATE INDEX events_payload_path_gin
ON events USING gin (payload jsonb_path_ops);
모든 JSONPath 조건이 동일하게 가속되지는 않는다. jsonb_path_ops는 값이 없는 구조, 예를 들어 빈 객체를 찾는 조건에 불리할 수 있다. ?는 JSONB의 최상위 키 또는 배열 요소 존재를 검사하며 임의 깊이의 키를 재귀 검색하는 연산자가 아니다.
쓰기 비용
전체 GIN은 문서 전반의 키를 추출한다. 특정 필드 GIN은 선택한 하위 값만, B-tree 표현식은 추출한 값을 유지한다. 필요한 데이터가 일부라면 인덱싱 범위를 줄여 유지 작업을 줄일 수 있다.
| 비용 | 전체 GIN | 필드 GIN | 단일 값 B-tree |
|---|---|---|---|
| 인덱싱 요소 | 문서 전반 | 선택한 배열·객체 | 하나의 값 |
| 새 튜플 반영 | 다수 키에 TID 추가 | 하위 값의 키에 TID 추가 | 키·튜플 위치 항목 추가 |
| pending 관리 | fastupdate ON이면 해당 | fastupdate ON이면 해당 | 해당 없음 |
| 주의 | 큰 문서·다수 요소 | 큰 배열 하나도 무거울 수 있음 | 여러 인덱스를 만들면 비용 누적 |
키 수가 100배라고 쓰기 시간이 100배라는 뜻은 아니다. 중복 키, 페이지 배치, WAL, 캐시, fastupdate 등에 따라 달라진다. 인덱스 종류와 무관한 heap·TOAST·행 버전 비용도 있다.
다른 JSON 필드만 바꾸어도 HOT이 막힐 수 있다
CREATE INDEX events_service_expr ON events ((payload ->> 'service'));

UPDATE events
SET payload = jsonb_set(payload, '{metadata,region}', '"us"'::jsonb)
WHERE id = 100;
service 값은 그대로지만 인덱스 표현식이 참조하는 기반 컬럼 payload는 실제로 변경되었다. PostgreSQL은 이 표현식 인덱스의 의존성을 JSON 경로별이 아니라 컬럼 기준으로 관리한다. 따라서 해당 변경은 HOT의 제약을 받는다.
HOT은 일반적으로 인덱스 참조 컬럼이 변경되지 않고, 같은 페이지에 공간이 있어야 한다. 요약 인덱스에 대한 예외 등이 있으므로 모든 인덱스에 동일한 규칙이라고 일반화하지 않는다. 여기서는 B-tree 표현식 및 GIN을 다룬다.
핵심 값을 일반 컬럼으로 분리하면 인덱스 의존성을 더 작게 나눌 수 있다. 하지만 분리한 인덱스 컬럼 자체를 수정하면 여전히 HOT 제약이 있다. 컬럼 분리는 모든 UPDATE를 HOT으로 바꾸는 마법이 아니다.
번역·이벤트 테이블 설계에 적용
- service, created_at처럼 자주 필터링·정렬하는 값은 일반 컬럼 검토.
- 자주 변하는 progress·status를 큰 JSONB에 섞어 수정할 필요가 있는지 검토.
- 태그 검색이 필요하면 tags 컬럼 또는 해당 JSON 경로의 GIN 검토.
- 드물게 탐색하는 확장 속성은 인덱스 없이 시작할 수 있음.
- 전체 GIN은 문서 전반의 탐색 요구가 실제로 있을 때 선택.
3. GiST: 자료형별 탐색 규칙을 담는 틀
GiST(Generalized Search Tree)는 공간·범위·유사도처럼 자료형별 성질을 활용하는 인덱스 구조를 구현하는 틀이다. 지원 연산과 거리순 탐색 여부는 operator class에 따라 달라진다.
예를 들어 pg_trgm의 GiST는 trigram 집합을 signature로 요약할 수 있다. 요약 단계에 후보가 섞여 들어와도 재검사로 최종 조건을 판단한다. 이 사실만으로 GiST를 정답 일부를 놓칠 수 있는 ANN 검색이라고 분류하면 안 된다.
| 질문 | 검토할 방향 |
|---|---|
| JSONB 안에 구조·값이 포함되는가? | 연산자와 맞는 GIN opclass |
| 특정 JSON 스칼라 값이 같은가? | 타입 변환과 표현식이 맞는 B-tree |
| 구간이 겹치거나 가까운가? | 해당 자료형의 GiST opclass |
| 문자열 오타 후보를 거리순으로 찾는가? | pg_trgm의 GiST KNN |
JSONB 컬럼이 있다고 GIN 하나로 통일하지 않고, 실제 WHERE·ORDER BY 표현식을 먼저 적은 뒤 구조를 고르는 편이 낫다.
자료 기준과 참고 문서
개인 PostgreSQL 학습 노트를 바탕으로 정리했다. 첨부 그림은 제공된 학습 자료를 사용했으며, 버전이나 설정에 따른 조건은 본문에 덧붙였다.