[PostgreSQL 8/12] PostgreSQL 텍스트 검색: FTS·pg_trgm·BM25 구분하기
PostgreSQL 공부 기록: 내부 구조부터 검색·운영까지
이 글에서 다룰 주제
- 검색 의도: 단어·부분 문자열·오타 후보는 같은 문제인가?
- 탐색과 순위: 역색인과 관련도 계산은 어떻게 다른가?
- 언어: 한국어·짧은 검색어·오류 코드에서 무엇을 시험해야 하는가?
주요 단어 · tsvector · tsquery · pg_trgm · GIN/GiST · BM25 · pg_search · Tokenizer
‘연결 오류’를 찾는다고 해도 원하는 동작은 다를 수 있다. 특정 단어를 포함한 문서를 찾을 수도 있고, 파일명 중간 문자열이나 비슷하게 입력한 제품명을 찾을 수도 있다. 이 차이를 무시하고 검색 기능을 한 이름으로 묶으면 인덱스와 평가 기준도 뒤섞인다.
FTS(Full Text Search)는 문서에서 추출한 단어와 질의의 관계를 검색한다. BM25는 단어 빈도·희소성·문서 길이 등을 활용하는 관련도 점수이며, 인덱스 구조 자체의 이름은 아니다.
자료와 예제 기준 — PostgreSQL 18을 중심으로 개인 학습 노트를 재구성했다. SQL·실행 계획·설정값은 설명 및 재현용 예제이며 이 글을 위해 운영 DB에서 새로 측정한 결과는 아니다. DDL/DML 예제는 독립적인 테스트 환경에서 사용한다.
1. 전문 검색과 부분 문자열·유사도 검색
검색 단위 비교
| 목적 | 전문 검색 | pg_trgm |
|---|---|---|
| 단위 | lexeme: 정규화된 어휘 | trigram: 3문자 조각 |
| 단어 변형 | 언어 설정·사전에 따라 처리 | 언어 규칙으로 처리하지 않음 |
| 중간 문자열 | 임의 부분 문자열 검색용이 아님 | LIKE·ILIKE 지원 |
| 오타 | 기본적으로 자동 해결되지 않음 | 유사도 연산으로 후보 검색 |
| 점수 | ts_rank·ts_rank_cd | similarity 등 |
| 인덱스 | tsvector에 GIN 등 | text에 GIN 또는 GiST |
tsvector·tsquery·GIN 연결
SELECT to_tsvector('english', 'The cats are running');
-- 'cat':2 'run':4
SELECT plainto_tsquery('english', 'cat run');
-- 'cat' & 'run'tsvector는 문서의 어휘·위치, tsquery는 검색 어휘와 논리 조건을 표현한다. 숫자 2·4는 출현 횟수가 아니라 원문 위치다. GIN은 어휘에서 후보 튜플 위치로 연결한다.
| 문서 | 원문 | 검색용 표현 |
|---|---|---|
| D1 | The cats are running | cat:2 run:4 |
| D2 | A cat sleeps | cat:2 sleep:3 |
| D3 | Dogs are running | dog:1 run:3 |
cat & run은 D1, cat | run은 D1·D2·D3, cat & !run은 D2다. GIN을 만들지 않아도 @@는 동작하며, GIN은 후보 탐색을 가속한다.
구문 검색
SELECT phraseto_tsquery('english', 'fatal error');
-- 'fatal' <-> 'error'
fatal error와 error is fatal은 같은 어휘를 포함하지만 위치가 다르다. GIN으로 후보를 좁힌 뒤 저장된 tsvector의 위치 정보를 확인하여 구문을 판정한다. 원문 전체를 매번 다시 분석해야 한다는 뜻은 아니다.
기본 구성
CREATE TABLE documents (
  id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  body text NOT NULL,
  search_vector tsvector GENERATED ALWAYS AS
    (to_tsvector('english', body)) STORED
);
CREATE INDEX documents_fts_gin ON documents USING gin (search_vector);

SELECT id, body,
       ts_rank(search_vector, websearch_to_tsquery('english', 'database monitoring')) AS score
FROM documents
WHERE search_vector @@ websearch_to_tsquery('english', 'database monitoring')
ORDER BY score DESC LIMIT 20;
문서와 질의의 설정을 일관되게 관리한다. english를 한국어 처리기로 해석하면 안 된다. ts_rank는 기본 BM25가 아니며, GIN 자체가 관련도순으로 문서를 반환하는 것도 아니다.
부분 문자열과 유사도는 별개
CREATE EXTENSION IF NOT EXISTS pg_trgm;
CREATE INDEX documents_body_trgm ON documents USING gin (body gin_trgm_ops);
SELECT id, body FROM documents WHERE body ILIKE '%gres%';
ILIKE는 대소문자를 무시한 문자열 패턴 조건이다. ILIKE '%postgreql%'을 사용하면 자동으로 postgresql을 오타로 인식하지 않는다.
-- products(name text)를 가정
SELECT name, similarity(name, 'postgreql') AS score
FROM products
WHERE name % 'postgreql'
ORDER BY score DESC LIMIT 10;%는 pg_trgm.similarity_threshold를 기준으로 유사도를 필터링한다. similarity() 함수의 점수를 비교하는 식만 쓴다고 동일한 인덱스 경로가 자동 선택된다고 가정하지 않는다. 인덱싱을 의도할 때 지원 연산자를 사용한다.
전체 문자열 유사도는 긴 본문과 짧은 질의 비교에 불리할 수 있다. word_similarity는 문자열 내부의 연속 영역과 비교하며, strict_word_similarity는 단어 경계를 고려한다.
trigram은 각 단어에 패딩을 추가해 추출한다. 단순히 문장을 공백 포함 3문자씩 자르는 것과 다르다. 다음으로 직접 관찰할 수 있다.
SELECT show_trgm('PostgreSQL');pg_trgm의 GIN vs GiST
| 요구 | 우선 검토 |
|---|---|
| 선택적인 LIKE·ILIKE 조건 | GIN부터 실제 비교 |
| 유사도 임계값으로 후보 필터링 | 둘 다 가능, 부하 측정 |
| 가까운 순서로 상위 K개 | GiST KNN |
| 완전 일치 | 일반 B-tree도 비교 |
CREATE INDEX products_name_gist
ON products USING gist (name gist_trgm_ops(siglen=32));

SELECT name, name <-> 'postgreql' AS distance
FROM products
ORDER BY name <-> 'postgreql' LIMIT 10;
text에 대한 <->는 1 - similarity다. GiST는 이 거리순 탐색을 지원한다. GIN은 %로 후보를 찾을 수 있지만 후보의 점수 정렬은 별도다.
ORDER BY ... LIMIT 10만 있는 KNN 쿼리는 임계값 제한이 없어 비슷하지 않은 항목도 반환할 수 있다. 품질 하한이 필요하면 WHERE name % 'postgreql'을 함께 검토한다.
GiST의 siglen은 signature 길이다. 길어지면 요약이 정밀해져 불필요한 탐색을 줄일 수 있지만 인덱스가 커진다. 결과를 더 정확하게 만드는 ANN 옵션은 아니다. GIN·GiST 모두 데이터에 따라 재검사가 필요할 수 있다.
한국어와 짧은 검색어
simple 설정은 한국어 형태소 분석기가 아니다. 조사·어미 분리 품질이 필요하면 적합한 분석 과정이 필요하다. LIKE '%모니터링%'은 실제 포함 문자열을 찾지만 언어를 이해한 것은 아니다.
추출할 trigram이 없는 LIKE·정규식 패턴은 전체 인덱스 스캔 수준으로 악화될 수 있다. 예를 들어 중간 포함 패턴 '%ab%'는 주의한다. 단순히 “모든 2글자 검색은 불가능”으로 일반화하지 말고 경계·패턴 종류도 고려한다.
2. ParadeDB pg_search와 BM25
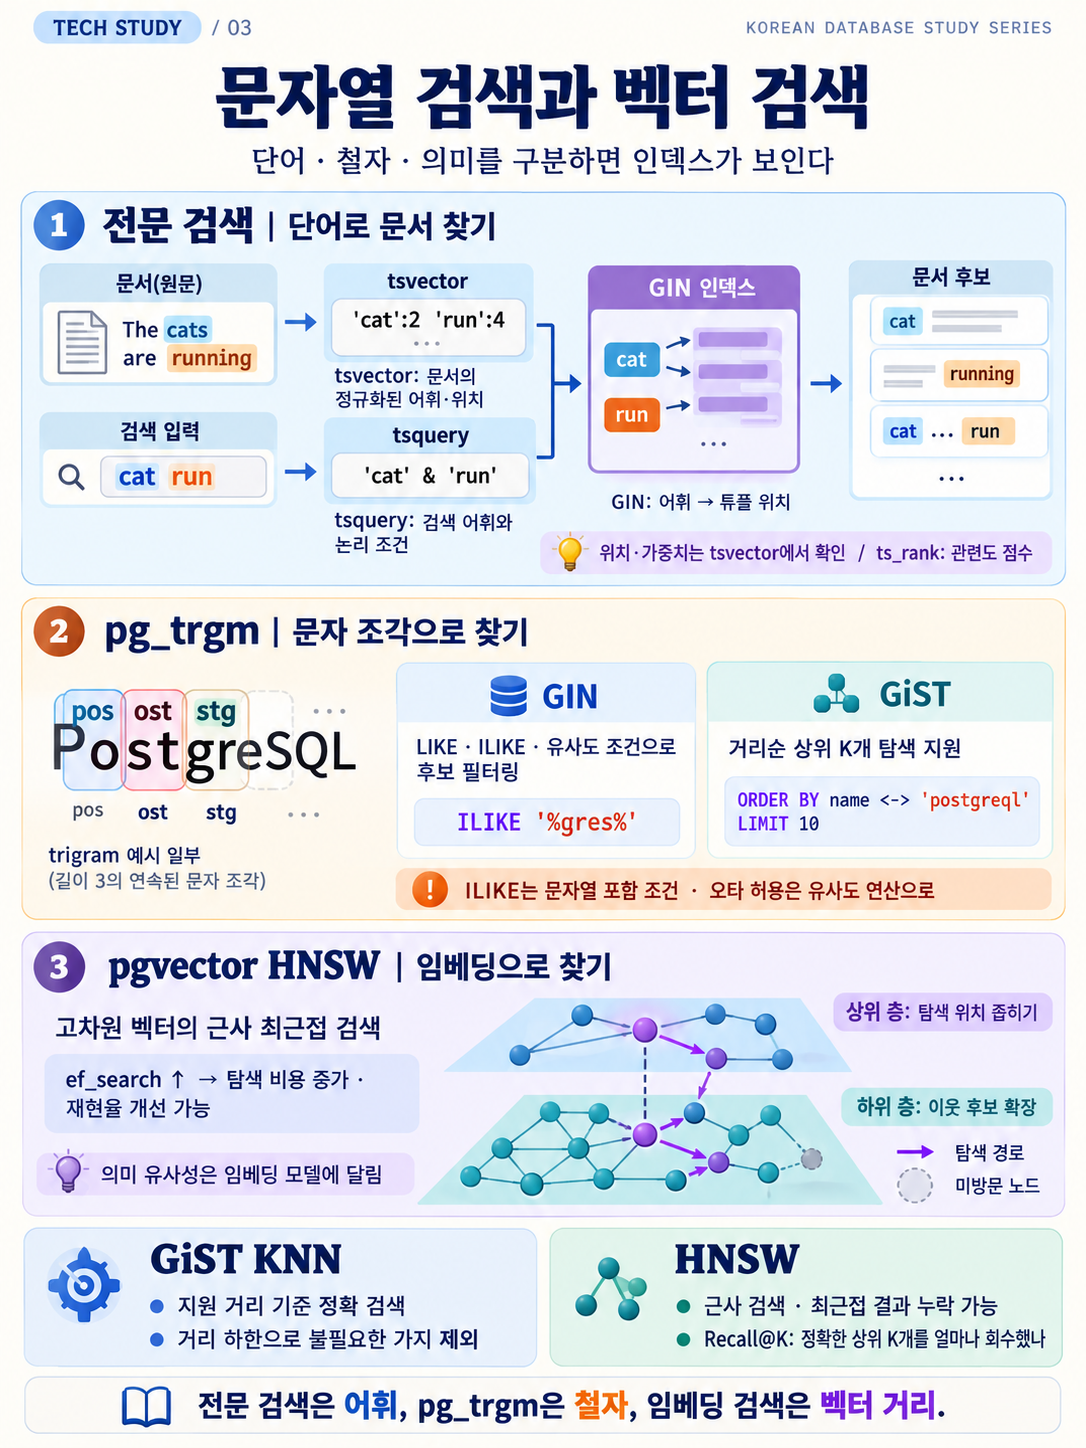
학습 자료의 개념도 — 텍스트 검색과 벡터 검색의 위치. 세부 조건은 본문 설명을 함께 읽는다.
어떤 pg_search인가?
여기서는 ParadeDB의 PostgreSQL 확장 pg_search를 의미한다. 같은 이름의 Rails 라이브러리와 구분한다. Tantivy 기반 전문 검색과 BM25 관련도 순위 등을 제공한다. PostgreSQL 테이블을 대상으로 검색 인덱스를 유지하므로 외부 검색 서버로 별도 복제하는 구성을 줄일 수 있다.
검색 방식 비교
| 방식 | 기준 | 강점 | 제약 |
|---|---|---|---|
| = | 정확한 값 | 문서 ID·오류 코드 | 의미 유사성 없음 |
| LIKE/ILIKE | 문자열 패턴 | 부분 문자열 | 관련도 순위는 별도 |
| 기본 FTS | tsvector·tsquery·GIN | PostgreSQL 내장 전문 검색 | ts_rank는 BM25가 아님 |
| pg_search BM25 | 토큰 일치와 통계 | 기술 용어·희귀 단어 | 다른 표현은 놓칠 수 있음 |
| pgvector | 임베딩 거리 | 표현이 다른 의미 유사성 | 정확한 식별자에 취약할 수 있음 |
역색인과 BM25
| 토큰 | 문서 목록 예시 |
|---|---|
| HikariPool | A, C |
| timeout | A, B |
| connection | A, C, D |
문서에서 토큰을 추출해 역색인을 만든다. 질의 토큰으로 후보를 찾고 점수를 계산한다. BM25는 단어 빈도, 빈도 포화, 단어 희소성, 문서 길이 보정을 활용한다. 점수는 관련도 신호이며 정답 확률이 아니다.
한국어·영어·코드가 섞이면 tokenizer를 시험해야 한다. INC-104나 ERR_CONNECTION_RESET이 분리되는 방식에 따라 결과가 달라진다. 정확한 식별자는 별도 컬럼과 동등 비교로 보완한다.
버전 주의
2026-09-28에 확인한 공식 문서 기준으로 0.25.0부터 인덱스 access method 이름은 paradedb이고 bm25는 호환 별칭이다. 이 글은 pg_search의 어휘 검색을 다룬다. 자체 벡터 검색의 지원 범위와 릴리스 상태는 설치 버전 문서로 확인하고, pgvector와 결합하는 구성과 구분한다.
-- 서버에 해당 버전의 pg_search 설치 및 확장 활성화가 필요
-- rag.chunks(id, content)가 존재한다는 전제의 최소 예시
CREATE INDEX chunks_search_idx
ON rag.chunks USING paradedb (id, content)
WITH (key_field = 'id');
공식 문서에서는 테이블당 하나의 ParadeDB 인덱스를 안내한다. 토크나이저와 필터·정렬 컬럼을 설계하고, 사용 버전의 문법을 확인한다.
3. Elasticsearch와 비교할 때의 기준
GIN과 Elasticsearch의 역색인
원리는 같다: 요소 → 포함 문서 목록. 하지만 실제 구현은 다르다. 정확한 비교 대상은 PostgreSQL GIN과 Elasticsearch가 사용하는 Lucene 역색인이다.
| 구분 | GIN | Lucene |
|---|---|---|
| 키 탐색 | Entry tree | 세그먼트별 term dictionary |
| 참조 | PostgreSQL 튜플 TID | Lucene 내부 문서 번호 |
| 목록 | Posting list·posting tree | 세그먼트별 postings |
| 갱신 | 인덱스 페이지·선택적 pending | 세그먼트 생성·병합 |
| 전문 검색 위치 정보 | tsvector에서 확인 | 설정에 따라 postings에 저장 |
| 관련도 | ts_rank 등 별도 계산 | Elasticsearch 기본 BM25 |
PostgreSQL 전문 검색용 GIN은 어휘를 중심으로 후보를 찾는다. tsvector의 위치·가중치를 모두 GIN에 보관하지 않는다. Lucene은 설정에 따라 문서 번호 외에 빈도·위치·offset을 인덱싱할 수 있다.
GIN을 생성한다고 BM25가 자동 적용되거나 Elasticsearch 전체 기능을 갖추는 것은 아니다. Elasticsearch도 모든 자료형을 하나의 역색인 방식으로만 처리하는 것은 아니다. 여기서는 텍스트 term 기반 검색을 비교한다.
Pending과 refresh의 차이
| 항목 | GIN pending | Elasticsearch refresh |
|---|---|---|
| 의미 | 본 GIN 구조로의 병합 대기 | 새 변경을 검색에 보이도록 반영 |
| 검색 가시성 | pending도 탐색, MVCC로 결정 | 일반 검색은 refresh 전 변경이 보이지 않을 수 있음 |
pending을 미커밋 상태 또는 검색 반영 대기로 이해하면 안 된다. Elasticsearch의 일반 검색 가시성과 실시간 문서 GET의 동작도 구분해야 한다. 또한 refresh와 내구성 확보를 같은 의미로 보지 않는다.
4. 프로젝트에 적용하기 전 평가
프로젝트 적용 판단
번역 가이드·용어집·장애 보고서에 키워드가 중요한 경우 pgvector 단독, BM25 단독, 하이브리드를 같은 평가셋으로 비교한다. 질문별 Recall@k, 최종 근거 정확성, 답변 지지율, p95 지연을 확인한다.
대량 로그·관측 플랫폼을 그대로 대체한다고 보지 않는다. 검색 기능뿐 아니라 수집·분산·보존·분석 UI까지 비교해야 한다. 검색 부하는 같은 PostgreSQL의 CPU·I/O를 사용한다.
자료 기준과 참고 문서
개인 PostgreSQL 학습 노트를 바탕으로 정리했다. 첨부 그림은 제공된 학습 자료를 사용했으며, 버전이나 설정에 따른 조건은 본문에 덧붙였다.