이 글에서 다룰 주제
- 객체와 DB: Dirty Checking·Flush·Commit의 경계는 어디인가?
- 성능: SQL 한 건의 시간 외에 무엇을 줄여야 하는가?
- 연결: 외부 API 대기와 풀의 크기는 어떻게 함께 설계하는가?
주요 단어 · ORM Session · Dirty Checking · Flush · Commit · N+1 · Lost Update · PgBouncer
객체의 필드 하나를 바꾸는 코드는 짧지만 DB에서는 SQL 실행, 행 버전 생성, 인덱스 유지, 잠금, WAL 기록으로 이어질 수 있다. ORM을 쓴다는 사실보다 중요한 것은 어떤 SQL이 언제 실행되고 트랜잭션과 연결이 얼마나 오래 유지되는지다. SQLAlchemy 2.x의 흐름을 기준으로 이 경계를 살펴본다.
ORM Flush는 객체의 변경을 SQL로 DB에 반영하는 단계다. Commit은 트랜잭션 확정이고, PgBouncer는 클라이언트와 DB 사이에서 서버 연결을 재사용하는 별도 프록시다.
자료와 예제 기준 — PostgreSQL 18을 중심으로 개인 학습 노트를 재구성했다. SQL·실행 계획·설정값은 설명 및 재현용 예제이며 이 글을 위해 운영 DB에서 새로 측정한 결과는 아니다. DDL/DML 예제는 독립적인 테스트 환경에서 사용한다.
1. ORM의 Dirty checking·Flush·Commit
1 서로 다른 계층의 Dirty
| 용어 | 계층 | 의미 |
|---|---|---|
| Dirty checking | 애플리케이션 ORM | 객체 변경 감지 |
| Dirty page | PostgreSQL 버퍼 | 메모리 페이지가 변경되어 기록 필요 |
| ORM Flush | 애플리케이션 → DB | 변경 SQL 실행 |
| WAL Flush | DB → 저장장치 | WAL 영속화 |
Dirty checking은 스냅샷 비교·속성 계측·변경 추적 등 ORM마다 구현이 다르다. 모든 ORM이 같은 시점에 같은 방식으로 비교한다고 가정하면 안 된다.
2 한 번의 객체 변경이 DB까지 이어지는 과정
order = session.get(Order, 42)
order.status = "PAID"
session.flush()
session.commit()| 단계 | ORM / 애플리케이션 | PostgreSQL |
|---|---|---|
| 객체 조회 | Entity 로딩 | SELECT와 가시성 판단 |
| 속성 변경 | 객체 상태 변화 | 아직 UPDATE가 없을 수 있음 |
| Flush | 변경 감지 후 UPDATE 실행 | 새 버전·WAL·Dirty page 생성 |
| Commit | 트랜잭션 확정 요청 | 기본 설정에서 커밋 WAL까지 영속화 |
| 이후 | 새 작업·조회 | 페이지 쓰기·Checkpoint·버전 정리 |
이 도식은 일반 영구 테이블 쓰기, 동기 커밋, 동기 복제 없음 기준이다. WAL 기록은 Commit 전에도 일어날 수 있다. Commit은 필요하다면 먼저 Flush를 수행한다.
3 Flush 후의 가시성과 잠금
자기 트랜잭션은 자신이 만든 새 버전을 조회할 수 있다. 다른 트랜잭션은 미커밋 버전을 볼 수 없다. 하지만 UPDATE가 획득한 잠금은 이미 존재할 수 있으므로 다른 쓰기를 대기시킬 수 있다.
SQLAlchemy는 특정 ORM 쿼리·Lazy loading 전에 자동 Flush를 수행할 수 있다. 따라서 코드에서 SELECT하는 지점에 이전 객체 변경의 UPDATE가 먼저 실행될 수 있다. no_autoflush는 특정 자동 Flush를 제어하지만 Commit 자체의 Flush까지 없애는 방법은 아니다.
4 Rollback·오류·응답 유실
- Rollback하면 미커밋 변경은 유효한 업무 결과로 노출되지 않는다.
- 이미 생성된 WAL이 즉시 삭제되는 것은 아니다.
- 실패한 Flush 이후 Session 재사용에는 명시적인 Rollback 등 ORM이 요구하는 복구가 필요하다.
- ORM 객체의 만료·새로고침·상태 복구는 DB 버전 정리와 별개다.
- DB가 Commit했지만 성공 응답이 네트워크에서 유실되면 클라이언트는 결과를 모를 수 있다. 재시도에는 멱등키·상태 조회가 필요하다.
2. ORM 안티패턴과 개선
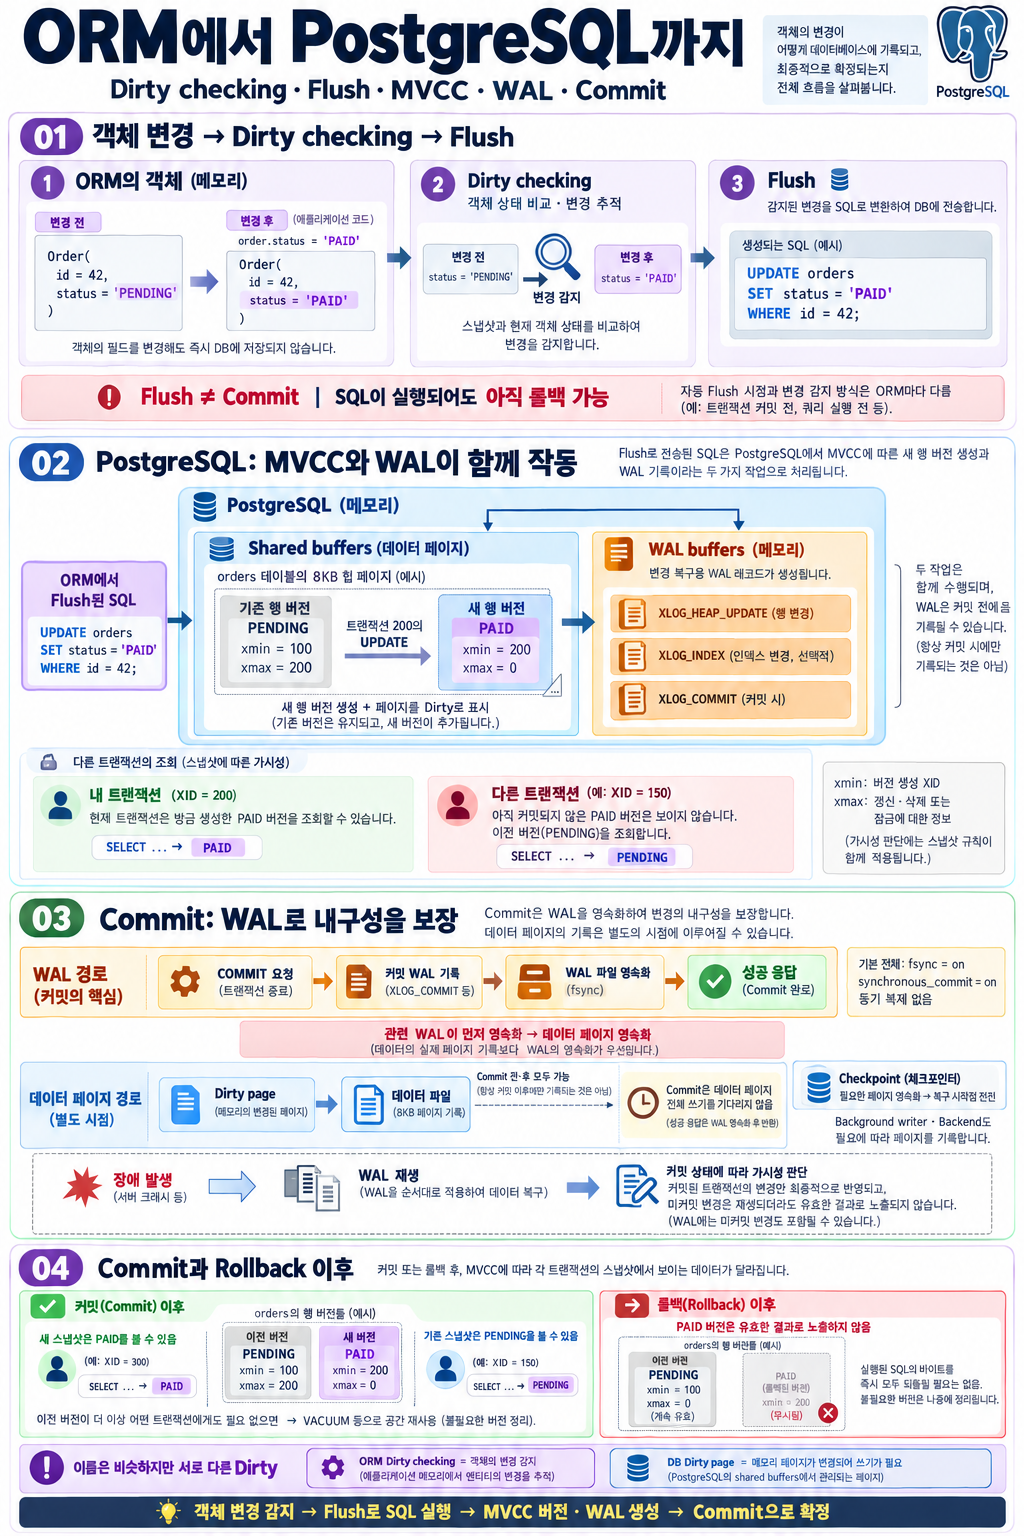
학습 자료의 개념도 — ORM의 변경이 PostgreSQL에 반영되는 흐름. 세부 조건은 본문 설명을 함께 읽는다.
1 N+1
# lazy relationship이라면 주문 조회 1회 + 주문별 품목 조회 N회 가능
orders = session.scalars(select(Order).limit(100)).all()
for order in orders:
    print(order.items)
from sqlalchemy import select
from sqlalchemy.orm import selectinload
stmt = (select(Order)
.options(selectinload(Order.items))
.order_by(Order.id)
.limit(100))
orders = session.scalars(stmt).all()Select-IN 로딩은 부모 키를 모아 관계 데이터를 일괄 조회한다. 실제 SQL 수는 배치 크기와 관계 깊이에 따라 달라진다. 테스트에서 raiseload로 예상하지 않은 Lazy loading을 드러낼 수도 있다.
2 모든 관계를 JOIN하는 해결책
주문 하나의 품목 10개·결제 이력 3개·배송 이벤트 5개를 독립적으로 JOIN하면 최대 150행으로 펼쳐질 수 있다. ORM이 주문 객체 하나로 합쳐도 DB·네트워크는 펼쳐진 행을 처리한다.
| 상황 | 검토할 방식 |
|---|---|
| Many-to-one 단일 연관 객체 | JOIN 로딩 |
| 큰 One-to-many 컬렉션 | Select-IN·별도 일괄 조회 |
| 여러 독립 컬렉션 | 관계별 조회·개별 집계 |
| 목록 화면 | 필요한 컬럼만 Projection |
쿼리 횟수·반환 행 수·반환 바이트 수를 함께 측정한다.
3 전체 Entity 로딩
stmt = select(TranslationJob.id, TranslationJob.status,
              TranslationJob.updated_at)
목록에 ID·상태만 필요한데 원문·번역문·큰 JSONB까지 가져오면 전송·디코딩·객체 생성·직렬화 비용이 증가한다. 조회 DTO와 수정 Entity를 구분할 수 있다. 별도 DB를 두는 큰 CQRS가 필수는 아니다.
4 행별 INSERT와 Commit
# 피해야 할 대량 적재 패턴
for row in rows:
    session.add(Translation(**row))
    session.commit()
Bulk INSERT, 적절한 트랜잭션 배치, COPY, Staging table을 검토한다. 전체 원자성이 필요하면 중간 Commit은 의미를 바꾸므로 주의한다. Bulk DML에서는 Entity 이벤트·Cascade·버전 검증·세션 동기화가 일반 객체 Flush와 다를 수 있다.
5 외부 API 대기 중 열린 트랜잭션
# 장시간 LLM 호출 동안 트랜잭션 유지
async with session.begin():
    job = await session.get(TranslationJob, job_id)
    result = await call_llm(job.source_text)
    job.result = result
연결과 잠금이 오래 유지될 수 있으며 XID·스냅샷에 따라 VACUUM을 지연시킬 수 있다. READ COMMITTED의 모든 조회가 오래된 스냅샷을 끝까지 유지하는 것은 아니므로 실제 상태를 확인한다.
개선 구조:
| 단계 | 트랜잭션 |
|---|---|
| 원자적 작업 선점·입력 확보 | 짧게 시작·커밋 |
| LLM·외부 API 호출 | DB 트랜잭션 유지하지 않음 |
| 선점 토큰 검증·결과 저장 | 짧게 시작·커밋 |
UPDATE translation_jobs
SET status = 'RUNNING', claim_token = :claim_token
WHERE id = :job_id AND status = 'PENDING'
RETURNING id, source_text;
결과가 없으면 선점하지 못한 것이다. 완료 저장도 WHERE id=:job_id AND claim_token=:claim_token AND status='RUNNING' 같은 조건을 검사한다. Lease 만료·Worker 장애·재시도·멱등성은 추가로 설계한다.
6 Lost update
두 요청이 재고 10을 읽고 각각 9를 저장하면 차감이 하나 사라진다. 객체에서 계산한 상수를 저장하는 패턴을 주의한다.
UPDATE products
SET stock = stock - 1
WHERE id = :id AND stock > 0
RETURNING stock;
복잡한 결정에는 낙관적 버전 검증 또는 짧은 비관적 잠금을 검토한다.
UPDATE orders
SET status = :status, version = version + 1
WHERE id = :id AND version = :expected_version;
영향 행 수가 0이면 충돌·행 부재 등을 처리한다. Serializable과 Repeatable Read에서 발생 가능한 재시도 오류도 설계에 반영한다. ORM 버전 검증이 모든 Bulk UPDATE에 적용된다고 가정하지 않는다.
7 불필요한 UPDATE
UPDATE translation_jobs
SET status = :status, updated_at = now()
WHERE id = :id
  AND status IS DISTINCT FROM :status;
값이 실제로 달라질 때만 UPDATE하도록 하면 불필요한 버전·WAL·Dirty page·청소 부담을 줄일 수 있다. IS DISTINCT FROM은 NULL을 포함해 비교한다. 영향 행 수 0은 같은 값이었거나 행이 없는 경우 등으로 구분할 수 있어야 한다.
모든 ORM이 전체 컬럼을 항상 갱신하는 것은 아니다. 실제 SQL을 확인한다. 같은 값을 SET 목록에 포함했다는 이유만으로 반드시 HOT이 실패하는 것도 아니다. 실제 값 변경과 인덱스 참조를 구분한다.
8 애플리케이션의 중복 검사만 사용
두 요청이 동시에 존재 여부를 확인하면 둘 다 INSERT할 수 있다. DB Unique 제약을 두고 업무 규칙에 맞는 UPSERT를 사용한다.
INSERT INTO translations (source_id, target_language, text)
VALUES (:source_id, :language, :text)
ON CONFLICT (source_id, target_language)
DO UPDATE SET text = EXCLUDED.text
RETURNING id;
위 예시는 (source_id, target_language)에 적절한 Unique 제약·인덱스가 있다는 전제다. 무조건 덮어쓰기가 업무적으로 맞는지도 확인한다.
9 깊은 OFFSET
SELECT id, created_at, status
FROM orders
WHERE (created_at, id) < (:last_created_at, :last_id)
ORDER BY created_at DESC, id DESC
LIMIT 50;
순차 탐색에는 Keyset pagination을 검토한다. (created_at DESC, id DESC) 인덱스와 NULL이 없는 안정적인 정렬 키를 전제로 한다. 첫 페이지는 커서 조건을 제외한다. 임의 페이지 점프에는 OFFSET이 단순할 수 있다. Keyset도 동시 수정된 정렬 키에 대한 완전한 스냅샷 일관성을 자동 제공하지 않는다.
10 AsyncSession 공유
AsyncSession은 하나의 상태 있는 작업 단위다. 여러 동시 Task가 같은 Session을 공유하지 않도록 한다. 각 Task에 별도 Session을 두면 트랜잭션도 분리되므로 전체 원자성이 필요할 때는 병렬화 구조 자체를 재검토한다.
11 성능을 SQL 평균 시간만으로 평가
N+1은 SQL 하나하나는 빠를 수 있다. 요청당 SQL 수, 반환 행·바이트, 객체 생성 시간, 연결 풀 대기, 트랜잭션 시간, 총 DB 호출 시간을 함께 본다. 같은 패턴 SQL의 높은 호출 수는 단서이지 단독으로 N+1의 증거는 아니다. 요청 Trace와 연결해 판단한다.
3. NORM과 데이터 접근 방식 선택
이 글의 NORM은 Hettie Dombrovskaya와 Boris Novikov가 소개한 No ORM 방법론을 의미한다. 같은 이름의 다른 라이브러리와 구분한다.
애플리케이션과 DB의 계약을 정의하고 PostgreSQL 함수·타입·SQL을 통해 직접 데이터를 주고받는다. 해당 프로젝트는 JSON Schema를 메타데이터로 사용해 함수와 타입 생성에 활용한다. 단순히 SQL을 직접 썼다고 모두 그 특정 NORM 프레임워크를 사용한 것은 아니다.
| 선택지 | 강점 | 비용 |
|---|---|---|
| ORM | CRUD·객체 상태 관리 | 숨은 SQL·세션 동작 이해 필요 |
| SQL Query Builder | SQL 구조 통제와 코드 조합 | 결과 매핑·업무 규칙 관리 |
| 직접 SQL | 실행문·PostgreSQL 기능 명확 | 파라미터 바인딩·유지보수 책임 |
| DB 함수·NORM | 데이터 계약·왕복·DB 처리 통제 | DB 코드 배포·버전·관측 책임 |
-- 계약 중심 접근의 개념 예시: 사용자 정의 함수가 있어야 실행 가능
SELECT api.get_order_detail(:order_id);
함수 호출이 한 번이어도 내부 SQL은 여러 번 실행될 수 있다. JSON 조립 비용도 DB CPU에서 발생한다. NORM이 자동으로 N+1·긴 트랜잭션을 해결하지는 않는다.
번역 플랫폼 같은 서비스에서는 단순 CRUD는 ORM, 목록·집계는 Projection 또는 명시적 SQL, 대량 적재는 COPY·Staging, 상태 선점은 조건부 UPDATE, 외부 LLM 조정은 애플리케이션으로 역할을 나누는 접근을 검토할 수 있다.
4. PgBouncer와 연결 예산
내부 확장이 아닌 연결 프록시
PgBouncer는 애플리케이션과 PostgreSQL 사이에 별도로 실행한다. 많은 클라이언트 연결을 더 적은 서버 연결로 처리하며 여유가 없으면 요청을 대기시킨다. CPU·I/O 성능이나 쿼리 자체를 자동 개선하는 도구는 아니다.
FastAPI Pod 4 × 프로세스 2 × 풀 최대 10이면 API만 최대 80개 연결이다. 각 프로세스의 overflow도 포함해야 한다. 앱 풀의 lazy 생성으로 실제 연결이 항상 최대값까지 열리는 것은 아니다.
풀링 모드
| 모드 | 반환 시점 | 적합성·제약 |
|---|---|---|
| Session | 클라이언트 연결 종료 | 세션 기능 호환, 기본 모드 |
| Transaction | 트랜잭션 종료 | 짧은 API 요청에 유리, 세션 의존 기능 주의 |
| Statement | 문장 종료 | 여러 문장 트랜잭션 불가 |
Transaction 모드는 BEGIN부터 COMMIT/ROLLBACK까지 같은 서버 연결을 할당한다. 다음 트랜잭션에서는 다른 연결이 배정될 수 있다.
앱이 장기 연결 풀을 유지하면서 Session 모드를 쓰면 서버 연결도 오래 점유하므로 공유 효과가 제한될 수 있다.
앱 풀과의 관계
| 구분 | 앱 풀 | PgBouncer |
|---|---|---|
| 범위 | 프로세스별 | 여러 클라이언트 |
| 재사용 | PgBouncer/DB 엔드포인트 연결 | 실제 PostgreSQL 연결 |
| 증설 영향 | 프로세스마다 증가 | 각 PgBouncer 인스턴스별 예산 |
SQLAlchemy 풀과 함께 사용 가능하다. 작은 앱 풀·제한된 overflow에서 시작해 앱 풀 대기와 PgBouncer 대기를 분리 관측한다. 무조건 앱 풀을 제거하는 것이 정답은 아니다.
세션 상태 주의
| 기능 | Transaction 모드 고려 |
|---|---|
| 일반 세션 SET | 지속 상태를 가정하지 말고 SET LOCAL 우선 |
| LISTEN | 전용 연결 또는 Session 모드 |
| session advisory lock | 트랜잭션 lock 검토 |
| 트랜잭션을 넘는 임시 테이블 | 별도 연결 또는 구조 변경 |
| prepared statement | 프로토콜·버전·설정 구분 |
참고한 공식 문서는 프로토콜 수준 named prepared statement를 max_prepared_statements가 0이 아닌 설정에서 지원한다고 설명한다. SQL PREPARE/DEALLOCATE와 동일하지 않다. 드라이버·ORM과 실제 버전 조합을 검증한다. 일부 추적 가능한 설정은 예외가 있지만 임의의 세션 상태가 모두 안전하다는 뜻은 아니다.
-- 11편의 study.vector_docs 예제 테이블이 있다는 전제
BEGIN;
SET LOCAL hnsw.ef_search = 100;
SELECT id, content FROM study.vector_docs
ORDER BY embedding <=> '[0.1,0.2,0.3]'::vector LIMIT 5;
COMMIT;
RLS용 사용자 컨텍스트도 인증된 서버 값으로 같은 트랜잭션 안에서 설정한다. 커넥션을 빌렸을 때 이전 요청의 상태가 있을 것이라 기대하지 않는다. 커스텀 세션 변수 자체가 클라이언트 신원을 보증하지도 않는다.
LLM 대기와 연결 점유
나쁜 패턴: BEGIN → 작업 조회 → LLM 2분 대기 → 저장 → COMMIT.
권장 패턴: 짧은 선점 트랜잭션 → 커밋·앱 풀에도 반환 → 외부 처리 → 짧은 완료 트랜잭션.
PGMQ read도 짧게 커밋하면 되지만 긴 폴링 SQL은 실행 중 서버 연결을 점유한다. Worker 수와 poll 시간도 예산에 포함한다.
주요 설정과 합산
| 설정 | 의미 |
|---|---|
| max_client_conn | 클라이언트 최대 연결 |
| default_pool_size | 사용자·DB 조합의 기본 서버 풀 크기 |
| reserve_pool_size | 추가 허용 서버 연결 |
| max_db_connections | 해당 PgBouncer DB 엔트리별 상한 |
| max_user_connections | 사용자별 서버 연결 상한 |
| query_wait_timeout | 서버 연결 대기 제한 |
pool_size=20은 모든 연결의 전역 합계를 20으로 제한하는 값이 아니다. DB·사용자 조합과 PgBouncer 인스턴스 수를 고려한다. 동일 PostgreSQL DB를 서로 다른 PgBouncer 별칭으로 등록하면 별칭별 제한을 전역 제한으로 오해하지 않는다.
PostgreSQL 총 서버 연결 예산
≈ 모든 PgBouncer 인스턴스의 서버 연결 합계
 + 직접 연결 앱·배치·관리 도구·모니터링 연결
예시: PgBouncer 2개가 각각 총 40개를 허용하면 최대 80개에 직접 연결 예산이 더해진다. 운영 접속용 여유도 남긴다. 이 값은 추천 설정이 아니라 합산 예시다.
앱 Pod마다 Sidecar를 두면 지연·독립성 측면의 장점이 있지만 풀 수도 Pod 수만큼 늘어난다. 독립 Deployment는 풀을 공유하기 쉽지만 가용성과 라우팅을 설계해야 한다. PgBouncer 자체가 PostgreSQL HA·자동 primary 선출을 제공하는 것은 아니다.
성능 진단
| 관찰 | 해석 방향 |
|---|---|
| 앱 풀 대기 증가 | 로컬 풀·요청 동시성·연결 미반환 |
| PgBouncer 대기 증가 | 서버 풀 한도 또는 DB 처리 지연 |
| DB active 증가·쿼리 지연 | 실행 계획·I/O·CPU·잠금 |
| idle in transaction 증가 | 트랜잭션 수명 관리 문제 |
| RAG 때만 업무 지연 | 자원 경합, 검색·인덱싱 동시성 |
PgBouncer를 도입해도 느린 SQL과 벡터 검색 비용은 남는다. 애플리케이션·PgBouncer·DB의 대기 시간을 분리해야 연결 부족과 실행 지연을 혼동하지 않는다.
5. 요청 한 건을 다시 따라가기
객체 변경은 SQL 실행 시점과 같지 않다. Flush가 일어나면 잠금과 DB 작업은 이미 시작될 수 있다. Commit을 끝냈더라도 애플리케이션이 연결을 풀에 반환하는 시점을 함께 확인해야 한다.
외부 API 호출 전후에 트랜잭션을 나누면 DB 점유를 줄일 수 있지만 작업의 중복 수행·소유권 변경·재시도 처리는 애플리케이션이 책임져야 한다. 마지막 편에서는 이 경계를 PGMQ와 문서 처리 작업에 적용한다.
자료 기준과 참고 문서
개인 PostgreSQL 학습 노트를 바탕으로 정리했다. 첨부 그림은 제공된 학습 자료를 사용했으며, 버전이나 설정에 따른 조건은 본문에 덧붙였다.