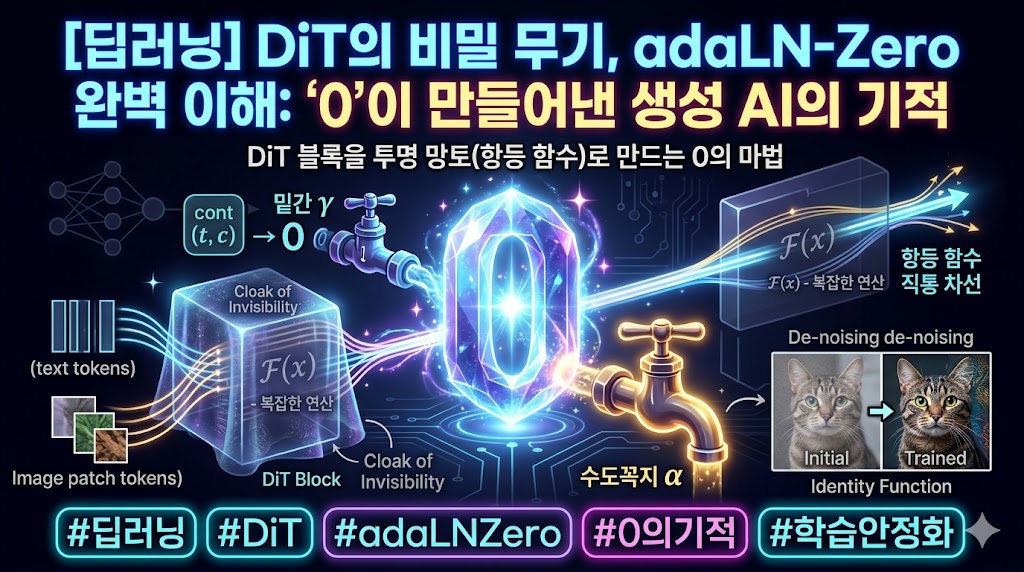
최근 생성 AI 업계를 뒤흔든 가상 현실 모델 'Sora'나 고품질 이미지 생성 모델들의 뼈대를 타고 올라가다 보면 DiT(Diffusion Transformers)라는 이름을 만나게 됩니다.
기존의 U-Net 구조를 탈피하고 트랜스포머를 확산 모델(Diffusion Model)에 성공적으로 이식한 이 혁신적인 모델 뒤에는, 사실 학습을 극도로 안정적으로 만들어준 숨은 공신이 있습니다.
오늘 블로그에서는 DiT 논문의 가장 핵심적인 네이밍이자 수학적 마법인 'adaLN-Zero'에 대해 아주 쉽고 직관적으로 파헤쳐 보겠습니다.
1. 이름 뒤에 붙은 '-Zero'의 진짜 의미
'adaLN-Zero'라는 이름을 처음 보면 단순히 숫자 0을 의미하는 것처럼 보일 수 있습니다. 하지만 이 'Zero'는 DiT의 아키텍처 설계 사상이 그대로 담긴 훈장과도 같은 이름입니다.
결론부터 말씀드리면, 여기서 Zero는 '0으로 초기화(Zero-initialization)'라는 수학적 기법을 뜻합니다.
DiT 블록 안에는 타임스텝()과 클래스()라는 힌트를 받아서 모델 내부의 수도꼭지 조절 나사들()을 찍어내는 작은 신경망(MLP)이 들어있습니다.
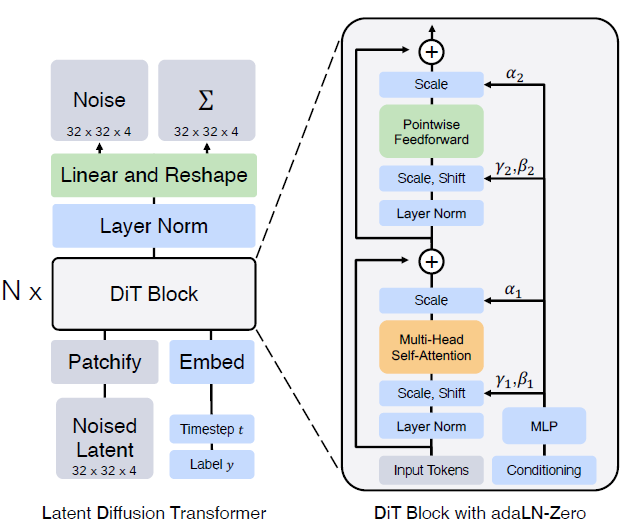
저자들은 학습을 시작하는 맨 처음 순간(Initialization), 이 작은 신경망의 최종 가중치(Weight)와 편향(Bias) 값을 모두 숫자 '0'으로 세팅해 버렸습니다. 이것이 바로 마법의 시작입니다.
2. 0이 만들어낸 수학적 마법: 블록을 '투명 망토'로 만들다
모든 가중치를 0으로 만드는 것이 왜 마법일까요? 신경망이 무조건 0을 뱉어내게 되면, DiT 블록 내부에서는 도미노처럼 아주 재미있는 일들이 벌어집니다.
이를 이해하기 위해 DiT 블록의 핵심 조절 나사인 (감마)와 (알파)의 역할을 먼저 알아야 합니다.
💡 직관적 비유: 는 '밑간', 는 '수도꼭지'
- (감마) - 요리 전 '밑간': 트랜스포머의 핵심 연산(Self-Attention 등)에 들어가기 전, 입력 데이터에 조건()이라는 양념을 뿌려 데이터의 성격을 조건에 맞게 변형시켜 줍니다.
- (알파) - 요리 후 '수도꼭지': 모든 복잡한 연산이 다 끝난 후, 그 결과물을 원본 데이터(고속도로, Residual Connection)에 얼마나 합류시킬지 최종 양을 조절하는 밸브 역할을 합니다.
이제, 모든 나사가 '0'이 된다면?
- 수도꼭지 이 됩니다: 트랜스포머 블록 내부에서 아무리 지지고 볶고 복잡한 연산을 했더라도, 마지막에 이 곱해지면서 결과물이 싹 날아가 버립니다. 메인 고속도로로 통하는 마지막 밸브가 꽉 잠겨버리는 것이죠.
- 밑간 이 됩니다: 단순히 0을 곱하는 것이 아닙니다. 원래 수식은 를 곱하는 형태입니다. 즉 가 0이 되면 크기를 배(그대로) 하라는 뜻이 되어 원래 데이터에 아무런 조작도 가하지 않게 됩니다.
결과: 항등 함수(Identity Function)의 탄생
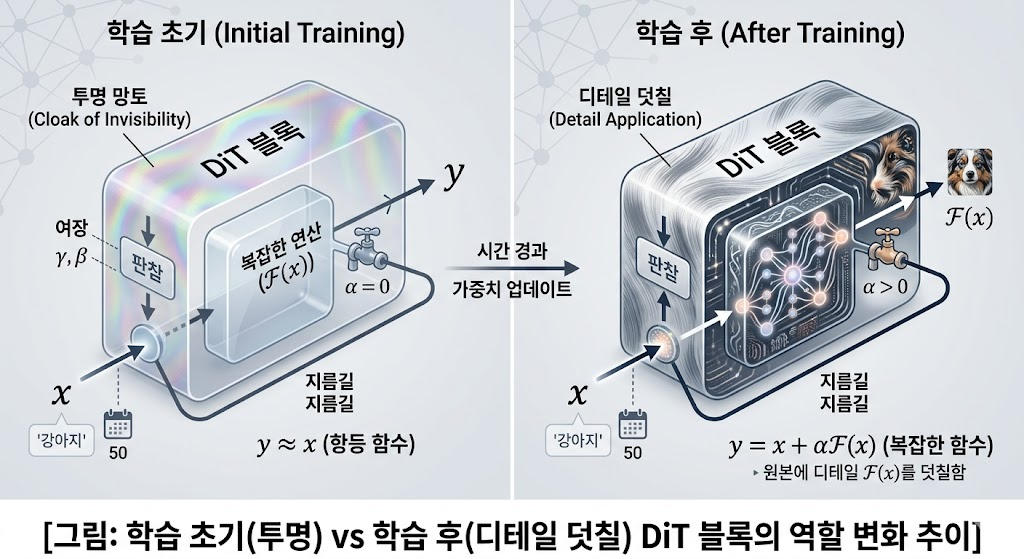
도미노의 마지막 조각은 잔차 연결(Residual Connection, 지름길)입니다. DiT 블록의 최종 수식은 다음과 같이 단순화됩니다.
여기서 이 되므로, 수식은 자연스럽게 다음과 같이 변합니다.
들어온 입력값()이 아무런 변형 없이 그대로 출력()되는 것, 이것이 바로 수학에서 말하는 항등 함수입니다.
결국, adaLN-Zero 초기화 덕분에 수억 개의 파라미터를 가진 거대한 DiT 블록이 초기에는 그저 입력값을 그대로 통과시키는 완벽한 '투명 망토'로 둔갑하게 됩니다.
3. 왜 처음에는 아무것도 안 하는 게 '유익(Beneficial)'할까요?
딥러닝 모델, 특히 층을 수십~수백 개씩 깊게 쌓는 거대 모델에서는 이 초기화가 생명줄과도 같습니다. 기존의 트랜스포머들은 이미지 생성(확산 모델)에 적용하려고 할 때 학습이 너무 불안정해서 번번이 실패했습니다. 하지만 adaLN-Zero는 이 문제를 천재적으로 해결했습니다.
1) 안전한 고속도로 개통 (Gradient Vanishing 방지)
100층짜리 신경망을 랜덤한 값으로 초기화하면, 데이터가 층을 통과하는 동안 값이 폭발하거나 소실되어 버립니다. 하지만 100개의 층을 모두 '항등 함수'로 초기화하면? 데이터와 학습 신호(기울기)가 100층을 통과해도 원래 모습 그대로 유지되며, 1층까지 막힘없이 뻥 뚫린 고속도로를 타고 안전하게 전달됩니다.
2) "일단 가만히 있어봐, 필요할 때만 고칠게" (점진적 학습)
모델에게 처음부터 복잡한 그림을 그리라고 윽박지르는 대신, "일단 원본 데이터 그대로 다음 층으로 넘겨. 그러다가 정답을 맞히는 데 꼭 필요한 부분이 생기면, 그때 가서 값을 0에서부터 아주 조금씩만 키워서 원본에 더해봐"라고 가르치는 것입니다. 이렇게 하면 학습이 놀라울 정도로 안정적이고 부드럽게 진행됩니다.
4. 학습이 진행된 후에는 어떻게 될까요?
당연히 영원히 항등 함수로 남아있는 것은 아닙니다! 학습(Training)이 진행되면서 오차를 줄이기 위해 모델은 스스로 가중치를 업데이트합니다. 이때부터는 가 더 이상 0이 아니게 되며, 모델은 원본 데이터 에 아주 정교하게 계산된 디테일들을 덧칠해서 아주 복잡하고 똑똑한 함수로 진화하게 됩니다.
요약: '0'의 마법이 만든 생성 AI의 역사
"초기에 항등 함수로 세팅한다"는 것은 건물을 지을 때 뼈대(원본 데이터)가 무너지지 않도록 튼튼하게 유지해 두고, 그 위에 인테리어(노이즈 예측)를 아주 조심스럽고 안전하게 시작하겠다는 저자들의 깊은 의도가 담긴 기법입니다.
저자들 입장에서는 이 "아무것도 안 하게 만드는 0의 마법"이 이 논문의 가장 위대한 발견이자 핵심이었기 때문에, 기존의 adaLN 구조와 구별하기 위해 아키텍처 이름 뒤에 당당하게 '-Zero'라는 훈장을 달아준 것입니다.
이제 DiT를 구성하는 심장부인 '블록 설계도'는 완벽하게 마스터하셨습니다. '아무것도 안 함'으로써 '모든 것'을 가능하게 만든 adaLN-Zero의 철학, 정말 경이롭지 않나요?