High Frequency와 Spectral Bias로 이해하는 3D 형상 학습의 한계와 해법
인공지능
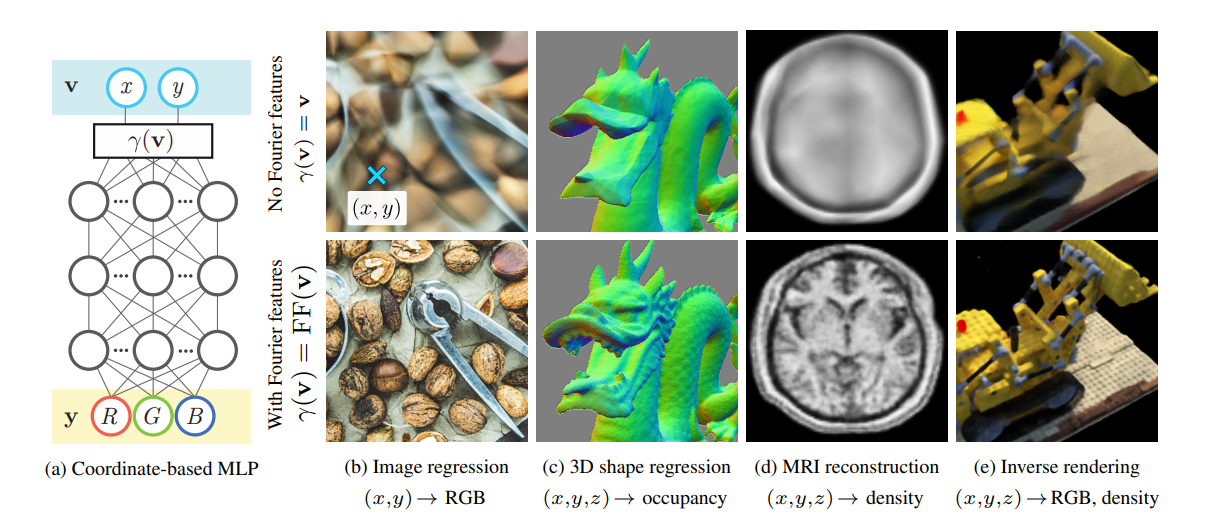
딥러닝 기반 3D 형상 복원이나 생성에서 자주 마주치는 문제가 있습니다.
전체적인 형태는 그럴듯한데, 짧은 거리에서 급격히 변하는 구조는 흐릿하게 표현되는 현상입니다.
이 문제의 핵심에는 High Frequency(고주파) 와 Spectral Bias라는 개념이 자리 잡고 있습니다.
이 글에서는 다음 세 가지를 중심으로 정리합니다.
- High Frequency란 무엇인가
- Spectral Bias란 무엇이며 왜 발생하는가
- High Frequency를 딥러닝 모델이 인식하도록 만드는 구현 방법
1. High Frequency란 무엇인가? (공간 주파수 관점)
1.1 주파수는 시간만의 개념이 아니다
우리가 흔히 아는 주파수(Hz)는 시간에 따른 변화 속도를 의미합니다.
하지만 이미지나 3D 형상에서는 공간 주파수(Spatial Frequency) 라는 개념을 사용합니다.
-
시간 주파수
→ 1초 동안 신호가 얼마나 빠르게 변하는가 -
공간 주파수
→ 단위 거리 이동 시 값이 얼마나 급격히 변하는가
즉, 공간 주파수는 “얼마나 짧은 거리에서 값이 크게 달라지는가”를 의미합니다.
1.2 High Frequency의 직관적 정의
공간 상에서 다음과 같은 차이가 있다고 가정해 봅시다.
-
저주파 성분
- 값 변화:
10 → 9.9 → 9.8 → 9.7 - 특징: 완만한 변화, 낮은 기울기
- 값 변화:
-
고주파 성분
- 값 변화:
10 → 3 → 10 - 특징: 아주 짧은 거리에서 급격한 변화, 높은 기울기
- 값 변화:
이처럼 공간적으로 빠르게 요동치는 변화율을 수학적으로 분석하면,
푸리에 변환(Fourier Transform)에서 짧은 주기의 파동, 즉 High Frequency 성분이 강하게 나타납니다.
👉 그래서 “형상 변화율이 급격하다” = “고주파 성분이 많다”는 말이 성립합니다.
2. 왜 딥러닝은 High Frequency를 잘 못 배울까?
— Spectral Bias의 정체
2.1 Spectral Bias란?
Spectral Bias는 신경망이 학습할 때 가지는 고유한 성향입니다.
👉 “저주파 성분은 빠르게 학습하고,
👉 고주파 성분은 매우 느리게 학습한다”
특히 ReLU 기반 MLP나 일반적인 CNN 계열에서 이 현상이 뚜렷하게 나타납니다.
2.2 학습 과정에서 실제로 일어나는 일
학습 중 loss 곡선을 떠올려 보면 다음과 같은 패턴을 자주 보게 됩니다.
-
초기 단계
- Loss가 급격히 감소
- 전체적인 형태, 큰 구조가 빠르게 맞춰짐
- → 저주파 학습
-
후기 단계
- Loss 감소가 거의 멈춤
- 세부 구조는 여전히 부정확
- → 고주파 학습 정체
이유는 단순합니다.
- 고주파 영역의 오차는 전체 MSE나 L2 loss에서 차지하는 비중이 작음
- 네트워크 입장에서는
“이미 대부분 맞았는데?”라고 판단 - 그 결과 학습이 수렴해 버림 (Early Convergence)
이것이 바로 Over-smoothing의 근본 원인입니다.
2.3 비유로 이해하는 Spectral Bias
Spectral Bias는 마치 화가의 작업 순서와 같습니다.
- 넓은 붓으로 전체 윤곽을 먼저 그림 (빠름)
- 가는 붓으로 미세한 디테일을 그림 (느림)
문제는 신경망이 2번 단계로 잘 넘어가지 않으려 한다는 것입니다.
3. High Frequency를 구현하는 핵심 전략
그렇다면 해결책은 무엇일까요?
핵심은 단 하나입니다.
“입력 공간의 미세한 변화를 특징 공간에서는 큰 변화로 보이게 만들 것”
이를 위해 사용되는 대표적인 기법들을 정리합니다.
3.1 Positional Encoding (Fourier Feature Mapping)
3.1.1 기본 아이디어
좌표 (x, y, z)를 그대로 네트워크에 넣으면,
서로 가까운 좌표는 거의 동일한 입력으로 인식됩니다.
이를 방지하기 위해 좌표를 고주파 사인·코사인 함수로 변환합니다.
3.1.2 왜 효과적인가? (민감도 증폭)
- 입력 좌표 차이:
0.0001 - 변환 후 특징 차이: 0 → 0.3 이상
👉 아주 작은 공간적 차이가
👉 완전히 다른 feature vector로 바뀜
이로 인해 네트워크는
“여기는 전혀 다른 위치다”라고 강하게 인식하게 됩니다.
3.1.3 구현 시 튜닝 포인트
-
Frequency Band 수 (L)
- L ↑ → 더 높은 주파수 표현 가능
-
Scale 계수
- 너무 크면 노이즈 증가
- 너무 작으면 효과 미미
실무에서는
L을 점진적으로 늘려가며 안정성과 디테일의 균형을 맞추는 방식이 효과적입니다.
3.2 Representation 자체를 고주파 친화적으로 바꾸기
3.2.1 Neural Feature Grid / Hash Grid
- 공간을 격자로 나누고
- 각 격자에 feature vector 저장
- MLP는 보간된 feature만 처리
👉 국소적인 변화는 Grid가 담당
👉 MLP는 복잡한 함수를 외울 필요가 없음
결과적으로 Local detail 표현력이 크게 향상됩니다.
3.2.2 Multi-resolution / Hierarchical 구조
- 저해상도: 전체 구조
- 고해상도: 국소 영역
이렇게 주파수 대역을 분리하면
Spectral Bias의 영향을 크게 줄일 수 있습니다.
3.3 Loss 설계로 High Frequency를 강조하기
단순 L1 / L2 loss는 고주파에 불리합니다.
다음과 같은 보조 손실이 효과적입니다.
-
Gradient-based Loss
- 값 자체보다 변화율에 집중
-
Normal / Direction Loss
- 급격한 방향 변화 강조
-
Curvature / Laplacian Loss
- 국소 곡률이 큰 영역에 가중치 부여
👉 핵심은
“값이 아니라 변화 자체를 학습 목표로 포함시키는 것”
4. 정리 (핵심 요약)
- High Frequency
→ 짧은 거리에서 값이 급격히 변하는 성분- Spectral Bias
→ 신경망이 저주파를 먼저, 더 쉽게 학습하는 성향- 문제의 본질
→ 고주파 오차는 loss에서 무시되기 쉬움- 해결 전략
- Positional Encoding으로 입력 민감도 증폭
- Grid / Multi-resolution 표현 사용
- 변화율 중심의 Loss 설계
한 문장으로 요약하면
딥러닝이 미세한 구조를 못 만드는 이유는 능력이 부족해서가 아니라, 애초에 “그게 중요하다고 느끼지 못하기 때문”입니다. High Frequency는 반드시 의도적으로 보이게 만들어줘야 합니다.