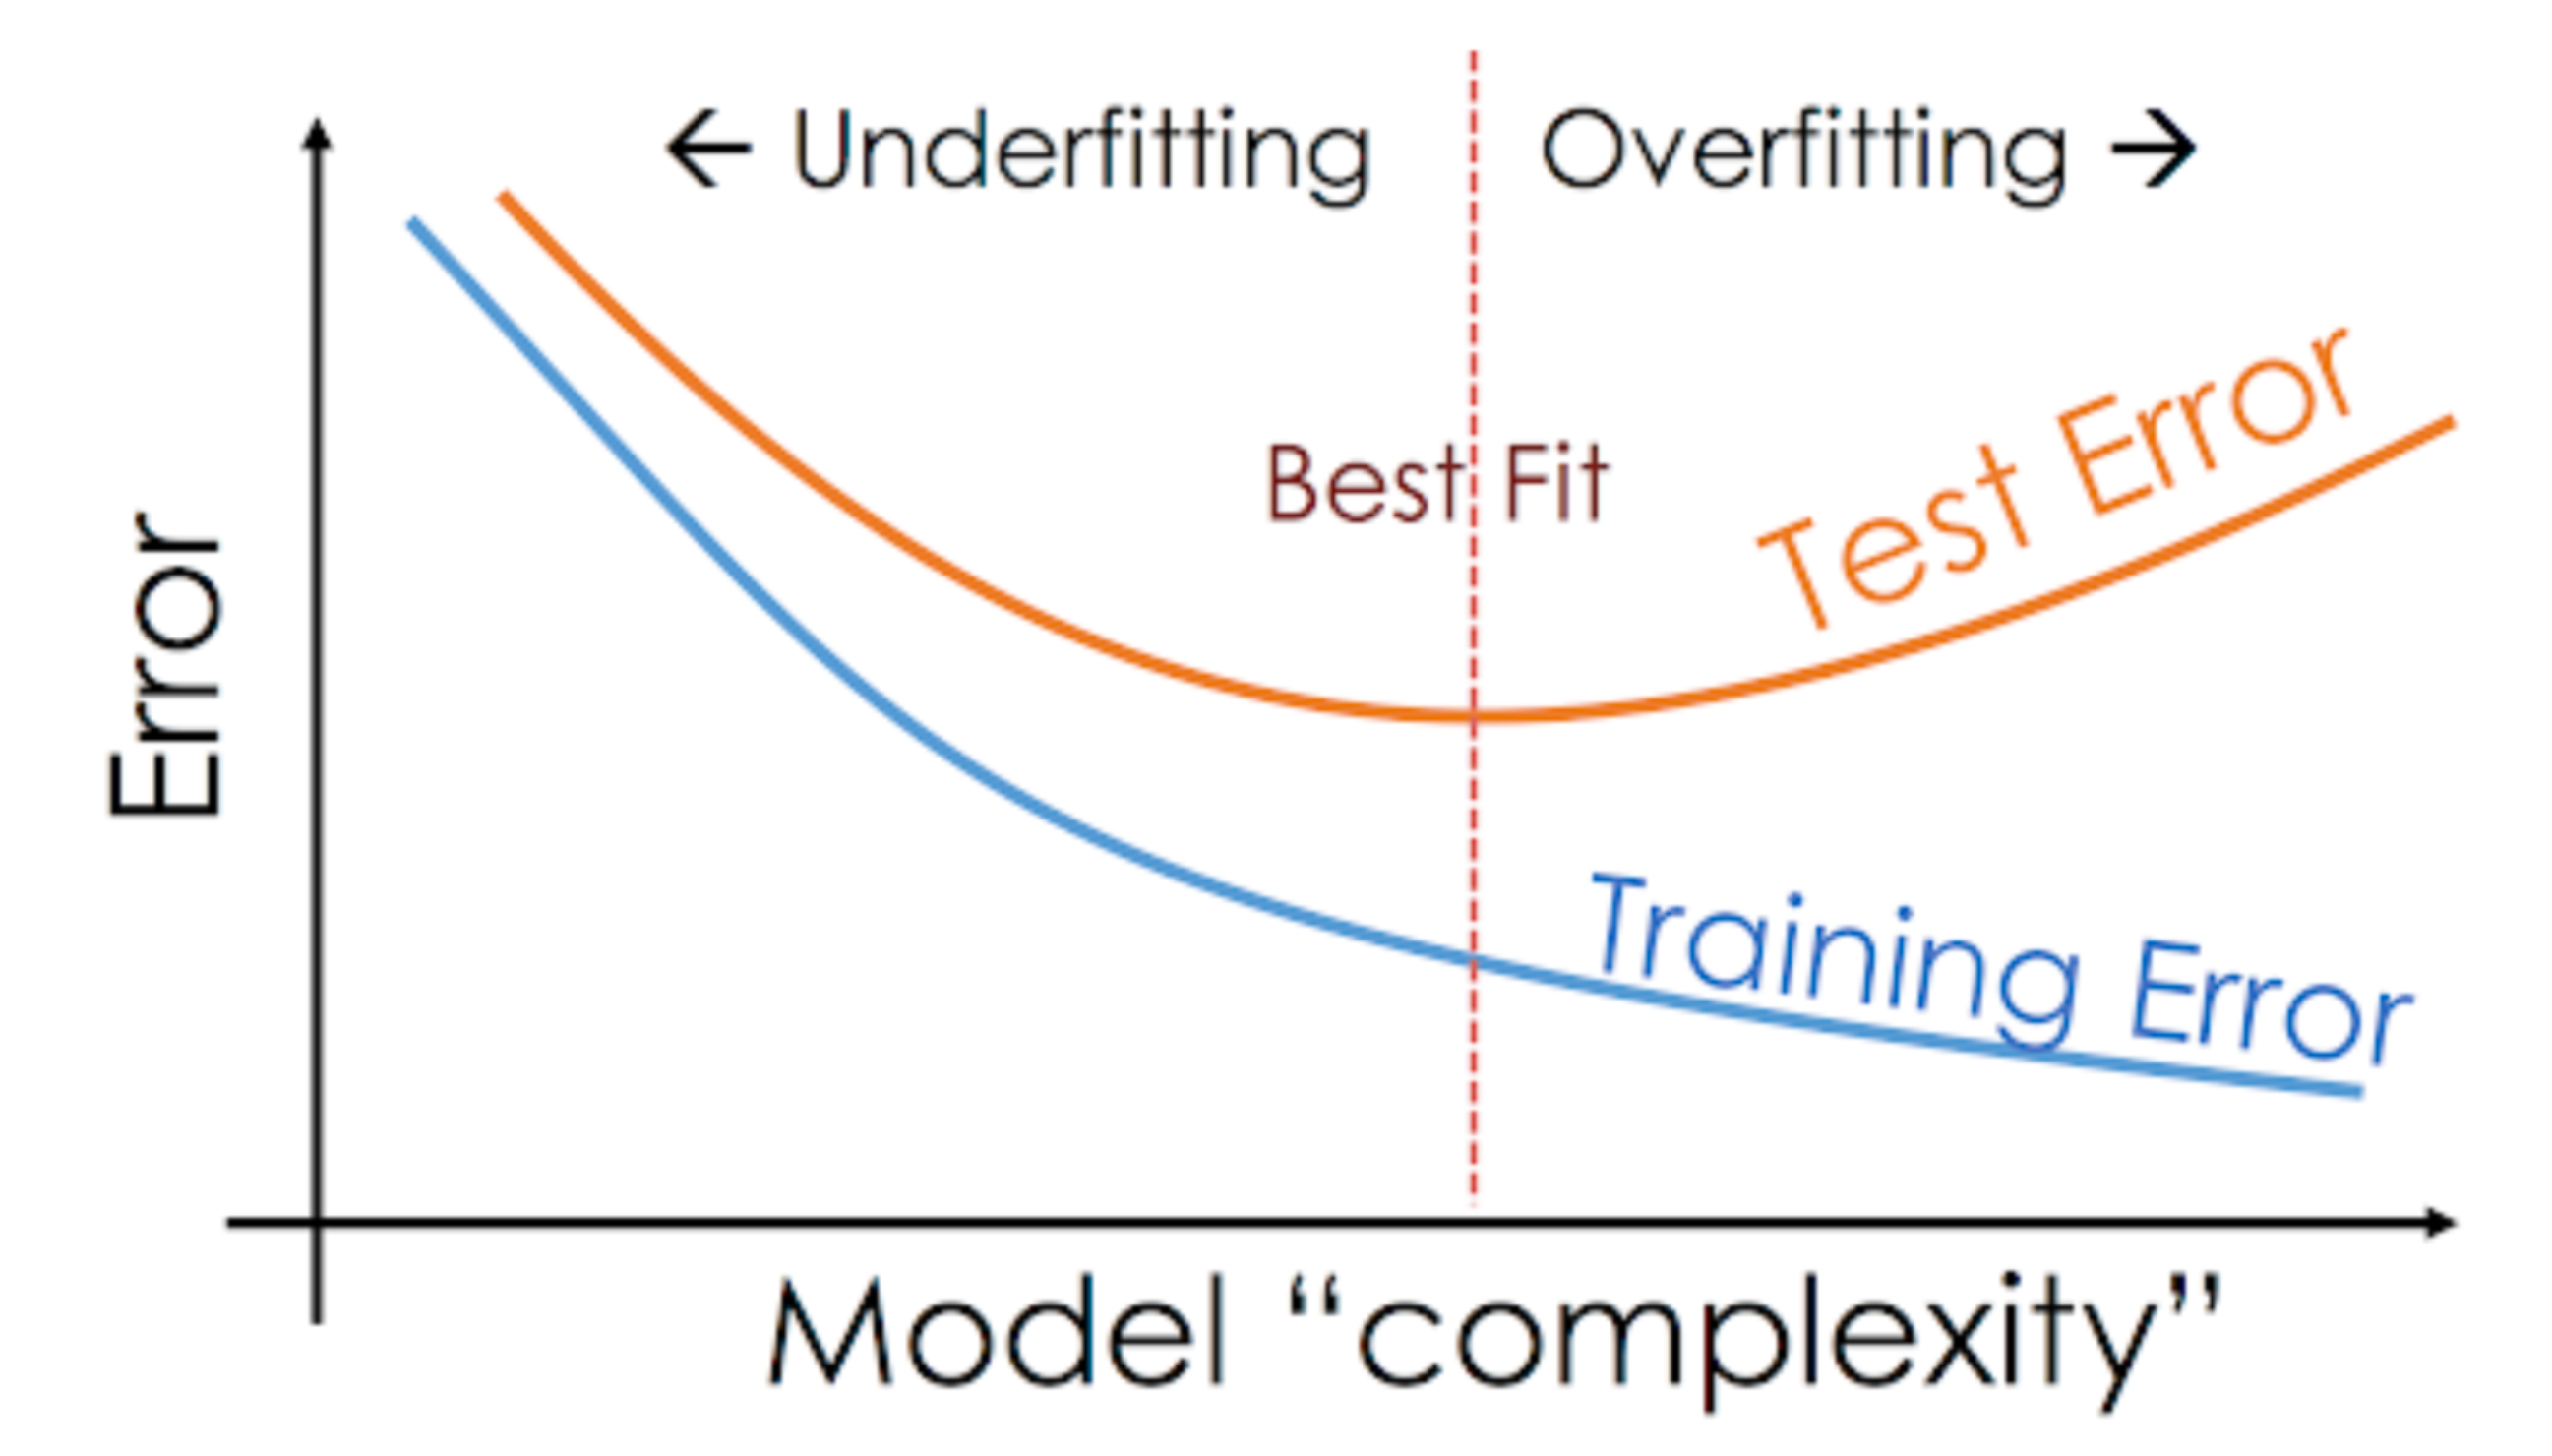
딥러닝 모델을 학습시키다 보면 누구나 한 번쯤 'U자형 곡선의 저주'를 만납니다. Training Loss는 바닥을 향해 예쁘게 내려가는데, 어느 순간 Validation Loss가 고개를 치켜들며 우상향하는 현상이죠. 보통 우리는 이를 '과적합(Overfitting)'이라 부르며 실패의 신호로 여깁니다.
하지만 생성형 모델(Generative Model)의 세계에서는 조금 다른 해석이 필요합니다. 특히 학습 데이터가 부족한 상황이라면 더욱 그렇습니다. 오늘은 수치상의 '골든 타임'과 실제 결과물의 '품질' 사이에서 어떤 결정을 내려야 하는지, 그리고 데이터 부족을 어떻게 극복할지 공유하고자 합니다.
1. 왜 Validation Loss는 요동치고 우상향할까요?
가장 큰 원인은 데이터의 절대량 부족과 평가 지표의 한계에 있습니다.
- 통계적 노이즈 (의 한계): 검증 데이터셋의 규모가 작을 경우(예: ), 모델이 단 한두 개의 까다로운 케이스에서 미세한 오차만 내도 전체 평균 손실 값은 폭발적으로 튑니다. 이는 모델이 망가진 것이 아니라 통계적인 '착시'일 확률이 높습니다.
- 모델의 암기 본능: 학습 데이터가 모델의 표현력(Capacity)에 비해 적으면, 모델은 규칙을 배우는 대신 데이터를 '통째로 암기'하기 시작합니다. 이때부터 Training Loss는 0에 수렴하지만, 처음 보는 데이터에 대한 유연성(Generalization)은 떨어지게 됩니다.
2. MSE의 함정: "뭉툭한 정답" vs "날카로운 오답"
생성형 모델에서 자주 쓰이는 등의 손실 함수는 모든 픽셀이나 좌표의 오차를 산술적으로 계산합니다. 여기서 '수치적 정답'과 '시각적 완성도'의 괴리가 발생합니다.
- 학습 초반: 모델은 안전한 선택을 합니다. 평균적인 형태를 만들어 오차를 최소화하죠. 수치상 는 낮지만, 결과물은 디테일이 뭉개진 '사용 불가능한 결과물'이 나오기 쉽습니다.
- 학습 후반: 모델이 세부적인 특징과 질감을 묘사하기 시작합니다. 이때 미세한 위치 차이만 발생해도 수치상 오차는 커집니다. 하지만 사용자 입장에서는 훨씬 선명하고 '완성도 높은 결과물'이 됩니다.
3. 모든 모델에 해당되는 이야기인가요?
아니요, 하지만 생성형 모델에서 가장 두드러집니다. 모델의 성격에 따라 를 해석하는 기준은 달라져야 합니다.
- 생성형 모델 (Generative): "자연스러운 형태"라는 정답지는 수만 가지가 존재할 수 있습니다. 고정된 정답과의 거리를 재는 함수가 한계를 보이기 때문에 정성 평가가 필수적입니다.
- 판별형 모델 (Discriminative): 분류나 검출 모델은 수치가 훨씬 정확합니다. 고양이를 개로 판단할 확률이 올라간다면 그것은 명백한 성능 저하입니다. 이 경우 가 튀면 대개 '진짜 과적합'입니다.
- 회귀 모델 (Regression): 가격 예측처럼 수치 자체가 목표인 경우, 수치적 수렴이 곧 성능과 직결됩니다.
즉, 출력물의 '형태'나 '질감'이 중요한 도메인일수록 수치보다 눈을 믿어야 하는 순간이 빨리 옵니다.
4. 데이터가 부족할 때의 합리적인 대처법
데이터가 적을 때 의 우상향을 방지하고 성능을 끌어올리는 실전 전략들을 소개합니다.
① 데이터 증강 (Data Augmentation)의 고도화
단순히 데이터를 뒤집는 것을 넘어, 도메인 특화 증강 기법을 사용해야 합니다.
- Geometric Augmentation: 회전, 크기 조절, 아핀 변환 등을 통해 모델이 형태의 본질을 배우게 합니다.
- Noise Injection: 입력 데이터에 인위적인 노이즈를 섞어 모델이 데이터 하나하나를 외우지 못하게 방해합니다.
② 전이 학습 (Transfer Learning) 활용
데이터가 적다면 모델을 처음부터() 가르치지 마세요. 유사한 대규모 데이터셋으로 먼저 학습된 가중치(Pre-trained weights)를 가져와 내 데이터로 미세 조정(Fine-tuning)만 진행하는 것이 훨씬 안정적입니다.
③ 모델 복잡도 낮추기 (Model Capacity Control)
데이터가 600개인데 모델 파라미터가 30M개가 넘는다면, 이는 초등학생에게 전공 서적을 외우라고 하는 것과 같습니다. 모델의 채널() 수를 줄이거나 레이어를 얕게 쌓아 모델을 '더 멍청하게' 만드세요. 그러면 오히려 데이터를 외우지 못하고 규칙을 배우기 시작합니다.
④ 강력한 정규화 (Regularization) 도입
- Dropout / Weight Decay: 특정 뉴런에만 의존하거나 가중치가 비정상적으로 커지는 것을 막습니다.
- Early Stopping: 가 최저점을 찍고 일정 기간 이상 개선되지 않으면 학습을 강제 종료합니다.
결론: 숫자는 가이드일 뿐, 본질은 결과물이다
딥러닝의 목표는 '로그 파일의 숫자를 줄이는 것'이 아니라, '실제 문제를 해결하는 결과물을 만드는 것'입니다. 실제로 많은 시니어 엔지니어들이 모델 배포 직전에는 그래프보다 'Inference 결과물 샘플 100개'를 더 꼼꼼히 살핍니다.
데이터가 부족할수록 수치라는 숫자의 감옥에 갇히지 마세요. 도메인 전문가의 시각과 정성적인 평가 시스템을 구축하는 것, 그것이 수만 줄의 로그 데이터보다 훨씬 강력한 성능의 증거가 될 것입니다.