DiT(Diffusion Models with Transformers) 논문을 읽다 보면 이런 문장이 등장합니다. "우리는 학습률(Learning Rate)을 튜닝하지도, 웜업(Warm-up)이나 감소(Decay) 스케줄을 쓰지도 않고 그냥 고정해서 썼다!" 이 대목에서 "어? 보통 학습률은 스케줄러를 써서 조절하는 게 국룰 아니었나?"라는 의문이 드셨다면, 여러분은 이미 딥러닝의 핵심을 꿰뚫어 보는 날카로운 통찰력을 가지신 겁니다.
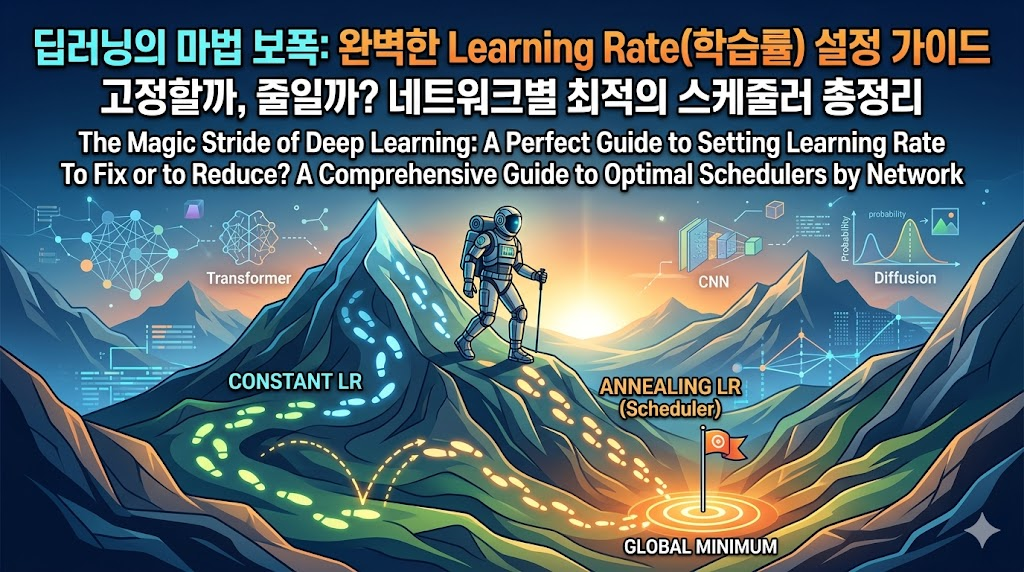
딥러닝 모델의 학습 과정을 산골짜기에서 가장 낮은 지점(최소 Loss)을 찾아 내려가는 등산객에 비유해 보겠습니다. 여기서 학습률(Learning Rate)은 바로 '등산객의 보폭'입니다. 이 보폭을 끝까지 똑같이 유지할지, 아니면 상황에 맞게 줄여나갈지에 대한 장단점과, 네트워크별 실전 가이드를 아주 명확하게 정리해 드립니다!
1. 학습률 고정 (Constant Learning Rate)
처음 설정한 보폭(예: )을 학습이 끝날 때까지 뚝심 있게 똑같이 유지하는 방식입니다.
- 장점 (단순함의 미학): 하이퍼파라미터를 세팅하느라 머리를 쥐어뜯을 필요가 없습니다. 딱 하나의 숫자만 잘 찾으면 끝입니다. 또한, Adam이나 AdamW 같은 적응형 옵티마이저(Optimizer)는 이미 내부적으로 파라미터마다 보폭을 스스로 조절하는 기능이 있어, 큰 틀의 학습률만 고정해 주어도 웬만큼 길을 잘 찾아갑니다.
- 단점 (최적점 언저리 맴돌기): 산골짜기 맨 밑바닥(Global Minimum)에 거의 다 왔는데 보폭이 너무 크면 어떻게 될까요? 바닥에 사뿐히 안착하지 못하고 좌우 경사면을 계속 왔다 갔다 튕기며(Overshooting) 학습이 끝나버릴 수 있습니다. 영혼을 끌어모은 최상의 성능을 뽑아내기는 다소 힘듭니다.
2. 학습률 감소 (Learning Rate Annealing / Scheduling)
학습 초반에는 큰 보폭으로 성큼성큼 내려가고, 목표 지점에 가까워질수록 보폭을 쫑쫑걸음으로 줄여나가는 방식입니다. 금속을 서서히 식혀 단단하게 만드는 '풀림(Annealing)' 공정에서 따온 개념입니다.
- 장점 (영혼까지 끌어모은 성능): 초반에는 지역 최솟값(Local Minima) 구덩이에 빠져도 큼직한 보폭으로 훌쩍 뛰어넘어 탈출할 수 있습니다. 후반부에는 아주 미세한 보폭으로 바닥의 정중앙에 완벽하게 안착하죠. 모델의 최종 성능(SOTA)을 쥐어짜 내는 데 필수적인 기법입니다.
- 단점 (하이퍼파라미터 지옥): "언제부터 줄일까?", "얼마나 확 줄일까?", "어떤 그래프 모양(계단식, 선형, 코사인)으로 줄일까?" 등 사람이 직접 실험해 보고 결정해야 할 골칫거리가 기하급수적으로 늘어납니다.
3. 실전! 네트워크별 완벽한 LR 스케줄러 가이드
그렇다면 내 모델에는 어떤 방식을 써야 할까요? 현업과 학계에서 수많은 실험을 통해 증명된 '국룰(Standard Practice)' 세팅법을 공개합니다.
① 트랜스포머 기반: NLP (GPT, BERT) & Vision (ViT)
- 추천 세팅: Warm-up + Cosine Annealing (웜업 후 코사인 감소)
- 이유: 트랜스포머는 초반 학습이 굉장히 불안정하기로 악명이 높습니다. 시작하자마자 보폭을 크게 가져가면 기울기 폭발(Gradient Explosion)이 일어나 모델이 망가집니다.
- 방법: 처음 5~10%의 기간 동안은 학습률을 0에서부터 목표치까지 아주 천천히 올립니다(Warm-up). 모델이 어느 정도 적응하면, 남은 기간 동안 코사인 곡선()을 그리며 부드럽게 0을 향해 학습률을 떨어뜨립니다.
② CNN 기반: 이미지 분류 (ResNet, EfficientNet)
- 추천 세팅: Step Decay (계단식 감소) 또는 Cosine Annealing
- 이유: 이미지 분류 문제는 Loss 공간이 비교적 예쁘게 생겼습니다. 특정 에포크(Epoch)마다 학습률을 팍팍 깎아주는 것이 매우 효과적입니다.
- 방법: "전체 100 에포크 중 30, 60, 90 에포크에 도달할 때마다 학습률을 로 토막 내라!"라고 설정합니다. 이때마다 성능(Accuracy) 그래프가 계단처럼 껑충껑충 뛰는 짜릿한 쾌감을 볼 수 있습니다.
③ 확산 모델 (Diffusion Models: DDPM, DiT 등)
- 추천 세팅: Constant LR (학습률 고정) + EMA (지수 이동 평균)
- 이유: 확산 모델은 한 장의 이미지를 볼 때마다 타임스텝이 계속 무작위로 바뀝니다. 즉, 타겟이 계속 움직이는 과녁을 맞히는 것과 같아 Loss가 심하게 요동칩니다. 여기서 학습률까지 요동치면 학습이 오히려 방해를 받습니다.
- 방법: AdamW를 쓰고 같은 고정 학습률을 쭉 밀고 나갑니다. 대신 통통 튀는 파라미터들을 잠재우기 위해, 과거 가중치들의 평균을 부드럽게 내는 EMA 모델을 따로 저장해 두어 최종 결과물로 사용합니다.
④ 파인튜닝 (Fine-tuning / Transfer Learning)
- 추천 세팅: 매우 작은 Constant LR 또는 Linear Decay (선형 감소)
- 이유: 이미 수많은 데이터로 똑똑하게 학습된 거대 모델(Pre-trained model)의 지식을 망가뜨리지 않고, 내 데이터에 맞게 살짝만 깎아내는 정교한 과정이기 때문입니다.
- 방법: 기존 학습률의 ~ 수준으로 아주 작게 시작해서 일정하게 유지하거나 0으로 천천히 빼줍니다.
| 네트워크 및 태스크 | 추천 스케줄러 | 선정 이유 (핵심) | 적용 방법 (핵심) |
|---|---|---|---|
| 트랜스포머 (Transformer) (NLP, Vision) | Warm-up + Cosine Annealing | 초기 학습 불안정 및 기울기 폭발 방지 | 0에서 천천히 증가(Warm-up) 후, 코사인 곡선 따라 부드럽게 감소 |
| CNN 기반 (이미지 분류) | Step Decay 또는 Cosine Annealing | Loss 공간이 비교적 규칙적, 주기적 감소가 효과적 | 특정 에포크 도달 시 학습률을 비율(예: 1/10)로 대폭 삭감 |
| 확산 모델 (Diffusion) (DDPM, DiT 등) | Constant LR (고정) + EMA (이동 평균) | 무작위 타임스텝으로 타겟 변동, 학습률까지 변하면 학습 저해 | 고정 학습률(예: 1e-4) 쭉 유지, 과거 가중치 평균(EMA)을 최종 적용 |
| 파인튜닝 (Fine-tuning) (전이 학습) | 매우 작은 Constant LR 또는 Linear Decay | 사전 학습된 기존 지식 보존 및 데이터에 맞춘 미세 조정 | 기존 학습률의 1/10 ~ 1/100 수준으로 작게 시작하여 유지/감소 |
💡 보너스 인사이트: DiT 논문 저자들의 자신감은 어디서 왔을까?
앞서 일반적인 트랜스포머 모델은 '웜업(Warm-up)'이 필수라고 말씀드렸습니다. 그런데 왜 DiT 저자들은 "우리는 웜업도 안 쓰고 학습률 고정했는데 아주 스무스하게 학습 잘 되더라!"라고 논문에 당당히 적을 수 있었을까요?
그 비밀은 바로 DiT 구조에 적용된 'adaLN-Zero' 초기화 마법 덕분입니다. 학습 시작 시점에 신경망 블록을 완벽한 항등 함수(0)로 묶어두었기 때문에, 초반에 큰 학습률을 때려 박아도 트랜스포머 특유의 기울기 폭발이 일어나지 않고 아주 안정적으로 학습을 시작할 수 있었던 것입니다.
결국 "학습률을 튜닝하지 않아도 된다"는 이 엄청난 장점 하나를 얻기 위해, 전체 아키텍처와 초기화 기법이 아주 치밀하게 계획되어 있었던 셈입니다. 딥러닝 아키텍처의 세계, 알면 알수록 정말 경이롭지 않나요?