0. Hardware Prefetching
No need for programmer or compiler intervention
No changes to existing executables
Take advantage of run-time information
앞 글의 프리페칭은 프로그래머나 컴파일러가 "이거 미리 가져와" 하고 코드에 넣는 방식이었어요. 하드웨어 프리페칭은 CPU가 실행 중에 메모리 접근 패턴을 지켜보다가 알아서 미리 가져오는 방식이에요.
프로그램을 고칠 필요가 없어요. 이미 만들어진 실행 파일도 그대로 빨라져요.
실행 중에 실제로 일어나는 일을 보고 예측해요.
Major design questions
- What to prefetch?
» Next sequential cache line(s), strided patterns, … - When to prefetch?
» On an access (prefetch always), on a miss (prefetch on miss), when other prefetched data used (tagged prefetch) - Where to place prefetched data
» In the cache or in a special prefetch buffer - How to handle VM exceptions?
» Don’t prefetch beyond a page
Tagged prefetch: 미리 가져온 블록에 표시(tag)를 해 둬요. 그 블록이 처음 쓰이는 순간 "이 예측이 맞았네" 하고 다음 블록을 가져와요. 실제로 쓰이는 속도에 맞춰 한 발씩 앞서가는 방식이에요.
페이지를 넘지 않는 이유: 가상 메모리에서 바로 다음 페이지가 실제 메모리에서도 옆에 있다는 보장이 없어요. 아예 할당이 안 돼 있을 수도 있어요. 함부로 넘어가면 엉뚱한 데이터를 가져오거나 페이지 폴트를 일으킬 수 있어요.
1. Simple Sequential Prefetching
미스가 나면 그 다음 블록 하나도 같이 가져와요.
- On a cache miss, fetch one sequential memory block
- Exploits spatial locality in both instructions & data - Mimic behavior of larger cache line size without really do it
- Extend to fetching N sequential memory blocks
- Fixed vs. dynamic number of blocks for prefetching
블록 A에서 미스 → A를 가져오면서 A+1도 미리 가져옴
→ 프로그램이 A+1을 쓸 때 이미 와 있음 (미스 없음)
효과는 블록 크기를 키운 것과 비슷해요. 하지만 실제 블록 크기는 그대로라서, 큰 블록의 단점(블록 개수가 줄어드는 것)은 없어요.
인텔은 이걸 “Adjacent Cache Line Prefetch”라고 불러요.
한 번에 N개를 가져오도록 늘릴 수도 있어요. N은 고정일 수도 있고, 상황에 따라 바뀔 수도 있어요.
Pros:
- No changes to executables
- Simple hardware
Cons:
- Only applies for good spatial locality
- Works poorly for nonsequential accesses
- Unnecessary prefetches for array accesses with large stride
2. Stream Prefetching
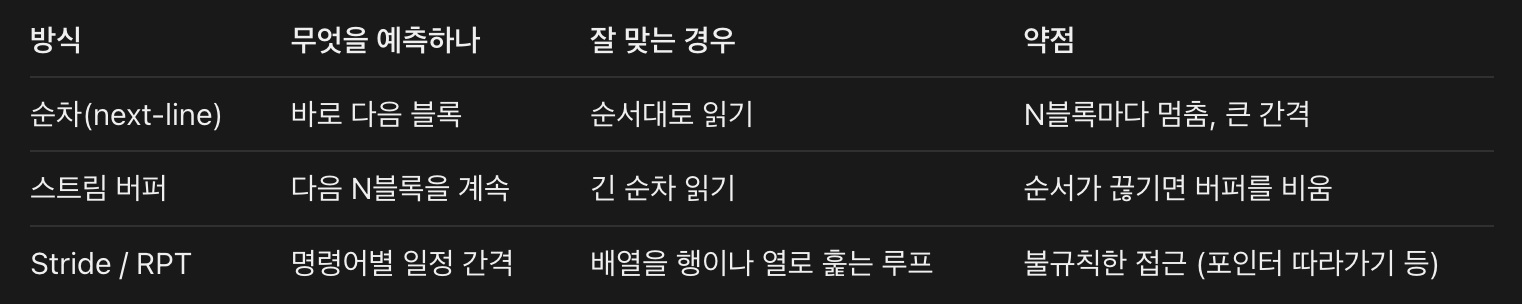
문제: 미스가 났을 때 N개를 한꺼번에 가져오면, N개를 다 쓰고 나서 또 미스가 나요. N블록마다 한 번씩 멈추는 셈이에요.
해결: 미리 가져온 블록이 하나 쓰일 때마다 하나를 더 가져와서, 항상 N개 앞서 있게 해요. 이걸 위한 별도 공간이 스트림 버퍼예요.
Sequential prefetching problem
- Performance slows down once every N cache lines
Stream prefetching is a continuous version of prefetching
- Stream buffer can fit N cache lines
- On a miss, start fetching N sequential cache lines
- On a stream buffer hit: Move cache line to cache, start fetching line (N+1) In other words, stream buffer tries to stay N cache lines ahead
Design issues
- When is a stream buffer allocated
- When is a stream buffer released
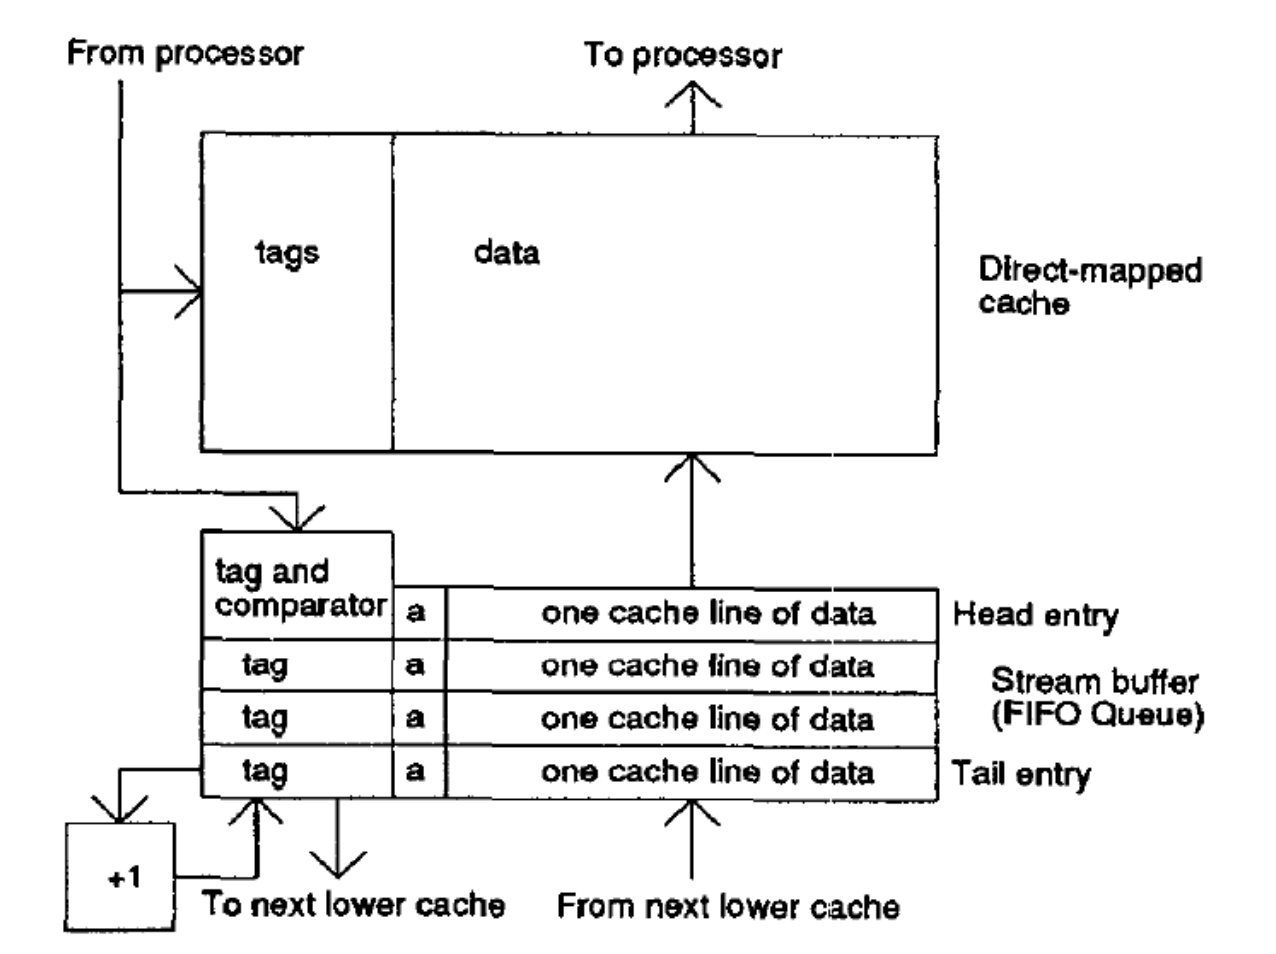
동작 예시 (N = 4)
① A에서 캐시 미스
   → A는 캐시로, A+1 ~ A+4는 스트림 버퍼로 가져오기 시작
   스트림 버퍼: [A+1][A+2][A+3][A+4]   (도착 전엔 "아직 안 옴" 표시)

② 프로그램이 A+1 요청 → 캐시엔 없지만 스트림 버퍼에 있음!
   → 1사이클 만에 캐시로 옮김, 나머지 한 칸씩 앞으로, 빈자리에 A+5 가져오기
   스트림 버퍼: [A+2][A+3][A+4][A+5]

③ A+2 요청 → 또 버퍼에서 → [A+3][A+4][A+5][A+6]  ... 계속 4개 앞서감

④ 갑자기 전혀 다른 주소 Z에서 미스 (순서가 끊김)
   → 버퍼를 비우고 Z부터 다시 시작: [Z+1][Z+2][Z+3][Z+4]
왜 캐시가 아니라 별도 버퍼에 넣을까? 예측이 틀리면 쓸데없는 데이터가 캐시의 좋은 데이터를 밀어내요(캐시 오염). 버퍼에 두면 실제로 쓰일 때만 캐시로 들어가니 안전해요.
각 칸에는 "데이터 도착함/아직" 표시(available bit)가 있어요. 요청한 블록이 아직 오는 중이면 기다려요.
비유: 회전초밥 레일에 다음 접시 4개를 항상 올려 두는 것. 하나 집으면 하나를 새로 올려요. 손님이 갑자기 다른 메뉴를 시키면 레일을 비우고 새 메뉴로 채워요.
3. Prefetching with Arbitrary Strides
마지막 단점을 해결하는 방법이에요. 루프에서는 같은 명령어가 매번 일정한 간격으로 떨어진 주소를 읽는 경우가 많아요.
같은 명령어가 읽은 주소: 1000 → 1400 → 1800 → 2200 ...
(+400) (+400) (+400) ← 간격 D = 400- Employ special logic to monitor the processor’s address referencing pattern
- Detect constant stride array references originating from looping structures
- Compare successive addresses used by load or store instructions
동작 원리
명령어 mi가 반복할 때마다 주소 a1, a2, a3…를 읽는다고 해요.
- a1, a2를 보고 간격 D = a2 − a1을 계산해요. D가 0이 아니면 프리페치를 시작해요.
- 다음 주소를 a3 = a2 + D로 예측하고 미리 가져와요.
- 예측이 계속 맞으면 a4 = a3 + D, … 이렇게 이어가요. 예측이 틀리면 멈춰요.
순차 프리페칭과의 차이: 순차는 "바로 옆"만 가져오지만, stride는 얼마나 건너뛰는지 학습해서 정확히 그 위치를 가져와요.
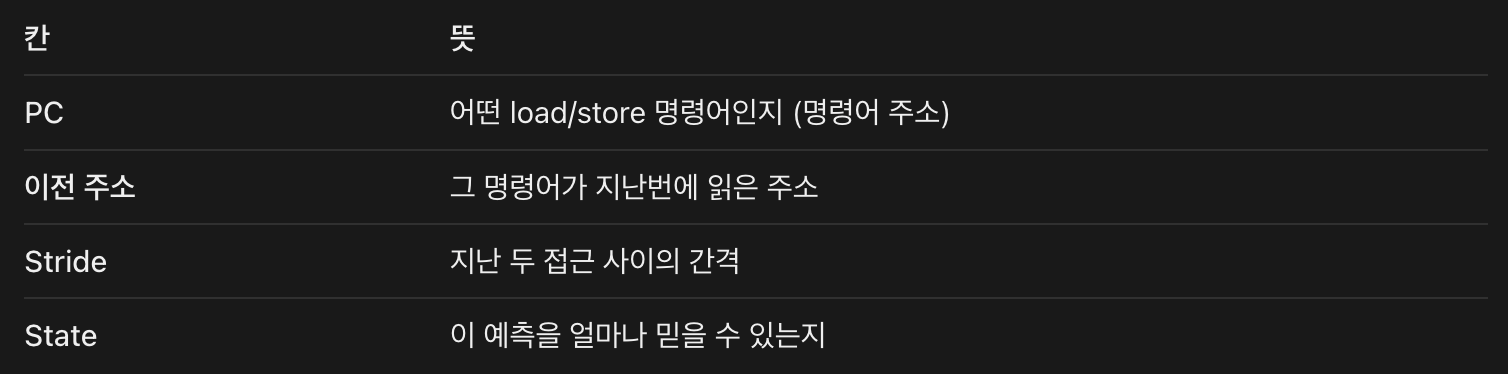
4. Reference Prediction Table (RPT)
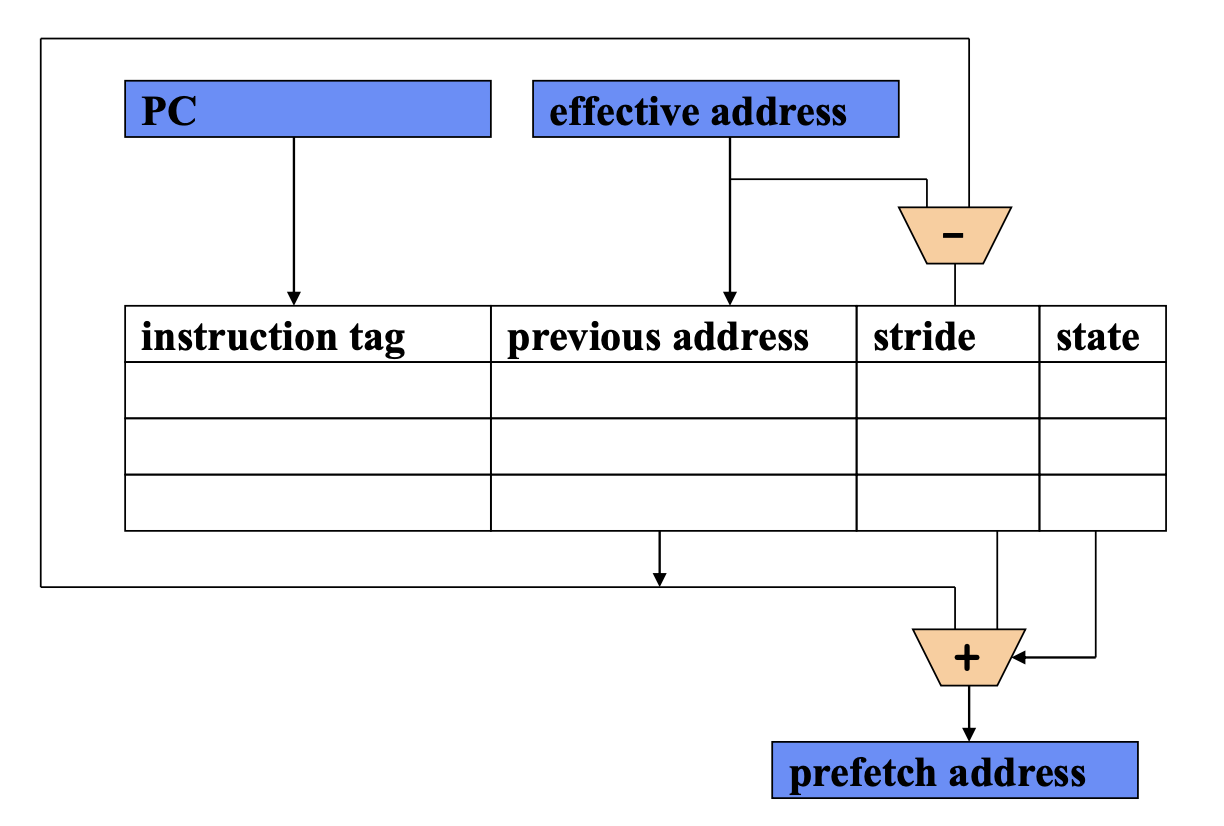
stride 프리페칭을 실제로 구현하는 표예요. 명령어마다 한 줄씩, 그 명령어의 접근 패턴을 기록해요.
Hold information for the most recently used memory instructions to predict their access pattern
- Address of the memory instruction
- Previous address accessed by the instruction
- Stride value
- State field
Organization of RPT
it's not in the Final test
but it's used alot in industry
Example
float a[100][100], b[100][100], c[100][100];
	for (i = 0; i < 100; i++)
		for (j = 0; j < 100; j++)
			for (k = 0; k < 100; k++)
				a[i][j] += b[i][k] * c[k][j]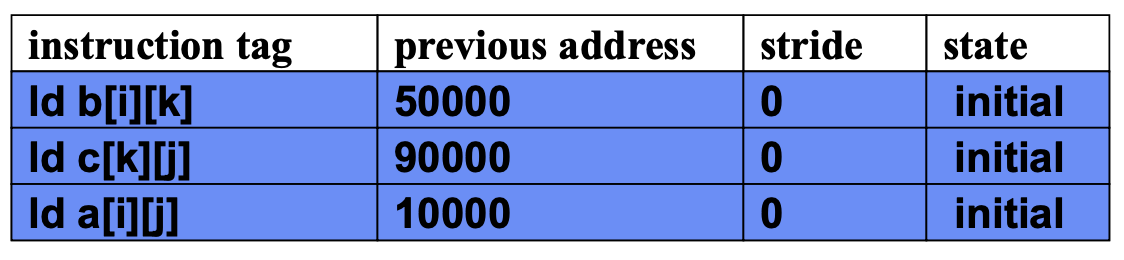
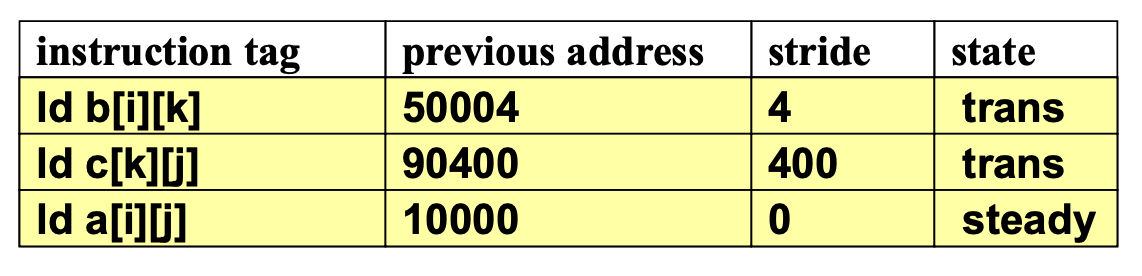
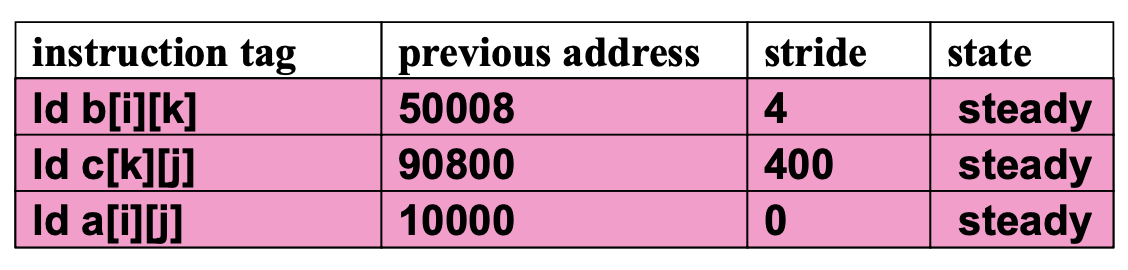
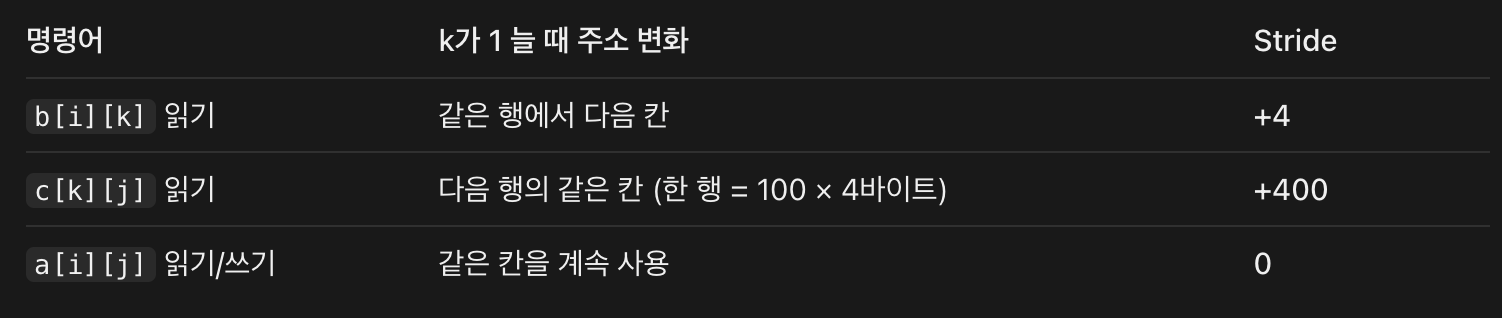
예를 들어 b가 주소 50000, c가 90000, a가 10000에서 시작한다고 하면 RPT는 이렇게 변해요.
1회차: b: 이전=50000  stride=0    initial     (처음 봄)
       c: 이전=90000  stride=0    initial
       a: 이전=10000  stride=0    initial

2회차: b: 이전=50004  stride=4    transient   (간격 4 발견, 확인 중)
       c: 이전=90400  stride=400  transient   (간격 400 발견)
       a: 이전=10000  stride=0    steady      (같은 주소 → 간격 0이 맞음)

3회차: b: 이전=50008  stride=4    steady  → 50012 미리 가져옴
       c: 이전=90800  stride=400  steady  → 91200 미리 가져옴
핵심은 명령어(PC)별로 따로 기록한다는 점이에요. 그래서 b, c처럼 간격이 서로 다른 접근이 섞여 있어도 각각 정확히 예측할 수 있어요.
Software Prefetching
for (i=0; i<N; i++) {
	prefetch(a[i+8]); // 8번 뒤에 쓸 a를 지금 미리 요청
	prefetch(b[i+8]); // b도 마찬가지
	sum += a[i]*b[i]; // 지금 계산은 이미 와 있는 데이터로
}

Doesn’t have to be correct!
prefetch(N+8);
프로그래머나 컴파일러가 “8번 뒤에 쓸 데이터를 지금 가져와 둬” 라고 코드에 직접 넣는 방식이에요. 앞 글의 하드웨어 프리페칭과 반대예요.
왜 8번 뒤일까? 메모리에서 데이터가 오는 데 시간이 걸리니까, 그 시간 동안 루프가 몇 번 돌지 계산해서 정해요. 지금 요청하면 8번 돌고 나서 도착하는 셈이라, 그때 쓸 데이터를 지금 요청하는 거예요.
“Doesn’t have to be correct!”의 의미
루프 끝부분에서는 a[N+7]처럼 배열 범위를 벗어난 주소를 프리페치해요. 그래도 괜찮아요. 프리페치는 "가능하면 가져와 줘"라는 힌트일 뿐이라서, 틀려도 결과는 바뀌지 않고 대역폭만 조금 낭비돼요. 일반 load였다면 프로그램이 죽을 수도 있는 주소예요.
Data Prefetch
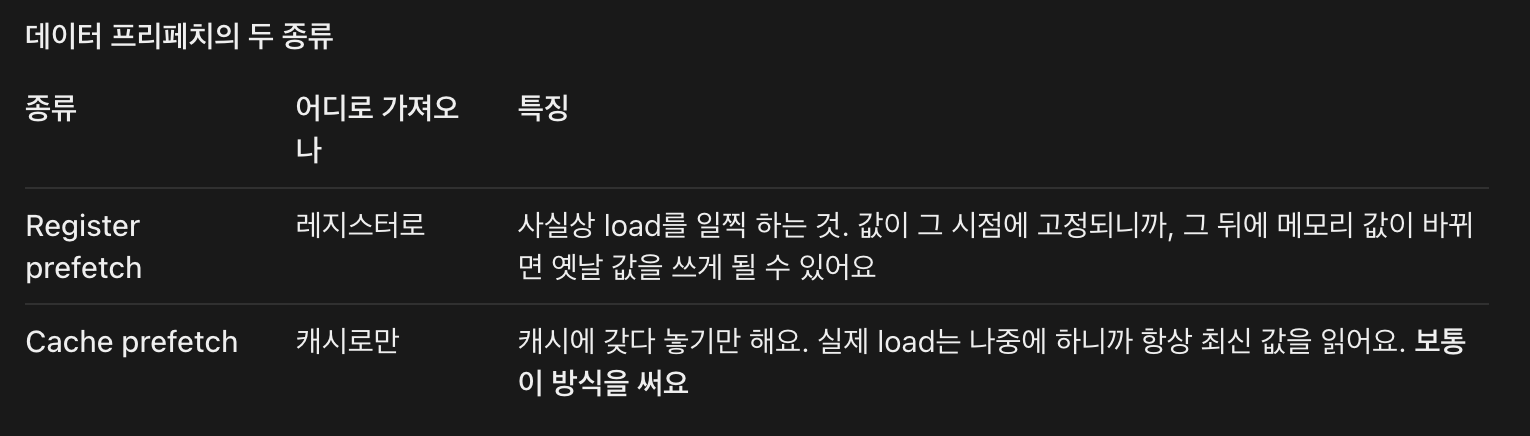
- Register Prefetch: load data int register
- Cache Prefetch: load into cache
- Special prefetching instructions cannot cause faults. The addr does not cause an exception (e.g. page fault)
- Requires nonblocking cache
Issuing Prefetch Instructions takes time
- Is cost of prefetch issues < savings in reduced misses?
프리페치 명령어가 갖춰야 할 조건
- 예외(fault)를 일으키면 안 돼요. 잘못된 주소나 아직 메모리에 없는 페이지를 가리켜도 페이지 폴트 없이 그냥 무시돼야 해요. 그래서 "틀려도 된다"가 가능한 거예요.
- 논블로킹 캐시(nonblocking cache)가 필요해요. 프리페치한 데이터가 오는 동안에도 캐시가 다른 load 요청을 계속 처리할 수 있어야 해요. 캐시가 프리페치를 기다리느라 멈춰 버리면, 미리 가져오는 의미가 없어요.
비용 문제
프리페치도 명령어라서 실행하는 데 시간이 걸려요. 그래서 따져봐야 해요.
프리페치 명령어 실행 비용 < 줄어든 미스로 아끼는 시간 이어야 이득
예를 들어 이미 캐시에 있는 데이터를 프리페치하면 시간만 날려요. 아래 Ex 1에서 이게 중요해져요.