[기출문제] 6회 풀이 학습 (교재 254p ~ 255p)
https://github.com/hscrown/bigdata/blob/631fd8facf15c629105f3ecb5d30344740a4bc3d/%EA%B8%B0%EC%B6%9C%EB%AC%B8%EC%A0%9C6.ipynb
[기출문제] 5회 풀이 학습 (교재 274p ~ 275p)
https://github.com/hscrown/bigdata/blob/631fd8facf15c629105f3ecb5d30344740a4bc3d/%EA%B8%B0%EC%B6%9C%EB%AC%B8%EC%A0%9C5.ipynb
[기출문제] 4회 풀이 학습 (교재 284p ~ 285p)
https://github.com/hscrown/bigdata/blob/631fd8facf15c629105f3ecb5d30344740a4bc3d/%EA%B8%B0%EC%B6%9C%EB%AC%B8%EC%A0%9C4.ipynb

과제
- 4주차 학습 내용 (기출문제) 업로드
개념정리
1. 데이터 처리 및 변환
pd.to_datetime()
- 문자열 형태의 날짜 데이터를
datetime타입으로 변환. - 데이터가 시간 정보와 관련된 경우 분석 및 계산에 필수.
- 예:
df['출동시간'] = pd.to_datetime(df['출동시간'])
groupby()
- 데이터를 특정 기준으로 그룹화한 뒤, 집계 연산을 수행.
- 주로 평균, 합계, 개수 등을 계산할 때 사용.
- 예:
df.groupby('구급대')['이동시간'].mean()
iloc와 슬라이싱
- 데이터프레임의 행과 열에 인덱스를 기준으로 접근.
iloc[:, 1:6]은 모든 행과 1~5번째 열을 선택.
2. 머신러닝
train_test_split
- 데이터를 훈련과 검증용으로 나누는 함수.
- 데이터셋의 과적합을 방지하고 모델 성능을 평가하기 위해 사용.
- 매개변수
test_size는 검증 데이터의 비율을 지정. - 예:
train_x, val_x, train_y, val_y = train_test_split(x, y, test_size=0.2, random_state=42)
원-핫 인코딩 (pd.get_dummies)
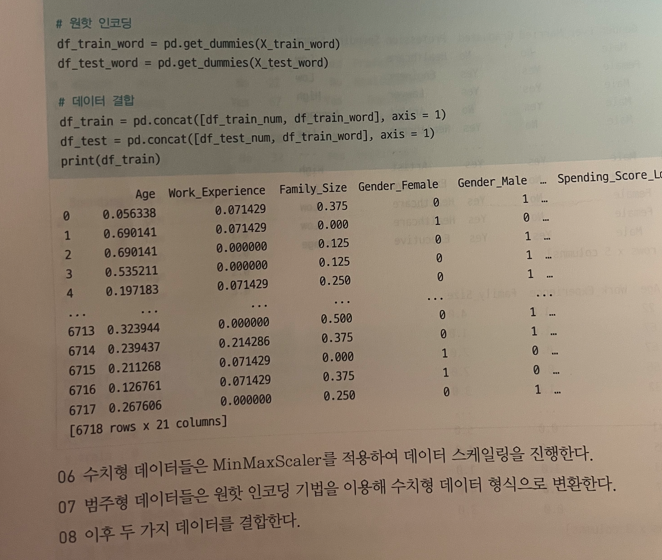
- 범주형 데이터를 0과 1로 구성된 이진 변수로 변환.
- 머신러닝 모델이 범주형 데이터를 처리할 수 있도록 하는 전처리 과정.
- 예:
df_encoded = pd.get_dummies(df)
3. 통계 및 모델링
scipy.stats.chisquare
- 카이제곱 검정을 수행.
- 관측된 데이터와 기대값 간의 차이를 통계적으로 검정.
- 결과로 검정 통계량(statistic)과 p-value를 반환.
- 예:
stats.chisquare([관측값], [기대값])
statsmodels.formula.api.ols
- 선형 회귀 모델을 생성하는 함수.
- 종속 변수와 독립 변수 간의 관계를 수식으로 정의하여 모델링.
- 예:
model = ols('Temp ~ Solar + Wind + Ozone', data=df).fit()Temp: 종속 변수Solar,Wind,Ozone: 독립 변수
4. 평가 지표 및 예측
f1_score
- 분류 모델의 성능을 평가하는 지표.
- 정밀도(precision)와 재현율(recall)의 조화 평균을 계산.
- 클래스 간 불균형 데이터에서도 유용.
- 예:
f1_score(y_true, y_pred, average='macro')
model.get_prediction()
- 회귀 모델을 기반으로 새로운 데이터의 예측 값을 생성.
- 신뢰 구간을 함께 제공 가능.
- 예:
pred = model.get_prediction(new_data).summary_frame(alpha=0.05)

kwonhs.alice@gmail.com