운영체제 (OS)
데이터
0 과 1 로 숫자를 표현하는 방법
정보 단위
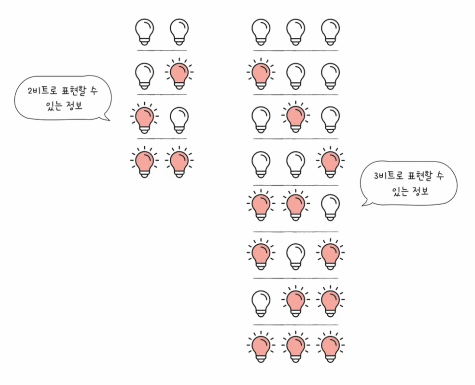
- 비트 ( Bit )
- 0 과 1 을 표현하는 가장 작은 정보 단위
- n 비트로는 2ⁿ 가지의 정보 표현 가능
- 프로그램은 수많은 비트로 이루어져 있음
- 다만, 평소 "이 파일은 8,920,120 비트야" 라고 표현하진 않음
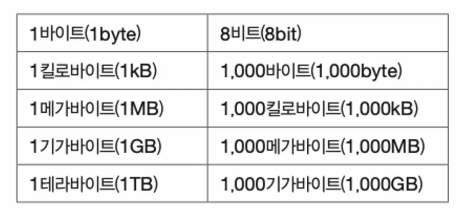
- 비트보다 더 큰 단위를 사용
- 바이트 ∙ 킬로바이트 ∙ 메가바이트 ∙ 기가바이트 ∙ 테라바이트 ∙∙∙
- 워드 ( Word )
- CPU 가 한 번에 처리할 수 있는 정보의 크기 단위
- 하프 워드 ( Half Word ): 워드의 절반 크기
- 풀 워드 ( Full Word ): 워드 크기
- 더블 워드 ( Double Word ): 워드의 두 배 크기
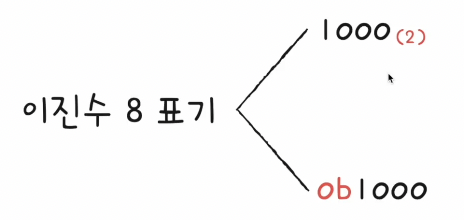
이진법: 0 과 1 로 숫자 표현하기
- 이진법 ( Binary )
- 0 과 1 로 수를 표현하는 방법
- 숫자가 1 을 넘어가는 시점에 자리 올림
- 우리가 일상적으로 사용하는 진법은 숫자가 9 를 넘어갈 때 자리 올림하는 십진법 ( Decimal )
- 0 과 1 로 음수 표현하기: 2 의 보수
- 어떤 수를 그보다 큰 2ⁿ 에서 뺀 값
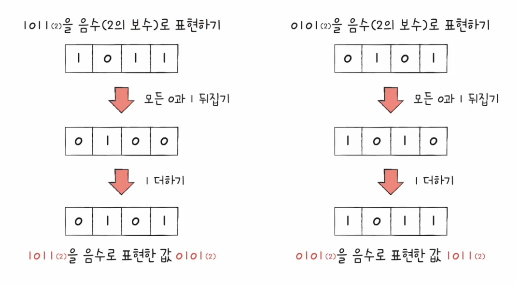
- = 모든 0 과 1 을 뒤집고 1 더한 값
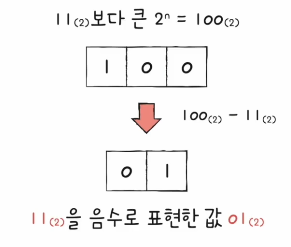
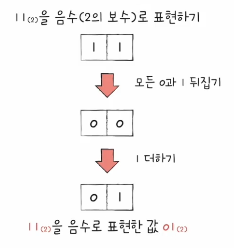
- 음수 두 번 구해보기
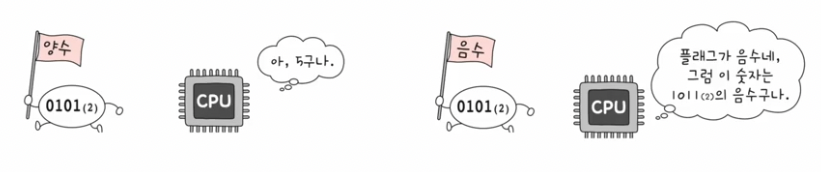
Tip! 플래그 ( Flag ) 란?
- -1011 ₍₂₎ 를 표현하기 위한 0101₍₂₎ 과 십진수 5 를 표현하기 위한 0101₍₂₎ 은 똑같이 생겼는데, 어떻게 구분하죠?
- 구분 하기 위해 CPU 내부에 플래그 ( Flag ) 레지스터 존재
십육진법
- 이진법으로는 숫자의 길이가 너무 길어진다
- 십진법 32 == 이진수 100000
- 그래서 컴퓨터의 데이터를 표현할 때 십육진법도 많이 사용
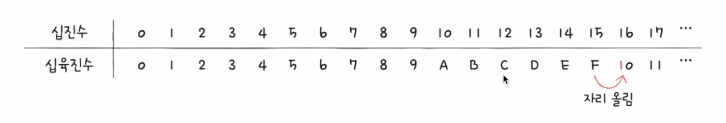
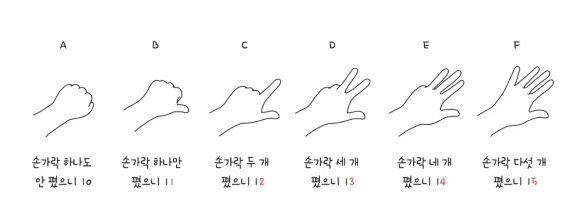
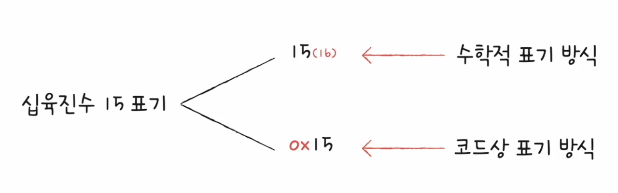
- 수가 15 를 넘어가는 시점에 자리 올림
Tip!
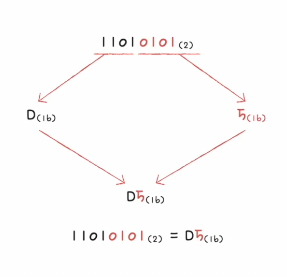
- 이진수 → 십윤진수 변환
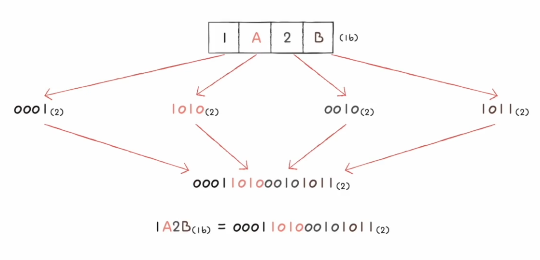
- 십육진수 → 이진수 변환
0 과 1 로 문자를 표현하는 방법
문자 집합과 인코딩
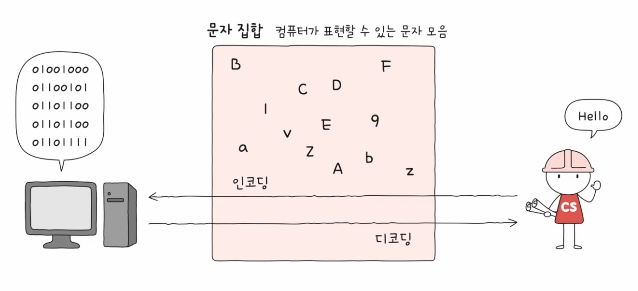
- 문자 집합 ( Character Set )
- 컴퓨터가 이해할 수 있는 문자의 모음
- 인코딩 ( Encoding )
- 코드화하는 과정
- 문자를 0 과 1 로 이루어진 문자 코드로 변환하는 과정
- 디코딩 ( Decoding )
- 코드를 해석하는 과정
- 0 과 1 로 표현된 문자 코드로 문자로 변환하는 과정
아스키 코드
- 초창기 문자 집합 중 하나
- 알파벳 ∙ 아라비아 숫자 ∙ 일부 특수 문자 및 제어 문자
- 7 비트로 하나의 문자 표현
- 8 비트 중 1 비트는 오류 검출을 위해 사용되는 패리티 비트 ( Parity Bit )
- 간단한 인코딩
- But 한글을 포함한 다른 언어 문자 ∙ 다양한 특수 문자 표현 불가
- 아스키 코드는 7 비트로 하나의 문자를 표현하기에
- 128 개보다 많은 문자를 표현할 수 없음
- 8 비트 확장 아스키 ( Extended ASCII ) 의 등장 ∙ 여전히 부족
한글 인코딩: 완성형 vs 조합형 인코딩
- 한글을 위한 인코딩이 필요
- 한글의 특징
- 알파벳을 이어 쓰면 단어가 되는 영어
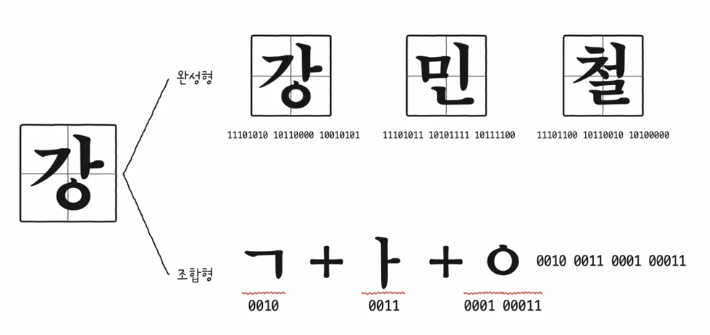
- 초성 ∙ 중성 ∙ 종성의 조합으로 이루어진 한글
- 완성형 인코딩 방식 과 조합형 인코딩 방식 이 존재
EUC-KR
- KS X 1001 KS X 1003 문자집합 기반의 한글 인코딩 방식
- 완성형 인코딩
- 글자 하나 하나에 2 바이트 크기의 코드 부여
- 2 바이트 == 16 비트 == 4 자리 십육진수로 표현
- 2300 여개의 한글 표현 가능
- 여전히 모든 한글을 표현하기에는 부족한 수
- 쀏 ∙ 뙠 ∙ 휔 같은 한글은 표현 불가능
- 더군다나 이렇게 언어별 인코딩을 국가마다 하게 되면 다국어를 지원하는 프로그램을 개발할 때엔 언어별 인코딩 방식을 모두 이해해야 한다
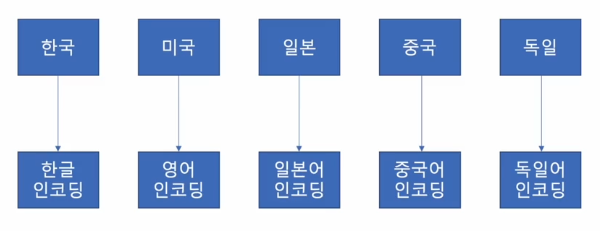
- 모든 언어 ∙ 특수문자까지 통일된 문자 집합을 사용하면 어떨까?
- 통일된 문자 집합 & 인코딩 방식이 있다면?
유니코드 문자 집합과 UTF-8
- 유니코드
- 통일된 문자 집합
- 한글 ∙ 영어 ∙ 화살표와 같은 특수 문자 ∙ 심지어 이모티콘까지
- 현대 문자 표현에 있어 매우 중요한 위치
- 유니코드의 인코딩 방식
- UTF-8 ∙ UTF-16 ∙ UTF-32 ∙∙∙
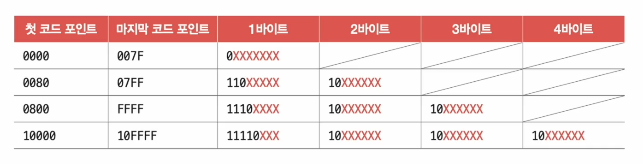
- UTF-8 인코딩
- UTF ( Unicode Transformation Format ) == 유니코드 인코딩 방법
- 가변 길이 인코딩: 인코딩 결과가 1 바이트 ~ 4 바이트
- 인코딩 결과가 몇 바이트가 될 지는 유니코드에 부여된 값에 따라 다름
🌱 Backend-Dev | hwaya2828@gmail.com