Overview
논문명: YOLOv11: An Overview of the Key Architectural Enhancements
학회(출판연도): arXiv (2024)
연구분야: 딥러닝 기반 객체 탐지 및 컴퓨터 비전(Object Detection & Computer Vision)
Abstract(초록)
✓ 아키텍쳐적 분석
- 모델 구조를 세부적으로 뜯어 보겠다~
- 보통 논문에서 “아키텍처 분석”이라고 하면
→ 이 모델이 왜 빠른지? 어떤 모듈이 정확도를 높였는지? 기존 아키텍처와 비교해 어떤 구조적 차이가 있는지? 같은 걸 따져 보겠다
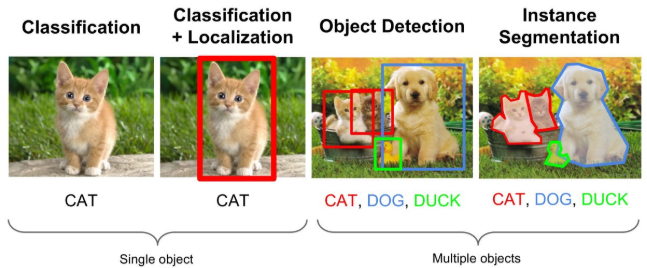
✓ 인스턴스 세그멘테이션
- 물체를 픽셀 단위로 잘라내면서 동시에 “각 객체(인스턴스)”를 구분
- 각 클래스 내에서도 개별 객체를 분리한다는 점에서 단순 semantic segmentation과 다름
✓ 포즈 추정
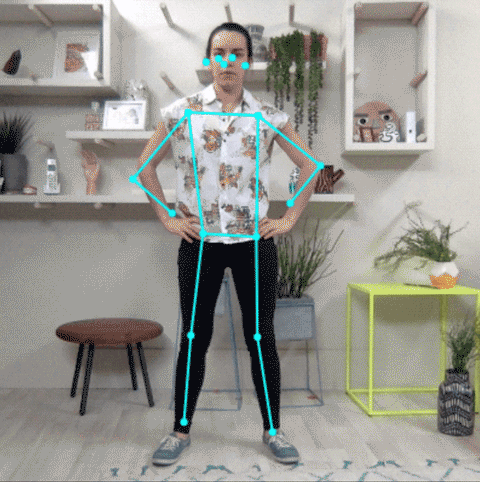
- 객체(특히 사람)의 관절/키포인트 위치를 추정해 “자세”를 파악
[방식]
① Top-down
- 객체(사람) 탐지 → 그 영역에서 관절 좌표 추정
② Bottom-up
- 이미지 전체에서 관절 후보 검출 → 이들을 연결하여 각 사람의 포즈 구성
✓ Oriented Object Detection(OBB, 방향성 객체 탐지)
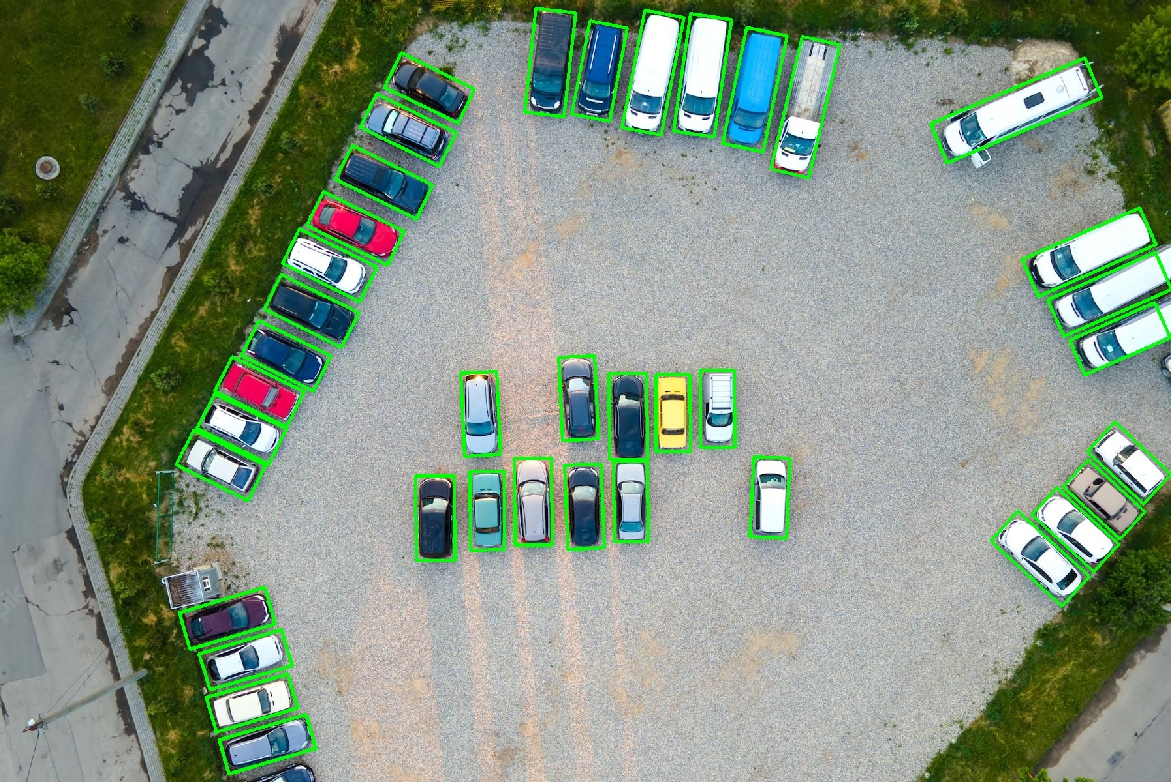
- 객체의 기울어진 바운딩 박스 검출
- 기본 Object Detection은 축과 평행한 직사각형 박스만 가능 → 기울어진 물체 표현⬇️
- 중심 좌표(x,y), 폭, 높이, 회전각(세타) 예측 → 박스를 물체 방향에 맞게 회전
✓ YOLOv 11
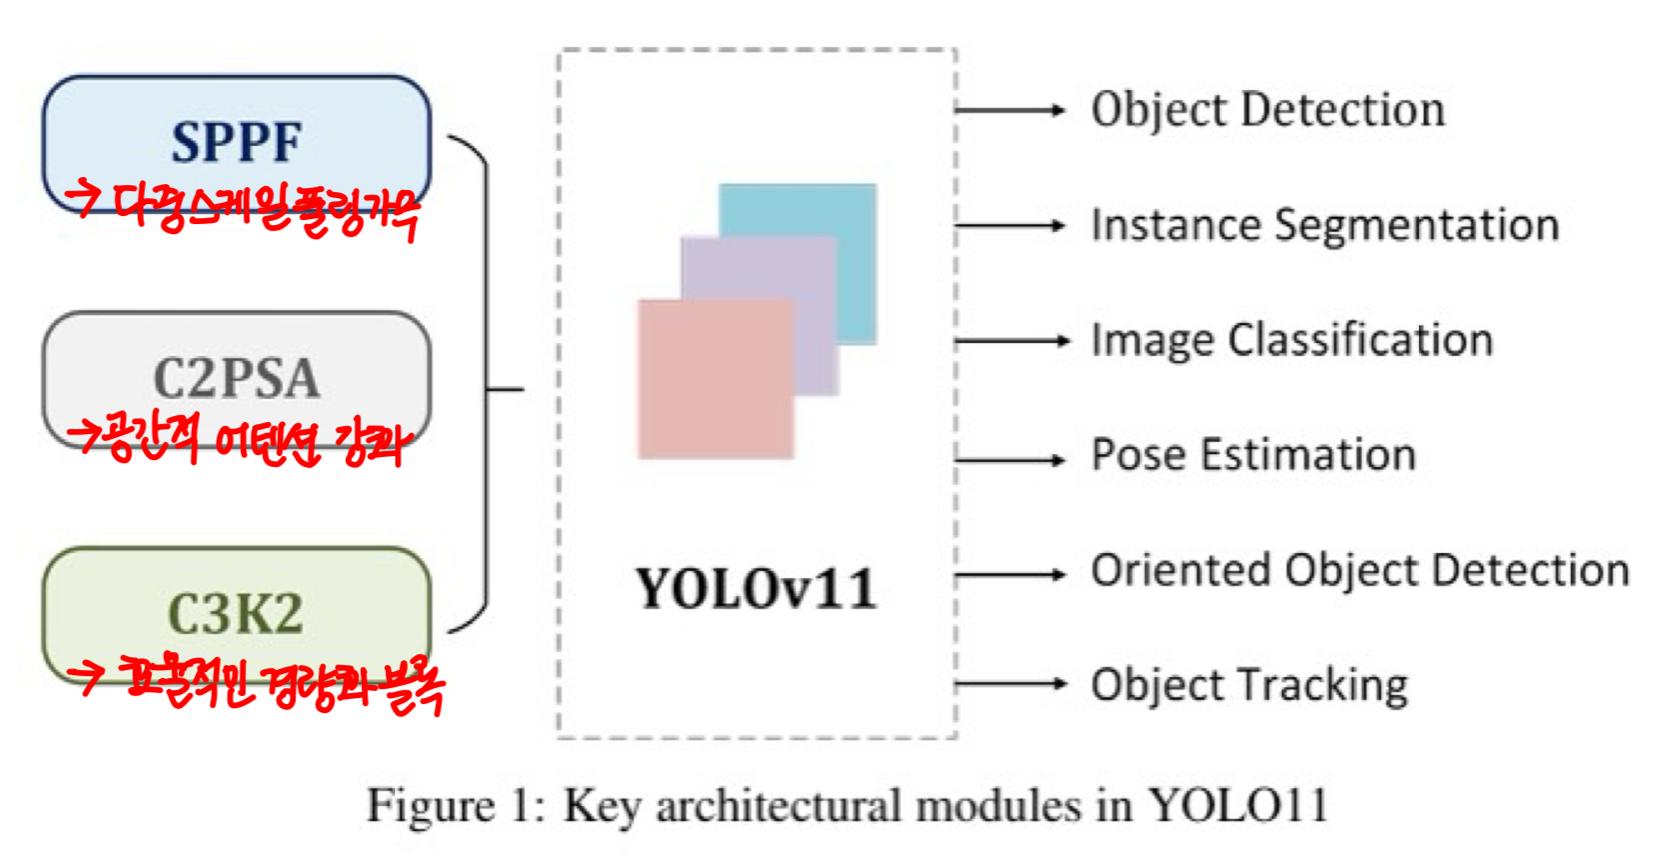
- C3k2 블록(Cross Stage Partial with kernel size 2), SPPF(Spatial Pyramid Pooling-Fast), C2PSA(Convolutional block with Parallel Spatial Attention) 구성요소의 도입
- 객체 탐지 + 인스턴스 세그멘테이션, 포즈 추정, Oriented Object Detection(OBB)
- mAP & 계산 효율성 개선 + 파라미터 수와 정확도 사이의 trade-off
- nano~extra-large 모델 크기까지 제공 → 엣지 디바이스~고성능 서버 환경까지 가
1. Introduction(서론)
✓ 배경
- CV에서 중요한 건 “객체 탐지(object detection)”
- 이미지, 비디오 스트림 속 객체를 정확히 식별하고 위치를 찾는 것까지 포함
✓ YOLO
- 전체 이미지 한 번만 처리 → 객체와 객체의 위치 탐지
- 회귀문제로 정의 → 1 stage
- CNN → 바운딩 박스 + 클래스 확률 동시 예측 : 훨씬 단순화된 파이프라인
✓ YOLOv 11
- 고도화된 특징 추출 기법 → 파라미터 수를 최소화하면서 정교한 세부 정보를 포착 가능해짐
2. Evolution of YOLO models
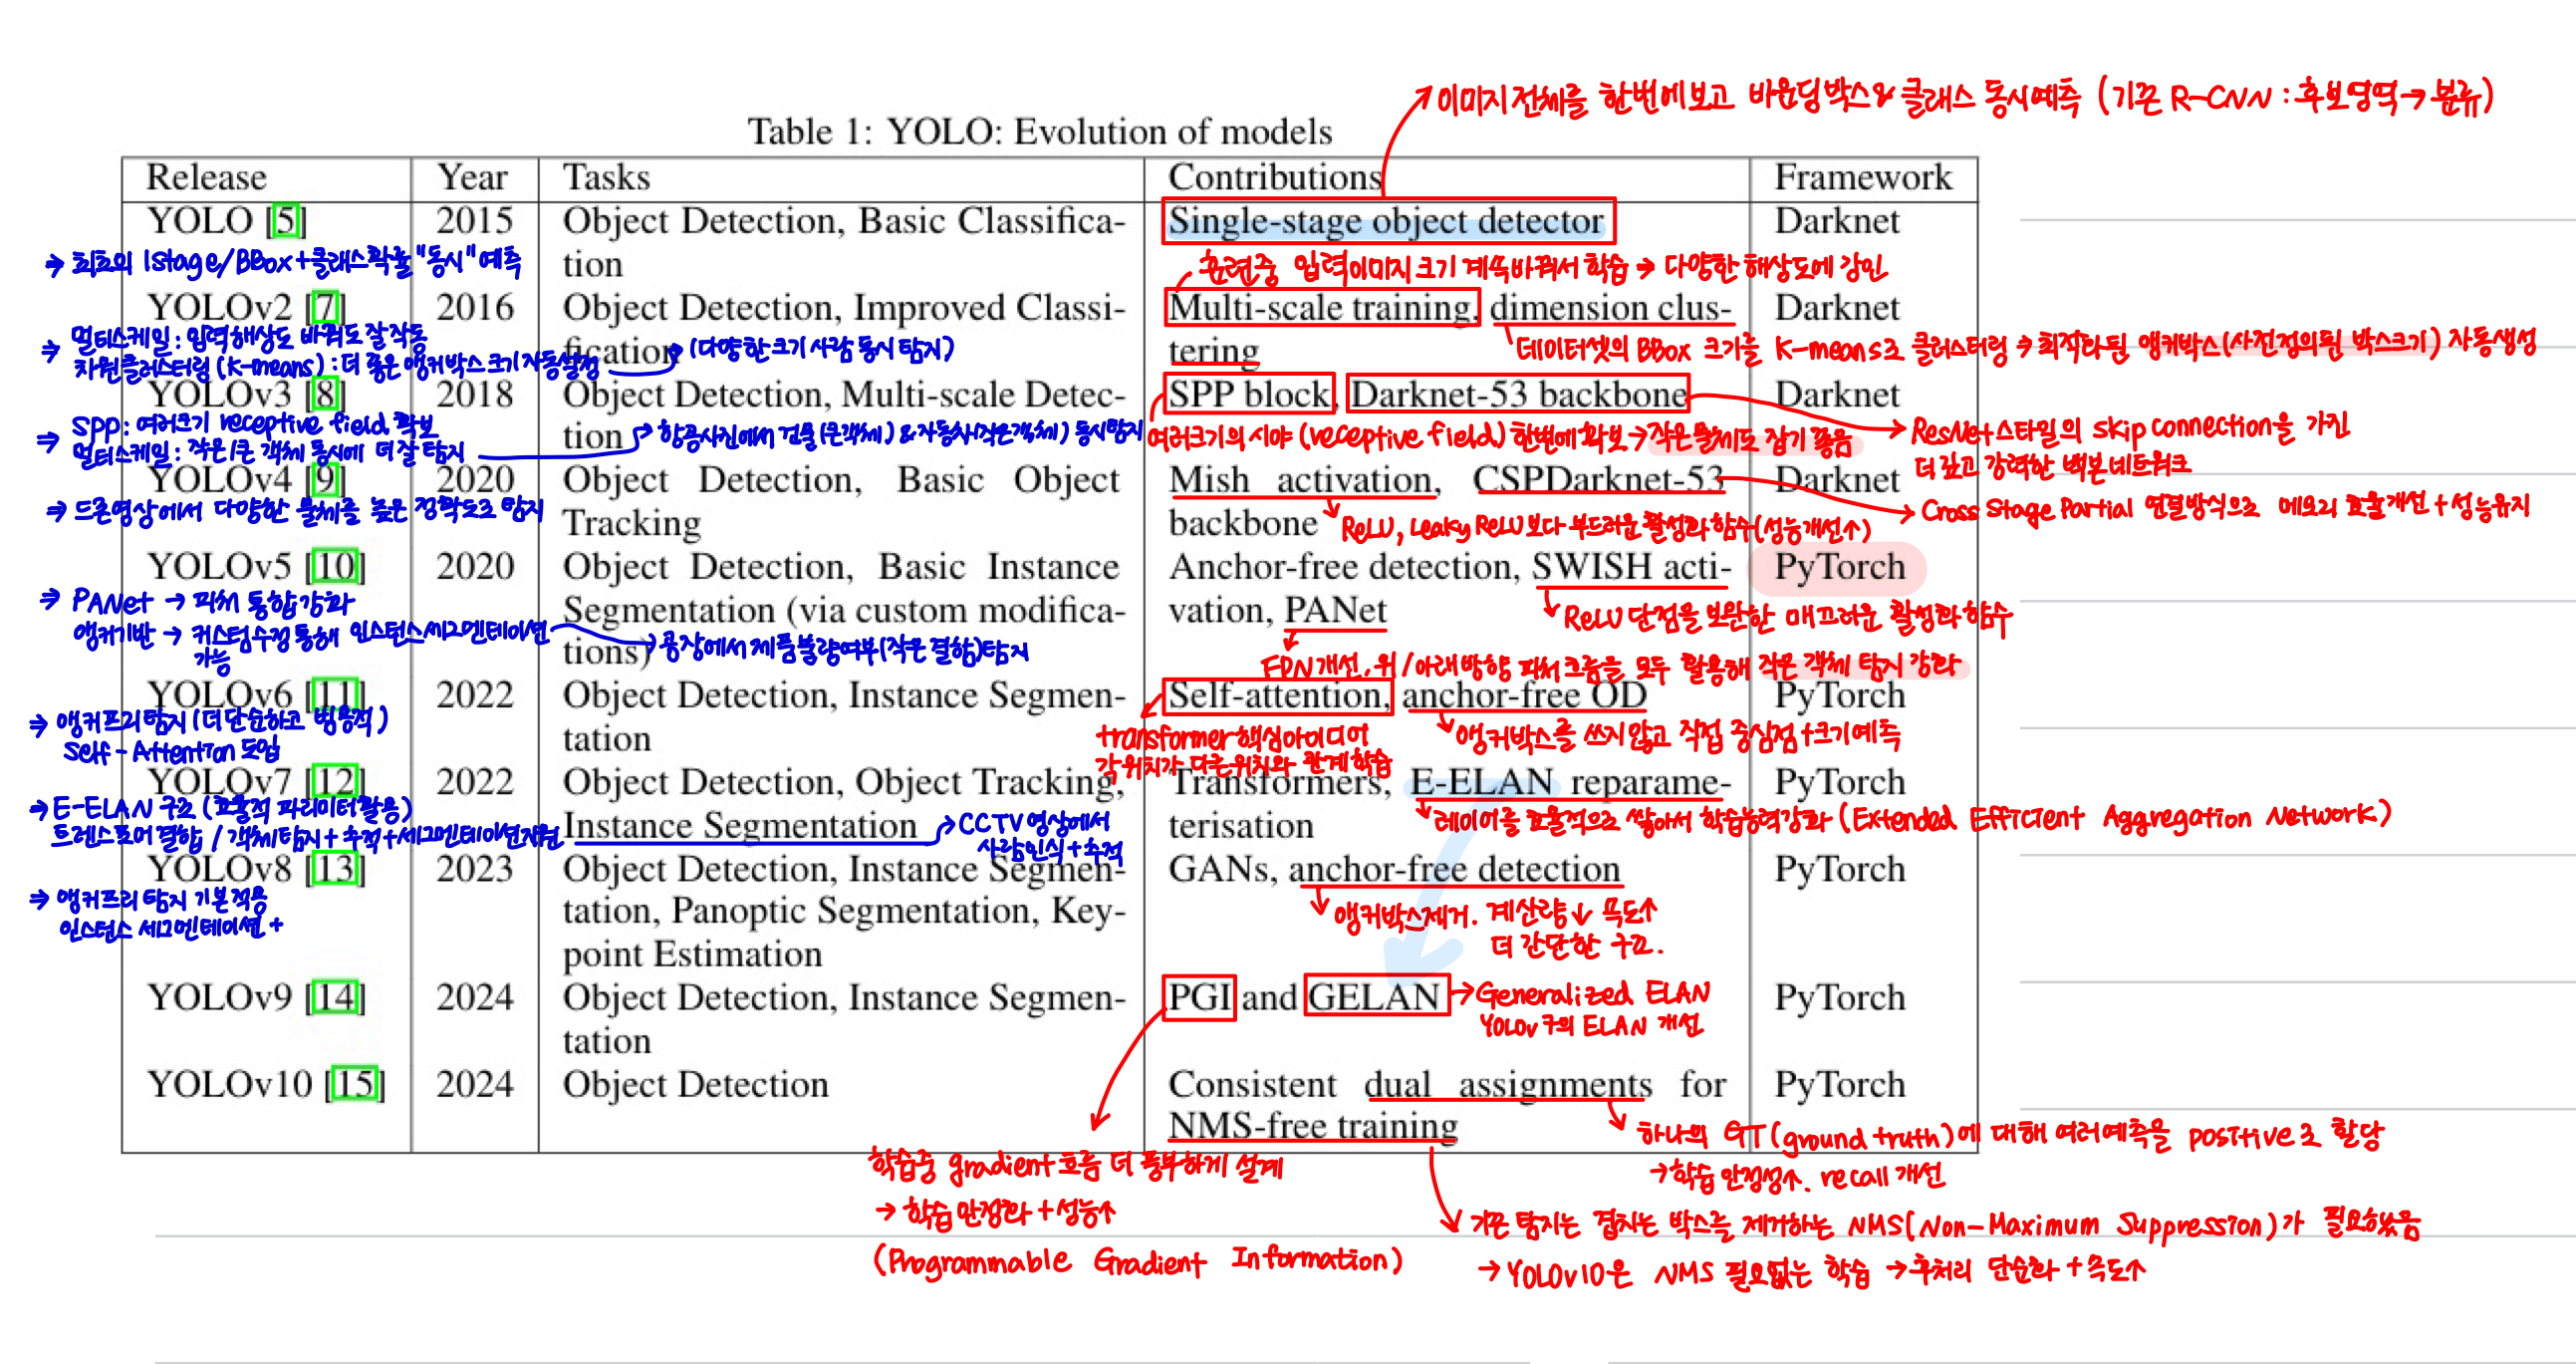
- <초기 YOLO> single-stage 객체 탐지 방식 ~ NMS-free 학습방식까지
- 특징추출, 효율성, 멀티태스크 처리 능력 향상
3. What is YOLOv11?
✓ 차별화
→ ① 포즈 추정(posture estimation) ② 인스턴스 세그멘테이션(instance segmentation)
⇒ 모델의 적용 가능성 확장가능
✓ 설계
→ ① 성능 ② 실용성의 균형 에 중점 → 더 높은 정확성과 효율성 해결 목표
4. Architectural footprint of YOLOv11
✓ YOLO 프레임 워크
: BBox 회귀와 객체 분류 작업을 동시에 처리할 수 있는 통합 신경망 구조의 도입 → 객체 탐지의 혁신
① Single-stage(↔ 2단계 탐지 방식)
② 완전 미분 가능 설계 → end-to-end 학습 가능
✓ YOLO 아키텍처의 핵심, 3가지 구성요소
✓ 다중 스케일 특징맵
CNN은 레이어를 거치면서 “특징맵(feature map)”의 크기가 점점 작아짐(해상도⬇️)
→ 채널 수, 추상적 의미⬆️
얕은 레이어(앞단): 해상도 높음, 세부 디테일(모서리,질감,작은 물체) 잘 보존
깊은 레이어(뒷단): 해상도 낮음, 의미적 정보(ex. 이건 고양이) 잘 표현
→ 작은 물체는 앞단 feature에서 잘 보이지만, 뒤로 갈수록 사라짐
→ 큰 물체는 뒷단 feature에서 잘 잡히지만, 앞단에서 구분이 어려움
⇒ 여러 스케일의 feature map을 동시에 활용하는 것이 필요!
- 대표적인 3가지 구조
- FPN(Feature Pyramid Network)
- 깊은 feature와 얕은 feature를 top-down + lateral 연결해서 결합
- 작은/중간/큰 객체를 모두 잡도록 설계
- PANet
- FPN에 bottom-up 경로 추가 → 정보 전달 더 강화
- YOLO 계열
- YOLOv3부터 3가지 크기의 feature map 사용(13x13, 26x26, 52x52)
- 작은 grid → 큰 객체 탐지/큰 grid → 작은 객체 탐지
✓ Grid와 Feature Map 관계
✓ 에서 grid = 최종 feature map의 ”cell”
⇒ grid가 작아질수록, 한 칸이 보는 영역(receptive field)가 훨씬 넓어짐
✓ 큰 객체: 넓은 영역을 커버해야하므로, 작은 grid가 유리
✓ 작은 객체: 세밀한 픽셀 차이까지 잡아야하므로, 큰 grid가 유리
① 백본(backbone): 주요 특징 추출기로 작동/CNN을 통해 원본 이미지를 다중 스케일 특징 맵으로 변환
② 넥(neck): 중간 처리 단계로 기능/특수화된 층을 사용해 서로 다른 스케일 특징을 통합 및 강화
✓ 서로 다른 스케일 특징을 통합 및 강화?
특수화된 층: FPN, PANet, C3k2, Attention 모듈
→ 이 층들은 서로 다른 깊이(스케일)에서 나온 특징들을 합치고(aggregation),
중요한 정보는 강조(attention/weighting)해서 모델이 더 잘 인식하도록 도움!⇒ 작은 물체, 큰 물체 각각에 맞는 정보를 잘 쓰기 위해 다양한 깊이에서 뽑힌 특징들을 합쳐서(통합) 중요한 부분은 더 강조(강화)하는 층들을 사용한다
③ 헤드(head): 예측 매커니즘/정제된 특징맵을 바탕으로 객체 위치(localization)과 분류 결과 최종 출력
✓ YOLOv 11
→ YOLOv 8을 확장 및 개선
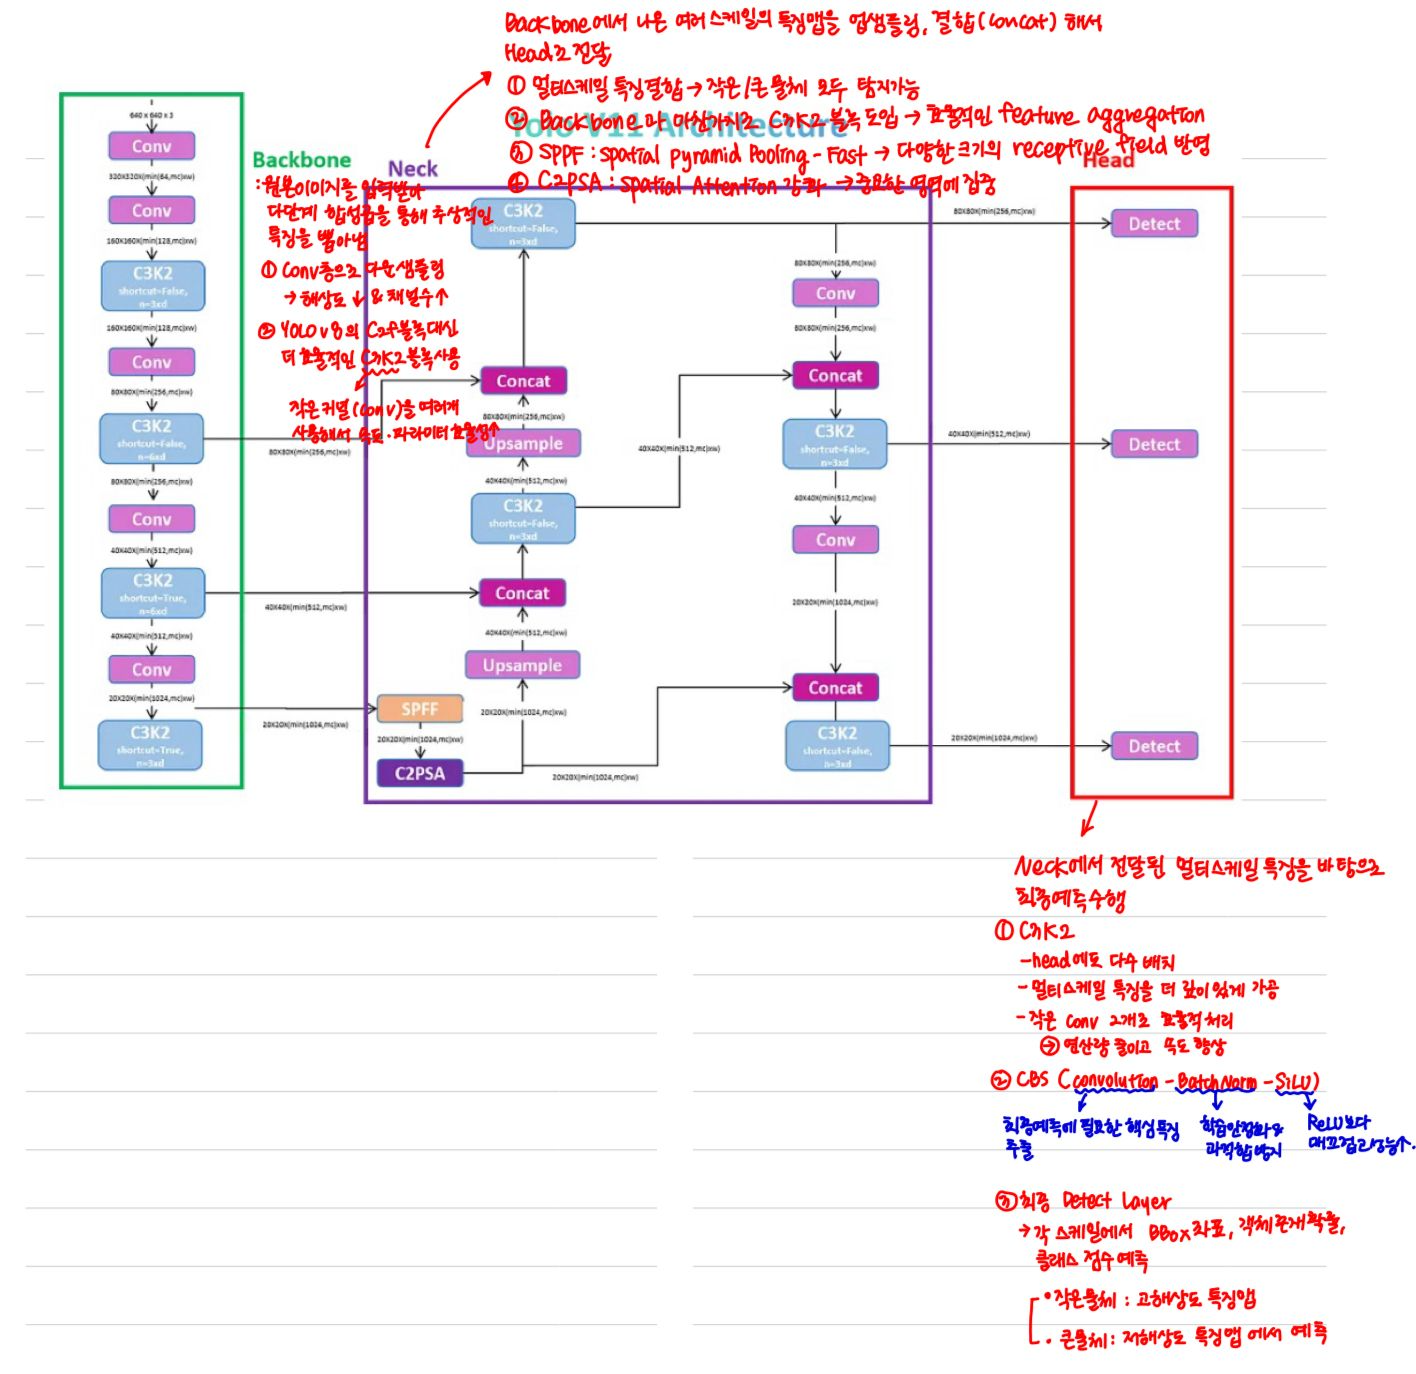
4.1 Backbone
→ 입력 이미지로부터 다중 스케일 특징 추출하는 역할 담당
- 합성곱 층과 특수 블록을 적층하여 다양한 해상도의 feature map 생성!
4.1.1 Convolutional Layers
- 초기 합성곱(Conv)층을 사용해 이미지를 다운샘플링하면서 특징 뽑음
- 해상도⬇️ 채널 수⬆️ → 점점 더 추상적인 특징맵 get!
✓ 주요 개선점
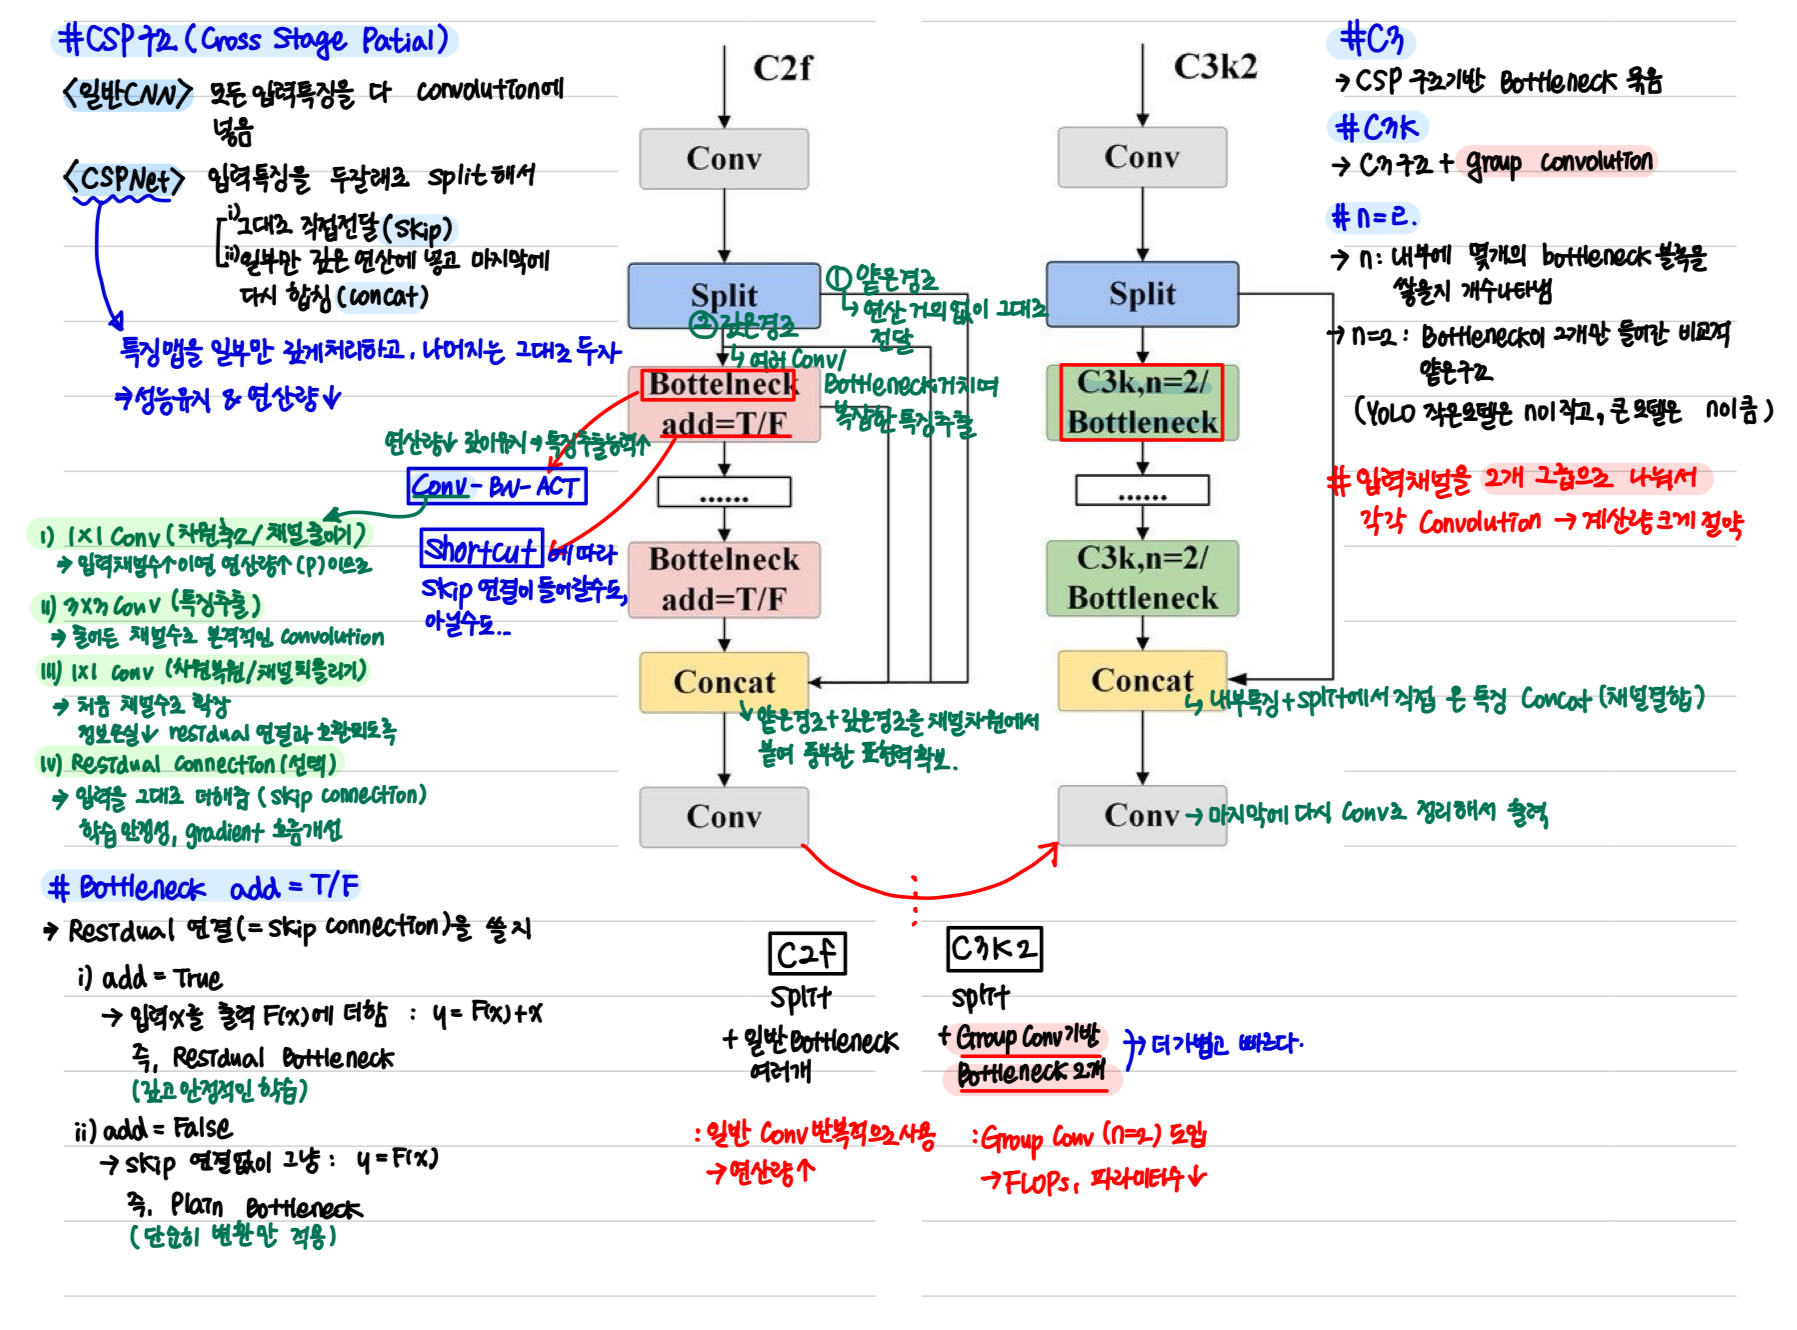
✓ C3k2 블록 도입
- CSP 병목구조를 더 효율적으로 구현
- 하나의 큰 합성곱 대신 작은 합성곱 2개 사용
4.1.2 SPPF & C2PSA
✓ SPPF(Spatial Pyramid Pooling-Fast) → 멀리 가까이 동시에 보기
→ 다양한 크기의 객체를 잘 잡기 위해 여러 크기의 receptive field를 동시에 보는 블록
- 구조
- 보통 하나의 5x5 max pooling을 반복해서 9x9, 13x13 같은 큰 커널 효과 얻음
- 마지막에 concat해서 채널 방향 합침
→ ✓SPPF 이거 다시 보기,, 뭔 구조야
✓ C2PSA(Cross Stage Partial with Spatial Attention) → 중요한 부분에 초점
→ “공간적 주의집중(spatial attention)”을 도입해서, 이미지 안에서 어디가 중요한 영역인지 강조
→ CSP(Cross Stage Partial) 구조 위에 어텐션 모듈을 얹은 것
구조
C2f(CSP 변형 블록) + Spatial Attention 모듈
Spatial Attention은 보통 “어떤 위치가 중요할까?”를 학습해서 중요도 맵(heatmap)을 곱해줌
ex. 배경은 약하게, 객체는 강하게
-
SPPF 블록 → 다양한 크기의 객체에 잘 반응하도록 만드는 블록
- YOLOv5, v8에도 있던 블록인데, v11에도 유지됨
-
SPPF 블록 뒤에 C2PSA 블록 추가
-
C2PSA = CSP구조(C2f와 비슷) + 공간적 어텐션(spatial attention)
-
단순 특징맵을 합치는 것이 아닌 어떤 위치/공간이 중요한 지 강조하는 기능 추가
⇒ 모델이 이미지 전체를 균등하게 보는 것이 아니라,
중요한 부분(=관심영역, object 후보 위치)에 집중 가능
⇒ 작은 물체나 복잡한 배경 속에 물체 탐지 정확도가 향상될 수도 있음
-
4.2 Neck
→ 여러 스케일의 특징을 결합하여 헤드(head)에 전달해 예측에 활용
- 업샘플링과 다른 레벨의 특징맵의 연결을 통해 다중 스케일 정보를 효과적으로 포착하도록!
4.2.1 C3k2 block
- C2f → C3k2 블록으로 교체
- 업샘플링, 연결 후 속도와 성능 강화
✓ 다운 샘플링
→ feature map 크기를 줄이는 것
✓왜 할까?
- 계산량 줄이기: 이미지가 클수록 연산량이 커짐
- 추상적 특징 학습: 국소적인 정보(edge, pattern)를 점차 요약해서 의미적 정보로 변환
- 큰 수용영역 : 더 큰 맥락 파악
✓ 업 샘플링
→ feature map 크기를 늘리는 것
✓왜 할까?
- 해상도 복원: 세그멘테이션에서 원본 크기와 같은 출력 필요
- 작은 객체 탐지 강화: 해상도를 키워서 세밀한 디테일 다시 확보
- feature fusion: 깊은 층(추상적 의미) + 얕은 층(디테일)을 합칠 때 크기를 맞춰야 함
✓ Backbone과 Neck 모두 C3k2? → YES!
- Backbone
- 기존 YOLOv의 C2f 블록을 C3k2 블록으로 교체
- 초기 단계부터 <특징 추출>을 더 가볍고 효율적으로 수행
- Neck
- 마찬가지로 기존 C2f → C3k2로 교체
- 멀티스케일 <특징을 합치는 과정>에서 연산량을 줄이고 속도를 높임
4.2.2 Attention Mechanism
-
C2PSA 모듈을 통한 공간적 어텐션 강화
→ 이미지 내의 중요 영역 집중할 수 있게 해서 작거나 부분적으로 가려진 객체 탐지 정확도 향상
4.3 Head
→ 객체 탐지의 분류에 대한 최종 예측
Neck에서 전달된 특징맵을 처리해, 최종적으로 이미지 내 객체의 바운딩 박스가 클래스 레이블 출력
4.3.1 C3k2 block
- 헤드 내 여러 경로에 배치되어 다양한 깊이의 다중 스케일 특징을 처리하는 역할(효율적)
- 파라미터 값에 따라 유연하게 동작
- C3k = False: C3k2모듈이 C2f 블록과 유사하게 동작(기본적인 bottleneck 구조)
- C3k = True: 병목 구조가 C3 모듈로 대체되어, 더 깊고 복잡한 특징 추출 가능
✓ C3k=True/False와 add=True/False 비교
- C3k=True/False
- C3k2 블록의 구조를 어떤 식으로 쓸 지 선택(C2f형 vs C3형)
- add=True/False
- skip connection에서 덧셈을 할 지, concat을 할 지 연결 방식 제어
⇒ C3k는 블록 내부 구조 선택
⇒ add는 연결 방식 선택
✓ C3k2 블록의 주요 특징
- Faster processing
- 2개의 작은 합성곱을 사용하여 큰 합성곱 하나보다 계산 부담⬇️
- 특징 추출 속도 빨라짐
- Parameter efficiency
- C3k2는 CSP 병목 구조의 더 간결한 버전
- 학습 가능한 파라미터 수 측면에서 아키텍처를 더 효율적으로
- 커널 크기 사용자가 정의 가능 → 유연성⬆️
- 더 세밀한 특징 추출하는데 유
4.3.2 CBS blocks
- C3k2 블록 이후 여러 개의 CBS 레이어 포함
- 특징추출, 탐지과정 ← 기초적인 구성요소로 작동
- 정제된 특징맵 이후 레이어로 전달되어 바운딩 박스와 분류 예측에 활용될 수 있도록 보장
✓ 특징맵 정제 방법 (Conv → BN → SiLU)
① 관련 특징 추출
② BN을 통해 데이터 흐름을 안정화 및 정규화
③ SiLU(Sigmoid Linear Unit) 활성화 함수를 사용해 비선형성 도입 → 모델 성능 향상 기
4.3.3 Final Convolutional Layers and Detect Layer
- 각 detection branch는 Conv2D 레이어 집합으로 끝
→ 이 레이어들이 특징맵을 줄여서 BBox 좌표와 클래스 예측에 필요한 출력 수로 변환
✓ Detect layer의 예측
- 이미지 내 객체 위치를 찾기 위한 BBox 좌표
- 객체가 존재할 가능성을 나타내는 객체성 점수
- 탐지된 객체의 종류를 판별하기 위한 클래스 점수
<YOLOv11 전체 흐름>
5. Key Computer Vision Tasks Supported by YOLOv11
→ YOLOv 11 다양한 CV 작업 지원