이전 글에서 AI에 대한 개념을 다루고 나서, 이걸 직접 내 서비스에 붙여보면 어떨까? 하는 생각이 들었다. 그래서 바로 팀원들과 현재 진행 중인 프로젝트에 RAG 기반 AI 기능을 붙여보기로 했다.
현재 개발중인 서비스에 AI를 붙여보자
실습 대상은 지도 기반 개인화 통신사 제휴처 할인 서비스이다.
이 서비스의 주요 기능 중 하나는 AI 챗봇으로,
나 지금 점심 먹으려고 하는데 근처 할인 매장 추천해줘!
와 같은 질문을 하면 AI가 실제 DB의 상점·혜택 정보를 기반으로 응답하는 것을 목표로 했다.
처음 구상한 구조
Python + FastAPI + ChromaDB + LangChain + Gemini API
RAG를 구현하기 위한 가장 흔한 정석 조합이었다.
- FastAPI : LLM API 서버 구축
- ChromaDB : 벡터 유사도 검색용 DB
- LangChain : 의도 분류 및 체인 구성
- Gemini API : 토큰 비용 절약형 LLM
외부 지식을 검색해 문맥 기반으로 답변을 생성하는 RAG의 특성이 "상점별 제휴 혜택 검색" 기능에 딱 맞을 거라 생각했다.
서버 환경 문제 발생
하지만, 현재 프로젝트는 Spring Boot + MariaDB 기반이며, 서버의 RAM이 1GB에 불과했다.
따라서, FastAPI 서버를 추가로 띄울 여유가 없었고, Spring AI는 버전 1.3 문제와 예제 부족으로 러닝커브가 높았다. 게다가 실서비스로 사용자 피드백을 받을 예정이라
로컬 테스트만으로는 의미가 없었다.
결론적으로, AI 기능을 붙이기엔 1GB 메모리의 한계가 명확했다.
데이터 구조 문제
데이터 구조 자체도 RAG에 적합하지 않았다.
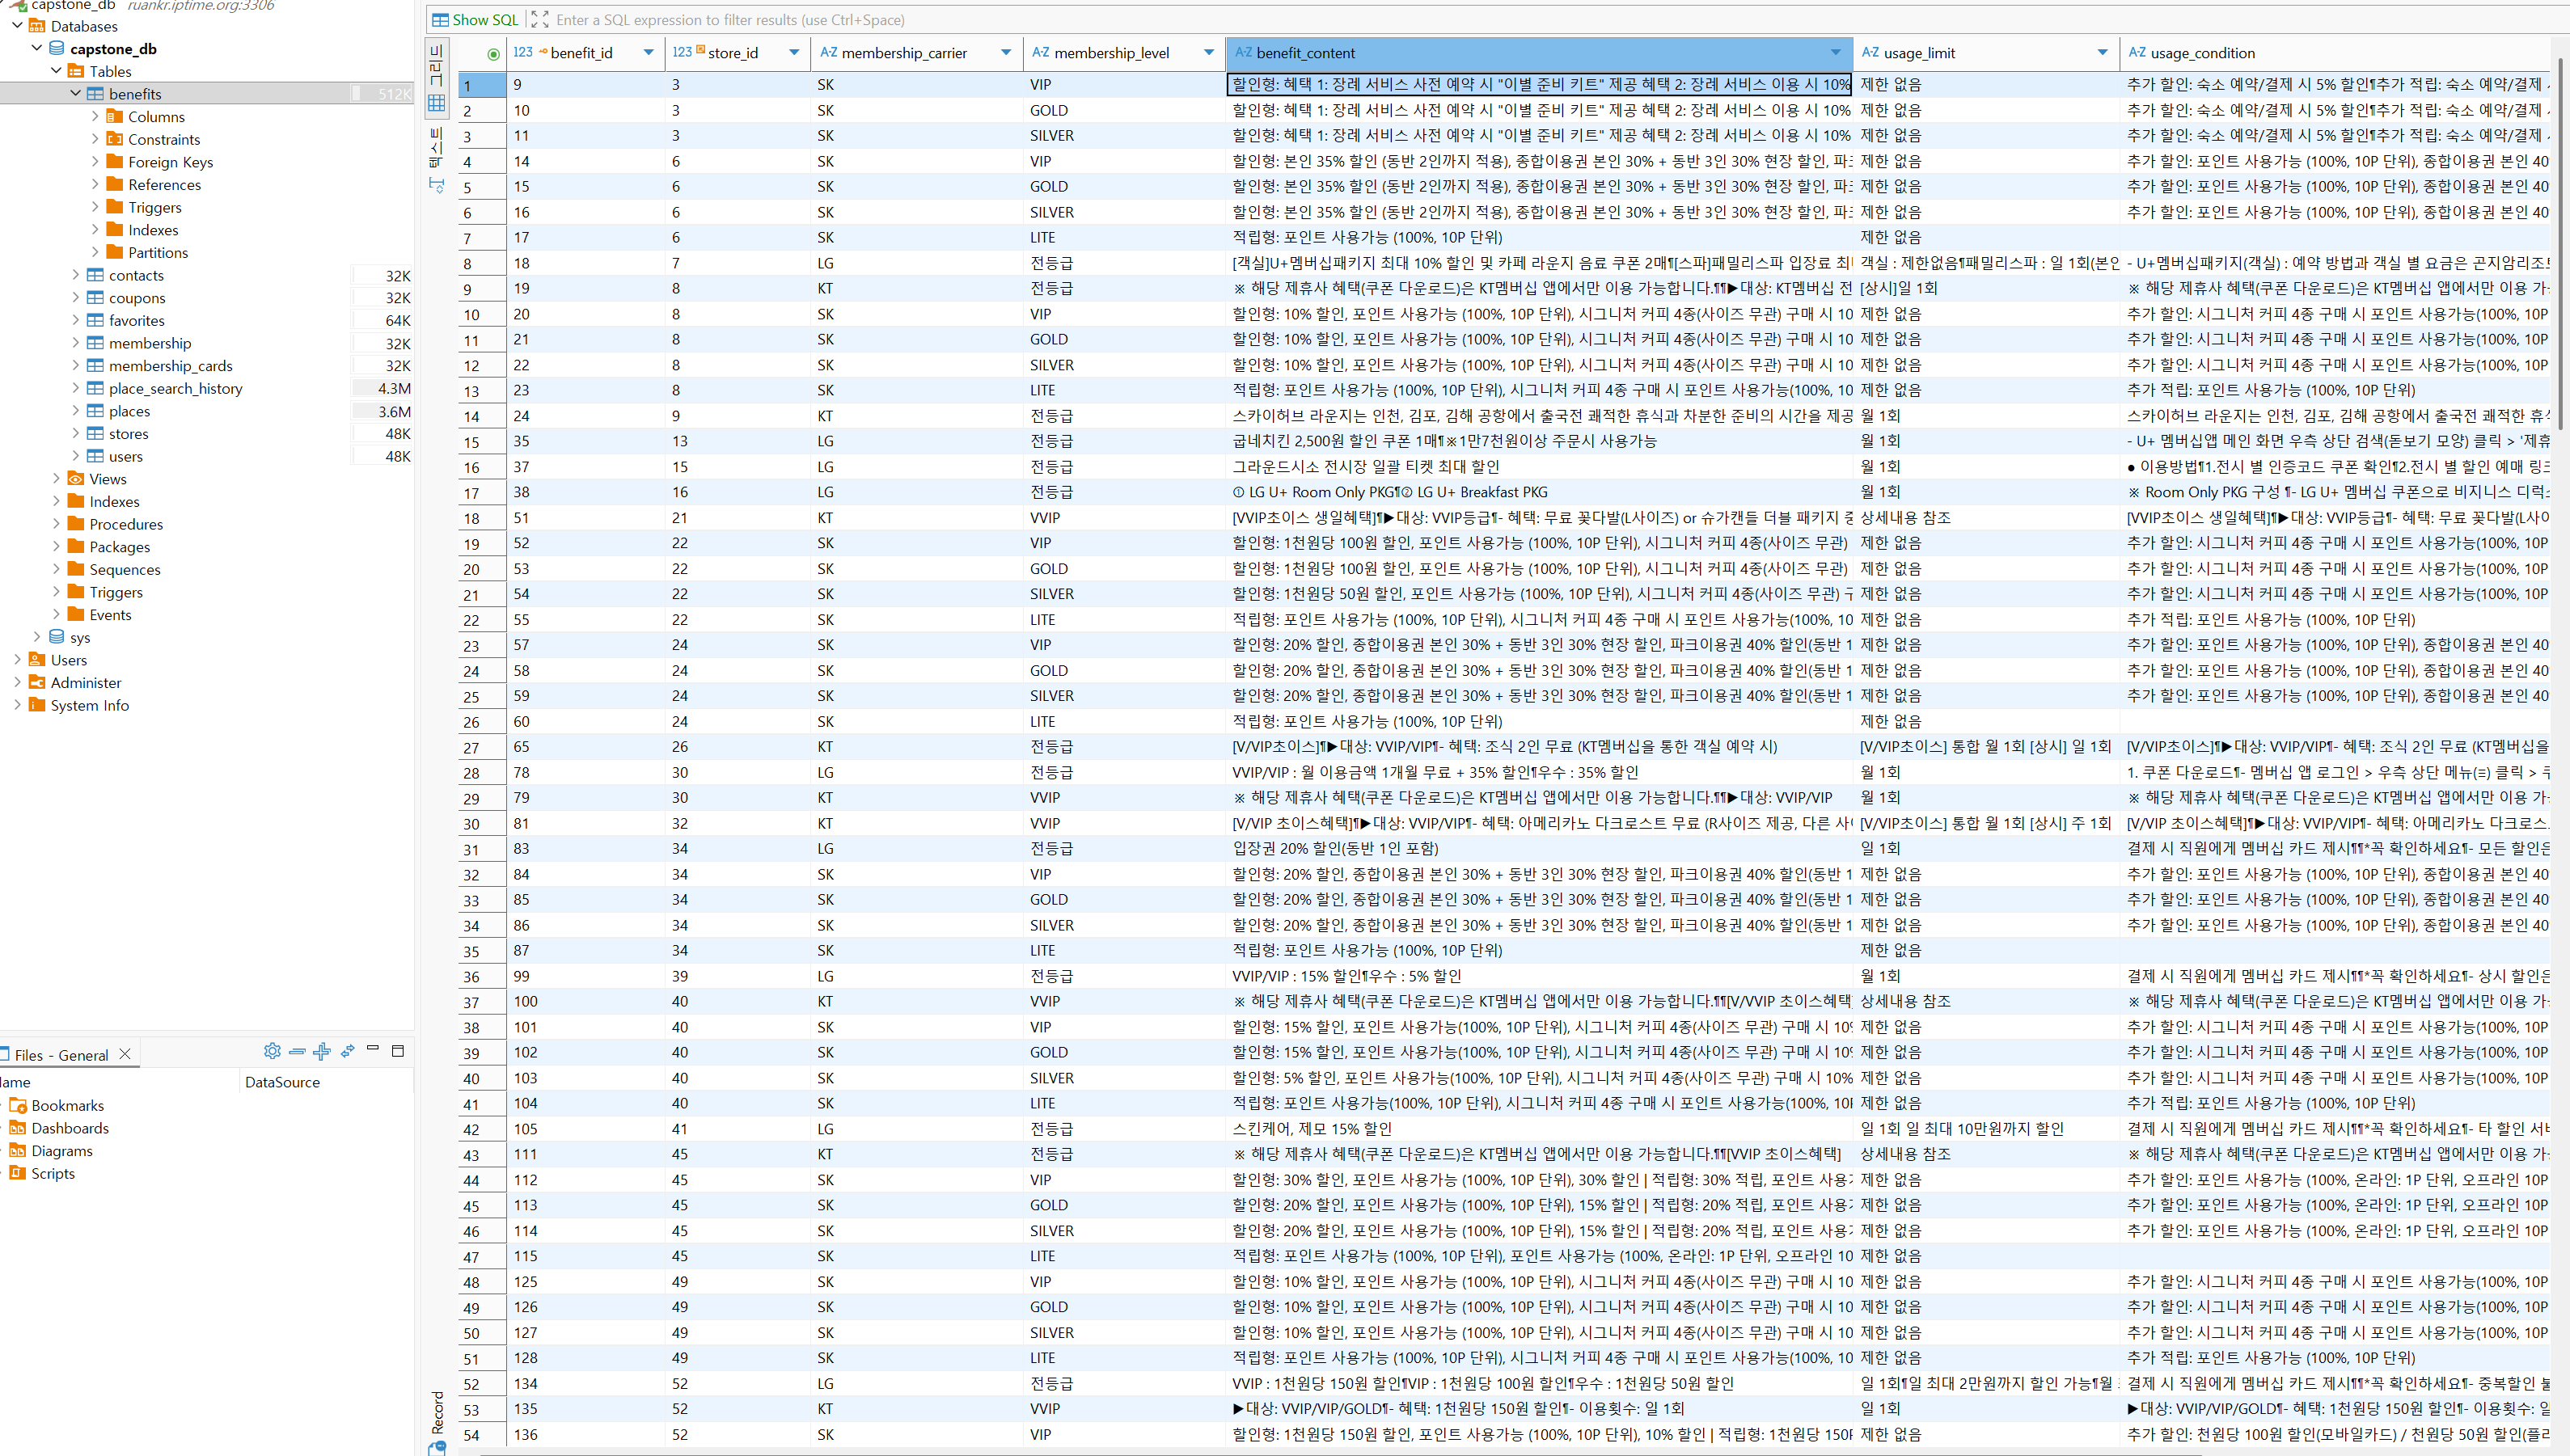
benefits 테이블을 보면 알 수 있듯이, 혜택 내용은 전부 자유 텍스트 형태로 저장되어 있었다.
- 문장 길이에 제한이 없고 몇백~몇천자까지 다양
- 조건문과 문장 패턴이 제각각
- 유사도 기준으로 구분이 어려움
이런 데이터는 벡터화해도 의미 유사도가 섞이기 쉽고, 통신사·등급·상점 정보가 뒤섞여 있어서 잘못된 상점을 매칭할 가능성이 높았다.
즉, RAG를 써도 성능 향상이 거의 없을 것 같았다.
결국 룰베이스 선택
처음엔 RAG를 통해 더 정교한 챗봇을 만들고 싶었지만, 서버 스펙, 데이터 구조, 배포 안정성을 고려했을 때 현실적인 대안은 룰베이스 + LLM API였다.
룰베이스란?
룰베이스는 정해진 규칙에 따라 동작하는 방식이다. 데이터를 벡터화하지 않고, DB의 정형화된 필드(통신사, 등급, 상점명 등) 를 조건으로 직접 쿼리한다.
LLM이 추측이 아닌, 명확한 데이터 기반으로 응답하도록 만드는 방식이다.
우리의 DB는 이미 정형화되어 있었기 때문에 벡터 검색보다 단순 쿼리 기반 룰 매칭이 훨씬 정확하고 빠른 구조가 될 수 있었다. 또한 최근 LLM의 성능이 좋아져, 간단한 의도 파악과 말투 조정 정도는 충분히 처리할 수 있었다.
- Spring 단일 서버에서 운영 가능
- 1GB RAM으로도 무리 없이 처리
- 데이터 구조가 정형화되어 있어 DB 쿼리로 해결 가능
- LLM API만으로도 의도 파악 및 자연스러운 대화 가능
챗봇 응답 로직 설계
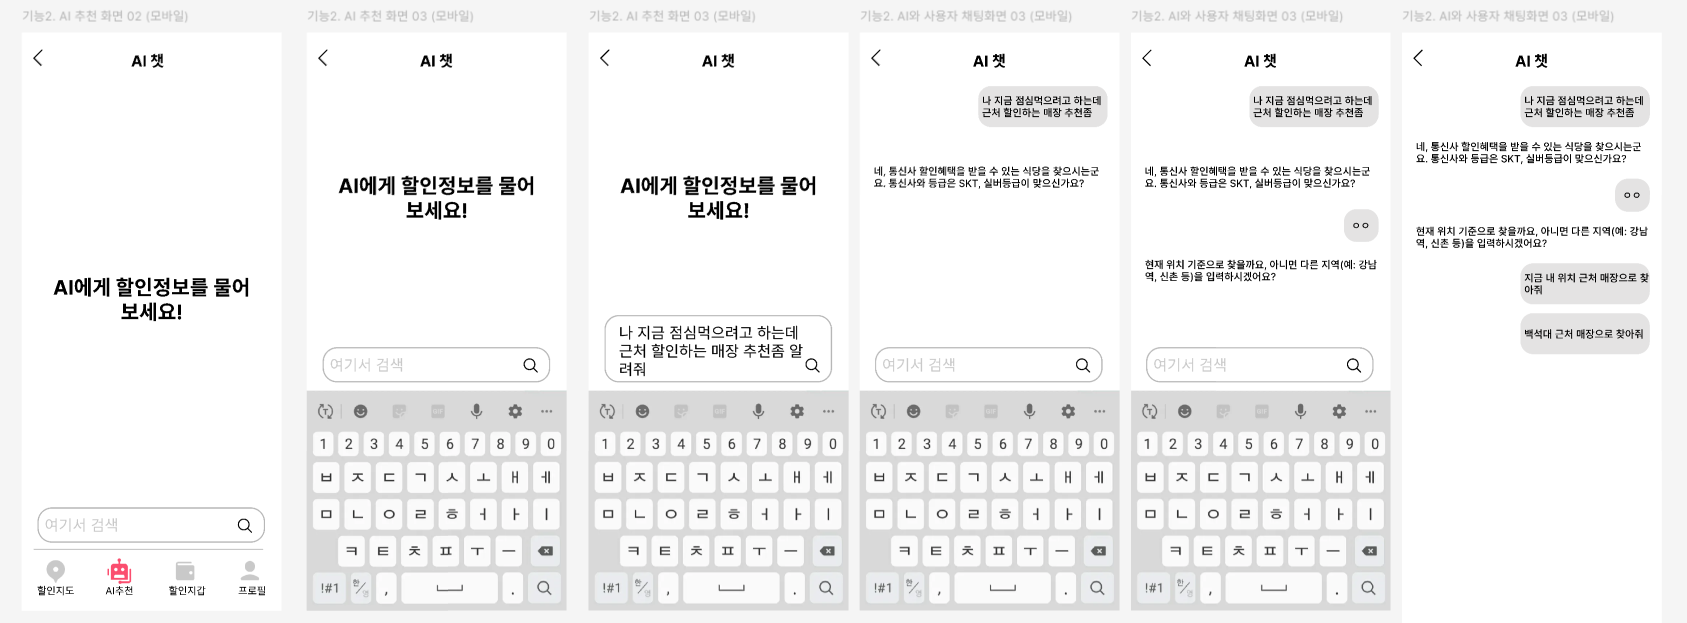
사용자의 대화 흐름을 아래처럼 설계했다.
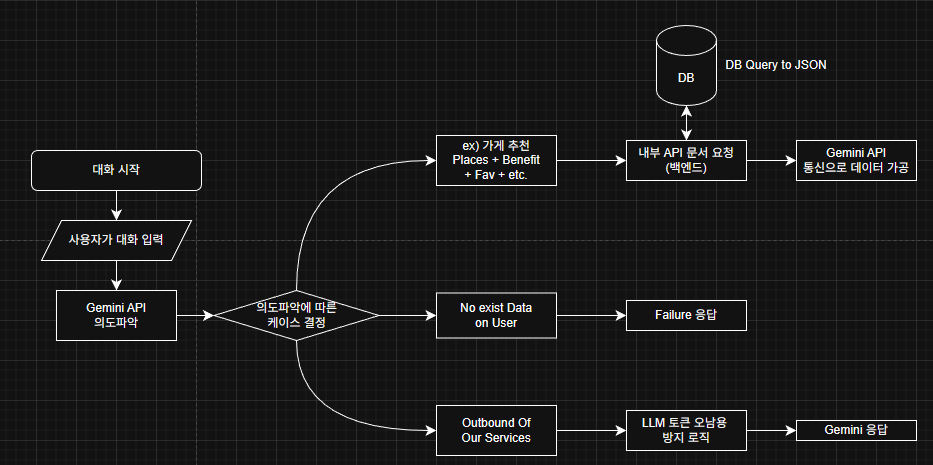
- 사용자가 질문 → LLM API로 의도와 슬롯 추출
- 추출된 키워드(통신사, 등급, 상점명 등)를 백엔드로 전달
- 백엔드는 회원 테이블 기반으로 DB에서 혜택 정보 조회
- 쿼리 결과를 LLM에 다시 전달해 말투만 자연스럽게 수정
- 챗봇이 사용자에게 응답
즉, LLM은 생성보다 의도 파악과 문체 조정에만 사용되고, 실제 검색은 전부 DB 쿼리 기반으로 해결된다.
응답 시나리오 설계
긍정적 응답
→ 현재 위치 기준으로 찾을까요, 아니면 다른 지역(예: 강남역, 신촌 등)을 입력하시겠어요?
이 시점에서
- 사용자의 실시간 위치 권한 확인
- LLM이 응답 분석 및 상태 파악
- 현재 멤버십 조회 API + 카테고리 배열 연동
이 함께 작동한다.
LLM의 응답 템플릿 예시는 다음과 같다.
네, 통신사 할인 혜택을 받을 수 있는 {카테고리}를 찾으시는군요. 통신사와 등급은 {carrier}, {level}이 맞으신가요?
부정적 응답
사용자가 잘못된 카테고리를 선택한 경우
→ 입력하신 카테고리는 지원되지 않아요. 다시 선택해볼까요?
통신사나 등급이 잘못된 경우
→ 통신사 정보가 일치하지 않습니다. 다시 확인해 주세요.
이 과정을 반복하면서 순차적으로 정의가 되면 사용자의 state를 갱신하고, 필요할 때마다 꼬리질문을 자동 생성한다. 이런 구조라면 벡터DB를 추가로 사용할 이유가 없고, 모든 흐름은 DB 쿼리와 룰 플로우로 해결된다.
느낀점
앞으로 나는 사용자 의도 추출을 위한 프롬프트 설계와 로직 순서 파이프라인을 직접 구성하며, 실시간으로 LLM의 응답을 받아 DB 검색과 연결되는 전체 흐름을 구현할 계획이다. 처음엔 룰베이스 방식이 룰을 많이 짜야 하고 유연한 응답이 어렵다고 생각했지만, 막상 적용하려고 해보니 오히려 RAG보다 현재 서비스 환경에 훨씬 적합했다.
LLM은 대화만, 데이터는 DB에서
이 단순한 원칙으로 구조를 설계하면 예상보다 안정적이고 유지보수하기 쉬운 시스템을 만들 수 있을 것이다. 이번 프로젝트는 벡터DB를 사용하지 않는 RAG 유사 구조지만, 향후에는 RAG를 직접 실습하며
- 업데이트 스케줄링 자동화
- 청킹 단위 조정에 따른 성능 실험
- 한국어 특화 임베딩 모델(BGE-m3-ko) 적용
- 마크다운 / 일반 텍스트 데이터셋 비교
- PDF가 아닌 텍스트 전처리 기반 RAG 파이프라인 구성
등을 시도하며 RAG 성능을 단계적으로 개선해볼 계획이다.