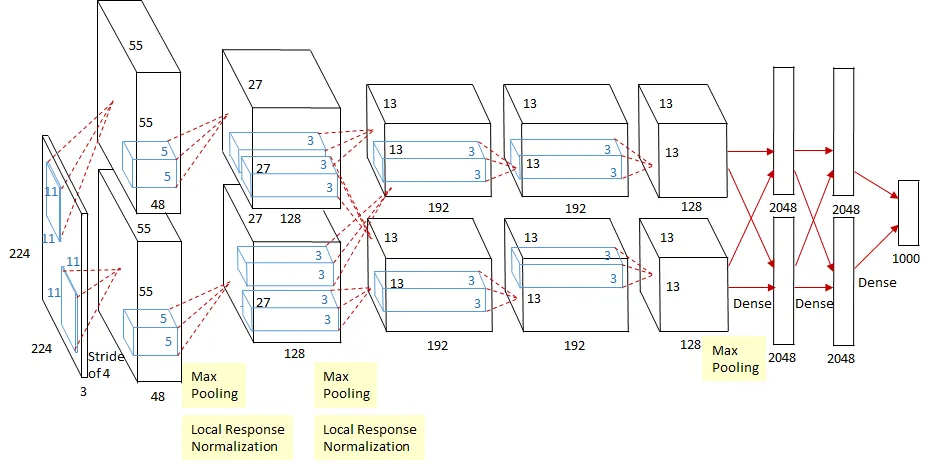
논문: ImageNet Classification with Deep Convolutional Neural Networks (2012)
저자: Alex Krizhevsky, Ilya Sutskever, Geoffrey E. Hinton
AlexNet은 2012년 ImageNet 이미지 분류 대회에서 압도적인 성능을 보이며 딥러닝 기반 컴퓨터 비전이 본격적으로 주목받는 계기를 만든 모델이다. CNN은 이전에도 존재했지만, AlexNet은 대규모 데이터와 GPU를 이용해 깊고 큰 CNN이 실제 이미지 분류 문제에서 얼마나 강력한지 증명했다. 이 글에서는 AlexNet이 해결하려던 문제, 전체 구조, 핵심 기술, 성능과 의미를 한 흐름으로 정리한다.
AlexNet은 어떤 문제를 해결하려 했을까?
AlexNet의 목표는 사진 속 물체를 정확한 클래스로 분류하는 대규모 이미지 분류다. 논문은 ImageNet ILSVRC 데이터셋의 1,000개 클래스를 대상으로 약 120만 장의 학습 이미지를 사용했다.
당시 이미지 분류에서는 SIFT, Fisher Vector처럼 사람이 직접 설계한 특징을 추출한 뒤 분류기를 학습하는 방식이 널리 쓰였다. 하지만 실제 사진에서는 물체의 위치, 자세, 조명, 배경이 계속 달라진다. 사람이 이런 모든 변화에 대응하는 특징을 설계하기는 어렵다.
AlexNet은 이미지에서 필요한 특징을 사람이 만들지 않고 CNN이 데이터로부터 직접 학습하게 했다. 다만 큰 CNN을 학습하려면 계산량이 매우 많고 과적합도 심해진다. 이 논문은 GPU, 빠른 활성화 함수, 데이터 증강, dropout을 조합해 이 문제를 해결했다.
AlexNet의 전체 구조
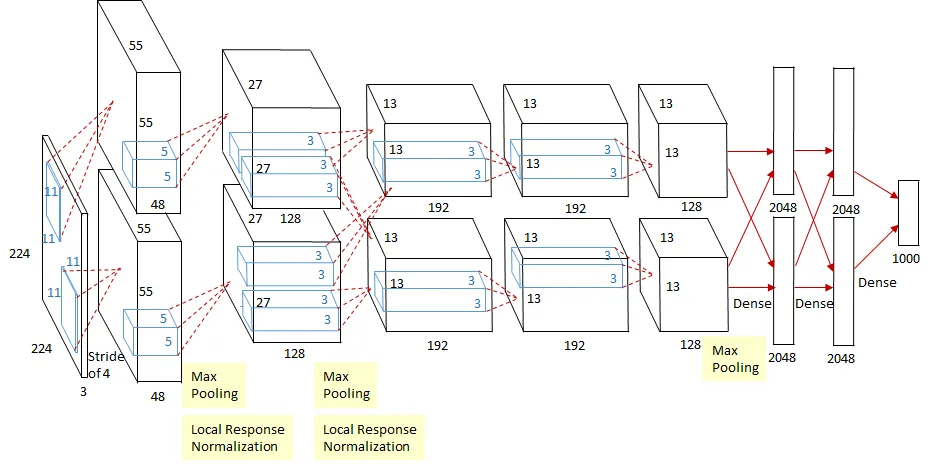
AlexNet은 가중치를 학습하는 8개 층으로 구성된다. 앞의 5개는 합성곱층(Convolutional Layer), 뒤의 3개는 완전연결층(Fully Connected Layer)이다. 마지막 완전연결층은 1,000개 클래스의 확률을 출력하는 Softmax와 연결된다.
입력 이미지 (224 x 224 x 3)
  → Conv1 → ReLU → LRN → Max Pooling
  → Conv2 → ReLU → LRN → Max Pooling
  → Conv3 → ReLU
  → Conv4 → ReLU
  → Conv5 → ReLU → Max Pooling
  → FC6(4096) → ReLU → Dropout
  → FC7(4096) → ReLU → Dropout
  → FC8(1000) → Softmax
합성곱층은 이미지에서 선, 질감, 색상, 물체의 부분처럼 점점 복잡한 특징을 추출한다. 이후 완전연결층은 추출된 특징을 종합해 최종 클래스를 분류한다. 전체 파라미터는 약 6,000만 개로 당시 기준으로 매우 큰 모델이었다.
논문은 합성곱층 하나만 제거해도 Top-1 성능이 약 2%p 떨어진다고 보고했다. 각 층이 단순히 파라미터 수만 늘리는 역할이 아니라 특징을 단계적으로 조합하는 데 중요하다는 뜻이다. 즉, AlexNet의 성능에서 네트워크 깊이가 중요한 역할을 했다.
왜 두 개의 GPU를 사용했을까?
당시 사용한 GTX 580 GPU 한 장의 메모리는 3GB였다. AlexNet은 한 GPU 메모리에 모델 전체를 올리기 어려웠기 때문에 필터와 뉴런을 두 GPU에 나누어 학습했다.
모든 층이 두 GPU와 계속 통신하면 통신 비용이 커진다. 그래서 일부 층에서는 두 GPU의 특징 맵을 함께 사용하고, 다른 층에서는 같은 GPU 안에 있는 특징 맵만 연결했다. 이는 현재의 일반적인 데이터 병렬화와 다르다. 당시에는 메모리 제약 때문에 하나의 모델 자체를 두 GPU에 분할하는 모델 병렬화가 필요했다.
이 구조는 단일 GPU에서 더 작은 모델을 학습한 경우보다 Top-1 오류율을 1.7%p, Top-5 오류율을 1.2%p 낮췄다.
ReLU를 사용한 이유: 큰 모델을 빠르게 학습하기 위해
AlexNet은 기존의 sigmoid나 tanh 대신 ReLU를 사용했다.
ReLU(x) = max(0, x)sigmoid와 tanh는 입력값이 너무 크거나 작아지면 기울기가 거의 0이 되는 포화(saturation) 문제가 있다. 이 경우 역전파 과정에서 학습 신호가 약해져 학습이 느려진다. 반면 ReLU는 양수 구간에서 기울기가 유지되므로 큰 모델에서도 학습 신호가 더 잘 전달된다.
논문에서는 ReLU를 사용한 4층 CNN이 tanh를 사용한 같은 구조의 CNN보다 CIFAR-10에서 학습 오류율 25%에 약 6배 빠르게 도달했다고 보고했다. ReLU는 AlexNet처럼 큰 CNN을 현실적인 시간 안에 학습하게 만든 핵심 요소다.
Max Pooling은 어떤 역할을 할까?
Pooling은 가까운 영역의 특징값을 요약하는 연산이다. AlexNet은 그중 가장 큰 활성값을 남기는 Max Pooling을 사용했다.
Max Pooling은 특징 맵의 크기를 줄여 계산량을 낮추고, 물체가 이미지 안에서 조금 이동해도 비슷한 특징을 인식하도록 돕는다. 예를 들어 고양이의 귀가 이미지 안에서 몇 픽셀 이동해도, 귀를 감지하는 강한 특징값은 남길 수 있다.
AlexNet은 3 x 3 풀링 창을 stride 2로 이동하는 Overlapping Pooling을 사용했다. 풀링 영역이 일부 겹치게 하여 출력 크기가 같은 일반적인 비중첩 풀링보다 Top-1 오류율을 0.4%p, Top-5 오류율을 0.3%p 낮췄다.
과적합은 어떻게 줄였을까?
6,000만 개 파라미터를 가진 AlexNet은 학습 이미지가 120만 장이어도 과적합 위험이 컸다. 논문은 이를 줄이기 위해 데이터 증강과 dropout을 사용했다.
Data Augmentation: 같은 이미지를 여러 상황으로 보여주기
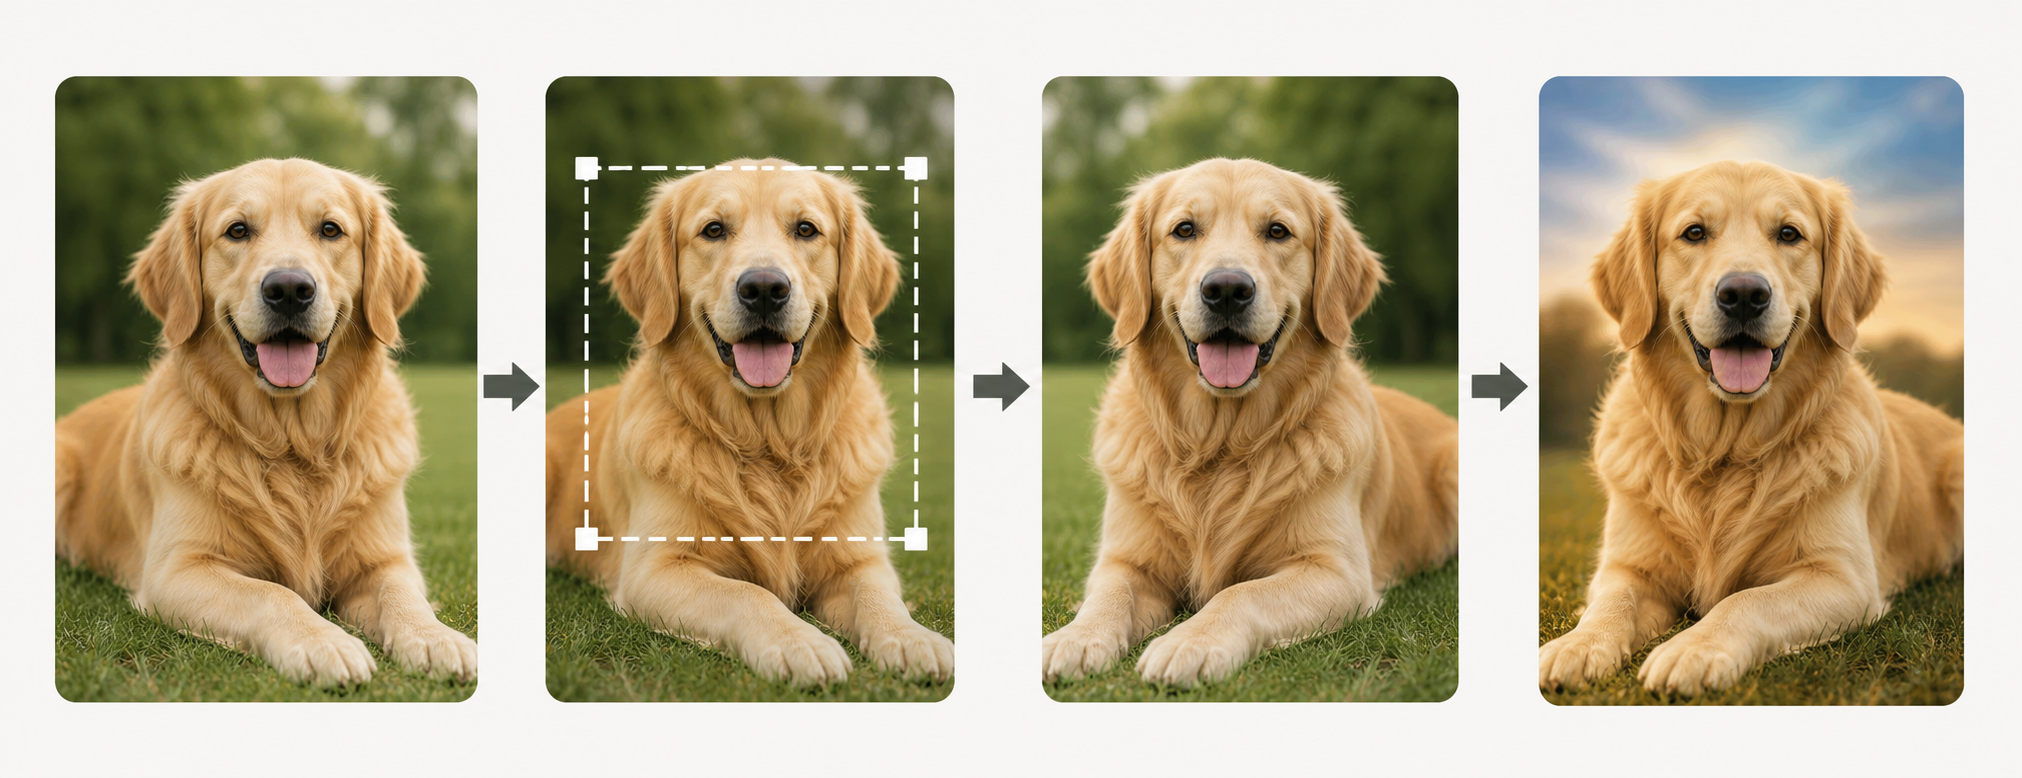
사진 : 원본 → 크롭 → 좌우 반전 → 색상 변화 흐름
첫 번째 방법은 256 x 256 이미지에서 무작위로 224 x 224 영역을 잘라내는 랜덤 크롭과 좌우 반전이다. 크롭은 이미지의 일부 영역을 잘라 사용하는 것을 뜻한다. 같은 고양이 사진이라도 왼쪽 위, 가운데, 오른쪽 아래에서 조금씩 다르게 잘라 학습에 사용한다.
이 방법은 물체의 위치가 달라지거나 좌우로 뒤집혀도 같은 클래스라는 점을 모델이 학습하게 만든다. 테스트 시에는 네 모서리와 중앙에서 자른 5개 패치, 그리고 각 패치의 좌우 반전본까지 총 10개를 사용하고, 이들의 Softmax 예측을 평균낸다.
두 번째 방법은 PCA 기반 색상 증강이다. ImageNet의 RGB 픽셀값에서 자주 나타나는 색상 변화 패턴을 PCA로 찾은 뒤 각 이미지 전체의 밝기와 색감을 조금씩 무작위로 바꾼다. PCA는 데이터에서 가장 큰 변화 방향을 찾는 방법이며, RGB 공분산은 빨강·초록·파랑 값이 함께 어떻게 변하는지를 나타낸다.
핵심은 픽셀마다 제멋대로 색을 바꾸는 것이 아니라 사진 전체에 같은 색감 변화를 적용한다는 점이다. 그래서 조명 색이나 밝기가 바뀐 것처럼 자연스러운 변형이 된다. 이 방법은 조명이 달라져도 물체의 정체성은 같다는 성질을 반영하며, 논문에서는 Top-1 오류율을 1%p 이상 낮췄다.
Dropout: 뉴런이 서로에게 과도하게 의존하지 않게 하기
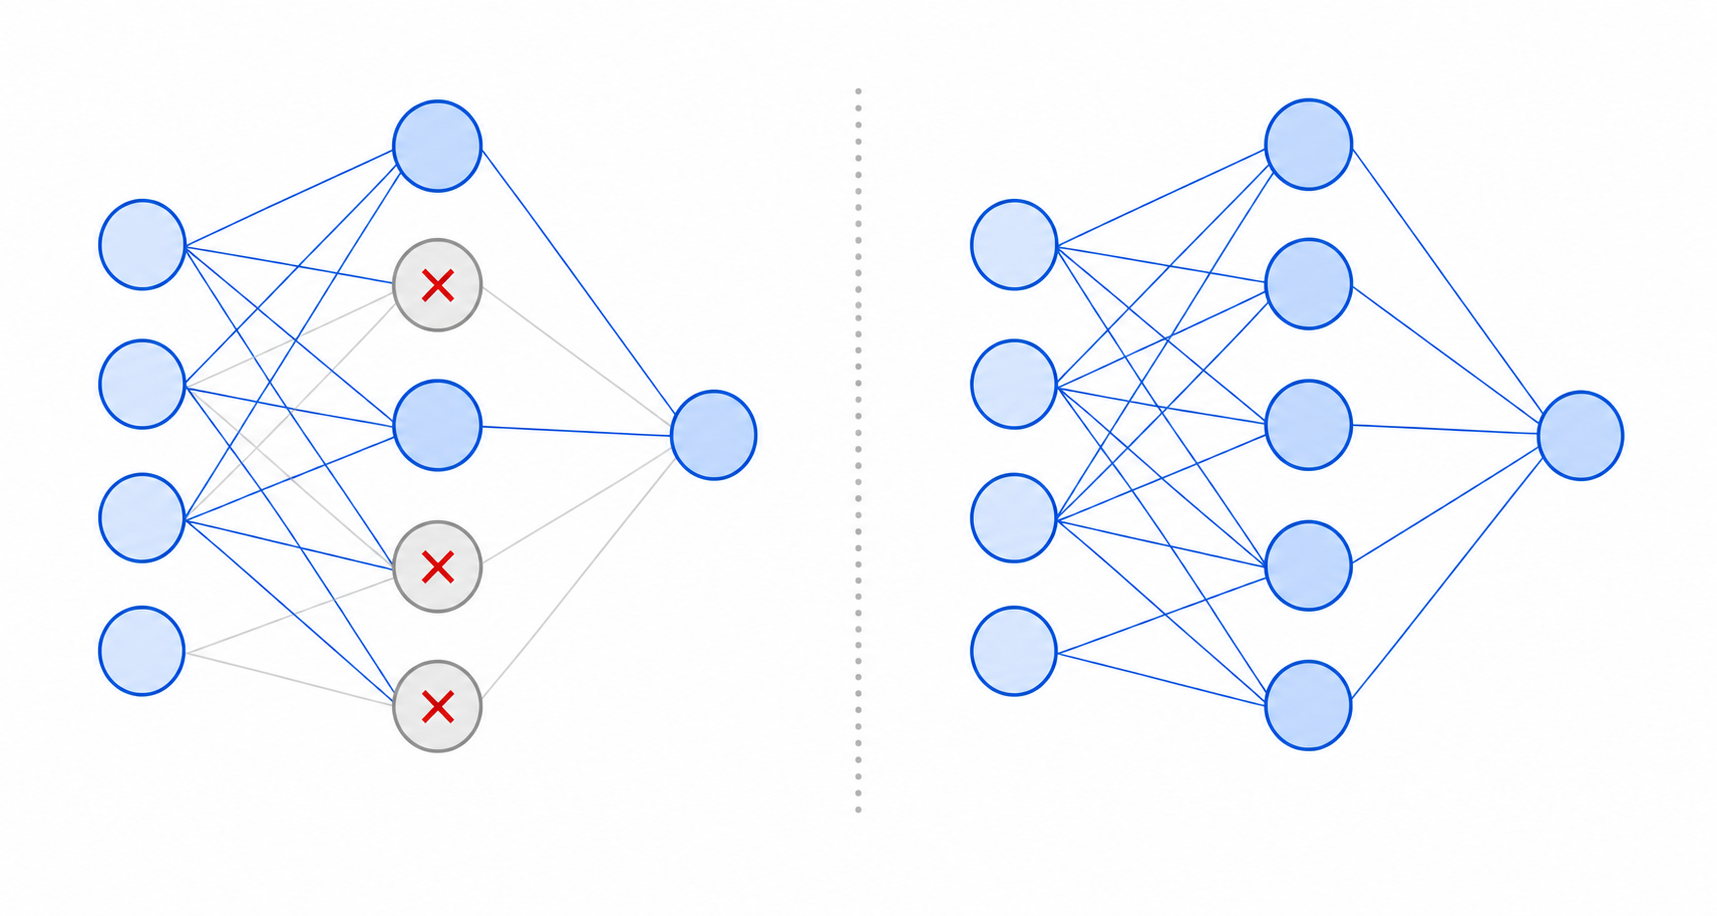
사진 : 왼쪽은 학습 중 일부 뉴런이 꺼진 상태, 오른쪽은 테스트 시 모든 뉴런을 사용하는 상태
여러 모델의 예측을 합치는 앙상블은 정확도를 높이지만, 큰 모델을 여러 개 학습하는 비용은 매우 크다. Dropout은 한 모델 안에서 앙상블과 비슷한 효과를 내는 기법이다.
AlexNet은 학습할 때 첫 두 완전연결층의 은닉 뉴런을 각각 0.5 확률로 끈다. 꺼진 뉴런은 그 학습 단계의 순전파와 역전파에 참여하지 않는다. 매번 다른 일부 뉴런만 남기므로 모델은 여러 작은 네트워크를 가중치 공유 방식으로 학습하는 것과 비슷해진다.
그 결과 특정 뉴런들이 항상 함께 존재한다고 가정할 수 없고, 각 뉴런은 더 다양한 조합에서도 쓸 수 있는 견고한 특징을 학습해야 한다. AlexNet에서는 특히 파라미터가 많은 완전연결층의 과적합을 줄이는 데 필요했다. 다만 dropout을 사용하면 수렴까지 필요한 학습 반복 횟수는 대략 두 배로 늘어난다.
LRN은 무엇이고, 지금도 사용할까?
LRN(Local Response Normalization)은 같은 위치에서 여러 필터가 강하게 반응할 때 서로 경쟁하도록 만드는 정규화 방식이다. 실제 신경세포의 측면 억제(lateral inhibition)에서 영감을 받았다. AlexNet에서는 ReLU 뒤의 일부 층에 적용했고, Top-1 오류율을 1.4%p, Top-5 오류율을 1.2%p 낮췄다.
하지만 현재 CNN에서는 LRN보다 Batch Normalization이나 Layer Normalization이 더 널리 사용된다. 따라서 LRN은 AlexNet 당시에는 의미 있는 기술이었지만 현재의 표준적인 CNN 구성요소는 아니다.
AlexNet의 성능은 얼마나 뛰어났을까?
ILSVRC-2010에서 AlexNet은 Top-1 오류율 37.5%, Top-5 오류율 17.0%를 기록했다.
| 방법 | Top-1 오류율 | Top-5 오류율 |
|---|---|---|
| Sparse Coding 앙상블 | 47.1% | 28.2% |
| SIFT + Fisher Vector 앙상블 | 45.7% | 25.7% |
| AlexNet | 37.5% | 17.0% |
이전 최고 발표 결과와 비교하면 AlexNet은 Top-1 오류율을 8.2%p, Top-5 오류율을 8.7%p 낮췄다. 이는 작은 개선이 아니라, 사람이 설계한 특징 기반 방식보다 CNN이 직접 학습한 표현이 훨씬 강력할 수 있음을 보여준 큰 성능 차이였다.
ILSVRC-2012에서는 단일 CNN이 Top-5 오류율 18.2%를 기록했고, CNN 5개의 예측을 평균내면 16.4%가 됐다. 더 큰 ImageNet 전체 데이터로 사전학습한 모델까지 포함한 7개 CNN 앙상블은 최종 테스트 Top-5 오류율 15.3%를 달성했다. 당시 2위 방법의 오류율은 26.2%였다.
Top-1 오류율은 모델이 가장 높은 확률로 고른 클래스가 틀린 비율이고, Top-5 오류율은 모델의 상위 5개 예측 안에 정답이 없는 비율이다. ImageNet처럼 시각적으로 비슷한 세부 클래스가 많은 문제에서는 Top-5도 중요한 평가 지표다.
현재 기준에서 본 AlexNet
AlexNet에서 지금도 중요한 기술은 ReLU 계열 활성화 함수, 데이터 증강, dropout, Max Pooling, SGD 기반 최적화, 대규모 GPU 학습이다. 특히 ReLU와 데이터 증강은 이후의 많은 비전 모델에서도 기본적인 구성으로 남아 있다.
반면 LRN과 AlexNet 특유의 제한적 2-GPU 연결 방식은 현재 많이 사용되지 않는다. 또한 AlexNet의 첫 합성곱층은 11 x 11 필터와 큰 stride를 사용했지만, 후속 모델은 작은 3 x 3 필터를 여러 층 쌓아 공간 정보를 더 오래 유지하는 방식을 자주 사용한다.
읽으며 어려웠던 부분과 느낀 점
가장 이해하기 어려웠던 부분은 LRN 수식과 두 GPU 사이의 제한적 연결 방식이었다. 특히 LRN은 여러 커널 맵의 활성값을 함께 사용해 하나의 출력을 조정하기 때문에 수식만 보면 직관적으로 이해하기 쉽지 않았다. 하지만 이를 "같은 위치에서 여러 필터가 강하게 반응할 때 서로 경쟁하도록 만드는 방법"이라고 이해하니 목적을 파악할 수 있었다.
이 논문을 통해 가장 중요하게 알게 된 점은 딥러닝의 성능이 모델 구조 하나로 결정되지 않는다는 것이다. AlexNet은 큰 CNN을 사용했지만, ReLU로 학습 속도를 높이고 GPU로 계산량을 감당하며 데이터 증강과 dropout으로 과적합을 줄였기 때문에 좋은 성능을 낼 수 있었다.
논문을 읽기 전에는 AlexNet이 단순히 CNN 층을 많이 쌓은 모델이라고 생각했다. 그런데 ReLU, GPU 두 장 사용, 데이터 증강, dropout 등 여러 방법을 함께 적용해야 큰 모델을 실제로 학습할 수 있었다는 점을 알게 되었다. 특히 좋은 모델을 만들려면 구조만 잘 정하는 것이 아니라, 데이터와 학습 방법도 같이 고민해야 한다는 것을 알게 되었다. 지금은 LRN처럼 잘 쓰이지 않는 기술도 있지만, 당시에는 이런 시도가 쌓여서 현재의 CNN 발전으로 이어졌다고 느꼈다.
