자료구조 조사 및 구현 과제: 트리(Tree)
1. 트리란?
트리(Tree)는 데이터를 계층 구조로 표현하는 비선형 자료구조이다.
하나의 시작점에서 여러 갈래로 뻗어나가는 구조가 나무를 거꾸로 뒤집어 놓은 모습과 비슷해서 트리라고 부른다.
        A
      /   \
     B     C
    / \   / \
   D   E F   G
위 그림에서 A는 가장 위에 있는 노드이고, B, C는 A 아래에 연결된 노드이다.
트리는 회사 조직도, 폴더 구조, HTML 문서 구조처럼 상하 관계가 있는 데이터를 표현할 때 적합하다.
1.1 그림으로 보는 트리 구조
트리는 위에서 아래로 내려가며 읽는다. 가장 위에 있는 노드가 시작점이고, 아래로 내려갈수록 더 세부적인 데이터가 나온다.
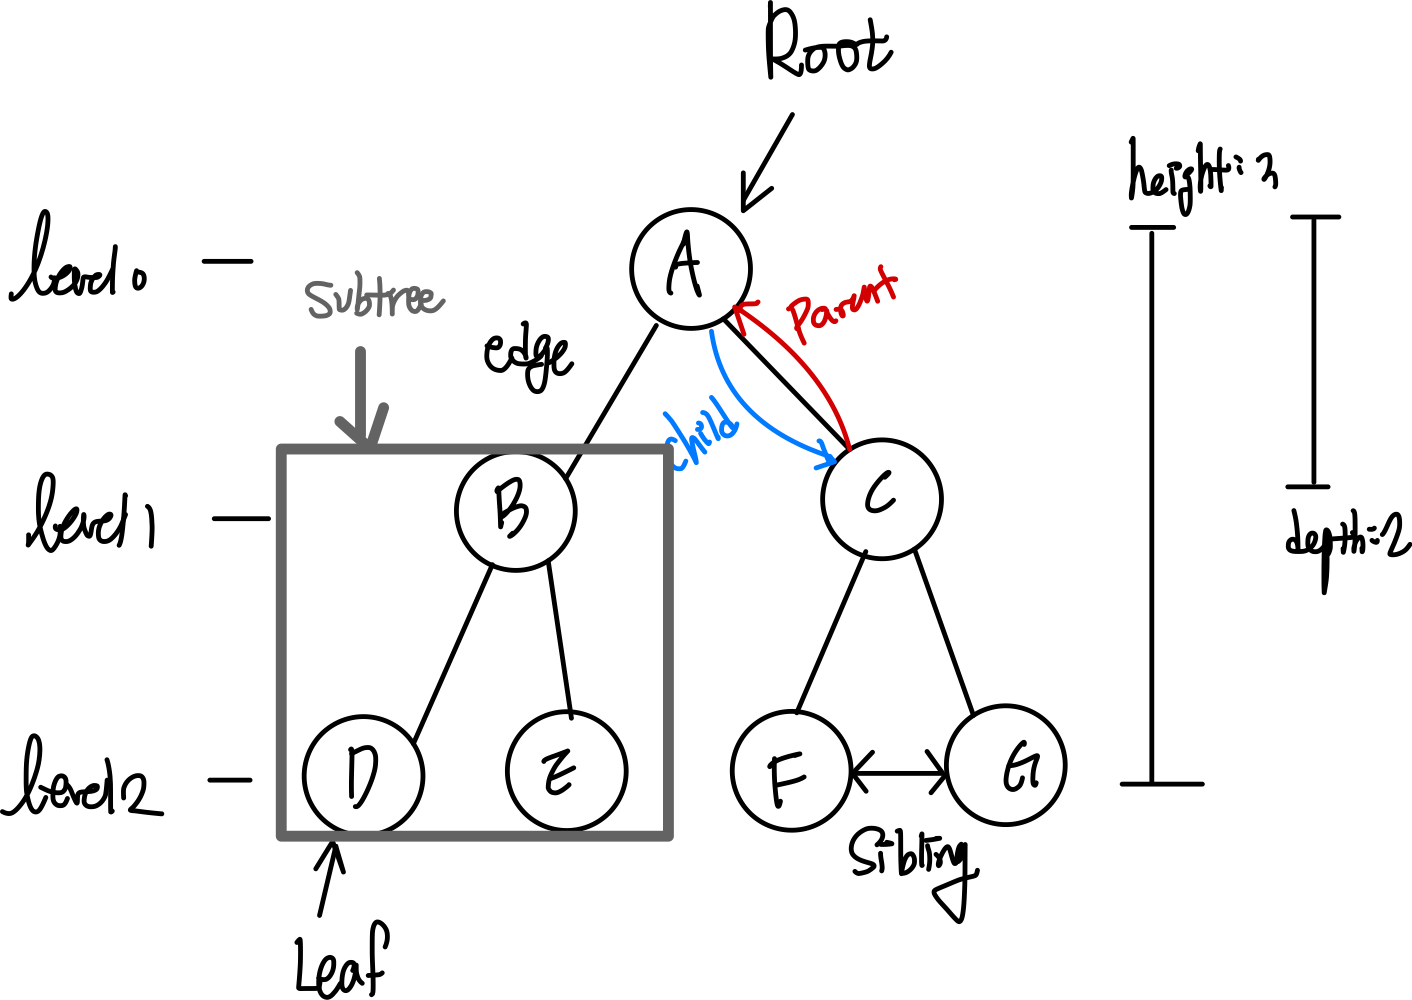
이 그림에서 선은 단순한 장식이 아니라 부모와 자식의 연결 관계를 의미한다.
즉, A와 B 사이의 선은 A가 B를 자식으로 가진다는 뜻이다.
트리를 코드로 만들 때도 이 관계를 그대로 표현한다.
root = A
A.left = B
A.right = C
B.left = D
B.right = E
C.left = F
C.right = G
2. 트리를 사용하는 이유
트리는 데이터 사이에 부모-자식 관계가 있을 때 유용하다.
예를 들어 다음과 같은 데이터는 단순한 한 줄 목록보다 트리로 표현하는 것이 자연스럽다.
- 컴퓨터 폴더 구조
- 회사 조직도
- 댓글과 대댓글 구조
- 웹 페이지의 HTML DOM 구조
- 이진 탐색 트리
- 게임의 선택지 구조
- 인공지능 탐색 트리
2.1 폴더 구조 예시
project/
├── main.py
├── data/
│   ├── users.csv
│   └── sales.csv
└── images/
    ├── logo.png
    └── banner.png
폴더 안에 파일과 하위 폴더가 있고, 하위 폴더 안에 다시 파일이 들어간다.
이런 계층 구조는 트리로 표현하기 좋다.
3. 배열과 트리의 차이점
배열(Array)은 데이터를 순서대로 나열하는 선형 자료구조이다.
트리(Tree)는 데이터가 부모-자식 관계로 연결되는 비선형 자료구조이다.
| 구분 | 배열(Array) | 트리(Tree) |
|---|---|---|
| 구조 | 일렬로 나열 | 계층적으로 연결 |
| 관계 | 앞뒤 순서 중심 | 부모-자식 관계 중심 |
| 접근 방식 | 인덱스 사용 | 루트부터 연결을 따라 이동 |
| 사용 예시 | 점수 목록, 상품 목록 | 폴더 구조, 조직도, DOM |
| 장점 | 인덱스 조회가 빠름 | 계층 관계 표현에 적합 |
| 단점 | 계층 구조 표현이 어려움 | 구현과 탐색이 배열보다 복잡 |
배열은 다음처럼 한 줄로 데이터를 저장한다.
[A, B, C, D, E]트리는 다음처럼 데이터 사이의 관계를 함께 표현한다.
        A
      /   \
     B     C
    / \
   D   E
4. 트리의 주요 용어
트리를 이해하려면 기본 용어를 알아야 한다.
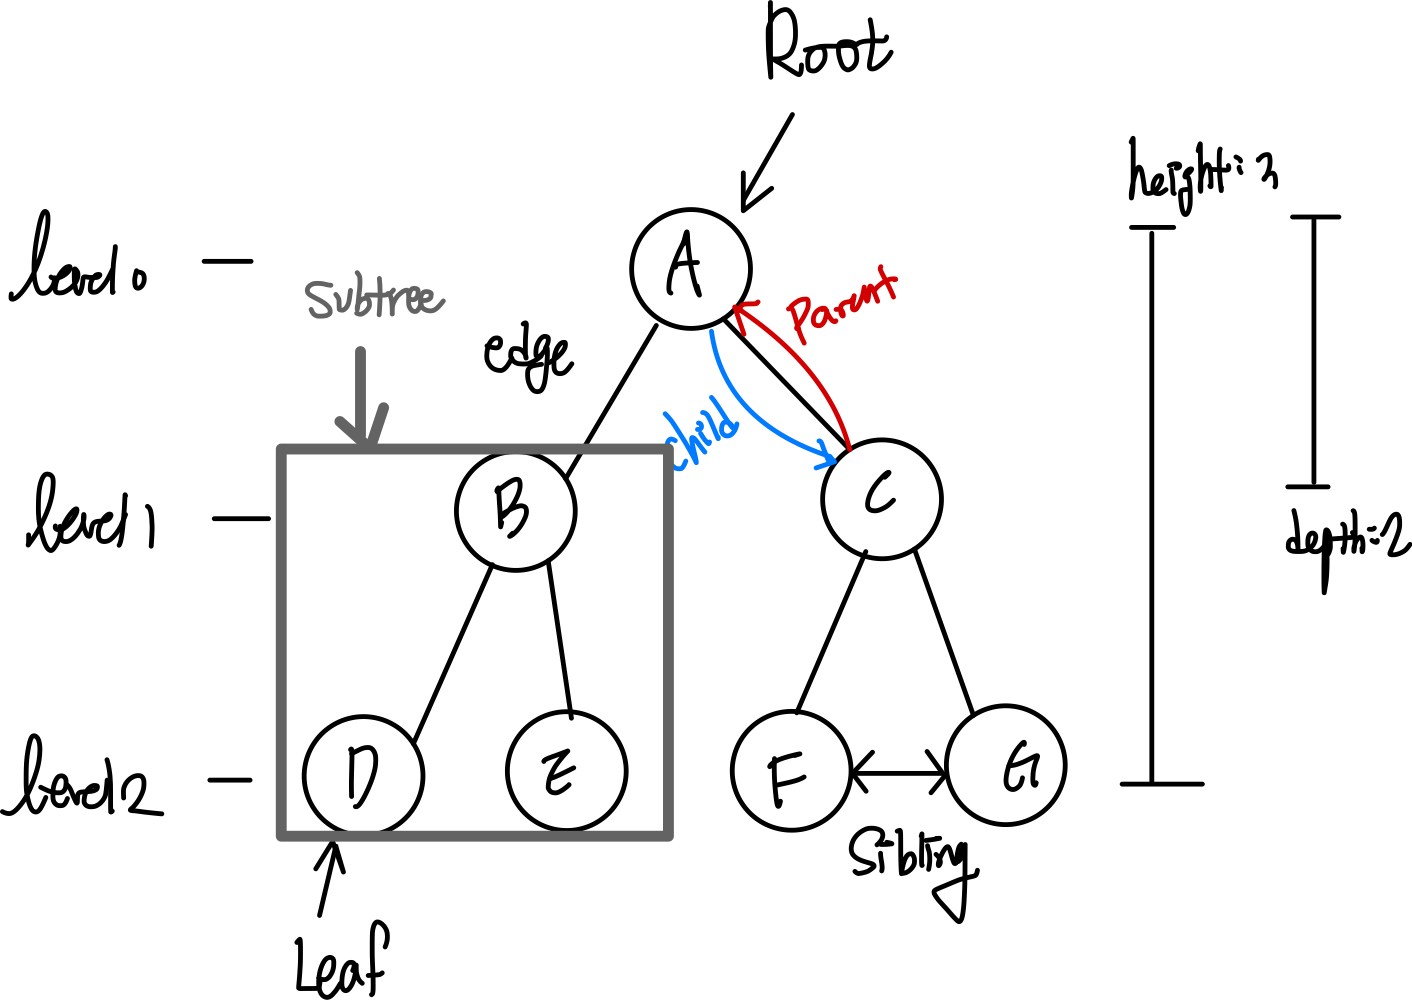
| 용어 | 의미 | 위 그림의 예 |
|---|---|---|
| Node | 데이터를 저장하는 하나의 요소 | A, B, C, D, E, F |
| Root Node | 트리의 가장 위에 있는 시작 노드 | A |
| Parent Node | 특정 노드의 바로 위 노드 | B는 D와 E의 부모 |
| Child Node | 특정 노드의 바로 아래 노드 | D와 E는 B의 자식 |
| Leaf Node | 자식이 없는 노드 | D, E, F |
| Depth | 루트에서 특정 노드까지의 거리 | A의 깊이는 0, B의 깊이는 1 |
| Sibling | 동일한 부모 노드를 공유하는 노드 | F, G |
| Level | 같은 깊이에 있는 노드들의 단계 | A의 레벨은 0, B, C 의 레벨은 1 |
| Height | 특정 노드에서 가장 먼 리프 노드까지의 거리 | height = 3 |
4.1 Node
노드(Node)는 트리에서 데이터를 저장하는 기본 단위이다.
+--------+
|  data  |
+--------+
트리에서는 노드들이 서로 연결되어 부모-자식 관계를 만든다.
예를 들어 위 그림에서는 A, B, C, D, E, F가 모두 노드이다.
노드는 단순히 값만 저장하는 것이 아니라, 자식 노드와 연결될 수 있는 하나의 데이터 단위이다.
4.2 Root Node
루트 노드(Root Node)는 트리의 시작점이다.
트리에는 루트 노드가 하나만 있다.
        A  ← Root Node
      /   \
     B     C
루트 노드는 트리에 접근하기 위한 입구 역할을 한다.
링크드 리스트에서 head가 첫 번째 노드를 가리키는 것처럼, 트리에서는 보통 root가 시작 노드를 가리킨다.
4.3 Parent / Child Node
부모 노드(Parent Node)는 어떤 노드의 바로 위에 있는 노드이고, 자식 노드(Child Node)는 어떤 노드의 바로 아래에 연결된 노드이다.
        B  ← Parent Node
       / \
      /   \
     D     E
     ↑     ↑
 Child   Child
위 그림에서 B는 D, E의 부모이다.
반대로 D, E는 B의 자식이다.
중요한 점은 부모와 자식 관계는 기준 노드에 따라 달라진다는 것이다.
        A
       /
      B
     /
DA를 기준으로 보면B는 자식이다.B를 기준으로 보면A는 부모이고,D는 자식이다.
4.4 Leaf Node
리프 노드(Leaf Node)는 자식이 없는 노드이다.
트리의 끝에 있는 노드라고 볼 수 있다.
        A
      /   \
     B     C
    / \     \
   D   E     F

Leaf Node: D, E, F
리프 노드는 더 이상 아래로 뻗어나가지 않는 마지막 노드이다.
폴더 구조로 비유하면, 더 이상 하위 폴더가 없는 마지막 파일이나 폴더처럼 생각할 수 있다.
4.5 Depth
깊이(Depth)는 루트 노드에서 특정 노드까지 이동하는 간선의 개수이다.
Depth 0:        A
              /   \
Depth 1:     B     C
            / \     \
Depth 2:   D   E     F
루트 노드의 깊이는 0이다.
루트에서 한 단계 내려가면 깊이는 1이 된다.
조금 더 자세히 보면 다음과 같다.
        A
       / \
      B   C
     / \
    D   E

A의 깊이: 0
B의 깊이: 1
C의 깊이: 1
D의 깊이: 2
E의 깊이: 2
깊이는 루트에서 얼마나 멀리 떨어져 있는지를 나타낸다.
트리 알고리즘에서는 특정 노드의 위치나 탐색 범위를 판단할 때 깊이 개념이 자주 사용된다.
4.6 Level과 Height
레벨(Level) 은 같은 깊이에 있는 노드들의 단계이다.
Level 0:        A
              /   \
Level 1:     B     C
            / \     \
Level 2:   D   E     F
위 그림에서 B와 C는 같은 레벨에 있다.
D, E, F도 같은 레벨에 있다.
높이(Height)는 아래 방향으로 얼마나 더 내려갈 수 있는지를 나타낸다.
        A
       / \
      B   C
     / \
    D   E

D의 높이: 0
E의 높이: 0
B의 높이: 1
A의 높이: 2
리프 노드의 높이는 0이다.
루트 노드의 높이는 트리 전체의 높이가 된다.
5. 트리 순회
트리 순회(Tree Traversal)는 트리의 모든 노드를 일정한 순서로 방문하는 방법이다.
대표적인 깊이 우선 순회 방식은 다음 세 가지이다.
| 순회 방식 | 방문 순서 |
|---|---|
| 전위 순회 | Root -> Left -> Right |
| 중위 순회 | Left -> Root -> Right |
| 후위 순회 | Left -> Right -> Root |
아래 트리를 기준으로 순회 방식을 살펴본다.
        A
      /   \
     B     C
    / \   / \
   D   E F   G
6. 전위 순회
전위 순회(Preorder)는 현재 노드(Root)를 먼저 방문하고, 왼쪽 자식, 오른쪽 자식 순서로 방문한다.
방문 순서:
Root -> Left -> Right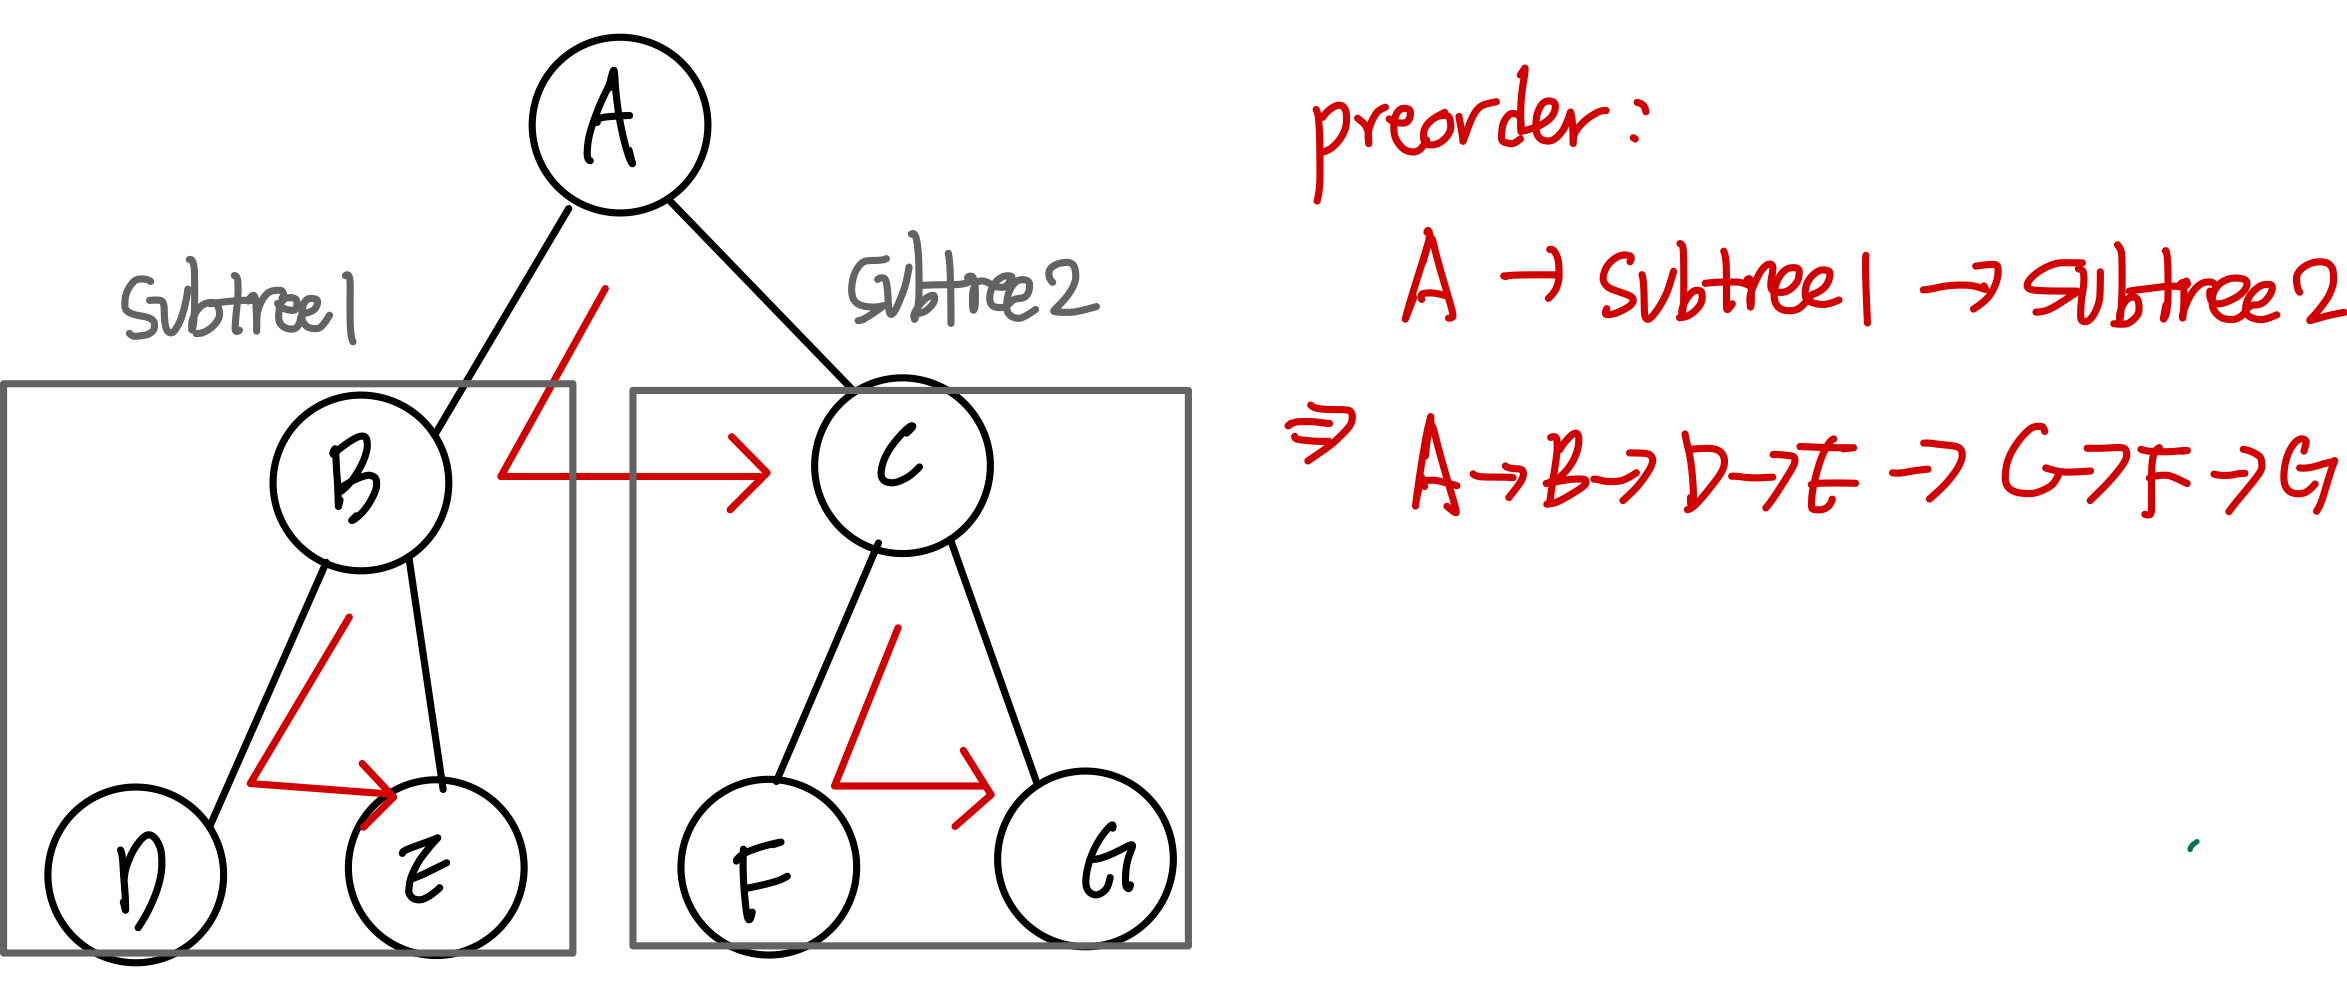
6.1 전위 순회 Python 예제
class Node:
    def __init__(self, data):
        self.data = data
        self.left = None
        self.right = None


def preorder(node):
    if node is None:
        return

    print(node.data, end=" ")
    preorder(node.left)
    preorder(node.right)


root = Node("A")
root.left = Node("B")
root.right = Node("C")
root.left.left = Node("D")
root.left.right = Node("E")
root.right.left = Node("F")
root.right.right = Node("G")

preorder(root)
출력 결과:
A B D E C F G전위 순회는 루트를 먼저 방문하기 때문에 트리 구조를 복사하거나 저장할 때 자주 사용된다.
7. 중위 순회
중위 순회(Inorder)는 왼쪽 자식을 먼저 방문하고, 현재 노드(Root)를 방문한 뒤, 오른쪽 자식을 방문한다.
방문 순서:
Left -> Root -> Right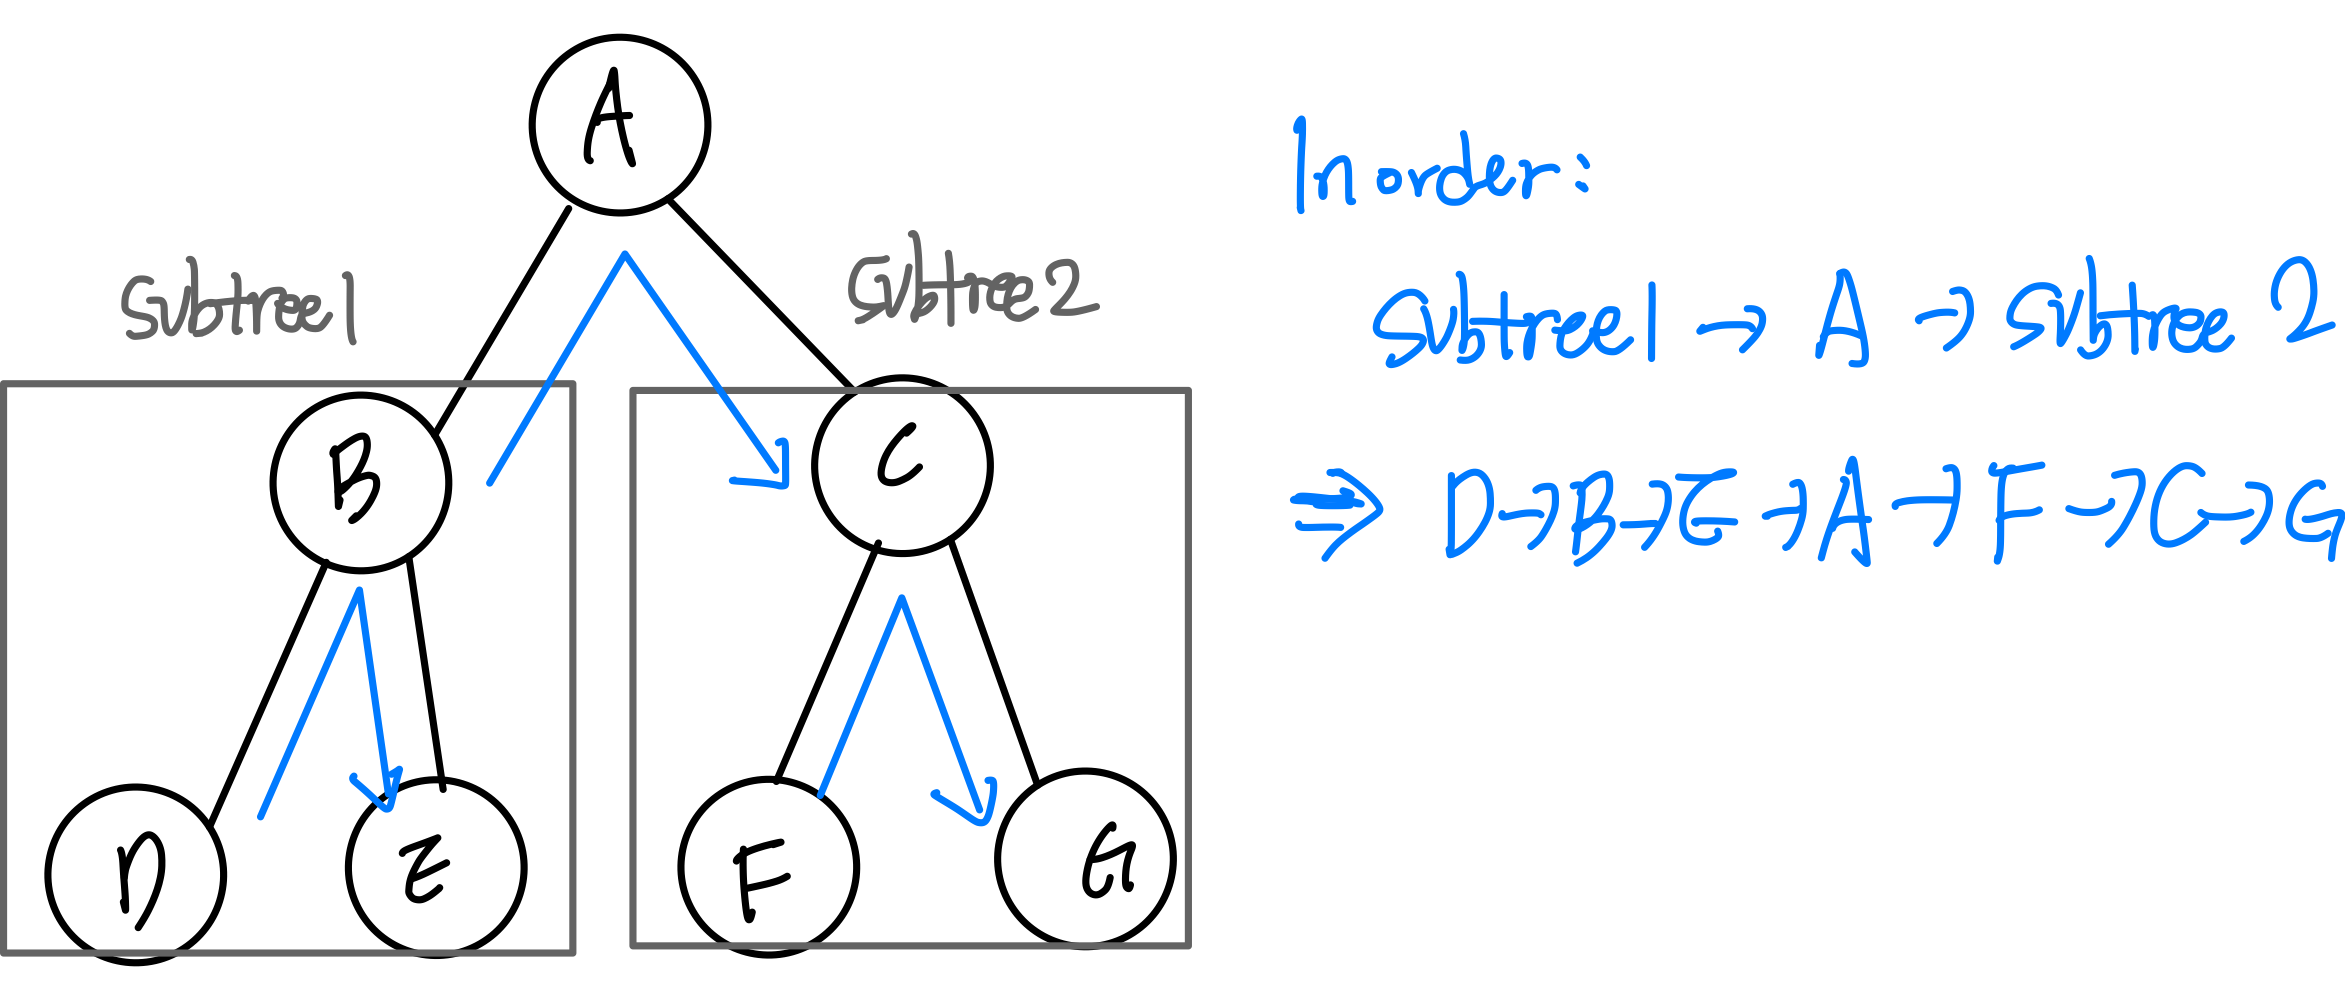
7.1 중위 순회 Python 예제
class Node:
    def __init__(self, data):
        self.data = data
        self.left = None
        self.right = None


def inorder(node):
    if node is None:
        return

    inorder(node.left)
    print(node.data, end=" ")
    inorder(node.right)


root = Node("A")
root.left = Node("B")
root.right = Node("C")
root.left.left = Node("D")
root.left.right = Node("E")
root.right.left = Node("F")
root.right.right = Node("G")

inorder(root)
출력 결과:
D B E A F C G중위 순회는 이진 탐색 트리(Binary Search Tree)에서 값을 오름차순으로 출력할 때 많이 사용된다.
8. 후위 순회
후위 순회(Postorder)는 왼쪽 자식, 오른쪽 자식을 먼저 방문하고 마지막에 현재 노드(Root)를 방문한다.
방문 순서:
Left -> Right -> Root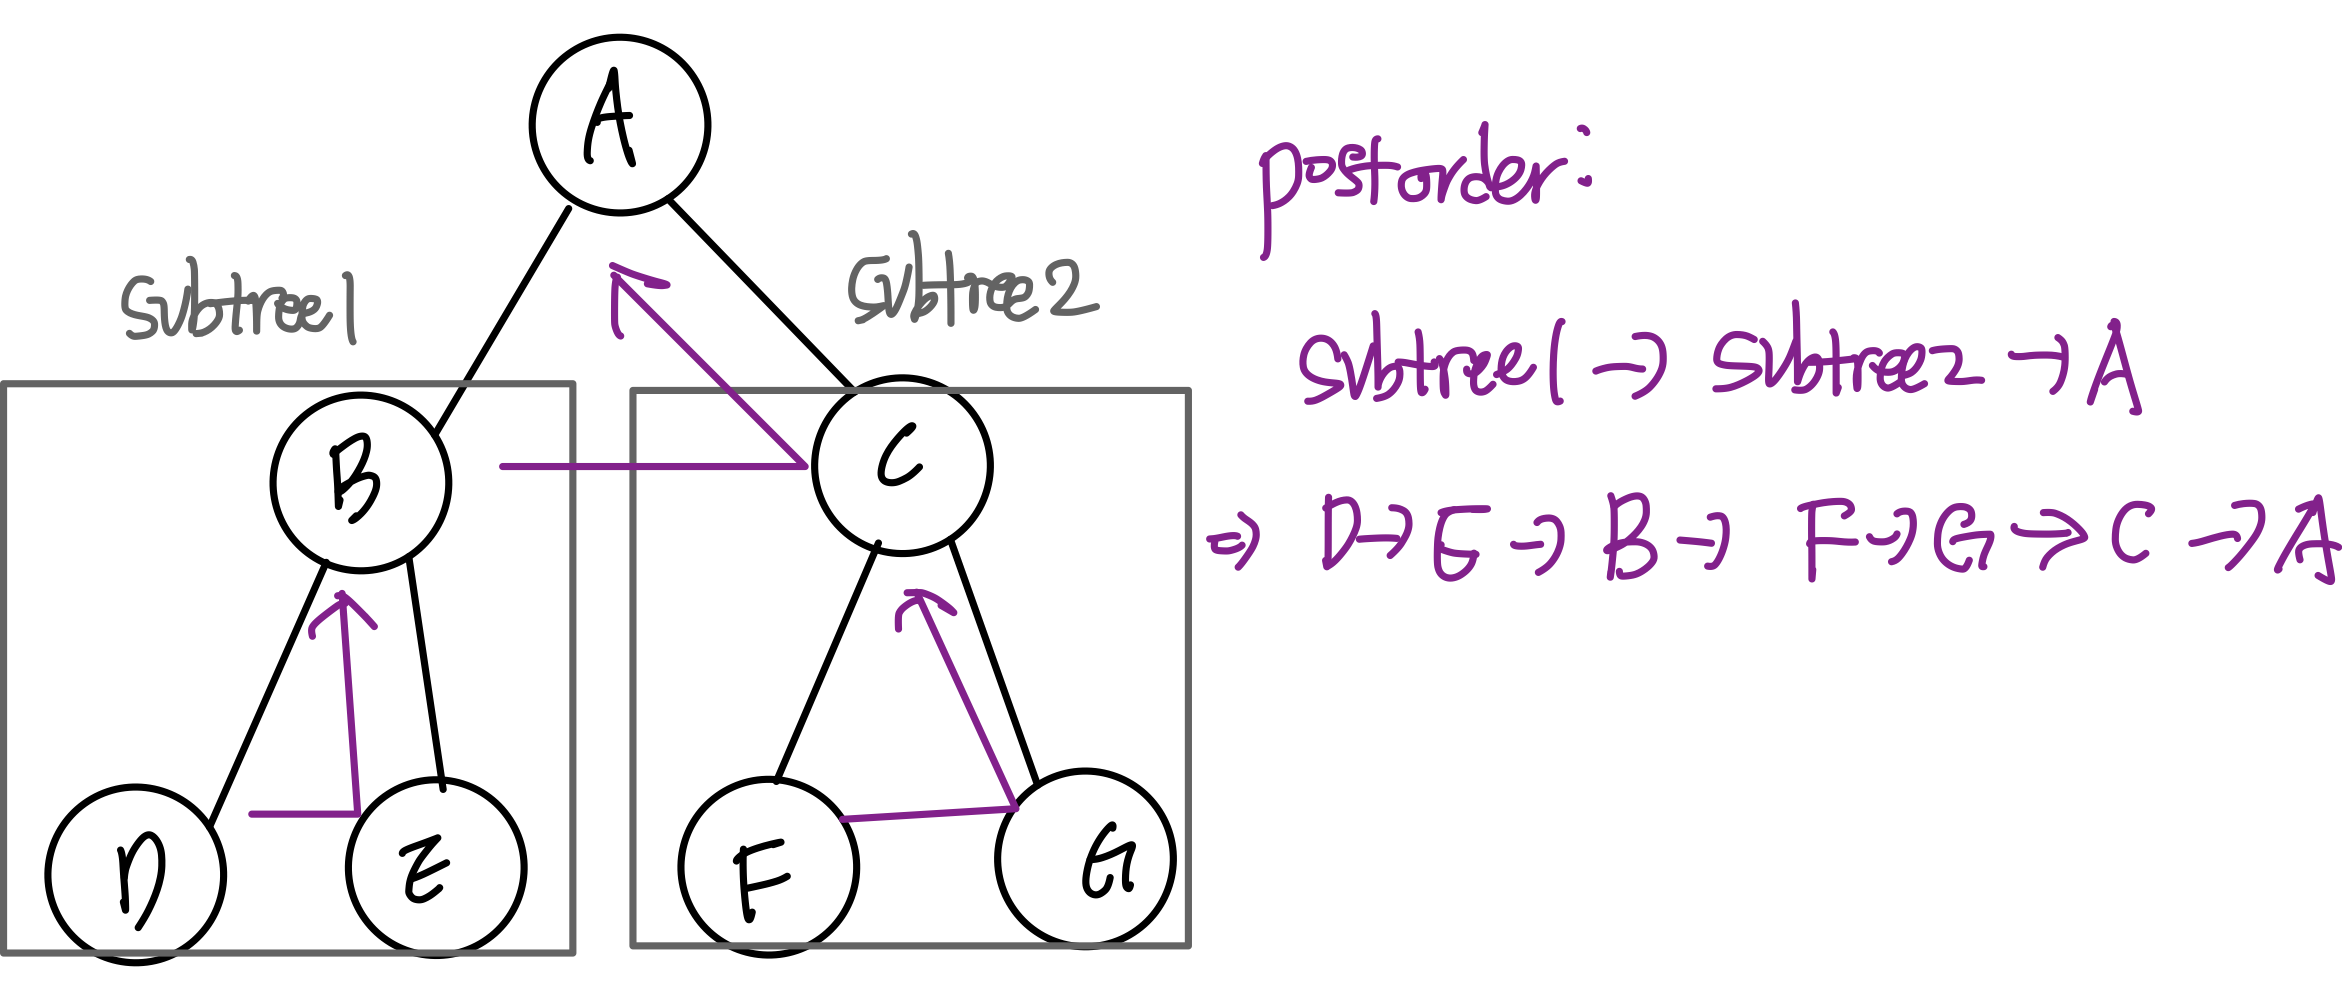
8.1 후위 순회 Python 예제
class Node:
    def __init__(self, data):
        self.data = data
        self.left = None
        self.right = None


def postorder(node):
    if node is None:
        return

    postorder(node.left)
    postorder(node.right)
    print(node.data, end=" ")


root = Node("A")
root.left = Node("B")
root.right = Node("C")
root.left.left = Node("D")
root.left.right = Node("E")
root.right.left = Node("F")
root.right.right = Node("G")

postorder(root)
출력 결과:
D E B F G C A후위 순회는 자식 노드를 먼저 처리하고 부모 노드를 처리해야 하는 상황에 적합하다. 예를 들어 폴더 내부 파일을 먼저 삭제한 뒤 폴더를 삭제하는 작업을 생각할 수 있다.
9. 파이썬으로 간단한 트리 구현하기
이제 Node 클래스를 만들고 노드를 직접 연결해 트리를 구현한다.
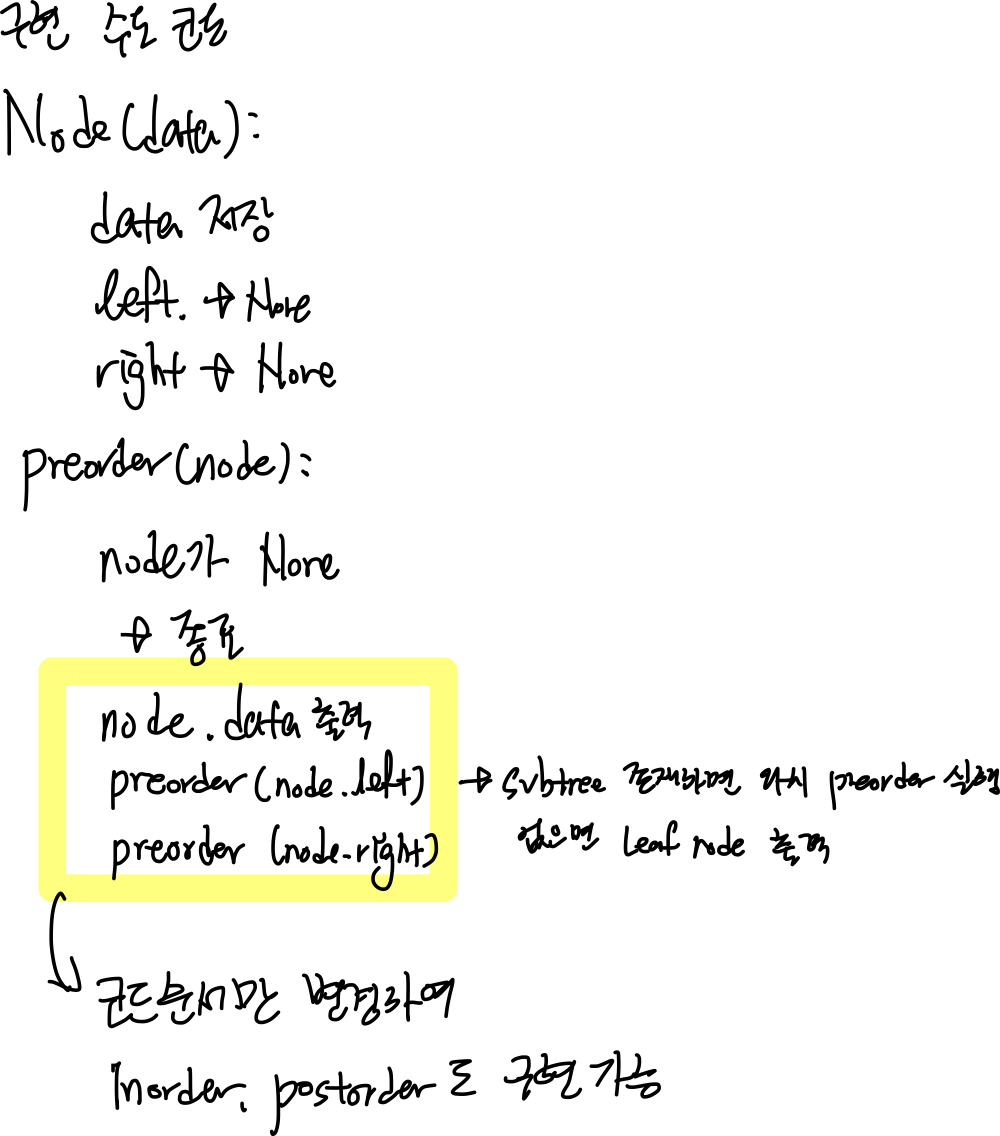
9.1 Node 클래스
class Node:
    def __init__(self, data):
        # 노드에 저장할 값
        self.data = data

        # 왼쪽 자식 노드
        self.left = None

        # 오른쪽 자식 노드
self.right = NoneNode는 하나의 데이터를 저장하고, 왼쪽 자식과 오른쪽 자식을 가리킨다.
9.2 트리 연결하기
class Node:
    def __init__(self, data):
        self.data = data
        self.left = None
        self.right = None


root = Node("A")
root.left = Node("B")
root.right = Node("C")

root.left.left = Node("D")
root.left.right = Node("E")
root.right.left = Node("F")
root.right.right = Node("G")
위 코드는 다음 트리를 만든다.
        A
      /   \
     B     C
    / \   / \
   D   E F   G
코드와 그림을 연결해서 보면 다음과 같다.
root = Node("A")

root
 ↓
[A]
root.left = Node("B")
root.right = Node("C")

        [A]
       /   \
     [B]   [C]
root.left.left = Node("D")
root.left.right = Node("E")

        [A]
       /   \
     [B]   [C]
     / \
   [D] [E]
root.right.left = Node("F")
root.right.right = Node("G")

        [A]
       /   \
     [B]   [C]
     / \   / \
[D] [E][F][G]root.left.left처럼 점(.)을 여러 번 사용하는 것은 연결된 노드를 따라 내려간다는 뜻이다.
root.left.left

root에서 시작
  ↓
A의 왼쪽 자식 B로 이동
  ↓
B의 왼쪽 자식 D로 이동
9.3 데이터 출력하기
트리의 데이터를 출력하려면 순회 함수를 사용한다.
class Node:
    def __init__(self, data):
        self.data = data
        self.left = None
        self.right = None


def print_tree(node):
    if node is None:
        return

    print(node.data, end=" ")
    print_tree(node.left)
    print_tree(node.right)


root = Node("A")
root.left = Node("B")
root.right = Node("C")
root.left.left = Node("D")
root.left.right = Node("E")
root.right.left = Node("F")
root.right.right = Node("G")

print_tree(root)
출력 결과:
A B D E C F G이 함수는 전위 순회 방식으로 트리를 출력한다.
10. 전체 예제 코드
아래 코드는 트리 생성과 세 가지 순회를 한 번에 확인할 수 있는 예제이다.
class Node:
    def __init__(self, data):
        self.data = data
        self.left = None
        self.right = None


def preorder(node):
    if node is None:
        return

    print(node.data, end=" ")
    preorder(node.left)
    preorder(node.right)


def inorder(node):
    if node is None:
        return

    inorder(node.left)
    print(node.data, end=" ")
    inorder(node.right)


def postorder(node):
    if node is None:
        return

    postorder(node.left)
    postorder(node.right)
    print(node.data, end=" ")


root = Node("A")
root.left = Node("B")
root.right = Node("C")
root.left.left = Node("D")
root.left.right = Node("E")
root.right.left = Node("F")
root.right.right = Node("G")

print("전위 순회:", end=" ")
preorder(root)

print()

print("중위 순회:", end=" ")
inorder(root)

print()

print("후위 순회:", end=" ")
postorder(root)
출력 결과:
전위 순회: A B D E C F G
중위 순회: D B E A F C G
후위 순회: D E B F G C A
11. 추가로 알아두면 좋은 내용
11.1 이진 트리
이진 트리(Binary Tree)는 각 노드가 최대 두 개의 자식 노드를 가지는 트리이다.
        A
      /   \
     B     C
이번 과제에서 구현한 트리는 왼쪽 자식과 오른쪽 자식을 가지므로 이진 트리 형태이다.
11.2 이진 탐색 트리
이진 탐색 트리(Binary Search Tree)는 왼쪽 자식은 부모보다 작은 값, 오른쪽 자식은 부모보다 큰 값을 가지는 트리이다.
        8
      /   \
     3     10
    / \      \
   1   6      14
이진 탐색 트리는 데이터를 빠르게 탐색하기 위해 사용된다.
11.3 트리와 재귀
트리는 재귀와 잘 어울린다.
트리의 각 자식도 다시 작은 트리로 볼 수 있기 때문이다.
        A
      /   \
   왼쪽트리  오른쪽트리
순회 함수가 자기 자신을 다시 호출하는 이유도 이 구조 때문이다.
11.4 완전 이진 트리와 포화 이진 트리
이진 트리를 공부하다 보면 완전 이진 트리와 포화 이진 트리라는 표현도 자주 나온다.
| 종류 | 설명 |
|---|---|
| 포화 이진 트리 | 모든 내부 노드가 자식을 2개씩 가지고, 모든 리프 노드가 같은 깊이에 있는 트리 |
| 완전 이진 트리 | 마지막 레벨을 제외하고 노드가 모두 채워져 있으며, 마지막 레벨은 왼쪽부터 채워진 트리 |
포화 이진 트리 예시는 다음과 같다.
        A
      /   \
     B     C
    / \   / \
   D   E F   G
완전 이진 트리 예시는 다음과 같다.
        A
      /   \
     B     C
    / \   /
   D   E F
완전 이진 트리는 힙(Heap) 자료구조를 이해할 때 중요하다.
11.5 트리의 시간 복잡도
트리의 시간 복잡도는 트리의 종류와 균형 상태에 따라 달라진다.
| 작업 | 일반 트리 | 균형 잡힌 이진 탐색 트리 |
|---|---|---|
| 탐색 | O(n) | O(log n) |
| 삽입 | O(n) | O(log n) |
| 삭제 | O(n) | O(log n) |
| 전체 순회 | O(n) | O(n) |
여기서 n은 노드의 개수이다.
이진 탐색 트리가 균형 잡혀 있으면 탐색 범위를 절반씩 줄일 수 있다. 하지만 한쪽으로 치우친 트리는 링크드 리스트와 비슷해져 탐색이 느려질 수 있다.
균형 잡힌 트리:
        8
      /   \
     3     10
    / \      \
   1   6      14

한쪽으로 치우친 트리:
1
 \
  2
   \
    3
     \
      4
12. 트리의 실제 활용 사례
트리는 계층 관계를 표현할 때 널리 사용된다.
12.1 회사 조직도
회사 조직도는 대표적인 트리 구조이다.
코드로 표현하면 다음과 같다.
조직도는 한 사람이 여러 하위 부서를 가질 수 있으므로 이진 트리보다 일반 트리 구조가 더 자연스럽다.
12.2 댓글과 대댓글 구조
댓글 시스템도 트리로 표현할 수 있다.
댓글1
├── 대댓글1
│   └── 대대댓글1
└── 대댓글2
댓글 아래에 대댓글이 달리고, 대댓글 아래에 다시 댓글이 달릴 수 있기 때문이다.
12.3 HTML DOM 구조
웹 페이지의 HTML도 트리 구조이다.
html
├── head
│   └── title
└── body
    ├── h1
    └── p
브라우저는 HTML 문서를 DOM 트리로 해석하고, JavaScript는 이 트리의 노드를 찾아 내용을 바꾸거나 스타일을 변경한다.
13. 마무리
트리는 데이터를 계층적으로 표현하는 자료구조이다. 배열처럼 데이터를 일렬로 나열하는 것이 아니라, 부모와 자식 관계를 중심으로 데이터를 연결한다.
이번 과제에서 꼭 이해해야 할 핵심은 다음과 같다.
| 핵심 개념 | 설명 |
|---|---|
| Root Node | 트리의 시작 노드 |
| Parent Node | 특정 노드의 바로 위 노드 |
| Child Node | 특정 노드의 바로 아래 노드 |
| Leaf Node | 자식이 없는 노드 |
| Depth | 루트에서 특정 노드까지의 거리 |
| Preorder | Root -> Left -> Right |
| Inorder | Left -> Root -> Right |
| Postorder | Left -> Right -> Root |
느낀점
트리는 폴더 구조, 조직도, 댓글 구조, HTML DOM, 탐색 알고리즘 등 다양한 곳에서 사되는 것을 알았다.
특히 순회 방식은 트리를 다루는 가장 기본적인 방법이므로 전위, 중위, 후위 순회의 차이를 확실히 이해하는 것이 중요하다고 생각이 들었다.