트리(Tree)는 데이터를 계층적으로 표현하는 자료구조이다. 그중에서도 이진 트리(Binary Tree)와 이진 탐색 트리(Binary Search Tree)는 자료구조 학습에서 가장 자주 등장하는 트리 구조이다.
이 글에서는 이진 트리와 이진 탐색 트리의 개념, 차이점, 순회 방식, 삽입·탐색·삭제 원리, Python 구현까지 정리한다.
1. 이진 트리란?
이진 트리(Binary Tree)는 각 노드가 최대 2개의 자식 노드를 가지는 트리 자료구조이다.
각 노드는 보통 다음 세 가지 정보를 가진다.
Node
├── data
├── left
└── right| 구성 요소 | 의미 |
|---|---|
data | 노드가 저장하는 값 |
left | 왼쪽 자식 노드를 가리키는 참조 |
right | 오른쪽 자식 노드를 가리키는 참조 |
예시는 다음과 같다.
        A
      /   \
     B     C
    / \     \
   D   E     F
위 트리는 이진 트리이다. 모든 노드가 자식을 0개, 1개, 또는 2개만 가지고 있기 때문이다.
1.1 이진 트리를 사용하는 이유
이진 트리는 데이터를 계층적으로 표현하면서도 각 노드의 자식 수를 2개로 제한한다. 이 제한 덕분에 구조가 단순해지고, 탐색이나 순회 알고리즘을 이해하기 쉬워진다.
이진 트리는 다음과 같은 자료구조와 알고리즘의 기반이 된다.
- 이진 탐색 트리
- 힙
- 우선순위 큐
- 수식 트리
- 의사결정 트리
- 탐색 알고리즘
2. 이진 트리의 종류
이진 트리는 노드가 채워진 형태에 따라 여러 종류로 나눌 수 있다.
2.1 포화 이진 트리
포화 이진 트리(Full Binary Tree 또는 Perfect Binary Tree)는 모든 내부 노드가 자식 2개를 가지고, 모든 리프 노드가 같은 깊이에 있는 트리이다.
        A
      /   \
     B     C
    / \   / \
   D   E F   G
모든 레벨이 꽉 차 있다.
2.2 완전 이진 트리
완전 이진 트리(Complete Binary Tree)는 마지막 레벨을 제외한 모든 레벨이 채워져 있고, 마지막 레벨은 왼쪽부터 채워진 트리이다.
        A
      /   \
     B     C
    / \   /
   D   E F
완전 이진 트리는 힙(Heap)을 구현할 때 자주 사용된다.
2.3 편향 이진 트리
편향 이진 트리(Skewed Binary Tree)는 한쪽 방향으로만 노드가 연결된 트리이다.
1
 \
  2
   \
    3
     \
      4
이런 구조는 링크드 리스트와 비슷해져 탐색 효율이 떨어질 수 있다.
3. 이진 탐색 트리란?
이진 탐색 트리(BST, Binary Search Tree)는 이진 트리에 정렬 규칙을 추가한 자료구조이다.
규칙은 다음과 같다.
왼쪽 서브트리의 값 < 현재 노드의 값 < 오른쪽 서브트리의 값예시는 다음과 같다.
        8
      /   \
     3     10
    / \      \
   1   6      14
      / \     /
4 7 138을 기준으로 보면 왼쪽에는 8보다 작은 값이 있고, 오른쪽에는 8보다 큰 값이 있다.
이 규칙은 모든 노드에 똑같이 적용된다.
3.1 BST의 핵심 특징
- 왼쪽 자식은 부모보다 작다.
- 오른쪽 자식은 부모보다 크다.
- 중복 값을 허용하지 않는 방식으로 구현하는 경우가 많다.
- 중위 순회를 하면 오름차순으로 출력된다.
4. 이진 트리와 이진 탐색 트리의 차이
| 구분 | 이진 트리 | 이진 탐색 트리 |
|---|---|---|
| 자식 수 | 최대 2개 | 최대 2개 |
| 값의 규칙 | 특별한 정렬 규칙 없음 | 왼쪽 < 부모 < 오른쪽 |
| 탐색 방식 | 전체를 확인해야 할 수 있음 | 값을 비교하며 한쪽으로 이동 |
| 중위 순회 결과 | 정렬 보장 안 됨 | 오름차순 출력 |
| 주요 목적 | 계층 구조 표현 | 빠른 탐색 |
이진 트리는 구조에 대한 개념이고, 이진 탐색 트리는 그 구조에 정렬 규칙을 더한 자료구조라고 볼 수 있다.
5. 이진 탐색 트리 동작 원리
5.1 삽입
값을 삽입할 때는 루트부터 시작해 현재 노드와 값을 비교한다.
삽입할 값이 현재 노드보다 작으면 왼쪽으로 이동
삽입할 값이 현재 노드보다 크면 오른쪽으로 이동
빈 자리를 만나면 새 노드 삽입
예를 들어 4를 삽입한다고 생각해보자.
        8
      /   \
     3     10
    / \
   1   6
이동 과정:
4 < 8  → 왼쪽으로 이동
4 > 3  → 오른쪽으로 이동
4 < 6  → 왼쪽으로 이동
빈 자리 → 4 삽입
결과:
        8
      /   \
     3     10
    / \
   1   6
      /
     4
5.2 탐색
탐색도 삽입과 비슷하게 값을 비교하며 이동한다.
예를 들어 13을 찾는 과정은 다음과 같다.
13 > 8   → 오른쪽 이동
13 > 10  → 오른쪽 이동
13 < 14  → 왼쪽 이동
13 == 13 → 찾음
매번 왼쪽 또는 오른쪽 중 한 방향만 선택하므로, 균형이 잡힌 트리에서는 탐색이 빠르다.
5.3 삭제
삭제는 삽입과 탐색보다 복잡하다. 삭제할 노드의 자식 개수에 따라 경우가 나뉜다.
1. 자식이 없는 노드 삭제
2. 자식이 하나인 노드 삭제
3. 자식이 둘인 노드 삭제
자식이 없는 노드는 그냥 제거하면 된다.
삭제 전:
    3
   /
  1

1 삭제 후:
    3
자식이 하나인 노드는 자식 노드가 삭제된 노드의 자리를 대신한다.
삭제 전:
    10
      \
       14
      /
     13

14 삭제 후:
    10
      \
       13
자식이 둘인 노드는 보통 오른쪽 서브트리에서 가장 작은 값을 찾아 현재 노드와 교체한다.
삭제 전:
        3
       / \
      1   6
         / \
        4   7

3 삭제:
오른쪽 서브트리에서 가장 작은 값은 4
3을 4로 교체
결과:
        4
       / \
      1   6
           \
            7
6. Python으로 이진 탐색 트리 구현하기
6.1 구현 단계
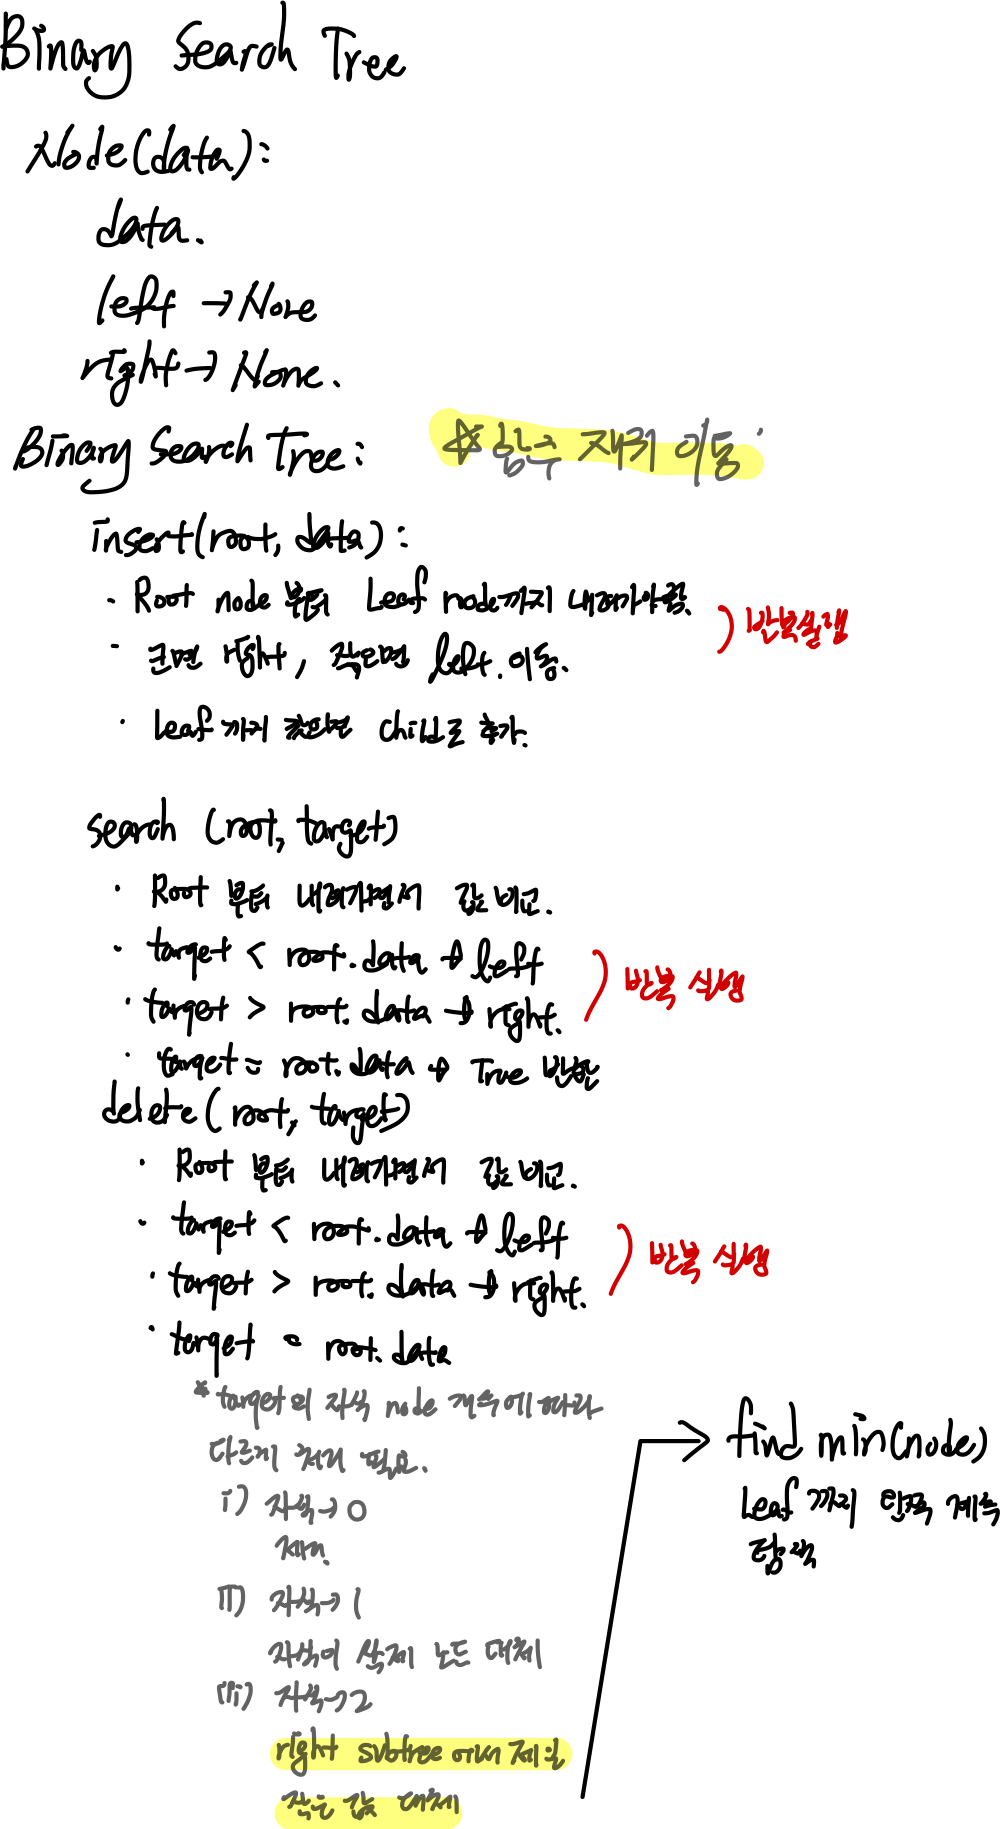
6.2 전체 코드
class Node:
    def __init__(self, data):
        self.data = data
        self.left = None
        self.right = None


class BinarySearchTree:
    def __init__(self):
        self.root = None

    def insert(self, data):
        self.root = self._insert(self.root, data)

    def _insert(self, node, data):
        if node is None:
            return Node(data)

        if data < node.data:
            node.left = self._insert(node.left, data)
        elif data > node.data:
            node.right = self._insert(node.right, data)

        return node

    def search(self, target):
        return self._search(self.root, target)

    def _search(self, node, target):
        if node is None:
            return False

        if target == node.data:
            return True

        if target < node.data:
            return self._search(node.left, target)

        return self._search(node.right, target)

    def delete(self, data):
        self.root = self._delete(self.root, data)

    def _delete(self, node, data):
        if node is None:
            return None

        if data < node.data:
            node.left = self._delete(node.left, data)

        elif data > node.data:
            node.right = self._delete(node.right, data)

        else:
            if node.left is None and node.right is None:
                return None

            if node.left is None:
                return node.right

            if node.right is None:
                return node.left

            min_node = self._find_min(node.right)
            node.data = min_node.data
            node.right = self._delete(node.right, min_node.data)

        return node

    def _find_min(self, node):
        current = node

        while current.left is not None:
            current = current.left

        return current
8.3 코드 설명
Node 클래스는 트리의 노드 하나를 표현한다.
class Node:
    def __init__(self, data):
        self.data = data
        self.left = None
        self.right = None
BinarySearchTree 클래스는 전체 트리를 관리한다.
class BinarySearchTree:
    def __init__(self):
self.root = Noneroot는 트리의 시작 노드이다. 처음에는 아무 노드도 없으므로 None이다.
8.4 insert()와 _insert() 설명
insert()는 외부에서 호출하는 메서드이고, 실제 재귀 삽입은 _insert()에서 처리한다.
def insert(self, data):
self.root = self._insert(self.root, data)_insert()에서 값이 현재 노드보다 작으면 왼쪽, 크면 오른쪽으로 이동한다.
if data < node.data:
    node.left = self._insert(node.left, data)
elif data > node.data:
    node.right = self._insert(node.right, data)
값을 넣을 위치를 찾다가 node가 None이면 새 노드를 만들어 반환한다.
if node is None:
    return Node(data)
즉, insert()는 사용자가 값을 추가할 때 호출하는 공개 메서드이고, _insert()는 실제로 트리 아래로 내려가며 위치를 찾는 내부 메서드이다.
8.5 search()와 _search() 설명
search()는 특정 값이 트리 안에 있는지 확인하는 메서드이다. 외부에서는 bst.search(6)처럼 호출한다.
def search(self, target):
    return self._search(self.root, target)
실제 탐색은 _search()에서 이루어진다.
def _search(self, node, target):
    if node is None:
        return False

    if target == node.data:
        return True

    if target < node.data:
        return self._search(node.left, target)

    return self._search(node.right, target)
탐색 과정은 이진 탐색 트리의 규칙을 그대로 사용한다.
찾는 값 == 현재 노드 값  → 찾음
찾는 값 < 현재 노드 값   → 왼쪽으로 이동
찾는 값 > 현재 노드 값   → 오른쪽으로 이동
끝까지 갔는데 없으면      → False 반환
예를 들어 13을 찾는다면 다음 순서로 이동한다.
13 > 8   → 오른쪽으로 이동
13 > 10  → 오른쪽으로 이동
13 < 14  → 왼쪽으로 이동
13 == 13 → 탐색 성공
8.6 delete()와 _delete() 설명
delete()는 특정 값을 가진 노드를 삭제하는 메서드이다. 외부에서는 bst.delete(3)처럼 호출한다.
def delete(self, data):
    self.root = self._delete(self.root, data)
삭제 후에는 루트가 바뀔 수도 있기 때문에 self.root에 _delete()의 결과를 다시 저장한다. 예를 들어 루트 노드를 삭제하면 새로운 노드가 루트가 될 수 있다.
실제 삭제 처리는 _delete()에서 이루어진다. 먼저 삭제할 값을 찾기 위해 왼쪽 또는 오른쪽으로 이동한다.
if data < node.data:
    node.left = self._delete(node.left, data)

elif data > node.data:
    node.right = self._delete(node.right, data)
삭제할 노드를 찾으면 자식 노드의 개수에 따라 처리 방식이 달라진다.
1. 자식이 없는 노드 삭제
if node.left is None and node.right is None:
    return None
자식이 없는 노드는 리프 노드이다. 그냥 None을 반환해서 부모와의 연결을 끊으면 된다.
삭제 전:
+---+
| 1 |
+---+

삭제 후:
None
2. 자식이 하나인 노드 삭제
왼쪽 자식이 없고 오른쪽 자식만 있다면 오른쪽 자식이 삭제된 노드의 자리를 대신한다.
if node.left is None:
    return node.right
오른쪽 자식이 없고 왼쪽 자식만 있다면 왼쪽 자식이 삭제된 노드의 자리를 대신한다.
if node.right is None:
    return node.left
예를 들어 14를 삭제할 때 13이라는 자식만 있다면 13이 14의 자리를 대신한다.
삭제 전:
10
  \
   14
  /
 13

삭제 후:
10
  \
   13
3. 자식이 둘인 노드 삭제
자식이 둘 다 있는 노드는 바로 삭제하기 어렵다. 이 경우 오른쪽 서브트리에서 가장 작은 값을 찾아 현재 노드의 값으로 바꾼다.
min_node = self._find_min(node.right)
node.data = min_node.data
node.right = self._delete(node.right, min_node.data)
오른쪽 서브트리에서 가장 작은 값은 현재 노드보다 크면서도 가장 작은 값이다. 그래서 해당 값을 가져오면 이진 탐색 트리의 정렬 규칙을 유지할 수 있다.
삭제 전:
        3
       / \
      1   6
         / \
        4   7

3 삭제:
오른쪽 서브트리에서 가장 작은 값은 4
3을 4로 교체

삭제 후:
        4
       / \
      1   6
           \
            7
8.7 _find_min() 설명
_find_min()은 특정 서브트리에서 가장 작은 값을 가진 노드를 찾는 메서드이다.
def _find_min(self, node):
    current = node

    while current.left is not None:
        current = current.left

    return current
이진 탐색 트리에서는 왼쪽으로 갈수록 값이 작아진다. 따라서 가장 작은 값을 찾으려면 왼쪽 자식이 없을 때까지 계속 이동하면 된다.
        10
       /
      6
     /
    4

가장 작은 값: 4
8.8 전체 메서드 역할 요약
| 메서드 | 역할 | 외부 호출 여부 |
|---|---|---|
insert(data) | 값을 트리에 추가한다. | 사용자가 호출 |
_insert(node, data) | 삽입 위치를 재귀적으로 찾는다. | 내부에서 사용 |
search(target) | 값이 존재하는지 확인한다. | 사용자가 호출 |
_search(node, target) | 탐색할 위치를 재귀적으로 이동한다. | 내부에서 사용 |
delete(data) | 값을 가진 노드를 삭제한다. | 사용자가 호출 |
_delete(node, data) | 삭제할 노드를 찾고 자식 개수에 따라 처리한다. | 내부에서 사용 |
_find_min(node) | 특정 서브트리에서 가장 작은 노드를 찾는다. | 내부에서 사용 |
메서드 이름 앞에 _가 붙은 함수들은 클래스 내부에서 보조적으로 사용하는 함수라는 뜻이다. 파이썬에서 강제로 막는 것은 아니지만, 관례적으로 외부에서 직접 호출하지 않는 메서드로 본다.
9. 시간 복잡도
BST의 성능은 트리가 얼마나 균형 잡혀 있는지에 따라 달라진다.
| 연산 | 균형 잡힌 BST | 한쪽으로 치우친 BST |
|---|---|---|
| 삽입 | O(log n) | O(n) |
| 탐색 | O(log n) | O(n) |
| 삭제 | O(log n) | O(n) |
| 중위 순회 | O(n) | O(n) |
균형 잡힌 경우:
        8
      /   \
     3     10
    / \      \
   1   6      14
한쪽으로 치우친 경우:
1
 \
  2
   \
    3
     \
      4
한쪽으로 치우친 BST는 사실상 링크드 리스트처럼 동작할 수 있다.
그래서 실제로는 AVL Tree, Red-Black Tree처럼 균형을 유지하는 트리도 사용된다.
10. 마무리
이진 트리와 이진 탐색 트리의 핵심은 다음과 같다.
| 개념 | 핵심 |
|---|---|
| 이진 트리 | 각 노드가 최대 2개의 자식을 가진다. |
| 이진 탐색 트리 | 왼쪽은 작은 값, 오른쪽은 큰 값을 가진다. |
| 중위 순회 | BST에서 오름차순 출력이 가능하다. |
| 탐색 | 값을 비교하며 왼쪽 또는 오른쪽으로 이동한다. |
| 삭제 | 자식 노드 개수에 따라 처리 방식이 달라진다. |
이진 트리는 트리 구조를 이해하기 위한 기본이고, 이진 탐색 트리는 효율적인 탐색을 이해하기 위한 중요한 자료구조이다.
특히 BST의 삽입, 탐색, 삭제를 직접 구현해보면 트리의 연결 구조와 재귀 동작을 함께 이해할 수 있다.
