1. 해시 테이블이란?
해시테이블 (hash tabel) 은 Key 와 Value 를 한 쌍으로 저장하는 자료구조이다. Key 를 해시 함수(Hash Function) 에 넣어 배열의 인덱스를 계산하고, 그 위치에 Value를 저장한다.
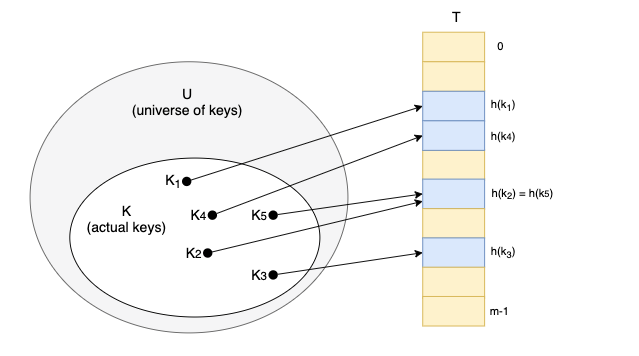
예를 들어, 학생 이름을 Key 로, 점수를 Value 로 저장할 수 있다.
김사과 -- hash() --> 2번 위치 --> 90점
반하나 -- hash() --> 5번 위치 --> 85점
Hash table 은 데이터를 빠르게 저장하고 조회하기 위해 사용한다.
일반적으로 삽입, 삭제, 조회가 빠르다.
1.1 Direct Address Table 과 비교
Hash Table 을 이해하기 전에 Direct Address Table 을 먼저 보면 차이가 더 선명하다.
Direct Address Table 은 Key 를 그대로 배열의 인덱스로 사용한다.
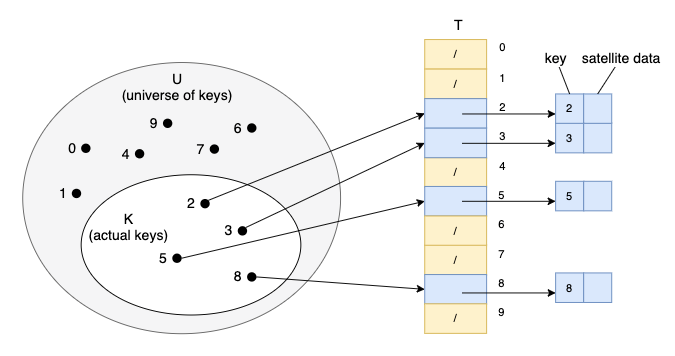
Key = 3
table[3]에 바로 저장
예를 들어 학생 번호가 0 부터 5까지만 존재한다면, 학생 번호를 그대로 인덱스로 사용할 수 있다.
학생 번호 : 0 1 2 3 4 5
배열 위치 : 0 1 2 3 4 5
파이썬 코드로 보면 다음과 같다.
direct_address_table = [None] * 6

direct_address_table[1] = "김사과"
direct_address_table[2] = "반하나"
direct_address_table[4] = "오렌지"

print(direct_address_table)
출력 결과 :
[None, '김사과', '반하나', None, '오렌지',None]Direct Address Table 의 장점은 매우 단순하고 빠르다는 점이다.
Key 가 곧 인덱스이므로 별도의 해시 함수가 필요없다.
하지만, Key 의 범위가 증가하면 메모리 낭비가 심해진다는 단점이 있다.
direct_address_table = [None] * 10000001

direct_address_table[100] = "김사과"
direct_address_table[10000000] = "반하나"
위 코드는 데이터가 2개뿐인데도 인덱스 10000001 을 사용하기 위해 리스트를 10000001 칸이나 만들어야 한다.
이처럼 Key 의 범위가 넓고 실제 저장할 데이터가 적으면 대부분의 공간이 None 으로 비어 있게 된다.
Hash Table 은 이 문제를 줄이기 위해 Key 를 Hash function 에 넣어 더 작은 범위의 인덱스로 바꾼다.
Direct Address Table vs Hash Table
| 비교 항목 | Direct Address Table | Hash Table |
|---|---|---|
| 인덱스 계산 방식 | Key를 그대로 인덱스로 사용 | Key를 해시 함수로 변환 |
| Key 형태 | 주로 작은 정수 Key에 적합 | 문자열, 숫자, 튜플 등 다양한 Key 사용 가능 |
| 조회 속도 | O(1) | 평균 O(1) |
| 메모리 사용 | Key 범위가 크면 낭비가 심함 | 필요한 크기의 테이블을 사용해 메모리 효율이 더 좋음 |
| 충돌 발생 여부 | 충돌이 거의 없음 | 서로 다른 Key가 같은 인덱스를 가질 수 있음 |
| 충돌 해결 필요 | 필요 없음 | Chaining, Open Addressing 등이 필요 |
| 적합한 상황 | Key 범위가 작고 촘촘할 때 | Key 범위가 크거나 문자열 Key를 사용할 때 |
정리 :
- Direct Address Table 은 Key 범위가 작을 때 가장 단순하고 빠른 방식이다.
- Hash Table 은 Key 범위와 다양한 Key 타입을 다루기 위해 Hash function 을 사용하는 방식이다.
2. Key 와 Value 의 구조
Hash Table 은 데이터를 Key : Value 형태로 저장한다.
| 용어 | 의미 | 예시 |
|---|---|---|
| Key | 데이터를 찾기 위한 이름 또는 식별자 | "apple" |
| Value | Key에 연결된 실제 데이터 | 1000 |
파이썬 딕셔너리의 예시는 다음과 같다.
fruit_price = {
  "apple" : 1000,
  "banana" : 1500,
  "orange" : 2000
}
3. Hash function 의 역할
Hash function 은 임의의 길이의 Key 값을 고정된 길이의 Hash 로 바꿔주는 맵핑 함수이다.
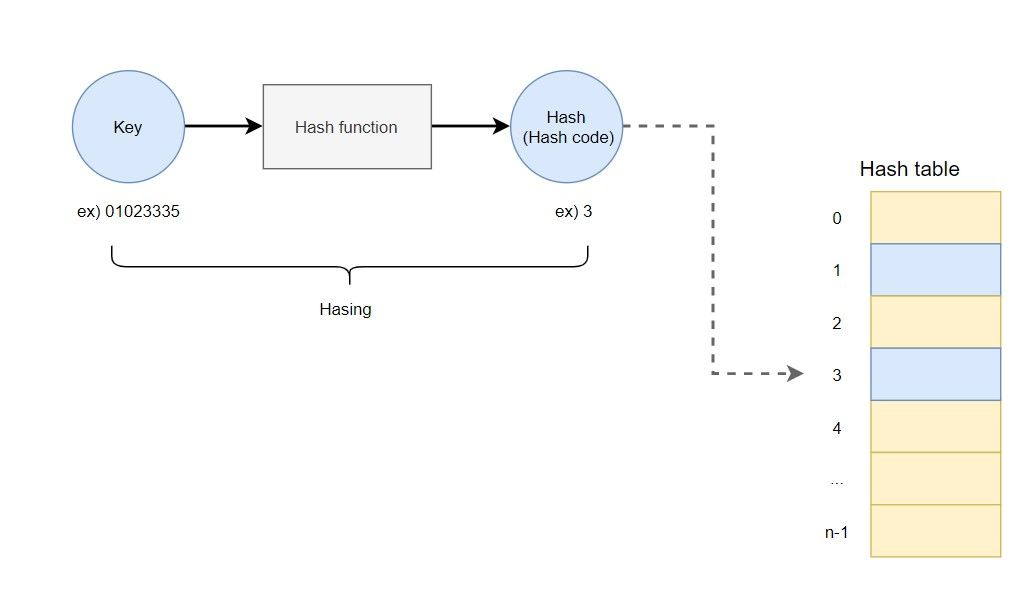
Key
- Hash function 에서 Key 는 자연수로 가정한다. (N = {0, 1, 2, ...})
- 만약 자연수가 아닌 character 나 string 의 형태라면 자연수 형태로 바꿔서 사용한다.
Hash
- Hash function 을 통해 작아진 값을 해시(Hash), 해시 값(Hash value), 해시 코드(Hash code) 라고 한다.
- Hash Table 의 버킷을 가리키는 주소로 사용된다.
Hashing
- Key 값을 Hash function 을 통해 해시로 바꿔주는 작업을 해싱(Hashing) 이라고 한다.
예시 )
hash_function("apple") = 3
hash_function("banana") = 1
Hash Table 내부에서는 이 인덱스를 이용해 데이터를 저장한다.
table[3] = ("apple", 1000)
table[1] = ("banana", 1500)
3.1 좋은 Hash function 의 조건
3.1.1 Hash function 의 특성
Hash function 가 기본적으로 동작하는 방식
1. 임이의 길이 입력은 받는다.
2. 입력 크기와 상관없이 결과 길이는 항상 동일하다.
3. Deterministic(결정적) : 같은 입력은 항상 같은 결과를 반환한다.
4. One-Way(단방향성) : 결과값 "y" 에 대해서 h(x) = y 를 만족하는 입력값 "x" 는 찾기 어려워야 한다.
- 빠른 계산 : Hash function 은 매우 빠르게 계산되어야 한다.
3.1.2 Hash function 의 성질
좋은 Hash function 가 만족해야하는 품질
- Uniform Distribution(균등 분포성) : 데이터가 특정 위치에 몰리지 않고 고르게 분산되어야 한다.
- 충돌 최소화 : 서로 다른 두 입력 데이터가 동일한 해시값을 생성하는 상황을 충돌(Collision) 이라 한다. 좋은 Hash function 은 이러한 충돌이 발생할 확률을 매우 낮게 유지해야 한다.
- Avalanche Effect(눈사태 효과) : 입력값에 아주 미세한 변화만 주어도, 출력되는 해시값이 전혀 다른 무작위 값이 나온다.
- 패턴 독립성 : 비슷한 데이터가 들어와도 특정 위치에 몰리지 않아야 한다.
암호학적 Hash function 의 추가 성질
자료구조용 Hash function 와 달리 암호학에서는 추가 보안 성질이 필요하다. 참고만 하자
- Preimage Resistance(역상 저항성) : 해시값만 보고 원본을 찾기 어려워야 한다.
- Second Preimage Resistance(제2 역상 저항성) : 어떤 입력값이 주어졌을 때 같은 해시값을 가진 다른 입력값을 찾기 어려워야 한다.
- Collsion Resistance(충돌 저항성) : 아무 두 입력값에 대해서 충돌하는 두 입력값을 찾기 어려워야 한다.
3.2 간단한 Hash function 예시
아래 함수는 문자열의 각 글자 코드를 더한 뒤 테이블 크기로 나눈 나머지를 인덱스로 사용한다.
def simple_hash(key, size):
  total = 0

  for char in key:
    total += ord(char)	# ord() : 문자를 숫자 코드로 바꾸는 함수

  return total % size

print(simple_hash("apple", 10))
print(simple_hash("banana", 10))
print(simple_hash("orange", 10))
출력 결과 :
0
9
6
4. 충돌이란?
충돌 (Collision) 은 서로 다른 Key 가 같은 인덱스를 갖게 되는 상황이다.
hash_function("apple") = 2
hash_function("melon") = 2
두 Key 가 모두 2번 위치 를 사용하려고 하면 충돌이 발생한다.
index 2에 이미 apple 이 존재
melon 도 index 2 에 저장하려고 함
4.1 충돌이 발생하는 이유
Hash Table 의 공간은 한정되어 있지만, 가능한 Key 의 개수는 훨씬 많다.
예를 들어 테이블 크기가 5라면 사용할 수 있는 인덱스는 0, 1, 2, 3 , 4 뿐이다.
하지만 문자열 Key 는 무수히 많다. 따라서 서로 다른 Key 가 같은 인덱스를 갖는 상황은 자연스럽게 발생할 수밖에 없다.
가능한 인덱스: 0, 1, 2, 3, 4
가능한 Key: apple, banana, orange, melon, grape, ...
그래서 Hash Table은 충돌을 해결하는 방법이 반드시 필요하다.
5. 충돌 해결 방법
대표적인 충돌 해결 방법은 다음 두 가지이다.
| 방법 | 설명 |
|---|---|
| Chaining | 같은 인덱스에 여러 데이터를 연결 리스트처럼 저장 |
| Open Addressing | 충돌이 발생하면 다른 빈 위치를 찾아 저장 |
6. Chaining
Chaining(체이닝) 은 Hash Table 에서 충돌이 발생했을 때, 같은 인덱스에 들어오는 데이터들을 linked-list 또는 list 형태로 이어서 저장하는 방식이다.
즉, 하나의 버킷(bucket) 에 여러 개의 데이터를 저장할 수 있게 만드는 충돌 처리 방법이다.
index 0: []
index 1: [("banana", 1500)]
index 2: [("apple", 1000), ("melon", 3000)]
index 3: []
index 4: []
apple 과 melon 이 같은 인덱스 2 를 가진다면, 2번 위치 의 리스트에 함께 저장한다.
6.1 Chaining 의 장점
-
구현이 비교적 쉽다.
- 충돌이 발생하면 같은 버킷에 추가하면 된다.
-
충돌이 발생해도 데이터를 잃지 않는다.
- 같은 인덱스에 여러 데이터가 들어갈 수 있으므로 기존 데이터를 덮어쓰지 않는다.
-
한 인덱스에 여러 데이터를 저장할 수 있다.
- 적재율이 1을 넘어도 동작 가능하다.
-
삭제가 비교적 쉽다.
- 해당 버킷에서 원소만 제거하면 된다.
Load Factor(적재율)
Load Factor = 저장된 데이터 개수 / 버킷 개수적재율이 높아질수록 빈 칸을 찾기 어려워지고, 충돌이 많아진다.
따라서 Open Addressing 을 사용할 때는 일정 수준 이상 테이블이 차면 더 큰 테이블로 확장하는 것이 좋다.
6.2 Chaining 의 단점
- 추가 메모리가 필요하다.
- 각 버킷에
list나linked-list를 유지해야 한다.
- 각 버킷에
- 캐시 효율이 떨어질 수 있다.
linked-list기반 chaining 은 노드들이 메모리상에 흩어져 있을 수 있다. 그래서 CPU 캐시 효율이 떨어질 수 있다.
- 특정 버킷에 데이터가 몰리면 느려진다.
- Hash function 이 나쁘면 한 버킷에 데이터가 몰리는데, 이 때 탐색이 느려질 수 있다.
7. Open Addressing
Open Addressing 은 충돌이 발생했을 때 같은 위치에 저장하지 않고, Hash Table 안의 다른 빈 공간을 찾아 저장하는 방식이다.
예를 들어, apple 과 melon 이 둘 다 2번 위치 를 사용한다고 하자.
apple ➡ index 2 저장
melon ➡ index 2 저장
melon ➡ index 3 이 비어 있으면 index 3에 저장
7.1 Linear Probing
Open Addressing 의 가장 단순한 방식은 Linear Probing 이다.
충돌이 발생하면 바로 다음 칸을 확인한다. 테이블 끝까지 갔는데도 빈 칸을 찾지 못하면 다시 처음으로 돌아간다.
index = hash(key)

if tabel[index]가 차 있으면:
	index + 1 확인
그래도 차 있으면:
	index + 2 확인
그래도 차 있으면:
	index + 3 확인
예 :
index 0: None
index 1: None
index 2: ("apple", 1000)
index 3: ("melon", 3000)
index 4: None
탐사 순서는 다음과 같다.
처음 위치 : 2

2 ➡ 3 ➡ 4 ➡ 0 ➡ 1
장점 : 구현이 쉽다.
단점 : 연속된 위치에 데이터가 몰리는 Primary Clustering 문제가 생길 수 있다.
7.2 Quadratic Probing
Quadratic Probing 은 충돌이 발생했을 때 한 칸씩 이동하지 않고, 제곱 간격으로 이동하는 방식이다.
처음 인덱스 = hash(key)

1번째 충돌: index + 1²
2번째 충돌: index + 2²
3번째 충돌: index + 3²
예를 들어 처음 인덱스가 2이고 테이블 크기가 7 이라면 탐사 순서는 다음과 같다.
2 ➡ 3 ➡ 6 ➡ 4 ➡ 4 ... 실제로는 중복 탐사를 피하고 모든 칸을 잘 확인할 수 있도록 테이블 크기와 계산식을 신중하게 정해야 한다.
Quadratic Probing 은 Linear Probing 보다 데이터가 연속적으로 뭉치는 문제를 줄일 수 있다.
하지만 서로 같은 시작 인덱스를 가진 데이터들은 비슷한 탐사 경로를 따라갈 수 있는 Secondary Clustering이라고 한다.
7.3 Double Hashing
Double Hashing 은 Hash function 을 두 개 사용하는 방식이다.
첫 번째 Hash function 은 처음 저장할 위치를 정한다.
두 번째 Hash function 은 충돌이 발생했을 때 얼마나 이동할지 결정한다.
첫 번째 위치 = hash1(key)
이동 간격 = hash2(key)

충돌 발생 시:
    hash1(key) + 1 * hash2(key)
    hash1(key) + 2 * hash2(key)
    hash1(key) + 3 * hash2(key)
Double Hashing 은 이동 간격이 Key 마다 달라질 수 있기 때문에 데이터가 한쪽에 몰릴 가능성을 줄일 수 있다.
다만 두 번째 Hash function 이 0을 반환하면 안되고, 테이블 전체를 잘 탐색할 수 있도록 설계해야 한다.
7.4 Open Addressing 에서 삭제가 까다로운 이유
Open Addressing 에서는 데이터를 삭제할 때 단순히 None 으로 바꾸면 문제가 생길 수 있다.
index 2: ("apple", 1000)
index 3: ("melon", 3000)
index 4: ("grape", 2500)
위 상태에서 melon 을 삭제하고 index 3 을 None 으로 만들었다고 하자.
index 2: ("apple", 1000)
index 3: None
index 4: ("grape", 2500)
나중에 grape 를 찾을 때 index 2 에서 시작해 다음 칸을 확인하다가 index 3 이 None 이면, 탐색을 멈춰버릴 수 있다.
그러면 실제로 index 4 에 있는 grape 를 찾지 못한다.
그래서 Open Addressing 에서는 삭제된 자리를 완전히 비우지 않고, 보통 삭제 표시 값(Tombstone) 을 남긴다.
index 2: ("apple", 1000)
index 3: DELETED
index 4: ("grape", 2500)
DELETED 는 "여기에 데이터가 있었지만 삭제되었다" 는 표시이다.
탐색할 때는 DELETED 를 만나도 멈추지 않고 다음 칸을 계속 확인한다.
7.5 Open Addressing 장점
- 추가적인 리스트나 연결 구조가 필요 없다.
- 모든 데이터를 테이블 배열 안에 저장한다.
- 메모리를 비교적 연속적으로 사용하므로 캐시 효율이 좋을 수 있다.
7.6 Open Addressing 단점
- 테이블이 많이 차면 성능이 떨어진다.
- 삭제 처리가 까다롭다.
- 연속된 공간에 데이터가 몰리는 clustering 문제가 생길 수 있다.
- 테이블 크기보다 많은 데이터를 저장할 수 없다.
- 적재율 관리와 리사이징이 중요하다.
8, Python dictionary 와 Hash Table
파이썬의 dict 는 Hash Table 기반으로 동작한다.
student = {
    "name": "김사과",
    "score": 90,
}

print(student["name"])
print(student["score"])
출력 결과 :
김사과
90
dict 는 Key 를 해시해서 내부 위치를 찾고, 그 위치에 Value 를 저장한다.
8.1 dict 의 Key 조건
딕셔너리의 Key 는 해시 가능(hashable) 해야 한다.
사용 가능한 Key 예시 :
data = {
    "apple": 1000,
    10: "숫자 키",
    (1, 2): "튜플 키",
}

print(data["apple"])
print(data[10])
print(data[(1, 2)])
출력 결과 :
1000
숫자 키
튜플 키
리스트는 변경 가능한 객체이므로 Key 로 사용할 수 없다.
# data = {[1, 2]: "리스트 키"} # TypeError: unhashable type: 'list'문자열, 숫자, 튜플처럼 변경 불가능한 값은 보통 Key 로 사용할 수 있다.
리스트, 딕셔너리, 세트처럼 변경 가능한 값은 Key 로 사용할 수 없다.
9. Hash Table 의 장점과 단점
9.1 장점
- Key 를 이용해 데이터를 빠르게 조회할 수 있다.
- 평균적으로 삽입, 삭제, 조회가 빠르다.
- Key 와 Value 구조라 의미 있는 데이터 저장에 적합하다.
- 캐시, 인덱스, 중복 검사 등에 유용하다.
9.2 단점
- 충돌이 발생할 수 있다.
- Hash function 이 좋지 않으면 성능이 떨어진다.
- 데이터가 저장되는 순서를 해시값만 보고 예측하기 어렵다.
- 메모리를 넉넉하게 사용해야 성능을 유지하기 쉽다.
10. Hash Table 실제 사용 사례
10.1 로그인 사용자 정보 저장
사용자 ID를 Key로, 사용자 정보를 Value로 저장할 수 있다.
users = {
    "apple": {"name": "김사과", "role": "admin"},
    "banana": {"name": "반하나", "role": "user"},
}

user_id = "apple"

print(users[user_id]["name"])
print(users[user_id]["role"])
출력 결과:
김사과
admin
10.2 중복 검사
이미 등장한 값을 빠르게 확인할 때 해시 테이블을 사용할 수 있다.
visited = {}
numbers = [1, 3, 5, 3, 7, 1]

for number in numbers:
    if number in visited:
        print("중복 발견:", number)
    else:
        visited[number] = True
출력 결과:
중복 발견: 3
중복 발견: 1
10.3 단어 빈도수 세기
문자열에서 단어가 몇 번 등장했는지 셀 때도 해시 테이블이 유용하다.
words = ["apple", "banana", "apple", "orange", "banana", "apple"]
count = {}

for word in words:
    if word not in count:
        count[word] = 0
    count[word] += 1

print(count)
출력 결과:
{'apple': 3, 'banana': 2, 'orange': 1}11. 시간 복잡도
해시 테이블은 평균적으로 매우 빠른 자료구조이다.
| 연산 | 평균 시간 복잡도 | 최악 시간 복잡도 |
|---|---|---|
| 삽입 | O(1) | O(n) |
| 조회 | O(1) | O(n) |
| 삭제 | O(1) | O(n) |
평균적으로는 Key를 해시해서 바로 위치를 찾기 때문에 O(1)에 가깝다.
하지만 충돌이 많이 발생하면 한 bucket 안에서 여러 데이터를 확인해야 하므로 O(n)이 될 수 있다.
12. 마무리
해시 테이블은 Key와 Value를 빠르게 저장하고 조회하기 위한 자료구조이다.
| 개념 | 설명 |
|---|---|
| Direct Address Table | Key를 그대로 배열 인덱스로 사용하는 방식 |
| Hash Table | Key-Value 데이터를 저장하는 자료구조 |
| Hash Function | Key를 배열 인덱스로 바꾸는 함수 |
| Collision | 서로 다른 Key가 같은 인덱스를 갖는 상황 |
| Chaining | 같은 인덱스에 여러 데이터를 리스트로 저장 |
| Open Addressing | 충돌 시 다른 빈 위치를 찾아 저장 |
| Python dict | 해시 테이블 기반의 내장 자료구조 |
해시 테이블은 딕셔너리, 캐시, 데이터베이스 인덱스, 중복 검사, 빈도수 계산 등 다양한 곳에서 사용된다.
Direct Address Table은 Key를 그대로 인덱스로 쓰기 때문에 단순하지만, Key 범위가 크면 메모리 낭비가 커진다.
해시 테이블의 핵심은 Key를 해시 함수로 인덱스화하여 빠르게 Value를 찾는 것이다.
