Bridging the Safety Gap: A Guardrail Pipeline for Trustworthy LLM Inferences Shanshan Han University of California, Irvine Irvine, California, USA shanshan.han@uci.edu Salman Avestimehr University of Southern California Los Angeles, California, USA avestime@usc.edu Chaoyang He TensorOpera AI Palo Alto, California, USA ch@tensoropera.com [Submitted on 12 Feb 2025]
1 서론
LLM의 안정성 문제. 탐지 모델(detection model), 사후 교정(post-hoc correction), RAG, 규칙 기반 사후 처리 래퍼(wrapper)는 완벽하지 않음.
제안: Wildflare GuardRail. 탐지, 맥락화, 수정, 사용자 맞춤화를 체계적으로 통합하여 LLM 추론 중 강건한 안전성과 적응성을 보장하는 가드레일 파이프라인.
구성 요소: Safety Detector, Grounding, Customizer, Repairer
2 관련 연구
안전화 완화 연구
-
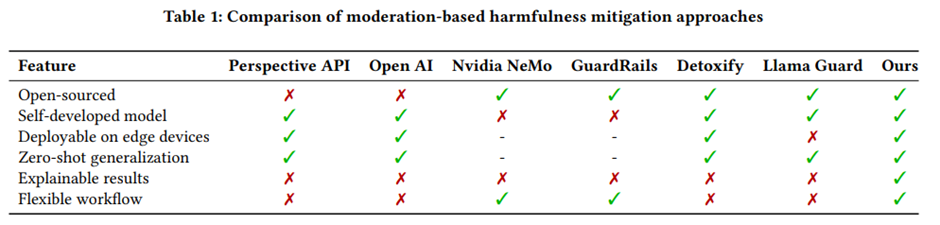
비공개 솔루션(Close-sourced solutions): OpenAI Moderation API, Perspective API 등은 유해성 분류를 제공하지만 오픈소스가 아니어서 새로운 위험에 적응 어렵고 파인튜닝 불가.
-
오픈소스 솔루션(Opensourced solutions): LlamaGuard, Detoxify 등이 있으나, LlamaGuard는 모델이 크고 엣지 디바이스에서 배포가 어렵고, Detoxify는 언어의 미묘한 뉘앙스를 인식해 유해 콘텐츠 감지 가능.
-
사용자 정의 솔루션(Customizable solutions): Guardrails, Nvidia NeMo Guardrails는 맞춤형 워크플로를 제공하지만 Guardrails는 자체 모델이 없고 완전한 통합 솔루션은 아님.
3. Wildflare GuardRail 개요
목표:
-
모든 사용자 입력이 안전하고, 맥락적으로 기반화(grounded)되며, 효과적으로 처리되어 LLM에 전달되는 입력이 고품질·정보성이 풍부하도록 한다.
-
LLM이 생성한 출력을 평가하고 개선하여 사용자에게 전달되는 결과가 관련성과 품질을 모두 갖추도록 한다.
파이프라인
-
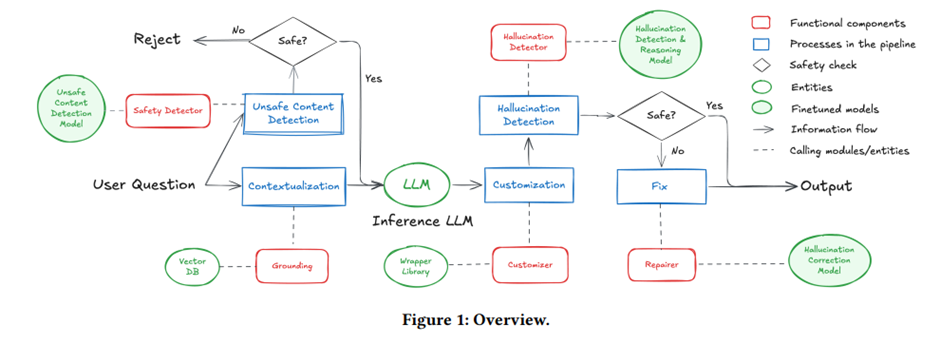
추론 전 처리(Pre-inference processing): Safety Detector가 입력의 유해성, 고정관념, 위협, 음란 표현, 프롬프트 인젝션 공격 등을 탐지하여 비안전 질의를 차단하고, Grounding이 벡터 데이터베이스에서 관련 정보를 검색해 질의를 맥락화함으로써 할루시네이션 가능성 줄임.
-
추론 후 처리(Post-inference processing): LLM 출력에서 할루시네이션 및 비안전 요소를 Safety Detector가 다시 탐지하고, 그 원인(reason for hallucination) 생성. 이후 Repairer가 해당 원인을 기반으로 문제적 출력 수정.
4 Wildflare GuardRail Safety Detector
4.1 비안전 입력 탐지(Unsafe Input Detection)
오픈소스 LLM[68]을 기반으로 파인튜닝된 통합 이진 분류(binary classification) 모델을 사용하여 콘텐츠를 “안전(safe)” 또는 “비안전(unsafe)”으로 분류.
이점: 안전 탐지와 관련된 기존 지식 활용, 효율적, 중첩되거나 모호한 비안전 콘텐츠 범주 분류의 복잡성과 부정확성 피함, 모호성 최소화 및 학습 데이터의 품질 보장
15개의 공개 데이터셋에서 무작위로 샘플을 추출하여 이를 결합함으로써 훈련 데이터셋을 구성함. -> 실제 사용자 입력의 다양한 콘텐츠를 포착하므로, 잠재적인 실제 입력을 더 대표적으로 반영.
4.2 할루시네이션 탐지 및 추론(Hallucination Detection and Reasoning)
할루시네이션은 저품질 학습 데이터, 샘플링 무작위성, LLM의 확률적 특성에서 비롯됨.
사용자에게 높은 품질의 응답을 제공하기 위해서는 탐지된 할루시네이션을 적절히 처리해야함. -> LLM 응답 내 할루시네이션의 원인을 설명하고, 가능하다면 할루시네이션된 응답 자체를 수정해야함.
자체 개발 LLM Fox-1[68]을 기반으로 할루시네이션 탐지 + 이유 설명, 이후 Repairer가 수정 작업을 수행할 수 있도록 지원하는 할루시네이션 탐지 모델을 파인튜닝. -> 계산 비용 절감 및 효율성 향상. 할루시네이션 탐지 및 추론 성능 잠재적으로 향상 가능.
훈련(Training)
할루시네이션 데이터셋을 기본 모델에 입력하여 할루시네이션 탐지와 추론을 동시에 수행할 수 있는 모델을 학습. -> 대부분 분류용 데이터셋.
GPT-4 API를 이용해 할루시네이션된 콘텐츠에 대한 설명 자동 생성, 분류 데이터에 기반한 구조화된 프롬프트 템플릿 정의해서 분류와 추론 동시에 수행.
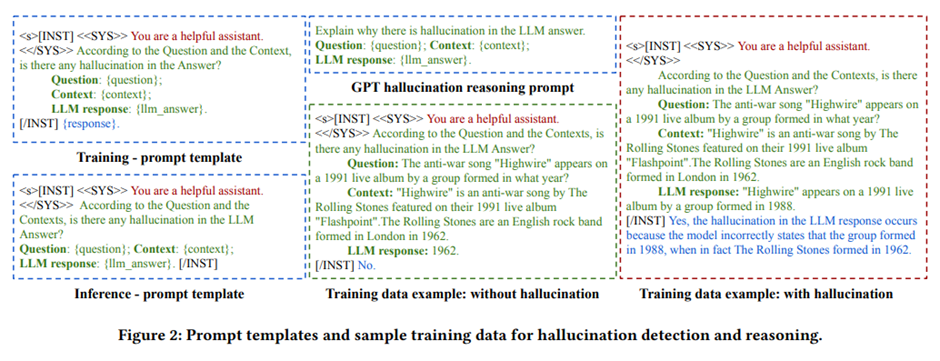
프롬프트 템플릿과 훈련 데이터 예시.
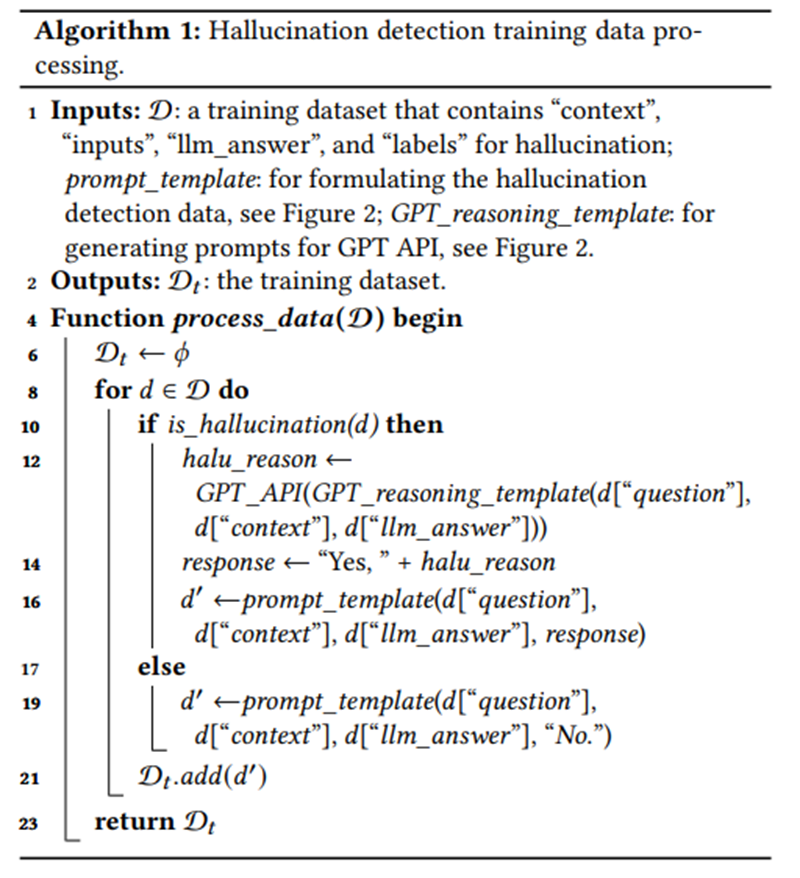
데이터 처리 과정.
입력 (Inputs)
D: 원본 학습 데이터셋 (각 항목은 context, inputs, llm_answer, label 포함)
prompt_template: 프롬프트 구조 정의
GPT_reasoning_template: GPT API 호출 시 사용할 프롬프트 템플릿
출력 (Outputs)
D_t: 새로 생성된 학습 데이터셋 (할루시네이션 여부 + 이유가 포함된 구조화된 데이터)
과정
빈 데이터셋 D_t 초기화 -> 원본 데이터셋 D의 각 샘플 d 순회 -> 각 데이터 할루시네이션 여부 판단
If 할루시네이션: GPT_reasoning_template 사용해서 GPT API 호출 -> 샘플의 ‘question’, ‘context’, ‘llm_answer’를 입력으로 할루시네이션 원인 생성 -> 이 결과를 “Yes, “와 결합해 할루시네이션 탐지 결과 응답 구성 -> prompt_template 이용해서 question, context, llm_answer, 그리고 이 response를 포함하는 구조화된 입력–출력 쌍 d’ 만들고 D_t에 추가
If not hallucination: “No.” 응답 부여하고 동일한 템플릿 구조로 d’ 생성, D_t에 추가.
추론(Inference)
LLM이 응답 내 할루시네이션 존재 여부를 직접 출력 -> 출력의 첫 토큰은 “Yes”/”No”.
디코더 확률적 특성 때문에 top-k 확률(기본 k=10)을 활용해서 할루시네이션 확률 계산.
Probability of hallucination:
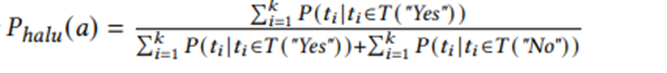
P_halu >= 0.5면 할루시네이션으로 분류, 아니면 안전으로 분류.
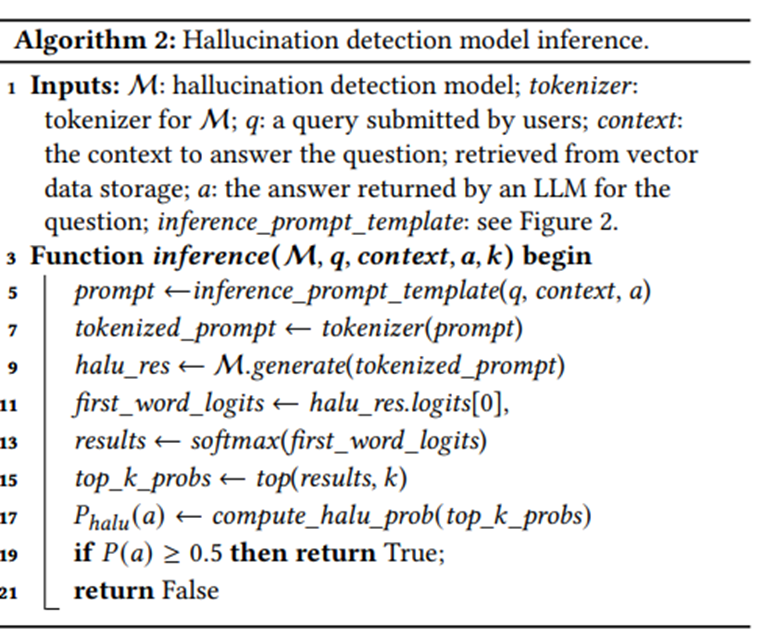
추론 세부 절차.
입력 (Inputs)
할루시네이션 탐지 모델 M, 해당 모델의 토크나이저, 사용자 질의 q, 질의에 대한 문맥(context, 즉 벡터 데이터 저장소에서 검색된 정보), LLM이 생성한 답변 a, 추론용 프롬프트 템플릿(inference_prompt_template), top-k 확률 계산을 위한 상위 토큰 개수 k
과정
주어진 질의 q, 문맥 context, LLM의 응답 a를 이용해 추론용 프롬프트 템플릿을 채워 하나의 완성된 프롬프트 만듦. -> 프롬프트를 모델의 토크나이저로 변환해서 토큰화된 입력 생성 -> 이 토큰화된 입력을 모델 M에 입력하면 모델은 텍스트 생성 과정 수행 -> 결과로 각 토큰에 대한 로짓 산출 -> 그 중 첫 번째 단어(모델이 생성할 첫 번째 토큰)에 대한 로짓 값 추출 -> 소프트맥스 함수를 통해 확률 분포로 변환 -> 확률 분포에서 상위 k개의 토큰과 그 확률을 선택하여 top-k 확률 집합 구성 -> op-k 확률을 사용해 식으로 정의된 환각 확률 P_halu (a)(LLM 응답 a가 할루시네이션일 확률, “Yes”/”No” 토큰의 확률 비율을 통해 계산) 계산 -> P_halu (a) >= 0.5 이면 해당 응답 할루시네이션으로 간주하고 True 반환, 아니면 False 반환.
5 Wildflare GuardRail Grounding
외부 벡터 데이터베이스에서 지식을 검색해 LLM 질의에 맥락을 부여해서 할루시네이션 줄임. 인덱싱 방법 두 가지 사용.
i) Whole Knowledge Index: 데이터셋의 각 전체 데이터 항목을 기반으로 인덱스 생성.
ii) Key Information Index: 각 데이터 항목 내 핵심 정보(예: QA 데이터셋의 질문 부분)만 인덱싱
평가는 콜백(callback), 즉 top-k 쿼리를 사용해 데이터셋에서 원본 레코드를 성공적으로 검색할 확률을 이용해 인덱싱 방법의 효과성을 통해 함.
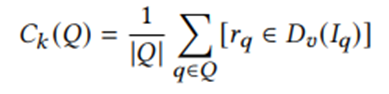
벡터 데이터 저장소 D_v가 n개의 레코드 포함. Q는 평문 사용자 질의 집합, I(Q)는 Q를 기반으로 생성된 벡터 인덱스. 각 질의 q에 대해 I_q는 q를 기반으로 생성된 벡터 인덱스, D_v (I_q )는 I(q)로 D_v를 질의했을 때 반환되는 top-k 레코드 집합, r_q는 D_v 내에서 q와 가장 관련있는 레코드.
6 Wildflare GuardRail Customizer
Wildflare GuardRail Customizer는 경량 래퍼(wrapper)를 활용해 LLM 출력을 유연하게 편집하거나 사용자 정의(customize)할 수 있도록 하며, 작은 오류를 수정하거나 응답의 형식을 개선하는 역할 수행. 코드 기반 규칙, API, 웹 검색, 소형 모델(small model) 등을 통합하여 사용자 정의 프로토콜에 따라 효율적으로 편집 및 맞춤화 수행
장점: 사용자 저의 프로토컬 빠른 개발과 배포 가능, 즉각적인 출력 맞춤화 제공, Wildflare GuardRail의 적용 범위 넓힘, 자원 소모 적음.
예시 1 (URL 경고, Warning URLs): LLM 출력에서 URL 탐지 -> Google Safe Browsing[19]과 같은 피싱 URL 탐지 API로 악성 URL, 접근 불가 URL 검사 -> 출력 앞부분에 경고 추가
예시 2: LLM은 텍스트를 생성하는 동안 이후 생성될 토큰의 발생을 예측할 수 없기 때문에, 미래 토큰에 대한 사전 지식(anticipatory knowledge)을 가질 수 없음. GPT-4에 rabbit 등장 횟수 쓰라는 지시를 함. 5회 등장하지만 4회로 잘못 표기. -> LLM이 텍스트를 일관되게 작성하면서 동시에 정확한 토큰 개수를 세는 능력을 유지하지 못하기 때문에 발생. 추론 후 wrapper의 필요성.
7 Wildflare GuardRail Repairer
Repairer는 환각 탐지 모델이 생성한 환각 원인(reason for hallucination)에 근거하여 환각된 출력을 분석하고 수정함.
입력값: 사용자 질의, grounding 통해 검색된 맥락 정보, LLM이 생성한 할루시네이션 응답, 할루시네이션 원인
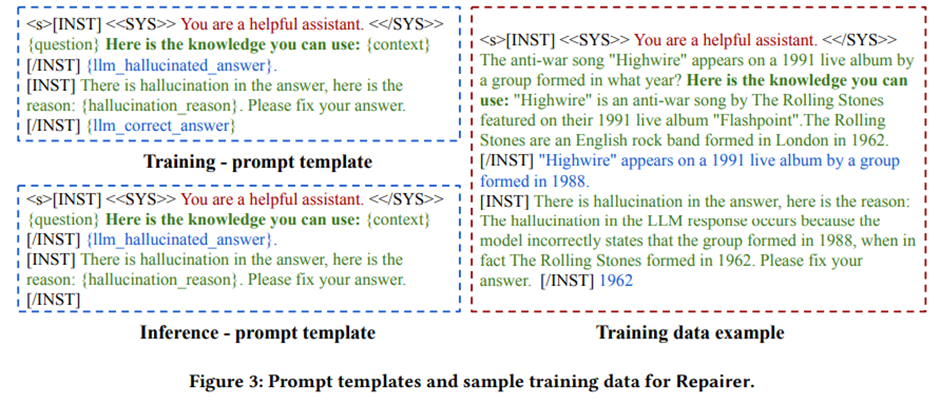
Safety Detector와 동일한 환각 탐지 데이터셋인 HaluEval[38] 사용해 맞춤형 데이터 템플릿 설계.
8 실험(Experiments)
기본 모델: Fox-1(1.6B 파라미터, GQA(그룹 쿼리 어텐션) 기반 모델, 3조 토큰 학습).
파인튜닝: Safety Detector 모델은 현실 세계의 비안전 콘텐츠를 시뮬레이션하기 위해 15개의 데이터셋에서 추출한 데이터를 결합하여 학습, 할루시네이션 탐지 및 설명 모델과 할루시네이션 수정 모델은 HaluEval 데이터셋[38]으로 학습.
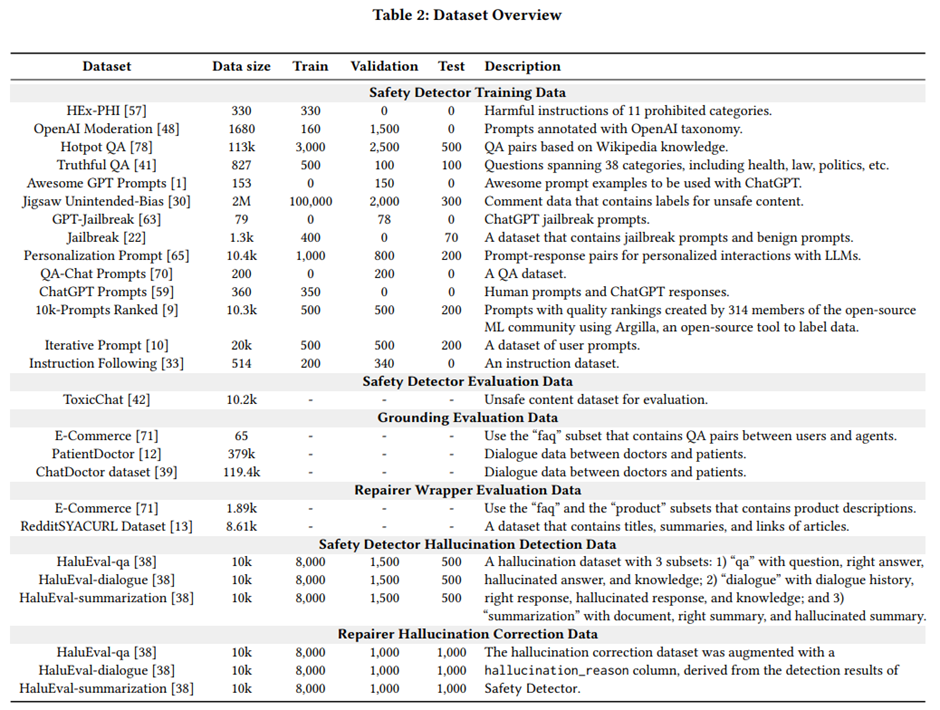
훈련 및 평가에 사용된 데이터셋.
실험 설정: Grounding 평가를 위해, 부정확한 검색이 금전적 손실 또는 위험한 의료 조언으로 이어질 수 있는 중요한 지식을 포함한 데이터셋 사용. 온라인 플랫폼의 고객 서비스 상호작용을 포함하는 E-Commerce 데이터셋[71], 의사와 환자 간 QA 쌍으로 구성된 PatientDoctor 데이터셋[12], ChatDoctor 데이터셋[39] 선택. Grounding의 두 인덱싱 방법의 효과성은 콜백(callback)을 이용해 평가.
Customizer의 평가는 E-Commerce[71] 데이터셋과 RedditSYACURL 데이터셋[13] 사용.
모든 평가와 모델 학습 실험은 NVIDIA H100 GPU 8개가 장착된 서버에서 수행.
실험 1 (Exp 1). Safety Detector에서의 비안전 사용자 입력 탐지(Unsafe user inputs detection).
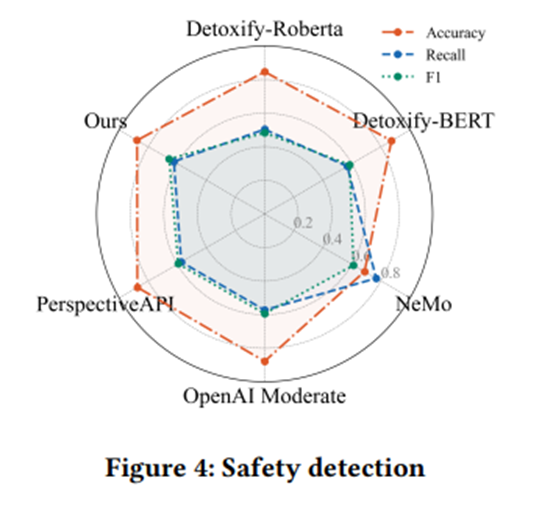
제안한 접근법을 Detoxify-RoBERTa[21], Detoxify-BERT[21], Nvidia NeMo GuardRail[61], OpenAI Moderate[48], Perspective API[36]와 비교.
OpenAI API와 비교 가능한 성능(comparable performance) 달성. 전반적으로 모델은 주요 평가 지표에서 견고한 성능(robust performance)을 보여줌, 실제 응용 환경에서의 효과성과 신뢰성(effectiveness and reliability) 입증.
실험 2 (Exp 2). Safety Detector에서의 LLM 출력 할루시네이션 탐지(Hallucination detection in LLM outputs).
HaluEval의 qa, dialogue, summarization에서 8,000개는 훈련, 1,500개는 검증, 500개는 테스트에 사용. 테스트 정확도 0.78.
실험 3 (Exp 3). Grounding에서의 인덱싱 방법 비교(Evaluation of different indexing methods).
사용한 질의: 원본 질의(데이터셋의 원래 질문과 동일한 질의, “O”로 표기), 재구성 질의(원본 질문을 TinyLlama[81] 또는 요약 모델[15]을 이용해 재표현하여 사용자 질의의 다양성을 시뮬레이션한 것, “R”로 표기)
각 평가에서 데이터셋에서 50개의 질문을 무작위로 선택하여 질의 집합 Q 구성, top-k 쿼리 처리하여 콜백 C_k (Q) 계산. K=1, 3, 5, 10.
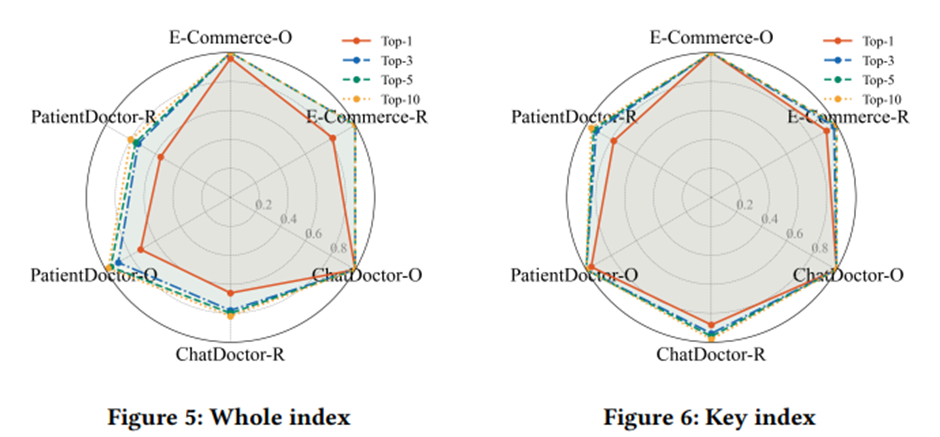
Key information indexing이 whole knowledge indexing보다 우수한 성능. -> 핵심 정보 인덱스가 사용자 질의를 더 잘 반영.
원본 질의와 재구성 질의 모두 높은 콜백 비율 달성 -> 다양한 사용자 입력을 처리할 때 벡터 검색의 효과성 입증.
실험 4 (Exp 4). Customizer의 래퍼(wrapper) 효율성 평가(Efficiency of wrappers in Customizer).
E-Commerce + RedditSYACURL 데이터셋에서 각각 15개의 레코드를 무작위로 선택하여 각 레코드를 결합해 URL이 포함된 텍스트 구성. 텍스트 내에 악성 URL을 삽입할 확률 20%로 설정.
URL 탐지를 위해 정규 표현식 사용, 악성 URL 탐지를 위해 Google SafeBrowsing[19]을 활용, 안전한 URL의 접근 가능성을 확인하기 위해 HTTP 요청 전송.
Customizer를 TinyLlama[81], Mistral-7B[28], LLaMA2-7B[72], Falcon-40B[2] 모델들과 비교.
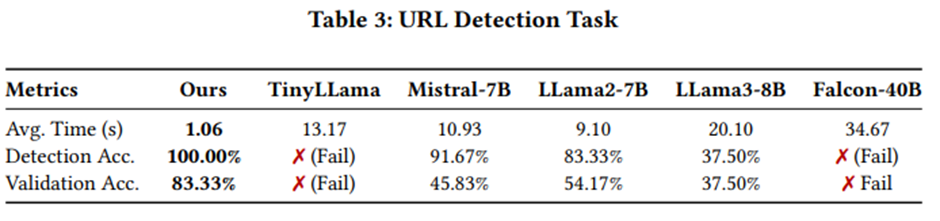
각 실험에서 질의 1건을 처리하는 평균 시간, URL 탐지 성공률(Detection Accuracy), 비안전 URL 식별 정확도(Validation Accuracy) 기록.
Wildflare GuardRail Customizer는 질의당 평균 1.06초, LLM 출력을 수정하기 위해 모델을 직접 호출하는 방법보다 훨씬 높은 효율성과 성능
TinyLlama와 Falcon-40B는 콘텐츠 내 URL을 전혀 탐지하지 못함.
Mistral-7B는 91.67%의 높은 URL 탐지 정확도, 비안전 URL 식별 정확도는 45.83%.
실험 5 (Exp 5). Repairer의 환각 수정 효과성 평가(Effectiveness of fixing hallucinations in Repairer).
HaluEval 데이터셋[38]의 QA 및 Dialogue 하위 집합을 사용하여 수정(fixing) 모델 파인튜닝. 각 하위 집합에서 8,000개는 훈련, 1,000개는 검증, 1,000개는 테스트에 사용.
Safety Detector의 탐지 결과로부터 생성된 hallucination_reason 열(column)을 추가하여 데이터셋 증강. -> 탐지 단계에서 식별된 환각의 근본 원인(root cause)을 분류함으로써, 수정 단계에서의 대응 전략 설계를 가능하게 함.
Vectara 할루시네이션 탐지 모델로 평가. LLM 출력과 원본 데이터(사용자 질문, 맥락, 정답) 간의 일관성 측정. 100개 테스트셋 평가 결과 출력 품질 크게 향상, 전체 할루시네이션 데이터 중 80.7%가 Reparirer를 통해 성공적으로 수정.
9 결론(Conclusion)
Wildflare GuardRail은 탐지, 맥락화, 수정, 맞춤화 기능을 통합한 guardrail pipeline 제시. -> 안정성 격차 해소, 신뢰할 수 있는 AI 연구의 기반 마련.
향후 연구 방향:
새로운 위협에 대응하기 위한 모듈형 설계 확장
저지연 환경을 위한 자원 효율성 최적화
멀티모달 안전 점검 통합