2024년 8월 13일, arXiv 공개
초록
우리는 이 능력을 측정하기 위해 LLM이 설문지 형식의 심리학 실험 범위 내에서 다양한 국적을 대표하는 인간 프로필을 시뮬레이션하도록 합니다. 구체적으로, 우리는 GPT3.5 7,286명의 참가자(15개국 출신)가 설득력 있는 뉴스 기사에게 보이는 반응을 재현하기 위해; 결과를 동일한 인구통계학적 특성을 공유하는 실제 참가자 데이터셋과 비교했습니다. 우리의 분석 결과, 개인의 거주 국가를 명시하면 GPT-3.5의 응답 일치도가 향상됩니다. 반 면, 모국어 프롬프트를 사용하면 전체 일치도가 크게 감소하는 변화가 발생하며, 일부 언어는 성능을 특히 저해합니다.
1 서론
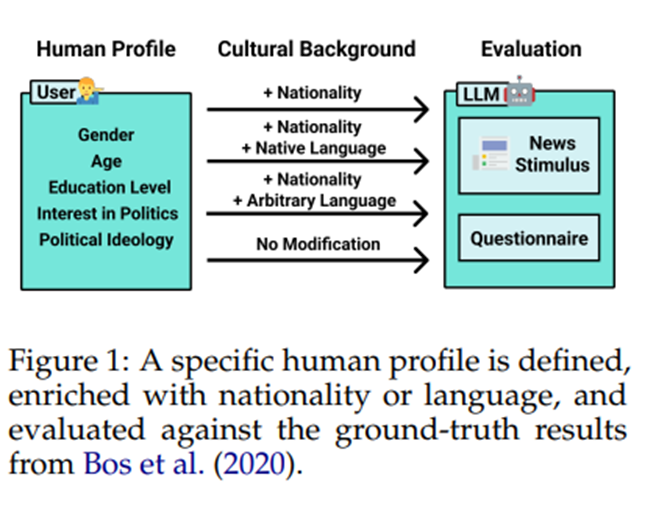
LLM은 여전히 영어와 영미 중심 문화에 편향된 모델을 생성함.
이 연구에서는 국가 관련 정보를 전달하는 관점에서 두 가지 질문을 다룸. 첫째, 다양한 방법이 LLM에게 개인의 국적을 전달하는 데 얼마나 효과적인가? 둘째, 이러한 국가적 특성이 다양한 다언어 환경에서 얼마나 정확하게 표현되는가?
2 관련 연구
2.1 대규모 언어 모델의 다언어 및 다문화적 측면
LLM은 고자원 언어에 대한 편향을 보일 수 있음. 또한 프롬프트를 통해 모델을 특정 국가의 관점을 고려하도록 유도하면 해당 인구집단의 의견을 재현하는 능력을 향상 시킬 수 있지만, 동시에 고정관념을 유발할 수 있음.
2.2 대규모 언어 모델의 인간 유사 특성
모델들이 특정 하위 그룹의 인간과 유사한 특성을 자체적으로 안정적으로 보여주지 않을 수 있지만, 이를 조정할 수 있음. 대화 에이전트가 동시에 여러 캐릭터를 연기하는 것으로 볼 수 있으며, 충분한 맥락이 제공될 때만 단일 개인에 해당하는 응답을 생성함.
2.3 LLM의 합성 행동 시뮬레이션에서의 역할
Argyle et al. (2023)은 인구 집단에 대한 사전 정의된 개인별 특성을 LLM에 입력하여 인간과 유사한 설문 응답을 생성하는 ‘실리콘 샘플링’을 제안함. LLMs는 정치 분야에서 인간 행동을 모방하고, 공공 여론을 예측하는 데 활용됨.
한계가 있음. 순서 지정 및 라벨링 편향이 LLMs의 인간 행동과의 일치도에 영향을 미침. LLMs가 인간 결과와 비교할 때 명확한 공정성 선호도를 보여주며, 긍정적 상호작용이 약함. 또한, 그들은 인간 내부에 존재하는 효과를 변동성 감소로 인해 과대평가할 수 있음.
3 방법론
서론에서 제기된 질문 ― “첫째, 개인의 국적을 LLM에 전달하는 다양한 방법들은 얼마나 효과적인가?” 그리고 “이러한 국가적 특성은 다양한 다국어 환경에서 얼마나 정확하게 묘사되는가?” ― 에 답하기 위해, Bos et al.(2020)이 수행한 연구를 기반으로 한 세 가지 실험을 수행함. 해당 연구는 인간 참가자들이 포퓰리즘 뉴스 자료에 의해 어느 정도 설득되고 동원되는지를 평가했음.
3.1 페르소나 합성
기존의 인간 대상 연구에서, 참가자들은 자신의 인구통계학적 정보와 자기 평가한 상대적 박탈감을 상세히 기술한 설문지를 작성했으며, 후자는 정치적, 사회적, 경제적 취약성에 대한 감정을 측정했음. 이후 참가자들은 경제적 악화를 예측하는 뉴스 기사에 노출됨. 참가자의 25%는 사실적인 기사 버전에, 25%는 정치 엘리트를 비난하는 버전에, 25%는 이민자를 비난하는 버전에, 나머지 25%는 두 집단 모두를 비난하는 버전에 노출됨. 기사를 읽은 후, 참가자들은 다섯 개의 진술에 대해 1~7점 척도로 동의 수준을 평가했는데, 두 개의 진술은 자신이 얼마나 설득되었는지를, 세 개의 진술은 자신이 얼마나 행동으로 동원되었는지를 평가함. 이러한 평가의 평균은 각각 각 참가자의 설득 점수와 동원 점수를 결정하는 데 사용됨.
이를 LLM 시뮬레이션에 적합한 형식으로 변환함. 7,286명의 시뮬레이션 참가자 표본은 15개국에 걸쳐 있었으며, 여기에는 14개의 유럽 국가와 이스라엘이 포함됨. 이는 국가당 평균 486명의 참가자(표준편차 = 74)를 산출함.
3.2 실험 1: 국적 표기의 효과
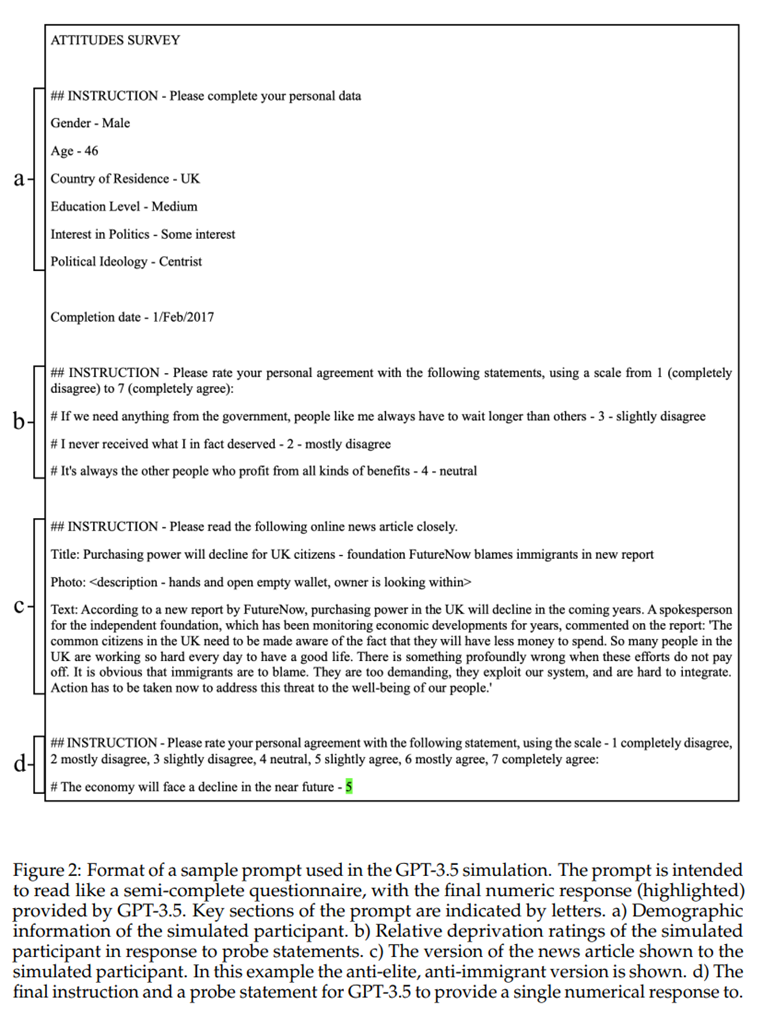
첫 번째 실험은 시뮬레이션된 참가자의 국적을 표기하는 효과를 평가함. 시뮬레이션은 두 번 수행되었는데, 한 번은 국적 정보가 드러난 상태(그림 2에 나타난 바와 같이 (a)의 ‘거주 국가’와 프롬프트의 (c) 구역에 있는 모든 국가 언급 포함)였고, 한 번은 가려진 상태였음. 두 시뮬레이션 모두에서, 시뮬레이션된 참가자의 국적과 관계없이 모든 프롬프트는 영어로 제시됨.
3.3 실험 2: 단일 언어를 사용하여 다국적 참가자를 시뮬레이션하는 효과
두 번째 실험에서는 모든 프롬프트에 국적 정보가 포함되었으며, 프롬프트의 언어가 달라짐. 시뮬레이션은 총 12회 수행되었고, 각 실행(run)에서는 참가자의 국적과 무관하게 동일한 언어로 시뮬레이션됨. 사용된 12개 언어는 Bos et al.(2020)에서 조사된 15개 국가에서 다수 사용되는 언어들임.
3.4 실험 3: 모국어를 사용하여 다국적 참가자를 시뮬레이션하는 효과
세 번째 실험에서는 모든 프롬프트에 국적 정보가 포함되었으며, 데이터셋 전체에서 프롬프트 언어가 달라짐. 주요 조건에서는, 프롬프트 언어가 각 시뮬레이션 참가자의 모국어와 일치하도록 설정됨. 국가-섞기(country-shuffled) 조건에서는, 각 언어를 사용하는 국가의 수는 일정하게 유지하면서, 프롬프트 언어가 무작위로 각 국가에 할당됨. 전체-섞기(full-shuffled) 조건에서는, 프롬프트 언어가 참가자 단위에서 무작위로 할당되었으나, 전체적으로 사용된 언어의 분포는 유지됨. 두 가지 섞기 조건 모두에서, 결과의 변동성을 평가하기 위해 시뮬레이션이 100회 수행됨.
3.5 프롬프트 절차
모든 실험은 OpenAI API를 사용하여 GPT-3.5-Turbo-1106 모델에 접근함으로써 수행됨. 각 시뮬레이션 참가자에 대해 다섯 개의 프롬프트가 GPT-3.5에 전송되었으며, 각 프롬프트는 사전에 생성된 설문지에 다섯 개의 탐색 진술 중 하나가 추가된 형태였음. 이 탐색 진술은 참가자가 포퓰리즘 자료를 접한 뒤 설득되었는지 혹은 동원되었는지를 평가하는 내용이었음. 각 프롬프트에 대해 LLM은 단일 숫자를 응답으로 반환하였음. 원래 연구를 따라, 각 참가자의 설득 점수와 동원 점수는 모델이 제공한 설득 및 동원 평가의 평균을 취하여 계산됨. 모든 언어의 프롬프트 번역은 영어에도 능통한 원어민 화자들에 의해 검증되었으며, 이를 통해 설문의 언어적 의미가 손실되거나 왜곡되지 않고 성별 편향이 도입되지 않았음을 보장함. 전체 파이프라인도 공개함.
4 평가
원래 분석과 마찬가지로 회귀분석을 사용함. 이 모델들에서 불리언 특징 E와 I는 각각 참가자가 반(反)엘리트 및 반(反)이민자 프레이밍에 노출되었는지를 나타내며, 특징 1 ≤ D ≤ 7은 참가자의 상대적 박탈감 평가의 평균을 부호화한다. P ̅와 M ̅은 각각 설득과 동원 평가의 평균임. C 항들은 국가 특유의 요소로, 지수 i는 참가자의 국가와 일치하도록 선택됨. 회귀분석은 C 항들(그 결과 P 버전과 M 버전이 국가 전체에서 평균이 0이 되도록)과 λ 계수들의 값을 추정함.
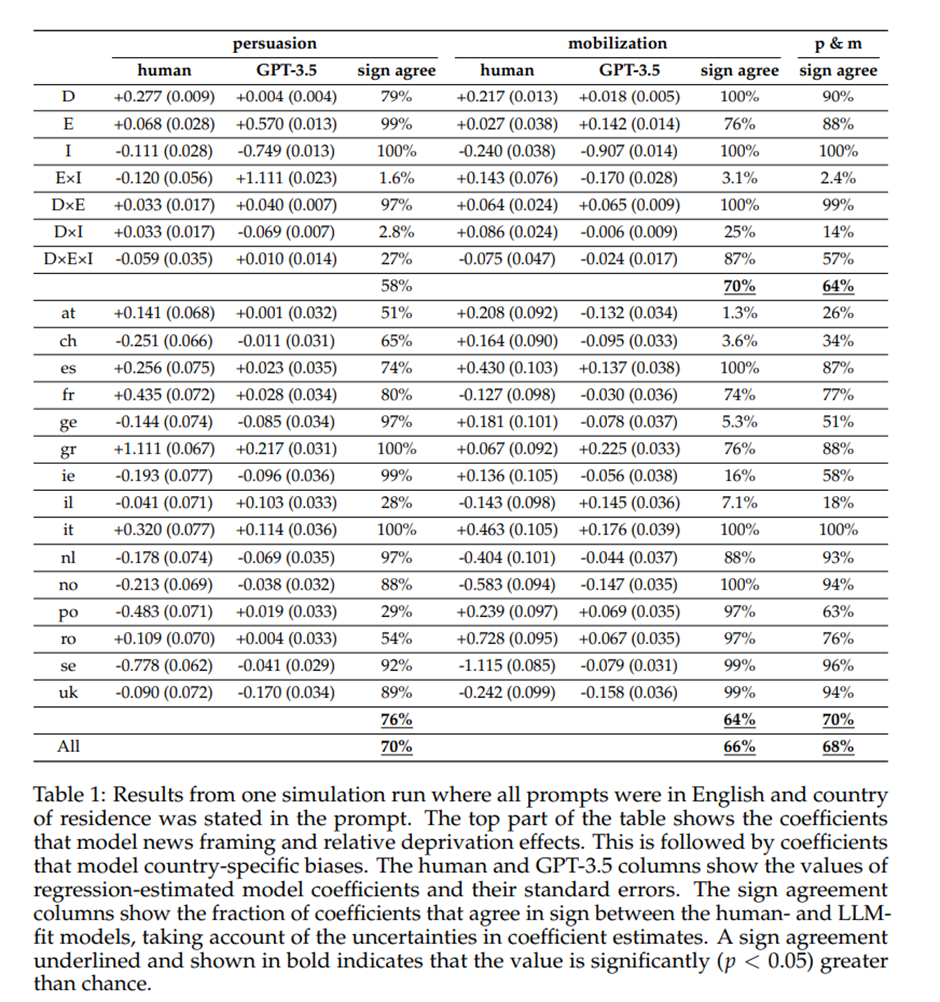
P와 M 모두에 대해 세 가지 모델 ― A, B, C ― 를 적합시킴. 모델 A는 국가 항과 D, E, I의 비상호작용(non-interaction) 항을 포함함. 모델 B는 이에 두 항 간 상호작용 EI, DE, DI를 추가한다. 모델 C는 여기에 세 항 상호작용 DEI를 추가함. 계수가 처음 등장하는 세 모델 중 가장 이른 모델에서 계수 추정치를 추출함.
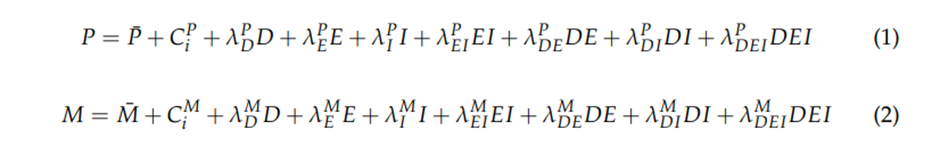
우리는 인간 데이터에 대해 회귀분석으로 도출된 계수의 부호를, LLM 응답에 대해 회귀분석으로 도출된 계수의 부호와 비교함.
이후의 분석에서는 오직 두 수치에 초점을 맞춘다: 첫째, 국가 특유 편향 항에 대한 부호 일치율, 둘째, 프레이밍 및 상대적 박탈감 계수에 대한 부호 일치율. 두 경우 모두 설득 계수와 동원 계수의 비율을 합산하여 고려함.
5 결과
5.1 실험 1: 국적 표기의 효과
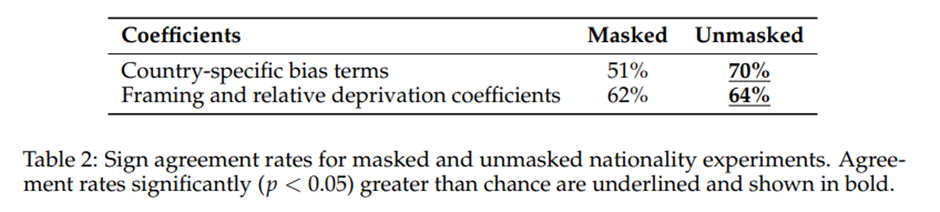
부호 일치율은 국적이 드러난 조건에서만 우연보다 유의하게 높았음. 시뮬레이션된 참가자의 국적을 드러냄으로써 발생한 부호 일치율 증가는, 프레이밍과 상대적 박탈감 계수(+2%)보다 국가 특유 계수(+19%)에서 훨씬 더 크게 나타났음.
5.2 실험 2: 단일 언어를 사용하여 다국적 참가자를 시뮬레이션하는 효과
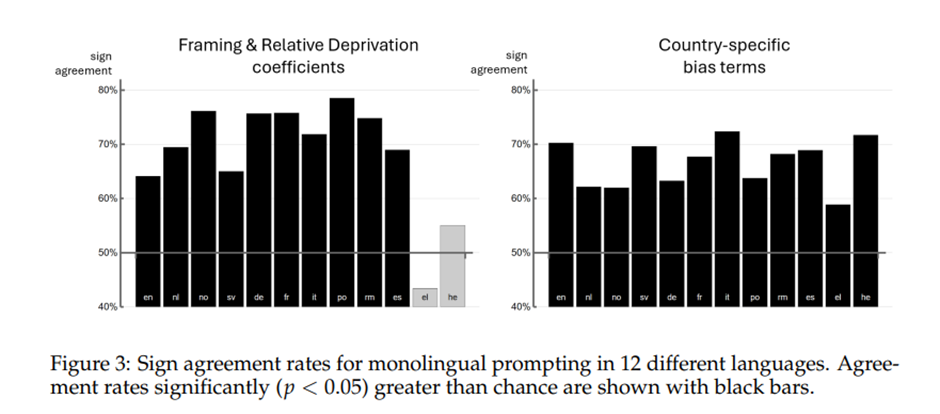
프롬프트 언어에 따라 나타나는 부호 일치율의 변동성은 국가 특유 계수보다 프레이밍 및 상대적 박탈감 계수에서 더 크게 나타났음. 특히 그리스어와 히브리어 프롬프트에서는 프레이밍 및 상대적 박탈감 계수의 부호 일치율이 우연보다 유의하게 큰 수준에 도달하지 못했음. 흥미로운 점은, 그리스어와 히브리어가 평가된 12개 언어 중 영어와 어휘적으로 가장 거리가 먼 언어라는 사실이지만, 어휘적 거리에 따라 부호 일치율이 감소하는 일반적인 경향은 나타나지 않았다는 것임.
5.3 실험 3: 모국어를 사용하여 다국적 참가자를 시뮬레이션하는 효과
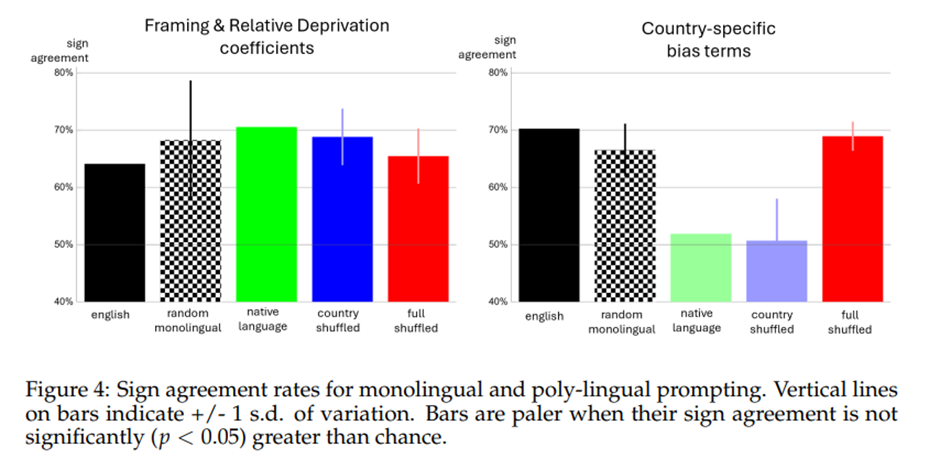
프레이밍 및 상대적 박탈감 계수의 부호 일치율에 대해서는 어느 프롬프트 방식도 유의한 우위를 가지지 못했음. 그러나 국가 특유 계수의 경우, 모국어 및 국가-섞기(country-shuffled) 프롬프트 방식은 단일 언어 프롬프트나 전체-섞기(full-shuffled) 프롬프트보다 훨씬 성능이 떨어졌으며, 우연보다 유의하게 큰 부호 일치율에 도달하지 못했음.
6 논의
반(反)엘리트 프레이밍은 설득과 동원을 증가시키는 반면, 반(反)이민자 프레이밍은 이를 감소시킨다는 점은 외집단을 비난하는 어떤 유형이든 증가를 초래할 것이라는 사회정체성 이론 기반의 예측과는 반대되는 결과였음.
7 한계와 향후 연구
본 연구의 두드러진 한계는 주로 유럽 국적자들에 집중했음. 향후 연구는 더 넓은 범위의 문화와 국적을 포함하도록 조사를 확장할 필요가 있음.
본 연구는 주로 단일 모델인 GPT-3.5의 성능을 검토했음. 다양한 모델에 걸쳐 문화적 적응성을 평가하는 종합적인 벤치마크를 개발하는 방향으로 연구를 확장할 상당한 잠재력이 있을 것임.
8 결론
두 가지 핵심적 통찰을 제안한다: (i) 인간 프로필의 국적을 명시하는 것은 GPT-3.5가 그들의 행동을 시뮬레이션하는 효과성을 향상시킨다. (ii) 참가자를 모국어로 시뮬레이션하는 것은 시뮬레이션의 충실도에 부정적인 영향을 주며, 특히 그리스어와 히브리어가 본 실험 환경에서 가장 해로운 요인으로 작용한다.