What is Reinforcement Learning
Reinforcement Learning is a discrete time stochastic control process, where an agent interacts with its environment/state
머신러닝의 종류에는 정답이 주어진 데이터로 학습해서 새로운 데이터에 대한 값이나 카테고리를 예측하는 지도학습(Supvervised Learning), 정답이 없는 데이터를 적절히 그룹화하거나 각 데이터 간의 관계를 찾아내는 비지도학습(Unsupvervised Learning), 그리고 어떤 임의의 존재(Agent)가 주어진 환경 내에서 어떻게 행동해야 하는지에 대해 학습하는 것을 다루는 강화학습(Reinforcement Learning)이 있다.
강화학습(Reinforcement Learning)는 어떤 임이의 존재 (Agent)가 주어진 환경 내에서 어떻게 행동해야 하는지에 대해 학습하는 것을 다루는데, 이러한 학습 과정은 다양한 상황에서 Agent가 한 행동에 대해, 양 또는 음의 보상으로 피드백을 받음으로써 진행된다.
강화학습 - 환경,상태,행동, 보상
강화학습의 최종 목표는 환경(Environment)과 상호작용하는 임의의 Agent를 학습시키는 것이다. Agent는 상태(State)라고 부르는 다양한 상황안에서 행동(Action)을 취하며 조금씩 학습해나간다. Agent가 취한 행동은 그에 대한 양(+)이나 음(-), 또는 0의 보상(Reward)을 돌려받는다.
여기서 Agent의 목표는 처음 시작하는 시점부터 종료시점까지 일어나는 모든 에피소드에서 받을 보상값을 최대로 끌어올리는 것이다. 이를 위해 음(-)값의 보상을 받는 행동은 최대한 피하도록 하고, 양(+)값의 보상을 받을 수 있는 행동을 강화시킨다는 의미에서 강화학습이라는 이름이 붙게 되었다. 이렇게 Agent가 학습을 하는 과정에서 점점 발전하게 될 의사결정 전략을 정책(Policy)라고 한다.
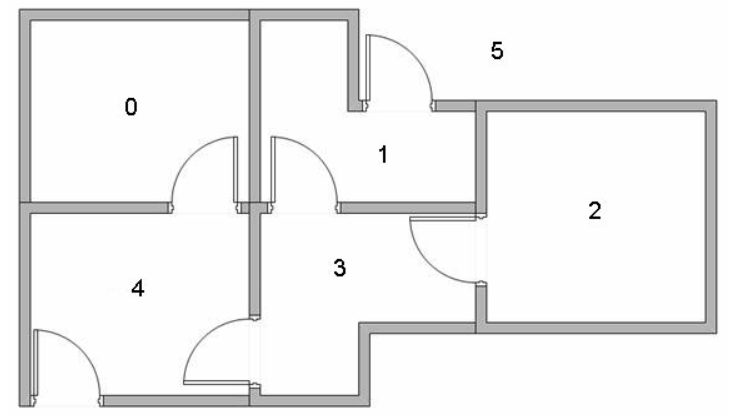
위와 같이 5개의 방이 있다고 가정한다. 5번 방은 밖이라고 생각할 때 밖으로 나가는 방법에 대하여 생각해 보려고 한다. (즉, 5번방으로 가는 방법)
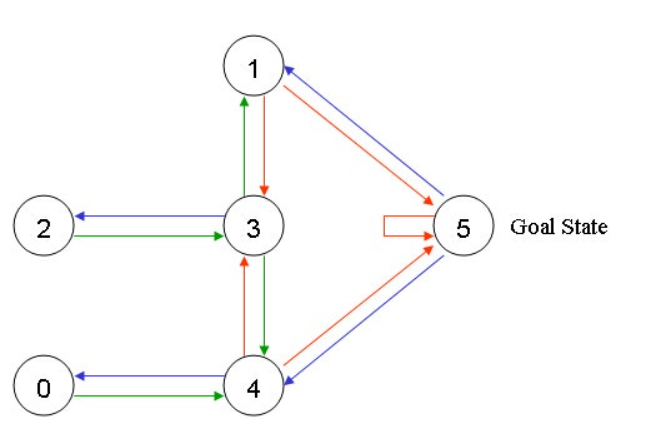
위의 그림에 있는 방을 node와 edge로 표시하면 다음과 같다.
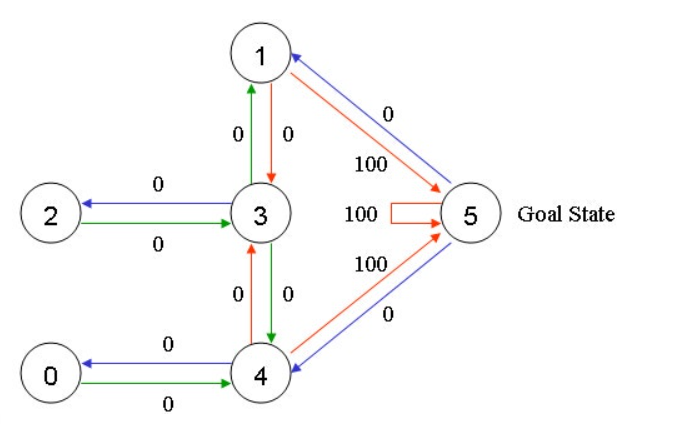
이 때 5번방으로 가야 하므로 5번방으로 직접 갈 수 있는 곳에는 edge의 weight을 100으로 두고 나머지 edge의 weight는 0으로 둔다.
이제 어느 Node에 있다고 하더라도 5번에 갈 수 있는 효율적인 방법을 학습할 수 있게 Q-Learning을 이용해 보도록 하자.
Q-Learning에서의 Goal은 가중치가 가장 큰 reward에 도달하는 것이다.
예를 들어 아래와 같이 2번에서 출발하여 5번에서 도착해야 한다.
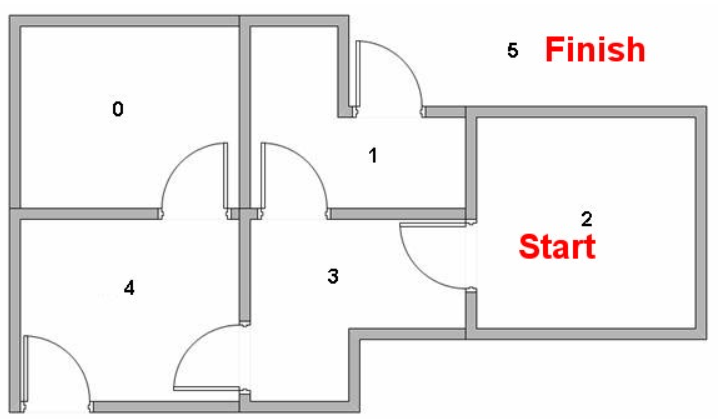
Q-Learning에서는 State와 Action이라는 용어가 나온다. 여기서 방(room)에 해당하는 것이 State이고, 방을 이동하는 것이 Action에 해당한다. 위의 다이어그램에서 State는 Node르ㅗ Action은 edge로 표현되어 있다.
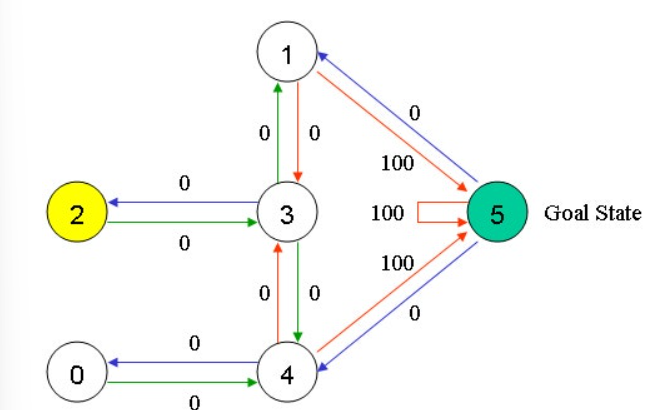
State 2에서 시작하여 State 5에 도착하려면 2->3->1->5 또는 2->3->4->5로 가야한다. 여기서 2->1로는 edge가 없으므로 갈 수 없다. 위의 정보를 matrix로 표현하려면 아래와 같이 표현할 수 있다.
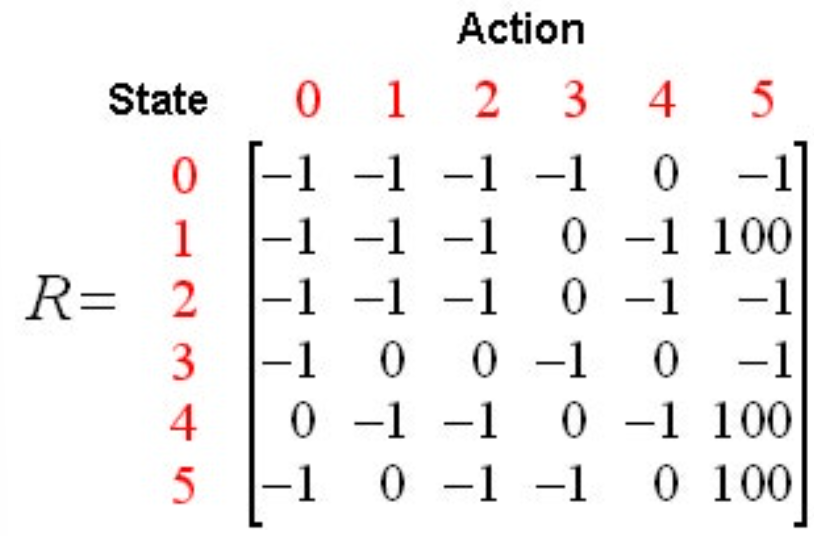
위의 Matrix를 R-Matrix(Reward Matrix)라고 한다. 이 Matrix에서는 edge의 weight이 표현되어 있다. 만약 edge가 없는 경우에는 -1로 표현하여 edge가 없음을 표현한다.(null value)
이제 R-matrix를 이용하여 우리가 학습한 결과를 나타낸 Q-Matrix를 만들려고 한다.
Q-Learning의 Formula는 다음과 같다.
Q(State, Action)=R(State,Action)+Gamma*Max[Q(next state, all actions)]
Q-Learning의 알고리즘은 다음과 같다.
1. 매개변수 gamma를 설정하고 matrix R에 환경변수를 입력한다.(가중치)
2. Matrix Q를 모두 0으로 초기화한다.
3. 다음 로직을 따른다.
For each episode:
	임의의 state를 선택한다.
    Do While(목표치에 도달하지 않았다면)
    	현재 State에서 가능한 action 중 하나를 선택한다.
    	선택한 action을 사용하여, next stage로 향한다.
    	모든 가능한 action을 기반으로 next stage의 Q value의 최댓값을 구한다.
    	Compute: Q(state, action) = R(state, action) + Gamma*Max[Q(next state, all actions)]
    	next state를 현재 state로 삼는다.
    End Do
End For
위의 작업을 계속 반복할수록 Q matrix에 experience가 축적되게 되어 learning 값이 최적화되다가 어느 순간 수렴하게 된다. 이 수렴값이 goal state가 된다.
gamma값은 0과 1사이 값이 되어야 한다. gamma값이 0에 가까우면 수렴값을 빨리 찾게 되는 반면 1에 가까우면 좀 더 큰 weight 값을 가지게 되어 값의 의미가 명확해진다.
다음은 Q-laerning을 직접 해본 예시디아.
gamma값은 0.8이라고 가정한다.
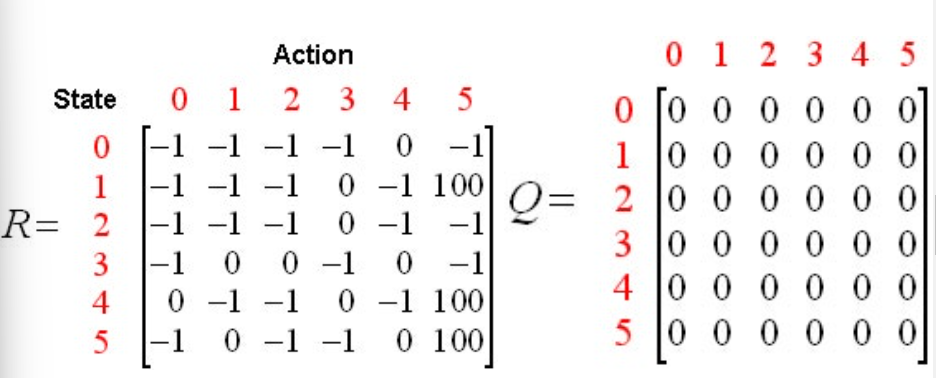
R matrix와 Q matrix가 다음과 같이 있다고 생각해 본다. R matrix는 위의 예제를 옮긴 것이다.
현재 State를 1, action(1->5)라고 생각해보면 식은 다음과 같다.
Q(state, action) = R(state,action)+gammaMax[Q(next state, all actions)]
Q(1,5) = R(1,5)+0.8Max[Q(5,1), Q(5,4), Q(5,5)] = 100 + 0.8*0=100
Q matrix가 모두 0으로 초기화 되어 있는 상태이기 때문에 값은 모두 0이다. Q(1,5)는 100이기 때문에 Q matrix를 다음과 같이 update한다.
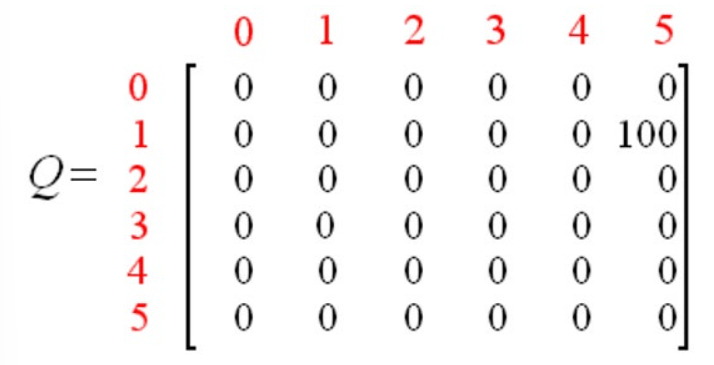
이제 현재 state를 3, action을 (1->3)이라고 생각해 본다.
Q(state,action) = R(state,action) + GammaMax[Q(next state, all actions)]
Q(3,1) = R(3,1)+0.8Max[Q(1,3),Q(1,5)] = 0 + 0.8*Max(0,100)=80
이 결과를 update하면 다음과 같다.
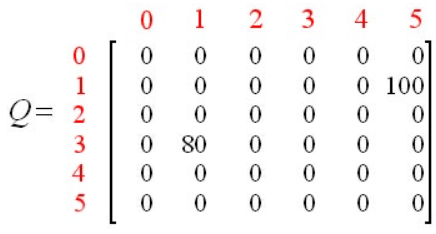
위에서 normalize 이전까지의 Q값을 구하면 아래와 같다.
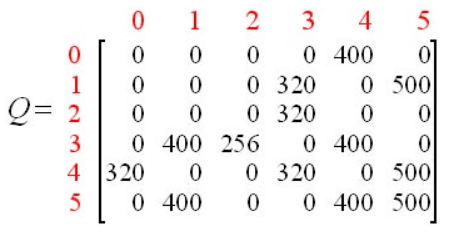
Q 원소 중 최댓값인 500을 이용하여 normalize한 최종적은 Q는 다음과 같다.
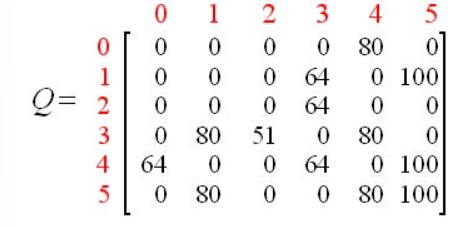
각 State에서 학습한 5번 State로 가기 위한 최적의 결과를 정리하면
0: 0->4(가중치 80)
1: 1->5(가중치 100)
2: 2->3(가중치 64)
3: 3->1, 4(가중치 80)
4: 4->5(가중치 100)
5: 5->5(가중치 100)
이 결과를 직접 반영하여 본다.
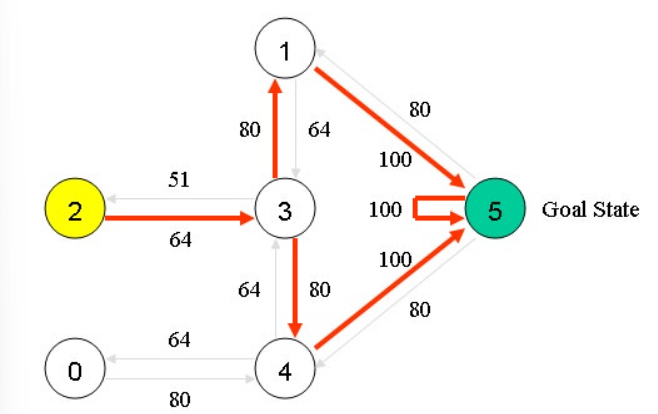
위에서 보면 State 2에서 시작하였을 때는 빨간색 edge를 이용하여 5번 state까지 찾아갈 수 있따.
또다른 예제
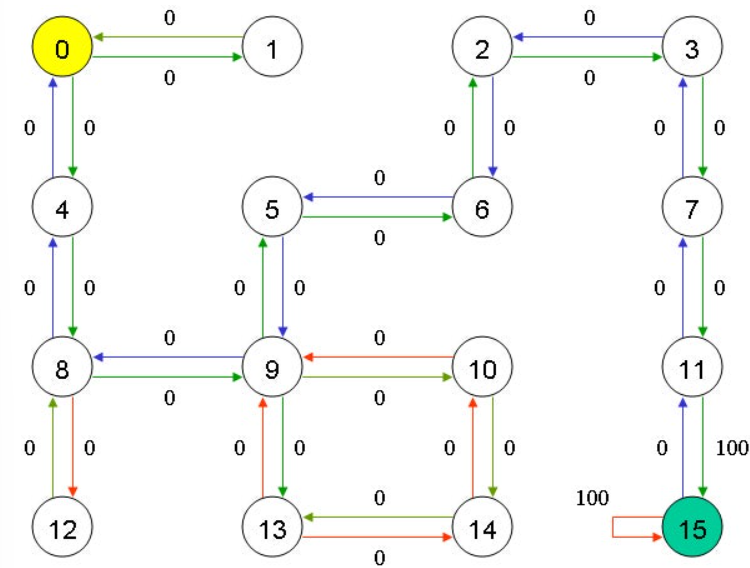
Reference