머신러닝 추천 시스템 과제: 아래 유사도 행렬 계산 방식에 대해서 공부하기
- 정의, 공간/시간 복잡도, 어떤 데이터가 쓰이는지, 적용사례, 장단점 등
(Definition, space/time complexities, target data, Applications, pros and cons)
- Euclidean distance, Manhattan distance, Minkowski distance
- Jaccard similarity
- Pearson correlation
- Cosine similarity(cosine angle between two vectors)
- Dot product (cosine angle and magnitude of the vectors)
0. Background
1. 거리함수 (metric, distance function)
1.1 거리함수의 조건
거리함수는 아래와 같은 조건을 만족하는 함수를 의미한다.
1.2 Similarity and Dissimilarity
거리함수는 말 그대로 어떤 점과 점 사이의 거리를 나타내며, 거리함수 종류에 따라 유사도(similarity) 또는 상이성(Dissimilarity)으로 표현된다.
1. Similarity Measure
Similarity measure는 두 data object가 얼마나 유사한지를 나타내며, 수가 커질수록 서로 유사하다고 얘기한다.
2. Dissimilarity Measure
Dissimilarity measure는 두 data object들이 얼마나 서로 다른지를 나타내며, 수가 클수록 상이하다고 얘기한다.
Proximity
Proximity(근점성)은 Similarity와 Dissimilarity를 포괄하는 말이다.
2. Norm
Norm은 벡터의 크기, 또는 길이를 측정하는 방법을 일반화한 것을 의미한다. 두 벡터 사이의 거리를 측정하는 방법을 의미하기도 한다.
Regularization
모델 학습을 할 때 과적합(Overfitting)을 방지하기 위해 cost function에 규제항(Penalty)을 넣어준다. 특정 변수 또는 가중치(Wegiht)가 과도하기 커지지 않도록 하는 역할이 Regularization이다.
L1 Regularization
Lasso(라쏘) model: L1 Regularization을 사용하는 선형 회귀 모델을 말함
L2 Regularization
Ridge(릿지) model: L2 Regularization을 사용하는 선형 회귀 모델을 말함
변수 선택에서 Lasso와 Ridge
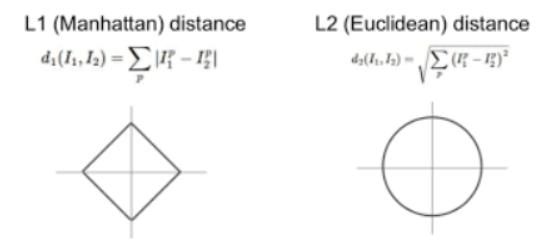
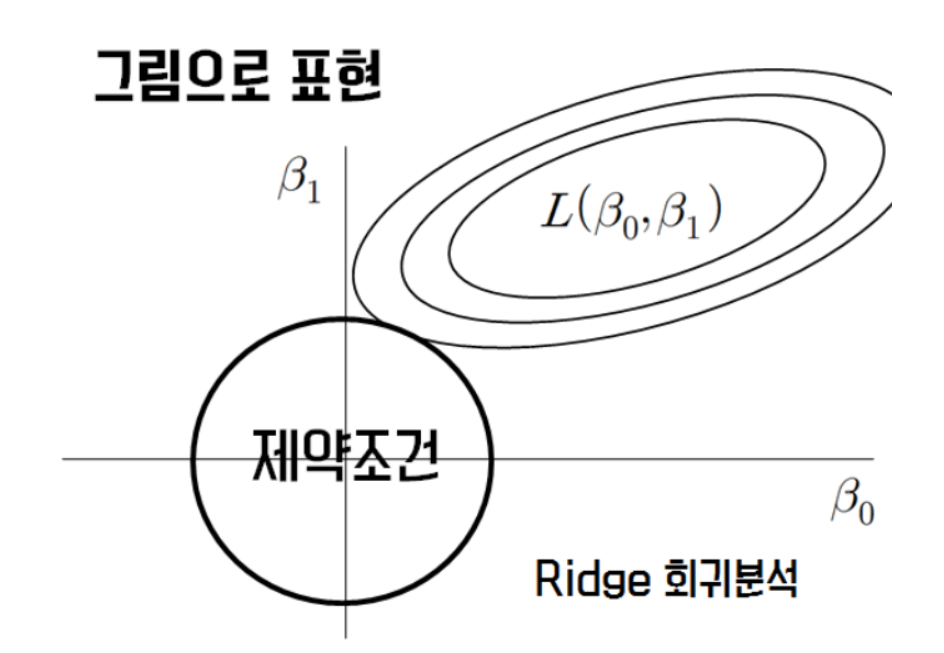
Regularization Term으로 맨하탄 거리와 유클리디안 거리를 사용한다.
Correlation(상관관계)
Correlation can measure the linear relationship
(상관관계란 선형 관계를 측정할 수 있는 지표, 비선형 관계의 상관관계는 구할 수 없다.)
예를 들어, 다음과 같은 데이터 셋이 있다고 했을 때 (x=[-3,-2,-1,0,1,2,3], y=[9,4,1,0,1,4,9]) 상관관계는 0으로 나온다. 하지만, 이 데이터들은 라는 함수로 표현되며, 이는 x와 y는 서로 비선형 관게로 연관이 되어 있음을 의미한다.
Similarity(유사도)
데이터를 클러스터링/분류하기 위해서는 기준이 있고, 그 기준 중에 하나가 Similarity(Dissimilarity=distance)이다. 유사도는 두 개의 데이터 성질이 얼마나 닮았는지를 나타낸다. 유사도의 범위는 [0,1]. 비유사도는 유사도와 반대 개념으로 범위는 [0~무한]으로 측정된다.
유사도를 측정하는 방법론은 다양하다. 그 중 데이터 값이 어떻게 이루어져 있는지에 따라서 분류 방법을 나눌 수 있사.
Sparse data (희소 데이터, 데이터 값이 0이 많은 데이터)
분석을 하다 보면, sparse data를 접하게 되는 경우가 많다. 예를 들어 기능과 리텐션의 상관관계를 분석하는 경우, 유저들이 특정 기능을 사용하는 경우와 리텐션에 집계되는 케이스가 각각 많을 수도 적을 수도 있다. 추천 시스템에서도 sparse data가 존재할 수 밖에 없다. 유저가 서비스를 보았거나, 샀어도 평점을 남기는 경우보다 남기지 않는 경우가 더 많이 존재하고, 이 때 Sparse data가 생성된다.
희소 데이터의 유사도를 측정할 때는 주로 Jaccard coefficient나 Cosine similarity를 사용한다.
Non-sparse(=dense) data(밀집 데이터, 데이터 값이 0이 거의 없는 경우)
희소 데이터의 반대 개념으로, 주로 사용하는 유사도 거리는 Euclidean Distance와 Correlation이 있다.
Jaccard Coefficient
Cosine Similarity
1. Euclidean distance (L2 Norm, L2 Distance)
유클리드 거리(Euclidean Distance)는 두 점 사이의 거리를 계산하는 방법이다. 두 점 와 가 각각 좌표를 가질 떄, 두 점 사이의 거리를 유클리드 거리 공식으로 표현하면 아래와 같다.
다차원이 아닌 2차원 공간에서 유클리드 거리는 다음과 같다.
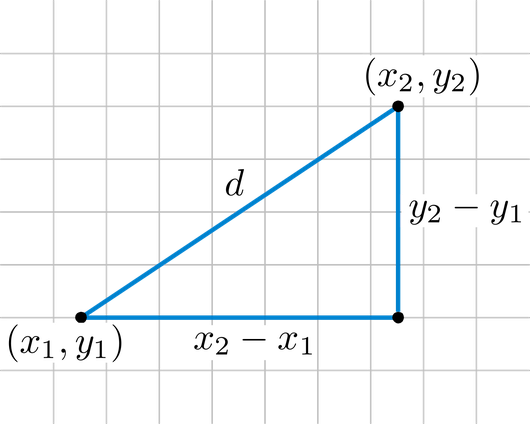
이때, 두 점 와 는 피타고리스의 정리를 활용하여 아래와 같이 계산할 수 있다.
NLP(자연어처리) 관점 접근
유클리드 거리를 활용하여 문서 간 유사도를 계산할 수 있다. 즉, 문서 간 유클리드 거리가 가까울 수록 헤딩 문서들이 서로 유사하다고 할 수 있다. 벡터 간 방향에 초점을 두는 코사인 유사도(Cosine Similarity)와 달리, 유클리드 거리는 비교하는 문서 간 길이에 영향을 받는다는 한계가 있다.
특징
- 중학교 때부터 배운 피타고라스 정리는 2차원 유클리드 공간에서 거리를 구한 것이다.
- 연속형 변수
- Regularization과 Regression에서 사용된다.
장점
- 거리에 기반한 유사도 측정 방식이기 때문에 두 데이터 사이의 스케일 차이가 크지 않은 경우에 사용하기에 좋음
(cf. 각도 기반 유사도 측정은 스케일 차이가 큰 경우에 사용하기에 좋음) - Outlier에 신경을 써야 하는 경우에 사용하기에 좋다.
단점
- (Euclidean Distance를 Loss function으로 이용할 경우) 만약에 실제값과 예측값 사이의 오차를 구할 때 Euclidean Distance를 이용한다면 다음과 같은 식이 성립하는데, , 이는 오차의 제곱을 더하는 것이기 때문에 Manhattan Distance(L1 loss)보다 Outlier에 더 큰 영향을 받는다. 즉, L2 Loss가 L1 Loss에 비해 Outlier에 대하여 더 민감하다고 할 수 있다.
- 동일한 시점에서 관찰된 두 시계열 데이터 사이의 거리만을 측정할 수 있음(문서 유사도를 측정할 때에도 유클리드 거리는 문서의 길이에 영향을 받기 때문에 자주 사용하지 않음서 유사도를 측정할 때에도 유클리드 거리는 문서의 길이에 영향을 받기 때문에 자주 사용하지 않음)
요약
- 정의: 두 점 사이의 직선 거리를 계산하는 방법으로, 가장 기본적인 거리 측정 방법이다.
- 공식:
- 시간 복잡도: O(n)
- n차원 벡터 x와 y의 모든 차원에 대해 차이를 계산하고, 각 차이의 제곱을 구한 후 합산해야 한다. 계산된 합을 제곱근으로 취하므로, 총 n번의 계산이 필요하다. - 공간 복잡도: O(1)
- 계산 중에 추가적인 메모리가 필요하지 않으며, 기존의 벡터 이외의 중간결과를 저장하는 상수 크기의 메모리만 필요하다. - 데이터 유형: 연속형 데이터
- 적용 사례: 이미지 인식, 추천 시스템에서 유사도 측정, 군집 분석 등
- 장점: 계산이 간단하고 직관적임
- 단점: 차원이 증가할수록 값이 커지므로 고차원 공간에서는 적합하지 않음(차원의 저주 문제)
2. Manhattan distance
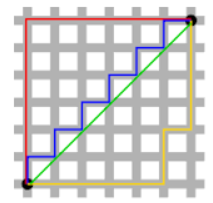
맨하탄 거리(Manhattan distance)는 2차원 평면 공간에서 두 점 p와 q 사이의 거리를 측정하는 방법 중 하나로, 두 점 사이의 수평 및 수직 이동 거리의 합으로 정의된다.
L1 Distance라고도 부른다. (cf. 유클리드 거리는 L2 Distance임)
위의 그림에서 초록색 선이 최단 거리인 유클리드 거리를 의미하고, 파란색 선, 빨간색 선, 노란색 선은 맨하탄 거리를 의미함, 이때, 파란색 선, 빨간색 선, 노란색 선의 길이는 모두 동일한 것이 특징.
회색을 도로, 흰색 블록을 건물이라고 생각한다면 건물을 뚫고 지날 수 없기 때문에 맨하탄 거리를 이용하여 거리를 측정.
수식
n차원 공간에 위치한 두 점 p, q 사이의 거리는 각 좌표의 차이의 절댓값을 모두 합한 것과 같다.
Euclidean Distance & Manhattan Distance
p는 norm의 차수를 의미하며(p=1은 L1 norm, p=2는 L2 norm) n은 대상 벡터의 요소 수, 즉 벡터의 차원을 의미한다.
장점
- 유클리드 거리와의 비교: 유클리드 거리를 이용하게 되면 고차원이 될 수록 대부분의 점들이 유사한 거리를 가지게 되기 때문에 고차원에서는 유용하지 않다. 이런 경우에 맨하탄 거리가 유클리드 거리보다 유용하다고 할 수 있다. 또한, 데이터의 차원이 다른 경우에도 맨하탄 거리가 유클리드 거리보다 낫다. 그리고, norm의 지수가 클 수록 큰 값의 원소에 거리가 치우치고 작은 값이 무시된다.
- 유클리드 거리와 달리 제곱을 하지 않기 때문에 차원의 영향력을 줄일 수 있음 => 고차원 벡터 사이의 거리를 구할 때 Euclidean Distance보다 일반적으로 낫다.
특성
- 맨 왼쪽 아래의 점에서 맨 오른쪽 위의 점으로 이동할 떄 각 좌표축의 방향으로만 이동할 경우에 사용되는 거리이다.
- 연속형 변수
맨하탄 거리는 다음과 같은 상황에서 유용하게 사용 될 수 있다.
- 물류: 택배회사나 배송업체에서 배송 경로를 최적화 할 때 사용한다.
- 도시 계획: 도시의 도로 네트워크 및 교통 흐름 분석 및 도시 발전 방향을 계산할 때 사용한다.
- 비전 및 머신러닝: 객체 간의 거리를 측정하거나 이미지 처리에서 특징을 추출하는 데 사용한다.
- 게임 개발: 게임 내 캐릭터나 NPC의 이동 경로를 계산하거나 충돌 감지에 사용 된다.
유클리드 거리보다 맨하탄 거리가 선호되는 경우
Multidimensional and sparse data
모든 유저가 많은 rating을 남기는 것이 아니기 때문에(Data Sparsity) 유저마다 몇 개의 아이템에 대해 평가를 했는지 그 수가 다를 수 있다. 이와 같은 이유로 rating matrix를 그렸을 때 유저들의 dimensions의 차이가 크다면, 유클리드 거리보다 맨하탄 거리(혹은 normalized value)를 사용하는 게 낫다.
요약
- 정의: 축을 따라 직각으로 이동하여 도달할 수 있는 거리로, '절대 거리'라고도 한다.
- 공식:
- 시간 복잡도: O(n)
- n차원 벡터 x와 y의 각 차이에 대해 절대값을 계산하여 더해야 하므로, n번의 계산이 필요하다. - 공간 복잡도: O(1)
- 유클리드 거리와 동일하게 추가 메모리 없이 중간 합산결과를 저장하기 위한 상수 크기의 메모리만 필요하다. - 데이터 유형: 연속형 데이터
- 적용 사례: 로봇 공학(격자기반 경로), 도시 거리 측정, 택스트 분석 등
- 장점: 유클리드 거리와 달리 고차원에서도 계산이 안정적임
- 단점: 축을 따라 이동한다는 점에서 실제 거리를 왜곡할 수 있음
3. Minkowski distance
개념
- L1(맨하탄), L2(유클리드) norm을 일반화한 함수이다.
- p=1일 때 맨하탄 거리와 같고, p=2일 때 유클리드 거리와 같음
- p=무한으로 가면 쳬비셰프 거리
수식
특성
- user case에 적합한 m을 찾아 거리 측정을 할 수 있다는 점에서 유연성을 가짐
- 민코프스키 시공간 (Minkowski spacetime)
- 사람이 인지하는 현실세계인 3차원 공간에, 1차원 시간을 더하여 4번째 차원으로 이루어진 공간
- 시공간이지만, 시간(t)에 속도(c)를 주어서 시간을 거리 함수처럼 다룸
요약
- 정의: 유클리드와 맨하탄 거리의 일반화된 형태로, 거리 측정을 위한 다양한 'p-값'을 선택할 수 있다.
- 공식:
- 여기서 p=1: 맨하탄 거리, p=2: 유클리드 거리 - 시간 복잡도: O(n)
- n차원 벡터 x와 y의 각 차이에 대해 p-제곱을 구하고, 이를 더해 p-제곱근을 취하는 꼐산이 포함된다. 계산은 차원 수 n에 선형적으로 비례한다. - 공간 복잡도: O(1)
- 계산 중에 추가적인 메모리를 사용하지 않으며, n번의 중간 계산을 합산하기 위한 메모리만 필요하다. - 데이터 유형: 연속형 데이터
- 적용사례: 군집화, 패턴 인식 등
- 장점: 다양한 거리 측정 방법을 일반화하여 적용할 수 있음
- 단점: 적절한 p-값 선택이 어려울 수 있다.
4. Chebyshev Distance (L-infinity norm) 체비셰프 거리
p를 무한대로 보내는 경우 쳬비셰프 거리라고 한다.
수식
정의 및 특성
- 벡터 성분의 절댓값 중 가장 큰 값을 거리를 구한다.
5. Jaccard similarity
한줄로 설명하면 두 집합의 교집합을 합집합으로 나눈 값을 Jaccard Coefficient(자카드 지수)라고 한다. 두 개의 명목형 변수가 존재할 때 생길 수 있는 케이스는 총 4가지가 있다. a=(0,0), b=(1,0), c=(1,1), d=(0,1). 자카드는 이 때, a=(0,0)을 분모, 분자에서 고려허지 않고 상관계수(Coefficient)를 구한다.
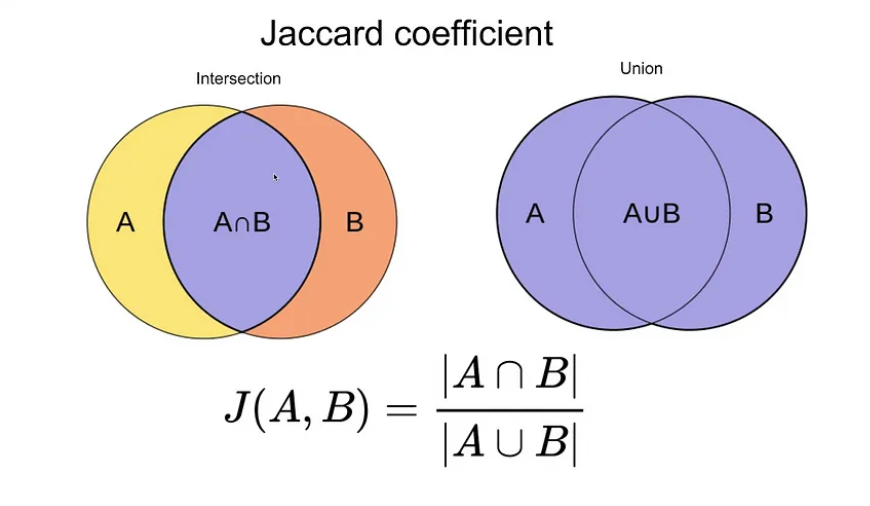
자카드 계수의 장점
1. 0이 많은 데이터에서는 해당 부분을 고려해준다.
2. A와 B는 같은 사이즈일 필요가 없다.(자연어분석(NLP)인 기준에서 의미한다.)
자카드 계수의 단점
1. 0과 1이 교차되는 경우에 Jaccardr는 상관관계를 구현하지 못한다.
2. 음의 상관관계를 알지 못한다.(산점도를 비롯한 그래프로 재확인 필요)
3. 얼마나 자주 발생하는지(term frequency)를 고려하지 않는다.
4. 정규화(normalize)작업이 필요할 때가 있다.
요약
- 정의: 두 집합 간의 유사성을 측정하는 지표로, 교집합과 합집하의 비율로 계산된다.
- 공식:
- 시간 복잡도: O(n) (집합 연산의 복잡도에 의존)
- 두 집합 A와 B에서 교집합과 합집합을 구해야 하므로, 각 원소를 순회하며 교집합에 포함될지 확인하고, 이후 합집합 크기를 계산하는 과정에서 b번의 연산이 필요하다. - 공간 복잡도: O(n)
- 교집합과 합집합을 저장하기 위해 최대 n개의 요소를 저장할 수 있는 메모리가 필요할 수 있다. 이는 Jaccard 유사도가 비교적 큰 집합을 사용할 대 메모리를 더 많이 차지하게 된다. - 데이터 유형: 이진형 데이터, 범주형 데이터
- 적용 사례: 문서 유사도 측정, 추천 시스템, 소셜 네트워크 분석 등
- 장점: 이진 또는 범주형 데이터에 적합하며, 직관적인 해석이 가능함
- 단점: 데이터의 교집합이 작을 경우 유사도가 과소평가될 수 있음
6. Pearson correlation
통계학에서, 피어슨 상관(Pearson Correlation) 란 두 연속 변수 사이의 선형 관계 정도를 정량화하는 통계적 척도이다. -1과 1사이의 값을 사용하는데, 여기서 -1은 음의 상관관계를 말하고, 0은 상관관계가 없음을 나타내고, 1은 양의 상관관계를 의미한다.
피어슨 상관계수(Pearson correlation coefficient, PCC)는 두 변수의 공분산(Covariance)를 표준편자(Standard Deviation)의 곱으로 나눈 값으로 계산된다. Pearson의 상관 게수 공식은 아래와 같다.
여기서, r은 Pearson 상관 계수(Pearson Correlation Coefficient,PCC)를 말한다. X와 Y는 두 개의 연속 변수이고, 는 공분산(covariance), 는 표준편차(Standard Deviation)이다.
데이터사이언스에서 Pearson의 상관 계수가 중요한 이유는 무엇일까?
데이터 사이언스에서 Pearson의 상관 계수가 중요한 이유는 데이터 세트의 변수 간의 관계를 이해하는 게 중요한데, 그걸 도와주기 때문이다. 두 변수 사이의 상관계수를 계산해서 두 변수의 관계가 양의 상관관계인지, 음의 상관관계인지, 서로 전혀 상관이 없는 건지 어느 정도 파악이 가능하기 때문이다. 상관관계의 정보는 feature selection, data preprocessing, model selection과 같이 다양한 데이터 분석을 하거나 머신러닝 작업을 할 때 유용하게 사용될 수 있다.
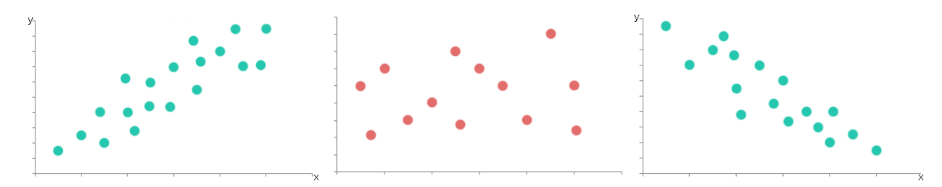
좌: 양의 상관관계 (-1)
가운데: 상관관계 없음 (0)
우: 음의 상관관계 (1)
요약
- 정의: 두 변수 간의 선형 관계를 측정하는 지표로, -1에서 1 사이의 값을 갖는다.
- 공식:
- 시간 복잡도: O(n)
- x와 y의 각 원소에 대해 평균 차이를 구하고, 이를 곱하고, 분산을 계산하는 과정이 포함된다. 이를 위해 각 차원에 대해 3번의 계산(평균, 분산, 공분산)을 수행하므로, 계산량은 n에 비례한다. - 공간 복잡도: O(1)
- 중간 계산을 위한 상수 크기의 메모리만 필요하다. - 데이터 유형: 연속형 데이터
- 적용 사례: 추천 시스템(영화,음악 추천 등), 통계 분석
- 장점: 두 변수 간 선형 관계를 잘 설명함
- 단점: 비선형 관계에서는 정확한 유사도를 측정하지 못함
7. Cosine similarity
두 데이터(벡터) 간의 코사인 각도를 이용하여 구할 수 있는 두 데이터의 유사도를 의미한다. 두 벡터의 방향이 완전히 동일한 경우에는 1의 값을 가지며, 로 반대의 방향을 가지면 -1의 값을 갖게 된다. 의 각을 이루면 분자에 위치한 A와 B의 내적의 값이 0으로 상관관계가 0이 된다. 결국 코사인 유사도는 -1이상 1이하의 값을 가지면 값이 1에 가까울수록 유사도가 높다고 판단할 수 있다.
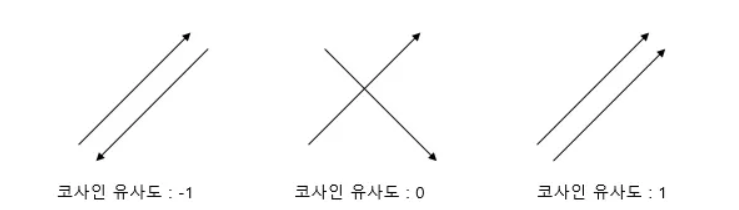
장점
1. 벡터의 규모(크기)가 중요하지 않다. 모수가 적을 때 장점을 가진다.
2. 다양한 차원이 존재할 때 유사도 구분이 뚜렷할 수 있다. 여러가지 지표들을 비교할 때 유사도를 비교적 뚜렷하게 구분할 수 있다.
3. 자카드와 마찬가지로 (0,0) match는 고려하지 않는다.
단점
1. 상호 상관관계의 feature(키, 몸무게 등)을 갖는 원소들간의 유사도를 계산할 때에 좋지 못하다.
2. 위치(vector)의 기준을 무엇으로 잡는지에 따라 유사도(각도)가 달라질 수 있다.
3. Binary data에서는 사용할 수 없다.
요약
- 정의: 두 벡터 간의 각도를 측정하여 유사도를 계산하는 방법으로, 주로 벡터 방향에 중점을 둔다.
- 공식:
- 시간 복잡도: O(n)
- 두 벡터의 내적 계산에 b번의 곱셈이 필요하고, 벡터의 각 길이를 구하는 데도 n번의 계산이 필요하므로, 전체적으로 O(n)의 시간 복잡도가 된다. - 공간 복잡도: O(1)
- 중간 결과값을 저장하기 위한 메모리 외에 추가적인 메모리가 필요하지 않다. - 데이터 유형: 희소 벡터, 문서 유사도 등
- 적용 사례: 문서 유사도 분석, 추천 시스템(텍스트 기반), 벡터 공간 모델
- 장점: 희소 벡터에서 유사도 측정에 효율적임
- 단점: 백터의 크기를 무시하므로 길이에 만족하지 않은 유사도 측정이 필요할 때만 적합함
8. Dot product
cosine angle and magnitude of the vectors
내적의 대수학적(Algebraic) 정의
위의 정의와 같이 inner product는 각 벡터의 성분 간에 곱하고, 그 곱한 성분들을 더한다. 즉, 같은 성분끼리 곱해서 더한다라는 것이 내적의 대수학적 정의이다.
내적의 기하학적(Geometric) 정의
이때, "대수학적(Algebraic)", "기하학적(Geometric)"이란
- 대수학적: "수치 연산"에 중점을 둔 정의 방식
- 기하학적: "도형이나 눈에 보이는 것들을 이용"해서 정의를 표현하는 방식
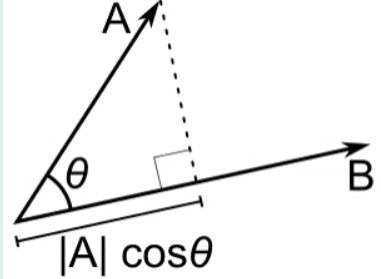
위의 그림을 보면, A라는 2차원 벡터를 B의 방향으로 놓고(=), B와 곱한 것이라는 것을 알 수 있다.
즉, 내적(Inner product)라는 건, "B라는 기준 벡터에 A라는 벡터가 얼마나 B 벡터의 성분이 들어있나"라고 해석할 수도 있다.
만약, A와 B가 이루는 각도가 90도라면, 이 될 것이고, 이것의 의미는 A는 B와 전혀 안닮았다이고, A와 B가 이루는 각도가 0이라면 A와 B는 동일하다가 된다.
벡터 곱 2가지 종류(2 types of vector multiplication)
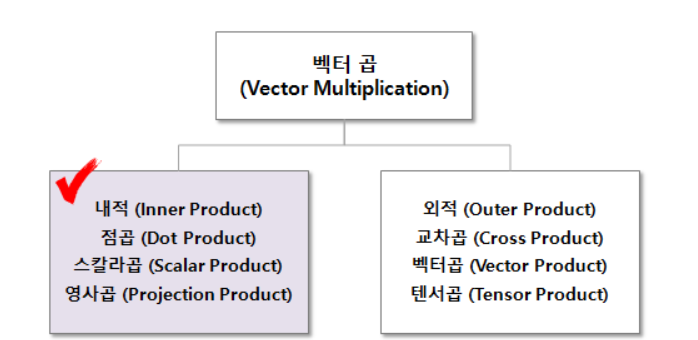
벡터의 내적과 외적 비교(comparison between inner(or dot) product and outer(or cross) product of vector)
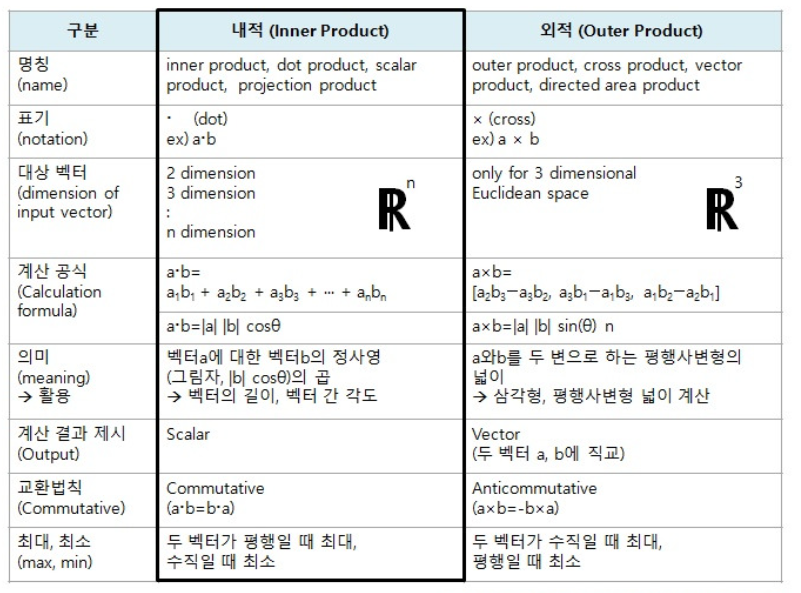
(1) 내적의 표기(notation and symbol of the inner product)
두 벡터의 내적(inner product)는 아래 그림처럼 '(dot)'으로 표기하며, 그래서 점곱(dot product)라고도 말한다. (혹은 (a, b)와 같이 표기하기도 한다.) 결과값이 스칼라값이기 때문에 스칼라곱(scalar product)라고도 하며, 계산할 때 한쪽 벡터의 코사인값을 사용하기 때문에(즉, 한쪽 벡터에 직사광선을 쪼였을 때 그 그림자에 해당하는 코사인값을 사용) 영사곱(projection product)라고도 말한다.
p.s) 똑같은 개념을 두고 표현하는 말이 이렇게나 많은 이유는 대수학, 기하학, 물리학 등의 학문 영역별로 하나의 개념을 표기하는 명칭, 표기법이 다르기 때문이라고만 알고 있으면 된다.
(2) 내적의 정의 (definition of the inner product)
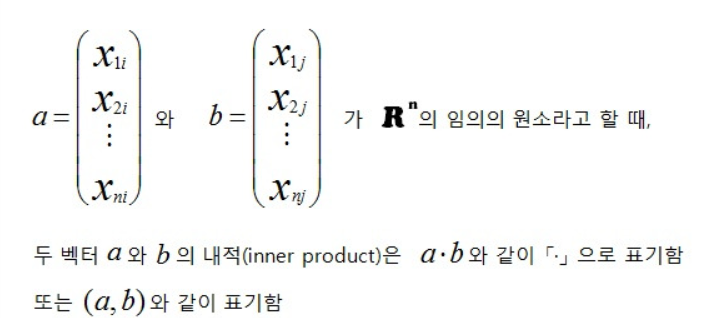
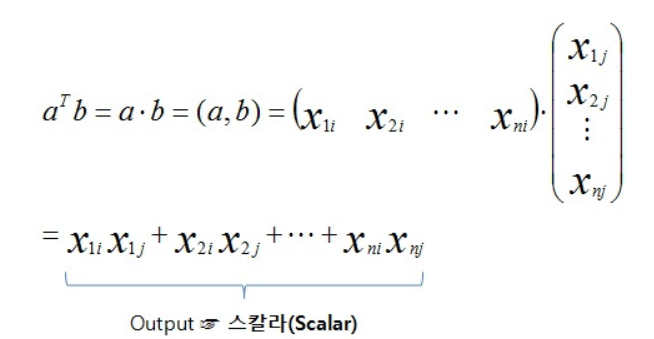
내의 두 열 벡터 a, b에 대하여 곱
의 결과인 단일 성분을 갖는 1x1 행렬, 즉 하나의 실수인 Scalar가 내적(inner product)이다. 그 수식을 풀어 써보면 아래와 같은 계산식이 되며, 그 결과는 스칼라가 된다.
참고로, 외적(outer product)의 결과는 벡터가 된다.
아래에 두개의 성분(2차원, 2 dimensions)을 가지는 열 벡터 a = (-5,6), b=(3,9)의 내적 예와 세개의 성분(3차원, 3 dimensions)을 가지는 열 벡터 c=(5,3,6), d=(2,7,4)에 대한 내적 계산을 보여주었다. 같은 행의 component 끼리 각각 곱해서 모두 더하면 된다.
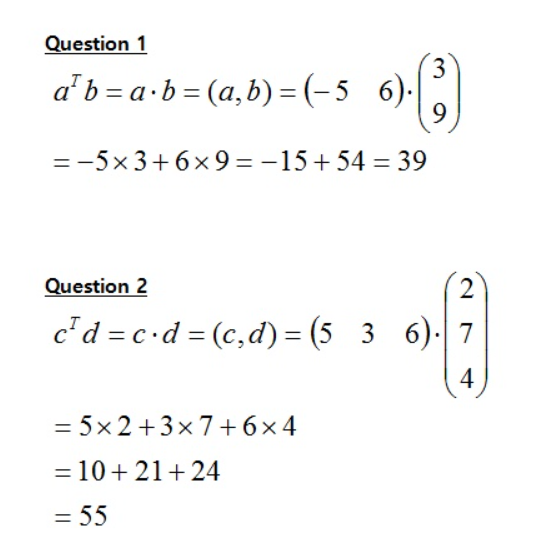
(3) 내적의 성질 (properties of the inner product)
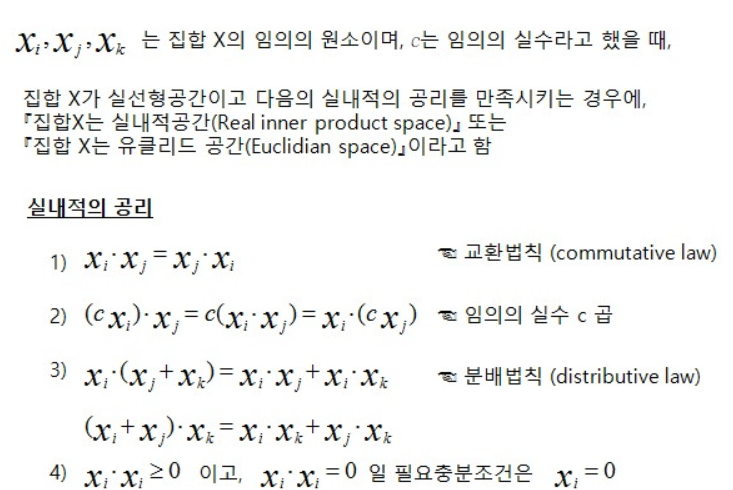
수학자들이 정의하는 실내적공간(real inner product space, or real pre-Hilbert space)의 정의와 공리는 아래와 같다. 실내적의 공리로 교환법칙(commutative law), 임의의 실수 c곱의 자유로운 이동 가능, 분배법칙(distribute law) 등의 공리도 포함되어 있다.
(4) 내적의 계산 원리, 방법 1 (1st formula of the inner product calculation)
내적을 계산하는 원리, 방법 중에 벡터를 성분분해해서 각 성분들의 벡터의 길이 (length of vector, norm)를 가지고 곱한 후 더하는 방법으로 구하는 방법이 있다.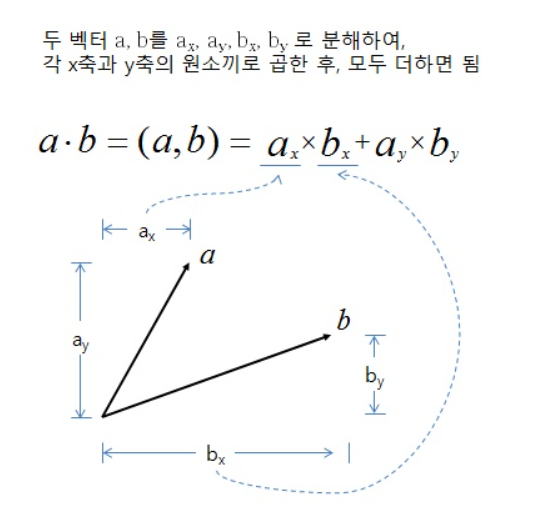
(5) 내적의 계산 원리, 방법 2 (2nd formula of the inner product calculation)
내적을 계산하는 또 한가지 방법은 벡터의 힘의 크기 또는 길이(magnitude or length of vector, norm)와 각도(angle between vector a and b)를 이용하는 방법이다. 벡터의 힘의 크기 또는 길이는 "norm"이라고도 불린다. 두 개중 한 개의 벡터에 빛을 비추었을 때 직각으로 생기는 그림자(=vectora*cosine())에다가 나머지 다른 한개의 벡터를 곱하는 개념이다.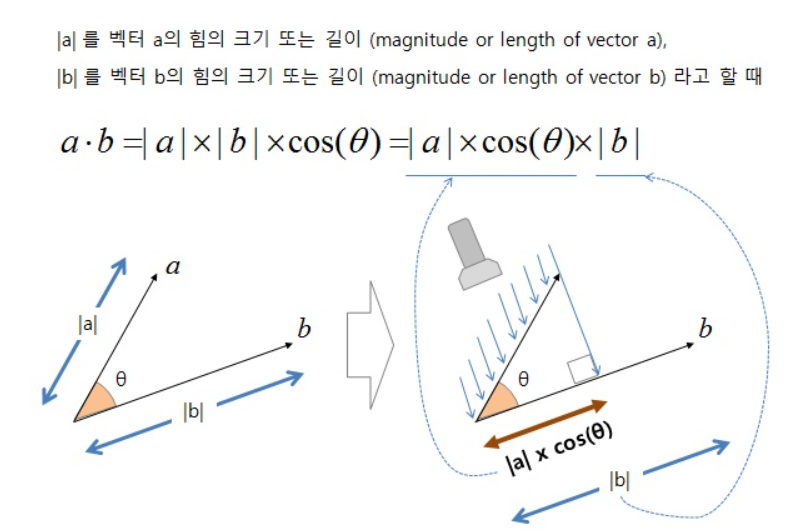
요약
- 정의 두 벡터의 원소별 곱의 합으로, 벡터의 방향이 일치하는 정도를 측정한다.
- 공식:
- 시간 복잡도: O(n)
- 두 벡터의 각 차원을 곱하여 모두 더하는 과정에서, n개의 요소에 대해 한 번씩 곱셈과 덧셈이 필요하므로 계산량은 n에 비례한다. - 공간 복잡도: O(1)
- 결과값을 위한 상수 크기의 메모리만 사용된다. - 데이터 유형: 연속형 데이터, 텍스트 데이터
- 적용 사례: 신경망(가중치 게산), 자연어 처리(임베딩 유사도)
- 장점: 벡터 방향 일치도를 간단하게 계산 가능
- 단점: 두 벡터의 크기에 영향을 받아 코사인 유사도와 같이 방향만 고려한 유사도 측정에는 부적합함
References
- https://en.wikipedia.org/wiki/Euclidean_distance
- https://benn.tistory.com/62
- https://ko.wikipedia.org/wiki/%ED%94%BC%EC%96%B4%EC%8A%A8_%EC%83%81%EA%B4%80_%EA%B3%84%EC%88%98
- https://velog.io/@so_yeong/%EA%B1%B0%EB%A6%AC%ED%95%A8%EC%88%98-Minkowski-Manhatten-Euclidean-Chebyshev-Distance-%EB%A5%BC-%EC%95%8C%EC%95%84%EB%B3%B4%EC%9E%90