어플리케이션에는 사라지지 않는 저장소가 필요하다.
자바 프로그램 안에서 List나 배열에 데이터를 저장하면 프로그램이 실행되는 동안에는 데이터를 사용할 수 있다. 하지만 서버를 종료하면 메모리에 있던 데이터는 사라진다. 게시글, 회원 정보, 일정, 주문 내역처럼 계속 남아 있어야 하는 데이터는 별도의 저장소가 필요하다.
이 역할을 하는 것이 데이터베이스(Database:DB)이다. 데이터베이스는 여러 사람이 공유하고 사용할 데이터를 구조화해서 저장하는 공간이다. 그중 관계형 데이터베이스(RDBMS)는 데이터를 엑셀 표처럼 테이블, 행, 열 구조로 관리한다. MySQL은 대표적인 관계형 데이터베이스 관리 시스템이다.
데이터베이스를 단순한 저장소로만 보면 부족하다. 데이터베이스는 데이터를 저장할 뿐 아니라, 중복을 막고, 잘못된 값이 들어오지 않도록 제한하고, 필요한 데이터를 빠르게 조회할 수 있도록 돕는다.
IntelliJ와 MySQL의 관계
이번 실습에서는 IntelliJ 안의 DB 도구를 사용해 MySQL에 접속했다. 여기서 중요한 점은 IntelliJ가 데이터베이스 자체가 아니라, MySQL 서버에 접속하는 클라이언트 역할을 한다는 것이다.
| 구분 | 역할 |
|---|---|
| MySQL | 데이터를 실제로 저장하고 관리하는 서버 프로그램 |
| IntelliJ Database Tool | MySQL 서버에 SQL을 보내고 결과를 확인하는 클라이언트 |
localhost | 내 컴퓨터 안에서 실행 중인 서버를 가리키는 주소 |
3306 | MySQL이 기본적으로 사용하는 포트 번호 |
즉, localhost:3306은 “내 컴퓨터에서 실행 중인 MySQL 서버의 3306번 문으로 접속한다”는 의미다.
관계형 데이터베이스의 기본 단위
관계형 데이터베이스는 데이터를 표 형태로 저장한다. 이때 각 용어는 다음처럼 이해할 수 있다.
| 용어 | 의미 | 예시 |
|---|---|---|
| 데이터베이스 | 여러 테이블을 담는 큰 저장 공간 | hello |
| 테이블 | 같은 종류의 데이터를 저장하는 표 | users |
| 열 / 컬럼 | 데이터의 속성 | id, username, email |
| 행 / 로우 | 실제 데이터 한 건 | 1, John, john123@gmail.com |
| 기본키 / PK | 각 행을 구별하는 고유한 값 | id |
| 외래키 / FK | 다른 테이블의 기본키를 참조하는 값 | user_id, team_id |
| SQL | 데이터베이스에 명령을 내리는 언어 | SELECT, INSERT, UPDATE |
테이블은 단순히 값을 담는 표가 아니라, 각 컬럼마다 타입과 제약 조건을 가진다. 예를 들어 VARCHAR(50)은 최대 50자까지 저장할 수 있는 문자열 타입이고, INT는 정수 타입이다.
CREATE TABLE users (
    id INT PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100)
);
위 구조에서는 id가 기본키이다. 기본키는 각 행을 구별하는 식별자이므로 중복될 수 없고, NULL이 될 수 없다. 만약 id가 비어 있거나 중복된다면 어떤 행을 가리키는지 알 수 없기 때문이다.
실습 코드에서는 id INT PRIMARY KEY만 사용했기 때문에 데이터를 넣을 때 id값을 직접 입력해야 한다. 나중에 직접 id를 넣지 않고 DB가 자동으로 증가시키게 만들려면 다음처럼 작성할 수 있다.
id INT AUTO_INCREMENT PRIMARY KEYSQL은 데이터베이스와 대화하는 언어다
SQL은 데이터베이스에 명령을 보내는 언어다.
크게 보면 구조를 만드는 명령, 데이터를 조작하는 명령, 데이터를 조회하는 명령으로 나눌 수 있다.
| 분류 | 역할 | 대표 명령어 | 이번 실습 예시 |
|---|---|---|---|
| DDL | 구조 정의 | CREATE, ALTER, DROP | DB 생성, 테이블 생성 |
| DML | 데이터 조작 | INSERT, UPDATE, DELETE | 회원 데이터 추가, 이메일 수정 |
| DQL | 데이터 조회 | SELECT | users 테이블 조회 |
이번 실습의 전체 흐름은 다음과 같다.
| 순서 | 작업 | SQL |
|---|---|---|
| 1 | 데이터베이스 생성 | CREATE DATABASE hello; |
| 2 | 사용할 DB 선택 | USE hello; |
| 3 | 테이블 생성 | CREATE TABLE users (...); |
| 4 | 데이터 삽입 | INSERT INTO users (...) VALUES (...); |
| 5 | 데이터 조회 | SELECT * FROM users; |
| 6 | 데이터 수정 | UPDATE users SET ... WHERE ...; |
| 7 | 수정 결과 확인 | SELECT * FROM users; |
실습 흐름 정리
1. 데이터베이스 생성
CREATE DATABASE hello;hello라는 이름의 데이터베이스를 생성했다. 실행 후 DB 패널에 hello가 표시되면 생성이 완료된 것이다. 콘솔에 1 row affected가 표시되면 쿼리가 정상적으로 실행되었다는 의미로 볼 수 있다.
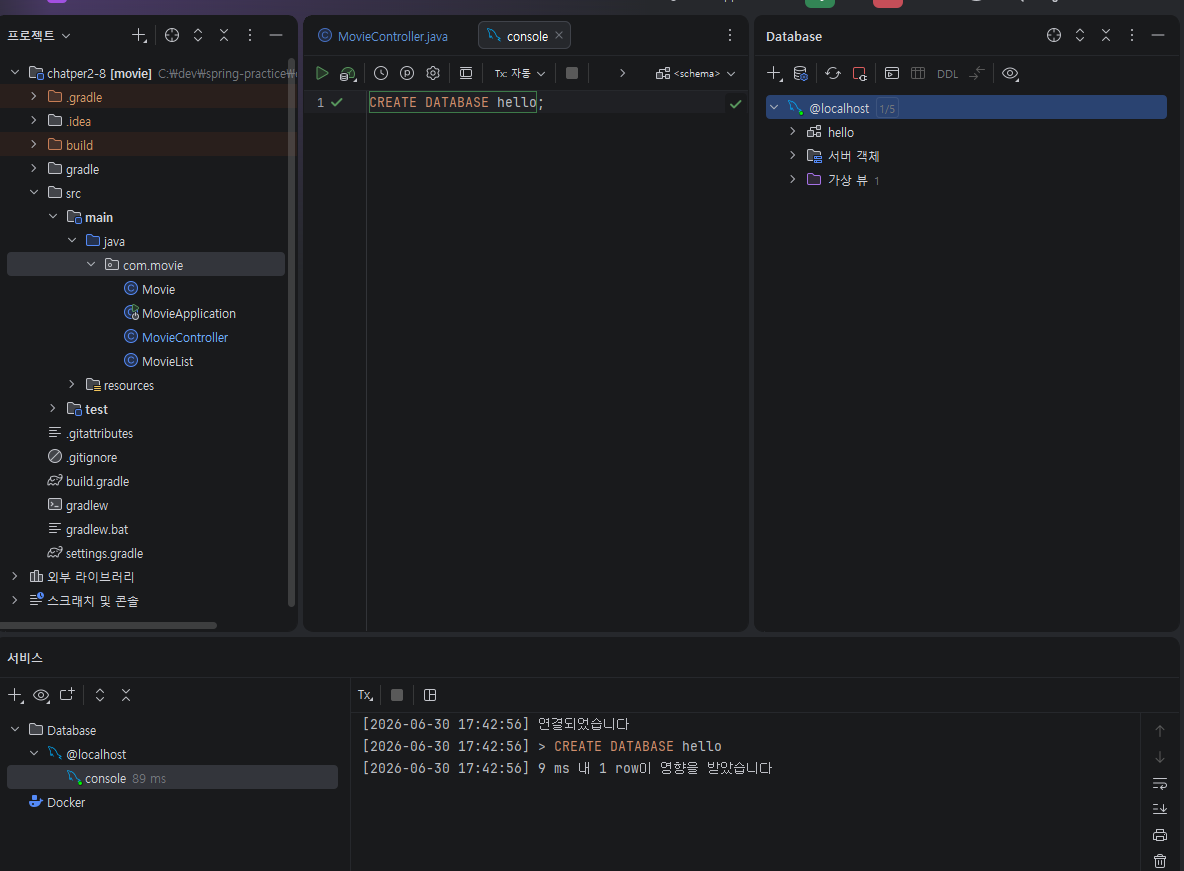
CREATE DATABASE hello 실행 결과
CREATE DATABASE hello; 실행 후 IntelliJ Database 패널에 hello 데이터베이스가 생성된 화면
2. users 테이블 생성
CREATE TABLE users (
    id INT PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100)
);
users 테이블은 사용자 정보를 저장하기 위한 표이다. 여기서는 id, username, email 세 개의 컬럼을 만들었다.
| 컬럼 | 타입 | 역할 |
|---|---|---|
id | INT | 사용자를 구분하는 기본키 |
username | VARCHAR(50) | 사용자 이름 |
email | VARCHAR(100) | 이메일 주소 |
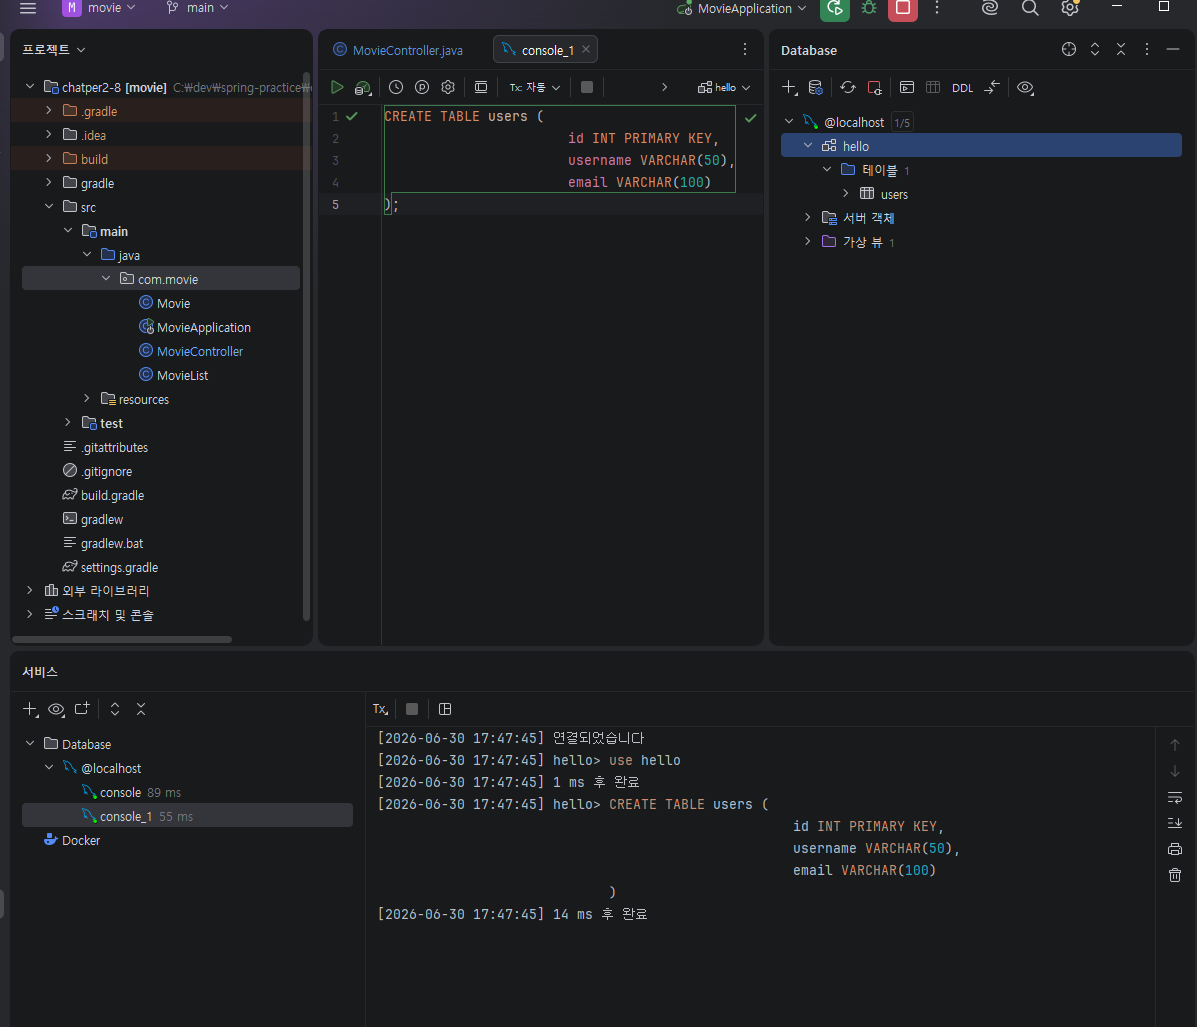
users 테이블 생성 결과
users 테이블이 생성되고, id, username, email 컬럼이 확인되는 화면
3. 데이터 삽입
INSERT INTO users (id, username, email)
VALUES (1, 'John', 'john123@gmail.com');
이 SQL은 users 테이블에 사용자 한 명을 추가한다. 컬럼 순서에 맞춰 id, username, email 값을 넣는다.
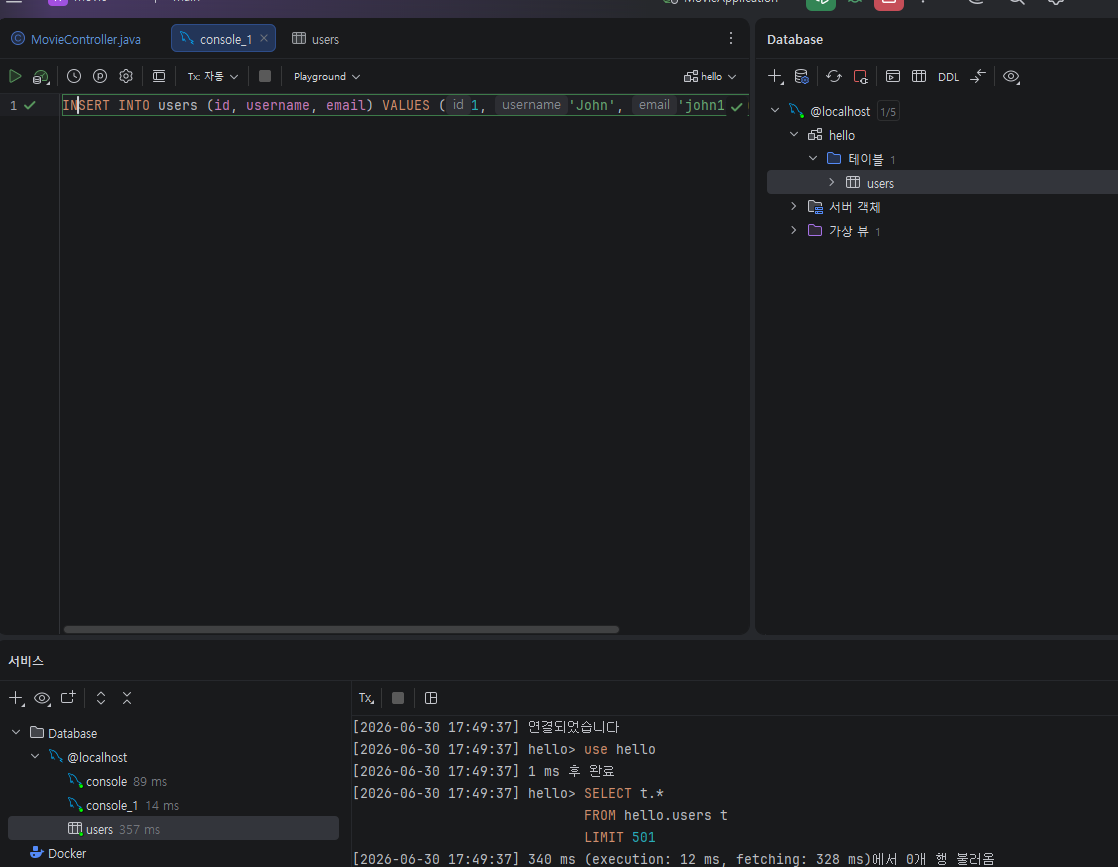
users 테이블에 데이터 삽입
INSERT INTO users ... VALUES ... 쿼리를 작성한 화면
4. 데이터 조회
SELECT * FROM users;SELECT는 데이터를 조회하는 명령어이다. 여기서 *는 wildcard로 모든 컬럼을 조회하라는 의미다.
즉, SELECT * FROM users;는 users 테이블의 모든 컬럼과 모든 행을 조회한다는 뜻이다.
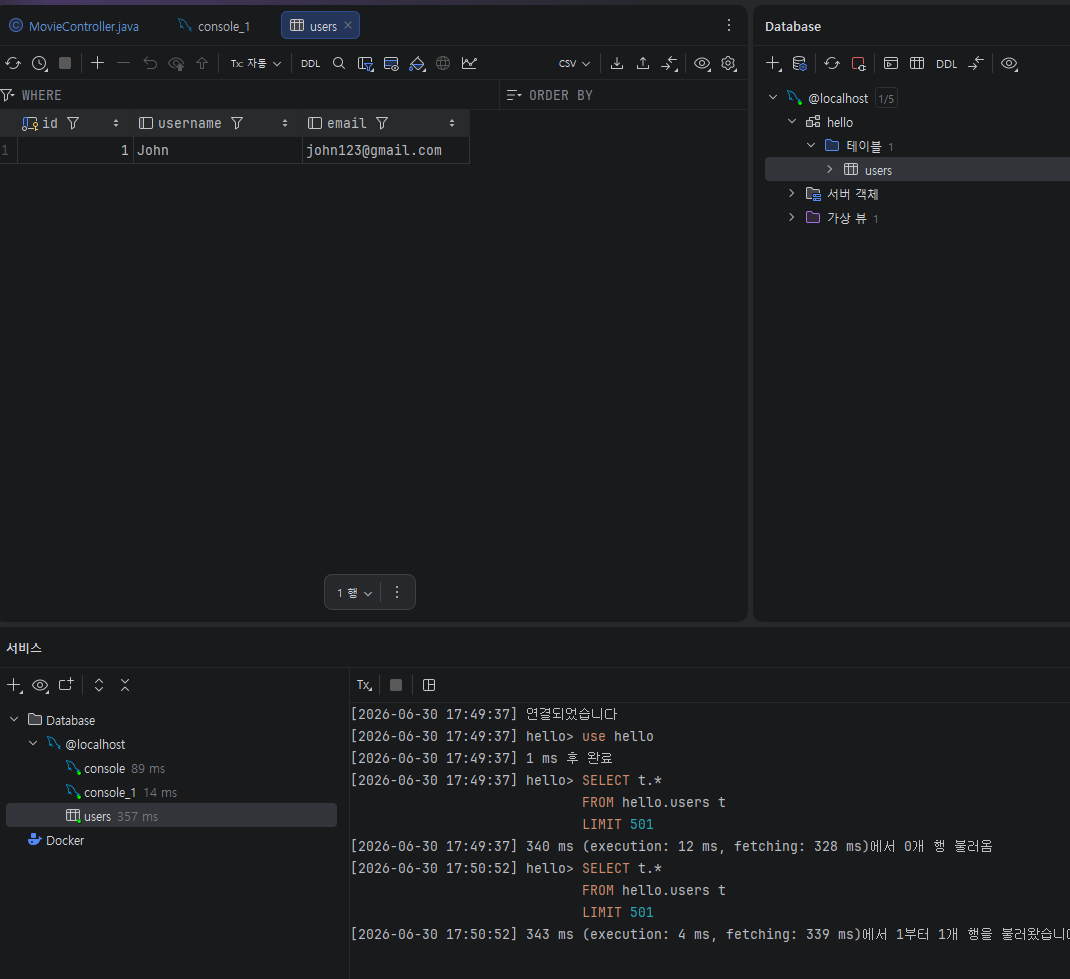
INSERT 후 users 테이블 조회 결과
id = 1, username = John, email = john123@gmail.com 데이터가 삽입된 것을 확인한 화면
5. 데이터 수정
UPDATE users
SET email = 'new.email@example.com'
WHERE id = 1;UPDATE는 기존 데이터를 수정하는 명령어이다. 여기서는 id가 1인 사용자의 이메일만 변경했다.
여기서 가장 중요한 부분은 WHERE id = 1이다. WHERE는 "어떤 행을 대상으로 할 것인지"를 지정한다.
| SQL | 결과 |
|---|---|
UPDATE users SET email = 'new.email@example.com'; | 모든 사용자의 이메일이 변경될 수 있음 |
UPDATE users SET email = 'new.email@example.com' WHERE id = 1; | id = 1인 사용자만 변경됨 |
UPDATE와 DELETE에서 WHERE를 빠뜨리면 테이블 전체 데이터가 수정되거나 삭제될 수 있다. 실무에서 매우 위험한 사고로 이어질 수 있으므로, 수정·삭제 쿼리에서는 WHERE를 먼저 확인하는 습관이 필요하다.
실습 중 알게 된 점 : 수정했는데 바로 안 바뀐 것처럼 보일 수 있다
이메일을 수정하는 쿼리를 작성했는데 화면의 조회 결과가 바로 바뀌지 않는 것처럼 보일 수 있다. 이때는 두 가지를 확인해야 한다.
| 확인할 것 | 이유 |
|---|---|
| 쿼리가 실제로 실행됐는지 | 작성만 하고 실행하지 않으면 DB에는 반영되지 않는다 |
| 다시 조회했는지 | 기존 결과 화면은 이전 조회 결과일 수 있다 |
현재 콘솔이 hello DB에 연결되어 있는지 | 다른 스키마에서 실행하면 원하는 테이블에 반영되지 않을 수 있다 |
수정 여부를 가장 확실하게 확인하는 방법은 다시 조회하는 것이다.
SELECT * FROM users;수정 후 다시 조회했을 때 email 값이 new.email@example.com으로 바뀌엇다면 UPDATE가 정상 반영된 것이다.
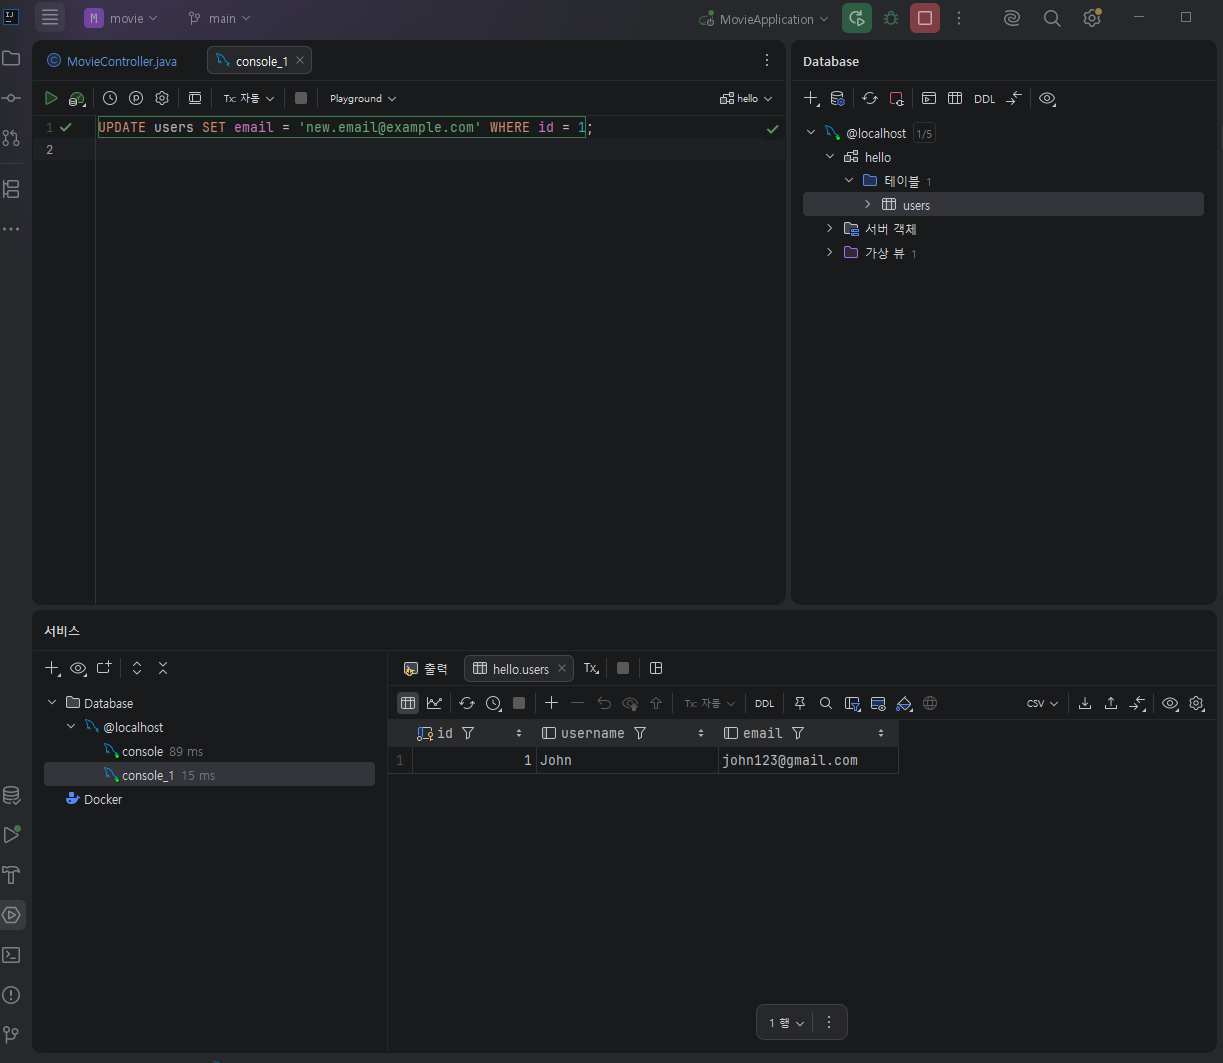
UPDATE 전 조회 결과
이메일 수정 쿼리를 작성했지만, 조회 결과에는 아직 기존 이메일이 보이는 화면
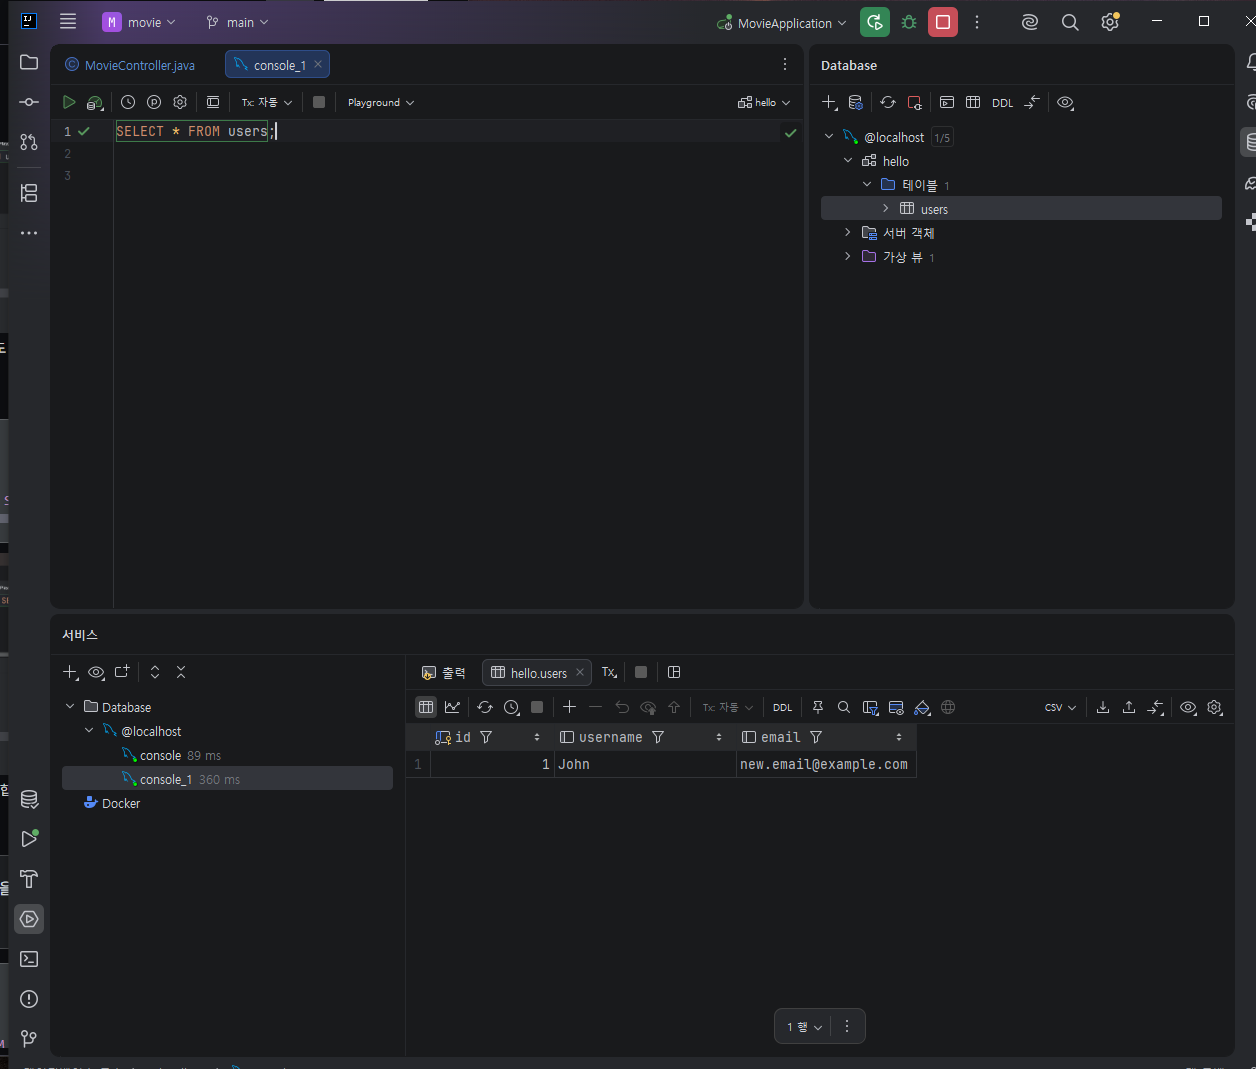
UPDATE 후 재조회 결과
SELECT * FROM users;를 다시 실행해 이메일이 new.email@example.com 으로 변경된 것을 확인한 화면
데이터 무결성은 "이상한 데이터가 들어오지 않게 막는 규칙"이다
데이터 무결성은 쉽게 말해 데이터가 정확하고, 일관되고, 유효한 상태로 유지되는 것이다. "이상한 데이터가 뜬금없이 들어오지 않게 유지하는 것"이라고 이해해도 현재 단계에서는 맞다. 다만 조금 더 정확히 말하면, 데이터베이스가 정해진 규칙을 통해 데이터의 정확성과 관계를 지키는 것이다.
| 무결성 종류 | 의미 | 예시 |
|---|---|---|
| 엔터티 무결성 | 기본키는 중복되거나 NULL이면 안 됨 | id는 각 사용자마다 달라야 함 |
| 참조 무결성 | 외래키는 실제 존재하는 데이터를 참조해야 함 | 없는 user_id로 주문 생성 불가 |
| 도메인 무결성 | 컬럼 타입과 조건에 맞는 값만 저장해야 함 | 숫자 컬럼에 이메일 문자열 저장 불가 |
외래키(FK)가 중요한 이유도 여기에 있다. 단순히 두 테이블에 같은 값을 넣는 것만으로는 데이터베이스가 관계를 검증하지 않는다. 외래키 제약 조건을 걸어야 존재하지 않는 데이터를 참조하는 실수를 DB가 막아준다.
트랜잭션과 롤백 : 작업을 하나의 묶음으로 처리하는 이유
트랜잭션은 데이터베이스 작업을 하나의 논리적 단위로 묶는 것이다. 대표적인 예시는 계좌이체이다.
계좌이체는 실제로 두 작업으로 나뉜다.
1. 보내는 사람 계좌에서 돈을 차감한다.
2. 받는 사람 계좌에 돈을 입금한다.
이 둘 중 하나만 성공하면 문제가 생긴다. 예를 들어 돈은 차감되었는데 입금이 실패하면 돈이 사라진 것처럼 보인다. 그래서 데이터베이스는 이런 작업을 하나의 트랜잭션으로 묶고, 모두 성공하면 확정하고 하나라도 실패하면 되돌린다.
START TRANSACTION;

UPDATE accounts
SET balance = balance - 10000
WHERE id = 1;

UPDATE accounts
SET balance = balance + 10000
WHERE id = 2;

COMMIT;
여기서 COMMIT은 변경 사항을 확정하는 명령어다.
반대로 ROLLBACK은 트랜잭션 안에서 진행한 작업을 확정하지 않고 이전 상태로 되돌리는 명령어다. 즉, 롤백한다는 것은 실패한 작업을 없던 일처럼 되돌린다는 뜻이다.
| 명령어 | 의미 |
|---|---|
START TRANSACTION | 트랜잭션 시작 |
COMMIT | 변경 사항 확정 |
ROLLBACK | 변경 사항 취소 |
ERD는 테이블들의 설계도다
ERD(Entity Relationship Diagram)는 데이터베이스 구조를 그림으로 표현한 설계도다. 건물을 지을 때 설계도 없이 방, 문, 배관을 마음대로 배치하면 나중에 고치기 어렵다. 데이터베이스도 마찬가지다. 테이블, 컬럼, 기본키, 외래키, 관계를 먼저 정리해야 구조적인 오류를 줄일 수 있다.
ERD가 필요한 이유는 세 가지다.
| 이유 | 설명 |
|---|---|
| 구조 파악 | 테이블과 컬럼을 한눈에 볼 수 있다 |
| 오류 예방 | 잘못된 관계나 빠진 컬럼을 미리 발견할 수 있다 |
| 협업 문서화 | 다른 개발자와 같은 구조를 보고 대화할 수 있다 |
테이블이 하나뿐일 때는 ERD가 크게 중요해 보이지 않을 수 있다. 하지만 테이블이 5개, 10개로 늘어나고 users, posts, comments, orders처럼 서로 연결되기 시작하면 머릿속으로만 구조를 기억하기 어렵다. 이때 ERD는 데이터베이스 구조를 설명하는 가장 기본적인 문서가 된다.
Entity는 테이블과 연결되는 개념이다
ERD에서 Entity는 저장하고 싶은 대상 또는 개념을 의미한다. 현재 단계에서는 Entity를 테이블 하나로 이해해도 충분하다. 예를 들어 User라는 Entity는 실제 데이터베이스에서는 users 테이블로 표현될 수 있다.
| 관점 | 표현 |
|---|---|
| Java | User 클래스 |
| ERD | User 엔티티 |
| SQL | users 테이블 |
| JPA | @Entity 클래스 |
즉, Java 클래스, ERD의 Entity, SQL의 테이블은 서로 완전히 다른 개념이 아니라 같은 데이터 구조를 서로 다른 방식으로 표현한 것이다.
public class User {
    private Long id;
    private String name;
    private String email;
    private String password;
}
위 Java 클래스는 ERD에서는 다음과 같은 Entity로 표현될 수 있다.
| Entity | Column |
|---|---|
| User | id |
| User | name |
| User | |
| User | password |
ERDCloud와 IntelliJ ERD의 차이
ERD는 반드시 하나의 도구로만 작성해야 하는 것은 아니다. ERDCloud 같은 온라인 도구를 사용할 수도 있고, IntelliJ처럼 이미 생성된 테이블을 기반으로 ERD를 자동 확인할 수도 있다.
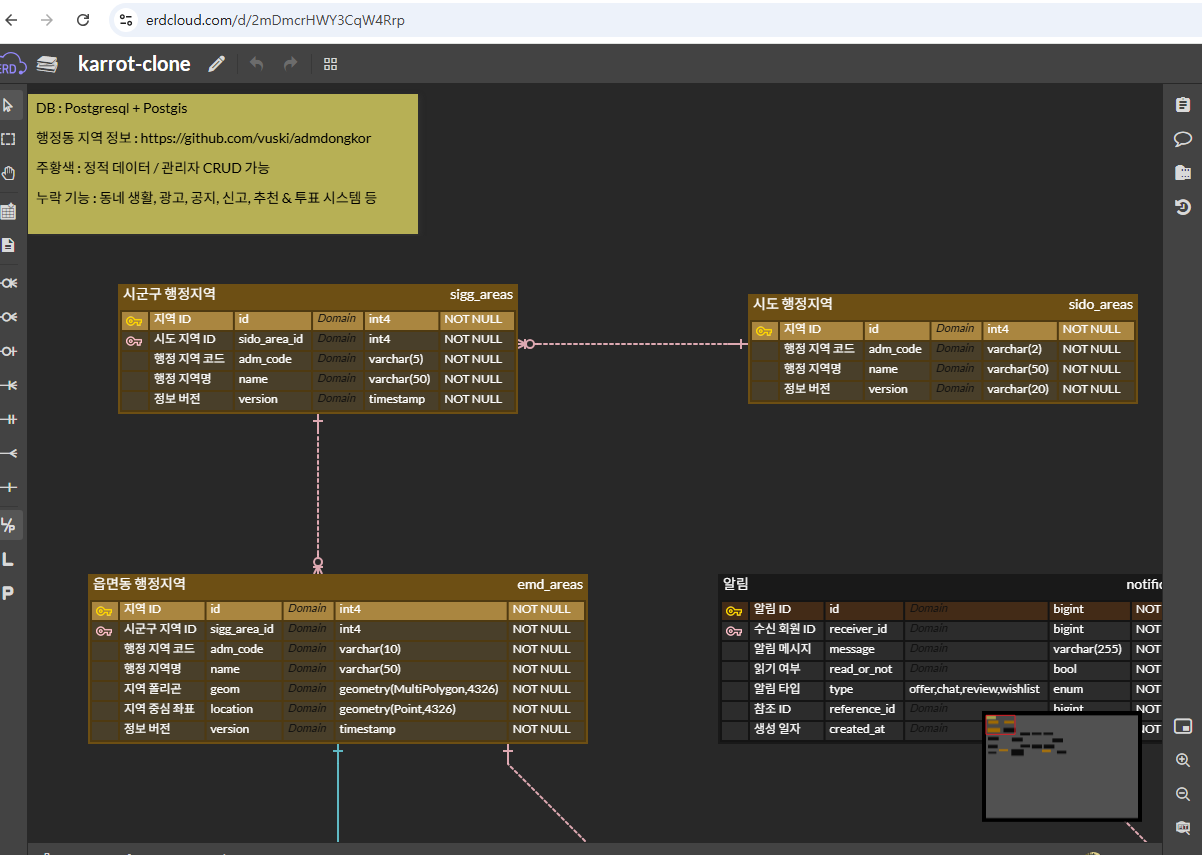
복잡한 서비스의 ERD 예시
역할 : 복잡한 서비스에서 여러 테이블이 어떻게 연결되는지 보여주는 예시
여러 지역·알림 관련 테이블이 관계로 연결된 ERDCloud 화면
출처 : https://www.erdcloud.com/
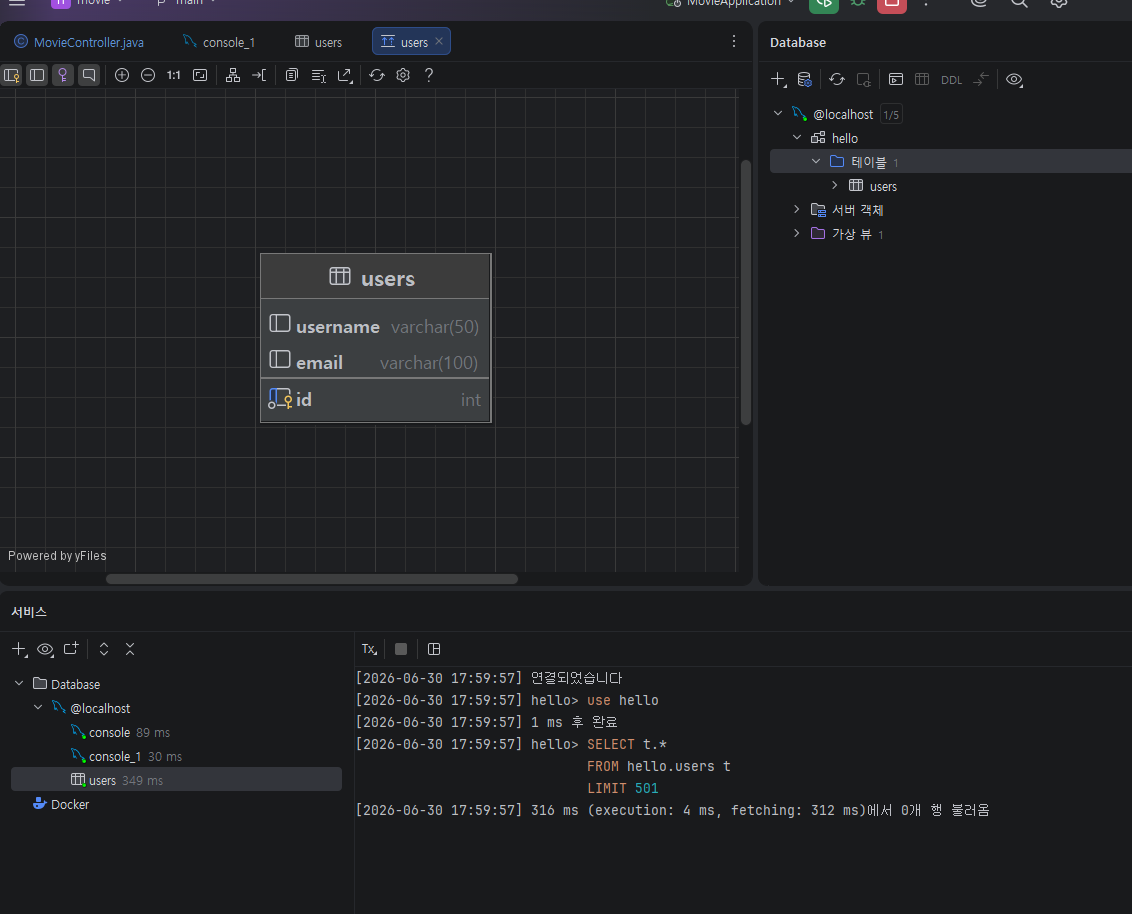
IntelliJ로 확인한 users 테이블 ERD
역할 : 직접 만든 users 테이블이 ERD 형태로 표현된 결과
users 테이블의 id, username, email 컬럼이 ERD 형태로 표시된 화면
반드시 기억할 것 3가지
| 핵심 | 설명 |
|---|---|
| 데이터베이스는 서버의 기억 장치다 | 프로그램이 꺼져도 남아야 하는 데이터는 DB에 저장해야 한다 |
WHERE는 수정·삭제의 안전장치다 | UPDATE, DELETE에서 WHERE를 빼면 전체 데이터가 바뀔 수 있다 |
| ERD는 테이블들의 설계도다 | 테이블, 컬럼, PK, FK, 관계를 시각적으로 정리해 오류를 줄인다 |
실무 관점에서의 활용
백엔드 개발자는 API만 만드는 사람이 아니라, API가 다루는 데이터 구조까지 함께 설계해야 한다. 예를 들어 "일정 관리 API"를 만든다면 먼저 어떤 데이터가 필요한지 정해야 한다.
| 기능 | 필요한 데이터 예시 |
|---|---|
| 일정 생성 | 제목, 내용, 작성자, 비밀번호, 생성일 |
| 일정 조회 | id, 제목, 작성자, 수정일 |
| 일정 수정 | id, 비밀번호, 변경할 제목 |
| 일정 삭제 | id, 비밀번호 |
이 구조를 먼저 ERD로 정리하면 API 설계가 더 명확해진다. 반대로 ERD 없이 바로 코드를 작성하면 나중에 “컬럼이 부족하다”, “관계가 잘못됐다”, “응답에 비밀번호가 노출된다” 같은 문제가 생길 수 있다.
따라서 데이터베이스와 ERD는 단순한 부가 지식이 아니라, 백엔드 개발자가 서버 로직을 안정적으로 만들기 위해 반드시 이해해야 하는 기본 설계 도구다.
마무리
데이터베이스는 애플리케이션의 데이터를 오래 보관하고, 여러 사용자가 함께 사용할 수 있도록 관리하는 저장소다. MySQL과 같은 관계형 데이터베이스는 데이터를 테이블, 행, 열로 구조화하며, SQL을 통해 생성·조회·수정·삭제 작업을 수행한다.
이번 정리의 핵심은 SQL 문법을 외우는 것이 아니라, 데이터가 어떤 구조로 저장되고 왜 제약 조건이 필요한지 이해하는 것이다. PRIMARY KEY는 행을 구별하기 위한 식별자이고, WHERE는 원하는 데이터만 조회·수정·삭제하기 위한 조건이다. 특히 UPDATE와 DELETE에서 WHERE는 선택 사항이 아니라 안전장치에 가깝다.
ERD는 데이터베이스 구조를 그림으로 표현한 설계도다. 직접 만든 users 테이블이 IntelliJ에서 ERD로 표현되는 것을 확인하면서, SQL 테이블과 ERD가 분리된 개념이 아니라 같은 구조를 다른 방식으로 보여주는 것임을 확인할 수 있었다.