개요
앞선 글을 통해 개별 EC2 서버를 구축하고 접속하는 법을 익혔다면, 이제는 이 서버들을 체계적인 네트워크 안에 가두고 효율적으로 관리하는 법을 알아볼 차례다. 실제 현업 수준의 아키텍처를 구성하기 위해 AWS 네트워크의 핵심인 VPC와 트래픽 분산 기술을 정리해 본다.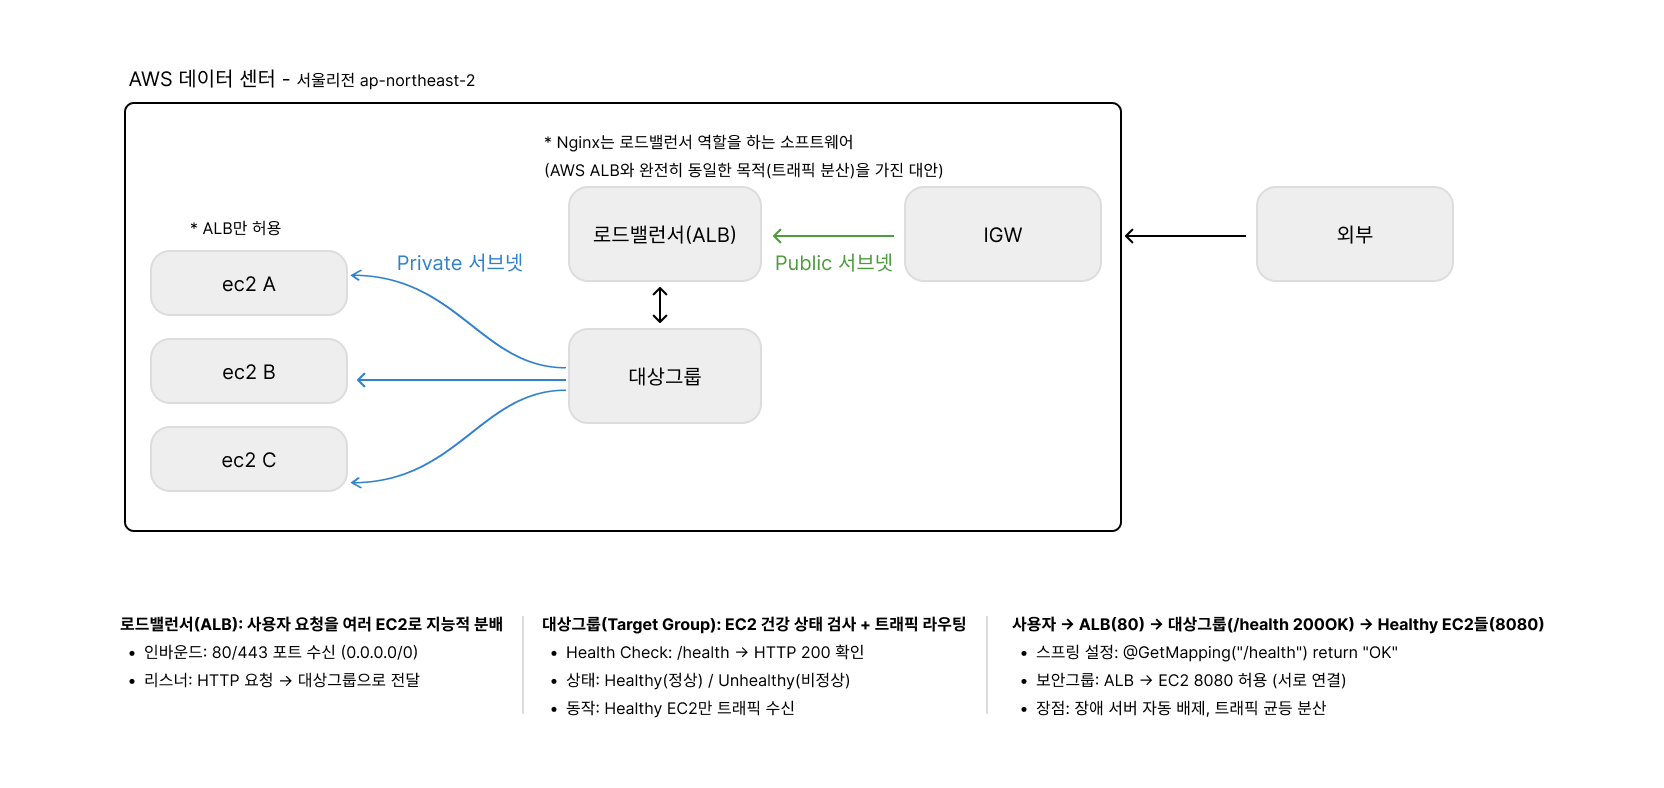
1. AWS VPC(Virtual Private Cloud): 나만의 가상 네트워크 설계
VPC는 AWS라는 거대한 클라우드 공간 안에 나만의 독립적인 네트워크 도시를 만드는 것과 같다. 이 안에서 IP 대역을 설정하고 목적에 따라 방(서브넷)을 나눌 수 있다.
- VPC CIDR (주소 대역): 예를 들어
172.31.0.0/16으로 설정하면 약 65,000개의 IP를 사용할 수 있는 거대한 네트워크 공간이 생긴다. - 서브넷(Subnet) 분할: 보안과 용도에 따라 도시를 다시 동네 단위로 쪼개는 과정이다.
- Public 서브넷: 인터넷 게이트웨이(IGW)와 연결되어 외부와 직접 통신할 수 있는 구역이다. (예: 로드밸런서 배치)
- Private 서브넷: 외부 접근은 차단하고 내부 서비스끼리만 통신하는 구역이다. (예: 실제 웹 서버, DB 배치)
2. 트래픽의 길잡이, 라우팅 테이블과 게이트웨이
네트워크 안에서 데이터가 어디로 흘러갈지 결정하는 것이 라우팅 테이블이다.
- IGW (Internet Gateway): 집의 현관문처럼 외부 인터넷과 VPC를 양방향으로 연결한다.
- NAT Gateway: 집에서 밖으로만 나갈 수 있는 뒷문과 같다. Private 서브넷의 서버들이 업데이트 등을 위해 외부로 나갈 때만 사용하며, 외부에서 안으로 직접 들어오는 것은 불가능하게 막아 보안을 강화한다.
3. 로드밸런서(ALB)와 대상 그룹(Target Group)
사용자가 늘어나면 서버 한 대(모놀리식)로는 감당하기 어렵다. 이때 트래픽을 여러 대의 서버로 지능적으로 나누어 주는 것이 로드밸런서다.
- 로드밸런서(ALB): 80번이나 443번 포트로 들어오는 사용자 요청을 받아 미리 설정된 대상 그룹으로 배분한다.
- 대상 그룹(Target Group): 요청을 처리할 EC2 인스턴스들의 집합이다.
- 상태 검사(Health Check): 로드밸런서는 주기적으로 서버들에게
/health같은 경로로 "살아있니?"라고 물어본다. 이때 HTTP 200 OK 응답을 주는 건강한(Healthy) 서버에만 트래픽을 보내 서비스 중단을 막는다.
4. 실습: 로드밸런싱 동작 확인하기
두 대의 EC2 인스턴스(my-ec2, my-ec2-test)를 준비하여 실제 트래픽이 분산되는지 확인해 볼 수 있다.
- 화면 차별화: 각 서버의
index.html파일을 "접속 화면 1", "접속 화면 2"로 다르게 수정한다. - 라운드 로빈: 로드밸런서 주소로 접속한 뒤 새로고침을 반복한다.
- 결과 확인: 설정된 알고리즘에 따라 1번 서버와 2번 서버의 화면이 번갈아 출력되는 것을 볼 수 있다. 이는 한 대의 서버에 장애가 나더라도 서비스가 유지될 수 있는 고가용성(HA) 구조가 완성되었음을 의미한다.
5. 최종 트래픽 흐름 정리
전체적인 데이터의 흐름을 요약하자면 다음과 같다.
- 사용자가 인터넷을 통해 IGW(현관문)로 진입한다.
- Public 서브넷에 위치한 ALB(안내원)가 요청을 받는다.
- ALB는 대상 그룹 내 서버들의 건강 상태를 체크한다.
- 보안 그룹 설정에 따라 ALB가 보낸 요청만 Private 서브넷의 EC2로 전달된다.
마치며
단순한 IP 주소 이해부터 시작해, 이제 우리는 클라우드 상에서 보안과 성능을 모두 고려한 네트워크 아키텍처를 설계할 수 있게 되었다. 이러한 인프라 구성은 서비스의 규모가 커질수록, 혹은 MSA 아키텍처로 분리될수록 그 중요성이 더욱 커진다.
Eazy하게