[논문 리뷰] DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
논문 리뷰
Summary
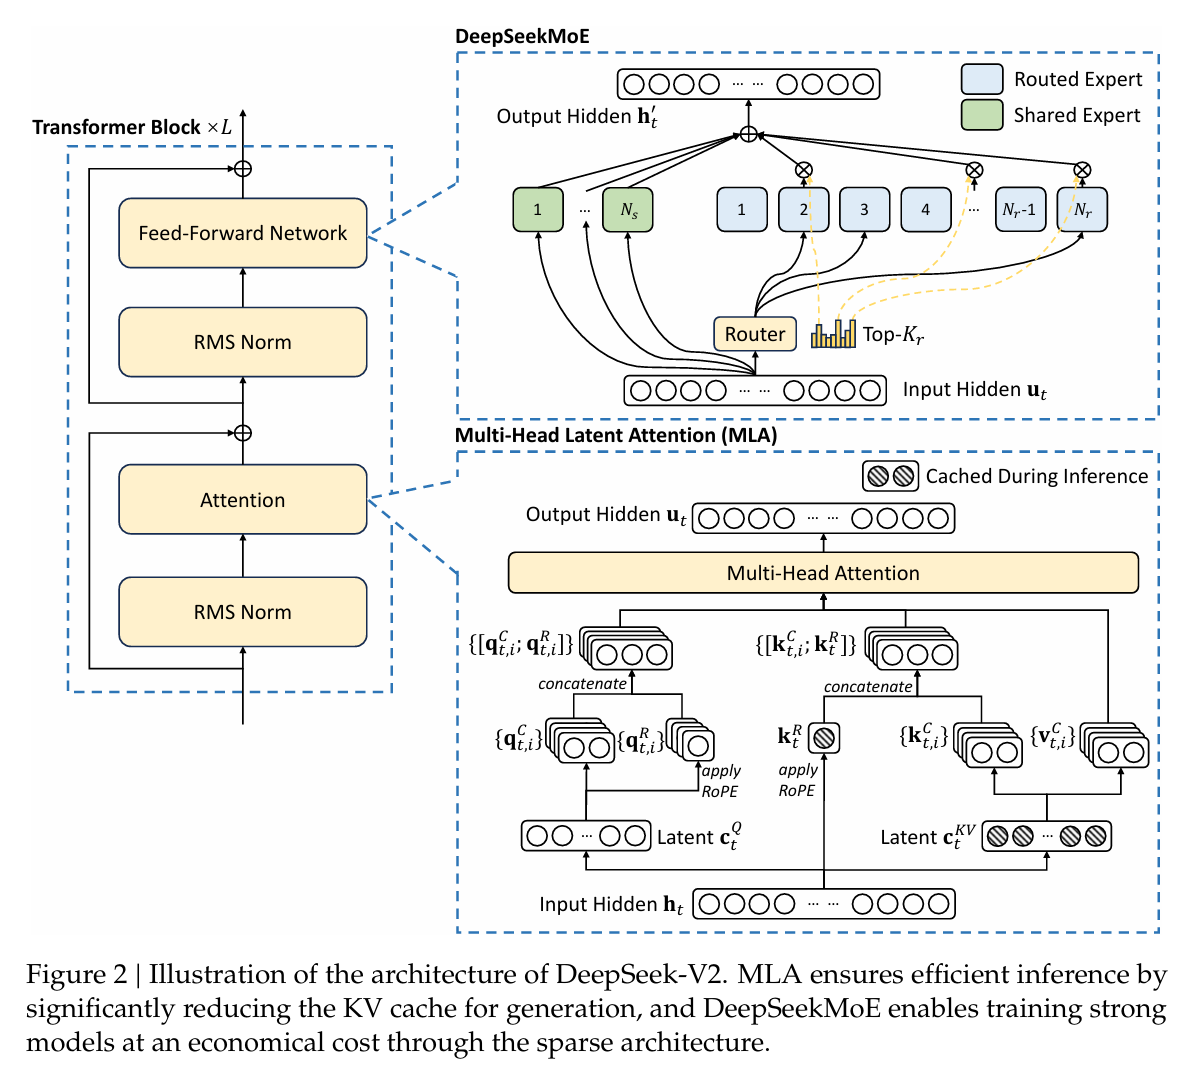
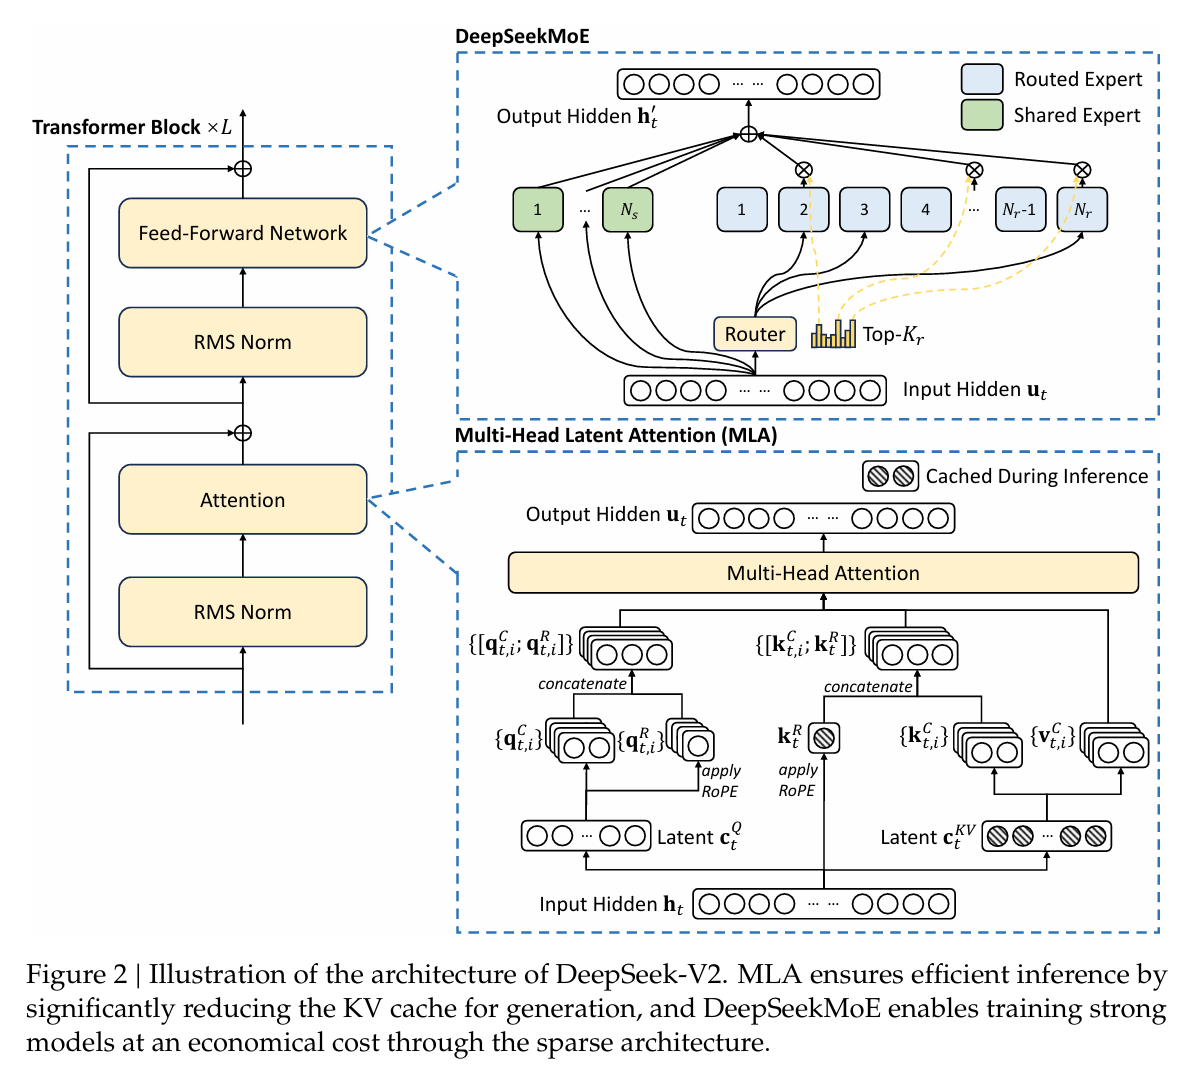
- MLA(Multi-head Latent Attention): K와 V를 하나의 저차원 latent vector로 함께 압축해서 그 latent만 캐싱한다. KV cache가 GQA 수준으로 작아지면서 성능은 오히려 MHA보다 좋다.
- DeepSeek MoE: FFN layer에서 모든 expert를 공유하는 것이 아닌, 몇 개의 shared expert와 affinity score를 바탕으로 routed expert로 학습한다. 여기에 device-limited routing과 세 가지 balance loss를 더해 expert parallelism의 통신 비용을 줄였다.
- Effect: 결과적으로 총 236B 파라미터 중 토큰당 21B만 활성화된다. DeepSeek 67B와 비교하면 학습 비용은 42.5% 줄고, KV cache는 93.3% 줄고, 최대 생성 throughput은 5.76배 높아졌다.
1. Problem & Motivation
LLM은 parameter 수가 늘수록 emergent capability가 나타나고 성능도 좋아진다. 대신 학습에 필요한 연산량이 증가하며 Attention의 inference step에서 각 token을 생성하기 위해서는 모든 previous K, V 값들을 caching해야 한다. 이는 memory capacity와 memory bandwidth를 증가시켜 throughput을 감소시킨다.
기존 해결책으로 사용된 방법들이 GQA와 MQA이다. 이는 Attention의 각 head들이 동일한 K, V값을 공유하여 cache를 줄이지만 동일한 K, V를 사용하기 때문에 MHA보다는 낮은 성능을 보인다. 이를 보완하고자 DeepSeek-V2에서는 두 가지 기법을 제시한다.
- Multi-head Latent Attention: Attention mechanism equipped with low-rank key-value joint compression
- DeepSeekMoE: Fine-grained expert with expert isolation
2. Core Idea ①: Multi-head Latent Attention (MLA)
2.1. Low-Rank Key-Value Joint Compression
Low-Rank Key-Value Joint Compression의 핵심은 K와 V를 직접 caching하지 않고 K와 V를 복원할 수 있는 latent vector인 만 caching하여 매번 K, V를 복원하여 사용하는 것이다.
Embedding token인 를 로 압축하고 inference 시에는 만 caching한 후 , 를 통해 , 를 복원하여 계산한다.
- : 번째 토큰의 입력 hidden state
- : down-projection. 로 압축하며, 이다.
- : up-projection. latent에서 각 head의 K, V를 복원한다.
Inference 시에 만 캐싱하므로 토큰당 레이어당 개의 원소만 저장하면 된다. 이는 기존 MHA의 개보다 훨씬 효과적이다. 또한, 실제 inference 시에는 매번 key, value 값을 계산하지 않는다. 와 가 곱해지고 는 와 곱해지기 때문에 는 쪽에, 는 쪽에 흡수시킬 수 있다. 그래서 추론 시에 K, V를 명시적으로 복원하지 않고 latent 위에서 바로 attention을 계산할 수 있다.
이처럼 Low-Rank Key-Value Joint Compression은 memory 접근을 감소시키는 대신 GPU의 연산량을 증가시킨다. 그렇다면 memory 접근 대비 computing을 늘리는 것이 실제 효과적일까?
GPU가 한 step을 처리하는 latency는 다음과 같이 나타낼 수 있다.
- : 메모리에서 읽고 쓰는 데이터 양 (bytes)
- : 메모리 대역폭 (bytes/s)
- : FLOPs
- : GPU의 최대 연산 성능 (FLOP/s)
이때, attention의 연산은 행렬곱 상에서 단순한 사칙연산으로 GPU의 FLOP을 증가시키는 것으로 가 증가하지 않는다. 즉, 의 증가로 를 감소시키는 것이 훨씬 효과적이다.
2.2. Query 압축: activation memory 절약
Query도 같은 방식으로 저차원 압축을 한다.
Query는 캐싱 대상이 아니므로 이 압축은 추론 때문이 아니라 학습 시 activation memory를 줄이기 위한 것이다. activation memory는 역전파를 위해 저장해 둬야 하는 중간값을 말한다.
2.3. Decoupled RoPE
RoPE는 위치에 따라 K에 회전 행렬을 곱하므로, 와 query 사이에 위치 의존적인 행렬이 끼어들게 된다. 즉, 기존 방식처럼 를 에 미리 흡수시킬 수 없고, 이는 매 inference step에서 과거 token들의 K를 모두 복원하는 것으로 MLA의 이점이 사라진다.
이를 해결하고자 내에서 위치 정보를 담당하는 부분을 분리한다.
- RoPE가 적용되는 query 는 head별로 두고, RoPE가 적용되는 key 는 모든 head가 공유한다.
- 캐싱 대상은 와 이고, 토큰당 개 원소다.
- 이처럼 RoPE가 적용되는 부분과 적용되지 않는 부분을 나눌 경우 연산 내부에서 은 과 곱해지고 는 와 곱해지므로 의 흡수가 가능하고, 는 latent에서 복원하는 값이 아니라, 처음부터 로 만들어서 RoPE까지 적용한 상태로 캐시에 저장하므로 최종적으로 K 복원이 필요 없어진다.
2.4. KV cache 비교
| Attention | 토큰당 KV cache (원소 수) | 성능 |
|---|---|---|
| MHA | Strong | |
| GQA | Moderate | |
| MQA | Weak | |
| MLA | Stronger |
DeepSeek-V2의 설정은 , 이다. 그래서 MLA의 캐시는 group이 2.25개인 GQA와 같은 크기인데, 성능은 MHA보다 좋다. 이 논문에서 가장 핵심적인 결과다.
3. Core Idea ②: DeepSeekMoE
3.1. 기본 구조
DeepSeekMoE는 크게 두 가지 아이디어로 구성된다.
Fine-grained expert segmentation: FFN을 여러 개로 쪼갠 형태인 Expert의 크기를 줄이고 여러 개를 동시에 활성화한다. expert 조합의 경우의 수가 늘어나서 다양한 특징을 학습할 수 있다는 논리이다.
Shared expert isolation: Token별로 다르게 활성화되는 expert 이외에도 모든 토큰이 항상 거치는 shared expert를 두어 공통적인 지식을 학습하도록 한다. 이는 routed expert에서 학습되는 지식의 중복을 줄이기 위함이다.
DeepSeek-V2는 레이어마다 shared expert 2개와 routed expert 160개를 두고, 토큰당 routed expert 6개를 활성화한다.
3.2. Device-Limited Routing
Expert parallelism에서는 expert들이 여러 GPU에 나뉘어 있다. 토큰이 선택한 expert가 여러 device에 흩어져 있을수록 통신 비용이 커진다. 통신 빈도가 대상 expert가 걸쳐 있는 device 수에 비례하기 때문이다.
그래서 routing을 두 단계로 나눈다. 먼저 affinity score가 가장 높은 expert를 가진 device 개를 고르고, 그 device 안의 expert들 중에서만 top-K를 고른다. 논문에서는 정도면 제한 없이 routing하는 경우와 성능이 비슷했다고 한다.
3.3. Load Balance를 위한 Auxiliary Loss
특정 expert나 특정 GPU로만 토큰이 몰리지 않게 하려고 세 가지 balance loss를 쓴다.
1) Expert-level balance loss: expert 사이의 불균형을 막는다.
- 는 expert 가 실제로 선택된 빈도이고, 는 expert 의 평균 affinity score다.
2) Device-level balance loss: device 사이의 계산량 불균형을 막는다.
3) Communication balance loss: 각 device가 받는 토큰 수를 균형 있게 맞춘다. device-limited routing은 보내는 쪽의 통신량만 제한하기 때문이다.
세 가지 loss의 의미는 다르지만 loss의 형태는 모두 유사한 것을 확인할 수 있다. 각 들은 device 혹은 expert가 균등하게 선택되는 경우에 대한 실제 선택 비율을 의미하며 이를 통해 만들어진 loss는 모든 device, expert들이 균일하게 선택되도록 유도한다.
3.4. Token-Dropping Strategy
Balance loss만으로는 엄격한 균형을 보장할 수 없다. 그래서 학습 시에 device 단위의 token dropping을 적용한다. 각 device의 계산 예산(capacity)을 정해두고, 예산을 넘으면 affinity score가 가장 낮은 토큰부터 버린다. 학습과 추론의 불일치를 줄이기 위해 일부 시퀀스(약 10%)는 dropping을 하지 않는다.
4. Pre-Training
4.1. Setup
- Data: 다양한 출처의 고품질 데이터를 추가하며 품질 기반 필터링과 편향 제거도 거쳤다. 총 8.1T 토큰으로 학습했다.
- Model: 60 layers, , , . 총 236B 파라미터 중 토큰당 21B를 활성화한다.
- Training: AdamW, warmup-and-step-decay schedule. 자체 framework인 HAI-LLM을 사용하였으며 activation 파라미터가 작아서 tensor parallelism 없이 학습할 수 있었다.
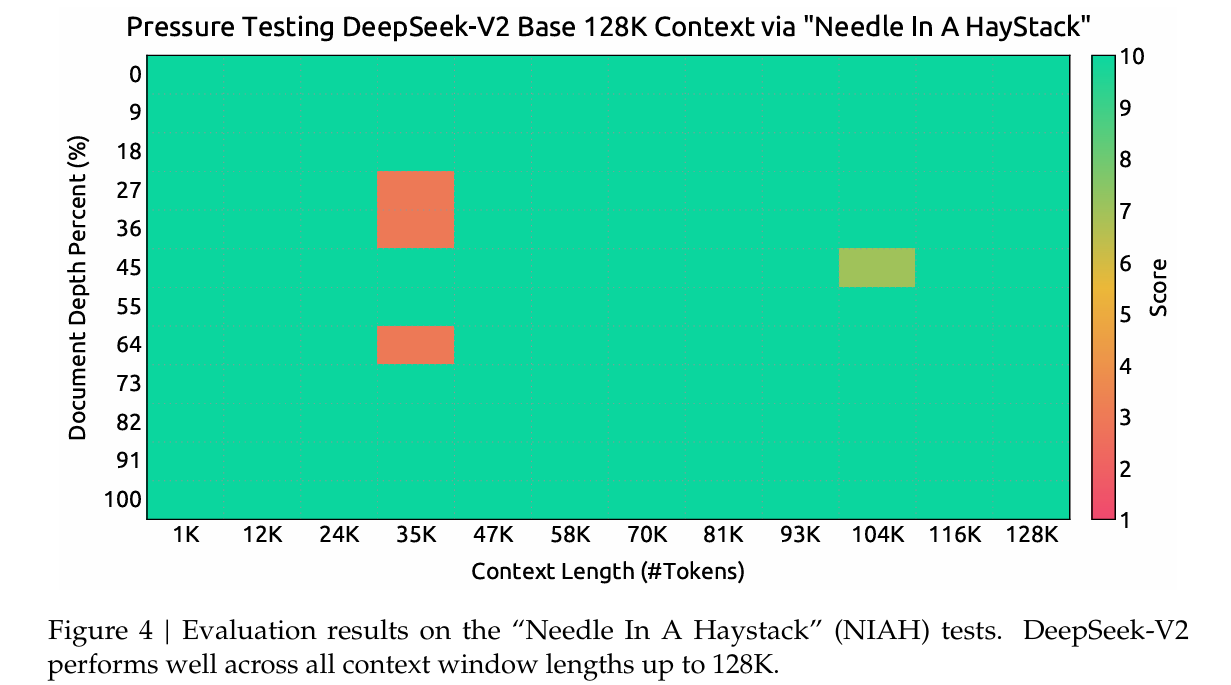
- Long context: YaRN을 decoupled key 에 적용해서 context를 4K에서 128K로 확장했다. Context 처리 가능성은 Needle In A Haystack task를 통해 확인하였다.
4.2. Evaluation
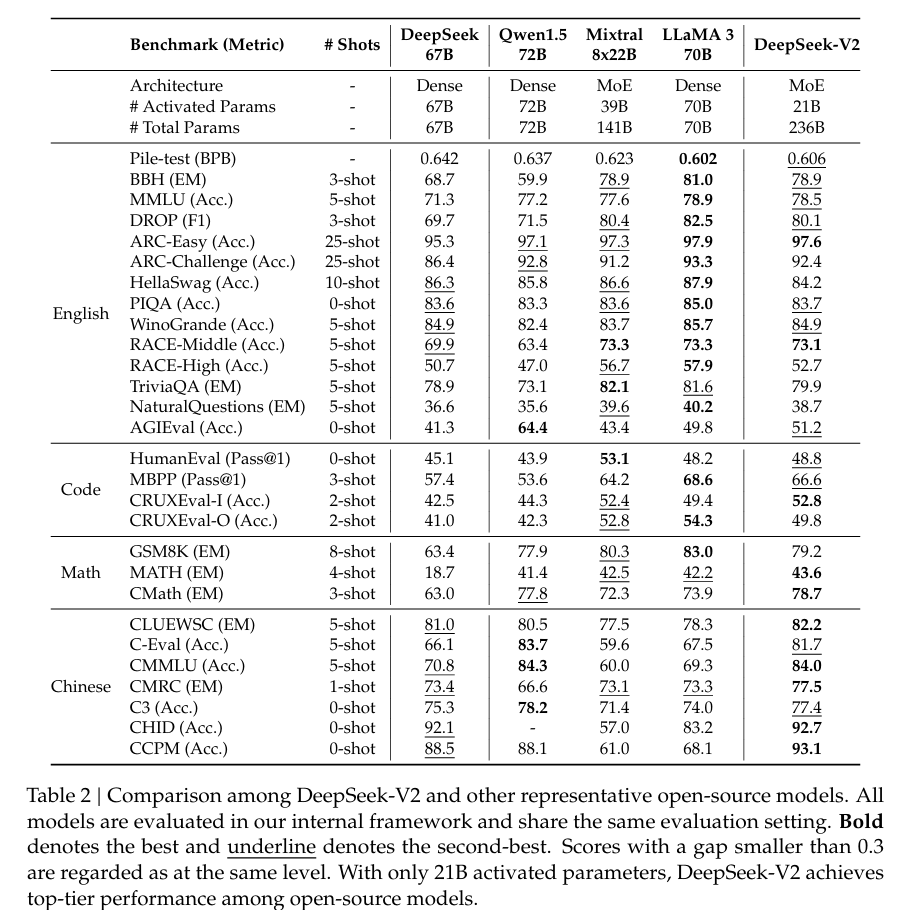
- DeepSeek 67B보다 거의 모든 벤치마크에서 성능이 높고, 발표 당시 오픈소스 모델 중 최상위권이다.
- Training Costs: 1T 토큰 기준 172.8K GPU hours로, DeepSeek 67B(300.6K)보다 42.5% 적다.
- Inference efficiency: KV cache를 원소당 평균 6-bit로 양자화했고, 캐시가 작아진 덕에 더 큰 batch size로 서빙할 수 있다. 결과적으로 최대 생성 throughput이 5.76배 높아졌다.
5. Alignment
5.1. SFT(Supervised Fine-Tuning)
1.5M개의 instruction 데이터를 썼다. helpfulness 데이터가 1.2M, safety 데이터가 0.3M이다. hallucination을 줄이고 글쓰기 능력을 높이는 쪽으로 데이터 품질을 개선했다.
5.2. Reinforcement Learning: GRPO
기존 RL의 경우 advantage의 계산에서 baseline 계산을 위하여 critic model의 추가 학습이 필요하였으며 critic model 자체가 policy와 비슷한 크기였기에 학습 효율이 좋지 못하였다. GRPO는 critic 없이 같은 질문에 대해 샘플링한 출력 개의 reward 통계로 baseline을 추정한다.
학습은 두 단계로 진행한다.
- Reasoning alignment: 코드와 수학 reasoning task에 대해 로 학습한다.
- Human preference alignment: 여러 reward를 섞는다.
학습 효율을 위해 학습과 추론에 서로 다른 병렬화 전략을 쓰는 hybrid engine을 도입했고, inference sampling 속도를 높이기 위하여 큰 batch size를 사용하였다.
5.3. Evaluation Results
- Base → SFT: SFT 데이터에서 수학과 코드 비중이 높아서 해당 성능이 크게 올랐다.
- SFT → RL: reasoning 관련 task, 특히 수학과 코드 생성에서 추가로 성능이 올랐다.
- SFT 데이터 양: 이전 연구에서는 10K 수준이면 충분하다고 봤다. 하지만 DeepSeek-V2에서는 데이터를 줄이면 instruction following 능력이 떨어졌다. 특정 능력을 얻으려면 최소한의 데이터가 필요하고, 그 양이 0에 가까워지지는 않는다는 해석이다.
6. My Take
6.1. MLA는 왜 MHA보다 성능이 좋을까?
MLA는 K와 V를 바로 만들지 않고 한 번 압축한 뒤 복원한다. 정보 손실이 있을 수밖에 없는 구조인데, 실험에서는 MHA보다 좋은 결과를 낸 task가 많았다. 그 원리가 무엇인지가 가장 궁금했다. (추론 시에는 weight absorption 덕분에 복원 연산을 따로 하지 않지만, 표현력 측면에서 병목이 있다는 점은 같다.)
가능한 설명을 두 가지 생각해 봤다.
- Query의 기여? GQA 같은 KV 공유 기법에서는 K/V보다 query의 다양성이 성능에 중요하다고 볼 수 있다. 하지만 MLA는 query도 압축하기 때문에 query 쪽이 원인은 아닐 것 같다.
- 공통 latent가 regularizer 역할? K와 V를 하나의 공통 vector로 압축하면서 일반화된 표현을 학습하게 된다. low-rank로 보내는 과정에서 중요한 feature만 남는 것이다.
둘 중에서는 2번이 더 그럴듯하다고 생각하지만, 논문에 이를 직접 검증한 ablation이 없어서 정확한 원인은 여전히 의문이다. 를 바꿔가며 성능 변화를 보면 이 가설을 어느 정도 확인할 수 있을 것 같다. 또한 더욱 긴 context와 data 및 sample 수가 많은 task에 대하여 학습 시 GPU efficiency와 상관없는 성능 자체는 MHA가 좋게 나올 수 있을 것이라고 생각한다.
6.2. Expert를 잘게 쪼개는 게 왜 좋을까?
DeepSeekMoE는 기존 MoE보다 훨씬 많은 수의 작은 expert를 쓰고, 그중 여러 개를 동시에 활성화한다. 그런데 전체 파라미터 수와 활성화 비율이 같다면, expert를 잘게 쪼개는 것과 크게 유지하는 것 사이에 이론적으로 표현력 차이가 있어야 하는 이유가 궁금했다.
- 조합의 수가 늘어나는 건 맞지만, 정말로 expert 하나하나가 분리된 sub-skill을 학습하는 걸까? Routed expert 사이에서도 공통된 정보가 학습될 가능성이 있어 보이는데 이를 사람이 확인할 수는 없기에 실제 sub-skill들이 구분되어 학습되는 것인지 궁금하였다.
- 역할이 겹치는 expert가 있다면 그걸 구분하거나 측정할 방법이 있을까?
- 또한, expert를 나누는 목적이 shared expert는 공통 특징을 학습하기 위함이고 routed는 더욱 세부적인 특징들을 학습하기 위함이라면 expert 자체의 크기를 다르게 한다면 각 expert가 학습하는 특징이 명확하게 구분되지 않을까?
6.3. Shared expert는 꼭 필요할까?
shared expert 없이 routing만으로 학습해도 공통 지식을 학습할 수 있지 않을까 생각했다. 외부에서 보면 각 expert가 어떤 skill을 담당하는지 구분되지 않는다. 그렇다면 공통 지식을 학습한 expert가 자연스럽게 모든 토큰에서 affinity score가 높아져서, 사실상 shared expert처럼 동작할 수도 있다. 다만 이 경우 balance loss가 그런 쏠림을 억제하는 방향으로 작용한다. 그래서 balance loss와 공통 지식 학습 사이의 충돌을 풀어주는 장치로 shared expert를 보는 게 더 정확한 해석일 수도 있겠다.
References
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. arXiv:2405.04434, 2024.
- Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. arXiv:2401.06066, 2024.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO). arXiv:2402.03300, 2024.
- Ainslie et al. GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. EMNLP 2023.

우와....너무 어렵네요 좋은 글과 생각 잘보고갑니다