Summary
- MQA(Multi-Query Attention): Query는 head마다 다르게 두고 Key와 Value는 모든 head가 동일한 값을 공유하여 incremental decoding step을 가속화한다.
- Transformer의 incremental inference는 연산량 때문이 아닌, token을 하나씩 생성할때마다 K, V를 memory에서 반복해서 읽어오는 memory bandwidth 때문에 느리다.
- K, V cache 크기가 head 개수 에 대하여 로 줄어 decoder 추론 속도가 약 12배 빨라지고 품질 저하는 아주 작다.
1. Problem & Motivation
Transformer는 attention layer로 sequence 내부 및 sequence 간 정보를 주고받는다. 학습할 때는 전체 sequence를 한 번에 병렬로 처리할 수 있어 빠르지만, incremental inference(추론) 과정에서는 이와 같은 병렬화를 적용할 수 없다.
- Incremental inference 과정에서는 매 step에서 token을 하나씩만 생성하기 때문에 병렬화가 불가능하다.
- Attention 연산을 위해서는 매 step마다 이전 모든 position의 K, V를 memory에서 불러와야한다. 즉, 연산량에 비해 읽어오는 데이터 양이 많아서 memory bandwidth가 bottleneck이 된다.
해당 논문에서는 MQA 방식을 통하여 읽어오는 K, V cache의 크기를 줄이는 방식으로 bottleneck을 해결한다.
2. Background: Neural Attention
해당 논문은 모든 연산을 tensor 사이 일반화된 contraction인 einsum notation으로 표현한다. 이 표기법 덕분에 각 텐서의 shape과 연산 흐름이 명확하게 보인다.
2.1. Dot-Product Attention
Query 하나에 대한 attention이다.
def DotProductAttention(q, K, V):
  """
  q: [k]      K: [m, k]      V: [m, v]
  Returns y: [v]
  """
  logits = tf.einsum("k,mk->m", q, K)
  weights = tf.softmax(logits)
  return tf.einsum("m,mv->v", weights, V)
2.2. Multi-head Attention
개의 서로 다른 attention layer(head)를 병렬로 사용한다.
- Query: 현재 입력 를 projection해서 만든다.
- Key, Value: 참조할 전체 sequence 을 projection해서 만든다.
def MultiheadAttention(x, M, P_q, P_k, P_v, P_o):
  """
  x: [d]    M: [m, d]
  P_q, P_k: [h, d, k]    P_v, P_o: [h, d, v]
  """
  q = tf.einsum("d,hdk->hk", x, P_q)
  K = tf.einsum("md,hdk->hmk", M, P_k)
  V = tf.einsum("md,hdv->hmv", M, P_v)
  logits = tf.einsum("hk,hmk->hm", q, K)
  weights = tf.softmax(logits)
  o = tf.einsum("hm,hmv->hv", weights, V)
  y = tf.einsum("hv,hdv->d", o, P_o)
  return y
2.3. Multi-head Attention (Batched)
실제 MHA 연산시에는 GPU를 최대한 효율적으로 활용하기 위하여 개의 서로 다른 position에서 query를 한번에 생성하여 개의 token을 한번에 처리하고 서로 상호작용하지 않는 개의 sequence를 batch로 처리한다. 즉, 한 step에서 개의 token을 처리하는 것이다.
def MultiheadAttentionBatched(X, M, mask, P_q, P_k, P_v, P_o):
  """
  X: [b, n, d]    M: [b, m, d]    mask: [b, h, n, m]
  """
  Q = tf.einsum("bnd,hdk->bhnk", X, P_q)
  K = tf.einsum("bmd,hdk->bhmk", M, P_k)
  V = tf.einsum("bmd,hdv->bhmv", M, P_v)
  logits = tf.einsum("bhnk,bhmk->bhnm", Q, K)
  weights = tf.softmax(logits + mask)
  O = tf.einsum("bhnm,bhmv->bhnv", weights, V)
  Y = tf.einsum("bhnv,hdv->bnd", O, P_o)
  return Y
Performance Analysis
직관적인 performance 표현을 위하여 다음의 가정이 적용되었다.
- (# of key/value = # of query)
- (전체 head를 합치면 dimension )
위의 조건을 바탕으로 분석한 performance는 다음과 같다.
- Operations:
- Memory access:
- :
- : logits & weights
- : projection 행렬
- Ratio (memory / operations):
는 낮을수록 좋다. 적은 데이터를 읽어서 많은 연산을 한다는 뜻이기 때문이다. 학습 때는 와 이 충분히 커서 이 비율이 작고, 따라서 GPU/TPU를 효율적으로 쓸 수 있다.
2.4. Multi-head Attention (Incremental)
추론 시에는 한 step에 token 하나만 처리한다. 이때 매번 에 를 곱해서 K, V를 새로 만드는 것이 아니라, 이전 position까지의 K, V(prev_K, prev_V)에 현재 token의 값만 이어 붙인다.
def MultiheadSelfAttentionIncremental(x, prev_K, prev_V, P_q, P_k, P_v, P_o):
  """
  x: [b, d]
  prev_K: [b, h, m, k]    prev_V: [b, h, m, v]
  Returns y: [b, d], new_K: [b, h, m+1, k], new_V: [b, h, m+1, v]
  """
  q = tf.einsum("bd,hdk->bhk", x, P_q)
  new_K = tf.concat([prev_K, tf.expand_dims(tf.einsum("bd,hdk->bhk", x, P_k), axis=2)], axis=2)
  new_V = tf.concat([prev_V, tf.expand_dims(tf.einsum("bd,hdv->bhv", x, P_v), axis=2)], axis=2)
  logits = tf.einsum("bhk,bhmk->bhm", q, new_K)
  weights = tf.softmax(logits)
  o = tf.einsum("bhm,bhmv->bhv", weights, new_V)
  y = tf.einsum("bhv,hdv->bd", o, P_o)
  return y, new_K, new_V
성능 분석 ( step 전체 기준)
- Operations: → batched와 동일
- Memory access:
- : 매 step마다 K, V 전체를 다시 읽음
- : 매 step마다 projection 행렬을 다시 읽음
- Ratio:
- : sequence 길이 이 에 가까워지면 K, V를 읽어오는 비용이 지배적이 된다.
- : batch가 작으면 projection 행렬을 읽는 비용이 지배적이 된다.
항은 batch를 키우면 줄일 수 있지만, 항은 구조적인 문제다. 이 항을 줄이는 것이 MQA의 목표이다.
3. Multi Query Attention (MQA)
핵심 아이디어
서로 다른 head들이 하나의 Key, Value 세트를 공유한다.
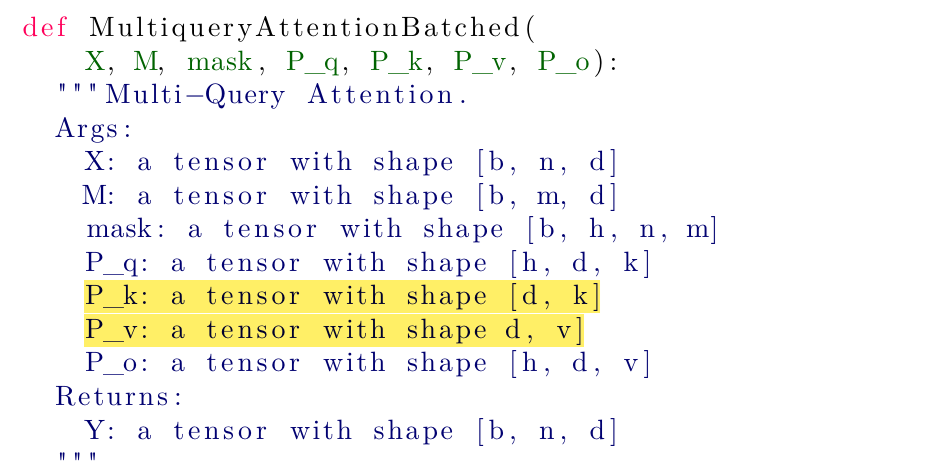
구현 관점에서는 정말 단순하다. Multi-head 코드에서 K, V와 관련된 텐서의 차원을 지우면 된다.
def MultiquerySelfAttentionIncremental(x, prev_K, prev_V, P_q, P_k, P_v, P_o):
  """
  x: [b, d]
  prev_K: [b, m, k]    prev_V: [b, m, v]        # h 차원이 사라짐
  P_q: [h, d, k]    P_k: [d, k]    P_v: [d, v]    P_o: [h, d, v]
  Returns y: [b, d], new_K: [b, m+1, k], new_V: [b, m+1, v]
  """
  q = tf.einsum("bd,hdk->bhk", x, P_q)          # Query는 여전히 head별
  new_K = tf.concat([prev_K, tf.expand_dims(tf.einsum("bd,dk->bk", x, P_k), axis=1)], axis=1)
  new_V = tf.concat([prev_V, tf.expand_dims(tf.einsum("bd,dv->bv", x, P_v), axis=1)], axis=1)
  logits = tf.einsum("bhk,bmk->bhm", q, new_K)  # 모든 head가 같은 K를 봄
  weights = tf.softmax(logits)
  o = tf.einsum("bhm,bmv->bhv", weights, new_V) # 모든 head가 같은 V를 봄
  y = tf.einsum("bhv,hdv->bd", o, P_o)
return y, new_K, new_V- Query projection
P_q:[h, d, k]그대로 유지 - Key/Value projection
P_k,P_v:[h, d, k]→[d, k] - KV cache
prev_K,prev_V:[b, h, m, k]→[b, m, k]→ 크기가 배
성능 분석 (Incremental)
- Operations: → 동일
- Memory access:
- : (x에 번 접근)
- : K, V →
- : projection →
- Ratio:
문제였던 항이 K, V를 공유함으로써 , 즉 배로 줄어든다.
| Operations | Memory access | Ratio | |
|---|---|---|---|
| MHA (Batched) | |||
| MHA (Incremental) | |||
| MQA (Incremental) |
4. Experiments & Results
4.1. Quality
Quality 평가에 앞서 K, V projection이 줄어든 만큼 파라미터 수가 줄어들기 때문에, baseline과 전체 파라미터 수를 맞추기 위해 FFN의 hidden dimension 를 키웠다.
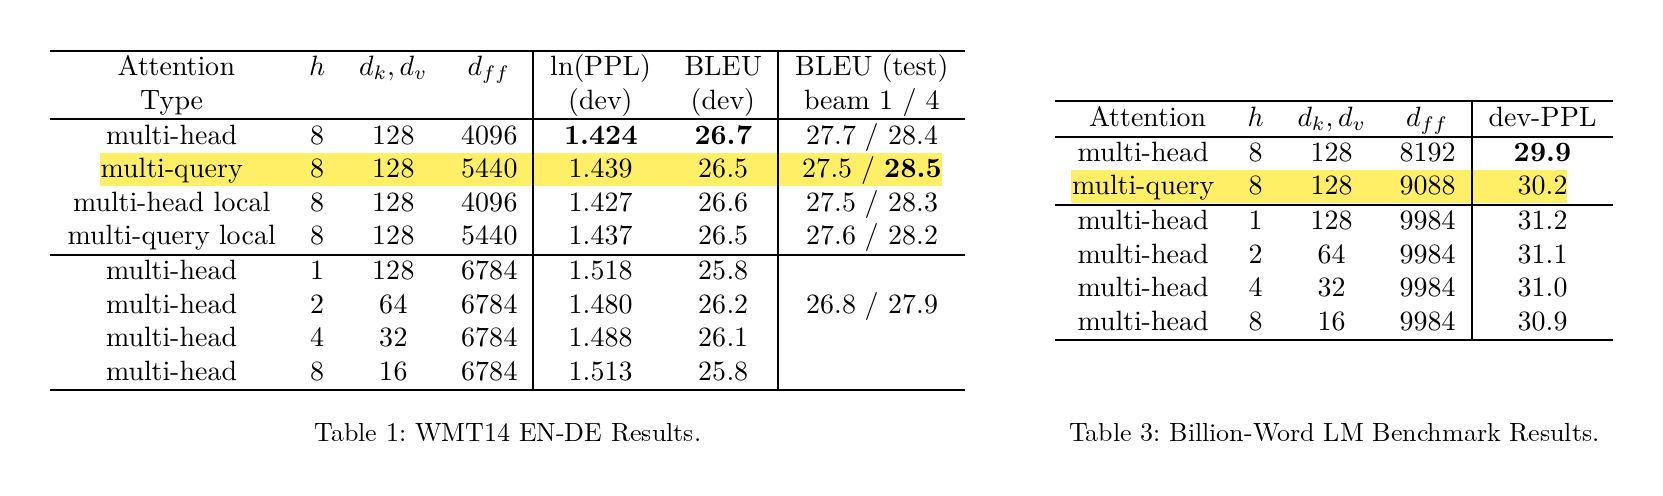
- MQA는 baseline(multi-head) 대비 아주 근소한 성능 하락만 보이고, beam 4 test BLEU에서는 오히려 약간 높다.
- 반면 K, V 크기를 줄이는 다른 방법들(head 수 를 줄이거나, 를 줄이는 것)은 MQA보다 성능이 확실히 떨어진다.
4.2. Speed
K, V를 head끼리 공유한 효과는 inference step에서 확실하게 드러난다. (Time per token)
| Encoder | Decoder | |
|---|---|---|
| Baseline (MHA) | 1.7μs | 46μs |
| MQA | 1.5μs | 3.8μs |
- Encoder는 학습과 마찬가지로 병렬 처리가 되기 때문에 차이가 거의 없다.
- Decoder는 약 12배 빨라진다. Memory bandwidth가 병목이었던 incremental decoding에서 KV cache가 로 줄어든 효과가 그대로 나타난다.
5. My Take
5.1. Query가 attention의 핵심인 것 같다.
MQA는 결국 K, V를 head별로 통일하는 방식이다. 서로 다른 head는 token 간의 서로 다른 상관관계를 학습하기 때문에, K, V를 head별로 통일하면 성능이 훨씬 많이 떨어질 거라고 예상했다. 그런데 실제로는 baseline과 매우 근소한 차이만 났다. 이를 보면 attention에서는 결국 현재 token이 요구하는 정보인 Query가 가장 영향력이 큰 것으로 보인다. head마다 "무엇을 물어볼지"만 다르면, "어디서 찾을지(K)"와 "무엇을 가져올지(V)"는 공유해도 충분히 다양한 패턴을 만들 수 있다는 뜻이다.
5.2. 같은 KV 크기 축소라도 방법에 따라 결과가 다르다.
head 수를 줄이거나 K, V의 dimension을 줄였을 때 성능이 낮아지는 것은 K, V 자체가 담는 정보가 줄어들기 때문으로 보인다. 이 경우 FFN dimension을 늘려서 파라미터 수를 맞춰도 token 간 정보 공유는 attention에서만 일어나기 때문에 그 손실을 메우지 못한다. 반면 MQA는 K, V의 dimension()은 유지하고 head 간 중복만 제거하기 때문에 정보 손실이 적다.
5.3. 실험 task에 대한 의문
논문에서 사용한 WMT14 번역, Billion-Word LM 등은 지금 기준으로 다소 오래되고 규모가 작은 task다. 그래서 dataset 규모가 크거나 더 어려운 task에서도 MQA가 좋은 성능을 보일지는 의문이 남는다. 다만 실제로 PaLM, Falcon 등 대형 모델에서 MQA가 채택되었고, LLaMA-2 70B는 MQA를 일반화한 GQA를 사용하는 것을 보면 대규모에서도 충분히 쓸 만한 trade-off로 받아들여진 것 같다.
References
- Shazeer, N. (2019). Fast Transformer Decoding: One Write-Head is All You Need. arXiv:1911.02150
