[논문 리뷰] GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
논문 리뷰
Summary
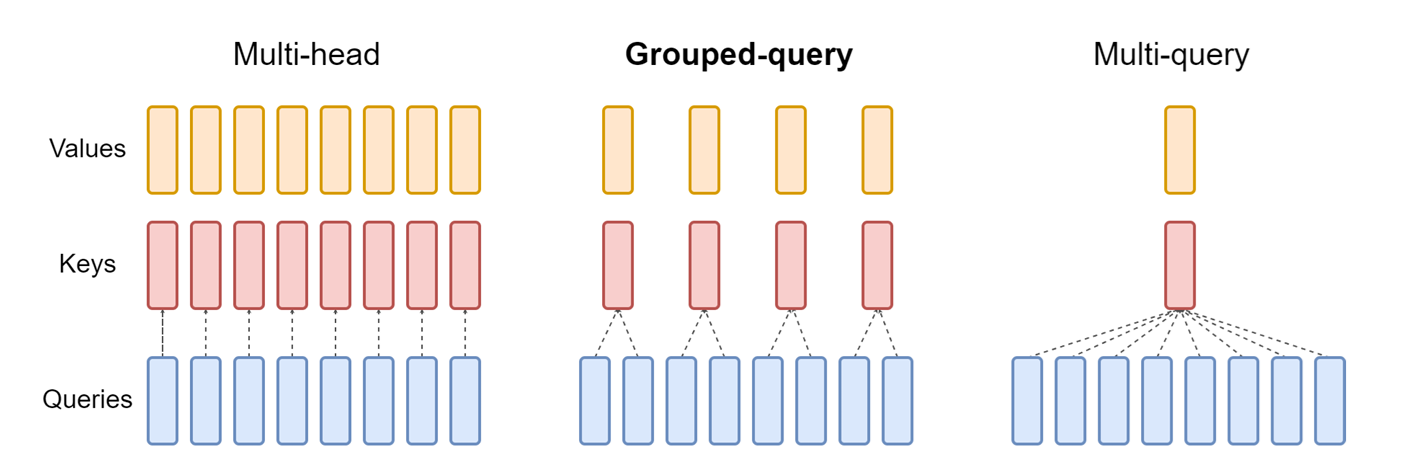
- GQA(Grouped Query Attention)은 Query head를 개의 그룹으로 나누고 각 그룹마다 동일한 head 하나를 공유하는 방식이다.
- 모든 head가 동일한 값을 공유하는 MQA와 모든 head가 독립적인 값을 가지는 MHA 사이의 절충안으로 GQA-8 모델은 MHA에 가까운 품질을 내면서 MQA에 가까운 속도를 보인다.
- Uptraining: 이미 학습된 MHA checkpoint의 K, V projection을 mean pooling으로 합친 뒤, 원래 pre-training 연산량의 5%만 추가 학습해서 MQA/GQA 모델로 바꾼다.
1. Problem & Motivation
Fast Transformer Decoding: One Write-Head is All You Need에서 확인할 수 있듯이 MQA는 모든 head가 K, V를 하나만 공유하게 해서 KV cache를 로 줄였다. 다만, MQA 방식은 몇가지 문제가 존재한다.
- Quality degradation: K, V head가 하나뿐이라 모델 성능이 떨어질 수 있다.
- Training instability: 특히 긴 입력을 다루는 task에서 학습이 불안정해진다.
- 별도 학습 비용: 이미 공개된 대형 모델은 대부분 MHA이므로 inference를 위하여 MQA 모델을 처음부터 다시 학습시키는 과정은 비용이 많이 든다.
이러한 문제를 해결하기 위하여 해당 논문에서는 두 가지 방법을 제시하였다.
- 기존 MHA checkpoint를 적은 연산으로 MQA/GQA로 바꾸는 uptraining
- MHA와 MQA 사이를 보간하는 Grouped-Query Attention
2. Method
2.1. Uptraining
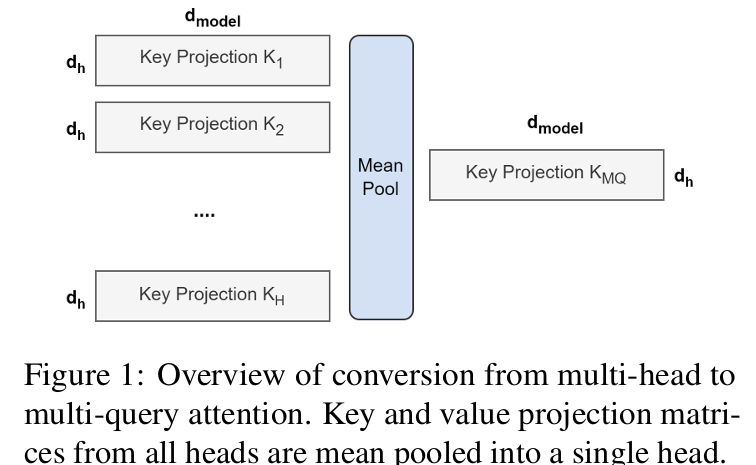
Uptraining은 Multi-head model에서 Multi-Query model을 만들어내며 그 과정은 다음과 같이 두 단계이다.
- Converting Checkpoint: head별 Key, Value projection 행렬을 mean pooling해서 하나의 Key, Value head로 합친다.
- Additional pre-training: 변환된 모델을 원래 pre-training 연산량의 비율 만큼 같은 recipe로 더 학습해서 새 구조에 적응시킨다.
2.2. Grouped Query Attention
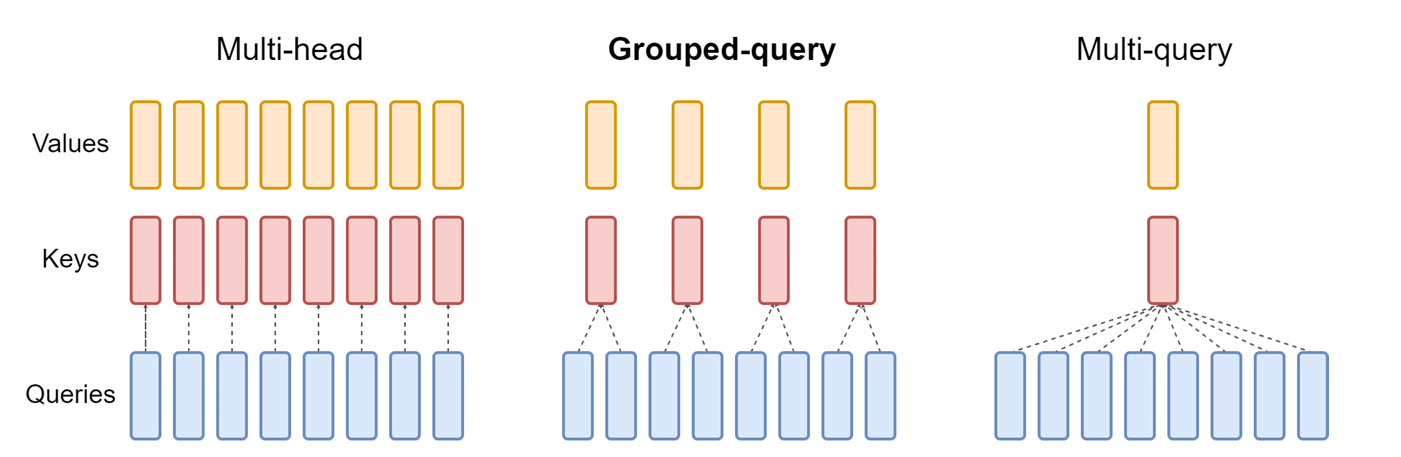
Query head 개를 개 그룹으로 나누고, 각 그룹이 하나의 K, V head를 공유한다. 이렇게 만든 모델을 GQA-라고 부른다.
- GQA-1 = MQA (K, V head 1개)
- GQA- = MHA (K, V head 개)
- 그 사이의 는 MQA보다 품질이 높고 MHA보다 빠른 중간 모델이 된다.
MHA checkpoint에서 GQA로 변환할 때는 그룹에 속한 head들끼리만 mean pooling한다.
그렇다면 큰 model에서 GQA가 왜 효과적인 trade-off인 것일까?
- GQA는 group 수를 model의 크기에 비례하여 늘릴 수 있다. MQA는 기존 head 수에 상관없이 하나의 K, V head로 줄이기 때문에 model이 커질수록 K, V의 표현력이 감소하지만 GQA는 head 수에 비례하여 K, V head를 유지할 수 있다.
- 큰 모델일수록 KV cache 병목의 비중이 작다. KV cache 크기는 에 비례하지만 연산량과 파라미터는 에 비례한다. 그래서 모델이 커질수록 KV cache memory bandwidth의 상대적인 영향이 줄어들고, 굳이 K, V를 하나만 쓸 필요가 없다.
- Sharding 낭비가 줄어든다. 모델을 여러 GPU/TPU에 나눌 때 MQA의 K, V head 하나는 모든 partition에 복제된다. GQA는 그룹 수를 장치 수에 맞춰 설정할 수 있어서 이 낭비를 줄일 수 있다.
3. Experiments
3.1. Setup
- Base model: T5.1.1 Large, XXL (encoder-decoder). MHA-Large, MHA-XXL은 공개 checkpoint 그대로 쓴다.
- Uptraining: MQA-XXL과 GQA-8-XXL을 원래 pre-training step의 만큼 추가 학습한다.
- Tasks
- 요약: CNN/Daily Mail, arXiv, PubMed, MediaSum, Multi-News (ROUGE-1)
- 번역: WMT 2014 En-De (BLEU)
- 질의응답: TriviaQA (F1)
3.2. Results
MQA, MHA, GQA 기반의 모델들을 여러 task들에 대하여 비교한 결과는 다음과 같다.
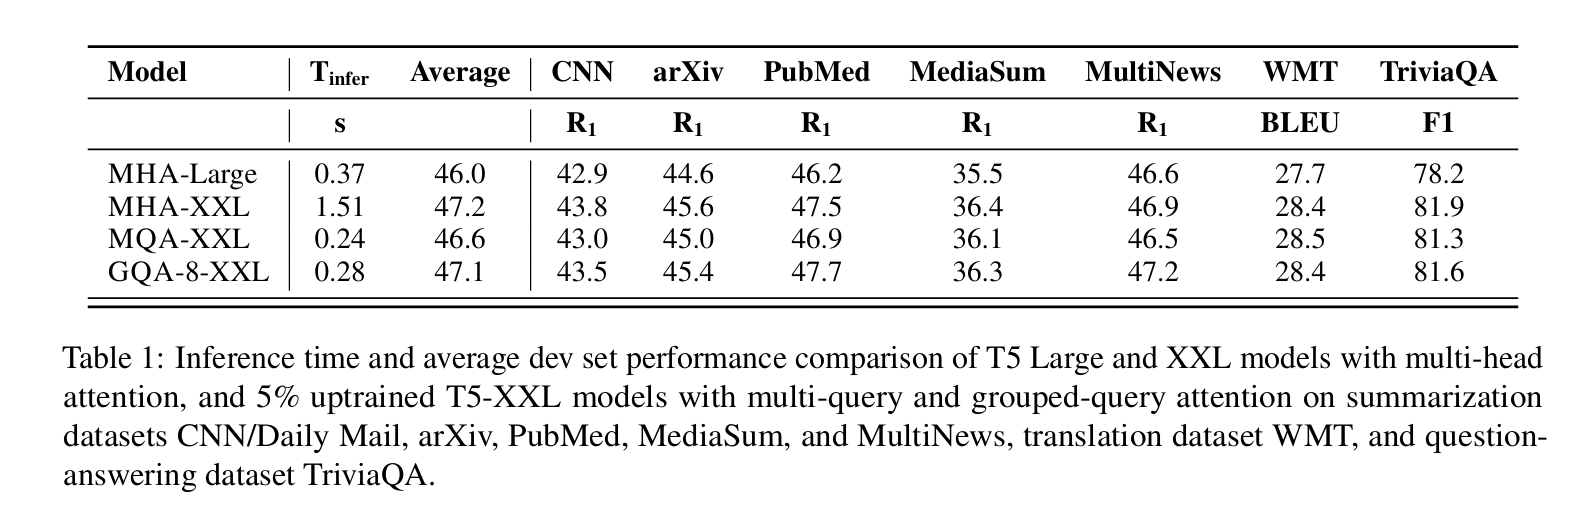
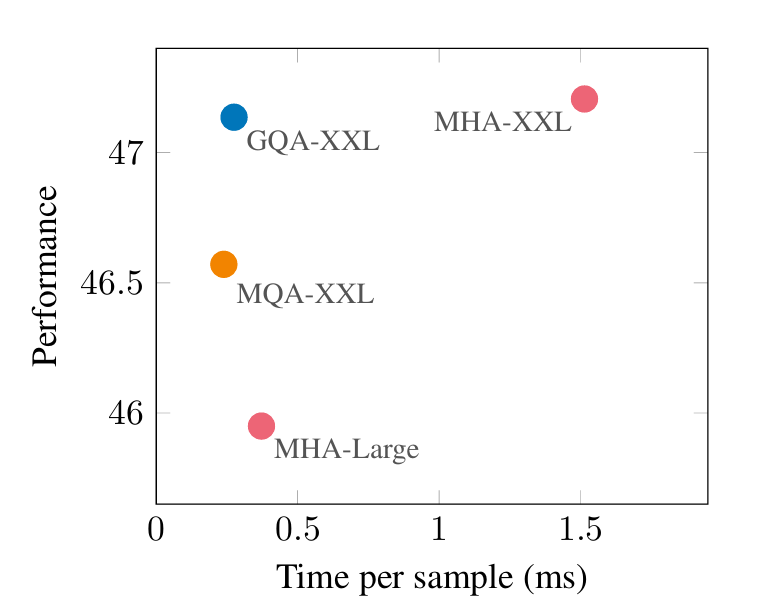
- Uptrained MQA-XXL은 MHA-Large보다 품질도 높고(46.6 vs 46.0) 속도도 빠르다(0.24 vs 0.37). 즉 작은 MHA 모델을 쓰는 것보다 큰 모델을 MQA로 uptraining하는 쪽이 더 나은 trade-off다. 다만 MHA-XXL과 비교하면 품질이 0.6 떨어진다.
- GQA-8-XXL은 MHA-XXL과 거의 같은 품질(47.1 vs 47.2) 을 내면서 속도는 MQA에 가깝다(0.28 vs 0.24). MHA-XXL(1.51)에 비하면 약 5.4배 빠르다.
- 위 그래프에서 GQA-XXL은 왼쪽 위, 즉 빠르면서 품질도 높은 위치에 있다.
3.3. Ablations
Ablation은 요약 task 일부로 진행했기 때문에 점수의 절대값이 main result와 다르다. Checkpoint conversion 방식, uptraining step, group 수에 따른 성능을 비교한다.
3.3.1. Checkpoint conversion
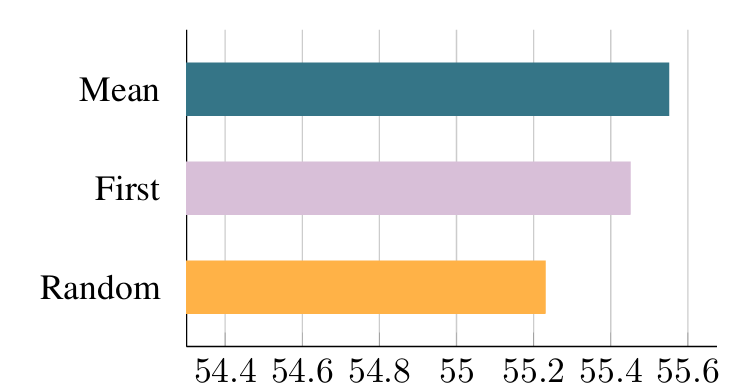
- Mean: 모든 head의 K, V projection을 평균낸다.
- First: 첫 번째 head의 K, V projection만 가져온다.
- Random: K, V projection을 새로 랜덤 초기화한다.
결과는 Mean > First > Random 순이다. pre-trained 모델의 정보를 많이 보존할수록 성능이 좋다.
3.3.2. Uptraining steps
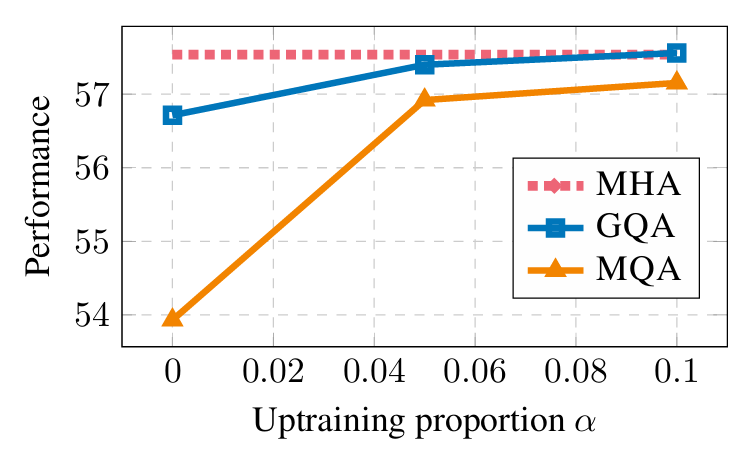
- GQA는 uptraining 없이 변환만 해도() 괜찮은 성능을 낸다. 반면 MQA는 변환 직후 성능이 크게 떨어져서 uptraining이 꼭 필요하다.
- 두 모델 모두 까지 크게 좋아지고, 에서는 개선 폭이 줄어든다. 그래서 논문은 를 기본값으로 사용한다.
3.3.3. Number of groups
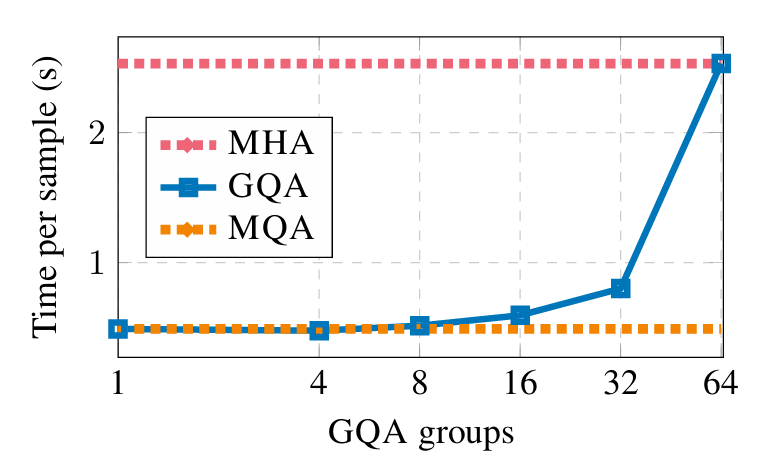
- Group 수를 1(MQA)에서 8까지 늘려도 추론 시간의 변화는 크지 않다
- 그 이상부터 추론 시간이 빠르게 증가하여, 64에서는 MHA와 같아진다.
- 품질과 속도의 균형점으로 group 수를 8로 정하였다.
4. Conclusion
GQA는 MQA와 MHA를 보간하는 방법이다. MHA에 가까운 품질을 MQA에 가까운 속도로 얻을 수 있다. 여기에 uptraining을 쓰면 기존 MHA checkpoint를 원래 pre-training 연산량의 5%만으로 GQA 모델로 바꿀 수 있다.
다만, 몇 가지 limitation들도 존재한다. 각 task별로 점수를 나타내는 평가 지표의 불확실성이 문제로 제시되었으며 uptraining한 model을 from-scratch로 학습한 model과 비교하지 않았기에 from-scratch로 학습한 model과 성능 비교가 이루어지지 못하였다. 여러 task 수행이 encoder-decoder(T5)로만 진행되며 decoder-only model에서의 효과도 확인하지 못하였다. 요즘 LLM의 주류인 decoder-only 모델에서는 self-attention만 있고 cross-attention이 없으므로, 논문은 GQA의 효과가 더 클 것으로 기대만 했다.
5. My Take
1. MQA 글에서 세운 가설과 이어진다.
MQA 리뷰에서 "attention에서는 Query가 가장 중요하고, K, V는 공유해도 충분하다"는 가설을 세웠다. GQA 결과도 이 방향과 맞는다. K, V head를 64개에서 8개로 줄여도 품질이 거의 그대로다. 다만 MQA(1개)에서는 품질이 떨어지기 때문에, K, V에도 최소한의 다양성은 필요하다는 점도 함께 보여준다.
2. Mean pooling이 가장 좋다는 건 head들의 K, V가 꽤 비슷하다는 뜻일 수 있다.
서로 전혀 다른 projection을 평균내면 의미 없는 값이 나올 것 같은데, 실제로는 Mean이 First, Random보다 좋았다. 이는 head들의 K, V projection 사이에 중복이 많다는 걸 보여준다. 이 중복 덕분에 GQA를 에서 써도 성능이 꽤 나오는 것으로 보인다.
References
- Ainslie, J. et al. (2023). GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. EMNLP 2023. arXiv:2305.13245
- Shazeer, N. (2019). Fast Transformer Decoding: One Write-Head is All You Need. arXiv:1911.02150
