🖇 전처리 자동화 프로세스
🖇 전처리 파이프라인 구성
🖇 주요 함수 동작
Speed Dating 데이터셋을 기반으로 Feature Engineering을 수행하면서,
반복적인 전처리 과정을 모듈화하고 패키징하여 효율적이고 재사용 가능한 전처리 흐름을 구축할 수 있다는 인사이트를 얻을 수 있었다.
기존의 전처리 흐름은 하나의 Jupyter Notebook 내에서 이루어졌지만, 이는 다음과 같은 단점이 있다.
- 코드가 길어지고 가독성이 떨어짐
- 재사용이 어려움 (다른 데이터셋에서 반복 불가)
- 수정이 발생했을 때 모든 셀을 수정해야 하는 비효율성
이러한 문제를 해결하고자
전처리 과정을 함수화하여 모듈별 .py 파일로 분리하고, src/ 폴더 내에 저장하여 체계적인 구조로 정리하였다. 이후 이 함수들을 불러와 다시 전처리 흐름을 재현하는 code_function_dating.ipynb를 구성하였다.
이 글에서는 모듈화 및 패키징으로 전처리를 자동화하는 흐름에 중점을 두고 있다.
자세한 전처리 과정은 GitHub repository에서 확인할 수 있다.
🖇 전처리 자동화 프로세스
# code_function_dating.ipynb

import sys
import pandas as pd

# 사용자 정의 모듈을 경로에 추가
sys.path.append('./src')

# 데이터 로드
dating_df = pd.read_csv('dating.csv')

# 전처리 과정을 순차적으로 호출하는 메인 함수
from pre_func import pre_func

# 전처리 실행
pre_func(dating_df)
모든 전처리 로직이 pre_func() 함수 한 줄로 실행된다.
글의 마지막에서 해당 코드 한 줄로 긴 전처리 과정을 한 번에 수행한 결과를 확인할 수 있다.
이 함수는 src/pre_func.py에 정의되어 있으며,
이후 설명할 아래의 여러 함수 및 라이브러리를 내부적으로 호출하여 전처리 파이프라인을 자동으로 구성하게 된다.
🖇 전처리 파이프라인 구성
pre_func.py 에서는 모듈화된 전처리 흐름을 불러와 실행하고 전처리를 재현 실험한다.
-
함수가 정상적으로 작동하는지 검증
-
모듈화된 흐름이 의도대로 전처리를 수행하는지 확인
-
전처리 파이프라인의 실행 결과를 재현하는 통합 테스트 역할
# pre_func.py

import sys

sys.path.append('./src')

import pandas as pd
import numpy as np
from col_rename import col_rename
...
from sel_one_func import sel_one_func

def pre_func(dating_df):
    dating_df = col_rename(dating_df)
    dating_df = missing_func(dating_df)
    dating_df = outlier_func(dating_df)
    dating_df = imp_func(dating_df)
    dating_df = age_gap_func(dating_df)
    dating_df = race_func(dating_df)
    dating_df = rating_func(dating_df)
    dating_df = sel_one_func(dating_df)
    return dating_df
이 함수는 8단계로 구성된 전처리 로직을 순서대로 호출한다.
각 함수는 독립된 전처리 단계를 수행하게 되는데, 디렉토리 구조와 함께 각 함수의 기능을 정리해 보았다.
feature-engineering-dating/
├── feature-engineering-dating.ipynb     # 피처 엔지니어링 실습 노트북
├── .gitignore
├── README.md
└── src/                                 # 전처리 함수 모듈
    ├── code_function_dating.ipynb       # 함수화된 전처리 흐름을 재구성한 노트북
    ├── col_rename.py                    # 컬럼명 통일을 위한 일괄 변경
    ├── missing_func.py                  # 결측치 제거 및 -99 보정
    ├── outlier_func.py                  # 점수 이상치 제거
    ├── imp_func.py                      # 중요도 합 100으로 정규화
    ├── age_gap_func.py                  # 나이 차이 및 방향성 파생 변수 생성
    ├── race_func.py                     # 인종 일치 여부 및 중요도 가중치 적용
    ├── rating_func.py                   # 항목별 조화평균으로 평가 점수 계산
    ├── sel_one_func.py                  # 모델링을 위한 원-핫 인코딩 및 컬럼 선택
    ├── pre_func.py                      # 전체 전처리 파이프라인 통합
    └── ...
🖇 주요 함수 동작
기존의 피처 엔지니어링 수행 로직 및 자세한 분석 과정은 앞서 언급한 레포지토리에서 확인할 수 있다.
col_rename.py
혼재된 컬럼명을 일관된 형태로 통일하기 위해 컬럼명을 정리한다.
| 수행 전 | 수행 후 |
|---|---|
pref_o_attractive | o_important_attractive |
attractive_partner | i_score_attractive |
intelligence_important | i_important_intelligence |
def col_rename(dating_df):
    new_cols = []

    for i in dating_df.columns:
        if i.startswith('pref_o'):
            i = i.replace('pref_o', 'o_important')
        ...  # 컬럼명 변경 로직
        new_cols.append(i)
    dating_df.columns = new_cols
    dating_df = dating_df.rename({'o_score_race': 'race_o', 'o_score_age': 'age_o'}, axis = 1)

    return dating_df
missing_func.py
주요 평가 항목 중 2개 이상 누락된 행 제거하고, 무응답 값은 -99로 명시 처리하여 결측치를 처리한다.
결측치는 "없어진 정보"일 수도 있지만 "응답자의 성향"일 수도 있다는 것을 고려하였다.
def missing_func(dating_df):
    drop_cols = []  # 제거할 컬럼

    for i in dating_df.columns:
        ...
    dating_df = dating_df.dropna(subset = drop_cols)
    dating_df = dating_df.fillna(-99)

    return dating_df
outlier_func.py
점수가 10이 넘는 이상치를 제거한다.
def outlier_func(dating_df):
    o_score = []
    i_score = []

    for i in dating_df.columns:
        if i.startswith('o_score'):
            o_score.append(i)
        ...  # i_score에 대해서도 적용

    for i in o_score:
        dating_df[i] = dating_df[i].apply(lambda x: 10  if x > 10  else x )

    ...  # i_score에 대해서도 적용

    return dating_df
imp_func.py
6가지 주요 평가 항목의 합이 100이 되지 않는 경우, 총합을 기준으로 비율을 재계산하여 정규화된 가중치를 반영한다.
def imp_func(dating_df):
    o_imp = []

    ...  # 6가지 주요 평가 항목 컬럼 선정

    dating_df[o_imp] = dating_df.apply(lambda x: (100 / x['o_imp_sum']) * x[o_imp], axis = 1)
    dating_df[i_imp] = dating_df.apply(lambda x: (100 / x['i_imp_sum']) * x[i_imp], axis = 1)
    dating_df.drop(['o_imp_sum','i_imp_sum'], axis=1, inplace = True)

    return dating_df
age_gap_func.py
두 성별 간의 나이차 및 방향성을 계산 후 결측치를 -99로 유지하여 파생 변수에도 반영한다.
def age_gap_func(dating_df):
    ...  # 결측치 -99 처리 로직

    # 나이차 계산 및 방향성 구분
    dating_df['age_gap'] = dating_df.apply(age_func, axis = 1)
    dating_df['age_gap_dir'] = dating_df['age_gap'].apply(lambda x: 'positive' if x > 0 else 'negative' if x < 0 else 'zero')
    dating_df['age_gap'] = abs(dating_df['age_gap'])
race_func.py
인종 일치 여부로 same_race 컬럼을 생성한다.
중요도에 따라 의미가 달라질 수 있기 때무에 인종이 다르면 -1로 처리한다.
def race_func(dating_df):
    dating_df['same_race'] = (dating_df['race'] == dating_df['race_o']).astype('int')
    dating_df['same_race'] = dating_df['same_race'].replace({0: -1})
    dating_df['same_race_point'] = dating_df['same_race'] * dating_df['importance_same_race']
    return dating_df
rating_func.py
두 점수가 서로 유사할수록 평균이 높아지는 조화 평균 공식을 활용한다.
평가 항목별로 중요도와 점수 간의 불균형을 보정하기 위해 중요도가 0인 경우 해당 항목은 -99 처리하여 평균에서 제외한다.
def rating_func(dating_df):

    o_important = []
    o_score = []
    i_important = []
    i_score = []

    for i in dating_df.columns:
        if i.startswith('o_important'):
            o_important.append(i)
        ...

    dating_df[o_important] = dating_df[o_important].replace({0: -99})
    dating_df[i_important] = dating_df[i_important].replace({0: -99})

    def rating(data, important, score):
        ...  # 중요도가 0인 경우 해당 항목은 -99 처리

    o_rating = [...]
    i_rating = [...]

    for i, j, k in zip(o_important, o_score, o_rating):
         dating_df[k] = dating_df.apply(lambda x: rating(x, i, j), axis = 1)

    for i, j, k in zip(i_important, i_score, i_rating):
         dating_df[k] = dating_df.apply(lambda x: rating(x, i, j), axis = 1)

    # 평균 계산: -99 제거 후 평균
    # 조화평균 계산: 2ab / (a+b)
    dating_df['o_rating_total'] = dating_df[o_rating].apply(lambda x: x[x > 0 ].mean(), axis = 1)
    dating_df['i_rating_total'] = dating_df[i_rating].apply(lambda x: x[x > 0 ].mean(), axis = 1)
    dating_df['rating_mean'] = 2 * dating_df['o_rating_total'] * dating_df['i_rating_total'] / (dating_df['o_rating_total'] + dating_df['i_rating_total'])

    return dating_df
sel_one_func.py
import pandas as pd
def sel_one_func(dating_df):

    select_col = ['gender',
     'age',
     'race',
      ...]

    # 모델링을 위한 최종 컬럼 선정
    final_df = dating_df[select_col]
    # 범주형 변수에 대한 원-핫 인코딩 수행
    final_df = pd.get_dummies(final_df)

    return final_df
이제 이 함수들이 제대로 동작하는지 'code_function_dating.ipynb' 노트북에서 실행해 보자.
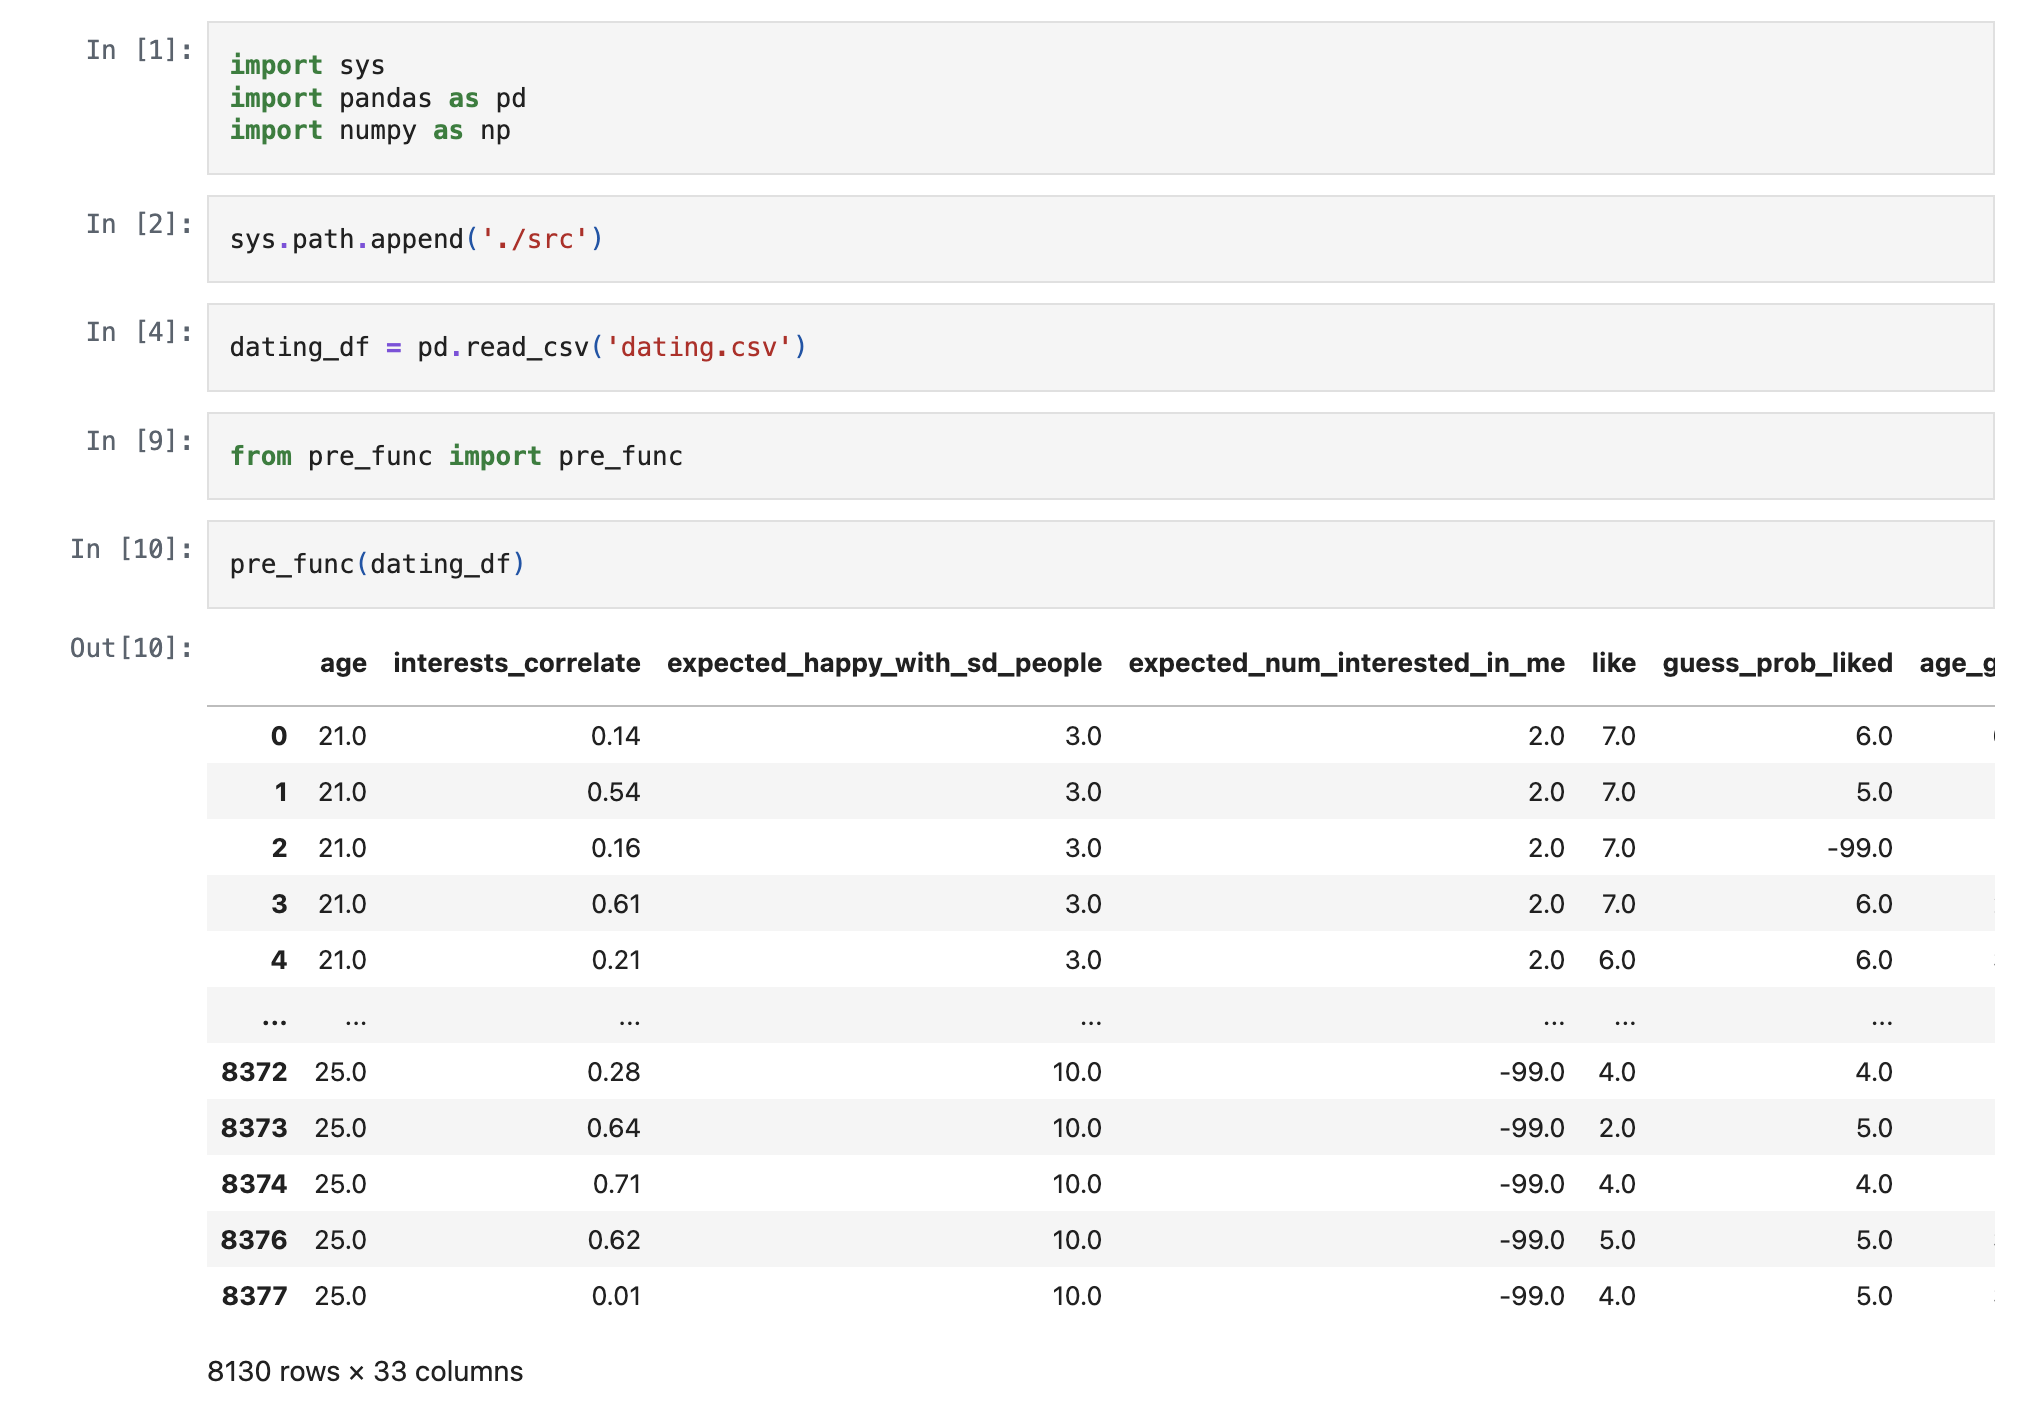
모듈화한 함수를 사용하여 피처 엔지니어링을 포함한 전처리 과정이 한 번에 수행된 결과를 확인할 수 있다.
이처럼 모듈화와 패키징을 통해 구조화된 전처리 흐름을 가져가고 재현성을 검증함으로써, 보다 효율적인 데이터 분석 환경을 구축할 수 있게 된다.
데이터 분석에서 전처리는 반복되는 작업이 많다.
새로운 데이터가 들어올 때마다
컬럼명을 일일이 바꾸고, 결측치를 확인해서 처리하고, 파생변수를 만들고, 조건을 나눠 평균을 계산하는 과정을 매번 수행하는 것은 비효율적이다.
이 글에서는 모든 전처리 과정을 모듈화하고 함수로 구조화해 재사용 가능하고 효율적인 전처리 파이프라인을 구축해 보았다.
전처리 과정을 함수화하고 모듈화하여 실제로 수행한 프로젝트에 적용해 재구현해 보면서
유사한 문제에 훨씬 빠르고 안정적인 대응 및 유지보수를 할 수 있고, 협업 시에도 같은 기준으로 데이터를 다룰 수 있는 구조를 만들 수 있는 경험이 되었다 :)
