1. Attention & Transformer
지난 글에서는 Seq2Seq에 대해서 다뤘다.
인코더는 입력 시퀀스를 받아서 입력 시퀀스를 압축한 벡터로(Context Vector)로 변환하고, 디코더는 이 벡터를 받아 출력 시퀀스를 생성한다.
그런데 이에는 문제가 있다.
만약 이게 너무 길어지게되면, 한정된 길이의 context vector에 모든 입력 시퀀스의 정보를 담을수가 없게된다. 즉 정보의 손실이 일어나고, RNN 특성상 나타나는 기울기 소실 문제가 나타나면서 문장이 길어지면 성능이 떨어지게 된다.
1.1. Attention
그래서 나온게 Attention이다.
이는 입력 시퀀스의 어떤 부분이 중요한지를 "주목"하게 만드는 알고리즘이다.
Attention을 함수로 표현하면 다음과 같다.
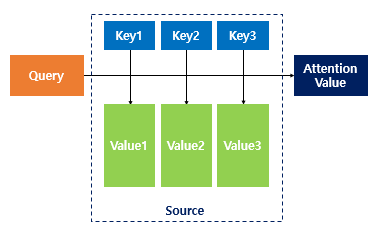
출처: https://wikidocs.net/22893
Attention(Q, K, V) = Attention Value
- 각각 Query, Keys, Values를 말하며
Query: 지금 내가 주목하는 것
Key: 내가 주목할 수 있는 후보들
Value: 각 Key에 매핑될 실제 정보 - 즉, Q와 각 K의 유사도를 구하고
-> 유사도(가중치)를 key와 매핑된 각 Value에 곱해서
-> 가중합을 반환. 즉 유사도가 반영된 Value를 모두 더해서 리턴
-> 그를 받는게 Attention Value
Seq2Seq + Attention
그리고 Seq2Seq + Attention 모델에서의 Q, K, V는
- Query: 디코더의 현재 시점 hidden state
즉 지금 어떤 정보를 주목할지 결정하는 주체- Keys: 인코더의 모든 시점 hidden state
어디를 주목할 수 있는가- Values: 인코더의 모든 시점 hidden state
그 주목할 곳이 담고 있는 정보단 Keys와 Values는 동일하게 인코더 hidden states지만, 사용 목적이 다르다.
Keys는 유사도 측정 대상, Values는 실제 정보
정리하면 Attention을 통해서 디코더는 인코더의 전체 hidden state를 한 번에 받아들여서 지금 필요한 정보에만 집중해서 문장을 생성할 수 있게 된다.
1.2. Dot-Product Attention
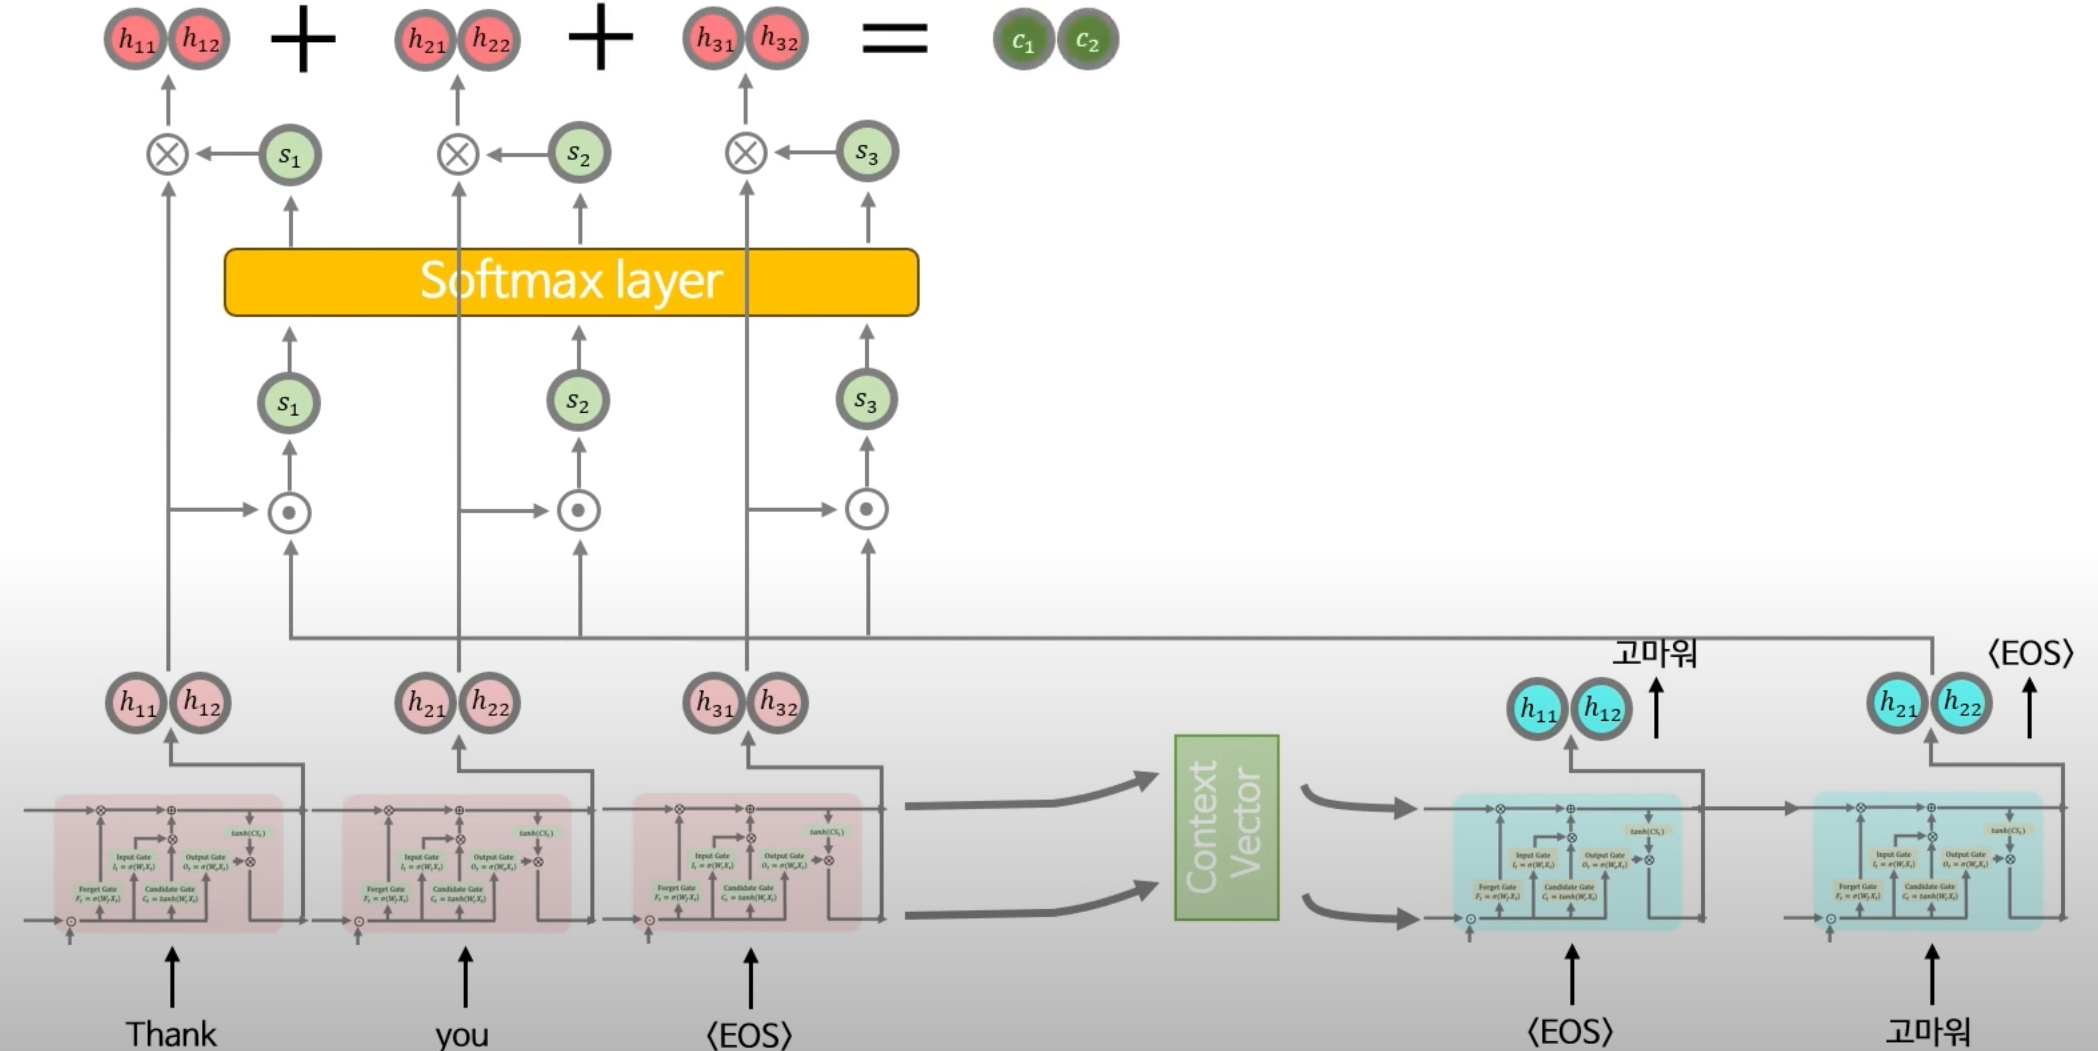
많은 종류의 Attention 중, 가장 간단한 방법인 Dot-Product Attention이 있다.
출처: https://youtu.be/cu8ysaaNAh0?si=85LiMNGugTlG4ChV
-
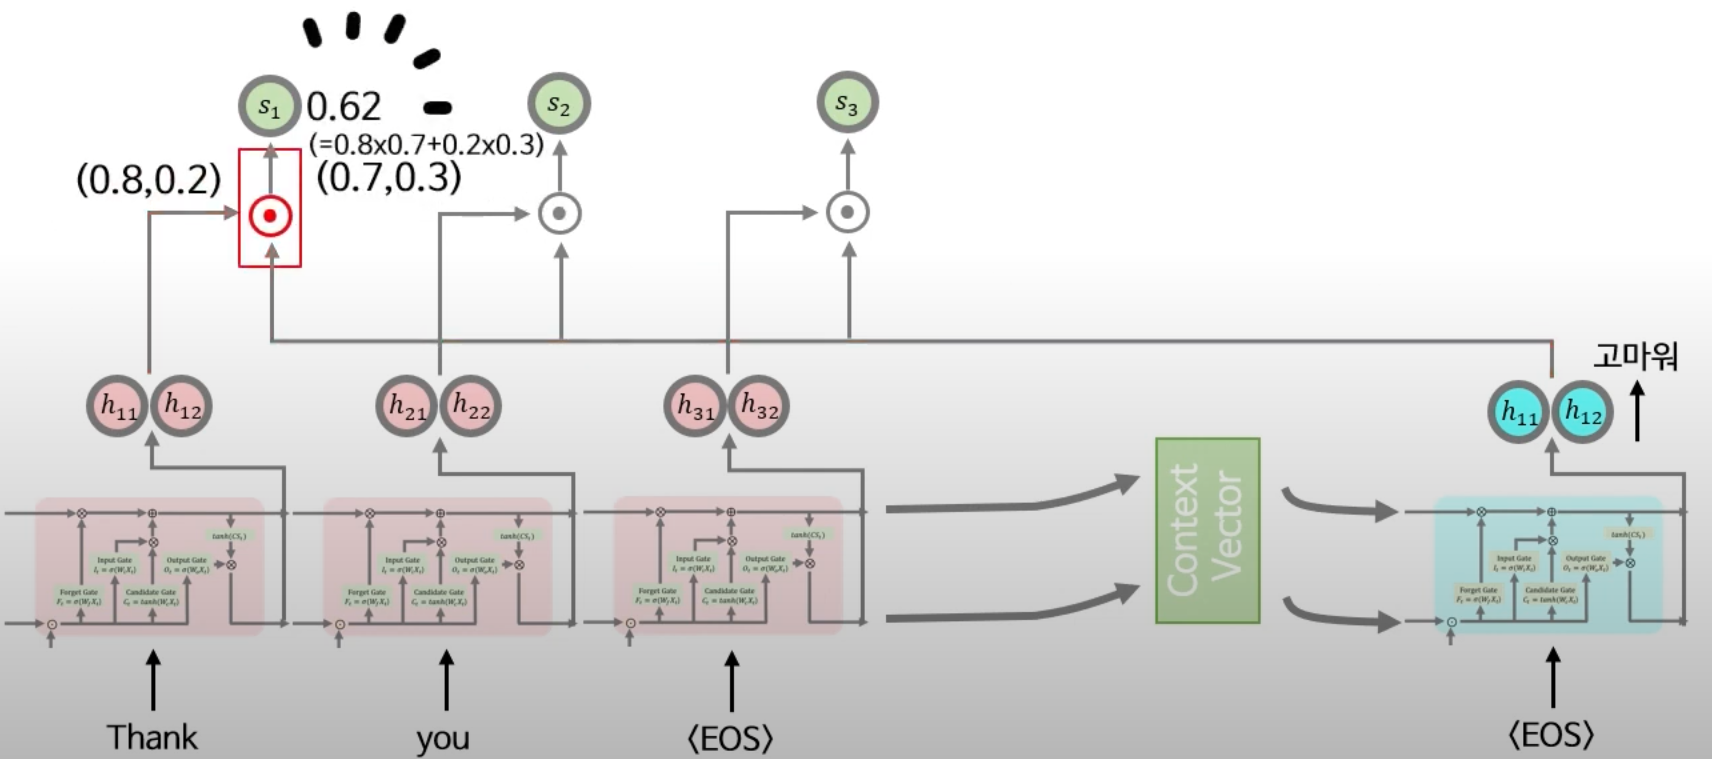
입력 시퀀스가 Thank you EOS 로 들어오고, 각 입력 단어에 대한 hs를 저장하는데, 이들 각각이 , , ... 와 같이 크기가 2인 벡터다.
-
Seq2Seq와 같이 Context Vector를 거치고 Decoder에 넣어서 디코더의 hs와 출력값을 구한다.
-
여기서 현재 디코더의 은닉상태와 가장 관련이 있는 것으로 추정되는 입력과의 관계성을 두 벡터간의 유사성을 기준으로 찾는다.
-
그리고 벡터간의 유사성을 계산하는 Attention 점수 계산법 중 하나가 Dot-Product다.
-
출력의 hs와 각 입력간의 , , (Attention Score)를 dot product를 사용해서 계산하여 구한다.
-
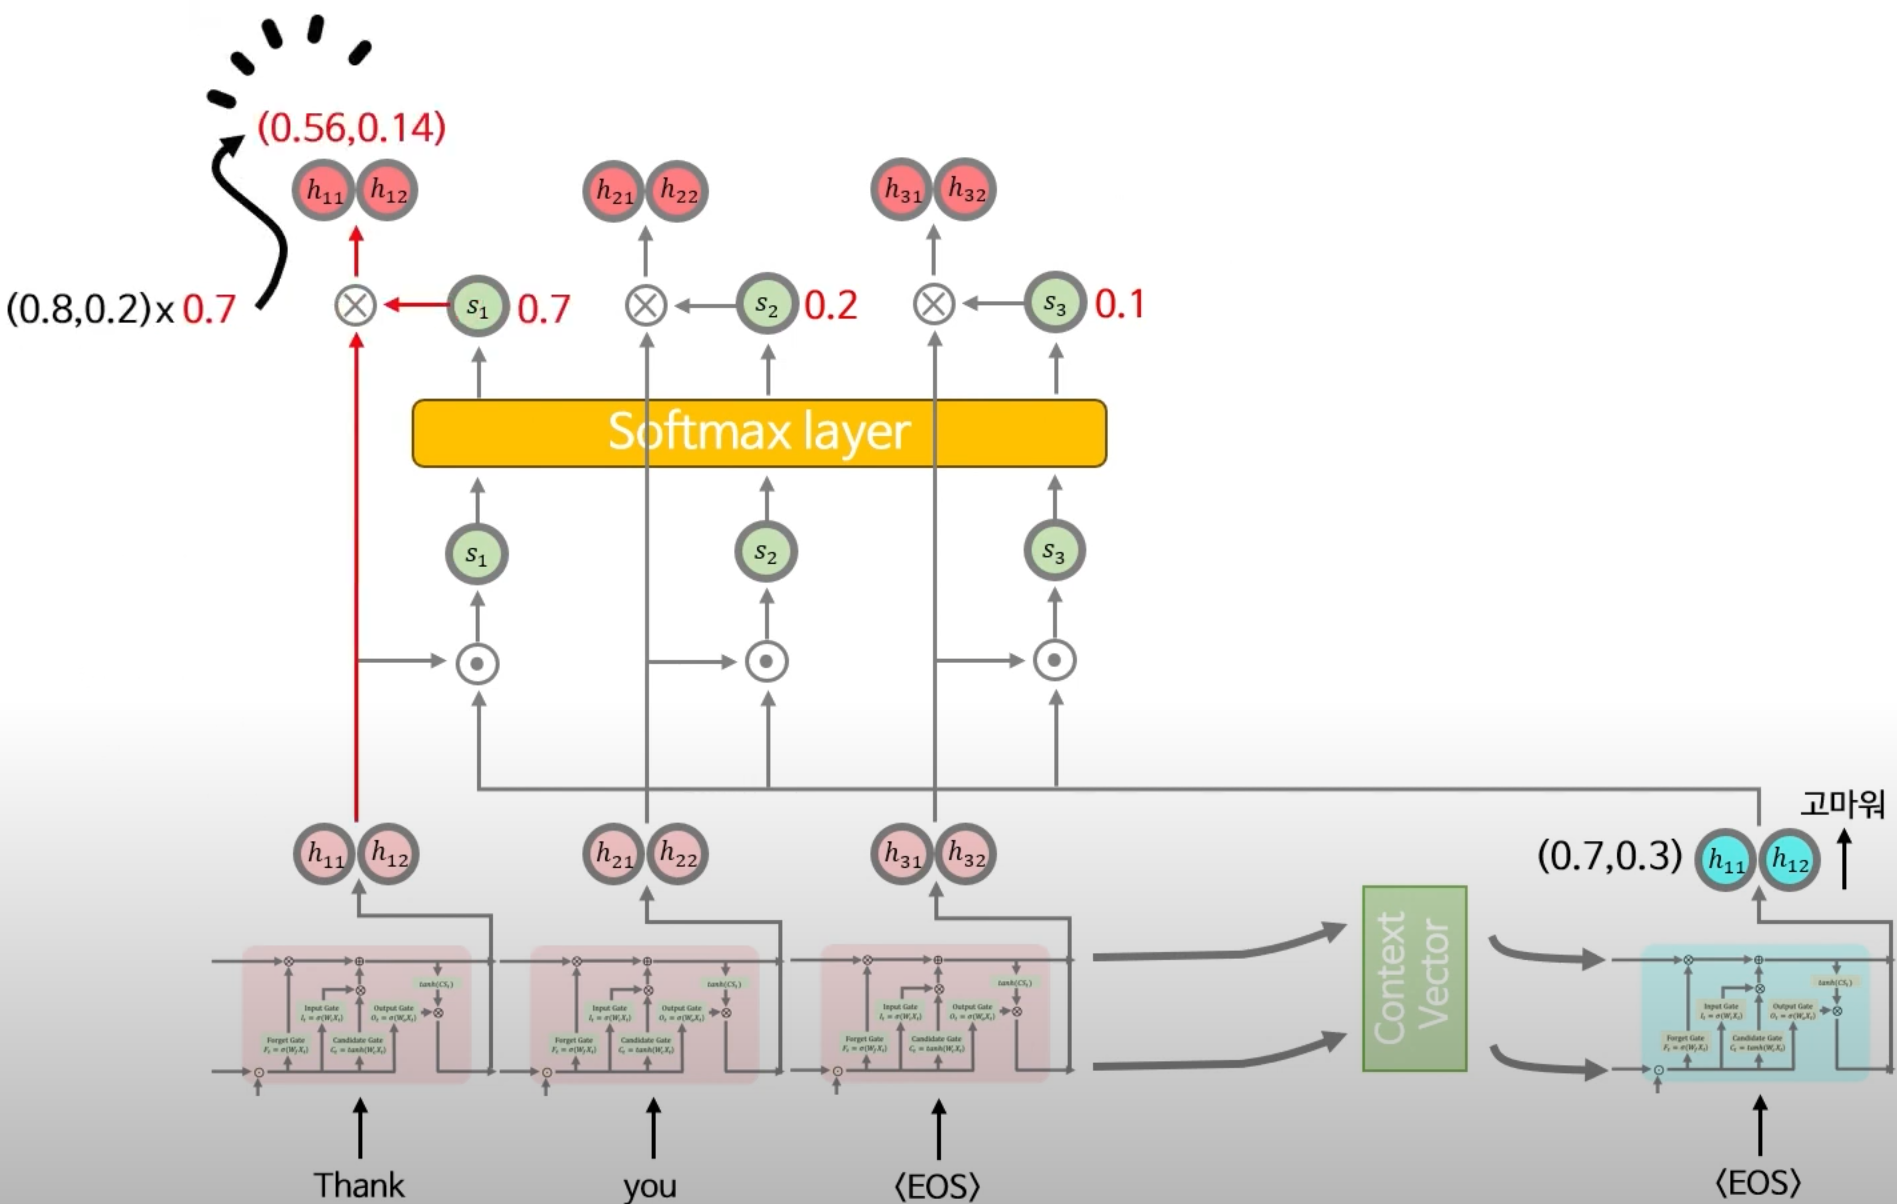
각 Attention Score 들의 Softmax 값을 구한다.
-
Softmax를 거친 Attension Score와 각 입력 시퀀스의 hs들을 곱한다.
-
Attention Score가 반영된 입력 시퀀스의 hs들을 다 더해서 새로운 Context Vector 생성한다.
-
그렇다면 기존의 Context에 비해 Attension Score가 반영된 새로운 hs기 때문에 다음번 디코더 LSTM의 hs로 입력하고, 차례로 필요한 값들을 입력하면 다음 번 hs를 구할 수 있고, 똑같이 반복해서 그 다음 Attention Context Vector를 구할 수 있다.
1.3. Transformer
이렇게 Attention에 대한 개념을 잡고 나서 Transformer로 넘어온다.
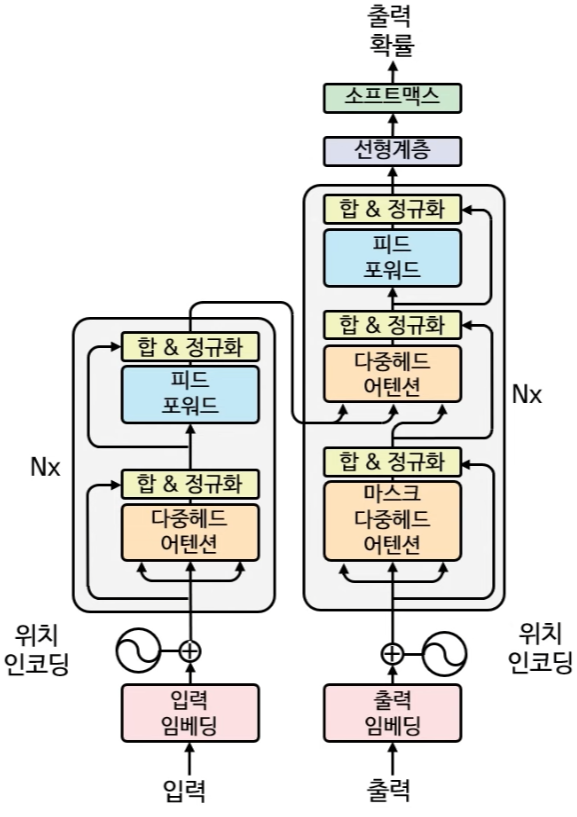
트랜스 포머의 구조는 위와 같은데, 잘 보면 내부적으로는 반복되는 부분이 많다.
여기서 중요한 부분은 위치 인코딩이다.
인코더와 디코더 부분에 위치 인코딩이 취가된다.
-
우선 트랜스 포머를 학습시키기 위해서 데이터셋을 만들고
Q: "how are you", "i am fine"
A: "i am fine", "how about yourself" -
만들었다면 해당 데이터 셋에서 모든 단어들을 추출해서 단어장(vocab)을 만들고 SOS, EOS, PAD도 포함해서 각 단어(토큰)에 인덱스를 달아준다.
<SOS>: 0
<EOS>: 1
<PAD>: 2
am: 3
fine: 4
how: 5
i: 6
about: 7
are: 8
you: 9
yourself: 10
...-
그럼 이제 입출력을 학습시키는 경우에
입력: "How are you?" -> 5, 8, 9
출력: "I am fine" -> 0, 6, 3
이와 같이 변환되어 트랜스포머 모델에 들어간다. -
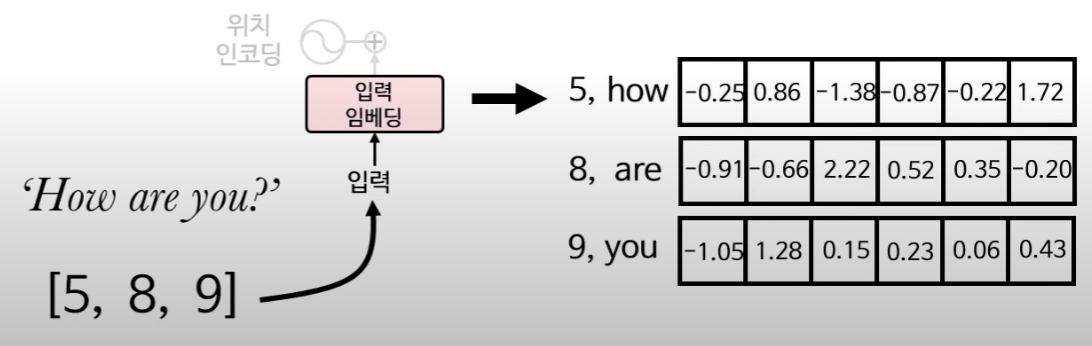
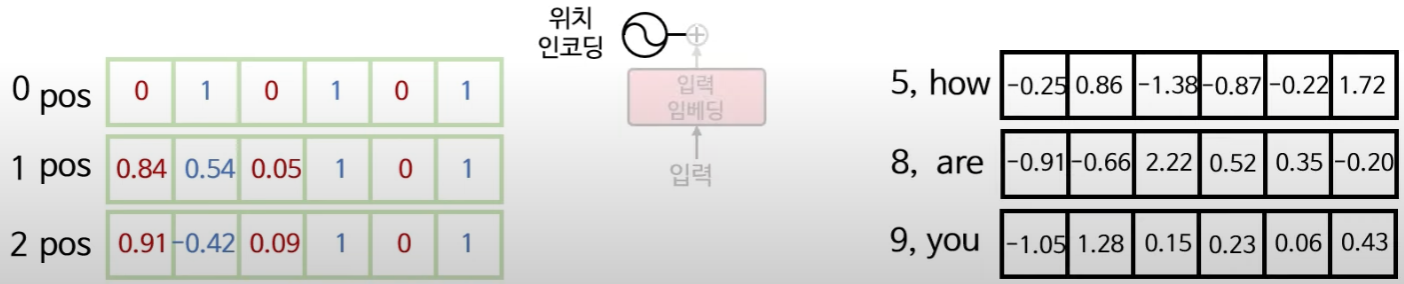
이제 입력 문인 "How are you"는 임베딩을 거쳐서 각 단어의 임베딩 벡터를 출력한다.
이때 임베딩 레이어는 길이가 앞선 0~10의 인덱스가 달린 총 11개의 단어들을 압축해서 길이가 6인 밀집벡터로 바꿔주는 레이어다.
-
이제 여기서 위치 인코딩이 들어간다.
문장 내의 단어의 위치를 인코딩하는데, 이 위치란 단어의 어순을 생각하면 된다.
예시로 "The dog bites the man"과 "The man bites the dog"는 완전히 다른 뜻인데, 이렇게 "dog"라는 단어 임베딩에 위치 인코딩을 다르게 달면 보다 더 정확한 입력 문장의 이미를 전달할 수 있게 된다.
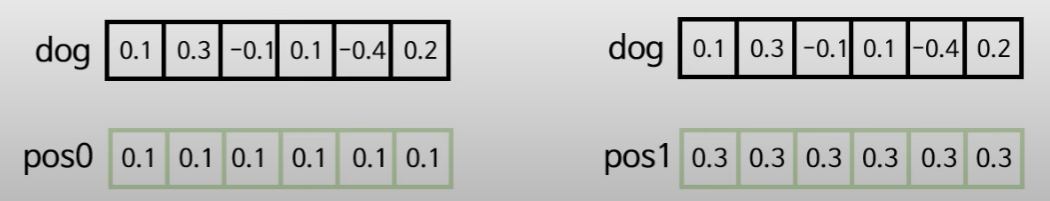
-
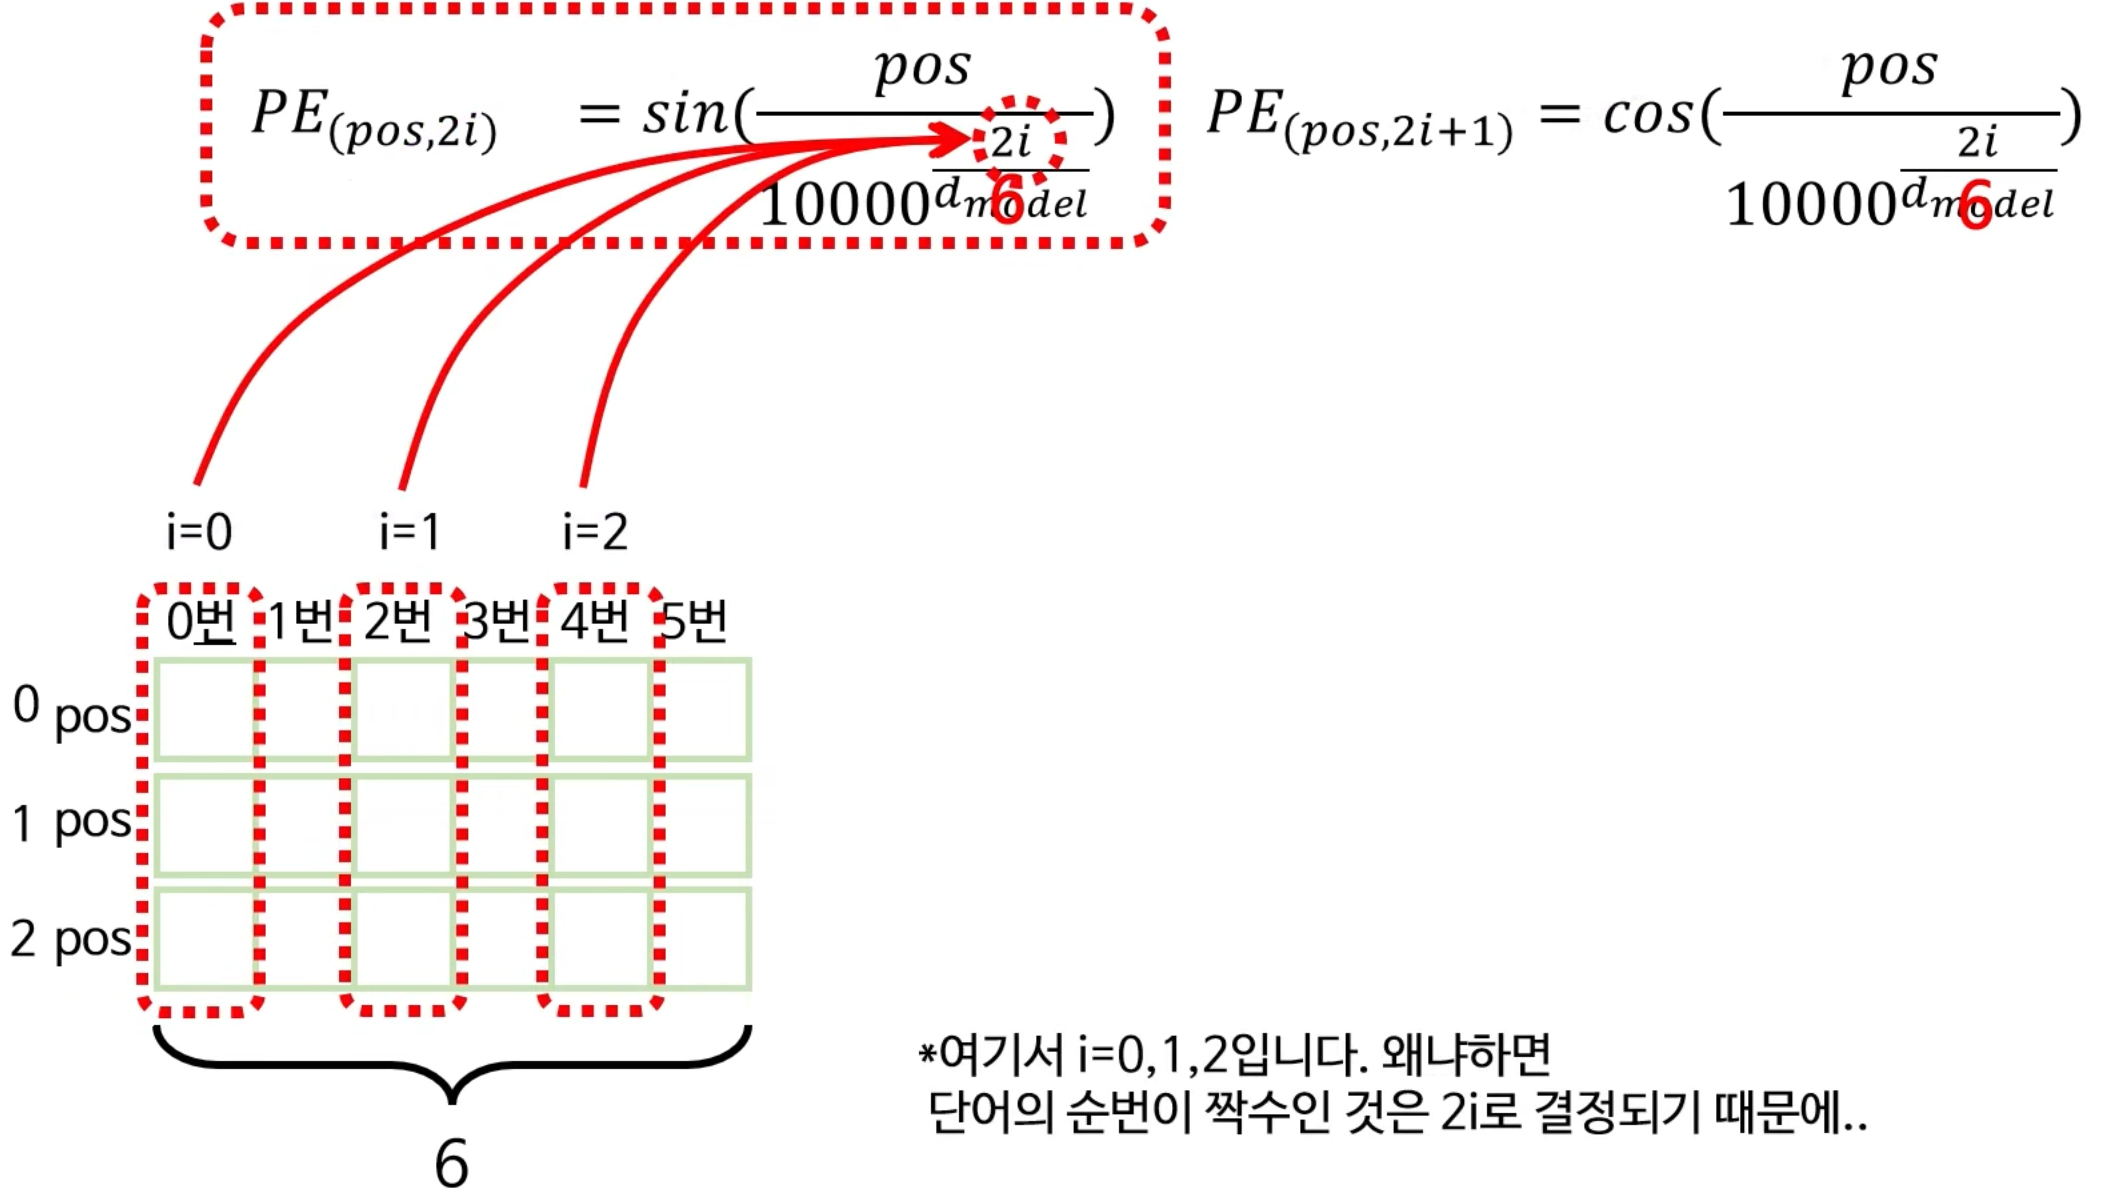
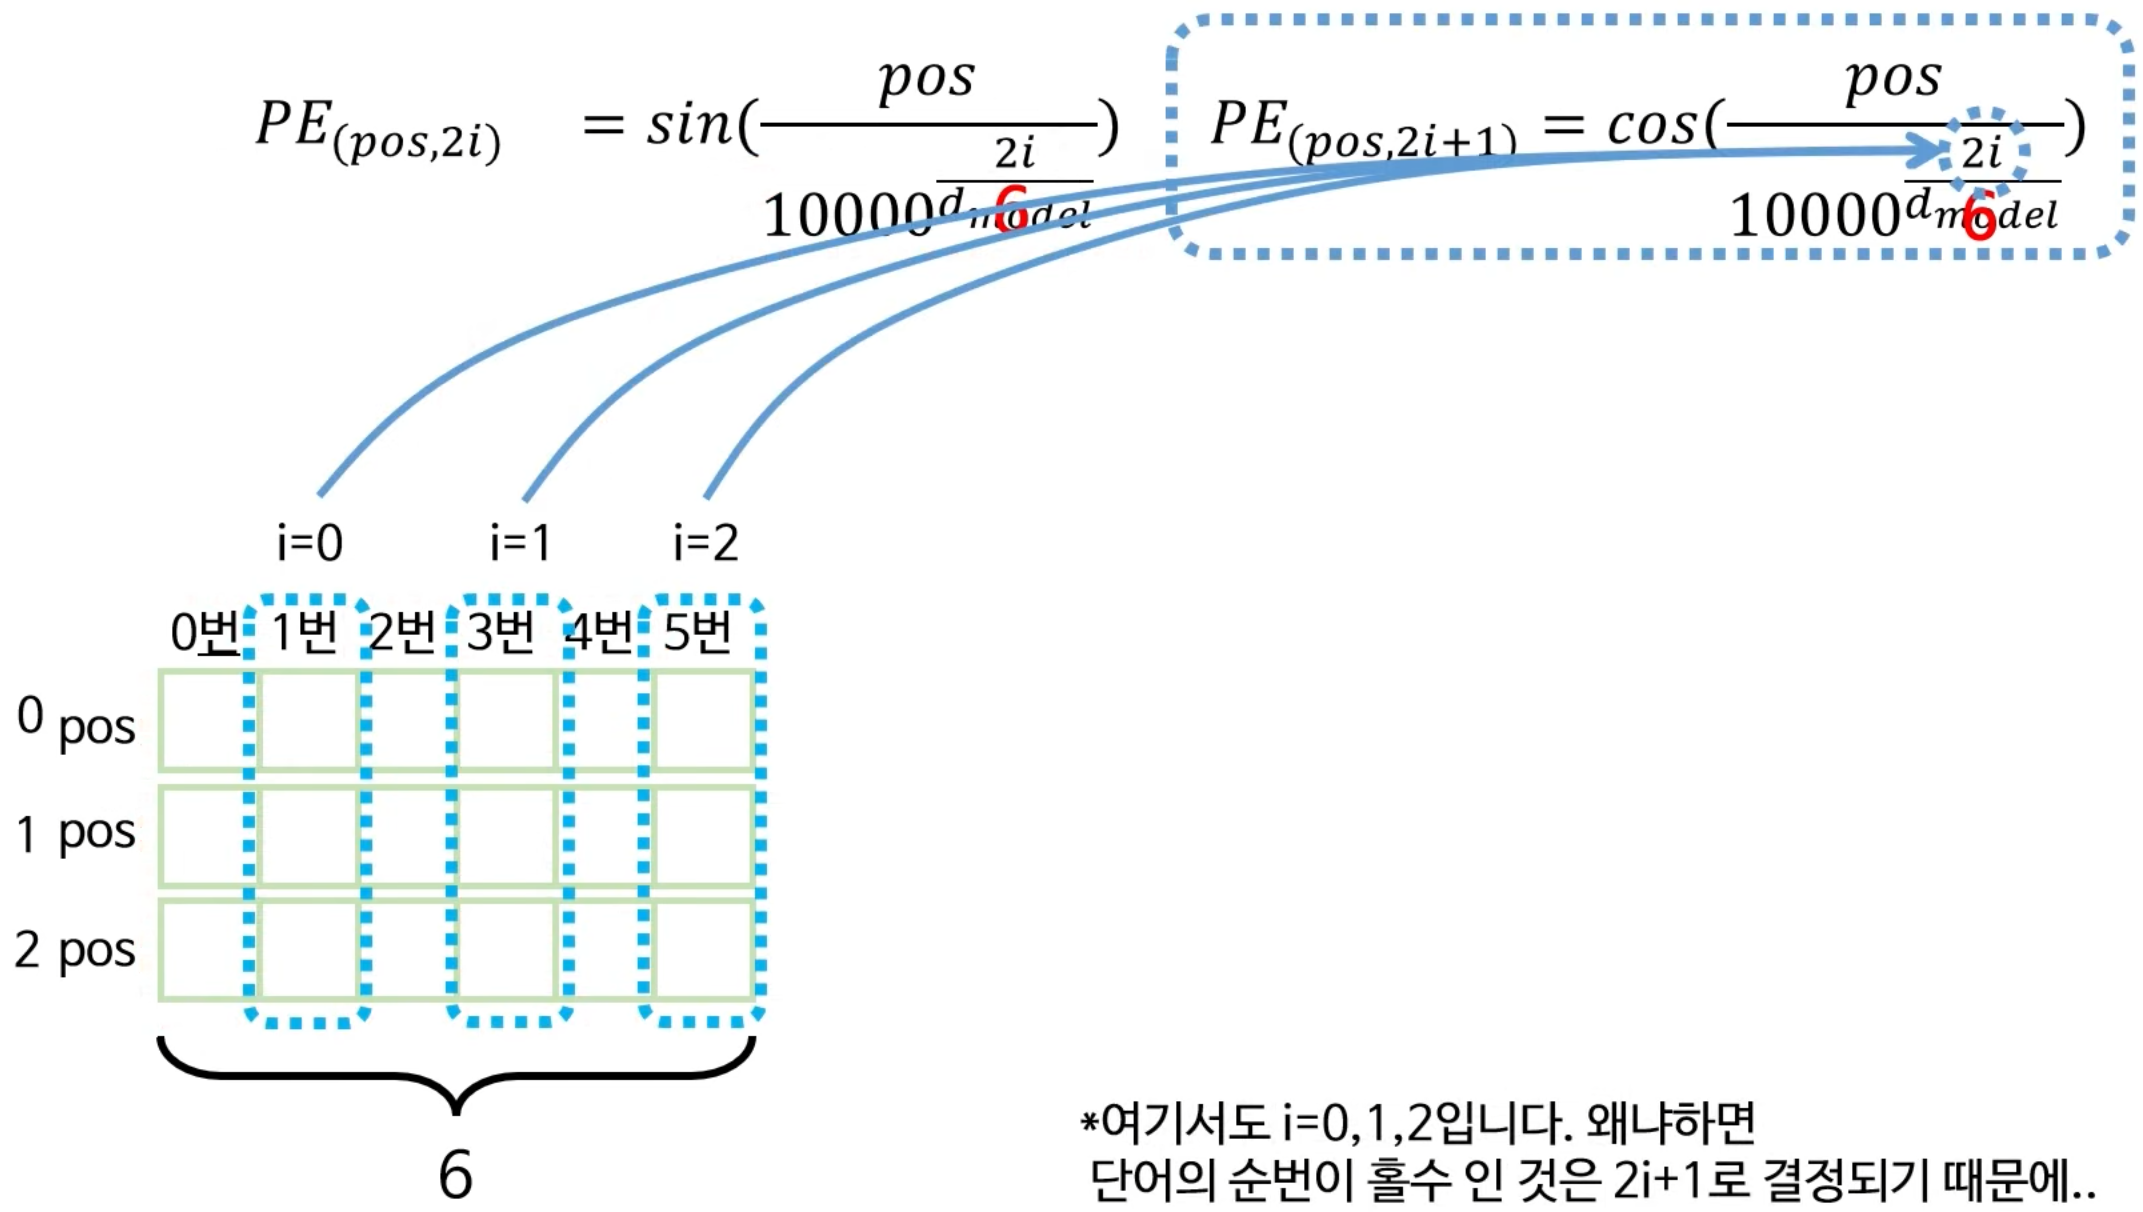
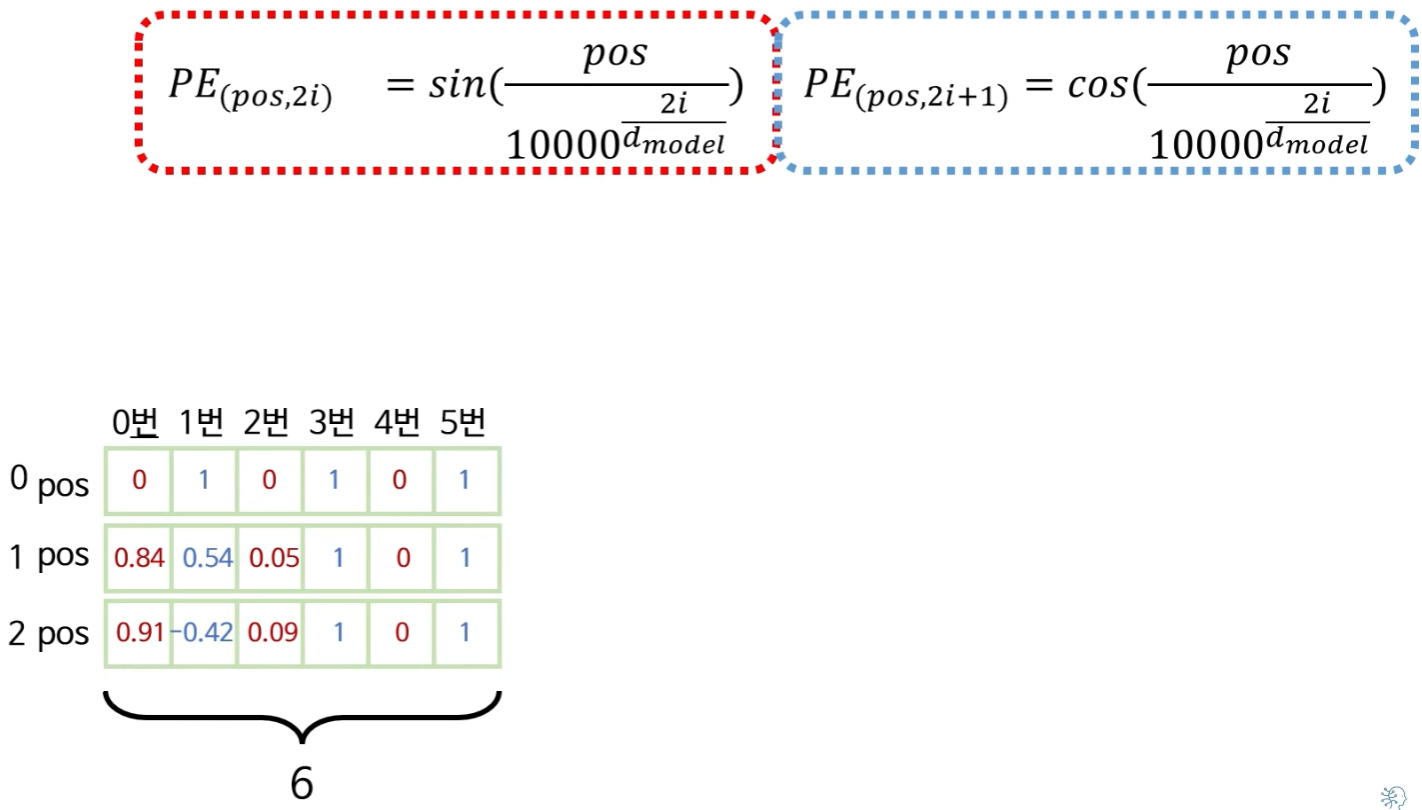
트랜스포머의 위치 인코딩의 공식은 다음과 같다.
6.1. 그리고 예시에서는 의 길이는 단어 임베딩의 길이가 6이었던 것과 같이 6이며, pos(position)에 0, 1, 2가 순서대로 들어간다.
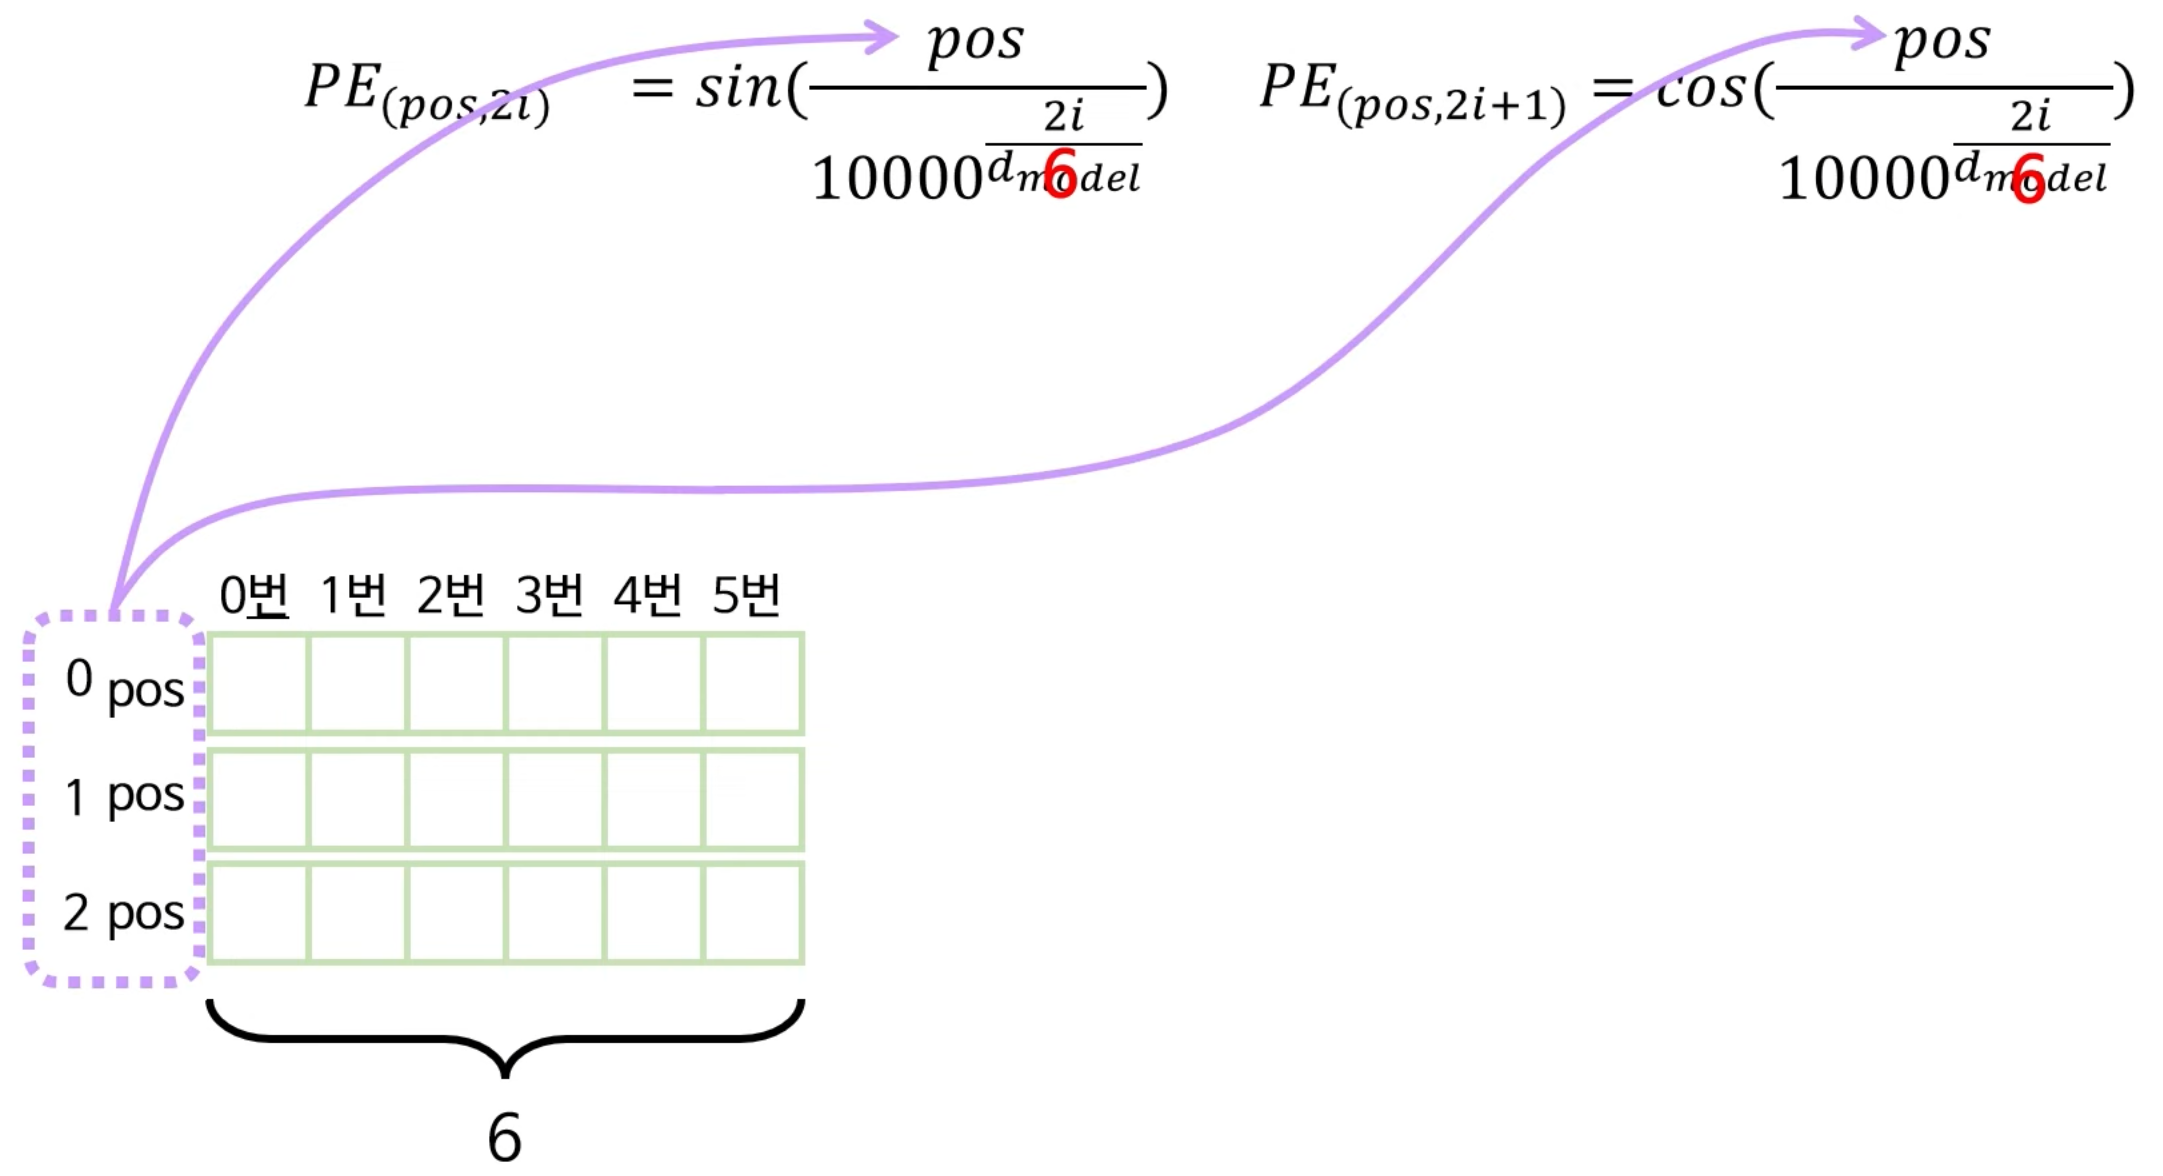
6.2. 이제 짝수번째 단어에 해당하는 i는 공식에 들어가고
6.3. 홀수번째 단어에 해당하는 i는 공식에 들어간다.
6.4. 그렇게하여 위치 인코딩 값을 계산할 수 있다.
-
이제 계산된 위치 임베딩과 입력 임베딩을 더해서 입력+위치 임베딩 벡터를 만든다.
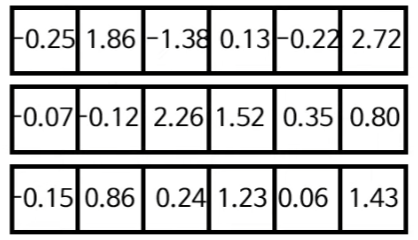
- 생성한 각 입력+위치 임베딩 벡터를 다중헤드 어텐션에 넣는다.
하지만 앞서 배운 Seq2Seq+Attention과 조금 다른 점이 있는데..
- Seq2Seq+Attention: 입력-출력 시퀀스간의 주목할 단어를 찾음
- Transformer Attention: "입력 문장 안"에서의 단어 간의 관계성 파악
그래서 이 Transformer Attention 매커니즘은 이렇게 "입력 문장 안"에서 "자체 단어들 간의 관계성 파악"한다고 해서 "self-attention"이라고도 부른다.
-
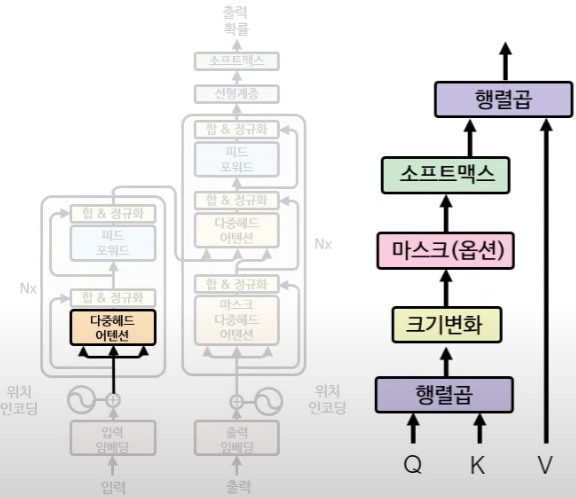
self-attention 을 수행하기 위한 다중헤드 어텐션의 구조는 다음과 같다.
-
앞서 구했던 입력+위치 임베딩 벡터들(행렬)을 세 개로 복사한다.
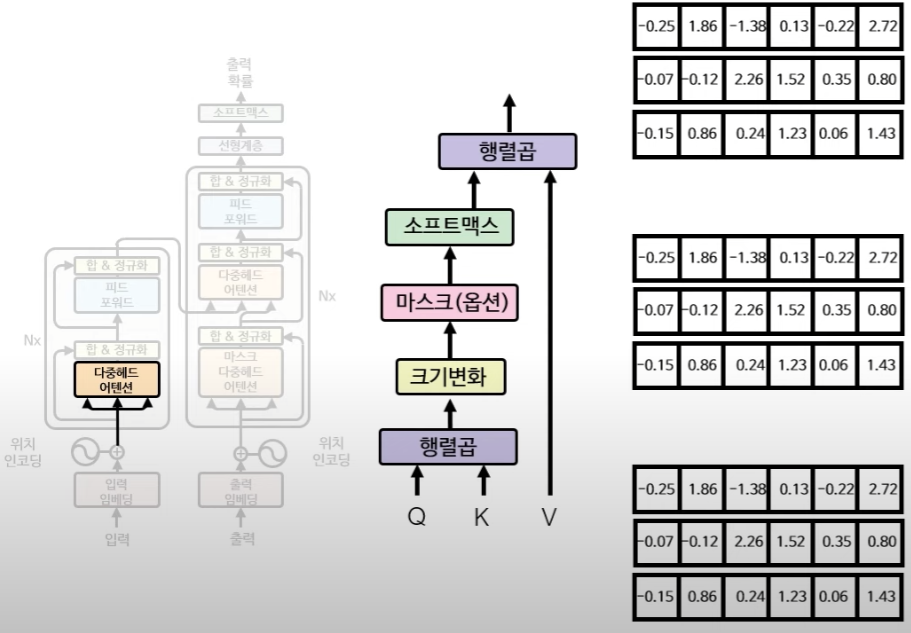
-
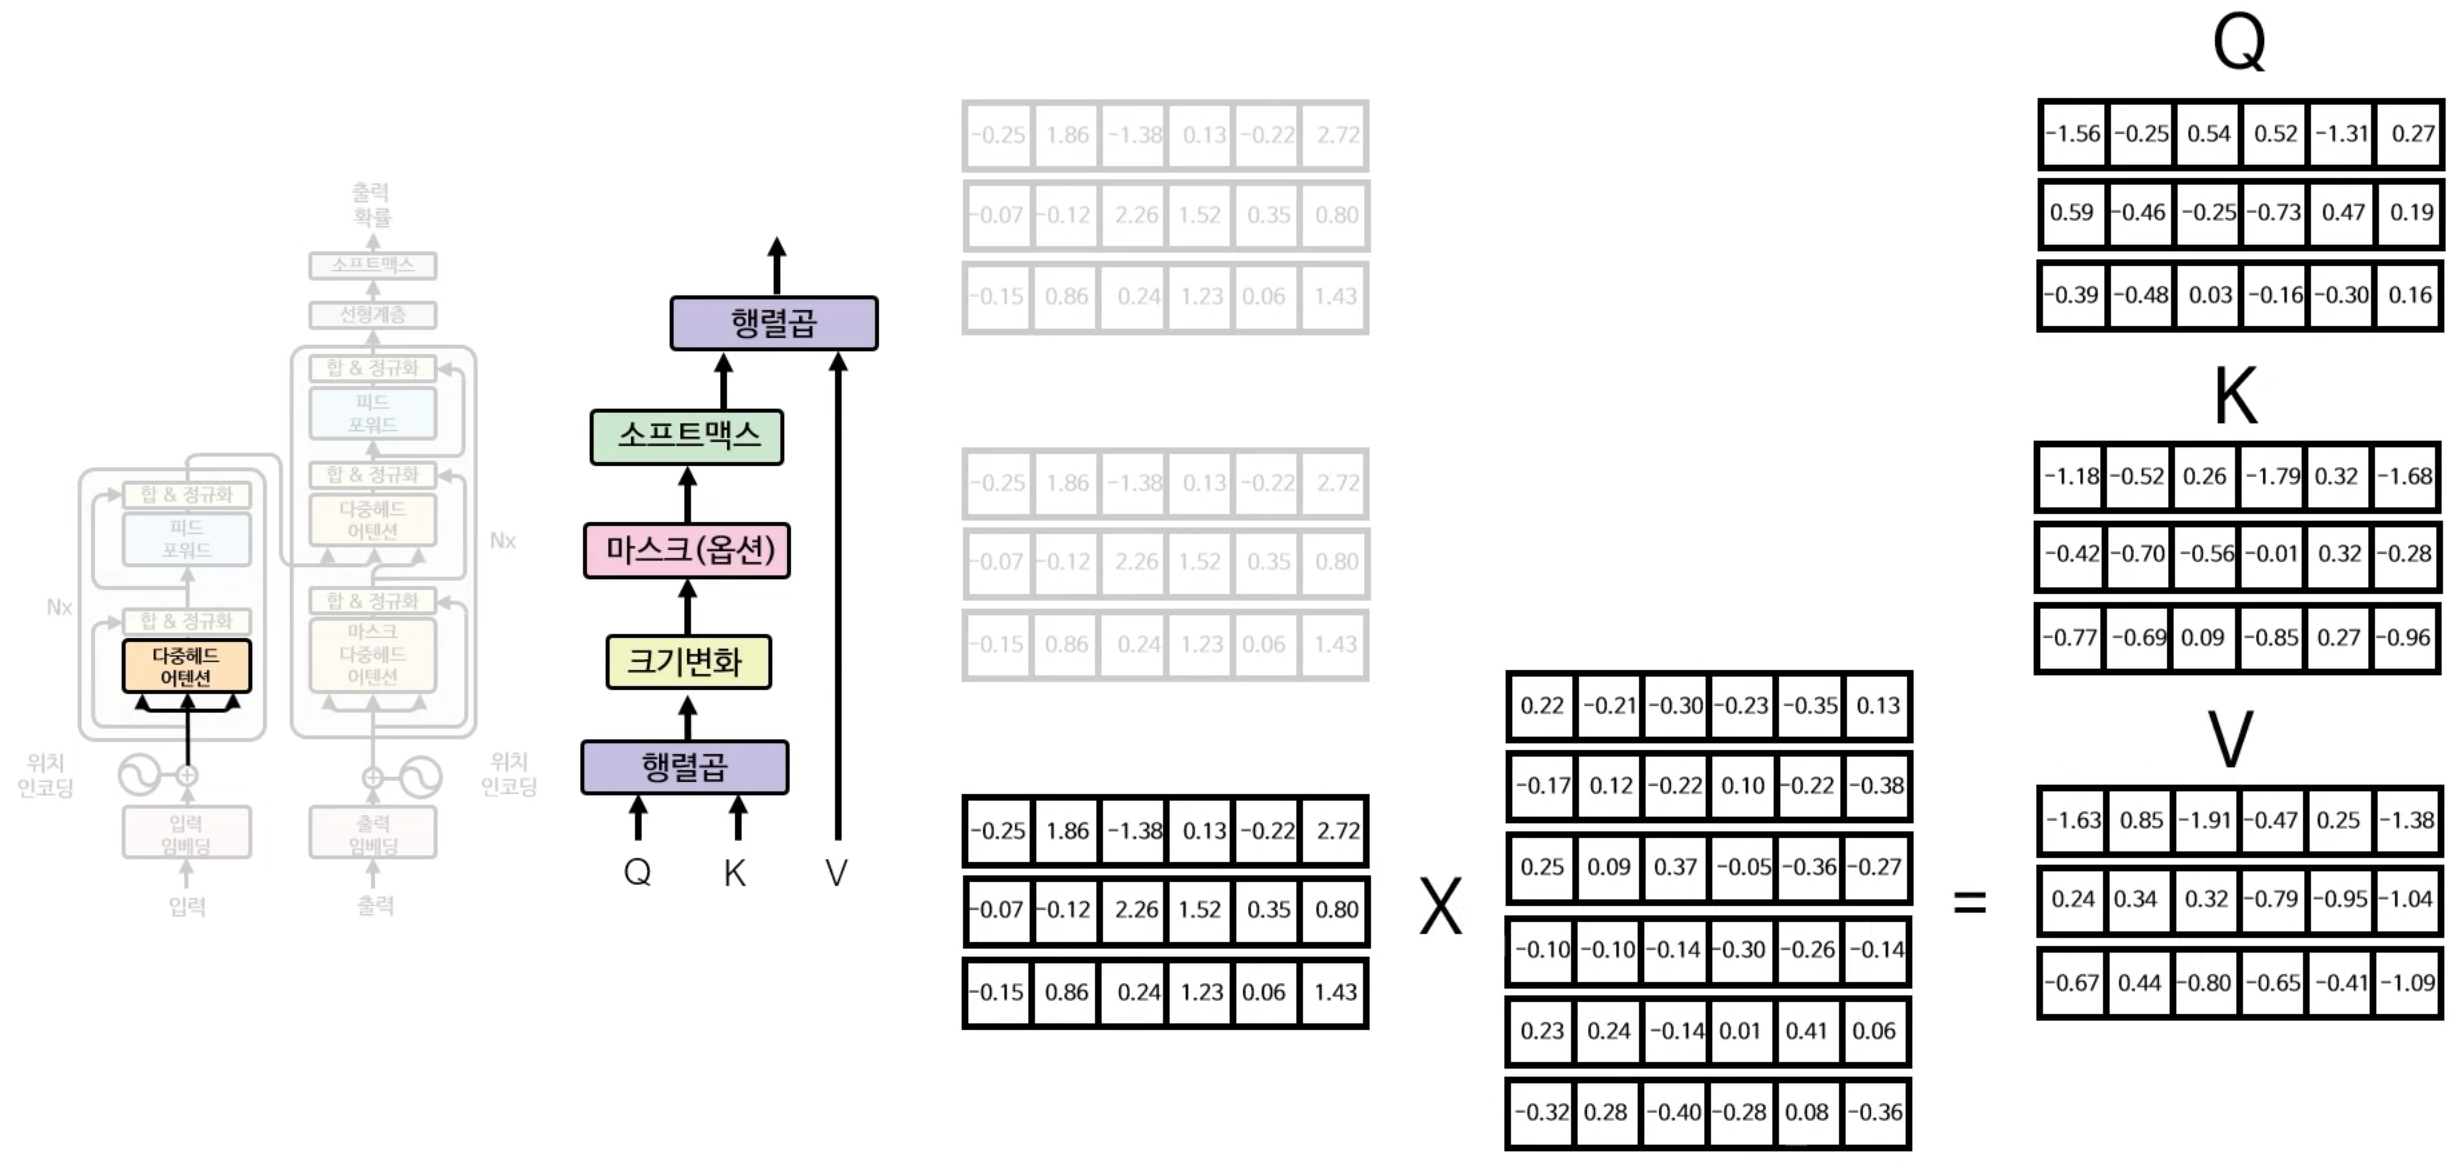
각 Q, K, V 행렬은 각각 임의의 6x6 행렬(일종의 가중치처럼, 처음에는 랜덤하게 주어진다)을 생성하고 행렬 곱을 거쳐서 구한다.
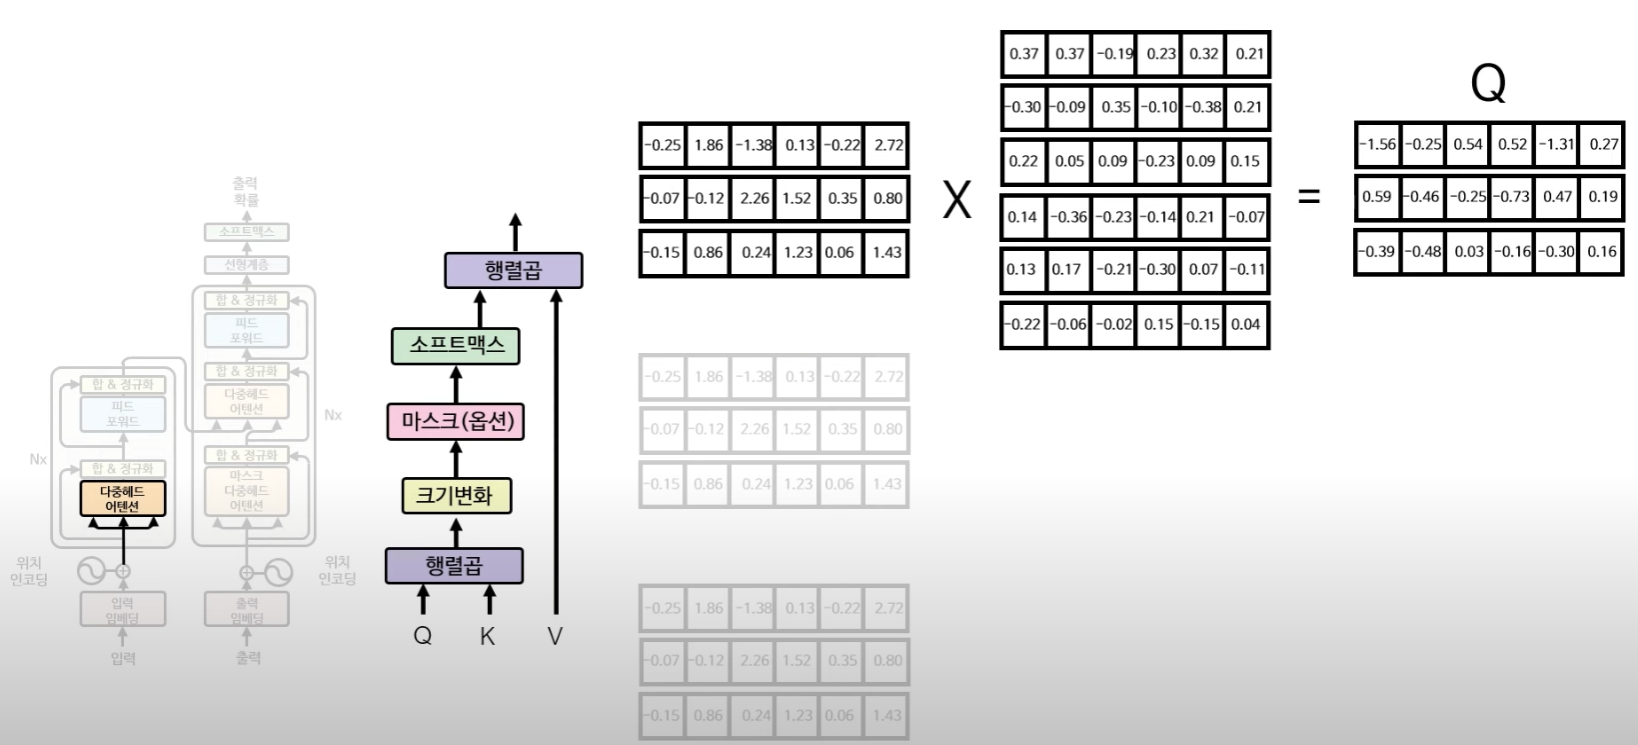
이후 K도 동일하게 생성하고, V도 동일하게 생성한 후 각각 곱한다.
-
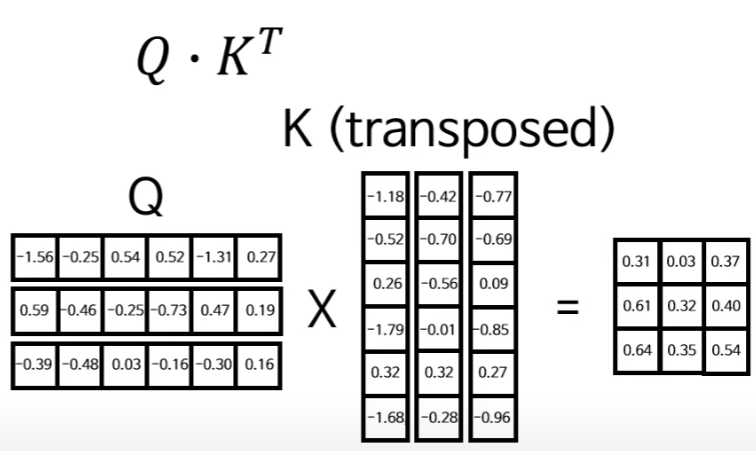
이렇게 구한 Q, K, V 행렬들이 다중헤드 어텐션 레이어에 들어가서 먼저 Q와 K의 행렬곱을 진행한다. (이때 V는 계속 빠져있다.)
-
다음은 크기 변화 Scaling인데, 행렬에 을 나눠준다.
(이때 의 길이가 6이여서 을 나눈다고 한다.)
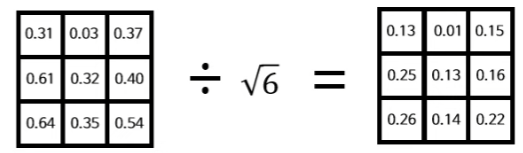
-
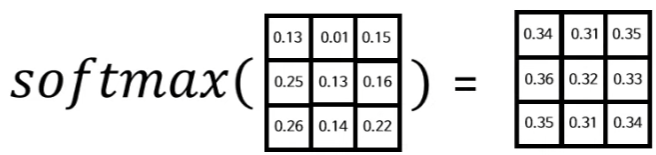
이제 마스크(옵션) 차례인데, 인코더에서는 사용하지 않는다! 따라서 스킵하고, 소프트맥스 레이어를 거쳐 행렬의 값을 확률로 바꿔준다.
-
이렇게 나온 3x3 행렬이 self-attention값을 나타내는 행렬이다.
보면 상관행렬과 비슷하다. 이제 지금은 값들이 다 비슷한데, 학습이 되지 않았기 때문이다.
따라서 진행할수록 각각 관련이 높은 단어쌍은 높은 값을 갖게 되고, 관련이 낮은 쌓은 낮은 값을 갖도록 학습이 되어간다.
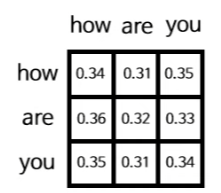
이 self-attention은 입력 문장의 단어를 병렬적으로 한번에 처리하기에 속도가 빠르고, 긴 문장이여도 각 단어들 간의 관계를 차별없이 주의를 계산할 수 있기 때문에 이가 ChatGPT와 같은 LLM으로 발전될 수 있었다. -
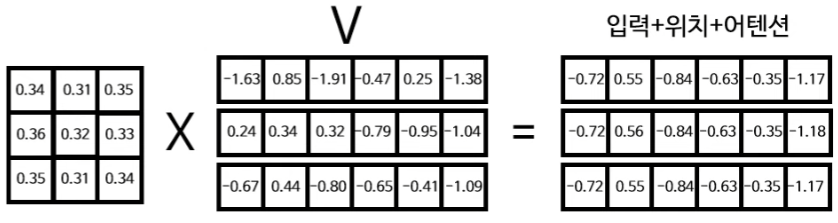
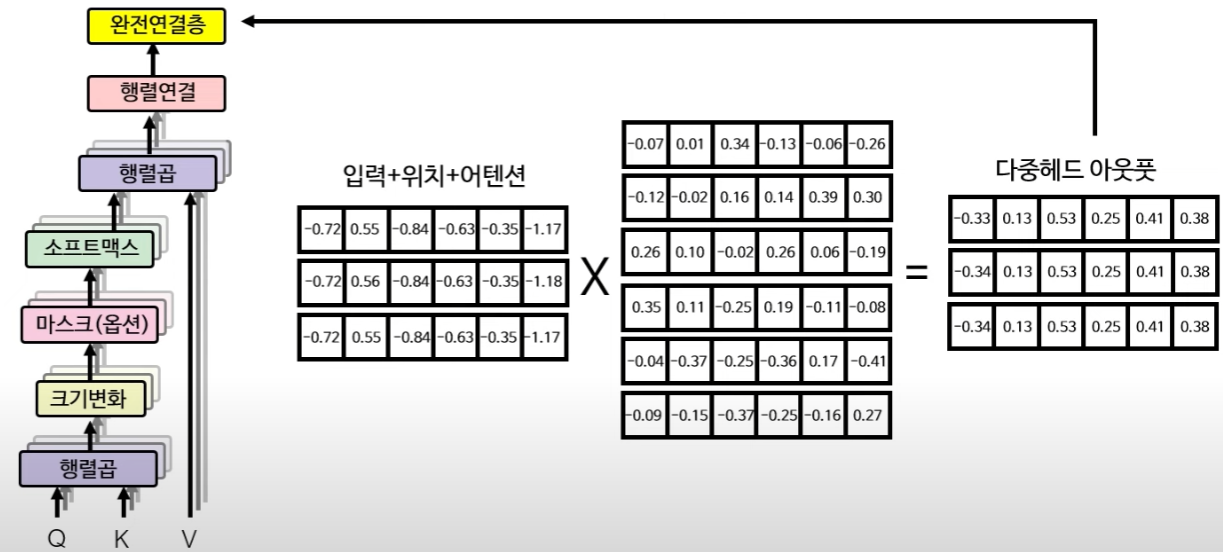
이제 15에서 나온 값과 V행렬과의 행렬곱을 통하여 self-attention이 반영된 입력+위치+어텐션 임베딩 행렬을 만든다.
-
지금은 다중헤드 어텐션 레이어가 하나의 헤드만 있을 경우였지만 실제로는 멀티헤드로 진행한다.
만약 2개일 경우에는 Q, K, V 단계에서부터 헤드의 숫자대로 나누어서 self-attention을 각각 계산해준 다음 행렬들을 연결(concat)하고
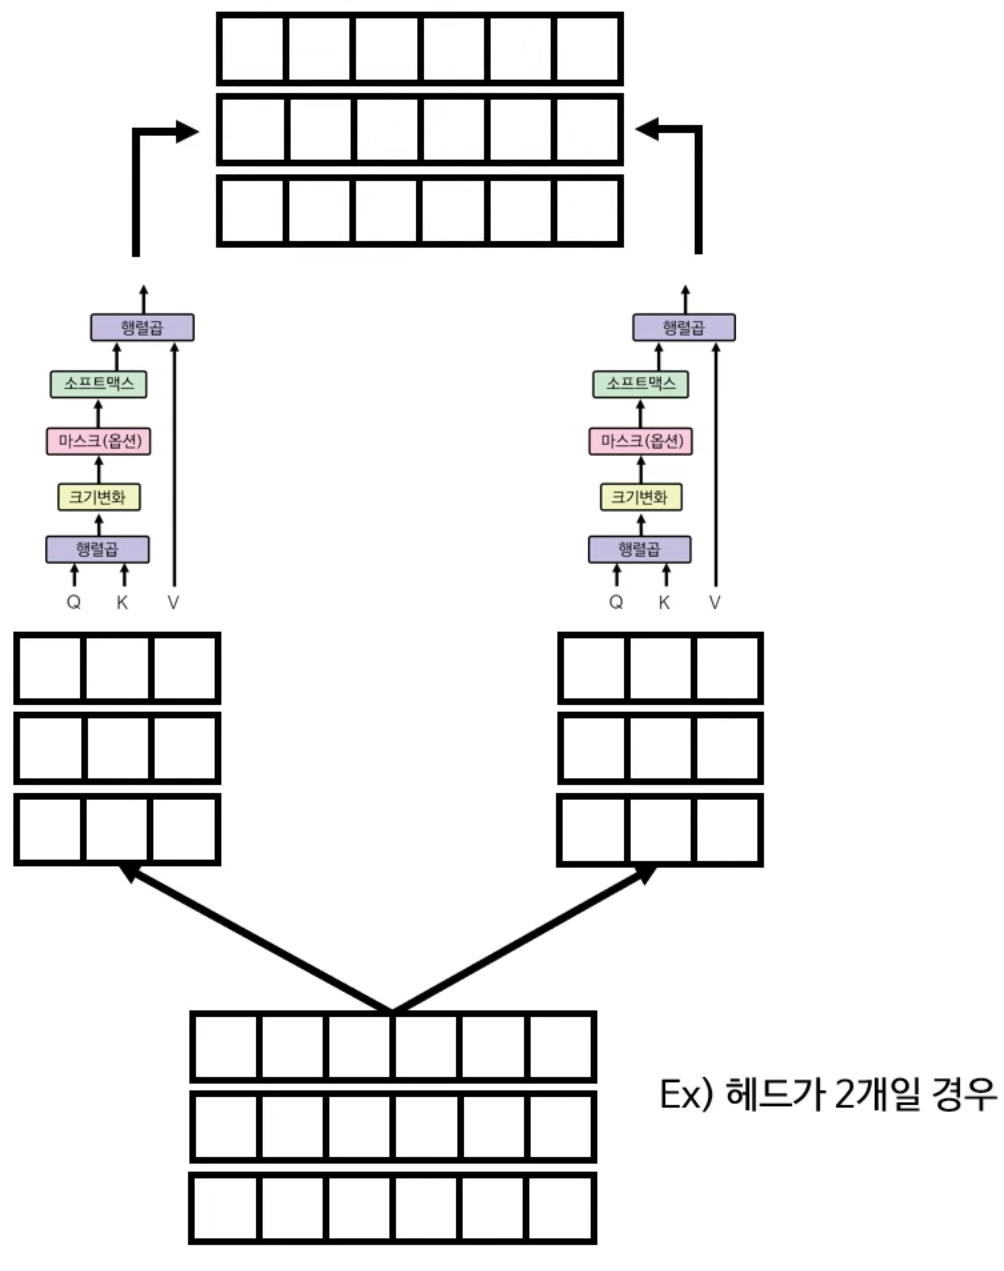
완전연결층으로 다중헤드 어텐션의 최종 결과를 계산한다.
-
여기까지가 다중헤드 어텐션이었고, 이제 합과 정규화 레이어다.
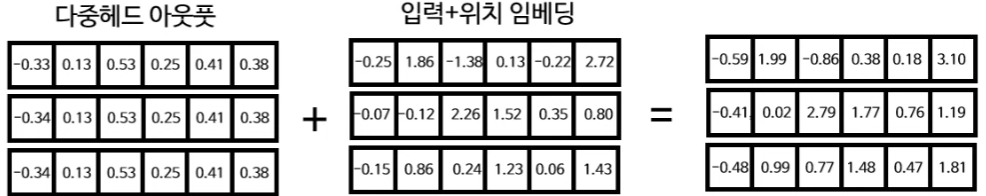
합은 다중헤드 아웃풋 행렬과 처음 생성한 입력+위치 임베딩과 합하는 과정이다.
-
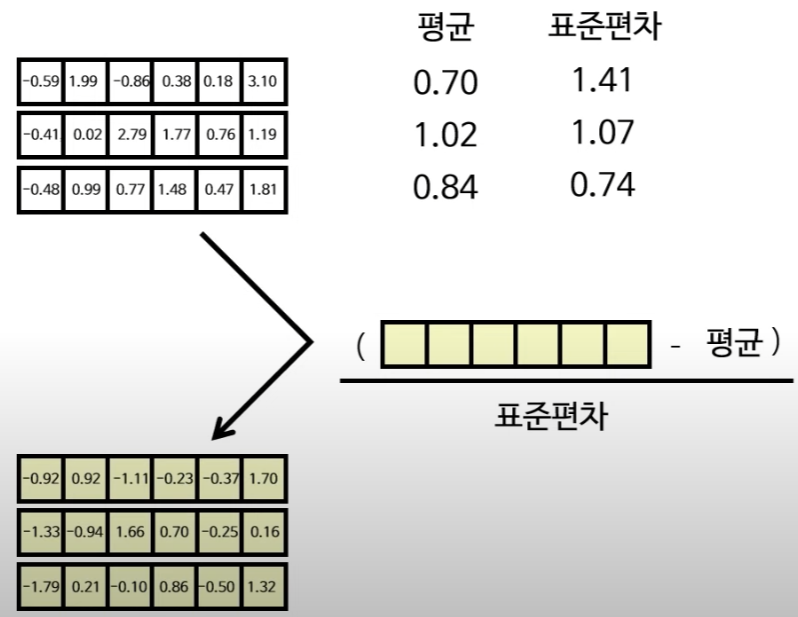
그 다음 합한 행렬을 정규화를 진행한다.
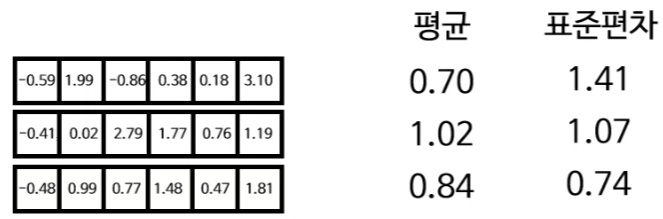
각 단어들마다 평균과 표준편차를 구하고, 공식을 통해 정규화 행렬을 만들어낸다.
-
그 다음 피드 포워드 레이어는 2개의 층으로 이루어졌고, ReLU()를 activation function으로 사용하는 신경망 구조다.
그래서 입력과 가중치와 편향을 이용해서 계산을 해주고 ReLU에 적용시키면
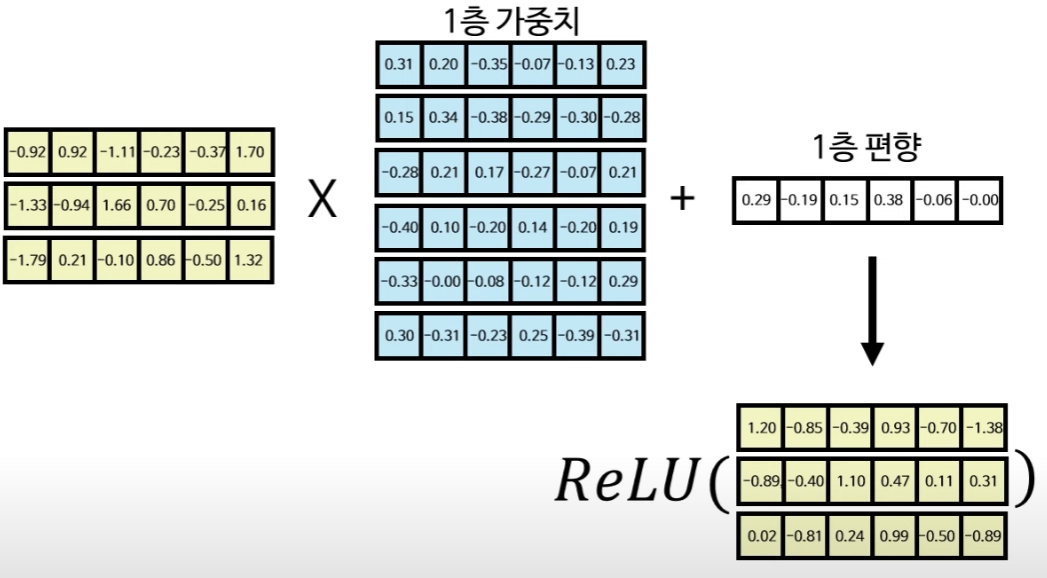
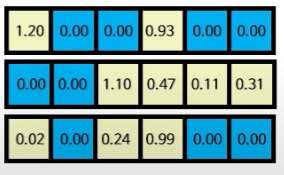
이렇게 음수들이 0으로 바뀌게 되고 이를 다시 2층 가중치와 편향을 이용해서 계산해주면 피드포워드 레이어의 아웃풋이 나온다.
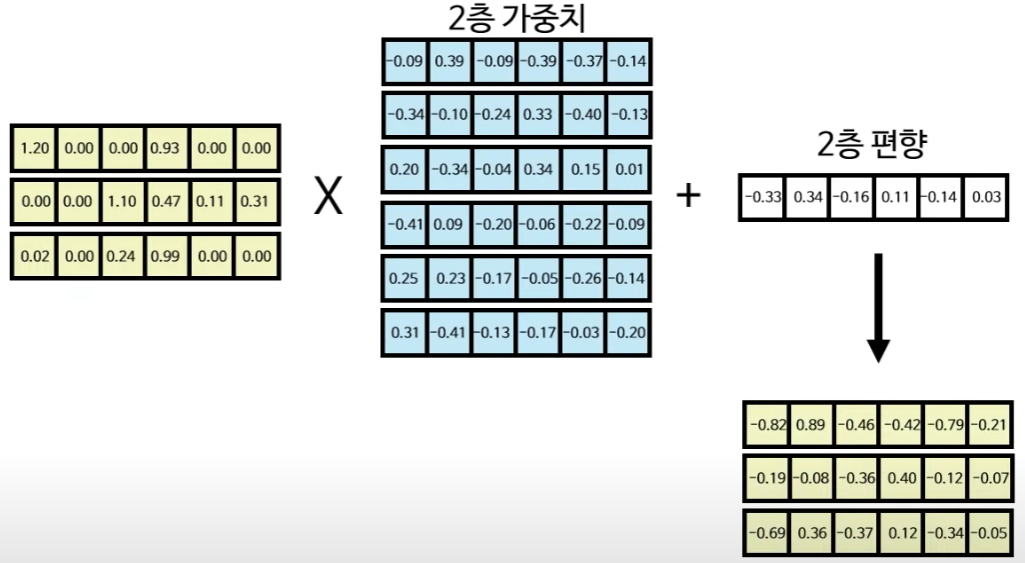
-
이제 다시 앞서 진행했던 합과 정규화 레이어를 동일하게 반복한다.
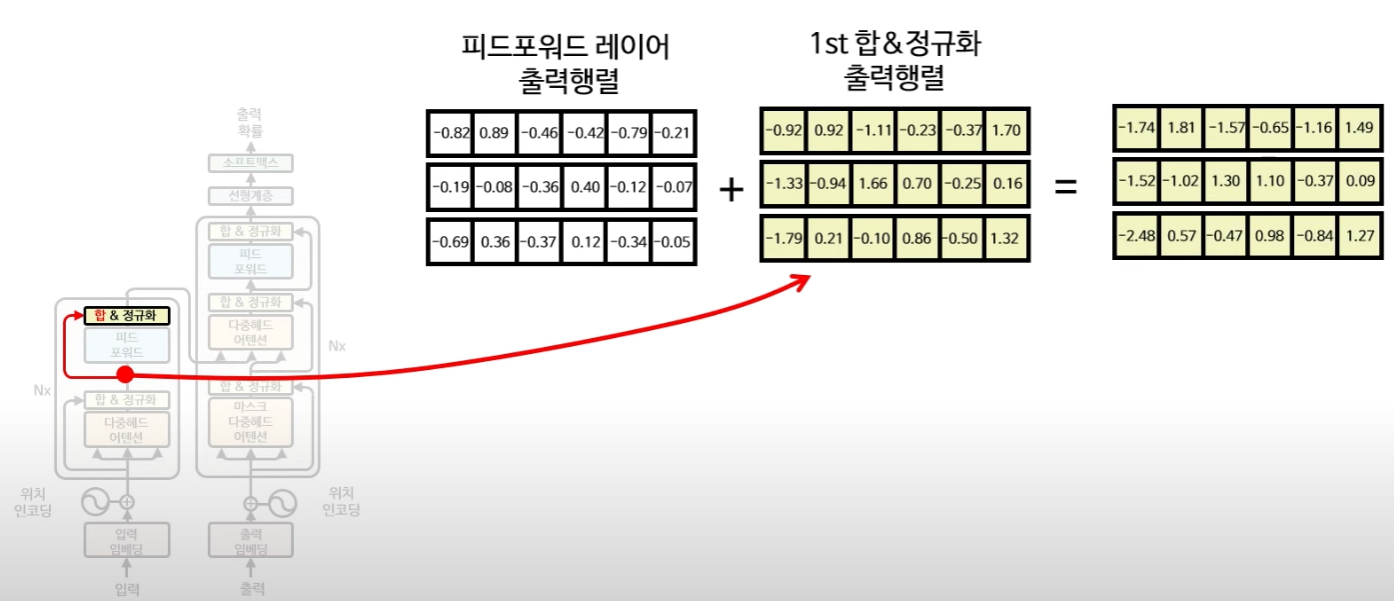
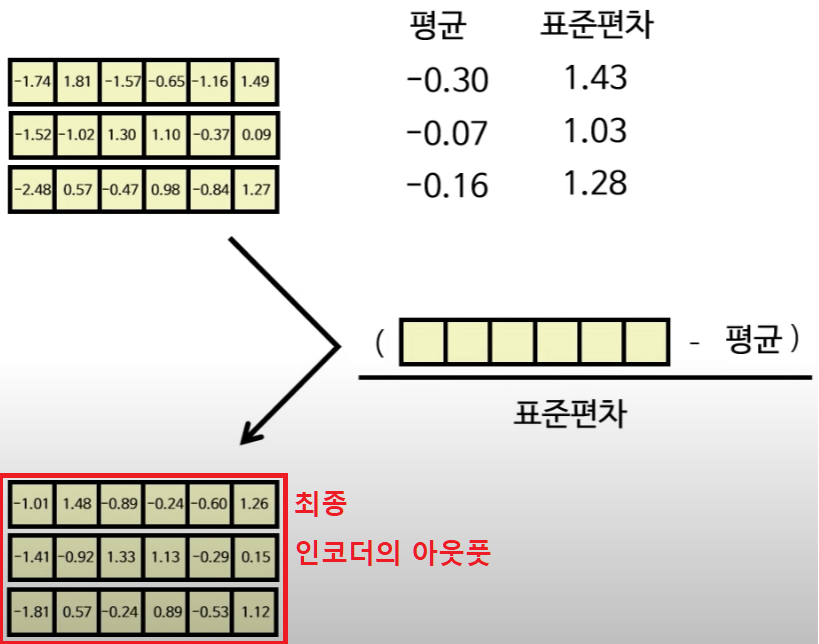
-
이제 디코더 단계다.
인코더와 마찬가지로 출력 단어의 인코딩과 위치 인코딩을 진행한다.
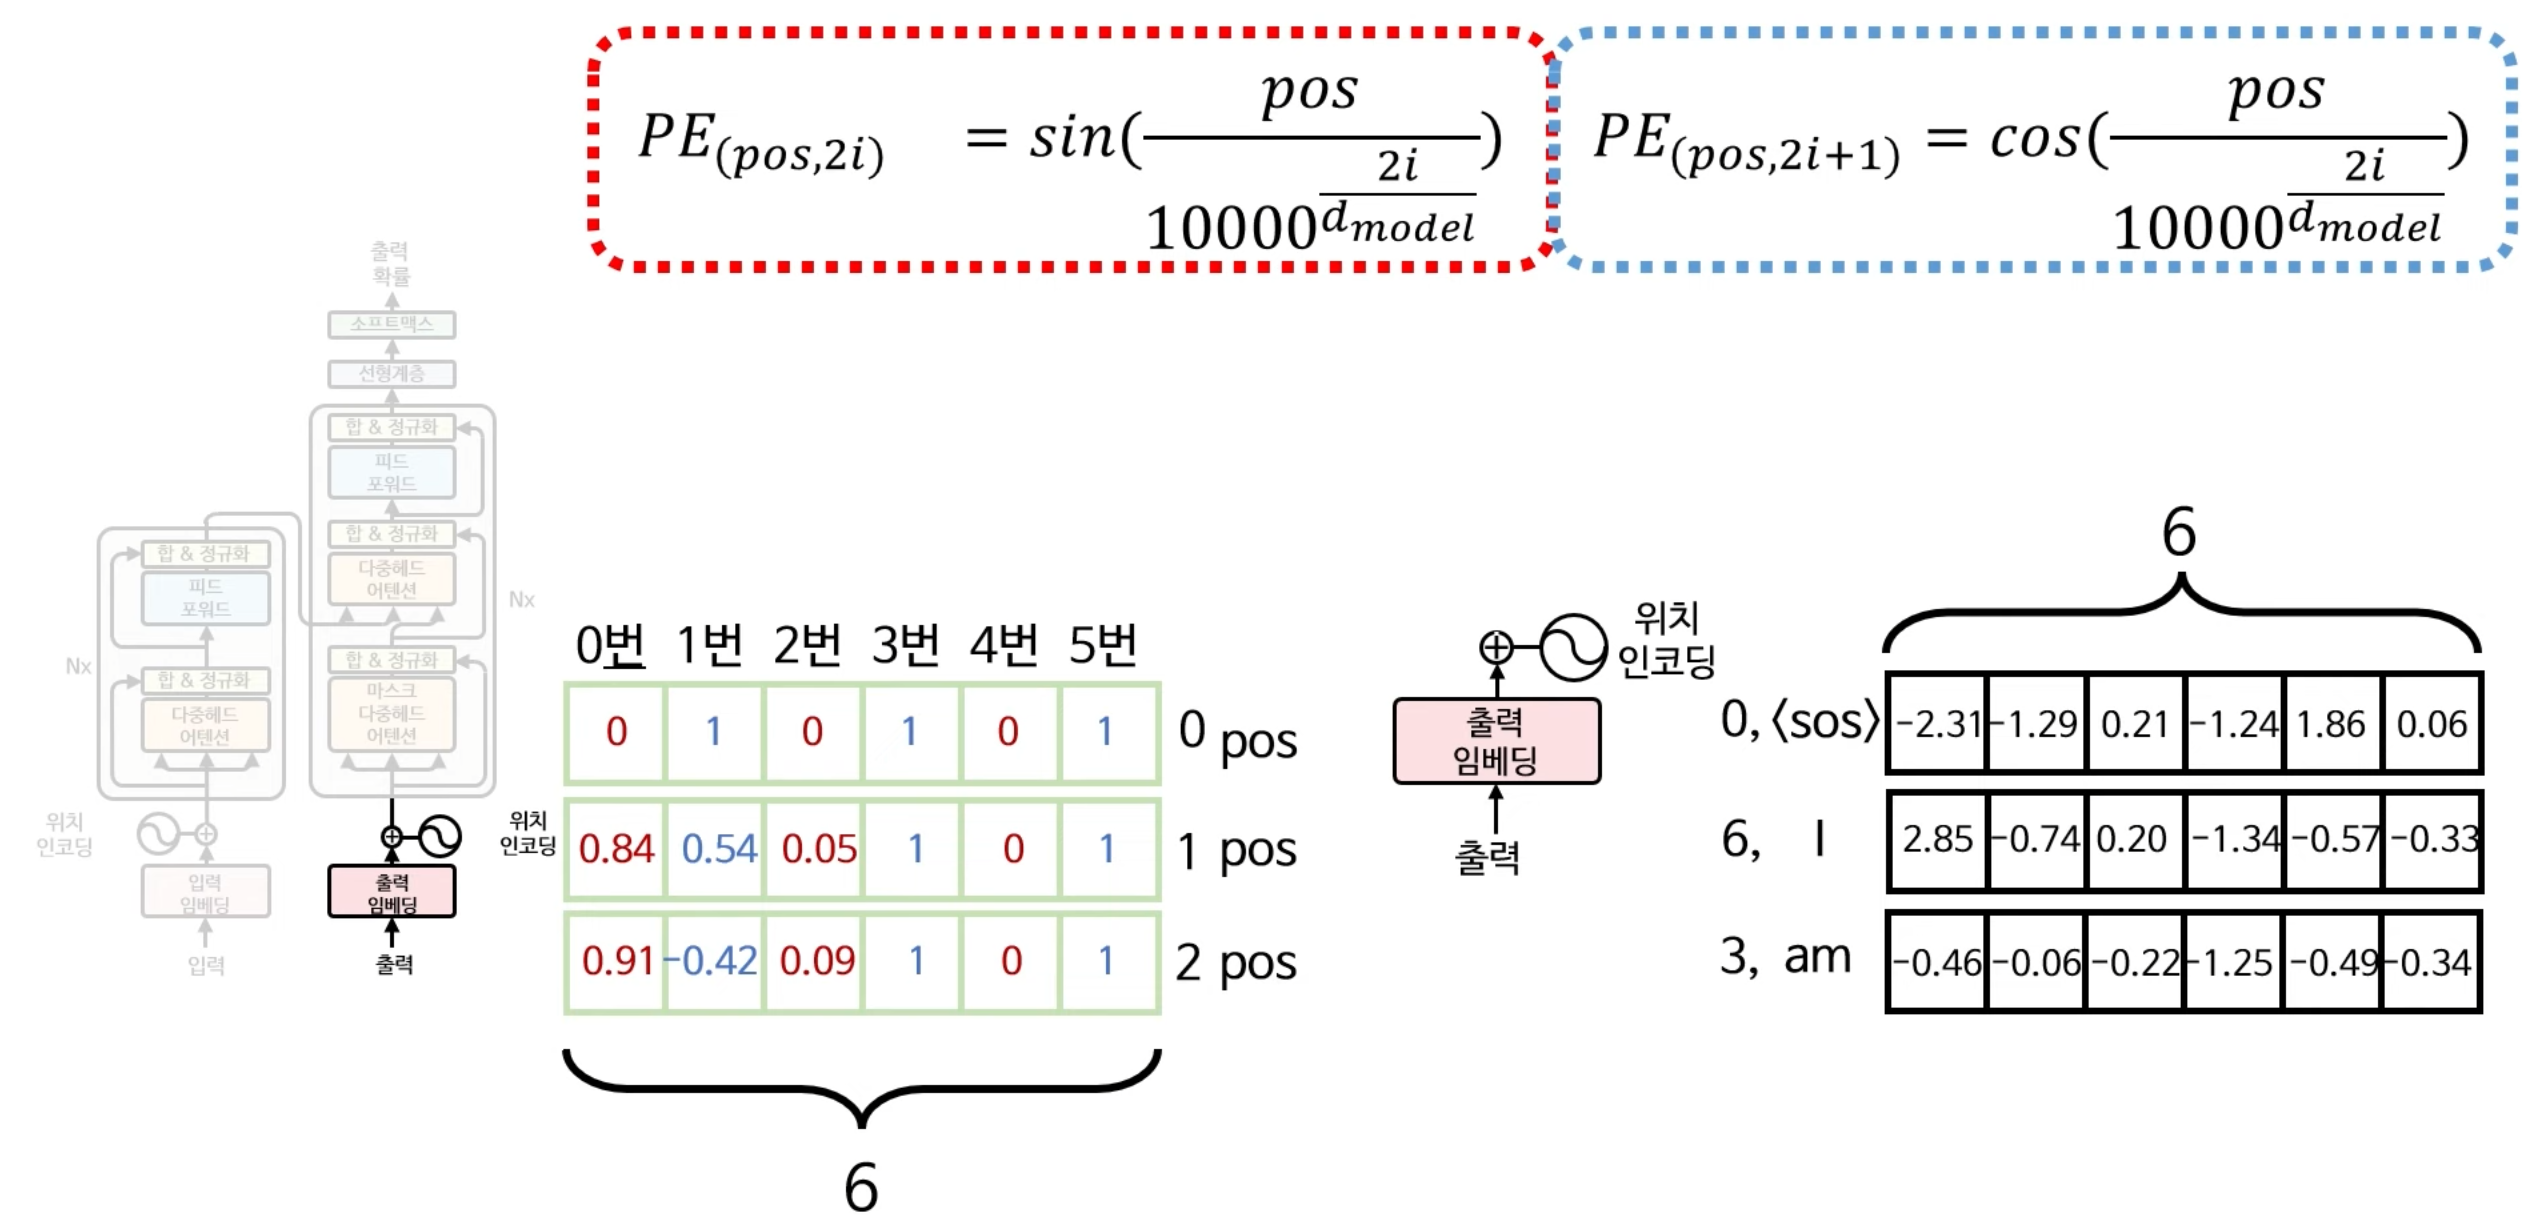
그리고 위치 인코딩은 기존에 계산한 값을 그대로 사용할 수 있다.
(6.4. 이미지 참고)
어찌됐든 이 둘을 합해준다.
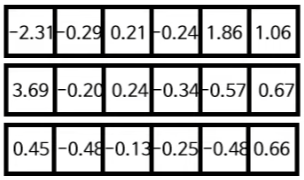
-
이 둘을 더해줬다면 위치+단어 인코딩이 되는 것이고 마스크 다중헤드 어텐션으로 넘어가는데 이도 크게 다르지 않다.
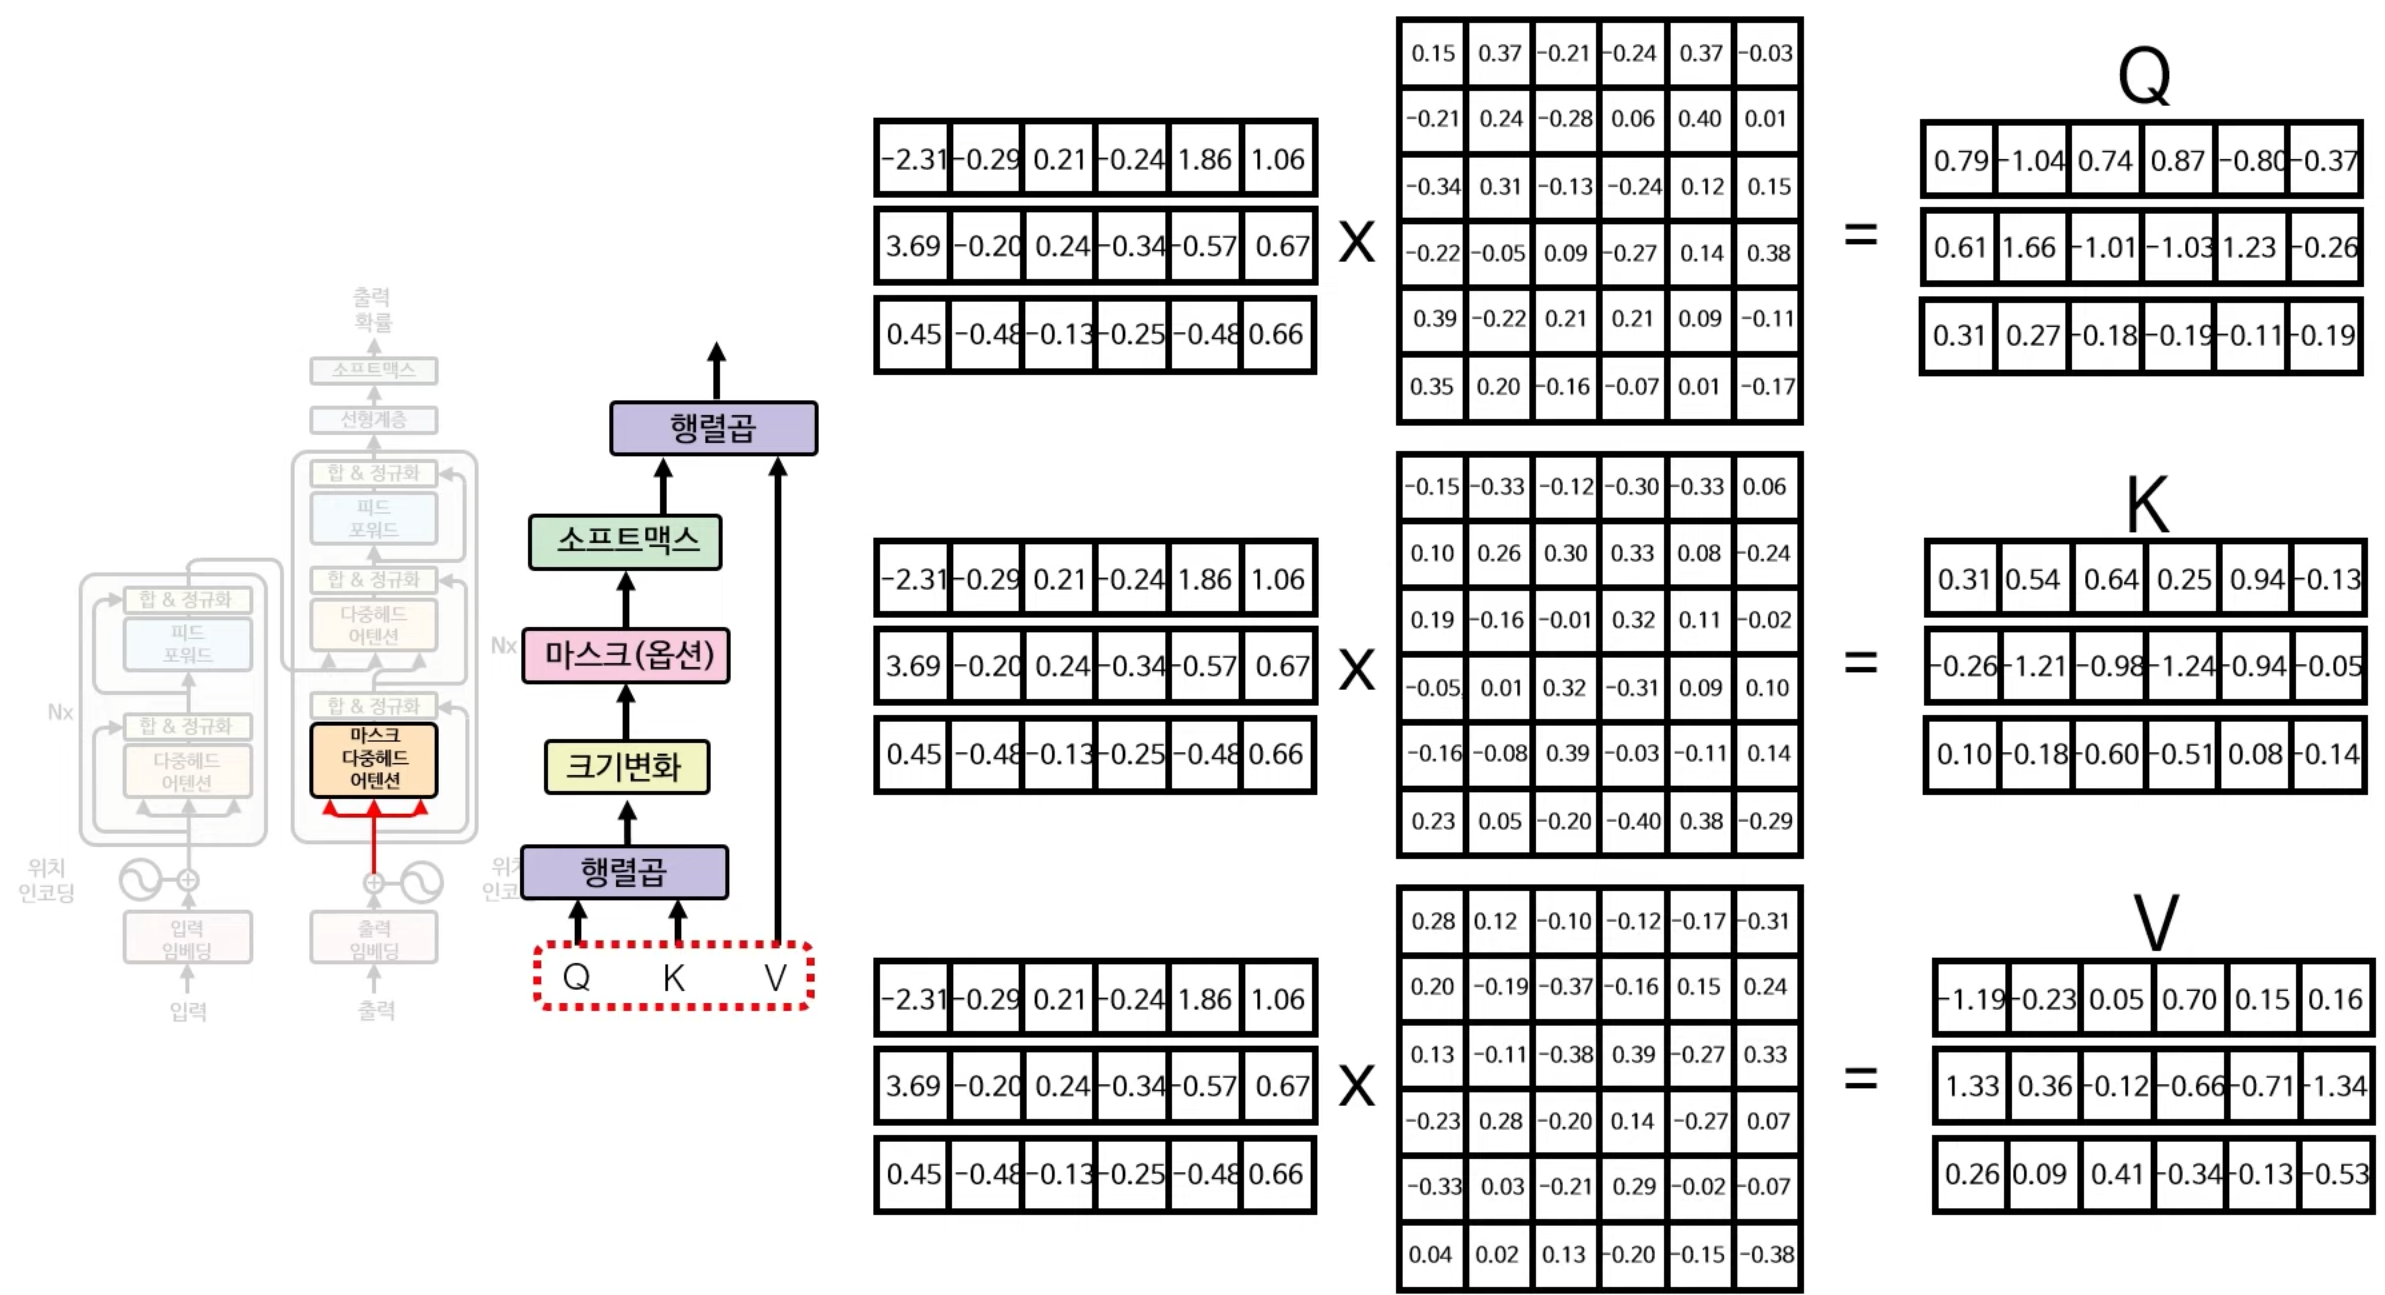
-
구한 Q, K 행렬을 곱해서 어텐션 행렬을 구하고
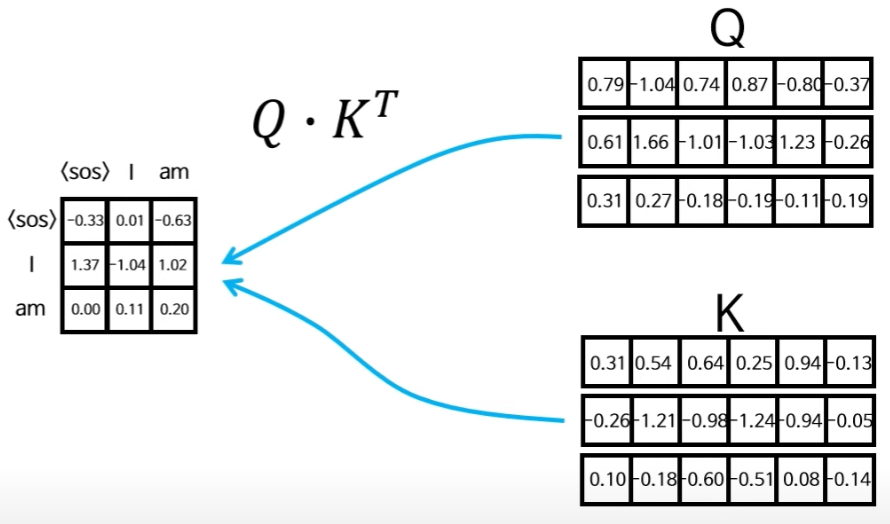
-
똑같이 으로( 길이 6) 나눠준다.
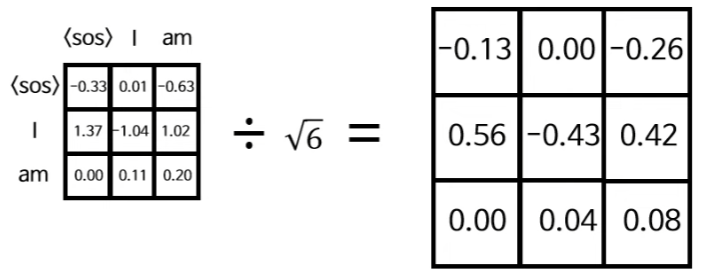
-
이제 앞서 인코딩에서는 진행하지 않았던 마스크 어텐션이다.
트랜스포머 디코더의 목적은 출력 단어 시퀀스를 "생성"하는 것이다.
인코더는 입력 문장 전체의 의미를 파악해야 하기 때문에 전체 단어들간의 관계를 다 파악해야 하는데,
디코더는 아니다. 출력 문장을 "한 단어씩" 출력하는 것이기 때문에 아직 출력되지 않은 단어에 주의를 줄 수 없다.
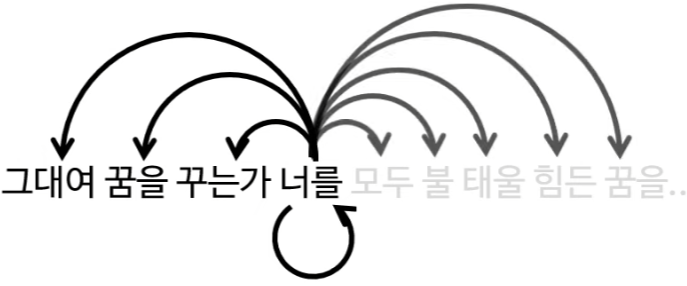
따라서 이를 디코더 학습 과정에 반영했는데, 아래 그림과 같다.
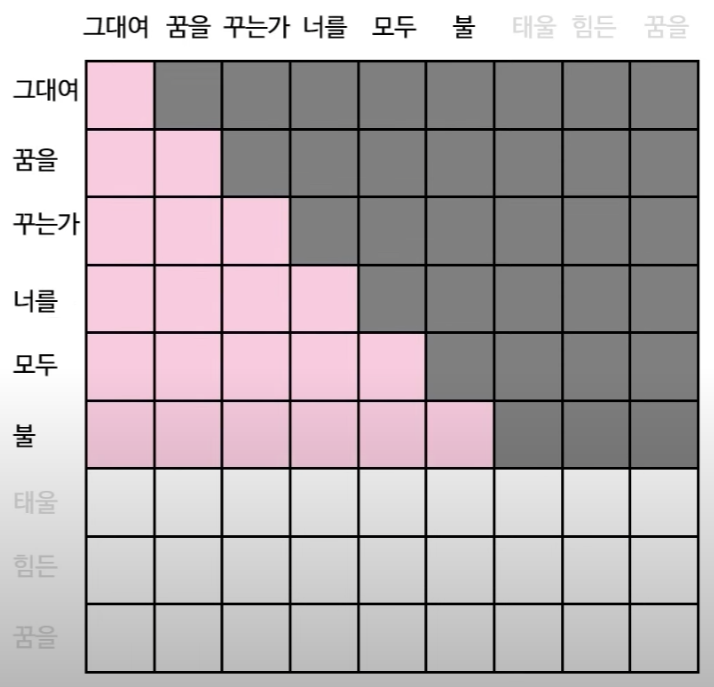
이렇게 각 단어들별로 미래에 나오는 단어는 가려서 게산에 영향을 주지 않도록 하는 것이다.
그래서 앞서 25.에서 나온 어텐션 행렬에 적용시키면 다음과 같아진다.
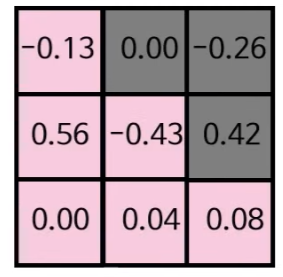
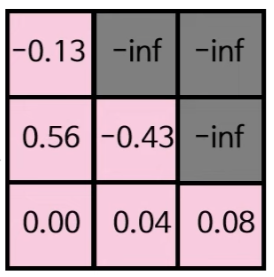
이 -inf는 -무한대 값으로, softmax를 거치면 0으로 바뀌기 때문이다. -
그렇게 softmax레이어로 넘어가서 아래와 같이 바뀌게 되고,
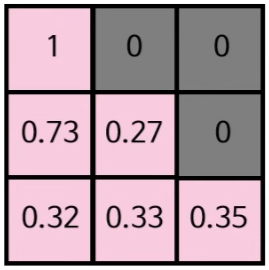
-
이를 이제 V와 행렬곱을 진행하면
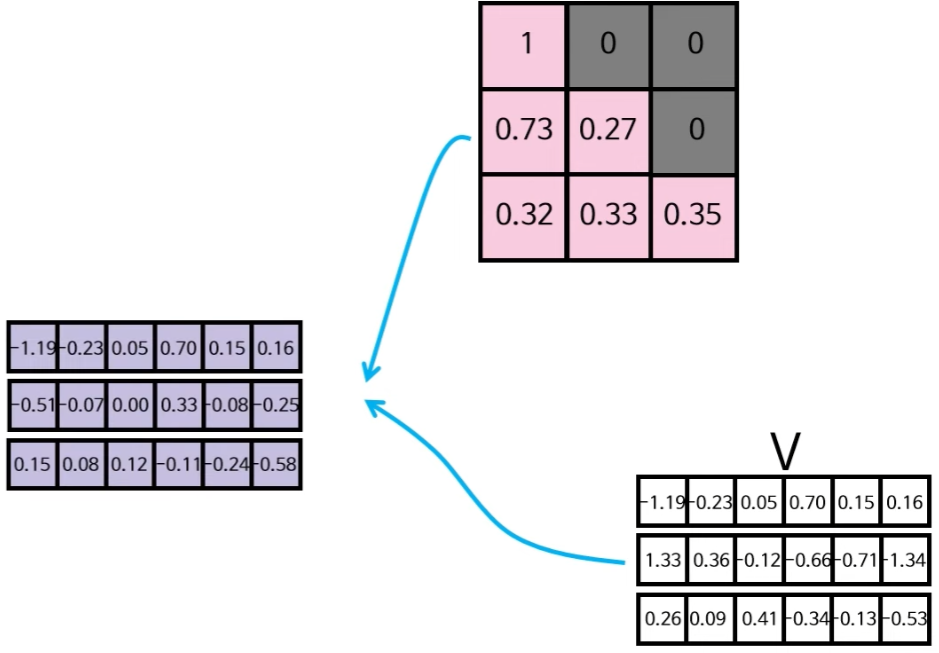
-
그 뒤에 만약 멀티헤드 어텐션이라면 연결 더 해줘서 6x6 행렬로 연산해주면 아래와 같이 마스크 다중헤드 어텐션의 최종 행렬값이 나온다.
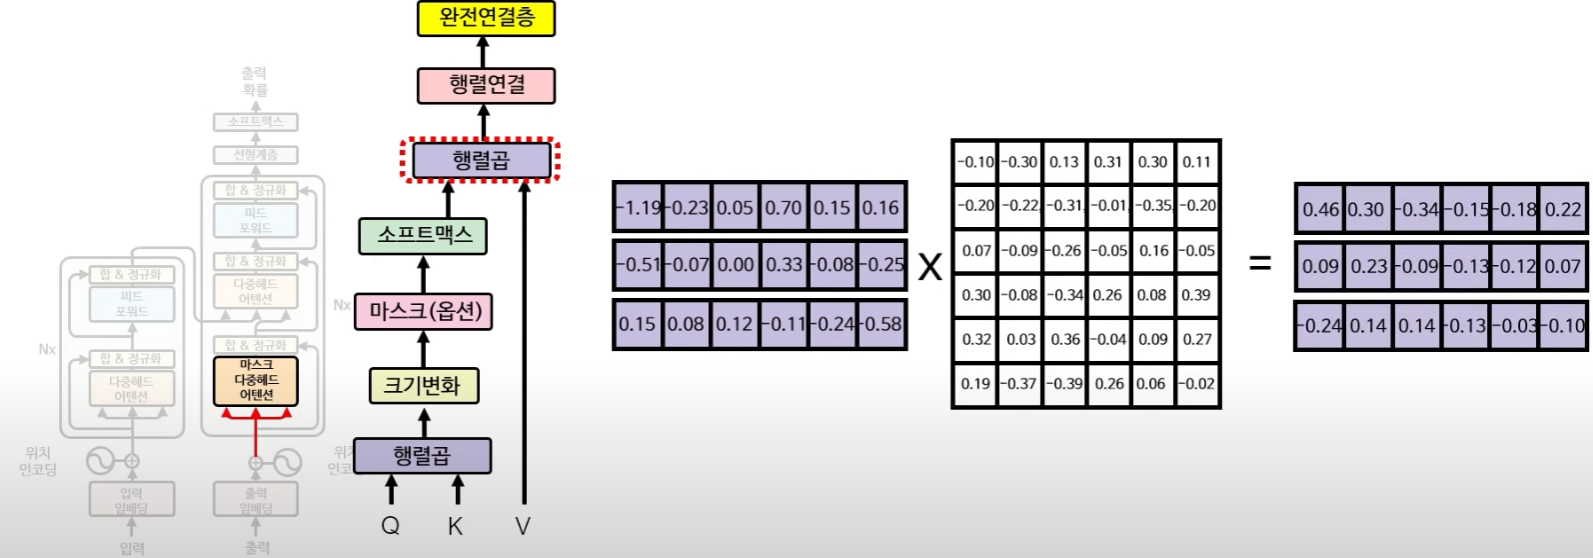
-
인코더와 동일하게 합과 정규화를 진행한다.
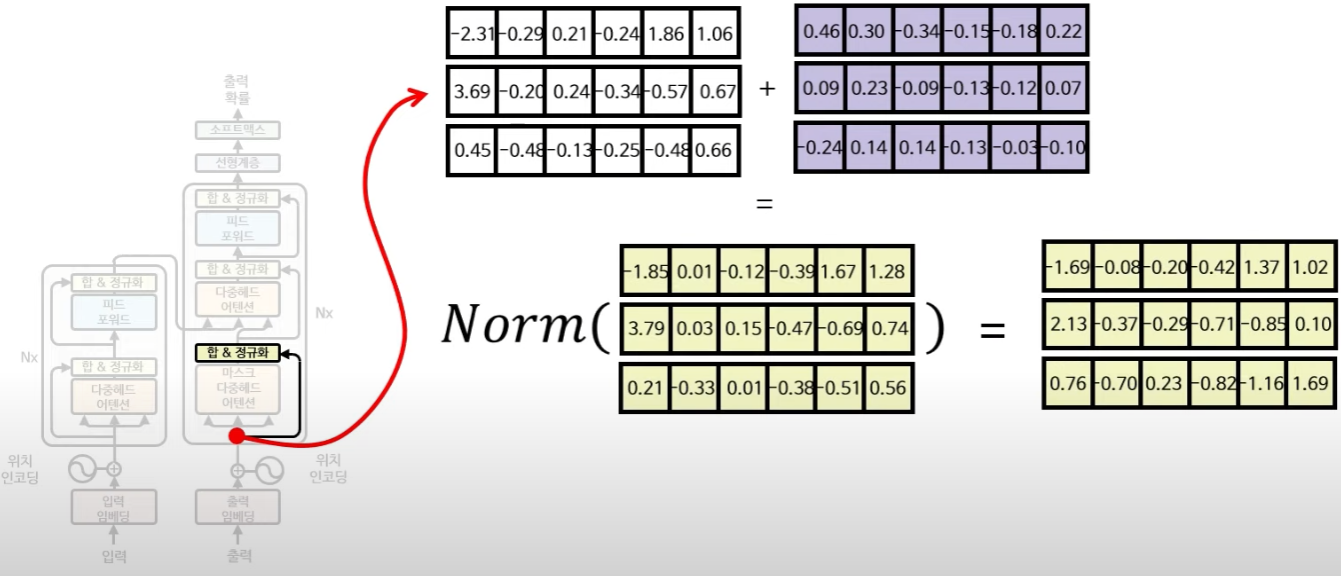
-
그 다음 이제 다중헤드 어텐션으로 들어오는데,
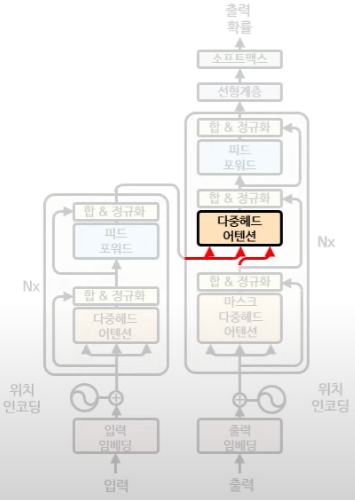
이번에는 조금 다르다.
Q는 좀 전에 구한 디코더의 행렬을 6x6행렬로 곱한 값을 입력으로하고,
K와 V는 인코더의 최종 아웃풋을 6x6 행렬로 곱한 값을 입력으로 한다.
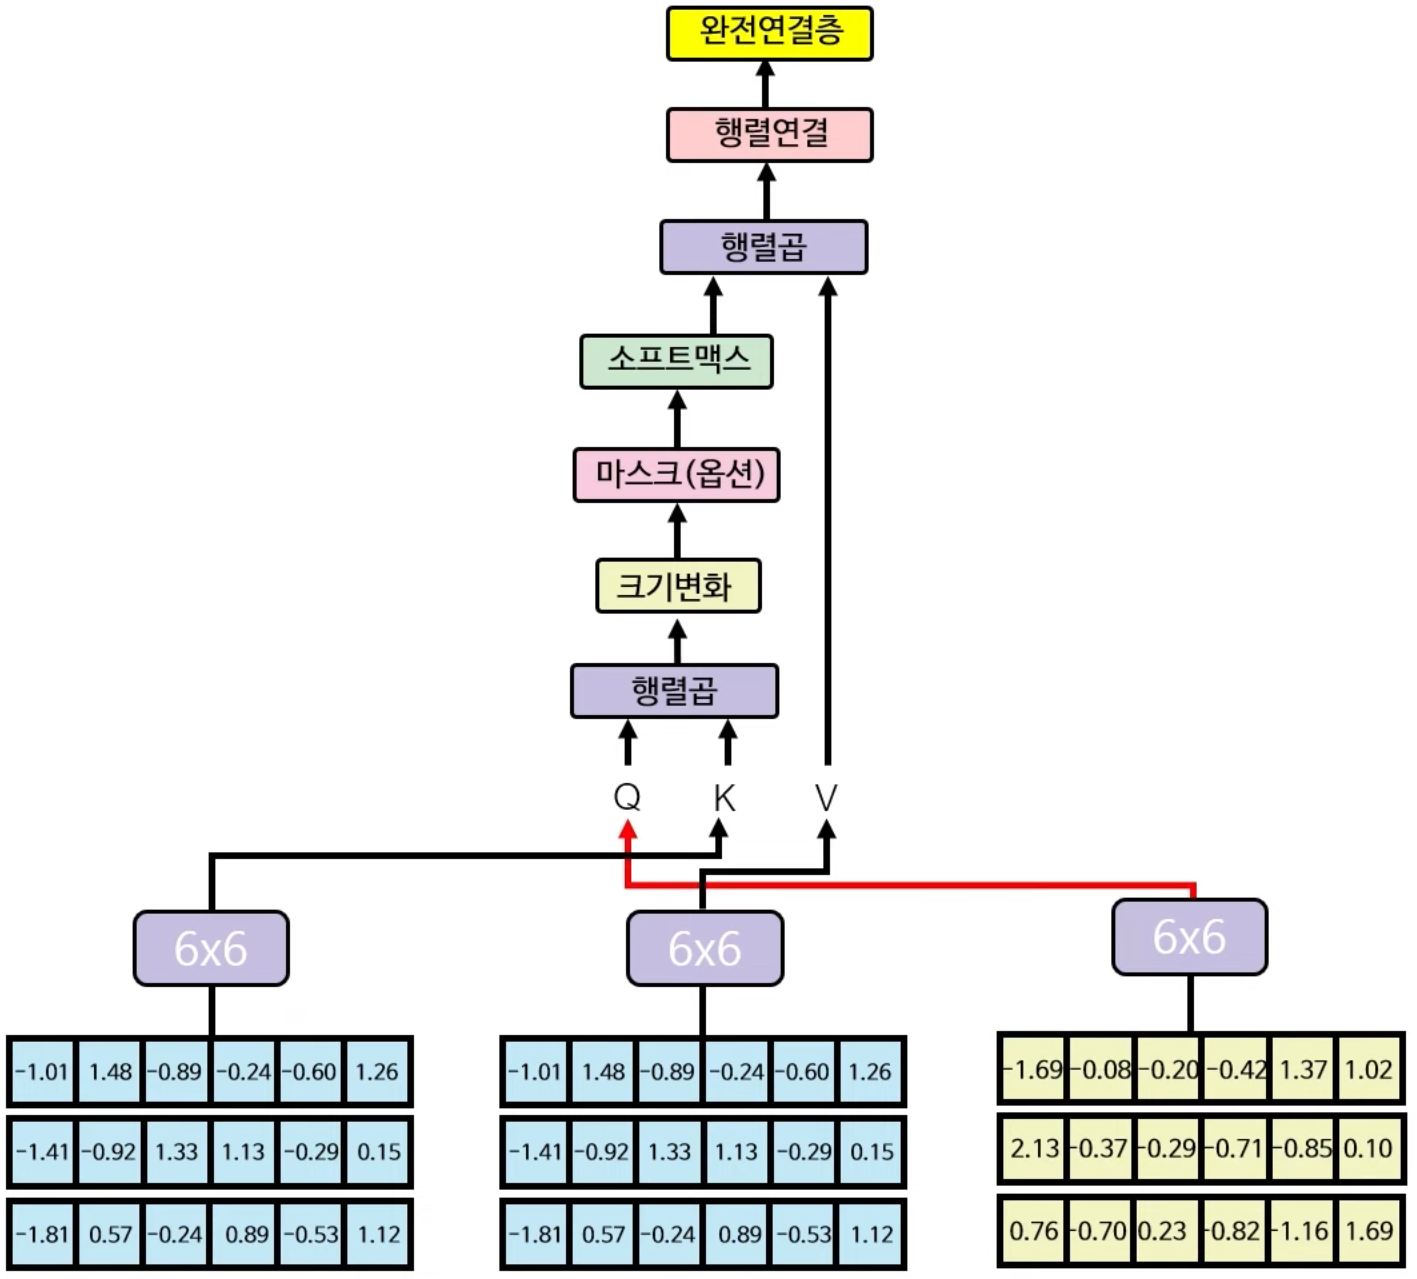
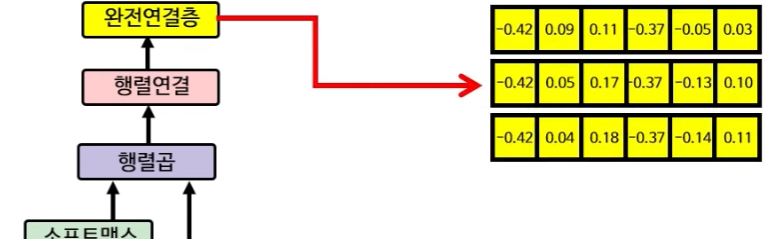
그리고 동일하게 진행되어 다중헤드 어텐션의 아웃풋은 아래와 같다.
-
그리고 이어지는 합과 정규화 -> 피드 포워드 -> 합과 정규화는 동일하니까 생략한다.
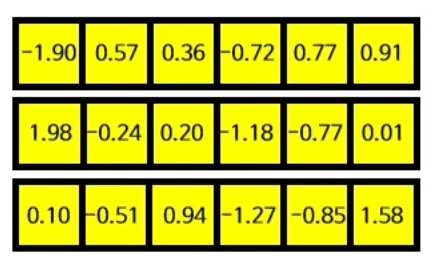
아래는 합과 정규화 -> 피드 포워드 -> 합과 정규화까지 진행한 디코더 아웃풋 행렬이라고 하자.
-
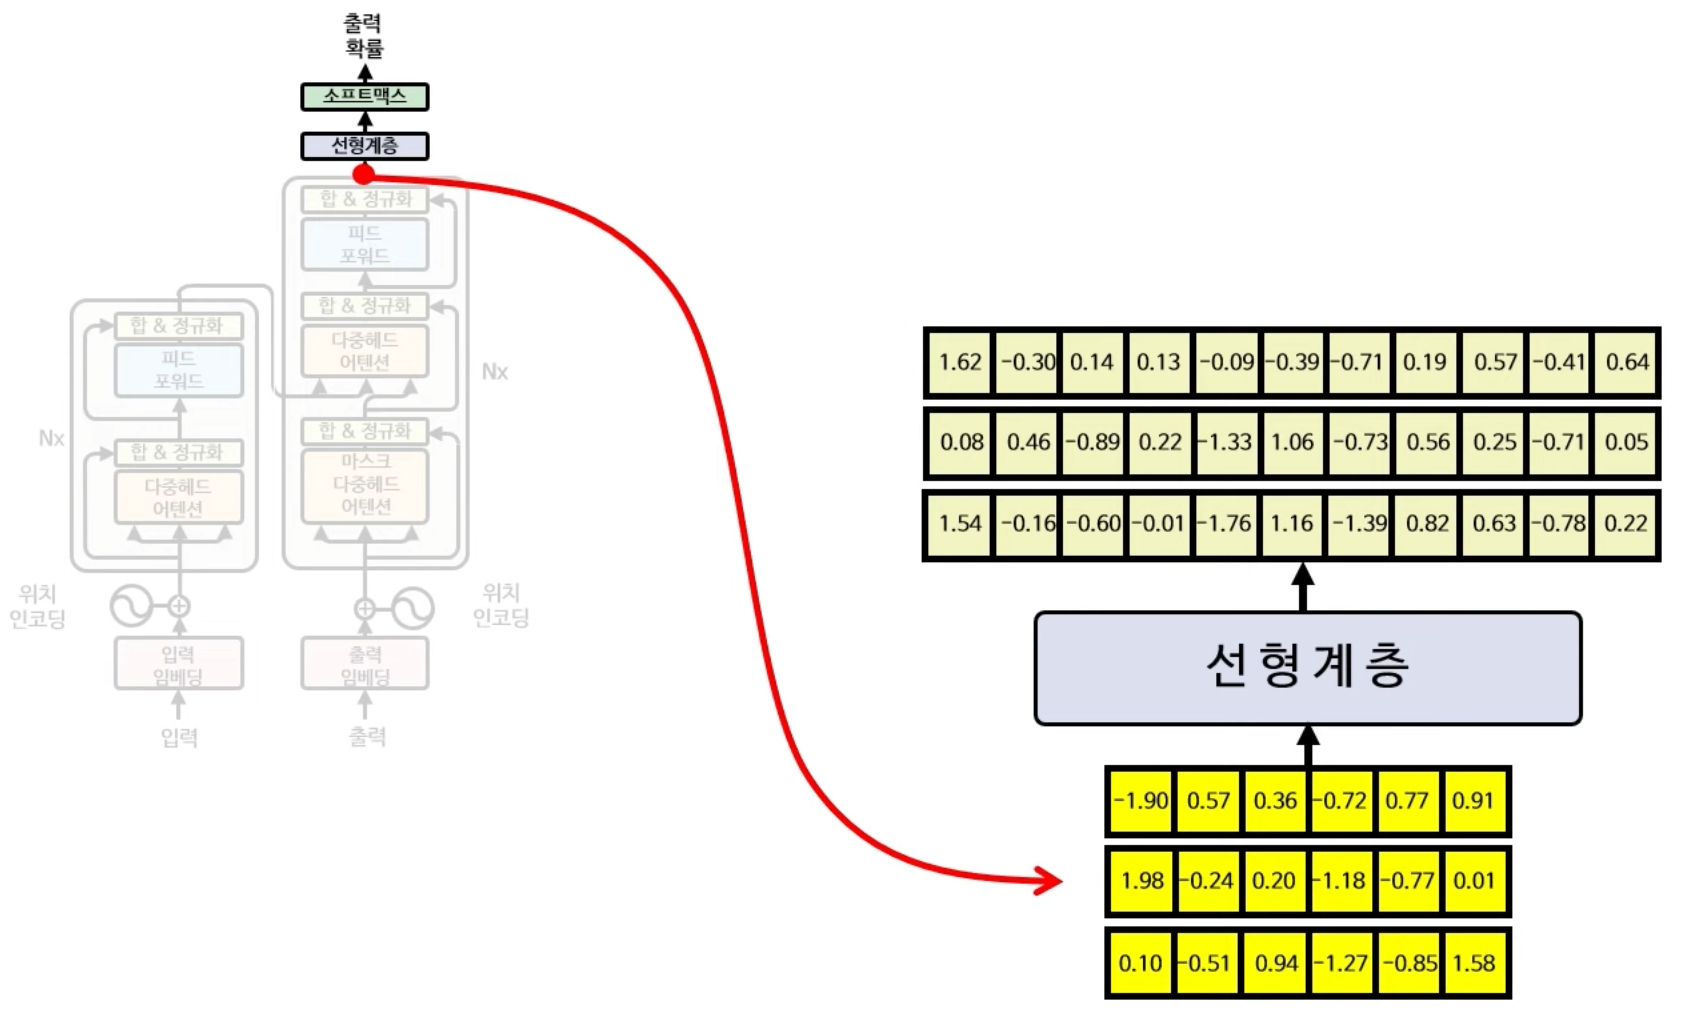
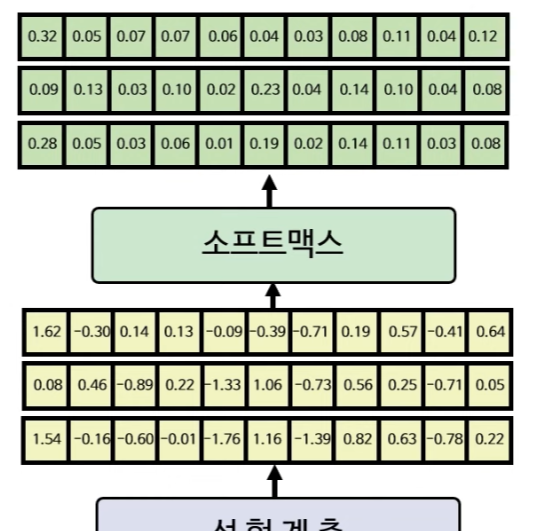
그럼 이제 마지막 디코더에서 나온 값들을 선형계층과 소프트 맥스 계층에 넣어서 최종 아웃풋을 구하게 된다.
앞선 32. 에서의 아웃풋 행렬은 선형계층을 통해서 앞서 6으로 압축했던 길이를 다시 원래 단어장(vocab) 길이인 11로 펼쳐지고
-
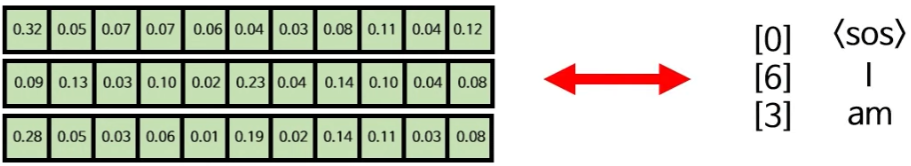
Softmax를 통해 최종 출력값이 나온다.
그러면 최종 정답(Answer)과 비교해서 손실함수와 역전파를 사용해서 모든 레이어들의 가중치값들을 조절해 나간다.
여기까지가 트랜스포머의 학습 과정이다.
정말 복잡하고 코드로 보면 더 머리가 아프다.
앞서 말했지만 이 Transformer가 발전된 형태가 GPT다.
따라서 GPT를 이용하면 더 간단하게 코드를 짤 수 있기에 GPT 코드 부분으로 넘어가겠다.
다음 글에서 GPT를 다루겠다.
⭐ 참고
1.2. 부터 지금까지 쭉
유튜브 신박Ai 님의 영상을 참고했다.
너무 잘 설명된 영상이니 참고하면 좋을 거 같다.
https://youtu.be/p216tTVxues?si=fmcMUdNMSr8DtiVw