참고 자료
- Auto-Encoding Variational Bayes (Kingma & Welling, 2013)
- An Introduction to Variational Autoencoders (Kingma & Welling, 2019)
6. 근사 사후분포
VAE에서는 적분을 다루기 쉽도록 쉬운 분포 를 도입합니다.
를 근사 사후분포(approximate posterior) 또는 인식 모델(recognition model)이라 합니다.
여기서 는 데이터를 생성하는 생성 모델의 파라미터이고, 는 실제 사후분포를 근사하는 인코더의 파라미터입니다.
VAE에서는 일반적으로 근사 사후분포를 정규분포로 설정합니다.
인코더 신경망은 입력 를 받아 이 분포의 평균과 로그 표준편차를 출력합니다.
이후 근사 사후분포에서 잠재변수 를 샘플링합니다.
근사 사후분포의 학습목표는 와 실제 사후분포 의 차이를 줄이는 것입니다.
두 분포의 차이는 KL 발산을 이용해 나타냅니다.
목표는 다음 KL 발산을 최소화하는 것입니다.
하지만 실제 사후분포 를 계산하기 힘들기 때문에 이 KL 발산 역시 직접 계산할 수 없습니다.
VAE에서는 이후 설명할 ELBO를 최대화하여 두 분포가 가까워지도록 간접적으로 학습합니다.
amortized inference
기존 방법에서는 각각의 데이터 마다 별도의 근사분포와 변분 파라미터 를 설정하고 최적화해야 합니다.
데이터가 개라면 개의 서로 다른 변분 파라미터를 반복적으로 최적화해야 하므로 계산량이 커집니다.
또한 새로운 데이터가 들어오면 그 데이터에 대한 파라미터를 처음부터 다시 최적화해야 합니다.
VAE는 모든 데이터에 하나의 인코더 신경망을 공유합니다.
인코더는 입력 를 받아 해당 데이터의 근사 사후분포에 필요한 파라미터를 계산합니다.
따라서 데이터마다 별도의 최적화 과정을 수행하지 않고 공유된 신경망 파라미터 만 학습하면 됩니다.
이처럼 여러 데이터의 추론에 필요한 계산 비용을 하나의 인코더 학습에 나누어 부담하는 방식을 amortized inference라고 합니다.
7. ELBO
ELBO는 Evidence Lower Bound의 약자입니다.
관찰 데이터의 log-likelihood 에 대한 하한을 의미합니다.
원래는 를 최대화해야 하지만,
에 대한 적분이 안되기 때문에 이를 직접 계산하기 어렵습니다.
따라서 VAE는 계산할 수 있는 하한인 ELBO를 대신 최대화합니다.
하한을 높이면 log-likelihood 값의 하한을 높여 최댓값을 간접적으로 찾을 수 있습니다.
ELBO는 다음과 같이 표현됩니다.
첫 번째 항은 샘플링한 잠재변수 로부터 입력 를 잘 복원하도록 만듭니다.
두 번째 항은 근사 사후분포 가 사전분포 와 비슷해지도록 만드는 KL 발산 입니다.
앞에서 실제 사후분포를 대신하기 위해 근사 사후분포 를 정의했지만, 분포를 정의하는 것만으로는 이를 어떻게 학습할지 알 수 없습니다.
실제 사후분포와의 차이도 직접 계산할 수 없기 때문에, VAE는 계산 가능한 복원 항과 KL 발산 항으로 이루어진 ELBO를 학습 기준으로 사용합니다.
는 무엇으로 근사할지를 나타내고
ELBO는 그 근사분포를 어떻게 학습할지를 나타냅니다.
8. 최적화 비대칭
VAE는 인코더와 디코더를 함께 학습해야 하지만 두 신경망의 최적화 방식에는 차이가 있습니다.
인코더는 입력 로부터 근사 사후분포의 파라미터 와 를 계산합니다.
그다음 이 분포에서 잠재변수 를 무작위로 샘플링합니다.
디코더는 를 입력으로 받아 를 복원합니다.
디코더의 연산은 미분 가능하기 때문에 역전파를 통해 파라미터 를 학습할 수 있습니다.
하지만 인코더와 디코더 사이에는 무작위 샘플링 과정이 존재합니다.
분포에서 표본을 뽑는 연산은 입력과 출력 사이의 결정적인 관계가 아니기에
일반적인 역전파로는 손실의 기울기를 인코더의 파라미터 까지 전달하기 어렵습니다.
디코더는 쉽게 미분할 수 있지만
인코더는 중간의 샘플링 과정 때문에 최적화하기 어렵다는 문제가 발생합니다.
이를 최적화의 비대칭이라고 합니다.
VAE는 이를 해결하기 위해 무작위성을 별도의 변수로 분리하는 재매개변수화 기법(reparameterization trick)을 사용합니다.
9. reparameterization trick
앞서 설명했듯
인코더가 만든 분포에서 잠재변수 를 직접 샘플링하면 무작위 샘플링 과정 때문에 기울기를 인코더까지 전달하기 어렵습니다.
재매개변수화 기법은 이러한 무작위성을 변수 으로 식으로부터 분리합니다.
먼저 표준정규분포에서 잡음 을 샘플링합니다.
그다음 잠재변수 를 다음과 같이 계산합니다.
여기서 와 는 인코더가 뱉은 평균과 표준편차이고 은 원소별 곱셈을 의미합니다.
이렇게 하면 무작위성은 인코더의 파라미터와 관계없는 으로 분리됩니다.
이 하나 주어져 고정되면 z는 와 에 대한 미분 가능한 함수가 됩니다.
손실의 기울기를 인코더까지 전달하여 역전파로 학습할 수 있습니다.
이 과정을 재매개변수화 기법(reparameterization trick)이라고 합니다.
10. 전체 구조
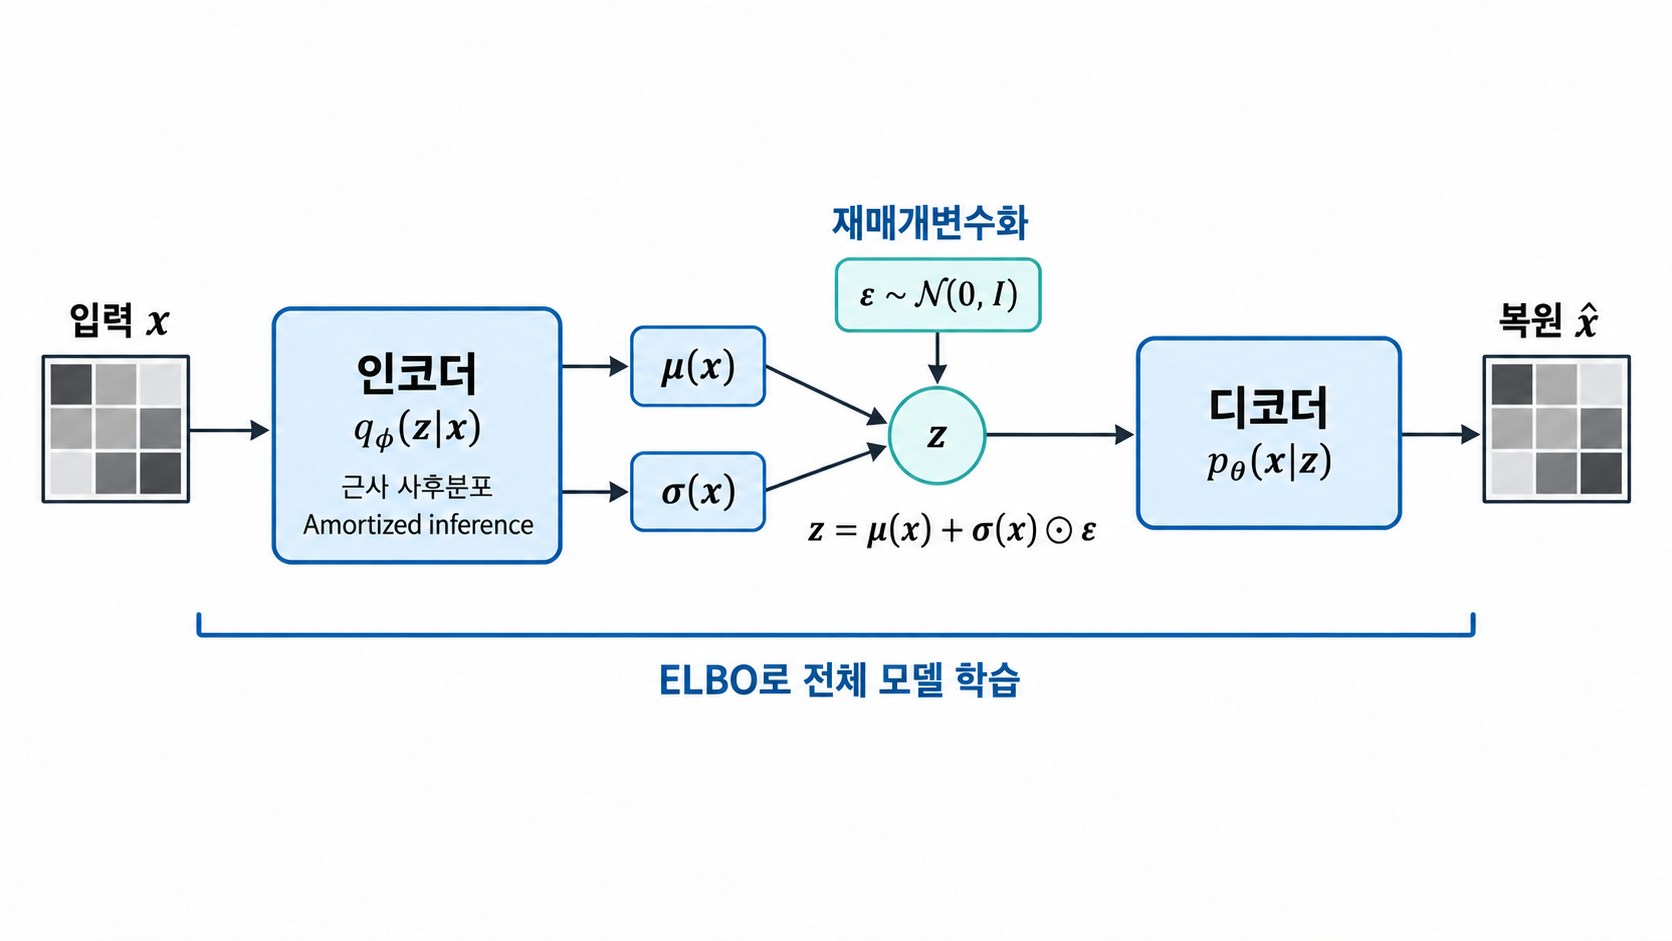
지금까지 내용을 요약하면
VAE의 인코더는 입력 를 받아 근사 사후분포 의 평균 와 표준편차 를 계산합니다.
하나의 인코더가 모든 입력의 분포를 계산하므로 이 과정에는 amortized inference가 사용됩니다.
잠재변수 는 재매개변수화 기법을 통해 다음과 같이 계산됩니다.
이를 통해 샘플링의 무작위성을 으로 분리하고 손실의 기울기를 인코더까지 전달할 수 있습니다.
디코더는 잠재변수 를 입력받아 조건부 분포 를 계산하고 입력 데이터를 복원합니다.
VAE는 ELBO를 최대화하여 전체 모델을 학습합니다.
복원 항은 디코더가 입력을 잘 복원하도록 만들고, KL 발산 항은 근사 사후분포 가 사전분포 와 비슷해지도록 만듭니다.
