참고자료
https://publications.aston.ac.uk/id/eprint/373/1/NCRG_94_004.pdf
1. 기존 딥러닝
일반적인 회귀 신경망은 입력 벡터 x를 받아
목표 벡터 t의 각 성분에 해당하는 출력 fk(x;w)를 계산합니다.
MSE로 학습할 때의 오차 함수는 다음과 같습니다.
21q=1∑nk=1∑c[fk(xq;w)−tkq]2
데이터가 충분히 많고 모델이 데이터를 잘 표현할 수 있을 때
데이터에 대한 합을 결합확률밀도 p(t,x)를 이용한 적분으로 나타낼 수 있습니다.
E=n→∞lim2n1q=1∑nk=1∑c[fk(xq;w)−tkq]2=21k=1∑c∬[fk(x;w)−tk]2p(t,x)dtdx
고정된 입력 x에서 이 오차를 최소화하는 출력값을 구해보면
p(t,x)=p(t∣x)p(x)를 이용하고 fk(x;w)에 대해 미분하면 다음과 같습니다.
∫[fk(x;w)−tk]p(t∣x)dt=0
조건부 확률밀도의 적분값은 1입니다.
따라서 출력값은
⟨tk∣x⟩=∫tkp(t∣x)dt
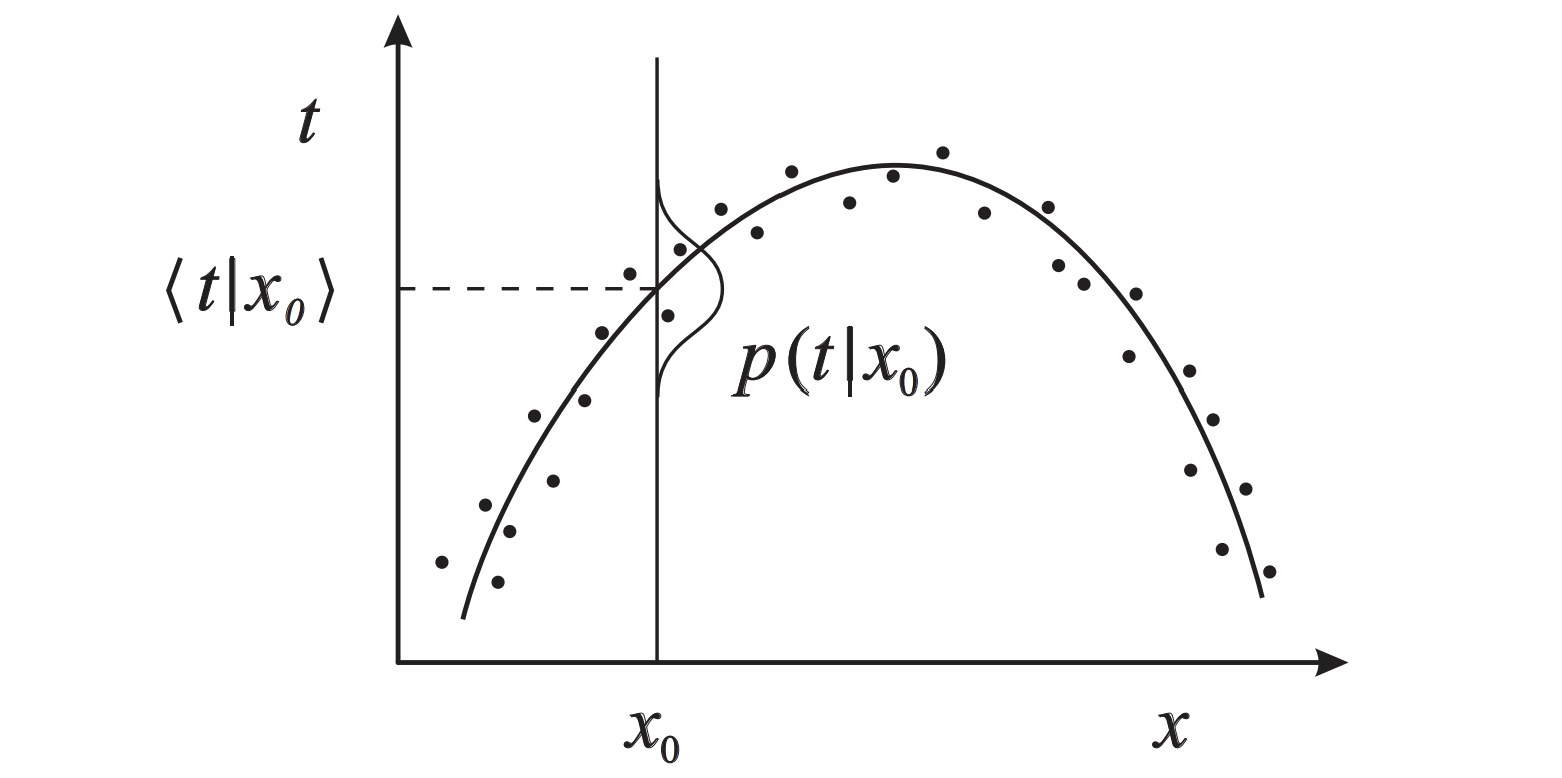
MSE로 학습한 신경망의 k번째 출력은 입력 x가 주어졌을 때 목표값 tk의 조건부 평균입니다.
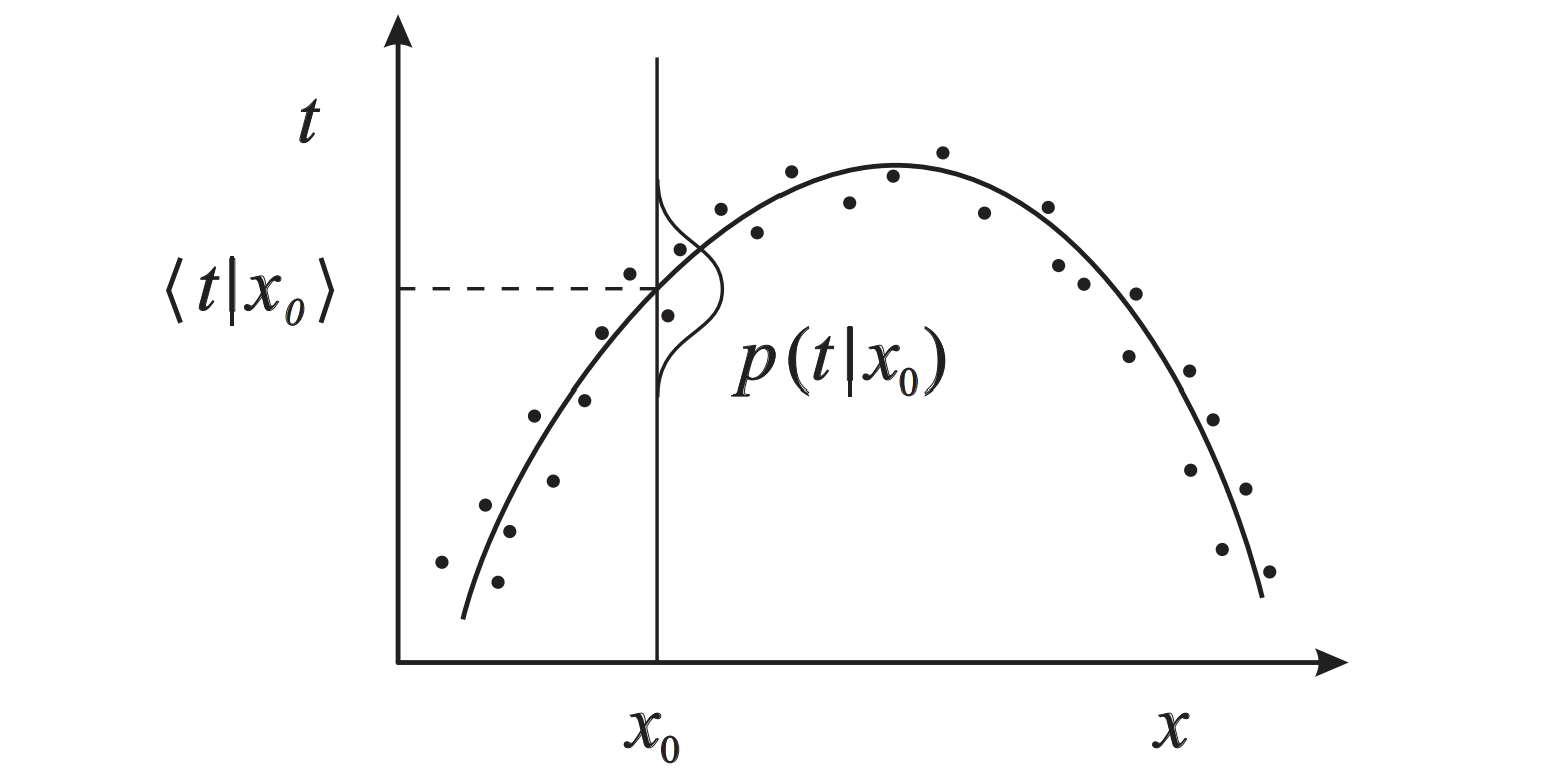
하지만 하나의 입력에 대해 목표값이 여러개라면 어떻게 될까요?
2. inverse problem
어떤 과정에서는 같은 결과가 서로 다른 원인에서 나올 수도 있습니다.
이렇게 관측된 결과로부터 그 결과를 만들어 낸 원인을 추정하는 문제를 inverse problem(역문제)이라고 합니다.
결과가 같더라도 가능한 원인이 여러 개라면, 하나의 입력에 여러 목표값이 대응하게 됩니다
이제 관측된 결과를 신경망의 입력 x
추정할 원인을 목표값 t라고 두겠습니다.
어떤 입력 x0에 대해
서로 다른 두 목표값 t1, t2가 모두 가능하다고 하였을 때
MSE 회귀 신경망은 하나의 출력값만 예측합니다. 두 목표값이 비슷한 빈도로 나타난다면 k번째 출력은 대략 다음과 같습니다.
⟨tk∣x0⟩≈2t1,k+t2,k
이 출력의 문제점은 출력값이 두 개의 원인 모두와 값이 달라 어느 쪽에도 해당하지 않을 수 있다는 점입니다.
이와 같은 역문제에서는 평균값 하나를 예측하는 것보다 주어진 입력에서 어떤 목표값들이 얼마나 가능한지를 나타내는 조건부 분포 p(t∣x)를 모델링할 필요가 있습니다.
이것이 다음 절에서 살펴볼 MDN의 출발점입니다.
3. MDN
문제는 신경망이 입력 x에 대해 목표값 하나만 출력한다는 데 있습니다.
Mixture Density Network(MDN)는 목표값 하나 대신 조건부 확률밀도 p(t∣x)를 모델링합니다. 따라서 같은 입력에서 여러 목표값이 가능한 상황도 표현할 수 있습니다.
MDN은 신경망과 혼합모형으로 구성됩니다.
신경망은 입력 x를 받아 혼합모형의 파라미터를 출력하고
혼합모형은 이 파라미터를 사용해 목표값 t의 확률밀도를 만듭니다.
가우시안 성분을 m개 사용하면 다음과 같습니다.
i=1∑mαi(x)ϕi(t∣x)
ϕi(t∣x)는 i번째 가우시안의 확률밀도이고
αi(x)는 그 성분의 혼합계수입니다. 각 성분은 입력에 따라 다음 세 가지 값을 가집니다.
αi(x): 해당 성분이 차지하는 비중
μi(x): 해당 성분의 중심
σi(x): 해당 성분의 퍼짐 정도
목표 벡터 t의 차원이 c일 때 자료에서 사용한 가우시안 성분은 다음과 같습니다.
(2π)c/2σi(x)c1exp(−2σi(x)2∣t−μi(x)∣2)
혼합계수는 확률의 비중이어서 αi(x)≥0, ∑i=1mαi(x)=1이어야 합니다.
이를 위해 신경망의 혼합계수 출력을 softmax에 통과시킵니다.
이 구조에서는 한 입력에 대해 가능한 목표값이 두 군데에 모여 있을 때 두 가우시안의 중심을 각각의 목표값 근처에 둘 수 있습니다.
기존 MSE 회귀 모델은 두 값 사이의 평균을 하나의 답으로 출력하지만 MDN은 두 영역 모두에서 목표값이 나올 수 있음을 분포로 표현합니다.
각 영역의 비중과 퍼짐 정도도 함께 나타낼 수 있습니다.
4. software implementation
Mixture Density Network도 일반적인 신경망과 같은 방법으로 학습합니다.
신경망이 혼합분포의 파라미터를 출력하면 오차 함수가 그 파라미터와 목표값을 이용해 손실 및 출력층의 기울기를 계산합니다.
이후에는 이 기울기를 신경망에 역전파하여 가중치를 조정합니다.
MSE 회귀에서는 예측값과 목표값의 차이 제곱을 오차로 사용했습니다.
MDN은 입력 xq가 주어졌을 때 실제 목표값 tq에 모델이 얼마나 높은 확률밀도를 부여하는지 평가합니다.
q번째 데이터의 손실은 음의 로그 가능도입니다.
Eq=−lnp(tq∣xq)=−ln[i=1∑mαi(xq)ϕi(tq∣xq)]
신경망의 출력 벡터를 zq라고 하겠습니다.
이 출력으로부터 혼합계수 αi 평균 μi 표준편차 σi를 계산합니다.
오차 함수는 zq와 목표값 tq를 받아 손실 Eq 및 출력에 대한 기울기 δq=∇zqEq를 반환합니다.
가중치를 조정하려면 먼저 실제 목표값 tq에 대해 각 가우시안 성분이 얼마나 기여했는지 계산합니다. 이를 i번째 성분의 책임도라고 합니다.
∑j=1mαj(xq)ϕj(tq∣xq)αi(xq)ϕi(tq∣xq)
책임도를 이용하면 손실을 신경망의 출력인 혼합계수, 평균, 표준편차에 대해 미분할 수 있습니다.
이렇게 구한 출력층의 기울기를 일반적인 역전파 알고리즘과 동일하게 사용하면 됩니다.
j∑∂zjq∂Eq∂w∂zjq 