참고자료
https://arxiv.org/abs/1803.10122
1. World Model
사람은 감각을 통한 경험을 통해 세상을 이해하고 변화를 예측합니다.
이는 머릿속에 있는 내부 모델을 통해 세상을 이해하는 것이라고 볼 수 있습니다.
World Model은 에이전트가 느낀 정보를 토대로한 환경의 표현과 변화를 학습하는 모델입니다.
환경을 이해하는 것과 행동을 결정하는 것을 하나의 신경망을 통해 한번에 학습할 수도 있습니다.
하지만 강화학습에서는 보상이 여러 행동 이후에 주어질 수 있습니다.
따라서 어떤 행동이 보상에 기여했는지 판단하기 어려운 상황인
신용 할당 문제(credit assignment problem)이 발생할 수 있습니다.
논문에서는 이를 보완하기 위해 환경을 표현하는 World Model과 행동을 결정하는 Controller을 분리합니다.
일단 관찰된 정보와 행동을 바탕으로 환경에 대한 표현과 변화를 학습하고
이를 이용하여 작은 제어기를 보상을 많이 받도록 학습합니다.
이런 구조를 통해 환경에 대한 표현력을 늘리고 보상을 통해 최적화 해야하는 파라미터 수를 줄일 수 있습니다.
2. V, M, C
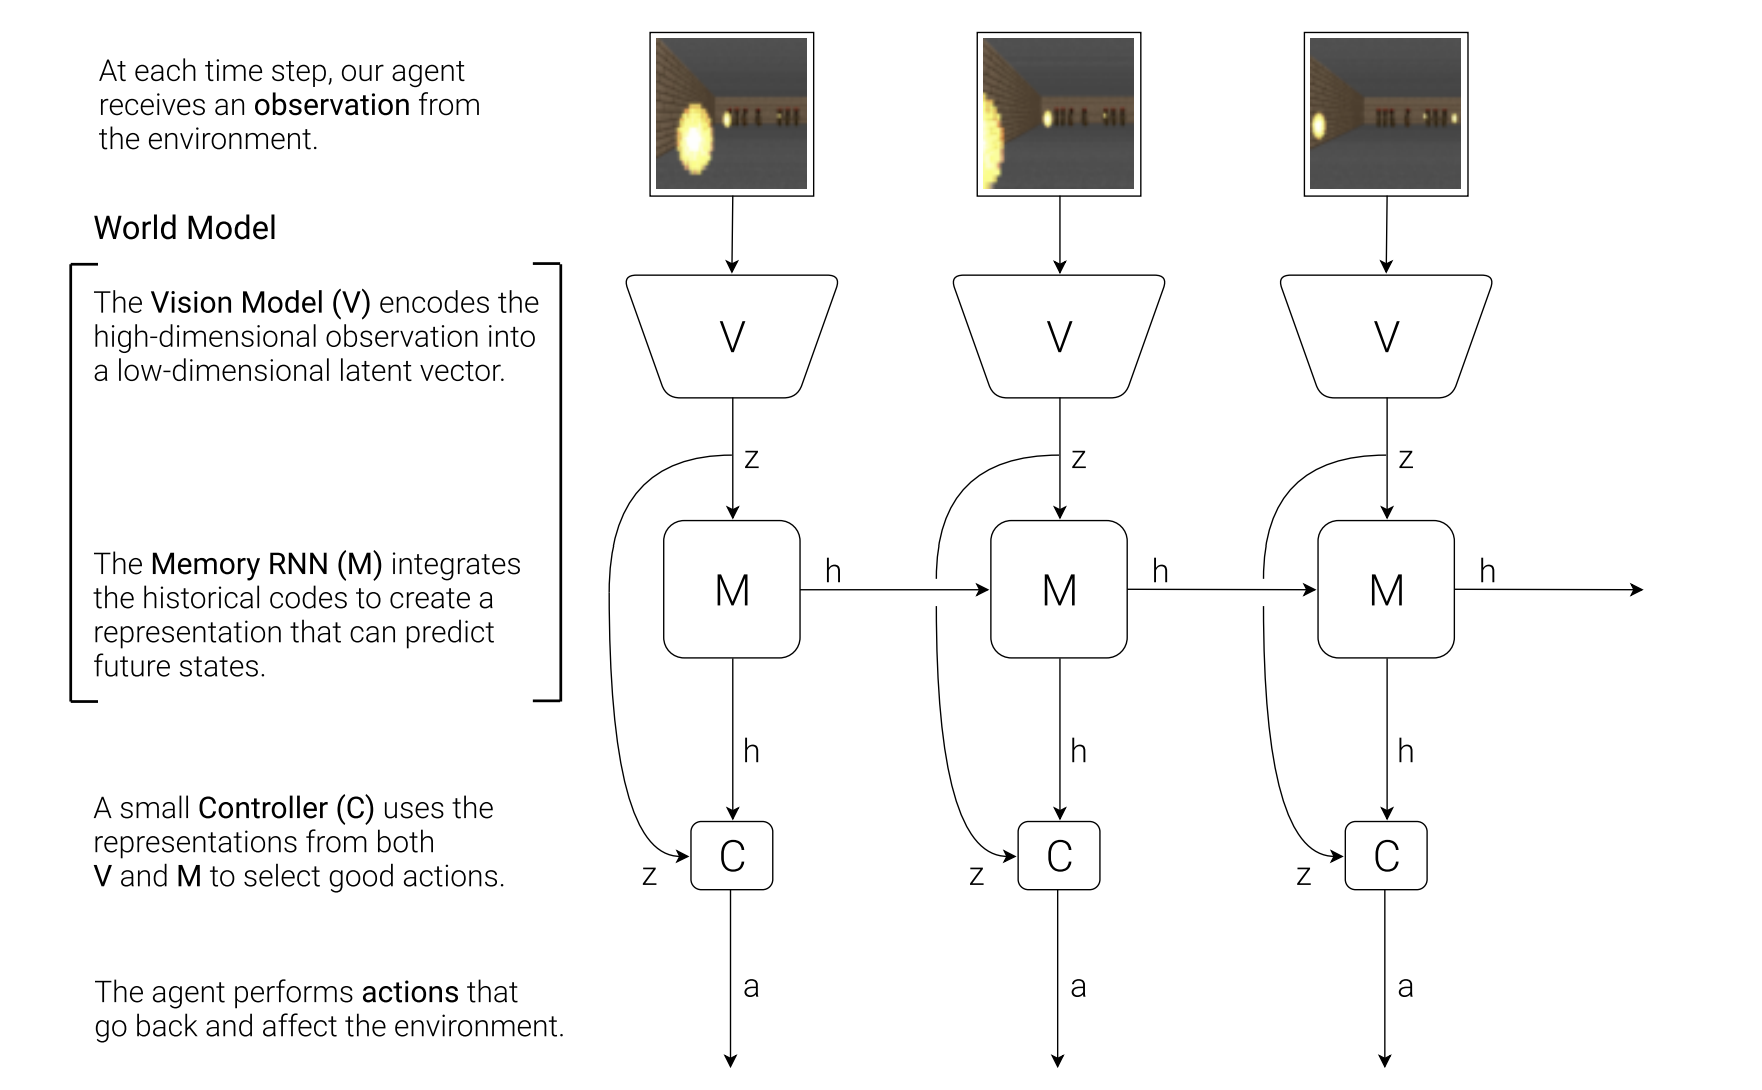
앞서 얘기했듯 모델은 크게 환경을 표현하고 변화를 예측하는 부분과 행동을 결정하는 부분으로 나뉩니다.
이중 V와 M이 환경을 표현하고 예측하는 World Model에 해당합니다.
에이전트가 환경을 관찰하면 V는 현재 화면을 잠재 벡터로 압축합니다.
C는 이 잠재 벡터와 M이 기억하고 있는 과거 정보를 함께 이용하여 행동을 결정합니다.
선택한 행동은 환경에 영향을 주고, M은 현재 관찰과 행동을 반영하여 기억을 갱신합니다.
이 과정이 매 시점 반복됩니다.
V: VAE
V는 관찰된 고차원 데이터를 저차원 데이터로 바꾸는 역할을 합니다.
논문에서는 이를 위해 VAE를 활용합니다.
시점 에서 관찰한 이미지 를 인코더에 입력하면 잠재 변수의 분포를 얻고 이 분포에서 잠재 벡터 를 샘플링합니다.
학습된 는 M과 C의 입력으로 사용됩니다.
따라서 이후 모델들은 수많은 픽셀을 직접 처리하는 대신 작은 잠재 벡터를 이용하여 예측과 행동 결정을 수행할 수 있습니다.
M: MDN-RNN
M은 과거의 환경과 행동을 기억하고 다음 잠재벡터를 예측합니다.
논문에서는 LSTM 기반 RNN에 MDN 출력층을 결합한 MDN-RNN을 사용합니다.
M이 학습하는 대상은 현재 잠재 벡터 , 행동 , 은닉 상태 가 주어졌을 때의 다음 잠재 벡터 의 조건부 확률분포입니다.
환경에는 불확실성이 존재하기 때문에 다음 상황을 하나의 값으로만 예측하면 여러 가능한 결과를 충분히 표현하기 어렵습니다.
따라서 MDN을 이용하여 다음 잠재 벡터의 분포를 가우시안 분포의 혼합으로 모델링합니다.
C: Controller
C는 V와 M이 제공하는 정보를 바탕으로 행동을 결정하는 역할을 합니다.
논문에서는 C를 복잡한 신경망으로 구성하지 않고 두 벡터를 연결한 뒤 선형 변환을 적용하는 간단한 모델로 구성합니다.
C는 에이전트 행동들의 누적 보상이 커지도록 학습합니다.
논문에서는 이를 위해 CMA-ES를 활용합니다.
3. Car Racing
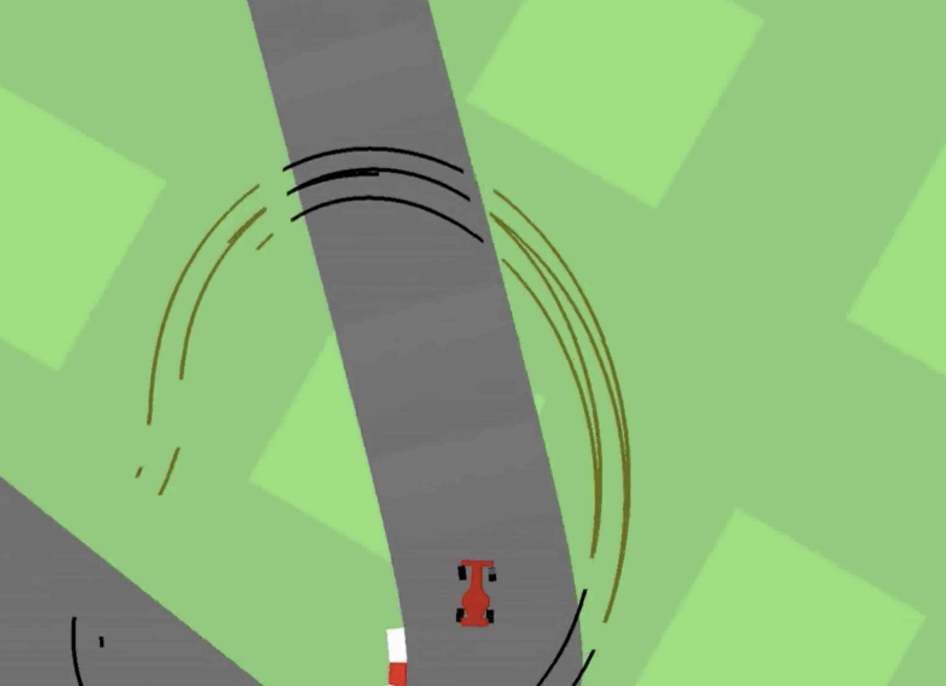
논문에서는 World Model이 학습한 표현이 실제 행동 결정에 도움이 되는지 확인하기 위해 Car Racing 실험을 진행했습니다.
에이전트는 매번 무작위로 생성되는 트랙에서 화면을 관찰하고 조향·가속·제동을 조절하여 주행합니다.
실험에서는 제어기 C가 현재 화면의 잠재 벡터 만 사용하는 경우와,
M의 은닉 상태 까지 함께 사용하는 경우를 비교했습니다.
V MODEL 632 ± 251
FULL WORLD MODEL 906 ± 21
논문에 의하면 다음과 같이
현재 화면의 표현만 사용했을 때는 과제 해결 기준에 도달하지 못했지만
은닉 상태를 함께 사용했을 때는 100회 주행에서 평균 900점이라는 기준을 충족했습니다.
이를 통해 현재 관찰과 함께 미래를 예측하도록 학습한 M의 정보까지 활용하면 단순한 제어기로도 주행 성능을 높일 수 있음을 확인했습니다.
