딥러닝을 배우기 위해서 최소 단위인 단일 신경망 구현에 대해서 배워보겠습니다.
1. 회귀와 분류
1) 회귀
회귀는 실수 값을 예측하는 것을 의미합니다.
가장 간단한 회귀로는 선형 회귀가 있습니다.
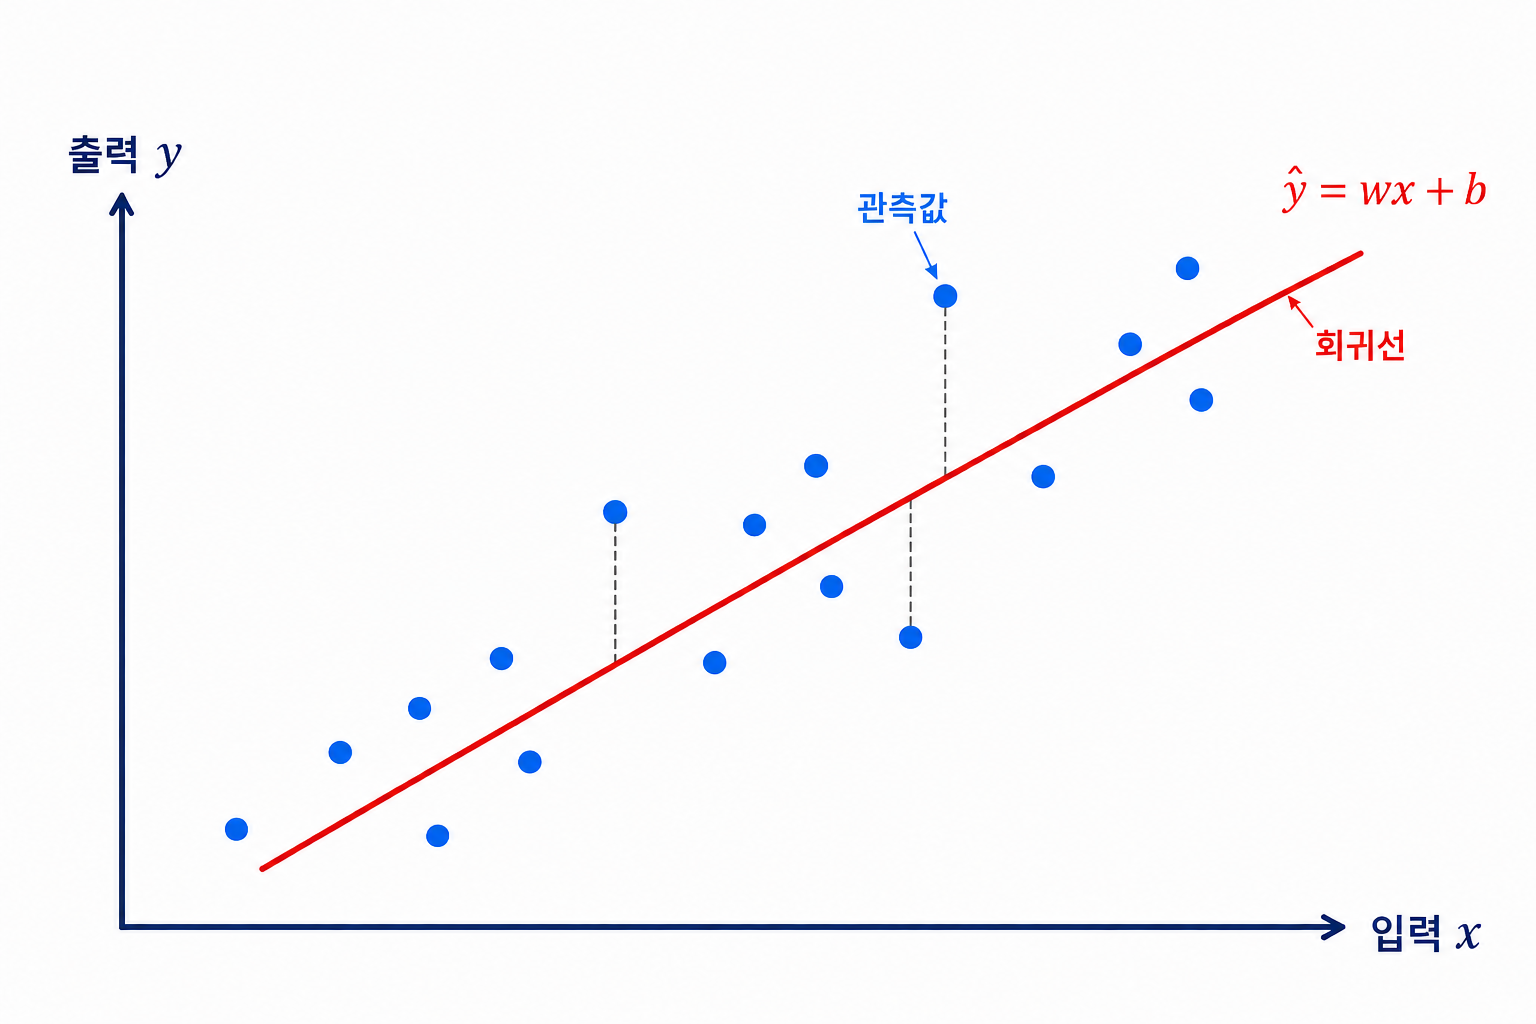
다음 그림처럼 주어진 데이터에 대해서 적절한 실수 값을 내놓는 모델 즉, w(weight), b(bias)를 찾는 것이 머신러닝의 목표입니다.
다음 그림처럼 입력값이 하나(x)인 경우도 있지만
실제로는 더 많은 입력값을 가지는 모델도 있습니다.
그런 경우 w와 x는 단일한 값이 아닌 벡터로 나타내어 집니다.
그런데 w와 x의 연산과 b로 회귀를 수행하였을때 적절한 모델을 만들었는지 어떻게 확인할 수 있을까요.
회귀에서는 실제값과 예측값 사이의 오차가 작은 모델을 좋은 모델이라고 볼 수 있습니다.
실제값을 , 모델의 예측값을 라고 하면 두 값의 차이를 오차라고 합니다.
하지만 여러 데이터의 오차를 그대로 더하면 양수와 음수가 서로 상쇄되어 전체 오차가 작게 나타날 수 있습니다.
따라서 선형 회귀에서는 일반적으로 각각의 오차를 제곱한 뒤 평균을 구하는 평균제곱오차(MSE, Mean Squared Error)를 사용합니다.
여기서 은 전체 데이터의 개수, 는 번째 데이터의 실제값, 는 모델이 예측한 값입니다.
오차를 제곱하면 음수와 양수 오차가 서로 상쇄되지 않으며, 오차가 클수록 더 큰 값을 부여할 수 있습니다.
따라서 평균제곱오차가 작을수록 모델의 예측값이 실제값에 가깝다고 볼 수 있습니다. 단일 신경망은 이 오차가 작아지도록 가중치 와 편향 를 반복해서 수정하며 학습합니다.
이제는 이 w와 b를 어떻게 수정할 건지 알아봅시다.
이를 위해 경사하강법(Gradient Descent)을 사용합니다.
경사하강법은 오차 함수의 기울기를 구하고, 오차가 감소하는 반대 방향으로 와 를 수정하는 방법입니다.
여기서 는 한 번에 값을 얼마나 수정할지 결정하는 학습률(learning rate)입니다.
한 개의 데이터에 대한 오차를 라고 하면 기울기는 다음과 같습니다.
따라서 이 기울기를 기존의 와 에서 빼는 과정을 반복하면 오차가 점차 감소합니다.
2) 분류
회귀가 연속적인 실수 값을 예측하는 문제라면, 분류는 주어진 데이터가 어떤 범주에 속하는지 예측하는 문제입니다.
두 개의 범주 중 하나를 예측하는 문제를 이진 분류(Binary Classification)라고 하며, 일반적으로 두 범주를 과 로 표현합니다.
단일 신경망은 먼저 입력값과 가중치의 선형 결합을 계산합니다.
하지만 는 범위가 정해져 있지 않기 때문에 그대로 확률로 해석하기 어렵습니다. 따라서 이진 분류에서는 를 시그모이드 함수에 통과시킵니다.
시그모이드 함수는 입력값을 과 사이의 값으로 변환합니다. 이 값을 범주 에 속할 확률로 해석할 수 있습니다.
일반적으로 가 0.5보다 크거나 같으면 , 작으면 으로 분류합니다.
이진 분류에서는 실제값 와 시그모이드 함수의 출력 를 비교하기 위해 이진 크로스엔트로피(Binary Cross Entropy)를 사용합니다.
하나의 데이터에 대한 오차 함수는 다음과 같습니다.
실제값이 이면 를 계산하고, 실제값이 이면 를 계산합니다. 따라서 모델이 정답에 가까운 확률을 출력하면 오차가 작아지고, 잘못된 예측을 하면 오차가 커집니다.
전체 데이터에 대한 평균 오차는 다음과 같습니다.
여기서 은 전체 데이터의 개수입니다.
시그모이드 함수와 이진 크로스 엔트로피를 함께 사용하면 손실 함수 L을 선형 출력 z에 대해 미분한 결과가 다음과 같이 간단해집니다.
이를 이용하여 와 의 기울기를 계산합니다.
계산한 기울기와 학습률 를 이용하여 와 를 수정합니다.
이 과정을 여러 번 반복하면 이진 크로스엔트로피가 감소하면서 모델이 데이터를 올바르게 분류하도록 학습됩니다.
이처럼 출력에서 발생한 오차를 이용하여 가중치와 편향의 기울기를 계산하는 과정을 역전파(Backpropagation)라고 합니다.
계산된 기울기는 경사하강법을 통해 모델의 가중치와 편향을 수정하는 데 사용됩니다.
