2. 규제
모델이 훈련 데이터에 지나치게 맞춰지면 새로운 데이터를 정확하게 예측하지 못할 수 있습니다. 이러한 현상을 과대적합(overfitting)이라고 합니다.
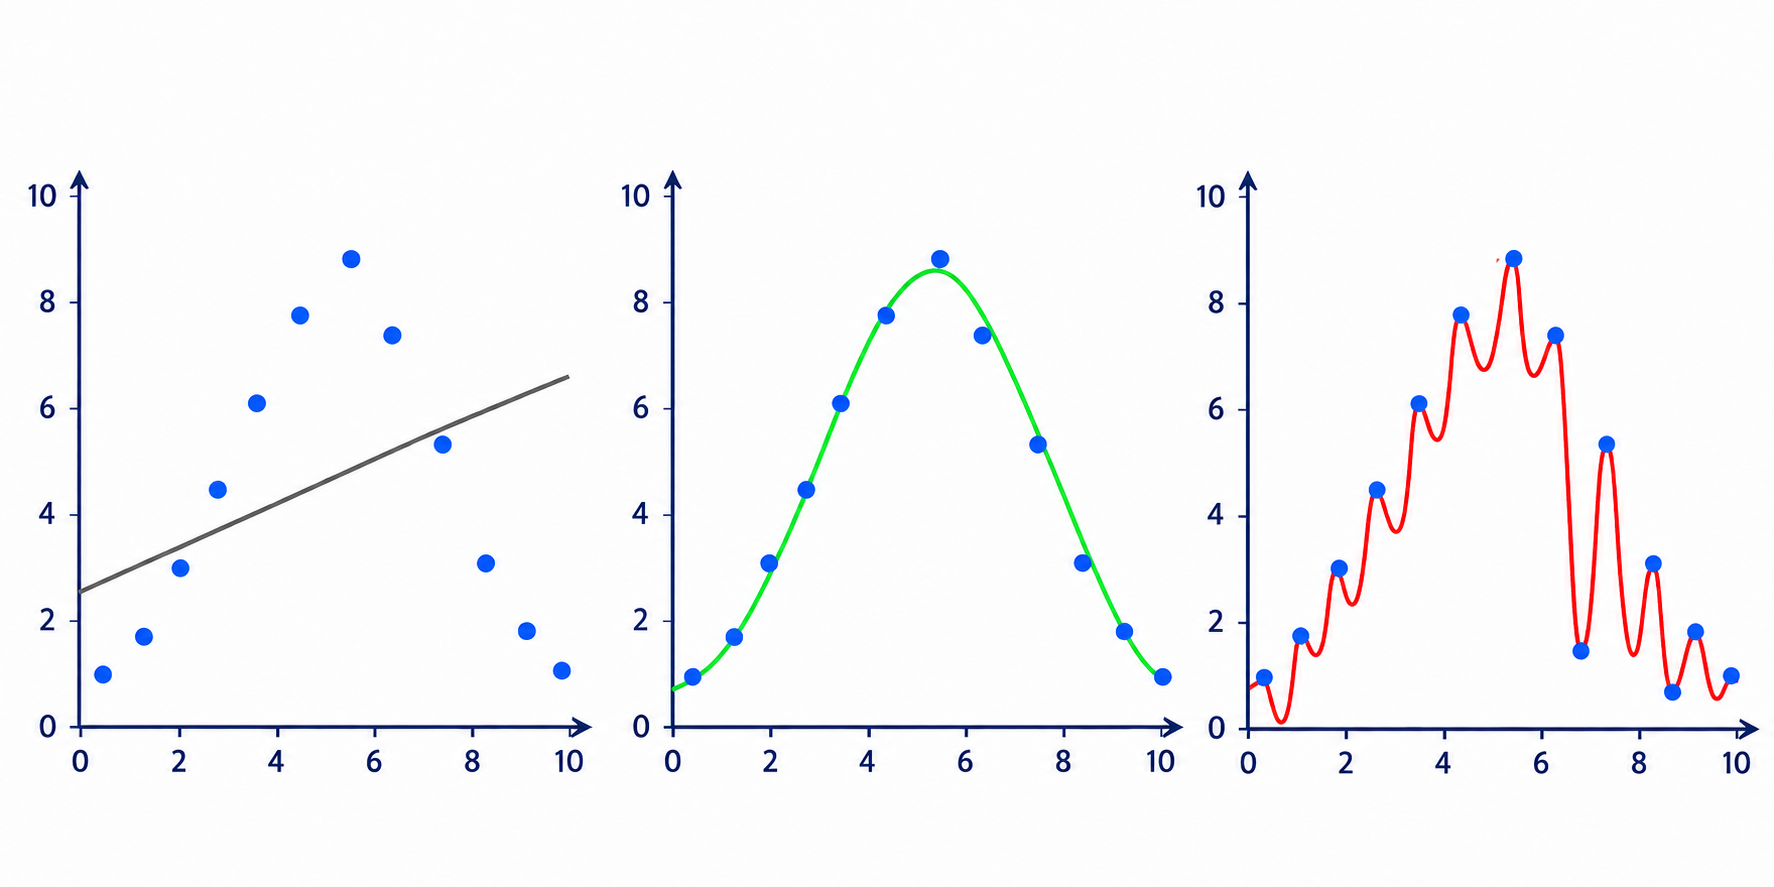
(왼쪽부터 과소적합, 적절한 학습, 과대적합)
과대적합을 줄이기 위해 오차 함수에 가중치의 크기에 대한 페널티를 추가하는 방법을 규제(regularization)라고 합니다.
규제를 적용하면 모델은 데이터의 오차를 줄이는 동시에 가중치가 지나치게 커지지 않도록 학습합니다.
1) L1 규제
L1 규제는 가중치의 절댓값 합을 손실 함수에 추가합니다.
L1 규제는 중요하지 않은 가중치를 0에 가깝게 만드는 특징이 있습니다. 따라서 불필요한 특성의 영향을 줄이는 데 사용할 수 있습니다.
2) L2 규제
L2 규제는 가중치의 제곱 합을 손실 함수에 추가합니다.
L2 규제는 큰 가중치에 더 큰 페널티를 부여하여 가중치가 지나치게 커지는 것을 방지합니다.
L1 규제와 L2 규제를 모두 적용한 전체 손실 함수는 다음과 같습니다.
여기서 과 는 규제의 강도를 결정하는 값입니다. 값이 클수록 규제가 강해지며, 지나치게 크면 모델이 충분히 학습하지 못하는 과소적합이 발생할 수 있습니다.
규제를 적용하면 가중치의 기울기에 다음 값이 추가됩니다.
3. 훈련 손실과 검증 손실
모델을 훈련하려면 데이터가 필요합니다.
하지만 모델을 훈련한 데이터로 다시 평가하면 모델이 데이터를 단순히 외운 경우에도 좋은 성능이 나올 수 있습니다.
따라서 전체 데이터셋을 훈련 데이터(train data)와 검증 데이터(validation data)로 나누어 사용합니다.
훈련 데이터는 모델의 가중치와 편향을 수정하는 데 사용됩니다.
반면 검증 데이터는 학습에 직접 사용하지 않고 모델의 성능을 확인하는 데 사용합니다.
훈련 데이터에서 계산한 오차를 훈련 손실(training loss)이라고 합니다. 모델은 훈련 손실이 감소하도록 가중치와 편향을 반복해서 수정합니다.
검증 데이터에서 계산한 오차를 검증 손실(validation loss)이라고 합니다. 검증 손실을 통해 모델이 학습하지 않은 데이터에서도 잘 동작하는지 확인할 수 있습니다.
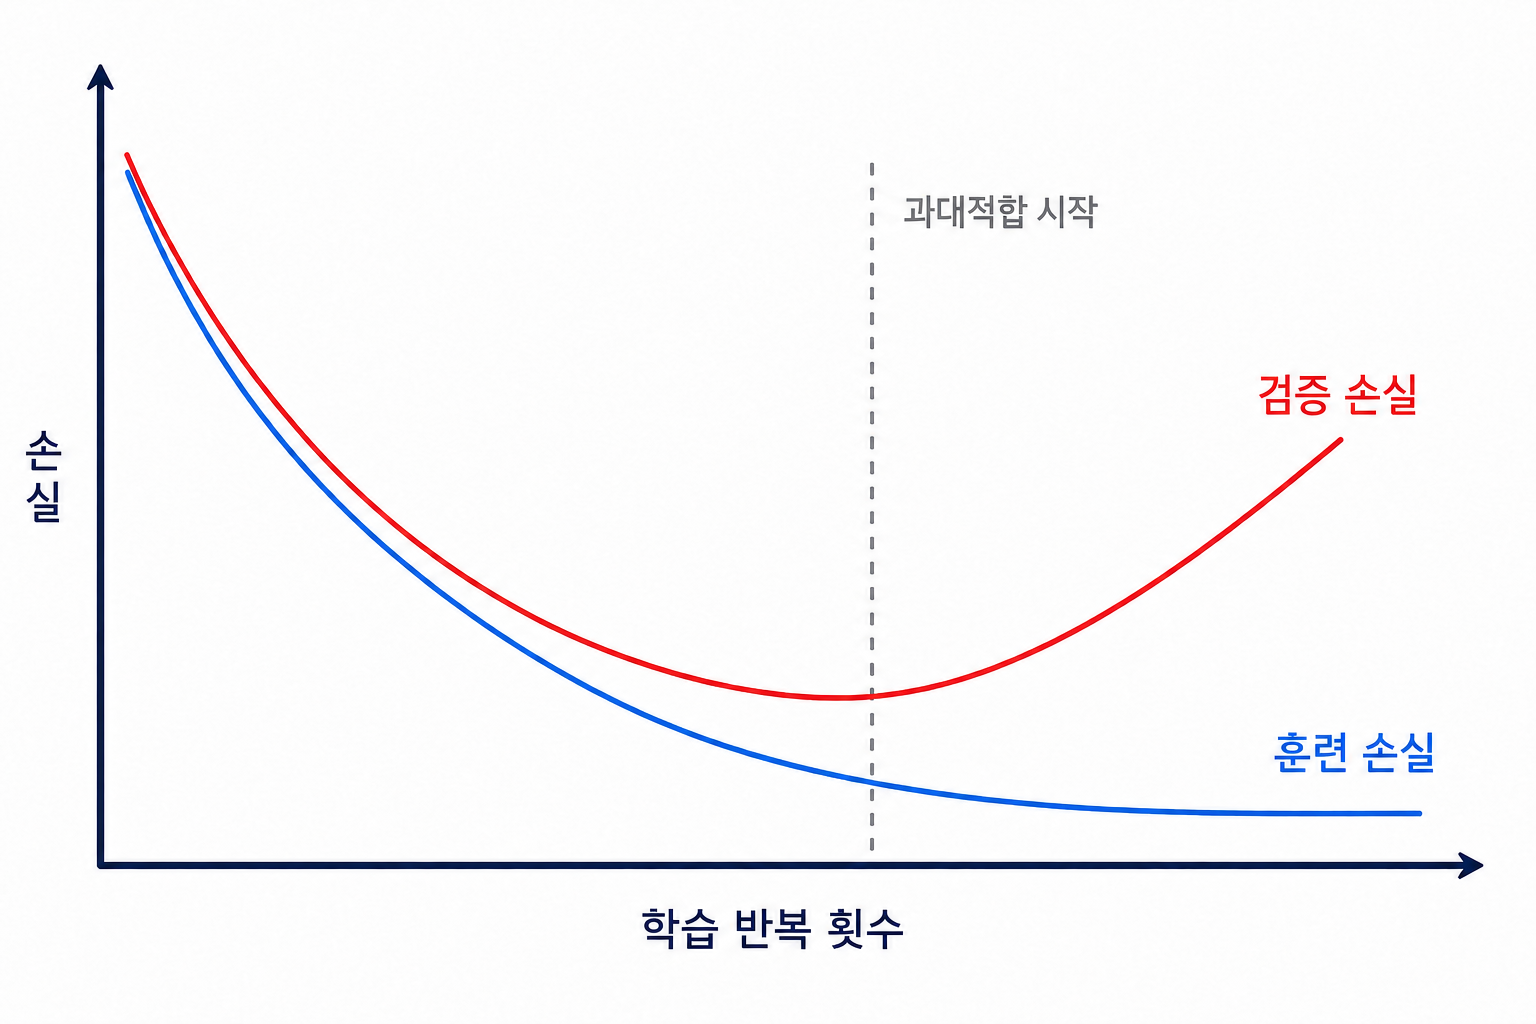
학습이 정상적으로 진행되면 처음에는 훈련 손실과 검증 손실이 함께 감소합니다.
하지만 훈련 손실은 계속 감소하는데 검증 손실이 다시 증가한다면, 모델이 훈련 데이터에 지나치게 맞춰진 과대적합이 발생했다고 볼 수 있습니다.
따라서 훈련 손실과 검증 손실을 함께 확인하면 모델의 학습 상태와 과대적합 여부를 판단할 수 있습니다.
테스트 데이터(test data)는 모델의 학습과 선택이 모두 끝난 뒤 최종 성능을 평가할 때 사용합니다.
상황에 따라 다를 수 있지만 일반적으로는 훈련데이터, 검증데이터, 테스트데이터의 비율을 8:1:1로 정합니다.
