최고의 논문이자, In silico Antibody Engineering의 미래
✅ Abstract
- 연구 배경과 핵심 문제
현재 AI 항체 설계가 충분히 발전하지 못하는 근본적인 이유 중 하나는 정확한 실험적 정답 데이터가 부족하기 때문
특히 여러 돌연변이가 함께 들어갔을 때 항체의 성질이 어떻게 달라지는지를 나타내는 fitness landscape의 epistatic topology를 알고 싶으나,
이를 학습하거나 검증할 만큼 크고 정밀한 데이터가 지금까지 충분하지 않았음
항체 서열을 하나의 지형으로 생각
- 항원 결합력이 높고 생산도 잘되는 항체는 높은 산봉우리
- 결합력이 약하거나 생산이 안 되는 항체는 낮은 골짜기
- 아미노산 돌연변이는 지형 위에서 한 칸씩 이동하는 것
문제는 돌연변이 A와 B가 각각 단독으로는 좋아 보여도, 둘을 함께 넣었을 때 반드시 더 좋아지지는 않는다는 것
-> 이러한 돌연변이 사이의 상호작용이 epistasis
- 17,000개 이상의 데이터로 항체 fitness landscape 구축
DMS를 이용해 단일 아미노산 돌연변이 중 기능을 유지하거나 향상하는 변이들을 선별
그 다음 이러한 기능성 변이들을 여러 방식으로 조합하여, 총 17,000개 이상의 데이터 포인트로 구성된 항체 fitness landscape를 구축
그 결과 항체의 fitness landscape 의 특징
- 매우 울퉁불퉁한 rugged landscape
- 한 단계씩 개선하며 이동하기 어려운 non-navigable landscape
- 여러 돌연변이가 조합될 때 성능이 악화되는 negative epistasis가 광범위하게 존재
-> 각각 좋은 돌연변이를 합쳤는데도 결합력이나 생산성이 크게 떨어지는 경우가 매우 많았음
따라서 “좋은 돌연변이를 하나씩 차례로 추가하면 최적 항체에 도달할 수 있다”는 단순한 전략은 잘 작동하지 않음
- 희귀한 peak cluster 발견
전체 landscape는 대부분 골짜기와 급격한 성능 저하 구간으로 이루어져 있었지만, 대규모로 탐색한 결과 연구진은 매우 드물게 존재하는 peak cluster를 발견
이 peak cluster에 포함된 항체들은 다음 두 성질이 동시에 향상되어 있었음
- affinity
- cellular productivity (Expression)
이는 결합력과 생산성이 항상 서로 상충하는 것은 아니며, 적절한 서열 조합을 찾으면 두 특성을 동시에 개선할 수 있음을 의미
- ProteinMPNN이 생산성 landscape를 예측
ProteinMPNN이 CDR 서열에 의해 결정되는 생산성 landscape를 매우 높은 정확도로 예측
ProteinMPNN은 주어진 단백질 골격 구조에 어떤 아미노산 서열이 잘 맞는지를 평가하거나 설계하는 inverse-folding 계열 모델
이 결과는 항체의 세포 내 생산성이 단순히 항원과 얼마나 잘 결합하는지에 의해 결정되는 것이 아니라, 다음에 크게 좌우된다는 것을 시사
sequence–structure compatibility (서열–구조 적합성)
-> CDR 아미노산 서열이 해당 CDR의 구조적 형태 및 주변 항체 구조와 얼마나 잘 호환되는가
서열–구조 적합성이 cellular productivity를 “gates” 한다
->
- CDR 서열이 항체 구조와 잘 맞으면 세포가 항체를 정상적으로 접고 분비할 수 있다.
- 반대로 구조와 맞지 않으면 항체가 불안정해지고 품질관리 과정에서 제거되어 생산성이 낮아질 수 있다.
- CDR structural fitness: CDR 서열이 항체의 구조적 환경과 얼마나 잘 맞고, 안정적인 형태를 유지할 수 있는지
CDR structural fitness가 항체의 cellular productivity를 결정하는 근본적인 요인이다.
- AlphaFold3와 ProteinMPNN을 이용한 항체 rescue
AlphaFold3: 항체–항원 복합체의 구조 예측
ProteinMPNN: 주어진 항체 구조에 적합한 아미노산 평가 및 제안
결합력은 높지만 생산성이 낮은 항체 (high-affinity, low-productivity clone)을 구조적으로 분석
그 후 구조와 잘 맞지 않는 CDR 위치를 찾아 단 하나의 아미노산만 치환
-> 그 결과 높은 결합력을 대부분 유지하면서 세포 생산성을 회복
복잡한 조합 탐색을 통해 어렵게 얻은 높은 결합력을 포기하지 않고, 생산성 문제만 국소적으로 고칠 수 있음
- 동물 모델에서 20–100배 향상된 효능
fitness landscape의 peak cluster에서 직접 선별한 두 개의 우수 항체 변이체는 건선 유사 마우스 모델에서 기존 항체보다 훨씬 강한 치료 효과
-> 20–100배의 in vivo efficacy gain
✅ Introduction
✅ AI 항체 설계의 가능성과 현재 한계
최근 AI를 이용한 항체 설계는 자연 진화가 아직 탐색하지 못한 서열 공간까지 접근할 가능성을 보여줌
-> 자연계에서 발견되는 항체를 단순히 변형하는 것을 넘어, 새로운 CDR 서열과 항체를 de novo로 설계할 가능성이 생김
하지만 실제 de novo 항체 설계의 성공률은 아직 제한적
AI 모델이 다음을 정확히 예측하지 못하기 때문
- CDR이 실제로 어떤 3차원 구조를 형성하는가
- 그 CDR 구조가 항원과 어떤 방식으로 상호작용하는가
“이 서열은 항원에 잘 붙을 것”이라고 예측하더라도,
실제 세포에서 만들어진 CDR이 예상한 형태로 접히지 않거나 항원 앞에서 다른 형태를 취하면 결합하지 못할 수 있다.
✅ 결합력만 좋아서는 치료용 항체가 될 수 없음
치료용 항체의 성공에는 항원 결합력뿐만 아니라 developability가 함께 최적화되어야 함
- Cellular productivity: 포유류 세포가 해당 항체를 얼마나 잘 생산하고 분비하는가
- Thermal stability: 온도 변화나 열 스트레스에서 항체 구조가 얼마나 안정적으로 유지되는가
아무리 항원에 강하게 결합하더라도 세포에서 거의 만들어지지 않거나 쉽게 변성된다면 실제 치료제로 개발하기 어려움
✅ AI 설계 항체에서 반복되는 생산성 저하 문제
AI 기반 항체 설계에서 자주 발생하는 병목은 높은 결합력을 가진 후보가 포유류 세포에서 매우 낮은 발현량을 보이는 것
-> 높은 affinity를 얻었더라도 실제 제조가 어렵기 때문에 후보 항체의 가치가 X
그런데 이러한 현상은 CDR에 대한 전통적인 관점으로는 쉽게 설명되지는 않음
전통적인 CDR
- 본질적으로 유연한 loop
- 항원을 만나면서 구조가 결정되거나 조정됨
- 생산성보다 항원 인식에 주로 관련됨
이 관점만 따르면 CDR 자체에 항체 생산성을 결정하는 강한 구조적 제약이 존재할 가능성을 생각하기 어려움
CDR은 정말 항원을 만날 때만 구조적 의미를 가지는 유연한 loop인가?
아니면 항원을 만나기 전부터 특정 구조를 형성해야 하며, 그 구조적 적합성이 항체 생산성을 결정하는가?
✅ Multi-dimensional fitness landscape와 epistatic topology
만들고자 하는 것은 단순한 affinity 지도 하나가 아니라 여러 성질을 동시에 나타내는 multi-dimensional fitness landscape
질문 1: Affinity와 developability 사이에는 필연적인 trade-off가 있는가?
질문 2: 적절한 서열 경로를 찾으면 두 특성을 동시에 개선할 수 있는가?
이를 판단하려면 개별 돌연변이 효과뿐 아니라 여러 돌연변이가 결합될 때 나타나는 positive / negative epistatic topology를 알아야 함
✅ 기존에는 landscape를 제대로 그릴 수 없었던 이유
기술적 딜레마
| 방법 | 장점 | 한계 |
|---|---|---|
| Library-scale screening | 매우 많은 서열 탐색 | 정량적 정밀도가 낮음 |
| SPR·DSF 등 | 높은 정밀도 | 발현·정제 때문에 낮은 처리량 |
| 이 연구의 목표 | 대규모 탐색 | 정밀 정량까지 함께 확보 |
✅ SPID 기반 workflow 개발
가장 중요한 장점은 항체나 항원을 개별적으로 정제하지 않고도 KD를 측정할 수 있다는 것
✅ 10개 치료용 항체의 CDR에 대한 DMS 수행
SPID workflow를 이용해 10개의 치료용 항체에 대해 DMS 수행
DMS에서는 CDR의 각 위치를 가능한 다른 아미노산으로 하나씩 바꾸고, 각 단일 치환이 미치는 영향을 측정
- 항원 affinity
- cellular productivity
- thermal stability 관련 성질
✅ 매몰된 CDR 잔기가 생산성에 미치는 영향
CDR의 표면 잔기뿐 아니라 구조 내부에 묻혀 있는 buried CDR residue가 항체의 세포 생산성에 큰 영향을 준다는 사실을 발견
그리고 그 영향은 잔기가 구조 내부에 더 깊이 묻혀 있을수록 커지는 depth-dependent pattern을 보임
이러한 양상은 일반적인 접힌 globular protein의 내부 잔기에서 관찰되는 구조적 제약과 유사
단백질 내부에 있는 아미노산은 주변 잔기들과 촘촘하게 맞물려 구조를 지탱
-> 내부 아미노산을 부적절하게 바꾸면 단백질 전체가 제대로 접히지 않을 수 있음
-> CDR도 단순히 표면에서 흔들리는 자유로운 loop가 아니라, 일부 잔기는 항체 구조 안에서 정교하게 맞물리며 생산성에 영향을 준다는 것을 보여줌
✅ 단일 돌연변이를 넘어 조합 landscape로 확장
DMS는 기본적으로 단일 아미노산 변화의 효과를 분석
그러나 실제 항체 최적화에서는 여러 돌연변이를 동시에 도입
따라서, 단일 변이 데이터에서 다음을 구분
- Functional variation: 기능을 유지하거나 향상하는 변이
- Destructive variation: 기능을 손상시키는 변이
그 후 기능성 단일 변이들을 adalimumab에 여러 조합으로 도입
✅ Adalimumab의 rugged fitness landscape
기능성 단일 변이들만 골라 조합했음에도, adalimumab의 조합 landscape는 매우 울퉁불퉁했음
-> 대부분의 조합에서 negative epistasis
개별적으로는 기능을 유지하거나 개선했던 돌연변이들이 함께 들어갔을 때 affinity 또는 productivity를 저하시킴
-> 항체 sequence space가 단순히 좋은 돌연변이를 누적해 갈 수 있는 부드러운 언덕이 아니라는 것을 의미
전통적인 점진적 최적화에서는 현재 항체보다 좋아진 돌연변이만 선택하고 다음 단계로 넘어간다.
하지만 최종적으로 매우 우수한 항체에 도달하려면 중간에 일시적으로 성능이 낮아지는 구간을 통과해야 할 수 있다.
그러면 “항상 더 좋은 변이만 선택하는 방식”으로는 최종 peak에 도달할 수 없다.
✅ 드문 positive-epistasis cluster 발견
Landscape 전체에서는 negative epistasis가 우세했지만, 드물게 positive-epistasis cluster 도 존재
-> 이 영역에서는 특정 돌연변이 조합이 예상보다 좋은 효과를 나타내면서 affinity, productivity 특성이 동시에 향상
affinity와 productivity 사이에 필연적인 trade-off만 존재하는 것이 아니라, 서열 공간의 매우 제한된 영역에서는 두 특성을 함께 높일 수 있음을 보여줌
✅ ProteinMPNN을 생산성 예측 모델로 활용
항체 조합 서열을 ProteinMPNN으로 평가
ProteinMPNN은 원래 주어진 단백질 backbone에 적합한 아미노산 서열을 설계하는 딥러닝 모델
ProteinMPNN 점수는 실험으로 측정한 productivity landscape를 예상보다 매우 정확하게 예측
-> CDR의 서열이 해당 backbone 구조 및 주변 항체 구조와 얼마나 잘 맞는지가 포유류 세포에서의 항체 생산성을 결정하는 핵심 요인
✅ High-affinity, low-productivity 항체의 구조 기반 rescue
결합력은 크게 향상되었지만 생산성이 낮아진 항체들을 구조적으로 구제할 수 있는지 시험
- AlphaFold3로 항체–항원 복합체 구조 예측
- 결합에 중요한 CDR 잔기 식별
- 항원이 없는 상태에서 구조와 잘 맞지 않는 CDR 잔기 탐색
- ProteinMPNN이 구조적으로 선호하는 아미노산으로 치환
- 항원 결합을 유지하면서 생산성 회복 여부 측정
그 결과 단일 아미노산 치환만으로 여러 high-affinity, low-productivity clone의 생산성을 회복
중요한 점은 생산성을 높이는 과정에서 기존에 어렵게 얻은 항원 결합 특성을 손상시키지 않았다는 것
✅ Peak에서 선별한 두 항체의 생체 효능
positive-epistasis peak cluster에서 선별한 두 개의 adalimumab 변이체를 건선 유사 마우스 모델에 투여
두 변이체는 부모 adalimumab보다 20–100배 낮은 투여량으로 유사하거나 더 강한 치료 효과
-> 이러한 큰 효능 향상은 단순히 equilibrium affinity가 높아졌기 때문만은 아니었음
항체–TNF-α 복합체의 수명이 크게 증가한 데 있음
- Equilibrium affinity: 평형 상태에서 항체와 항원이 얼마나 결합해 있는가
- Complex lifetime 또는 residence time: 한번 결합한 항체가 항원에서 떨어지지 않고 얼마나 오래 머무는가
두 변이체는 평형 결합력의 개선 정도보다 실제 생체 효능이 훨씬 크게 증가
-> 한번 TNF-α를 잡은 후 오랫동안 놓지 않는 특성이 치료 효과를 크게 높였음을 뜻함
✅ Results
✅ Generating precision antibody data at scale with SPID
주목할 점은 대부분의 항원을 정제 단백질이 아니라 full-length, unpurified form으로 측정했다는 것
막단백질의 경우에는 transmembrane domain도 유지
-> 항원이 복잡한 상태에서도 원래의 구조적 epitope 관계를 유지하고 있음을 뒷받침
✅ SPID를 이용한 pilot DMS
각 위치에서는 자연적으로 존재하는 아미노산을 사용하되 cysteine은 제외
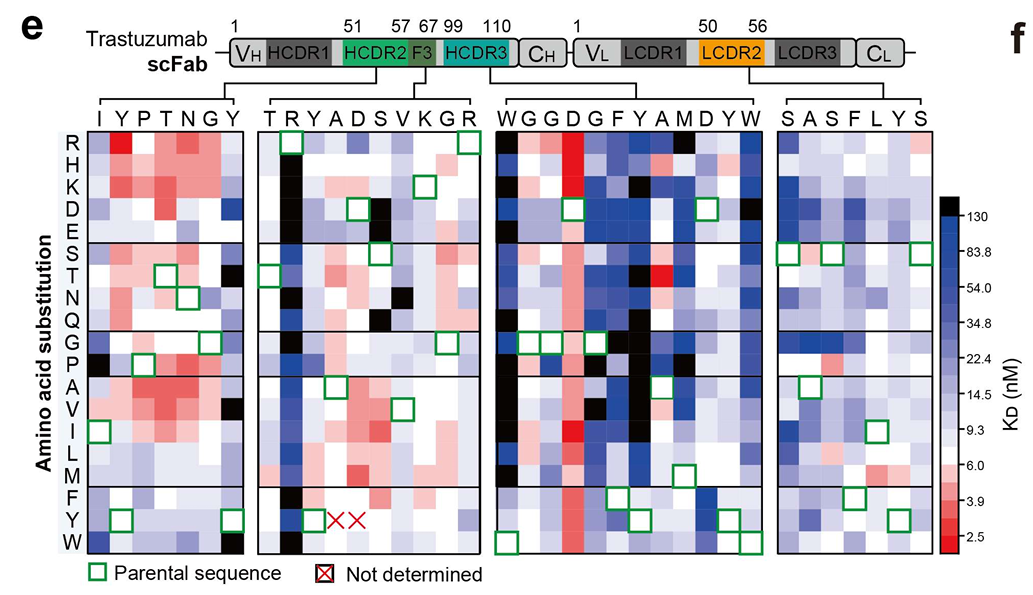
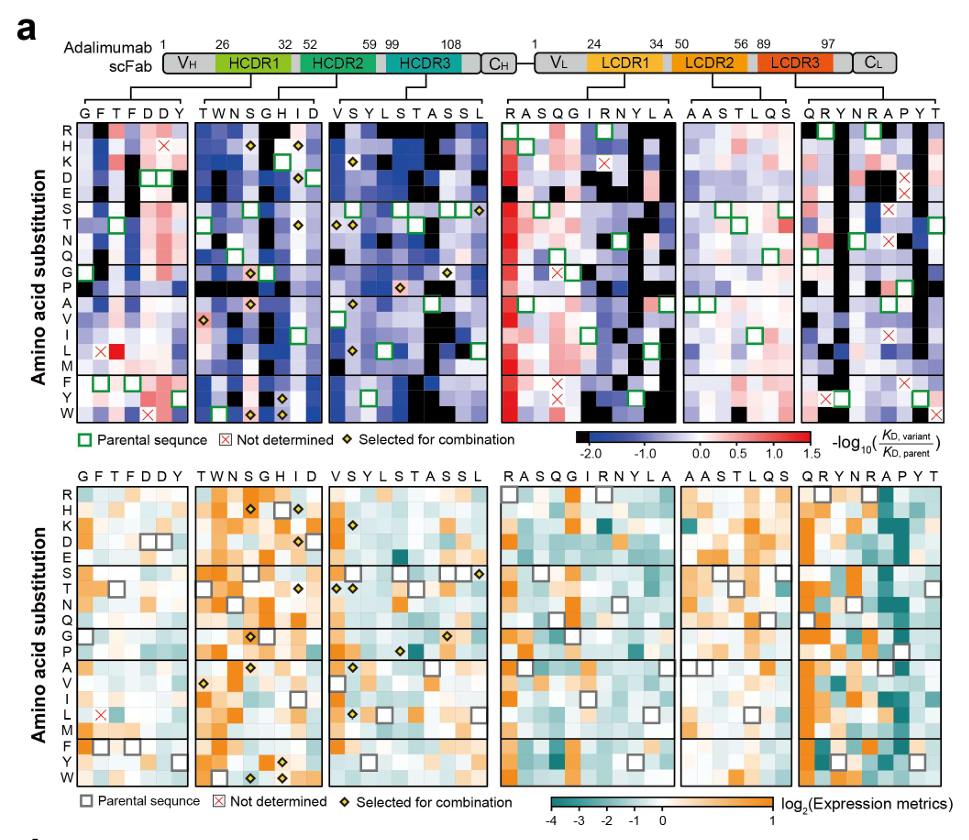
Figure 1e와 Figure 2a의 affinity heatmap에서는 다음 경향이 나타남
-
HCDR3에 짙은 파란색과 검은색이 많이 존재
-> HCDR3 변이가 항원 결합을 크게 떨어뜨리거나 완전히 제거하는 경우가 많음
-> HCDR3는 두 항체 모두에서 항원 인식의 핵심 영역 -
다른 위치에는 흰색과 비교적 약한 빨간색·파란색이 섞여 있음
-> 다른 CDR의 상당수 변이는 affinity에 점진적인 영향을 줌
-> 다른 CDR이나 framework 위치의 변이도 모두 무해한 것은 아니며, 어떤 변이는 affinity를 증가시키거나 감소시켰음
추가적으로 Figure 2a 를 보면 Affinity와 expression heatmap의 패턴이 서로 일치하지 않음
✅ Cellular productivity 측정
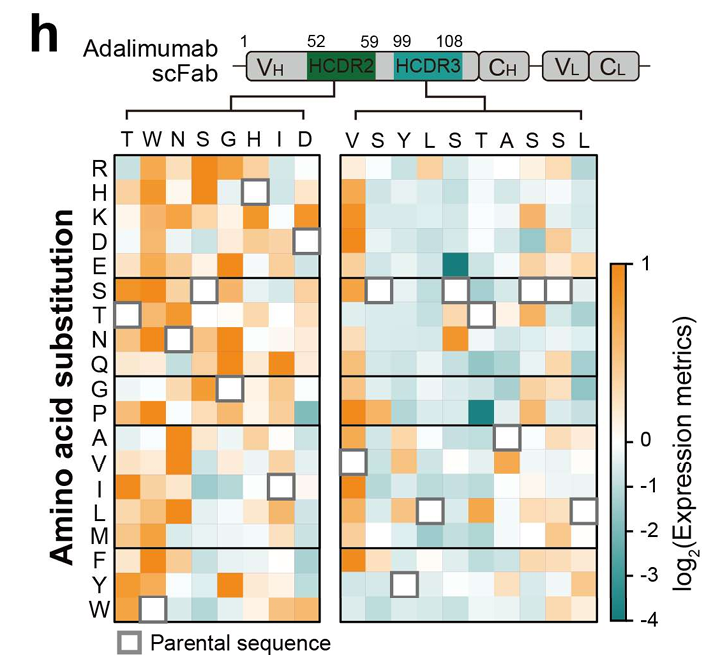
Figure 1h: adalimumab scFab의 각 CDR 단일 변이에 대한 expression heatmap
- 주황색 방향: 부모 항체보다 높은 expression
- 청록색 방향: 부모 항체보다 낮은 expression
- 흰색: 부모 항체와 유사
- 녹색 테두리: parental amino acid
-> 하나의 CDR 아미노산만 바꾸어도 cellular productivity가 크게 달라질 수 있음을 보여줌
✅ 소규모 SPID expression metric이 대규모 생산성을 예측
SPID에서 얻은 expression metric이 실제 산업적 항체 생산성과 연결되는지를 검증하기 위해 19종의 IgG 항체를 비교
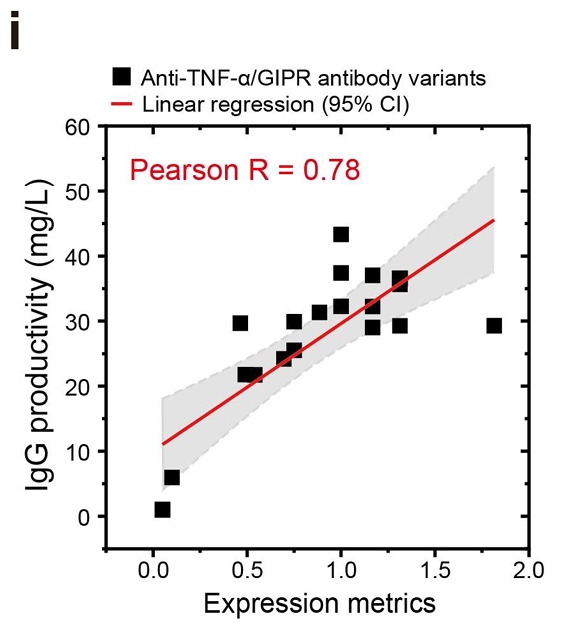
Figure 1i: SPID expression metric과 대규모 배양의 IgG 생산량 사이의 상관관계
-> R=0.78
96-well 또는 유사한 소규모 조건에서 얻은 SPID 단일분자 항체 count가,
나중에 훨씬 큰 배양 규모에서 얼마나 많은 IgG가 생산될지를 조기에 추정할 수 있다는 것
-> 개발 초기에 productivity가 낮은 clone을 식별하는 유용한 screening 지표
✅ Deep mutational scanning of therapeutic antibody CDRs
항원 결합 구조가 알려진 10개의 FDA 승인 치료용 항체에 대해 CDR deep mutational scanning을 수행
분석한 CDR 잔기: 324개
분석한 CDR: 33개
측정한 단일 아미노산 치환: 5,832개
Cysteine 치환: 제외
✅ 각 항체는 고유한 DMS fingerprint를 가짐
여러 항체에서 공통적으로 관찰된 특징은 HCDR3에 affinity를 완전히 제거하는 변이가 많이 존재한다는 것
하지만 세부적인 DMS heatmap은 항체마다 매우 달랐음
같은 항원을 표적으로 하거나 비슷한 epitope에 결합하는 항체라도, 어떤 CDR 위치가 변이를 허용하고 어떤 위치가 민감한지는 항체마다 다르다.
- Pembrolizumab과 nivolumab 비교
Pembrolizumab과 nivolumab은 모두 PD-1에 결합하며 서로 겹치는 epitope를 인식
하지만 두 항체는 다음 차이를 가짐
- HCDR3 길이가 서로 다름
- 각 위치의 affinity DMS 패턴이 다름
- expression DMS 패턴도 다름
두 항체가 같은 항원의 비슷한 부위를 인식하더라도, CDR 서열과 framework 사이의 구조적 관계가 다르기 때문에 변이에 대한 허용성도 서로 다르다.
- Cetuximab과 panitumumab 비교
Cetuximab과 panitumumab은 모두 EGFR을 표적으로 하며 겹치는 epitope에 결합
- 두 항체의 HCDR3 DMS profile도 뚜렷하게 달랐음
- expression-sensitive 위치의 mutation 분포 역시 두 항체에서 동일하지 않았음
따라서 항원 또는 epitope만 보고 특정 CDR 돌연변이의 효과를 일반화하기 어렵다.
변이의 효과는 “어떤 항원에 결합하는가”뿐 아니라
“그 CDR이 해당 항체의 전체 구조 안에서 어떤 환경에 놓여 있는가”에 따라 달라진다.
✅ 대부분의 단일 변이는 affinity를 향상시키지 못함
전체 5,832개 단일 치환을 분석했을 때, 대부분의 변이는 항원 affinity를 향상시키기보다 손상시켰음
Functional variants: 부모 항체와 비교하여 affinity를 유지하거나 향상시킨 단일 아미노산 변이
-> 이 functional variant들을 어떤 물리화학적 성질의 치환이 기능을 보존할 가능성이 높은지를 분석
✅ 비슷한 물리화학적 성질로 바꾸면 기능이 보존될 가능성이 높음
아미노산을 물리화학적 특성에 따라 여러 group으로 나눔
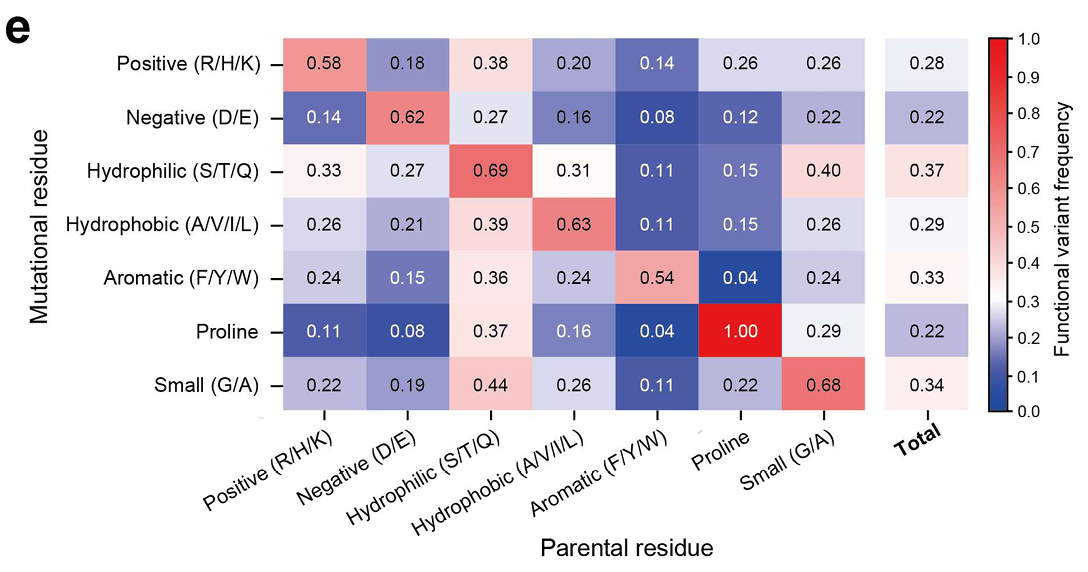
- 양전하: Arg, His, Lys
- 음전하: Asp, Glu
- 친수성: Ser, Thr, Gln
- 소수성: Ala, Val, Ile, Leu
- 방향족: Phe, Tyr, Trp
- Proline
- 작은 잔기: Gly, Ala
원래 아미노산과 같은 물리화학적 group에 속하는 아미노산으로 치환했을 때 functional variant가 될 확률이 가장 높았음
(각 칸의 숫자가 해당 유형의 치환 중 affinity를 유지하거나 향상시킨 변이의 비율)
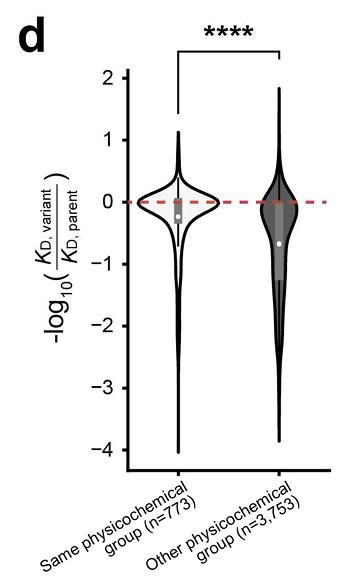
Figure 2d의 violin plot에서도 같은 group 내 치환이 다른 group 간 치환보다 affinity 손상이 적었음
✅ 친수성 아미노산으로의 치환이 높은 성공률을 보임
치환 후 들어가는 아미노산의 특성별 functional variant 빈도
- 친수성 잔기: 0.37
- 양전하 잔기: 0.28
- 음전하 잔기: 0.22
- 소수성 잔기: 0.29
- 방향족 잔기: 0.32
친수성 아미노산으로 치환했을 때 affinity를 유지하거나 향상시킬 확률이 가장 높았음
개별 아미노산 중에서는 다음 두 잔기가 특히 높은 성공률을 보였음
- Serine: 0.42
- Threonine: 0.37
단백질–단백질 결합면에서는 큰 소수성 잔기나 방향족 잔기가 결합의 핵심이 된다고 흔히 생각
하지만 항체 paratope의 정교한 국소 환경에서는 항상 큰 잔기가 유리한 것이 아니었음
Ser과 Thr처럼
- 크기가 작고
- 수소결합을 만들 수 있으며
- 주변 구조에 적응하기 쉬운
잔기가 기존 결합을 유지하거나 새로운 유리한 상호작용을 형성할 수 있음
“affinity를 높이려면 큰 방향족 잔기를 넣어야 한다”와 같은 단순한 설계 규칙이 보편적으로 적용되지 않음을 뜻함
✅ Cellular productivity도 비슷한 성질의 치환에 더 관대함
Affinity뿐 아니라 cellular productivity에서도 같은 물리화학적 group 내 치환이 더 높은 허용성을 보였음
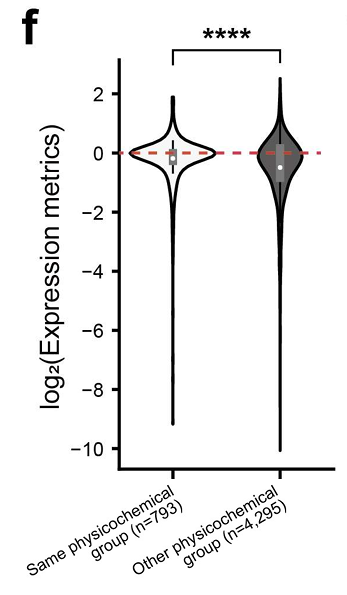
Figure 2f에서 같은 group 내 치환 / 다른 group으로의 치환을 비교하면, 같은 group 내 치환의 expression 감소가 전반적으로 더 작았음
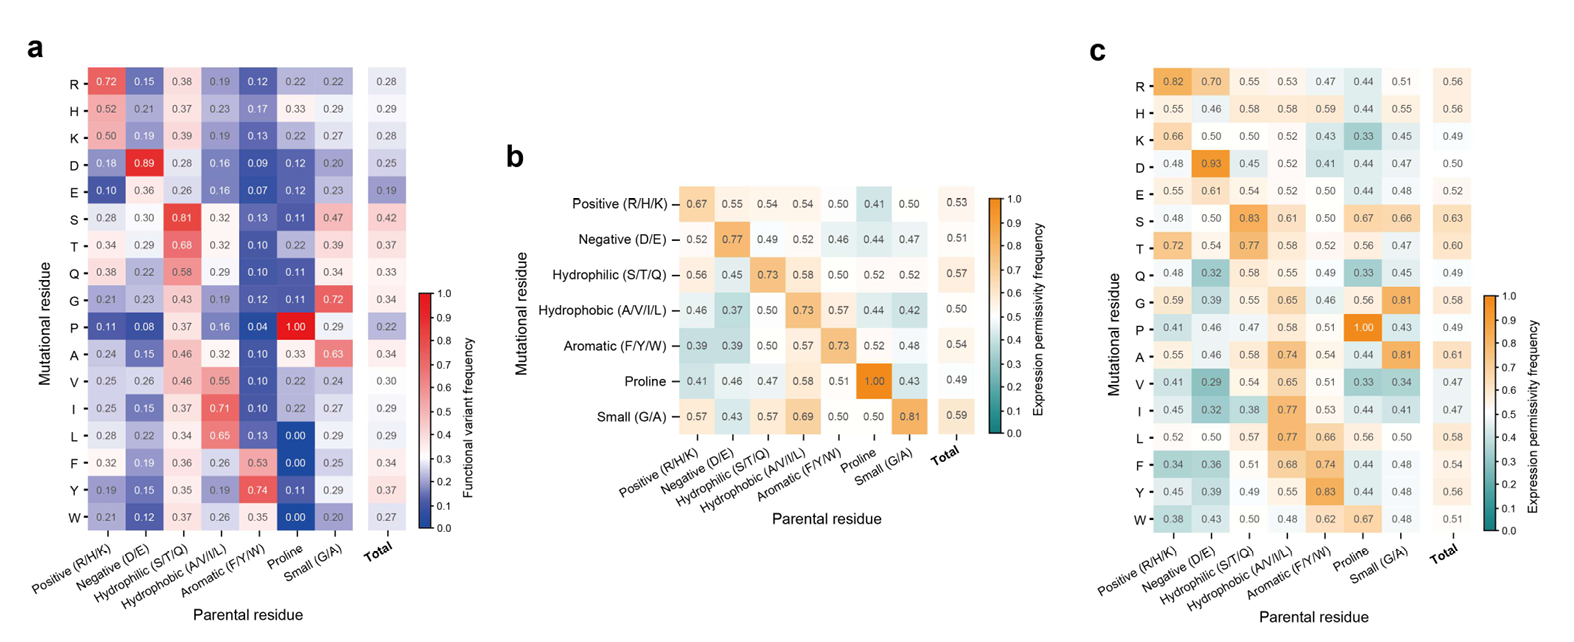
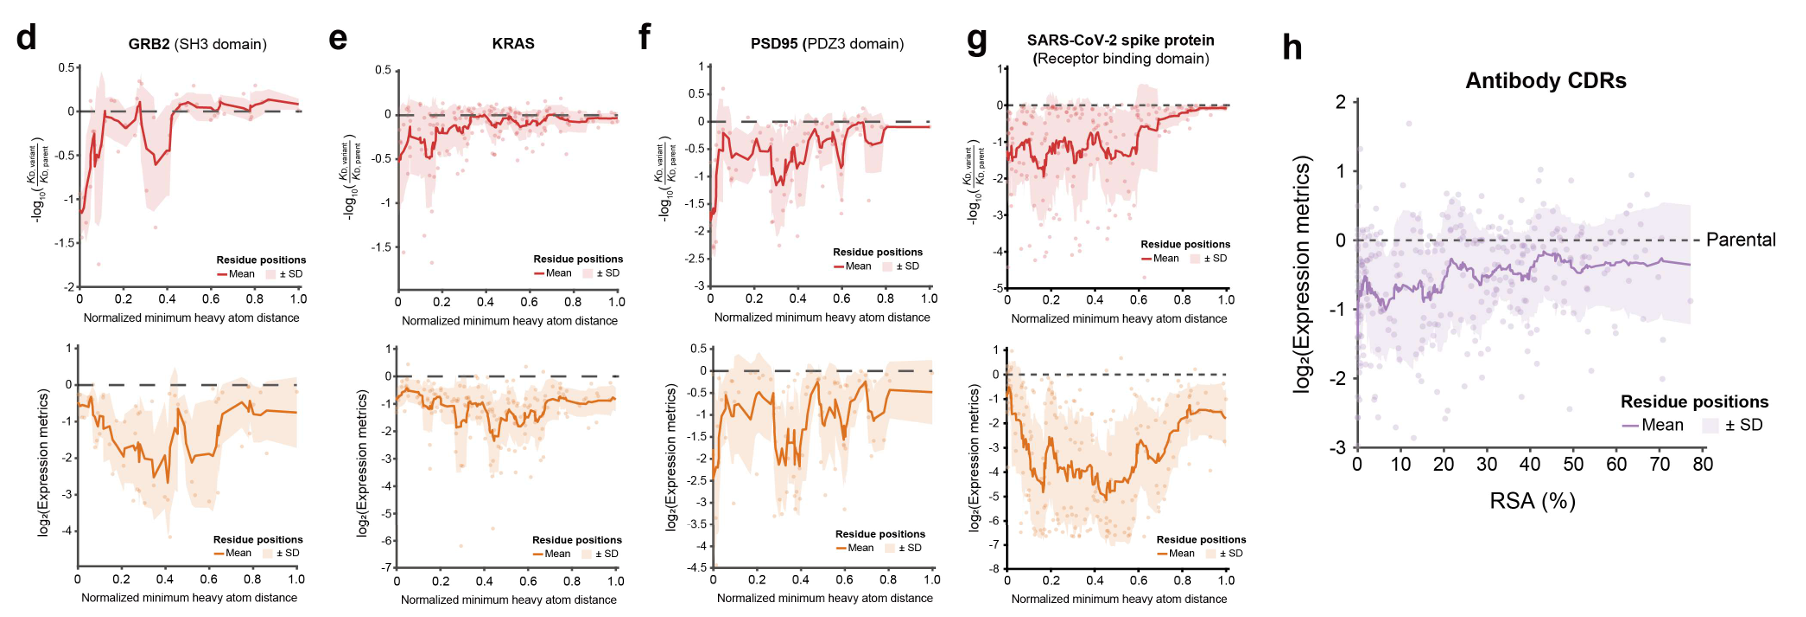
Extended Data Fig. 5
a: 아미노산 종류별 affinity functional variant 빈도
b: 물리화학적 group별 expression permissivity
c: 개별 아미노산별 expression permissivity
d–g: 개별 globular protein의 거리 의존적 DMS 결과
h: 항체 CDR의 RSA와 expression 사이 관계
하지만 같은 group 내 치환이 항상 안전한 것은 아니었음
Pembrolizumab과 cetuximab에서 보듯이 CDR의 단 한 잔기만 바꾸어도 cellular productivity가 크게 감소할 수 있었음
✅ Affinity와 productivity는 거의 상관되지 않음
5,443개의 CDR 변이체에 대해 affinity 변화와 expression 변화를 서로 비교
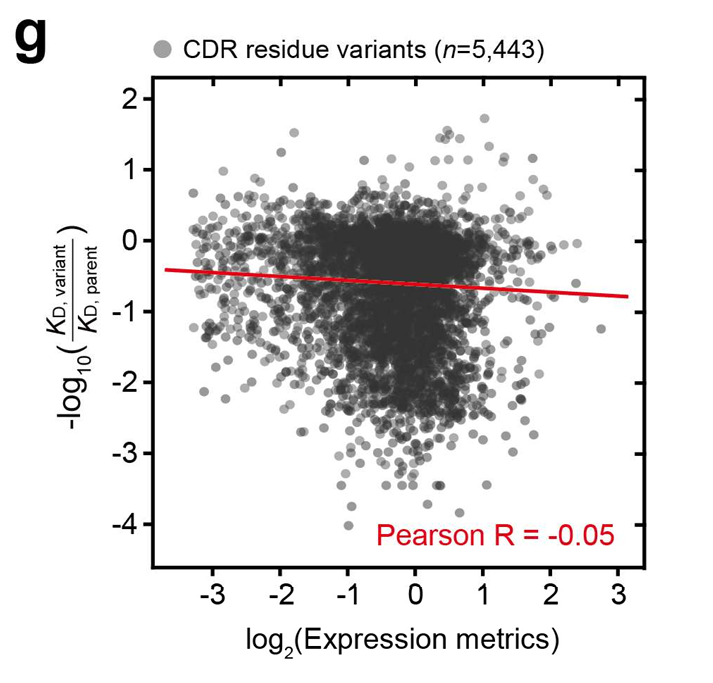
Figure 2g
Pearson R=−0.05
-> 유의미한 선형 상관관계가 없음
개별 변이는 두 성질에 동시에 영향을 줄 수 있음
다만 전체 변이 데이터를 보면
- affinity가 증가한 변이가 반드시 expression도 증가하지 않고
- affinity가 감소한 변이가 반드시 expression도 감소하지 않으며
- 두 성질을 결정하는 주된 물리적 원리가 서로 다르다
는 것
-> 두 fitness trait가 orthogonal하다
✅ Orthogonality가 중요한 이유
Affinity와 productivity의 fitness cliff가 서로 같은 위치에 있다면, affinity를 높이는 변이가 언제나 productivity를 낮추는 필연적인 trade-off가 생길 수 있음
하지만 두 landscape가 서로 다른 규칙으로 결정된다면 다음이 가능
- affinity를 높이면서 productivity를 유지
- productivity를 회복하면서 affinity를 유지
- 두 성질이 모두 높은 sequence region 탐색
-> 높은 affinity 때문에 생산성이 낮아진 항체도, 결합에 중요하지 않은 다른 위치를 고쳐 생산성만 회복할 가능성이 생김
(뒤의 ProteinMPNN 기반 HALP clone rescue 전략의 근거)
✅ 항원으로부터의 거리와 affinity 영향
항원 결합 구조가 알려진 10개 항체의 324개 CDR 잔기에 대해, 각 잔기와 항원 사이의 거리를 계산
- 거리: CDR 잔기의 원자와 항원 원자 사이의 최소 heavy-atom distance (in antigen-bound structure)
- Heavy atom: 수소를 제외한 탄소, 질소, 산소 등의 원자
각 위치의 모든 단일 치환 효과를 평균하여 항원과의 거리에 따른 affinity 변화를 분석
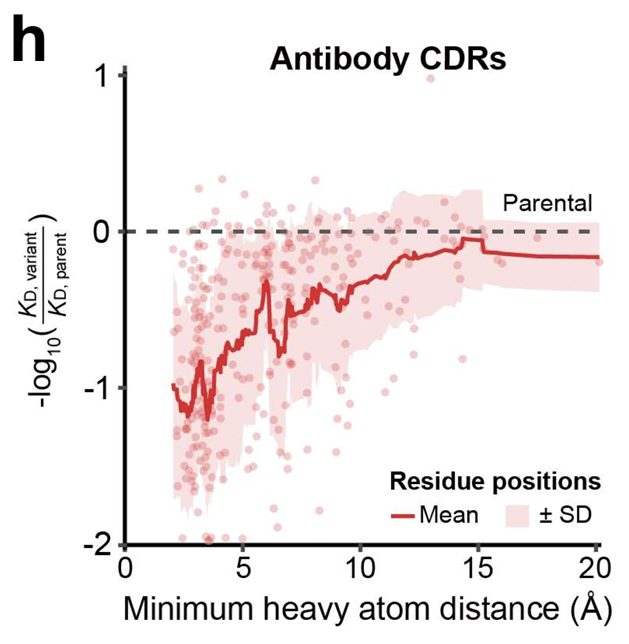
Figure 2h
- 항원 바로 근처에 있는 CDR 잔기: 변이 시 affinity 손실이 가장 큼
- 항원에서 멀어질수록: 평균 affinity 손실이 감소
- 충분히 먼 위치: 부모 항체에 가까운 수준
항원과 직접 접촉하는 잔기는 수소결합, 정전기적 상호작용, 소수성 접촉 등을 형성하므로 치환에 매우 민감
✅ 항원으로부터의 거리와 productivity 영향
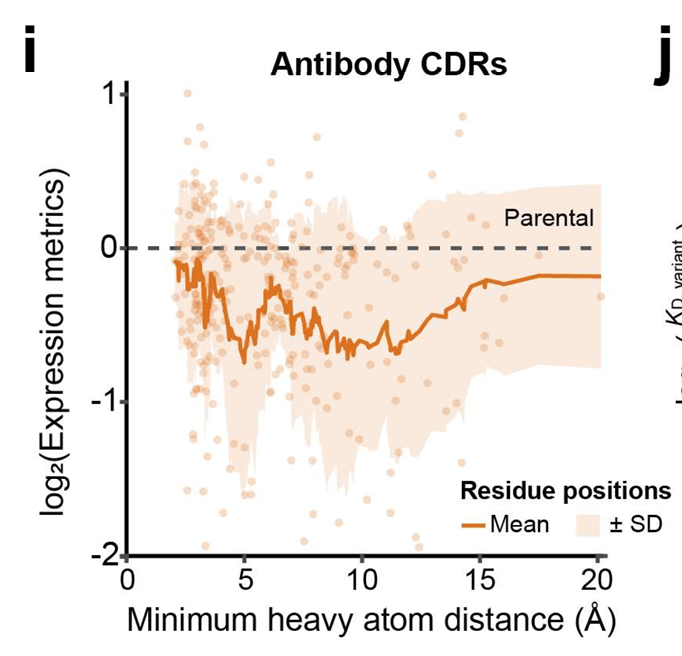
Figure 2i
productivity는 affinity와는 반대의 거리 의존성을 보임
- 항원에 가장 가까운 표면 노출 잔기에서는 평균 productivity 손상이 상대적으로 작았음
- 반면 항원 결합면에서 약 5–10 Å 떨어진 CDR 잔기에서 broad valley가 나타났음
-> 해당 거리 구간의 잔기를 바꾸었을 때 expression이 크게 감소하는 경향이 있었음
왜 5–10 Å 위치가 중요한가?
항원과 직접 맞닿는 최외곽 잔기들은 대체로 solvent에 노출되어 있음
이 잔기들은 항원 인식에는 중요하지만, 항체 자체의 내부 구조를 지탱하는 역할은 상대적으로 작을 수 있음
반면 항원에서 약간 뒤쪽에 있는 잔기들은
- CDR loop 내부
- 인접 CDR
- 항체 framework
와 접촉하면서 CDR의 구조를 지지할 수 있음
따라서 이러한 잔기를 부적절하게 바꾸면 항원 결합면 자체보다 먼저 항체 folding이나 cellular processing이 손상되어 생산성이 낮아질 수 있음
✅ Globular protein과 유사한 패턴
CDR은 흔히 유연한 표면 loop로 간주되지만, 관찰된 패턴은 일반적인 globular protein의 구조적 제약과 비슷
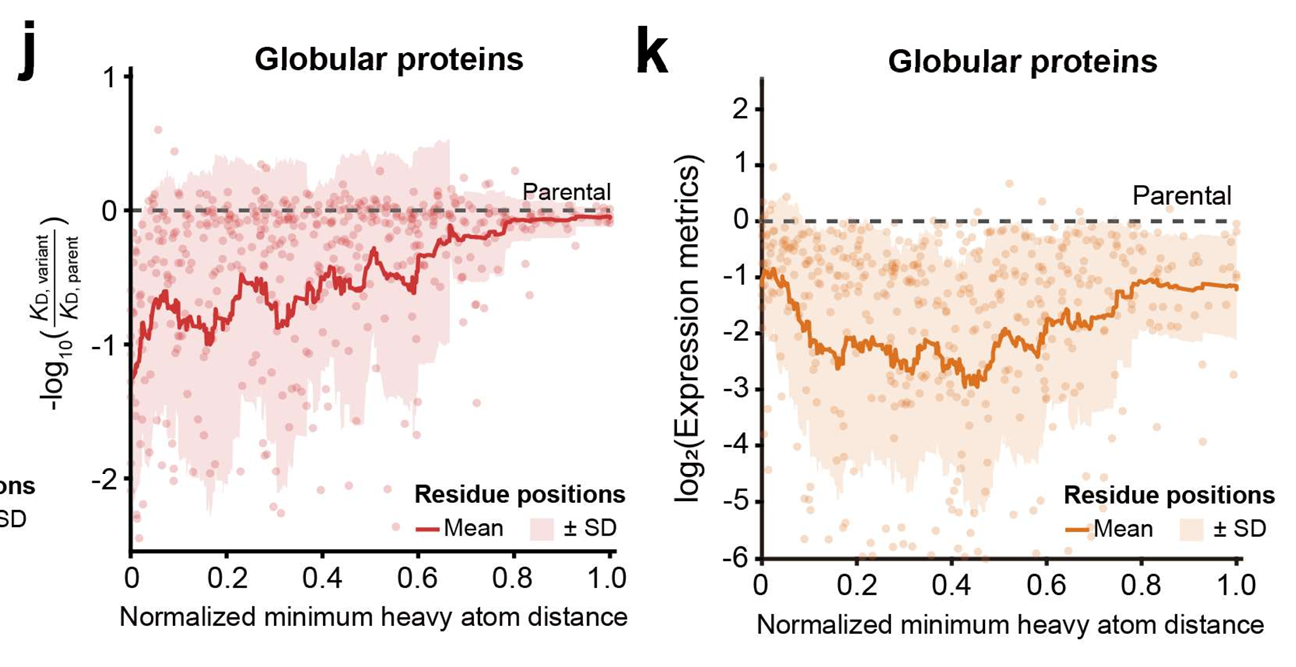
Figure 2j, 2k
globular protein에서도 유사한 경향이 관찰
결합 interface에 가까운 잔기: binding function에 민감
단백질 내부에 위치한 잔기: expression 또는 folding에 민감
즉, CDR에서도 표면 결합 잔기와 내부 구조 지지 잔기의 역할이 구분될 수 있다는 것
✅ Relative solvent accessibility (RSA) 분석
항원과의 거리만으로 잔기의 매몰 정도를 완전히 판단할 수는 없음
324개 CDR 잔기를 relative solvent accessibility (RSA) 에 따라 다시 분류
RSA= 구조에서 실제로 용매에 노출된 표면적 / 해당 아미노산이 가질 수 있는 최대 노출 표면적
- RSA가 높음: 표면에 많이 노출
- RSA가 낮음: 구조 내부에 많이 묻힘
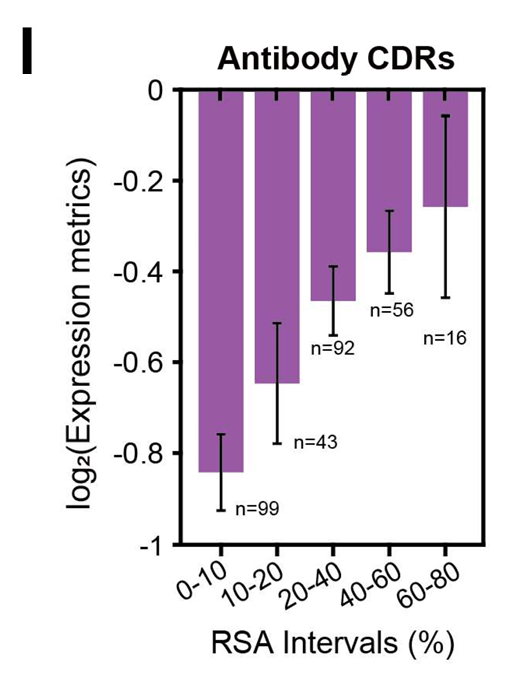
Figure 2l
RSA가 낮아질수록 단일 변이 후 expression metric이 더 크게 감소
RSA가 가장 낮은, 즉 가장 깊이 묻힌 CDR 잔기에서 평균 productivity 손상이 가장 컸음
->
RSA가 감소할수록 변이의 productivity 영향이 단조롭게 증가(expression 손상의 크기가 증가)
노출도가 증가할수록 손상이 작아짐
✅ Exploring fitness landscapes for adalimumab
실제 항체 최적화에서는 여러 개의 유리한 돌연변이를 동시에 넣는다.
그렇다면 단독으로는 기능을 유지하거나 향상시키는 돌연변이들을 함께 조합하면, 그 효과도 그대로 누적되는가?
adalimumab의 HCDR2와 HCDR3에서 선별한 functional substitution을 조합해 대규모 fitness landscape를 구축
✅ Functional substitution만 선별해 조합 library 제작
adalimumab의 HCDR2와 HCDR3 DMS 결과에서 두 조건을 모두 만족하는 치환을 선택
- 부모 adalimumab보다 antigen affinity를 유지하거나 향상
- 부모 adalimumab보다 cellular productivity를 유지하거나 향상
선별된 변이는 HCDR2와 HCDR3의 총 9개 위치에 분포
- HCDR2: 52, 55, 57, 58번
- HCDR3: 99, 100, 103, 106, 108번
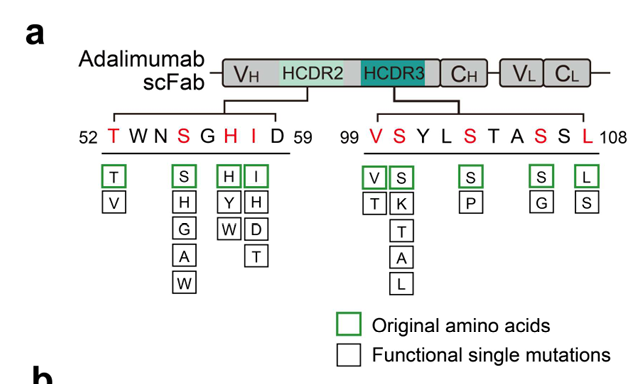
9,600개 조합으로 이루어진 목표 library를 구성
affinity와 productivity 측정에 성공한 clone: 9,517개
✅ 9,517개 서열을 27차원 물리화학적 vector로 표현
각 변이체를 단순히 아미노산 이름으로만 비교하지 않고, 각 치환의 물리화학적 특성으로 vector화
각 아미노산은 다음 세 특성으로 표현
- Hydrophobicity: 소수성
- Side-chain volume: 곁사슬 부피
- Isoelectric point, pI: 등전점
표적 위치가 9개이고 위치마다 특성이 3개이므로,
각 항체 변이체는 9 positions×3 properties=27-dimensional vector
Parental amino acid의 특성값은 각 위치에서 [0,0,0]이 되도록 함
따라서 vector는 절대적인 아미노산 특성보다는 부모 adalimumab으로부터 얼마나, 어떤 방향으로 달라졌는지를 나타냄
이후 각 특성을 Z-score로 표준화
✅ densMAP을 이용한 2차원 서열 공간 생성
27차원 공간을 2차원으로 축소
densMAP 사용 (UMAP의 density-preserving 변형)
일반적인 UMAP은 가까운 데이터끼리 모아 보여주는 데 강하지만, 실제 데이터 밀도를 시각적으로 왜곡할 수 있음
densMAP은 두 요소를 함께 보존하려는 방법
- 비슷한 서열끼리 가까이 놓이는 local topology
- 특정 서열 조합이 얼마나 조밀하게 존재하는지 나타내는 density
물리화학적으로 비슷한 돌연변이 조합을 가진 항체는 가까운 곳에 놓이고, 크게 다른 조합은 멀리 떨어짐
UMAP1과 UMAP2 축 자체에는 직접적인 생물학적 단위가 없고, 항체 서열 간 상대적 관계를 나타냄
✅ 2차원 지도가 실제 서열 관계를 보존하는지 검증
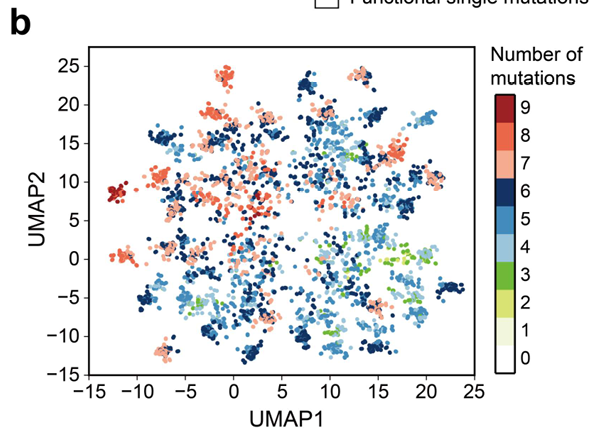
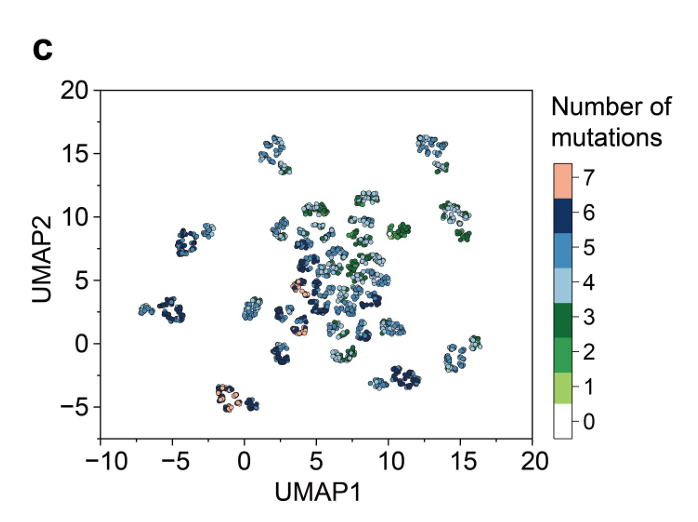
Figure 3b: 각 clone을 mutation 개수에 따라 색칠
- 돌연변이가 적은 clone은 parental sequence 근처에 위치
- 돌연변이가 많을수록 부모에서 점차 멀리 분포
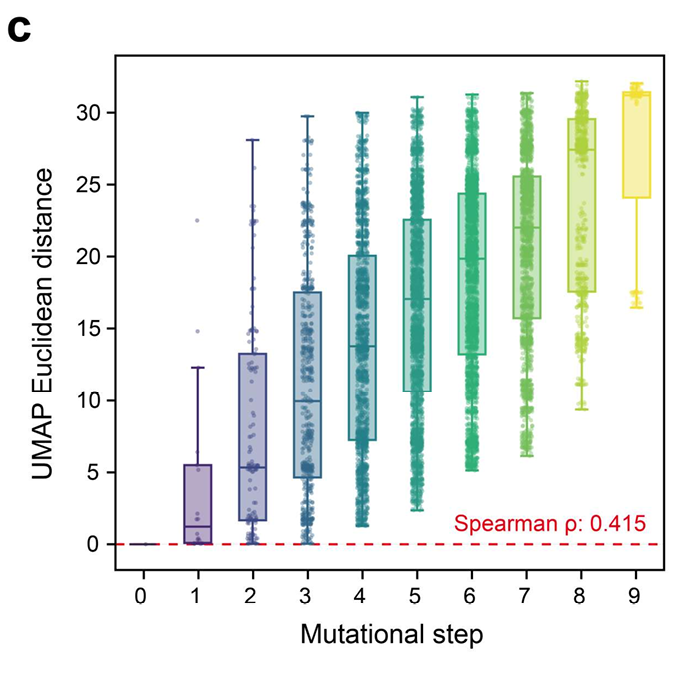
Extended Data Fig. 6c: 돌연변이 단계 수가 증가할수록 UMAP Euclidean distance도 증가
Spearman ρ=0.415
-> 부모 항체에서 더 많은 돌연변이를 축적한 clone일수록 대체로 더 멀리 떨어짐
✅ Affinity와 productivity fitness landscape 구축
각 clone의 실험값을 높이로 올려 3차원 지형을 만듦
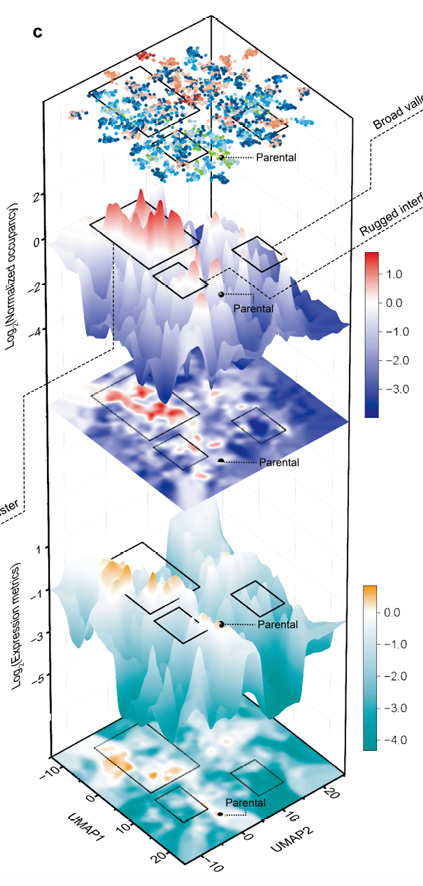
Figure 3c
- 위쪽: red–white–blue surface: affinity landscape
- 아래쪽: orange–white–teal surface: expression/productivity landscape
✅ 기능성 단일 변이만 조합했는데도 대부분 성능이 저하됨
Library는 처음부터 해로운 돌연변이를 무작위로 넣은 것이 아니었음
각 돌연변이는 단독 상태에서 affinity와 productivity를 유지하거나 향상시킨 functional building block
조합 결과는 예상과 크게 달랐음
9,517개 조합 중:
- 부모보다 affinity가 안 좋아진 clone: 73.5%
- 부모보다 productivity가 낮아진 clone: 81.7%
-> 단독으로는 좋은 돌연변이들을 결합했는데도 대부분의 조합에서 성능이 낮아졌음
landscape 전체가 negative epistasis에 지배된다
✅ 세 가지 대표적인 지형
K-nearest neighbors와 DBSCAN을 결합해 landscape에서 특징적인 영역을 분류
- DBSCAN: 밀도 기반 군집 분석
- Peak cluster
높은 affinity 또는 높은 productivity를 보이는 clone들이 밀집한 영역
한두 개의 고성능 clone이 고립된 것이 아니라, 비슷한 돌연변이 조합을 가진 우수 clone들이 군집을 이룸
- Broad valley
낮은 fitness를 가진 clone들이 넓고 연속적으로 분포하는 골짜기
특정 돌연변이 조합들이 광범위하게 해로운 epistatic interaction을 일으킴
- Rugged interface
서로 가까운 clone 사이에서도 fitness가 급격하게 바뀌는 영역
한두 개의 아미노산 차이만으로 높은 fitness에서 거의 기능이 없는 상태로 떨어질 수 있음
✅ Affinity peak와 productivity peak는 대부분 일치하지 않음
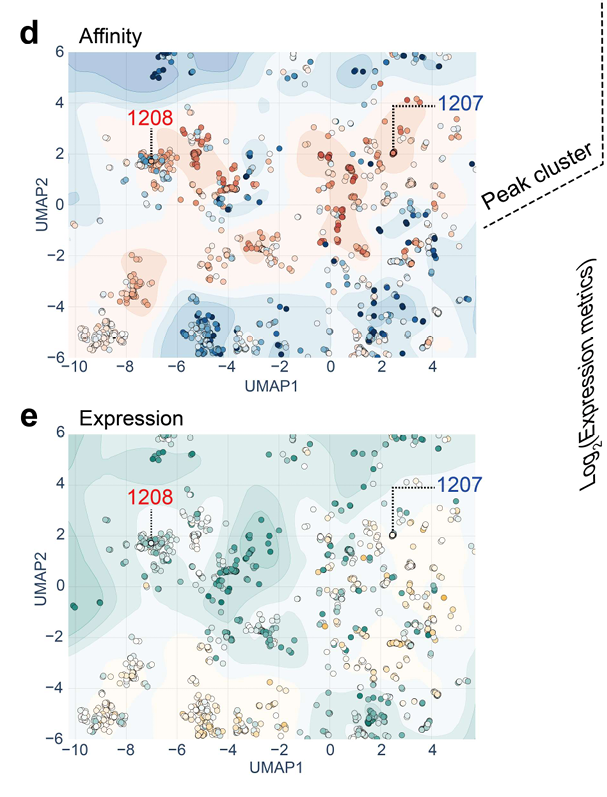
Figure 3d, e: 동일한 peak-cluster 영역을 각각 affinity와 expression으로 표시
Affinity가 높은 영역과 productivity가 높은 영역이 일부 겹치기는 하지만, 대부분은 서로 다른 위치에 있었음
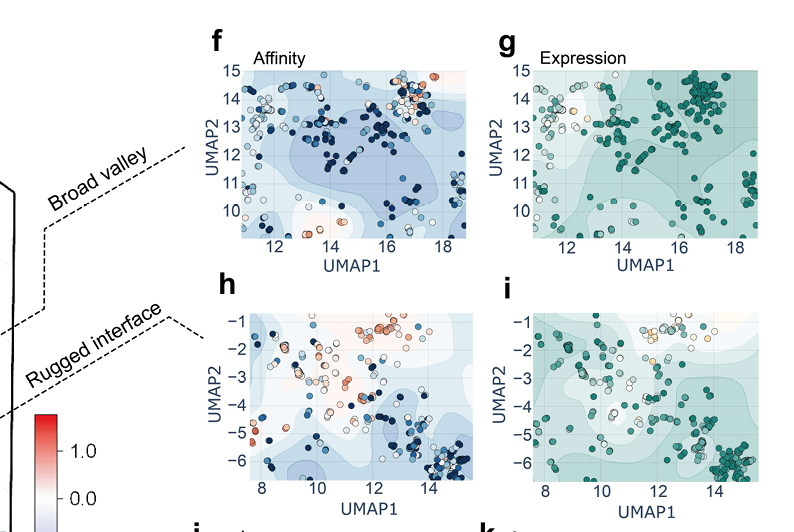
Figure 3f–i: broad valley와 rugged interface에서도 두 landscape의 패턴은 지속적으로 어긋남
- affinity가 높은 clone이 반드시 생산성이 높지 않음
- 생산성이 높은 clone이 반드시 affinity가 높지 않음
- 한 landscape의 절벽 위치가 다른 landscape의 절벽과 일치하지 않음
-> 단일 변이 DMS에서 발견했던 affinity–productivity orthogonality가 다중 돌연변이 공간에서도 유지된다는 것을 보여줌
또한 높은 peak 바로 옆에 기능이 거의 소실된 clone이 존재
-> landscape가 매우 rugged하다는 증거
✅ 지형마다 서로 다른 돌연변이가 농축됨
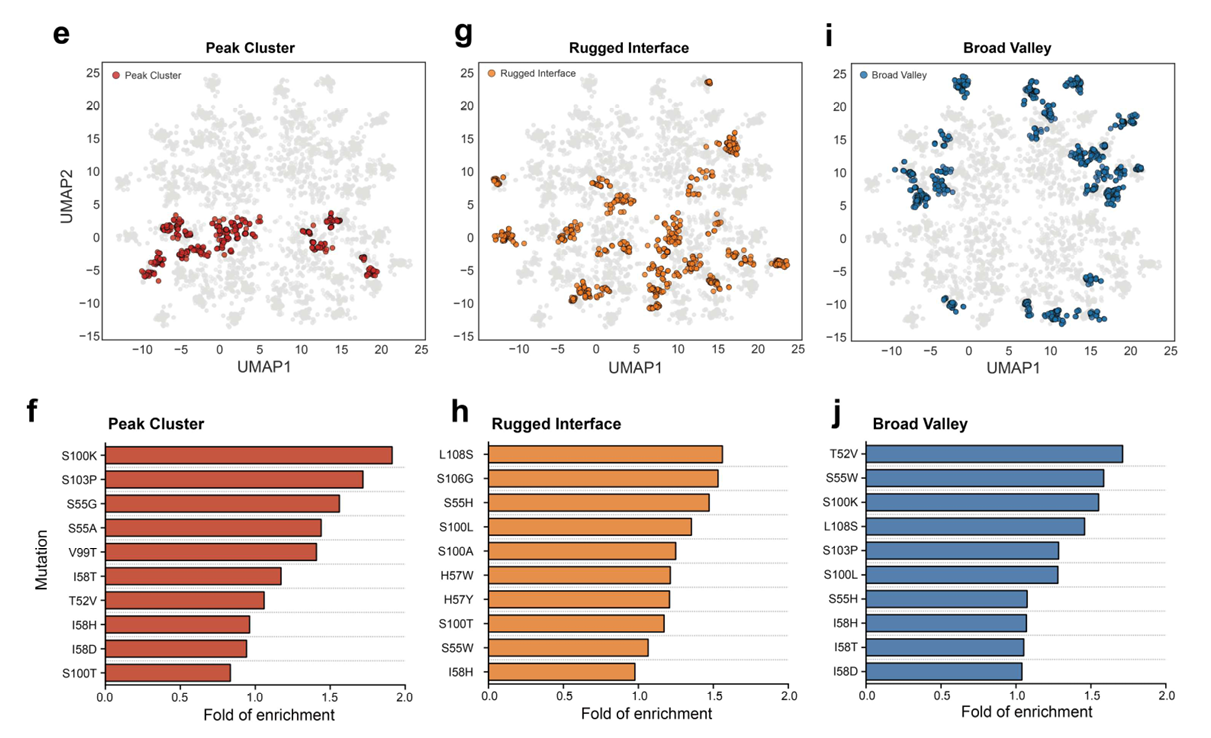
Extended Data Fig. 6e–j
peak cluster, rugged interface, broad valley가 UMAP 지도 어디에 위치하는지와 각 영역에 어떤 단일 돌연변이가 많이 포함되는지를 보여줌
e, f: peak cluster의 위치와 mutation enrichment
g, h: rugged interface의 위치와 mutation enrichment
i, j: broad valley의 위치와 mutation enrichment
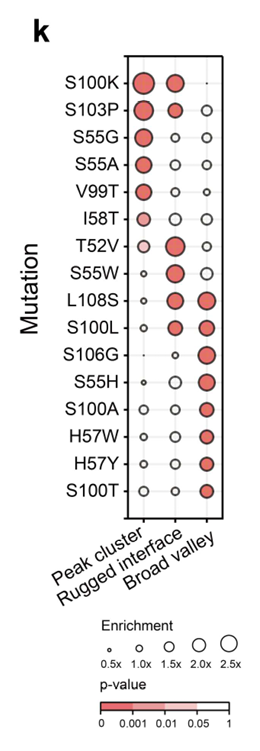
Extended Data Fig. 6k: 이 결과의 통합 bubble chart
- Peak cluster에는 특정 유리한 mutation set이 농축
- Broad valley에는 다른 해로운 조합과 연관된 mutation set이 농축
- Rugged interface는 두 특성의 중간적인 mutation profile을 보임
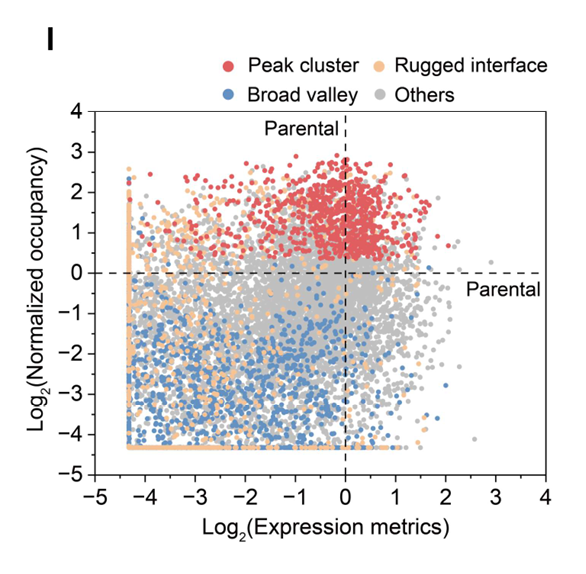
Extended Data Fig. 6l: 각 지형을 affinity–expression 2차원 공간에 표시
- Peak cluster: 빨간색
- Rugged interface: 갈색
- Broad valley: 파란색
- 나머지: 회색
peak cluster가 전반적으로 높은 affinity 쪽에 위치하지만, expression 값은 여전히 다양
✅ Clone 1207, 1208 선택
Figure 3d의 주요 peak cluster에서 두 clone을 선택
Clone 1207, Clone 1208
두 clone은 각각 6개의 CDR 치환을 가지고 있었으며, 높은 affinity와 productivity뿐 아니라 thermal stability도 유지
1207과 1208로 가는 가능한 경로는 각각 720개
부모 adalimumab에 6개의 돌연변이를 순서대로 하나씩 넣는 경우, 6!=720
-> parental sequence에서 1207 또는 1208로 가는 경로는 각각 720개
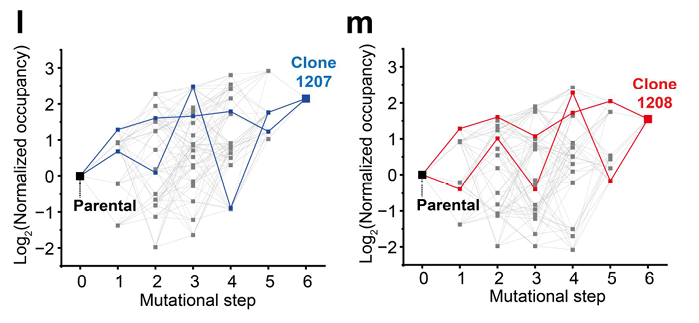
Figure 3l, m: 모든 mutational trajectory 중 대표적인 경로
모든 경로에서 최소 한 번 affinity가 감소함
1207과 1208로 가는 720개의 가능한 경로를 모두 분석했을 때, 단 한 경로도 affinity가 계속 증가하는 monotonic pathway를 보이지 않았음
-> 모든 경로에서 최소 한 번은 이전 단계보다 affinity가 감소
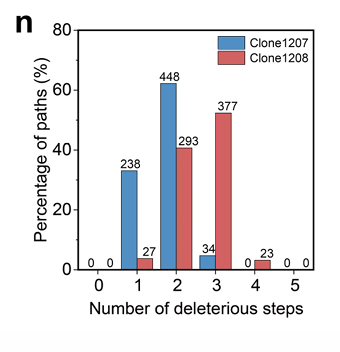
Figure 3n: 각 경로에 몇 번의 deleterious step이 포함되는지
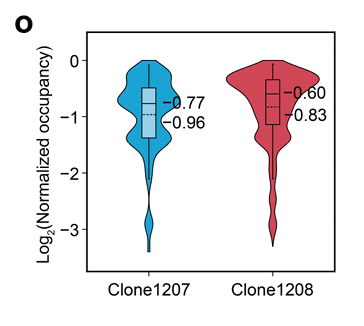
Figure 3o: 성능이 낮아진 단계에서 감소 폭이 얼마나 컸는지
중앙값 기준으로 약 50%의 antigen occupancy 감소
최종 clone은 매우 우수하지만, 그곳에 도달하기 위해서는 중간에 성능이 낮은 clone을 거쳐야 한다.
일반적인 directed evolution에서는 현재 clone보다 성능이 낮은 intermediate를 제거한다.
그러면 1207이나 1208로 이어지는 경로가 중간에 끊어진다.
“매 단계에서 더 좋은 돌연변이만 선택한다”는 점진적 최적화로는 1207과 1208에 도달할 수 없다.
✅ DMS pre-filtering의 필요성 검증: L108G library
처음부터 functional variant만 조합한 전략이 실제로 유용했는지 확인
단독 상태에서 해로운 변이인 L108G를 모든 clone에 고정하고, 나머지 위치에 functional substitution을 조합한 별도의 library를 제작
Library 크기: 1,920개
- L108G 고정
- 나머지 HCDR2/HCDR3의 7개 위치를 조합
Extended Data Fig. 7c: UMAP에 투영하고 mutation count로 색칠
✅ 하나의 해로운 변이를 포함하면 valley가 크게 확장됨
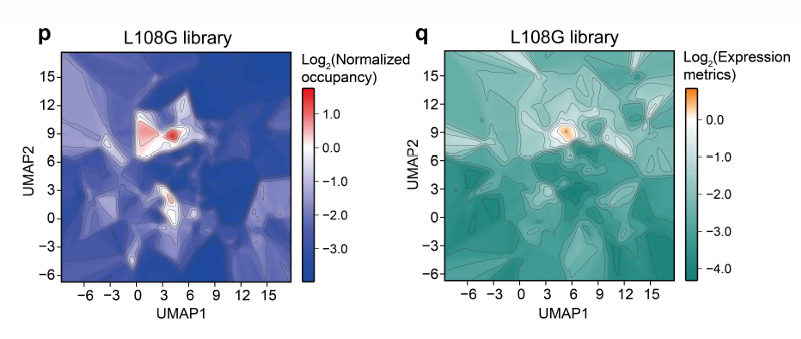
Figure 3p, q: L108G library의 affinity와 expression landscape
몇 개의 peak는 여전히 존재했지만, 낮은 fitness를 가진 void valley가 훨씬 넓게 확장
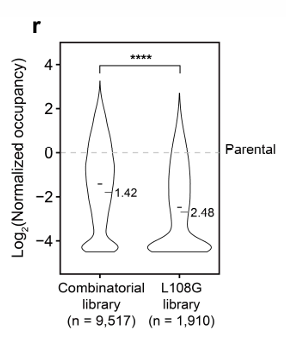
Figure 3r: affinity 분포 중앙값
- Functional combinatorial library: 약 −1.42
- L108G library: 약 −2.48
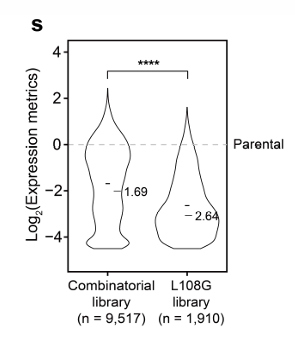
Figure 3s: expression 분포
Functional combinatorial library: 약 −1.69
L108G library: 약 −2.60
해로운 단일 변이를 하나 포함하면 다른 functional variant들과 negative epistasis를 일으킬 가능성이 크게 증가
따라서 DMS로 먼저 destructive variant를 제거하고, 단독으로 기능적인 변이만 조합하는 사전 필터링은 필요함
다만 functional variant만 사용해도 negative epistasis가 사라지지는 않음
단지 우수 clone을 발견할 가능성을 높여주는 것
✅ 전체 9,600개를 모두 만들지 않고 탐색하는 방법 ① Ridge regression
더 적은 clone만 측정하면서 global optimum을 찾는 전략
전체 library에는 이미 모든 single mutant와 double mutant가 포함
-> 이 변이 데이터를 사용해 ridge regression model을 학습
각 mutation의 존재 여부를 one-hot encoding하고, 모델이 각 단일 돌연변이에 additive weight를 부여하도록 함
- Positive coefficient: 전체적으로 유리하다고 예측
- Negative coefficient: 전체적으로 해롭다고 예측
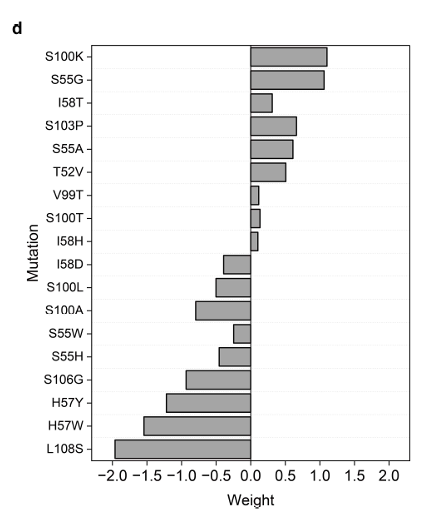
Extended Data Fig. 7d: 각 mutation의 additive weight
일부 mutation은 강한 양의 weight를, L108S 또는 특정 H57 변이는 음의 weight
Negative coefficient를 가진 mutation을 제외하고 positive-weight mutation만으로 조합한 결과, library 크기를 216개로 줄임
이 216개를 실제 전체 landscape와 비교했을 때:
- Global top 1% 전체 clone 수: 96개
- ML library가 회수한 top 1% clone: 33개
- ML library 내부 hit rate: 33/216=15.3%
Global top 1% clone들은 부모 대비 normalized antigen occupancy가 약 5–8배 높은 변이체들
전체 9,517개를 전부 분석하지 않아도 single/double mutant 패턴을 먼저 학습하면 우수 clone이 있을 가능성이 높은 영역을 집중적으로 탐색할 수 있음
✅ 효율적 탐색 방법 ② Modular divide-and-conquer
HCDR2와 HCDR3를 각각 하나의 module로 취급하는 방식
먼저 각 CDR 내부 조합을 별도로 측정
- HCDR2 combinations: 120개
- HCDR3 combinations: 80개
그다음 각 CDR에서 상위 성능 module만 골라 서로 조합
각 CDR에서 상위 10% module을 선택해 조합했을 때
- 최종 평가 조합: 96개
- Global top 1% 회수: 30개
- Recovery rate: 31.2%
각 CDR에서 상위 20%를 선택했을 때
- 최종 평가 조합: 384개
- Global top 1% 회수: 67개
- Recovery rate: 69.8%
전체 9,600개보다 훨씬 작은 384개를 검사하면서도 global top 1%의 약 70%를 회수
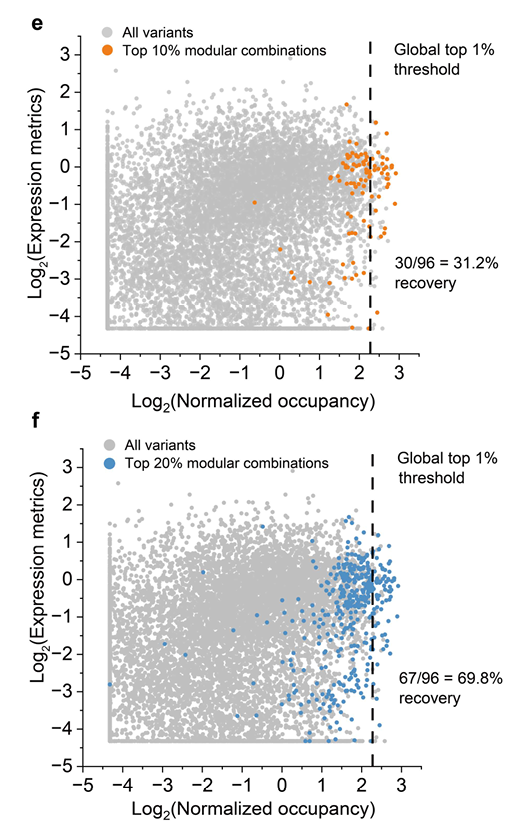
Extended Data Fig. 7e, f: 선택된 clone들이 global top 1% threshold 오른쪽에 얼마나 포함되는지
✅ ML과 modular strategy는 서로 다른 top clone을 찾음
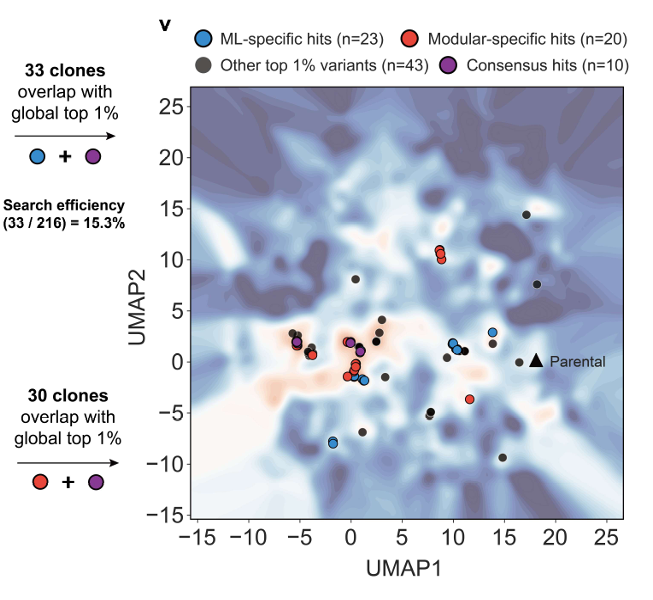
Figure 3v: global top 1% clone을 UMAP landscape에 표시
두 전략은 일부 clone을 공통으로 찾지만, 서로 다른 영역의 top clone도 회수 (상호보완적)
- Ridge regression: 저차 mutant의 평균적인 mutation effect를 이용
- Modular assembly: CDR 내부의 local epistasis를 먼저 보존
두 방식을 결합하면 screening 부담을 더 줄이면서 넓은 고성능 영역을 탐색할 가능성이 있음
✅ AI-driven prediction and rescue of antibody cellular productivity
CDR 서열이 해당 backbone 구조와 얼마나 잘 맞는지를 계산하면, 항체의 세포 생산성을 예측할 수 있지 않을까?
ProteinMPNN을 생산성 scoring 도구로 사용
✅ ProteinMPNN이 평가하는 것
주어진 protein backbone에서 각 위치에 어떤 아미노산이 적합한지를 조건부 확률로 계산
특정 위치의 실제 아미노산 확률이 높으면
- 해당 아미노산이 그 backbone geometry에 잘 맞음
- 주변 residue와의 packing 및 interaction이 자연스러움
확률이 낮으면
- 서열과 구조 사이의 mismatch 가능성
- folding 또는 구조 안정성에 불리할 가능성
adalimumab의 antigen-free backbone 구조인 PDB 3WD5를 사용
✅ Compatibility Score 계산
각 CDR residue의 native amino acid 확률을 이용해 점수를 계산
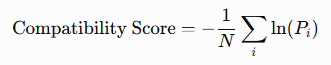
Pi: 위치 i의 실제 amino acid에 대한 ProteinMPNN 확률
N: 평가한 residue 수
Compatibility Score: 낮을수록 구조와 서열이 잘 맞는다는 뜻
experimental expression과 같은 방향으로 해석하기 위해 부모 adalimumab에 대해 정규화
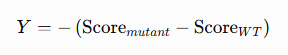
양수: 부모보다 구조 적합성이 좋음
음수: 부모보다 구조 적합성이 나쁨
✅ ProteinMPNN score가 productivity landscape를 예측
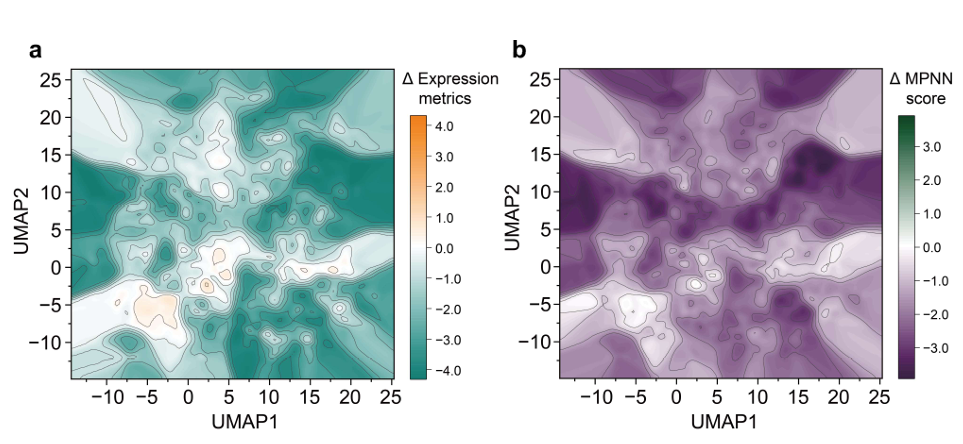
Figure 4a: 실제 SPID expression landscape
Figure 4b: ProteinMPNN compatibility landscape
두 지도의 높은 영역과 낮은 영역이 매우 유사
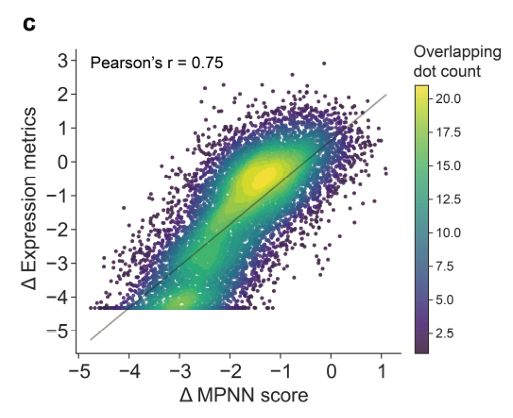
Figure 4c: 9,517개 변이체의 두 값을 직접 비교
Pearson r=0.75
-> CDR-dependent productivity를 높은 정확도로 예측
CDR 서열이 항원을 만나기 전부터 항체의 local backbone, framework, 인접 CDR과 구조적으로 맞아야 세포에서 정상적으로 folding되고 분비될 수 있다.
✅ ProteinMPNN은 affinity보다 productivity를 더 잘 예측
전체 antibody–antigen complex 구조를 사용해 affinity landscape도 예측
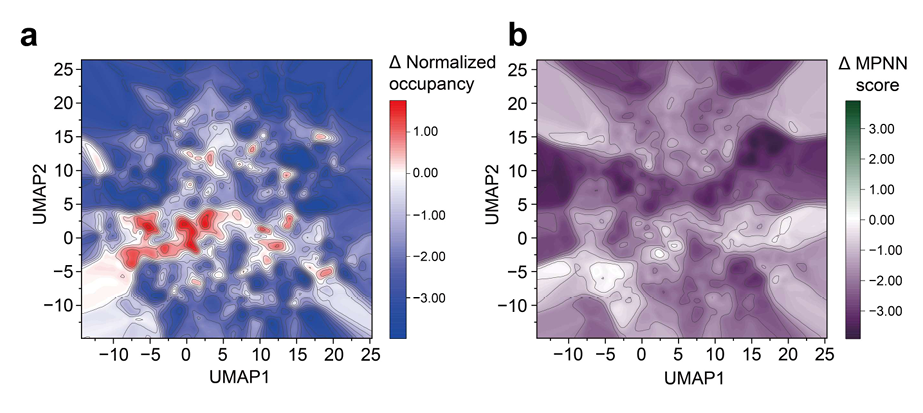
Extended Data Fig. 8a: experimental normalized occupancy landscape
Extended Data Fig. 8b: complex 기반 ProteinMPNN score
Pearson r=0.40
ProteinMPNN: 주어진 고정 backbone에 어떤 서열이 잘 맞는지를 평가하는 inverse-folding model
Productivity는 CDR이 항체 자체의 구조에 안정적으로 들어맞는지와 밀접하게 연결
affinity는 더 복잡한 요인에 좌우됨
- 항원과의 직접 interaction
- 결합 전후 CDR conformational change
- 물과 이온의 재배열
- 결합 kinetics
- induced fit
- conformational entropy
-> 고정된 구조의 sequence compatibility만으로 affinity를 완전히 설명하기 어려움
✅ 생산성이 낮은 bottom 10%에서 농축된 위치
전체 library 중 expression이 가장 낮은 bottom 10%를 분석
특히 해로운 변이가 많이 농축된 위치
HCDR2: T52, S55, H57, I58
HCDR3: S100, S103, S106, L108
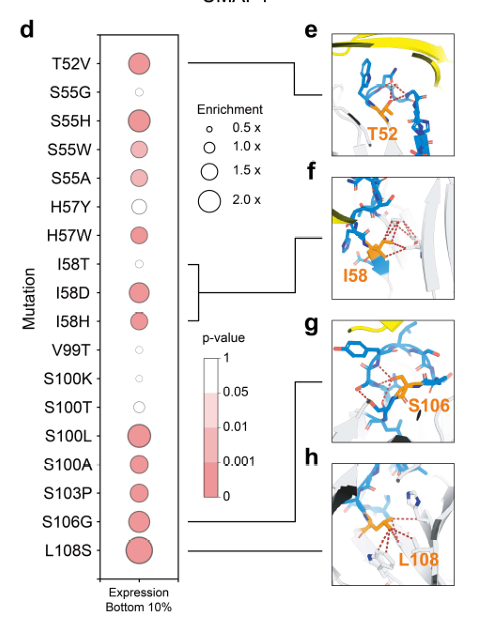
특정 위치의 mutation이 low-expression clone에 우연히 포함된 것이 아니라 반복적으로 농축됨
이 위치들은 framework와 CDR을 연결하는 interaction network를 형성
이 잔기들은 단순히 solvent에 노출된 자유로운 CDR 끝부분이 아니라
- 인접 CDR residue
- antibody framework
- 때로는 antigen
과 조밀한 상호작용을 형성
따라서 잘못된 아미노산이 들어가면 loop 자체의 구조와 framework 연결이 동시에 깨질 수 있음
추가 구조 잔기
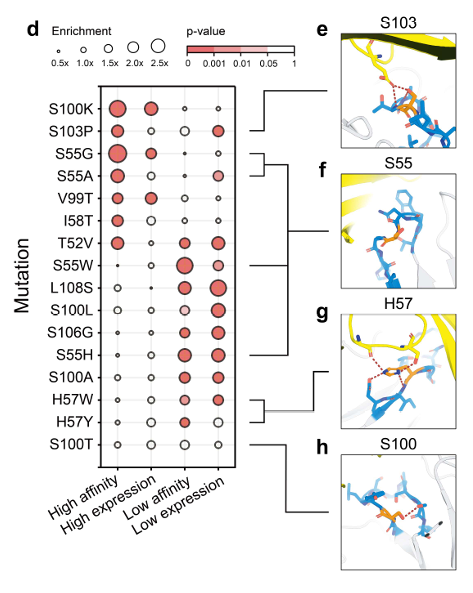
Extended Data Fig. 8d: mutation enrichment를 네 개의 fitness quadrant에 걸쳐 비교
S103 (HCDR3): Antigen-binding interface에 위치하며, antigen 및 주변 HCDR3 residue와 수소결합을 형성
S55 (HCDR2): HCDR2의 local structural environment를 지지하는 interaction에 참여
H57 (HCDR2): 주변 HCDR2 residue와 수소결합을 형성하는 동시에 antigen과도 접촉
S100 (HCDR3): 인접 HCDR3 residue와 intra-loop polar contact를 형성
-> expression-sensitive residue 중 일부는 항원 결합과 구조 안정성 양쪽에 관여하고, 일부는 주로 CDR 내부 구조를 지지
✅ HALP clone의 정의
High-Affinity, Low-Productivity (HALP clone) 을 구조적으로 구제할 수 있는지 시험
Methods의 초기 filtering 기준
- Normalized Occupancy > 4
- Normalized Expression < 0.5
- (Occupancy−error) > 3
- (Expression+error) < 0.5
단순히 cutoff 근처에서 우연히 HALP로 분류된 clone을 제외하고, 오차 범위를 고려해도 높은 affinity와 낮은 expression이 확실한 clone만 선택
✅ 다양한 서열 배경을 가진 14개 HALP clone 선정
특정한 한 종류의 CDR 서열에서만 rescue가 성공하는 것을 피하기 위해 diversity-aware selection을 함
- HALP 후보들을 UMAP 공간에 배치
- k=12로 k-means clustering
- 각 cluster에서 affinity가 가장 높은 clone을 하나씩 선택
- 12개의 서로 다른 CDR background 확보
- High-affinity peak cluster에서 2개 추가
-> 최종적으로 총 14개 HALP source clone을 선정
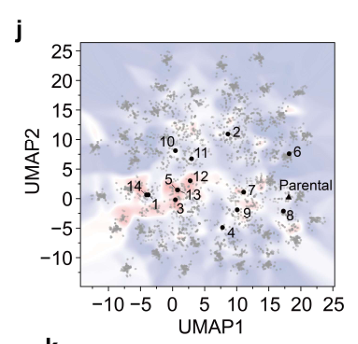
Figure 4j: clone들이 UMAP의 다양한 위치에 분포
14개 clone은 모두 부모 adalimumab과 비교하여
- affinity: 약 4–7배 향상
- cellular productivity: 약 5배 감소
✅ AlphaFold3로 bound structure 생성
각 sequence당 5개의 random seed 사용
총 25개의 structural model 생성
HCDR2와 HCDR3에서 pLDDT가 가장 높은 model 선택
이후 Antigen을 제거해 constructed unbound structure 생성
이 구조는 완전히 독립적으로 예측한 실제 apo antibody conformation이 아님
항원 결합 상태의 backbone을 유지한 채 항원만 제거한 binding-ready antibody structure
-> affinity를 형성하는 bound-compatible backbone을 보존하고
그 backbone 안에서 CDR 서열이 구조적으로 불안정한 위치를 찾기 위함
이러한 형태를 안정화하면 항원 결합 시 CDR이 새로운 구조로 정렬되는 데 필요한 conformational entropy cost도 줄어들 수 있음
✅ Bound와 unbound ProteinMPNN logit 비교
logit: ProteinMPNN에서 probability로 softmax하기 전의 값
각 CDR 위치에서 native amino acid의 logit을 두 구조에서 계산
Δlogit_i = logit_bound,i − logit_unbound,i
- Step 1: Binding key residue 보호
binding key residue로 분류
->
Δlogit_i > 1.0
해당 native amino acid가 antigen이 있을 때 훨씬 더 강하게 선호된다는 뜻
-> 그 아미노산이 antigen interaction에 중요한 역할을 할 가능성이 높으므로 rescue mutation 후보에서 제외
- Step 2: Unbound 상태에서 가장 구조적으로 맞지 않는 위치 탐색
Binding key residue를 제외한 나머지 위치를, unbound model에서 native amino acid의 logit이 낮은 순서로 정렬
“현재의 backbone 구조에서는 이 아미노산보다 다른 아미노산이 더 자연스럽다.”
각 HALP clone에서 가장 낮은 세 위치를 선택
각 위치마다 unbound structure에서 ProteinMPNN logit이 가장 높은 아미노산을 단일 치환으로 제안
HALP clone당 최대 3개 rescue candidate
HALP clone 14개
총 candidate: 42개
✅ Rescue 성공 기준
단순히 expression만 높아지면 성공 X
- Source HALP affinity의 최소 80% 유지
- Source HALP보다 productivity가 최소 2배 향상
- Parental adalimumab expression의 최소 50% 도달
✅ 14개 중 11개 HALP clone rescue 성공
14개 source HALP 중 11개에서 최소 한 개의 successful rescue candidate가 발견
성공한 후보에서 단 하나의 아미노산을 바꾸는 것만으로 productivity가 2.48–3.94배 향상되었고, 높은 antigen binding은 유지
여러 돌연변이를 어렵게 조합해 얻은 높은 affinity를 그대로 보존한 채, 구조적으로 문제가 되는 CDR residue 하나만 국소적으로 교정할 수 있음을 보여줌
✅ 대표적인 세 가지 rescue 방식
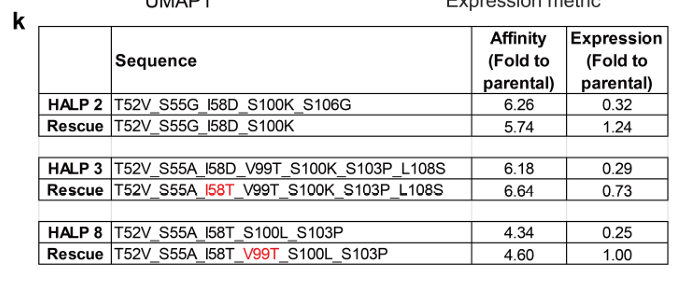
Figure 4k: HALP clone 2, 3, 8의 구조적 rescue
(1) HALP clone 2: 해로운 mutation의 reversion
HALP 2:
- Sequence: T52V, S55G, I58D, S100K, S106G
- Affinity: parental 대비 6.26배
- Expression: parental 대비 0.32
Rescue clone:
- S106G mutation을 제거하여 parental S106으로 복귀
- Affinity: 5.74배
- Expression: 1.24
(2) HALP clone 3: 해로운 아미노산을 다른 대체 residue로 교환
HALP 3:
- T52V, S55A, I58D, V99T, S100K, S103P, L108S
- Affinity: 6.18배
- Expression: 0.29
Rescue clone:
- I58D → I58T
- Affinity: 6.61배
- Expression: 0.73
단순히 parental I58로 되돌린 것이 아니라, ProteinMPNN이 해당 backbone에서 더 적합하다고 판단한 threonine으로 변경
(3) HALP clone 8: 새로운 compensatory mutation 추가
HALP 8:
- T52V, S55A, I58T, S100L, S103P
- Affinity: 4.34배
- Expression: 0.25
Rescue clone:
- 기존 mutation을 제거하지 않고 V99T를 추가
- Affinity: 4.60배
- Expression: 1.00
낮은 생산성을 유발한 mutation 자체를 되돌리지 않고, 새로운 위치의 mutation으로 구조적 문제를 해결
✅ 전체 후보의 fitness 이동
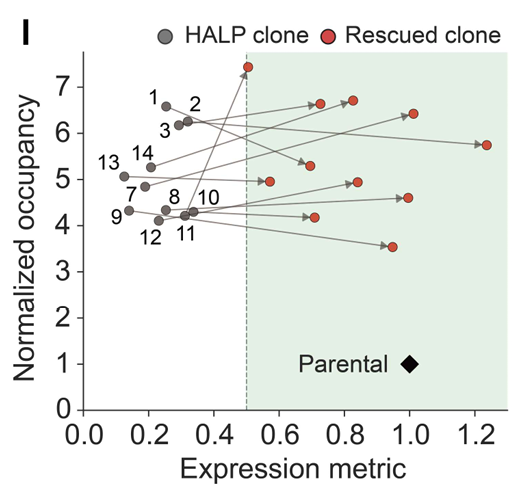
Figure 4l: 성공한 rescue 전후의 위치를 affinity–expression 공간에 표시
대부분의 화살표가 오른쪽으로 이동
-> expression이 향상되었음을 뜻함
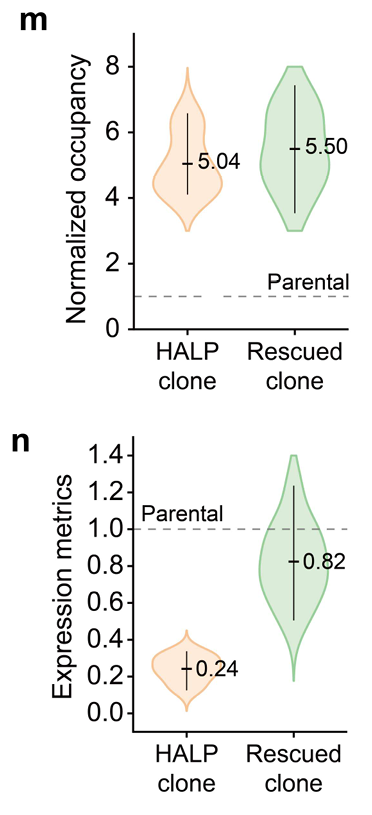
Figure 4m, n: 성공한 clone의 평균
Normalized occupancy: 5.04 → 5.50
Expression: 0.24 → 0.82
성공한 rescue에서는 affinity가 손상되지 않았고 평균적으로는 약간 증가했으며, expression은 부모의 약 24%에서 82% 수준으로 회복
✅ 모든 제안이 성공한 것은 아님
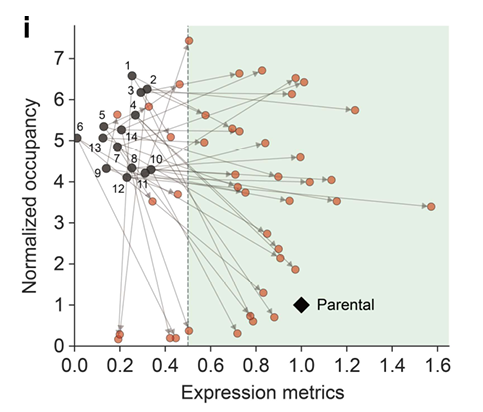
Extended Data Fig. 8i: 14개 HALP clone에서 생성한 42개 전체 후보의 이동
전체 후보 평균
- Occupancy: 5.11 → 3.68
- Expression: 0.22 → 0.74
ProteinMPNN 후보들은 전체적으로 생산성을 높였지만 일부 후보는 affinity를 손상시킴
구조 scoring이 매우 유용하지만
모든 computational proposal이 성공하는 것은 아니며
SPID 같은 정량적 실험 검증이 여전히 필요함
✅ In vivo therapeutic efficacy of landscape-navigated adalimumab variants
AI rescue는 높은 affinity지만 생산성이 낮은 clone을 구제하는 방법
그러나 fitness landscape에는 처음부터 affinity, productivity, stability가 함께 높은 peak cluster도 존재
-> 그 peak에서 직접 선별한 clone 1207과 1208이 실제 치료 효능에서도 부모 adalimumab보다 우수한지 검증
Peak에서 직접 선별한 1207과 1208은 마우스에서 20–100배 낮은 용량으로 치료 효과
이 효능 향상은 equilibrium affinity 증가만이 아니라, 항체–TNF-α complex lifetime이 1.8시간에서 50시간 이상으로 연장된 것과 연결됨
이 연구의 핵심은 단순히 “더 낮은 KD를 가진 항체”를 만드는 것이 아니다.
대규모 sequence landscape를 실제로 측정하면 affinity, productivity, stability, kinetics처럼 서로 다른 biophysical property가 함께 향상되는 희귀 영역을 발견할 수 있고,
그 결과 기존의 점진적 affinity maturation으로는 얻기 어려운 치료용 항체를 만들 수 있다.
✅ Discussion
-
CDR은 항원을 만날 때만 형태가 정해지는 단순한 유연한 loop가 아니라, 항원 결합 전부터 구조적 제약을 받는 접힌 구조 단위다.
-
Affinity와 productivity가 서로 다른 원리로 결정되므로, 높은 affinity를 유지하면서 낮은 productivity만 고칠 수 있다.
-
항체 fitness landscape가 negative epistasis로 인해 매우 rugged하고 단계적으로 탐색하기 어렵다.
-
전체 조합을 검사하는 대신 저차 돌연변이 학습과 CDR 단위의 modular assembly로 거대한 sequence space를 효율적으로 탐색할 수 있다.
✅ CDR에 대한 관점
-
기존 관점: CDR을 어떻게 바꾸면 항원과 더 강하게 결합할 것인가?
-> 항체 최적화의 핵심 목표가 오랫동안 binding affinity에 놓여 있었음 -
추가한 관점: CDR은 항원 결합 전에도 구조적으로 적합해야 한다.
CDR은 항원을 만나기 전에도 항체 backbone과 주변 CDR 환경에 맞는 구조를 형성해야 하며, 이 서열–구조 적합성이 cellular productivity를 결정한다.
CDR에도 일반적인 folded protein과 비슷한 sequence–structure compatibility 원리가 작용
- Inverse folding: 이 backbone 구조에는 어떤 아미노산 서열이 가장 잘 맞을까?
ProteinMPNN은 주어진 backbone의 각 위치에서 어떤 아미노산이 구조적으로 자연스러운지를 계산
-> ProteinMPNN이 낮게 평가한 CDR 서열은 실제로 세포에서 낮은 productivity를 나타내는 경우가 많았음
✅ CDR은 일반적인 folded protein처럼 작동한다
✅ HCDR3의 높은 다양성에도 공통 원리가 존재
HCDR3를 포함한 CDR residues가 cellular productivity와 관련해서는 일반적인 접힌 단백질과 같은 서열–구조 적합성 원리를 따른다는 것을 보여줌
- 항원에 가까운 잔기가 affinity에 가장 민감
- 항원에서 조금 뒤쪽의 CDR 잔기가 productivity에 민감
- RSA가 낮아 내부에 묻힌 CDR 잔기일수록 변이 시 productivity 손상이 큼
항원과 직접 닿는 CDR 표면은 결합 기능을 담당하고, CDR 안쪽 또는 framework와 접촉하는 부분은 구조 형성과 생산성에 기여한다.
✅ Nascent CDR fold의 의미
CDR이 항원을 만나기 훨씬 전부터 defined structural fold를 형성한다
-> nascent fold
항체가 세포 안에서 합성되고 folding되는 과정에서 만들어지는 CDR의 초기 구조를 의미
- 항체가 세포에서 합성됨
- CDR이 framework 및 주변 CDR과 상호작용하며 특정 local fold를 형성함
- 이 구조가 충분히 안정적이어야 항체가 정상적으로 분비됨
- 이후 항원을 만나면 추가적인 구조 조정과 결합이 일어남
CDR 돌연변이가 이 초기 구조를 불안정하게 만들면 antigen affinity를 평가하기도 전에 세포 발현이나 분비 단계에서 문제가 생길 수 있다.
✅ 항체 engineering에 대한 직접적인 의미
Affinity maturation / Humanization /CDR grafting 에서 발생하는
productivity 문제를 일반 단백질 engineering과 같은 inverse-folding framework로 분석할 수 있다
- Affinity maturation
affinity를 높이는 돌연변이가 항체 자체의 folding 환경과 맞지 않을 수 있다
-> 어떤 CDR 잔기가 구조적으로 맞지 않는지 계산해 고칠 수 있다
- Humanization
원래 framework에서 안정적이었던 CDR이 새로운 인간 framework에서는 구조적으로 잘 맞지 않을 수 있다.
CDR–framework 상호작용, 서열–backbone compatibility, buried CDR residue의 packing
문제로 분석할 수 있다.
- CDR grafting
CDR은 항원 결합 정보를 가지고 있지만, 실제 구조는 주변 framework와의 상호작용에도 의존한다.
-> 단순히 CDR 서열만 옮기면 다음 문제가 생길 수 있다.
- CDR의 원래 형태가 유지되지 않음
- 생산성 감소
- affinity 감소
- folding 불안정
✅ 예측 구조를 사용한 경우의 결과와 한계
예측 구조를 사용할 경우 ProteinMPNN scoring error rate가 약간 증가
✅ Affinity와 productivity의 orthogonality
- 두 특성의 결정 원리가 다르다
-> Affinity와 productivity의 fitness cliff가 동일한 서열 위치에 존재하지 않는다.
- Orthogonality가 제공하는 최적화의 창
두 fitness cliff가 겹치지 않으면 sequence space 안에 다음과 같은 영역이 생긴다.
Affinity는 높게 유지 & Productivity만 개선 가능
Productivity는 유지 & Affinity만 개선 가능
✅ HALP rescue가 보여준 중요한 비대칭성
affinity와 productivity 최적화 사이에 비대칭성이 존재
-
Affinity-enhancing mutation은 어렵게 얻고 유지하기도 어렵다
-> combinatorial screening을 통해 어렵게 얻은 높은 affinity를 downstream optimization 중에 유지하기가 어렵다. -
Productivity defect는 국소적으로 수정 가능한 경우가 많다
-> 정확한 구조 정보를 이용하면 한 위치에서 국소적으로 고칠 수 있는 경우가 많았다. -
14개 HALP source clone 중 11개가 rescue됨
-
단일 CDR substitution으로 productivity 회복
-
높은 affinity는 대부분 유지
-
대표 clone에서 productivity가 2.48–3.94배 향상
-> 높은 affinity를 만드는 전체 mutation 조합을 다시 설계할 필요 없이, structural mismatch가 가장 큰 위치만 교정할 수 있다.
✅ 항체 선별 pipeline에 대한 변화
Affinity와 productivity screening을 selection 단계에서 반드시 엄격히 결합할 필요는 없다.
높은 affinity와 낮은 productivity를 가진 후보를 즉시 버리는 대신
- 높은 affinity clone을 우선 보존
- 구조 모델 생성
- CDR sequence–structure mismatch 분석
- 결합에 핵심적인 residue를 보호
- 생산성 문제만 단일 치환으로 rescue
할 수 있다
✅ 현재 AI 항체 설계가 잘할 수 있는 것과 아직 어려운 것
완전한 de novo antibody design을 실현하려면 단순한 nascent fold 예측만으로는 부족하다.
AI는 항체가 실제 항원에 높은 affinity로 결합하는 과정의 복잡한 conformational plasticity를 다뤄야 한다.
- 결합 전 CDR이 가질 수 있는 여러 conformational state
- 항원이 접근하면서 일어나는 구조 변화
- Induced fit
- Conformational selection
- 항체–항원 계면의 수소결합과 수분자 재배열
- 결합에 따른 entropy 변화
- On-rate와 off-rate
- 최종 복합체가 아닌 결합 과정 전체
ProteinMPNN은 고정된 backbone에 어떤 sequence가 맞는지는 잘 평가하지만, CDR이 움직이며 항원을 찾아가고 결합하는 동적 과정 전체를 모델링하는 것은 아니다.
de novo high-affinity binder 설계는 여전히 CDR의 동적 구조 변화와 항원 결합 메커니즘을 정확히 모델링해야 하는 미해결 문제다.
✅ 기존 screen이 보지 못했던 ruggedness와 non-navigability
- Rugged landscape
Adalimumab landscape는 부드러운 언덕이 아니라 높은 peak와 깊은 valley가 가까이 붙어 있는 매우 rugged한 지형
-> 가까운 서열인데도 affinity 또는 productivity가 크게 달라짐
- Non-navigable landscape
좋은 mutation을 하나씩 추가하는 방식으로는 최종 peak에 도달할 수 없는 경로가 많았음
-> 점진적인 최적화 방식의 한계
✅ 드문 positive epistasis와 peak cluster
Negative epistasis가 지배적이었지만 모든 조합이 나쁜 것은 아니었음
매우 드물게 positive epistasis가 나타남
- 높은 affinity peak
- 높은 productivity peak
- 두 성질이 함께 높은 peak cluster
1207과 1208 역시 이러한 peak cluster
이러한 elite clone 대부분이 4–7개의 동시 mutation을 가지고 있었음
-> 우수한 항체가 단일한 “magic mutation”으로 만들어지는 것이 아니라, 여러 mutation 사이의 드문 유리한 상호작용을 통해 만들어질 수 있음을 의미
✅ Modular assembly 전략
CDR 내부의 local epistasis가 서로 다른 CDR 사이의 inter-CDR epistasis보다 우선적으로 나타날 수 있음
- HCDR2 내부 residue들은 서로 물리적으로 가까워 직접 상호작용할 가능성이 큼
- HCDR3 내부 residue들도 서로 강하게 연관됨
- HCDR2와 HCDR3 사이의 장거리 또는 간접 interaction은 상대적으로 드물 수 있음
따라서 각 CDR 내부에서 먼저 좋은 local combination을 찾는 것이 효율적
✅ SPID
SPID landscape data는 동일한 workflow 안에서 많은 변이체를 연속적인 수치로 측정하므로, AI가 학습하는 데 유용
- 단일 mutation 효과
- Negative·positive epistasis
- Affinity와 productivity의 분리된 규칙
- 구조적으로 허용되는 CDR 서열
- Peak와 valley를 형성하는 mutation pattern
- 어떤 clone이 구조적으로 rescue 가능한지
이러한 dense, quantitative ground-truth dataset이 AI-guided antibody design의 발전을 촉진할 것
✅ Materials and Methods
✅ 왜 one-hot encoding이 아니라 물리화학적 특성을 사용했는가?
One-hot encoding에서는 각 아미노산이 완전히 독립적인 범주로 표현됨
- Valine
- Isoleucine
- Lysine
은 다른 아미노산으로 처리됨
하지만 실제로는 valine과 isoleucine은 둘 다 소수성이며 크기도 비슷한 반면, lysine은 양전하를 가짐
물리화학적 vector를 사용하면
- 서로 비슷한 치환은 가까운 vector
- 성질이 크게 다른 치환은 먼 vector
로 표현할 수 있음
-> 이 embedding은 단순한 서열 동일성보다는 돌연변이가 항체의 생화학적 환경을 얼마나 변화시켰는가를 나타냄
✅ densMAP을 이용한 2차원 sequence space
- UMAP의 기본 목적
UMAP은 고차원에서 가까운 데이터들을 저차원에서도 가능한 한 가깝게 배치
-> 물리화학적으로 비슷한 항체는 2차원 지도에서도 가까이 놓임
하지만 일반적인 UMAP은 local neighborhood는 잘 보존하면서도, 실제 데이터가 얼마나 밀집되어 있는지는 왜곡할 수 있음
- densMAP의 목적
densMAP은 두 요소를 함께 보존하고자 함
-
Local topology: 어떤 서열이 어떤 서열과 가까운가
-
Density: 특정 종류의 서열이 얼마나 조밀하게 존재하는가
-
UMAP1과 UMAP2는 특정 물리화학적 특성 하나를 직접 의미하지 않음
각 축은 27차원의 여러 feature가 비선형적으로 결합된 결과임
- 두 점이 가까움 → 전체 물리화학적 mutation pattern이 비슷함
- 두 점이 멂 → mutation 위치 또는 physicochemical change가 다름
✅ Peak, valley, rugged interface 분류
- DBSCAN의 역할
DBSCAN은 밀도가 높은 점들을 cluster로 묶고, 밀도가 낮거나 고립된 점을 분리하는 비지도 clustering 방법
-> cluster 수를 사전에 정할 필요가 없고, 불규칙한 형태의 영역을 찾는 데 적합
✅ Ridge regression
각 mutation의 평균적인 효과를 계산하는 ML
기본적으로 각 돌연변이에 하나의 additive weight를 부여
- Fitness≈β_AA+β_BB+β_CC
A와 B가 함께 있는
- β_ABAB interaction term
을 넣었다고 적혀 있지는 않음
->
A와 B가 같이 있으면 어떻게 되는가를 계산하기보다는,
A는 여러 조합에서 대체로 좋은가? B는 여러 조합에서 대체로 나쁜가?
를 판단
이미 9,517개로 이루어진 큰 combinatorial landscape를 측정
그래서 후향적 검증이 가능
- Single·double mutant 의 fitnees 를 실험적으로 먼저 획득
- Ridge regression을 학습
- 학습이 끝난 뒤 음수 mutation을 제외
- positive additive weight를 가진 mutation들만으로 조합
- 그 조건을 만족하는 216개 조합을 전체 데이터에서 추림
- 이 216개 안에 실제 global top 1%가 얼마나 들어 있었는지 확인
- 216개 안에 global top 1% clone 96개 중 33개가 포함
- 이를 바탕으로 이후엔, low-order mutant만 먼저 측정한 뒤 Ridge로 다음 library를 줄일 수 있음
✅ ProteinMPNN을 이용한 전체 landscape scoring
- Bound와 pseudo-unbound 구조 제작
이 설계의 목적은 결합 가능한 CDR geometry를 그대로 보존하면서, 항원이 없을 때 CDR 자체가 그 구조를 얼마나 안정적으로 지지하는지를 평가하기 위함
- Rescue 설계에서 probability가 아니라 raw logit을 사용
logit을 사용한 이유
-
Bound와 unbound 차이를 비교할 때 더 넓은 dynamic range 제공
-
Native amino acid의 mismatch 정도를 probability보다 민감하게 구분
-
각 위치에서 20개 아미노산의 상대적 선호도를 직접 ranking하기 쉬움
-
Δlogit_i > 1.0
Native amino acid가 항원이 있을 때는 매우 선호되지만, 항원을 제거하면 덜 선호된다면
해당 residue는 항원 context에 의해 선택되는 아미노산일 가능성이 높음
-> antigen interaction 때문에 그 residue identity가 유지되어야 할 수 있음
-> 따라서 expression을 개선하려고 이 위치를 바꾸면 affinity가 손상될 위험이 있으므로 rescue mutation 후보에서 제외
✅ 핵심
- Landscape modeling
서열을 물리화학적 vector로 바꿔 실험 fitness와 연결
-> 어떤 sequence region이 peak이고, 어떤 영역이 valley인지 찾는 분석
- Structure-guided rescue
Binding에 중요한 residue는 보호하고, antigen-free 상태에서 구조적으로 맞지 않는 residue만 교정