✅ Abstract
Latent-Y라는 AI 에이전트로 항체 설계 캠페인의 전 과정을 자연어 프롬프트만으로 수행했고, 실제 실험에서도 여러 타깃에 결합하는 nanobody를 만들었다.
Latent-Y: 항체 설계 캠페인 전체를 자율적으로 수행하는 AI agent
-
문헌 조사, 타깃 분석, epitope 식별, 후보 항체 설계, 계산적 검증, 그리고 실험실에 보낼 수 있는 최종 서열 선택까지 수행
-
단순한 생성기가 아니라, 자료를 찾아보고 판단하면서 설계하는 시스템이라는 점을 강조
-
두 가지 방식 지원
- 자율 모드: 처음부터 끝까지 사람이 개입하지 않고 진행
- 협업 모드: 연구자가 중간 과정을 검토하고 피드백을 주고, 다음 방향을 지시할 수 있음
-
후보 항체 생성에는 Latent-X2 모델을 사용
-
세 가지 유형의 설계 캠페인에서 검증
- therapeutic specification에 의해 유도된 epitope discovery
사용자가 원하는 치료적 기능을 말하면, Latent-Y가 어떤 epitope를 겨냥해야 할지 찾아서 설계하는 방식
- cross-species binder design
사람 단백질과 동물 모델 단백질 모두에 결합하는 항체를 설계하는 작업 (Cross-reactivity)
- 논문 하나를 입력으로 받아서 설계
과학 논문에 나온 생물학적 맥락을 읽고 “어떤 타깃의 어느 부위를 잡아야 하는지”를 AI가 추론해서 설계
- 실험 결과
총 9개 타깃에 대해 6개 타깃에서 실험적으로 확인된 nanobody binder를 얻음
✅ Introduction
병목은 더 이상 “후보 분자를 찾는 것”이 아니라 “전문가 작업을 확장하는 것”이다
Latent-Y: 연구 목표에서 실험 가능한 후보까지 가는 전체 과정을 조율하는 에이전트
- 분자 데이터베이스와 문헌 데이터베이스를 검색
- Latent-X2를 호출해서 후보를 생성하고 점수화
- 생물정보학 도구를 사용해 타깃, epitope, 설계된 분자의 서열과 구조를 분석
- Latent-Y는 조합들을 무작정 다 하는 것이 아니라, 가설을 세우고 실험해보고 결과를 분석하면서, 병렬 실행에서 얻은 insight를 통합하고, 다음 단계를 계획
예를 들어 epitope 후보가 5개, 항체 framework가 4개, CDR 길이 조건이 여러 개 있으면 가능한 조합이 폭발적
- 사용자가 준 목표에 맞춰 작업
예를 들어 “특정 단백질 상호작용을 막는다” 같은 기능적 목적
- 완전 자율 모드와 협업 모드 모두에서 작동
협업모드에서는 사람이 생물학적 판단이나 전략적 제약을 주면 Latent-Y가 그걸 반영해 설계를 계속 진행하는 방식
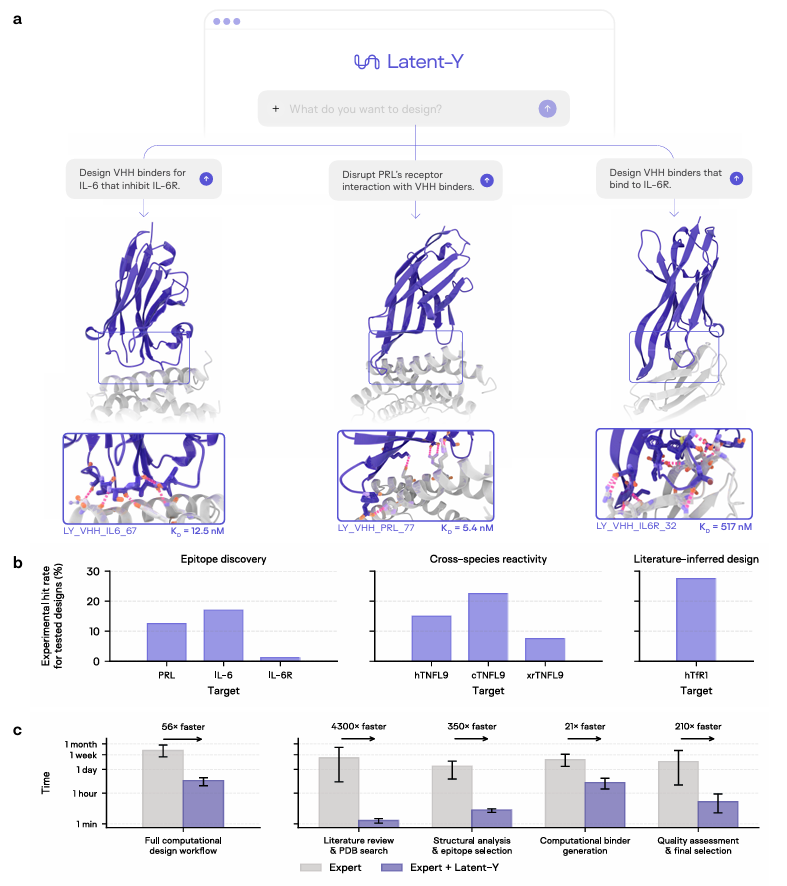
- Fig. 1a: 세 개의 독립적인 VHH 설계 캠페인
각각 IL-6, PRL, IL-6R을 타깃으로 하고, 모두 자연어 프롬프트 하나에서 시작
-
Fig. 1b: 성공한 타깃들에 대한 experimental hit rate
-
Fig. 1c: 전문가 혼자 캠페인을 수행할 때 걸리는 시간과 Latent-Y를 사용했을 때 걸리는 시간을 비교
-
Fig. 1d: 작업 단계를 나눠서 시간 단축이 어디서 발생했는지 보여줌
단계는 문헌 조사와 PDB 검색, 구조 분석과 epitope 선택, computational binder generation, 품질 검사와 최종 선택
✅ Results
Latent-Y를 세 가지 항체 설계 상황에서 평가
(1) epitope discovery campaign
“이 타깃을 막는 VHH를 만들어라”라는 큰 목표만 주고, Latent-Y가 어느 부위에 붙어야 기능을 막을 수 있는지, 즉 epitope를 스스로 찾는 설정
대상은 PRL, IL-33, TNFα, SC2RBD
목표는 치료적 억제
IL-6R은 억제보다는 타깃에 결합하는 것이 목표
(2) cross-species reactivity campaign
인간 단백질뿐 아니라 전임상 동물 모델인 cynomolgus monkey 단백질에도 동시에 결합하는 VHH를 설계하는 설정
대상은 TNFL9
(3) literature-inferred design campaign
논문 하나를 입력으로 주고, Latent-Y가 그 논문을 읽어서 어떤 타깃의 어떤 기능적 부위를 잡아야 하는지 추론한 뒤 VHH를 설계하는 설정
대상은 hTfR1
총 9개 타깃에 대해 wet-lab 검증을 했고, 그중 6개 타깃에서 실제 결합하는 binder를 얻음
✅ Latent-Y is a wet-lab-validated agent for drug design at scale
Latent-Y는 단순히 항체 서열을 생성하는 모델이 아니라, 웹 브라우저에서 자연어로 조작할 수 있고, 전체 항체 설계 캠페인을 수행한 뒤 실제 wet-lab 검증까지 통과한 agent
- 입력 방식은 크게 세 가지
(1) 사용자가 자유 텍스트로 치료 목표를 줄 수 있음
“IL-6와 IL-6R의 상호작용을 막는 VHH를 설계해줘”
(2) 타깃과 제약 조건이 들어간 구조화된 work plan을 줄 수도 있음
(3) 과학 논문을 넣을 수 있음
논문에서 타깃 이름, 생물학적 맥락, 설계 제약 조건을 스스로 추출
- 신약 설계 문제는 처음부터 명확하지 않다
처음에 “이 단백질을 막는 항체를 만들어라”라고 해도, 실제로는 결정해야 할 것이 많다는 뜻
-> 사용자의 요청은 보통 “목표”에 가깝고, 실제 설계에는 그 목표를 수많은 구체적 판단으로 바꾸는 과정이 필요
-> Latent-Y가 이 모호성을 줄임
- Latent-Y는 목표를 받으면 문헌과 데이터베이스를 조사
설계 목표를 받으면 과학 문헌과 생물학 데이터베이스를 조회해서 생물학적 맥락을 만듦
그다음 적절한 타깃 구조를 찾고, 후보 epitope들을 기능적 기준에 따라 평가
- 고정된 pipeline이 아니라 다양한 연구 제약을 이해한다
고정 pipeline은 “입력 구조 넣기 → 후보 생성 → 점수화 → 필터링”처럼 정해진 순서만 수행하는 방식
Latent-Y는 임의의 연구 제약을 이해하고 의사결정에 반영
modality: 어떤 형태의 치료 분자를 설계할 것인지
intended function: “그냥 결합”인지, “특정 상호작용을 차단”인지, “특정 수용체를 활성화/억제”인지 같은 기능적 목표
species requirements: 인간 단백질뿐 아니라 cynomolgus monkey 같은 전임상 종에도 결합해야 하는 조건
structural considerations: 타깃 구조의 품질, 노출된 표면, glycosylation 위험, unresolved region 같은 구조적 고려사항
즉, Latent-Y는 사용자의 큰 목표를 실제 설계 판단으로 번역
- Latent-X2를 이용해 실험을 돌리고, 결과를 보고 방향을 바꾼다
Latent-Y는 Latent-X2를 호출해서 후보 binder를 생성
-> 단순히 한 번 생성하고 끝내지 않음
여러 조건으로 batch를 돌려보고, 어떤 epitope, framework, CDR 길이, hotspot 조합이 잘 작동하는지 본 뒤, 생산적인 방향에 더 많은 계산 자원을 배정
- 표준 도구가 부족하면 custom computational approach도 만듦
- 각 단계마다 reasoning trace를 남기고, 사람이 확인하거나 override할 수 있다
각 단계에서 자신의 reasoning이 달린 output을 만듦
- 최종 후보를 고르기 전에 QA를 수행한다
(1) clustering for diversity
너무 비슷한 후보만 보내지 않도록 다양한 서열 군집에서 후보를 고름
(2) sequence similarity search against external databases
기존 항체 데이터베이스와 비교해서 너무 유사한지 확인
(3) sequence liability analysis
항체 개발에 문제가 될 수 있는 서열 motif를 찾음
✅ Latent-Y enables autonomous design of low nM-affinity antibodies
-
여섯 개 치료 관련 타깃에 대해 완전 자율 VHH 설계 캠페인을 수행
-
억제 목적 캠페인에서는 의도한 작용 기전에 맞는 epitope를 골랐다
IL-6, PRL 같은 inhibition-focused campaign에서는 Latent-Y가 의도한 mechanism of action과 맞는 epitope를 골랐음
- IL-6R의 경우 특이하게 domain 1 epitope를 찾았다
IL-6R은 억제 조건이 아니라 단순 binding 목적
Latent-Y는 receptor ectodomain의 domain 1에 있는 epitope를 찾음
중요한 점은 이 region이 대부분의 co-crystal structure에는 없었음
즉, 기존 복합체 구조에서 흔히 관찰되는 부위를 단순히 따라간 것이 아니라, 비교적 덜 대표된 구조 영역을 타깃했다는 의미
- 여섯 개 타깃 중 실험적으로 VHH binder가 확인된 것은 세 개
IL-6, IL-6R
PRL 은 antibody-bound structure가 PDB에 없음
-> de novo 설계 주장에 힘을 주는 사례
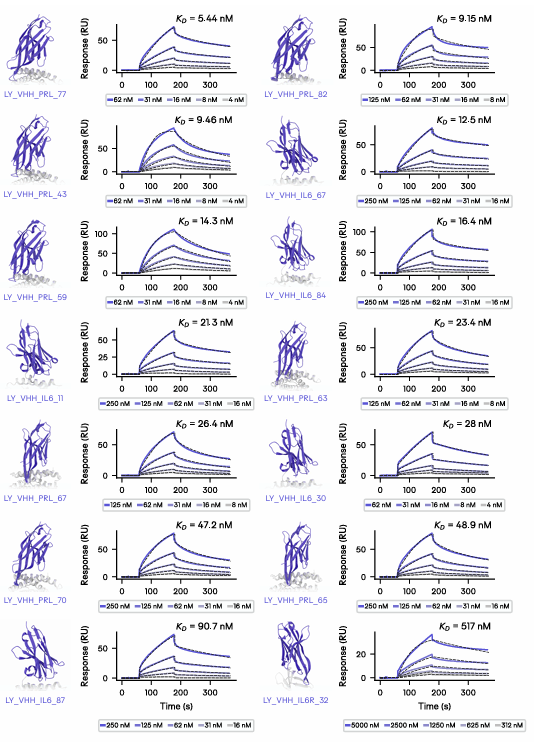
- “한 plate보다 적은 디자인”에서 high-affinity binder를 찾았다
plate는 96-well plate 규모
즉, 수천~수만 개를 실제로 합성해 다 뒤진 것이 아니라, 비교적 적은 수의 설계 후보를 wet lab으로 보내도 강한 binder가 나왔음
- 성공 후보들은 CDR 길이, framework, hotspot이 다양했다
성공 후보들은 다양한 CDR length, 다양한 antibody framework, 그리고 서로 다른 hotspot residue를 사용
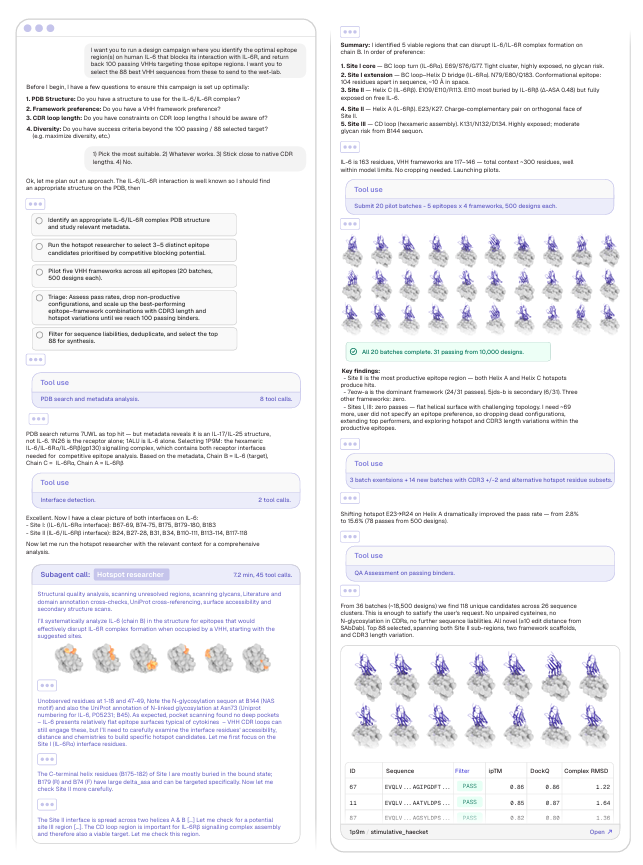
Fig. 3: IL-6 캠페인의 reasoning trace
- 사용자의 원래 요청
인간 IL-6에서 IL-6R과의 상호작용을 막을 수 있는 최적 epitope region을 찾아라.
그 epitope를 겨냥하는 passing VHH 100개를 반환하라.
그중 wet lab에 보낼 best VHH sequence 88개를 선택하라.
어느 epitope를 잡아야 하는지를 지정하지 않았기 때문에, Latent-Y가 직접 찾아야 했음
- Latent-Y는 먼저 clarifying question을 했다
Latent-Y는 시작 전에 몇 가지 질문을 함
사용할 IL-6/IL-6R complex 구조가 있는지, 선호하는 VHH framework가 있는지, CDR loop length 제약이 있는지, 100개 passing / 88개 선택 외에 diversity 같은 성공 기준이 있는지
사용자는 대략 “가장 적절한 것을 고르고, 잘 되는 것을 쓰고, native CDR length에 가깝게 유지하고, 추가 기준은 없다”는 식으로 답
- Latent-Y의 계획
먼저 IL-6/IL-6R interaction이 잘 알려져 있으므로 PDB에서 적절한 구조를 찾는다.
그다음 hotspot researcher를 사용해 competitive blocking 가능성이 높은 epitope 후보 3–5개를 고른다.
여러 VHH framework와 epitope 조합에 대해 pilot batch를 돌린다.
각 batch 결과를 보고 pass rate가 낮은 조합은 버리고, 잘 되는 epitope–framework 조합은 scale up한다.
마지막으로 sequence liability를 필터링하고, 중복을 제거하고, top 88개를 합성 후보로 고른다.
- PDB 구조 선택 과정
Latent-Y는 PDB 검색을 했고, 처음 top hit로 7UWL이 나왔지만 metadata를 확인해 보니 IL-6 구조가 아니라 IL-17/IL-25 구조였다고 판단해 제외
1N26은 receptor alone이고, 1ALU는 IL-6 alone이라서, 경쟁 결합 epitope 분석에는 부족하다고 판단
최종적으로 1P9M을 선택
이 구조는 hexameric IL-6/IL-6Rα/IL-6Rβ, 즉 gp130 signaling complex를 포함
그래서 IL-6가 IL-6Rα와 IL-6Rβ 양쪽에 닿는 interface를 분석할 수 있었음
- IL-6의 receptor interface를 두 site로 나누었다
Latent-Y는 IL-6 표면에서 두 주요 receptor-binding site를 확인
Site I은 IL-6와 IL-6Rα의 interface
Site II는 IL-6와 IL-6Rβ, 즉 gp130 쪽 interface
Latent-Y가 “IL-6의 어느 면을 막으면 receptor binding을 방해할 수 있는가?”를 구조적으로 분석
- Hotspot researcher subagent가 epitope 후보를 분석했다
Fig. 3에서 Latent-Y는 hotspot researcher subagent를 호출
이 subagent는 7.2분 동안 45개 tool call을 사용했다고 표시
수행한 분석
구조 품질 분석, unresolved region 확인, glycan 위험 확인, 문헌과 domain annotation 교차 확인, UniProt cross-reference, surface accessibility 분석, secondary structure scan 등
unresolved region은 실험 구조에서 좌표가 없는 부분
보통 유연하거나 관찰이 어려워 구조에 빠져 있음
glycan risk는 당화가 붙을 수 있는 위치 때문에 항체 결합이 방해될 수 있는 위험
Latent-Y는 IL-6가 cytokine답게 깊은 pocket이 거의 없고, 비교적 평평한 표면을 가진다고 판단
그래서 VHH CDR loop가 이런 평평한 epitope를 잘 잡도록 신중히 hotspot을 골라야 한다고 판단
- IL-6에서 5개 viable epitope region을 골랐다
IL-6/IL-6R complex 형성을 방해할 수 있는 viable region 5개가 제시
- pilot batch 결과 Site II가 가장 생산적이었다
여러 epitope와 framework 조합으로 pilot batch를 돌림
20개 batch, 약 10,000개 design을 돌린 결과 31개 passing design이 나왔음
- Latent-Y는 죽은 조합을 버리고 좋은 조합을 확장했다
Latent-Y는 pass가 없는 configuration을 버리고, 잘 되는 Site II 쪽을 확장
구체적으로 batch extension 3개와, CDR3 길이를 ±2로 바꾸거나 alternative hotspot residue subset을 쓰는 새 batch 14개를 돌렸음
그 결과 총 36 batches, 약 18,500 designs에서 118 unique candidates를 얻었고, 이 후보들은 26 sequence clusters에 걸쳐 있었음
-> 최종 후보가 모두 거의 같은 서열이 아니라 여러 cluster에 분산
- 최종 QA 결과
unpaired cysteine 없음,
CDR 안의 N-glycosylation 없음,
추가 sequence liability 없음.
SAbDab과 비교했을 때 모두 novel하다고 판단
최소 edit distance가 10 이상
마지막으로 top 88개를 선택
이들은 Site II의 두 sub-region, 두 framework scaffold, CDR3 length variation을 모두 포함하도록 골랐음
- 중요한 발견: hotspot을 E23에서 R24로 바꾸자 pass rate가 크게 올랐다
Helix A에서 hotspot을 E23 → R24로 바꾸자 pass rate가 2.8%에서 15.6%로 크게 개선
이건 Latent-Y가 단순히 처음 정한 epitope를 고집한 것이 아니라, 중간 결과를 보고 hotspot 수준에서 세부 전략을 수정했다는 예시
✅ Latent-Y designs cross-species antibodies via autonomous capability extension
Latent-Y가 인간 TNFL9와 cynomolgus monkey TNFL9에 동시에 결합하는 cross-reactive VHH를 설계했고, 이를 위해 기존에 없던 custom generation routine까지 만들었다.
TNFL9 cross-species design이 여러 난점을 가졌음
-
cyno variant에는 empirical structure가 없음
-> 실험적으로 결정된 cyno 구조가 없어서, sequence에서 구조를 예측해야 했음 -
인간 variant의 crystal structure에도 unresolved region이 있음
-
TNFL9는 trimer로 기능하고, 결합 표면이 비교적 flat 함
-> flat surface는 깊은 pocket이 있는 표면보다 binder 설계가 어려움 -
Latent-Y에게 pre-built cross-species design 기능이 주어진 것이 아니었음
-> agent가 직접 custom generative method를 만들어야 했다는 것 -
TNFL9는 협업 trace
-> 인간 전문가가 Latent-Y와 협업하면서 high-level biological steering을 제공했지만, 코딩 전문성이나 세부 개입 없이 agent가 적응
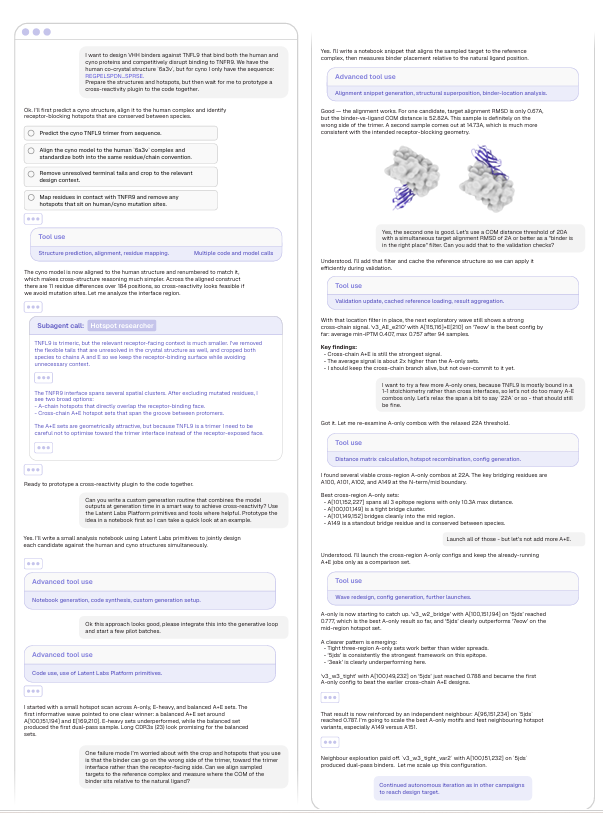
Latent-Y의 초기 작업: cyno 구조 예측과 human complex 정렬
사용자의 시작 prompt
인간과 cyno TNFL9 모두에 결합하고, TNFL9–TNFRSF9 binding을 경쟁적으로 방해하는 VHH를 설계하고 싶다. 인간 co-crystal structure는 PDB 6A3V가 있고, cyno는 sequence만 있다.
Latent-Y는 먼저 cyno TNFL9 trimer 구조를 sequence에서 예측
그다음 cyno model을 human 6A3V complex에 align하고, residue numbering과 chain convention을 맞춰서 두 구조를 비교
또 unresolved terminal tail을 제거하고, 관련 design context로 구조를 crop
그다음 TNFRSF9와 접촉하는 residue를 mapping하고, human/cyno mutation site에 해당하는 hotspot은 제거
-> mutation site를 epitope 핵심으로 잡으면 한 종에는 잘 붙지만 다른 종에는 못 붙을 수 있음
Hotspot researcher는 두 가지 epitope 전략을 찾았음
Fig. 5에 따르면 hotspot researcher는 receptor-binding surface를 분석하면서 두 가지 옵션을 확인
- A-chain hotspot
receptor-binding face와 직접 겹치는 한 chain 위의 hotspot들
- A+E cross-chain hotspot set
trimer의 protomer 사이 groove를 가로지르는 hotspot 조합
초기에는 A+E set이 기하학적으로 좋아 보였지만, agent는 TNFL9가 trimer이기 때문에 trimer interface 쪽으로 잘못 최적화될 위험이 있다고 인식
Latent-Y가 custom cross-reactivity generation routine을 만듦
사용자는 Latent-Y에게 “model outputs를 generation time에 smart하게 결합해서 cross-reactivity를 달성하는 custom generation routine을 만들어보라”고 요청
Latent-Y는 Latent Labs Platform primitive를 사용해 notebook에서 prototype을 만들고, 인간 전문가가 logic을 확인한 뒤 generative loop에 통합
-> agent가 원래 있던 버튼만 누른 것이 아니라, “인간 구조와 cyno 구조를 동시에 만족시키는 generation/validation 방식”을 직접 구현
초기 결과는 A+E balanced set이 좋아 보였음
초기 pilot에서 Latent-Y는 A-only, E-heavy, balanced A+E set을 비교
첫 informative wave에서 balanced A+E set이 가장 좋아 보였고, A[100,151,194]와 E[169,210] 주변 조합이 첫 dual-pass sample을 만들었음
또 balanced set에서는 긴 CDR3, 특히 CDR3 length 23이 유망해 보인다고 판단
하지만 wrong side of trimer 문제가 발생
인간 전문가는 crop과 hotspot 설정 때문에 binder가 trimer의 receptor-facing side가 아니라, trimer interface 쪽 또는 생물학적으로 잘못된 면에 붙을 수 있다고 우려
-> agent가 계산 점수를 높이는 방향으로는 성공했지만, 실제 생물학적 목적과는 어긋난 해법을 찾은 상황
Latent-Y는 이 문제를 확인하기 위해 sampled target을 reference complex에 align하고, binder의 center of mass가 natural ligand 위치와 얼마나 가까운지 측정하는 코드를 작성
한 후보는 target alignment RMSD가 0.67 Å로 구조 정렬은 매우 좋았지만, binder-vs-ligand COM distance가 52.82 Å였어. 즉 타깃 구조는 잘 맞았지만 binder가 완전히 잘못된 쪽에 붙은 것
다른 후보는 COM distance가 14.73 Å였고, 이는 의도한 receptor-blocking geometry에 더 맞다고 봤음
그래서 사용자는 다음 기준을 추가
binder가 올바른 위치에 있으려면 COM distance ≤ 20 Å, 동시에 target alignment RMSD ≤ 2 Å여야 한다.
Latent-Y는 이 geometric location filter를 validation check에 추가
이후 agent는 A+E와 A-only 전략을 다시 탐색
필터를 넣은 뒤에도 cross-chain A+E signal은 강했음
A[115,116]+E[210] on 7eow가 평균 min-iPTM 0.407, max 0.757을 보임
하지만 인간 전문가는 TNFL9가 mostly 1:1 stoichiometry로 bound된다는 점을 고려해, A+E cross-interface 조합만 너무 많이 하지 말고 A-only 조합도 더 보자고 steering
그래서 span threshold를 22 Å 정도로 완화하고 A-only 조합을 다시 분석
Latent-Y는 A-only cross-region combo를 찾았고, A149가 conserved bridge residue로 중요하다고 판단
이후 A-only 결과가 따라잡기 시작
v3_w2_bridge with A[100,151,194] on 5jds가 0.777까지 올라가 best A-only result
또 5jds framework가 이 epitope에서 강하고, 3eak는 underperforming한다고 판단
그다음 v3_w3_tight with A[100,149,232] on 5jds가 0.788을 기록하면서 기존 A+E design을 앞질렀음
이후 Latent-Y는 best A-only motif를 scale up하고, 특히 A149와 A151 주변 hotspot variant를 테스트
v3_w3_tight_var2 with A[100,151,232] on 5jds가 dual-pass binder를 만들었고, Latent-Y는 이 configuration을 scale up
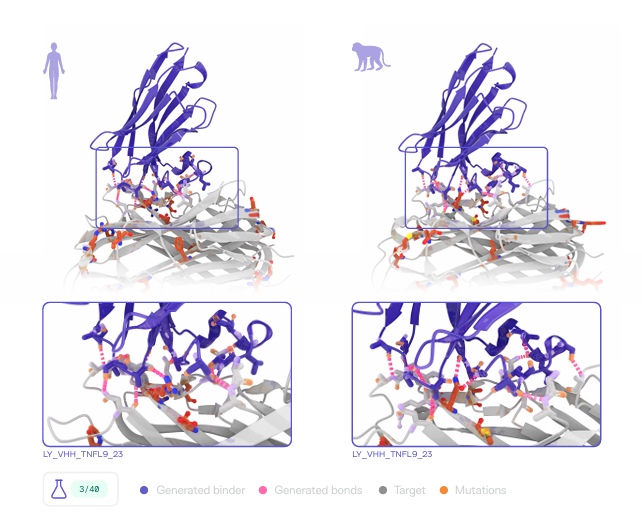
Wet-lab 결과: 40개 중 3개가 human/cyno 양쪽에 결합
✅ Latent-Y translates scientific publications into antibody binders targeting the reported epitope
Latent-Y가 “문헌을 읽고 그 문헌의 기능적 의미를 바탕으로 설계할 수 있는가?
-> 논문 하나를 입력으로 줬을 때, Latent-Y가 해당 논문에서 중요한 단백질 상호작용과 epitope를 추론하고, 그 기능적 epitope를 겨냥하는 VHH를 설계할 수 있는지 테스트
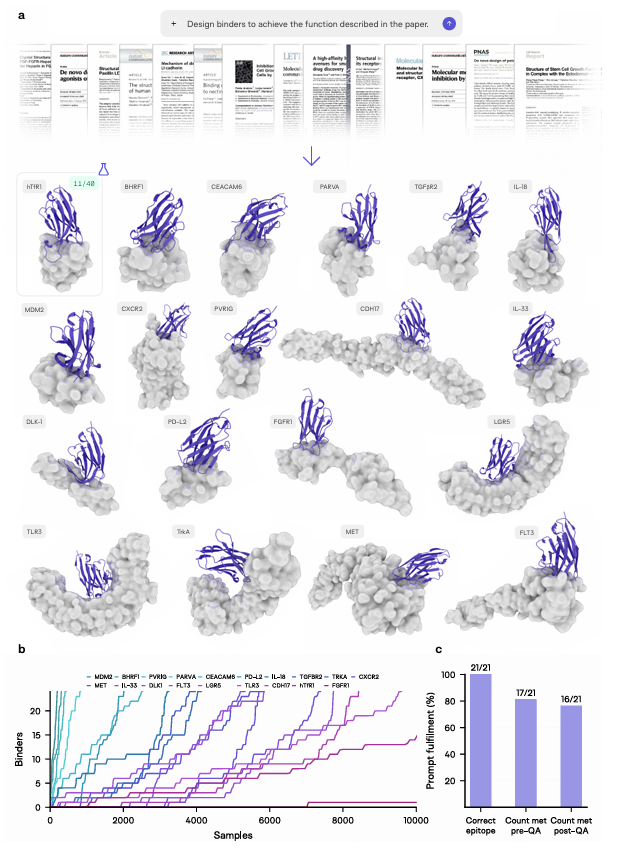
21개의 peer-reviewed publication으로 benchmark를 만들었음
여기서 중요한 조건은, 설계 정보가 모두 논문에서만 나와야 한다는 점
Latent-Y는 논문을 바탕으로 biological context, mechanism of action, functionally relevant site의 identity와 structural location을 추론해야 했음
Prompt에는 target protein name만 넣었음
-> 특정 논문에는 여러 단백질이 나오기 때문에, 어떤 단백질을 설계 타깃으로 삼을지 혼동을 막기 위해서
사용자는 “이 논문에서 설명하는 기능을 겨냥해 [TARGET_NAME]에 결합하는 VHH 24개를 설계해라” 라고 제시
정보 누출을 막기 위해 antibody-bound structure가 없는 epitope를 골랐음
source publication이 지정한 epitope에 대해 Fab-, scFv-, 또는 VHH-bound structure가 PDB에 없는 타깃을 골랐음
만약 이미 PDB에 항체가 epitope에 붙은 구조가 있다면, Latent-Y가 그 구조를 참고해서 비슷한 방식으로 설계할 가능성이 생김
epitope identification은 21/21, 100% 성공
Latent-Y는 21개 campaign 중 21개 모두에서 correct target epitope를 식별했다고 보고
24개 이상 passing binder 생성은 pre-QA 17/21, post-QA 16/21
QA 후 숫자가 줄어드는 이유는 중복 서열, 기존 항체와 너무 유사한 서열, CDR 안의 liability motif 등을 제거하기 때문
passing binder 수는 선형적으로 늘지 않았음
passing binder 수가 선형적으로 증가하지 않고, campaign이 진행되면서 갑자기 빨라지는 경우가 많았음
초반에는 다양한 epitope, framework, CDR length 조합을 탐색
이때는 pass가 잘 안 나올 수 있음
그러다가 생산적인 조합을 찾으면 그 방향에 집중하고, passing design이 빠르게 쌓이기 시작
-> 처음에는 여러 길을 시험하고, 좋은 길을 찾으면 그 길로 달리는 방식
hTfR1은 budget을 늘려 40개 후보를 wet lab에 보냈고, 11개 hit
hTfR1 campaign은 실험 검증을 위해 표준 10,000 sample budget보다 더 확장
최종적으로 QA 후 40개 high-quality binder를 선택해 wet lab으로 보냈고, HT-SPR screening 결과 11/40이 binder hit로 확인
✅ Methods
Latent-Y의 핵심 reasoning engine은 frontier large language model
Context management와 subagent 구조
특히 강조하는 설계 원칙은 effective context management
긴 연구 캠페인을 agent가 수행하다 보면, 문헌 조사, 구조 분석, 후보 생성, QA, 사용자 지시, 이전 batch 결과 등 정보가 너무 많아짐
이 정보를 한꺼번에 LLM context에 다 넣으면 혼란이 생기거나 중요한 정보를 잃을 수 있음
그래서 Latent-Y는 specialized subagent를 사용
(1) hotspot researcher subagent
target characterization과 epitope analysis를 담당
-> “타깃 단백질에서 어디를 잡아야 좋은가?”를 분석하는 역할
(2) quality assurance subagent
candidate evaluation, diversity filtering, sequence liability analysis를 담당
-> 후보들이 너무 비슷하지 않은지, 기존 항체와 너무 유사하지 않은지, 문제가 될 수 있는 서열 motif가 있는지 확인
Latent-Y가 사용하는 도구와 데이터베이스
ANARCI: 항체 서열의 numbering과 classification에 쓰이는 도구
MMseqs2: 대규모 단백질 서열 검색 도구
BLAST: 단백질 또는 DNA 서열 유사성을 찾는 대표적인 검색 도구
Biotite: Python 기반 생물정보학/구조생물학 분석 라이브러리
사용하는 외부 데이터베이스와 API
UniProt: 단백질 서열, 기능, annotation 정보
PDB: 실험적으로 결정된 단백질 구조 데이터베이스
NCBI / PubMed: 논문과 생물학 데이터 검색
SAbDab: 항체 구조 데이터베이스. 후보가 기존 항체와 얼마나 유사한지 확인하는 데 사용
ChEMBL: 생물활성 데이터베이스
AlphaFold Protein Structure Database: 예측 단백질 구조 데이터베이스
이런 일반 도구 외에도, protein binder design campaign에 특화된 내부 도구들이 있음
Modality 선택
Nanobody / VHH: 작은 단일 도메인 항체
Macrocyclic peptide: 고리형 펩타이드
Miniprotein binder: 작은 단백질 기반 binder
System prompt와 reasoning 방식
Latent-Y에는 “신약 설계 campaign에서 보통 어떤 전략이 생산적인가”, “어떤 품질 기준을 봐야 하는가”, “언제 탐색하고 언제 확장해야 하는가” 같은 축적된 설계 원칙이 system prompt 형태로 들어감
중요한 점은 이게 rigid workflow가 아니라 soft guidance라는 것
Rigid workflow는 “항상 1번, 2번, 3번 순서대로만 실행하라”는 고정 파이프라인
soft guidance는 “이런 식으로 사고하면 좋다”는 방향성은 주되, 실제 상황에 따라 agent가 경로를 바꿀 수 있게 하는 방식
논문은 복잡하고 열린 과제에서는 rigid workflow보다 soft guidance가 낫다고 봄
Explore-then-exploit reasoning
처음에는 여러 epitope, framework, CDR 길이, hotspot 조합을 넓게 시험
-> explore
그다음 중간 결과를 보고 pass rate가 높은 방향, iPTM이 높은 방향, 구조적으로 그럴듯한 방향을 찾아 계산 자원을 집중
-> exploit
✅ Discussion
-
Latent-Y는 lab-validated result를 낸 최초의 autonomous agent for de novo biologics design
-
저자들이 특히 주목하는 것은 Latent-Y가 scientific literature에서 추론할 수 있다는 점
-
Latent-Y가 고정 workflow를 실행하는 시스템이 아님
-> 처음에 정해진 pipeline을 무조건 따르는 것이 아니라, 중간 결과를 보고 전략을 바꾼다는 것