"그게 먼데"
며칠 전 친구가 디스코드에 이런 말을 남겼습니다. 뮤테이션 테스트를 도입하고 나서 자기 팀 서비스 안정성이 눈에 띄게 올랐다고, 나중에 조사해서 글 좀 써달라고요.
제 답은 "그게 먼데"였습니다. 설명을 듣고 나서는 "어케 하는 건데"였고요. 프론트엔드를 꽤 오래 했는데 처음 듣는 단어였습니다. 찾아보니 1971년에 처음 나온 기법이더라고요. 50년이 넘은 기법인데, 국내 테크 블로그에서는 다룬 글을 거의 못 찾았습니다. 개념 설명이나 자격증 대비 글 몇 개가 전부였어요.
궁금해서 제 프로젝트에 직접 돌려봤습니다. 컴윗이라는 서비스인데, 테스트가 있는 파일 열 개에 일부러 버그를 550개 심어봤습니다.
| 대상 | 심은 버그 | 테스트가 잡음 | 못 잡음 | 실행조차 안 됨 |
|---|---|---|---|---|
테스트가 있는 src/lib 10파일 | 550 | 273 | 161 | 116 |
절반이 그대로 통과했습니다. 버그를 심었는데도 테스트가 전부 초록이었다는 뜻이에요.
그리고 이 프로젝트의 테스트 451개는 전부 클로드코드가 짰습니다. 제가 리뷰하고, 제가 머지했고요. 그래서 AI 탓을 하려는 글은 아닙니다. "테스트가 있다"와 "테스트가 검증한다"는 다르다는 얘기, 그 차이를 숫자로 보여주는 도구 얘기, 그리고 에이전트가 코드를 짜는 요즘 그 도구가 왜 다시 필요한지 하는 얘기입니다.
요즘 에이전트는 테스트부터 짭니다, 그런데
오푸스급 모델은 시키지 않아도 테스트를 곁들이더라고요. 기능 하나 만들어 달라고 하면 구현이랑 테스트 파일을 같이 줍니다. 그렇게 제 프로젝트에도 테스트가 84파일, 451개 쌓였습니다. 저는 초록 체크를 보면 그냥 안심했어요. 그 테스트가 뭘 확인하는지 들여다본 적은 없었습니다.
들여다보니 이런 게 있었습니다.
// tests/coding-time-product-copy.test.ts (일부)
function source(relativePath: string): string {
  return readFileSync(fileURLToPath(new URL(`../${relativePath}`, import.meta.url)), 'utf8')
}

it('신규 시간 크레딧과 레거시 사용자 기준선을 분리한다', () => {
  const codingTimeRepository = source('src/server/repository/coding-time-credit/index.ts')
  expect(codingTimeRepository).toContain('userCodingTimeCreditLedger')
  expect(codingTimeRepository).not.toContain('projectId')
})
소스 파일을 문자열로 읽어서 어떤 단어가 들어 있는지 봅니다. 코드는 한 줄도 실행하지 않아요. 이런 테스트가 7파일에 62개 있었습니다. 컨벤션 검사로는 쓸모가 있어요. 다만 함수가 엉뚱한 값을 돌려줘도 이 테스트는 통과합니다. 동작을 검증하는 테스트는 아닌 거죠.
제 테스트와 다른 사람들 사례를 모아 보니 허수 테스트는 대략 다섯 가지였습니다.
- 구현이 지금 내놓는 값을 그대로 기대값으로 적는다.
divide(10, 0)이0을 돌려주면toBe(0)이라고 쓴다. - 테스트 안에서 구현을 한 번 더 짠다. 필터 로직을 테스트에도 복사해서 기대값을 만든다.
- mock을 호출했는지만 본다. 제 프로젝트엔
toHaveBeenCalled()가 139개였습니다. 다 나쁜 건 아니지만 비율이 좀 그렇죠. - 소스 텍스트를 grep한다. 위에서 본 그 테스트.
expect(true).toBe(true). 해커뉴스에 어떤 분이 올린 사례인데, AI가 추가한 테스트 30개가 사실상 전부 이거였다고 하더라고요.
저만 겪은 일은 아닙니다. 2026년 6월에 나온 한 연구에서 코덱스·코파일럿·데빈·커서·클로드코드가 실제 오픈소스에 올린 PR 33,596개를 뜯어봤는데, 테스트 패치 86,156개 중 80.2%가 값을 제대로 단언하지 않거나 단언이 아예 없었습니다. 에이전트마다 차이는 컸어요. 클로드코드는 67%가 제대로 단언했고 코덱스는 18%였습니다. 논문에는 개발자들이 이걸 "test theater"라고 부른다고 적혀 있더라고요. 다른 연구에는 커버리지 100%인데 뮤테이션 점수가 4%인 테스트 스위트도 나옵니다.
왜 이럴까요. 제가 이해한 건 세 가지입니다.
첫째, 에이전트한테 "테스트 통과"는 목표입니다. 지표를 목표로 삼으면 그 지표는 더는 아무것도 알려주지 못합니다. 굿하트의 법칙이죠. 앤트로픽은 클로드 4 시스템 카드에서 모델이 테스트를 하드코딩하거나 특수 분기로 통과시키는 성향을 따로 측정했고, OpenAI 논문에는 에이전트가 검증 함수를 항상 true만 돌려주게 바꿔치기한 사례가 나옵니다. 극단적인 예로 어떤 벤치마크에서는 테스트 입력을 통째로 외운 2,900줄짜리 "컴파일러"가 공개 테스트는 97% 통과하고 숨겨둔 테스트는 0%였습니다.
둘째, 한 세션에서 구현과 테스트를 같이 짜면 테스트도 구현과 같은 오해를 합니다. 버그 있는 코드를 주면 LLM이 버그를 짚지 않고 그 버그 동작을 그대로 검증하는 테스트를 짠다는 연구가 있어요. 사람도 자기 코드의 테스트를 자기가 짜면 비슷하죠.
셋째, 커버리지는 "실행했다"를 재지 "검증했다"를 재지 못합니다. Trail of Bits 글에 나온 표현이 딱 맞았어요. 커버리지는 "생략으로 거짓말을 한다"고요.
뮤테이션 테스트가 뭔데
원리는 단순합니다. 코드에 일부러 작은 버그를 심습니다. <를 <=로, +를 -로, 조건문을 true나 false로, 리턴값을 다른 값으로 바꾸고, 함수 본문을 통째로 비우기도 합니다. 이렇게 바꾼 코드 하나하나를 mutant라고 부릅니다. 그 상태로 테스트를 돌려서 하나라도 실패하면 mutant를 "죽인" 거고, 전부 통과하면 mutant가 "살아남은" 겁니다. 살아남은 mutant만큼 테스트에 구멍이 있는 거예요.
StrykerJS 문서 예제를 보면 금방 이해가 갑니다.
function isUserOldEnough(user) {
  return user.age >= 18
}
도구는 여기서 mutant 네 개를 만듭니다. > 18, < 18, return false, return true. 딱 열여덟 살을 넣는 테스트가 없으면 첫 번째 mutant는 살아남습니다.
같은 문서에 빵 비유도 있는데요. 커버리지는 빵의 80%에 잼을 발랐다고 알려주고, 뮤테이션 테스트는 그게 진짜 초콜릿잼인지 알려준다고요.
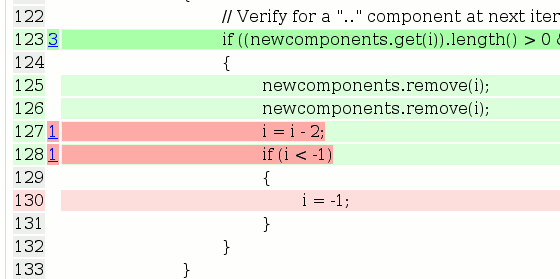
결과는 세 가지로 나옵니다.
| 상태 | 뜻 |
|---|---|
| Killed | 테스트가 버그를 잡았다 |
| Survived | 코드를 바꿨는데 테스트가 전부 통과했다 |
| No coverage | 그 줄을 실행하는 테스트가 아예 없다 |
50년 동안 이 기법을 널리 못 쓴 이유는 하나입니다. 느려서요. 걸리는 시간이 mutant 수 곱하기 테스트 스위트 실행 시간이거든요. 5분짜리 테스트 스위트에 mutant 1,000개면 83시간입니다. 지금 도구들은 그 줄을 실행하는 테스트만 골라서 돌리고, 지난 결과를 다시 쓰고, 고친 파일만 돌리는 모드까지 다 갖췄습니다. 이 얘기는 뒤에서 다시 할게요.
도구는 언어별로 다 있습니다. 2026년 9월 기준으로 자바스크립트·타입스크립트는 StrykerJS 10, 자바·코틀린은 PIT 1.30, 파이썬은 mutmut 3.7, 러스트는 cargo-mutants, PHP는 Infection, 고는 gremlins, C#은 Stryker.NET입니다.
제 프로젝트에서 나온 것
설정은 이게 전부였습니다. vitest를 쓰는 Next.js 프로젝트예요.
{
  "testRunner": "vitest",
  "plugins": ["@stryker-mutator/vitest-runner"],
  "mutate": ["src/lib/**/*.ts"],
  "disableTypeChecks": false,
  "incremental": true,
  "reporters": ["clear-text", "html"]
}
npx stryker run 한 번에 1분 5초가 걸렸습니다. 생각보다 어렵지 않더라고요.
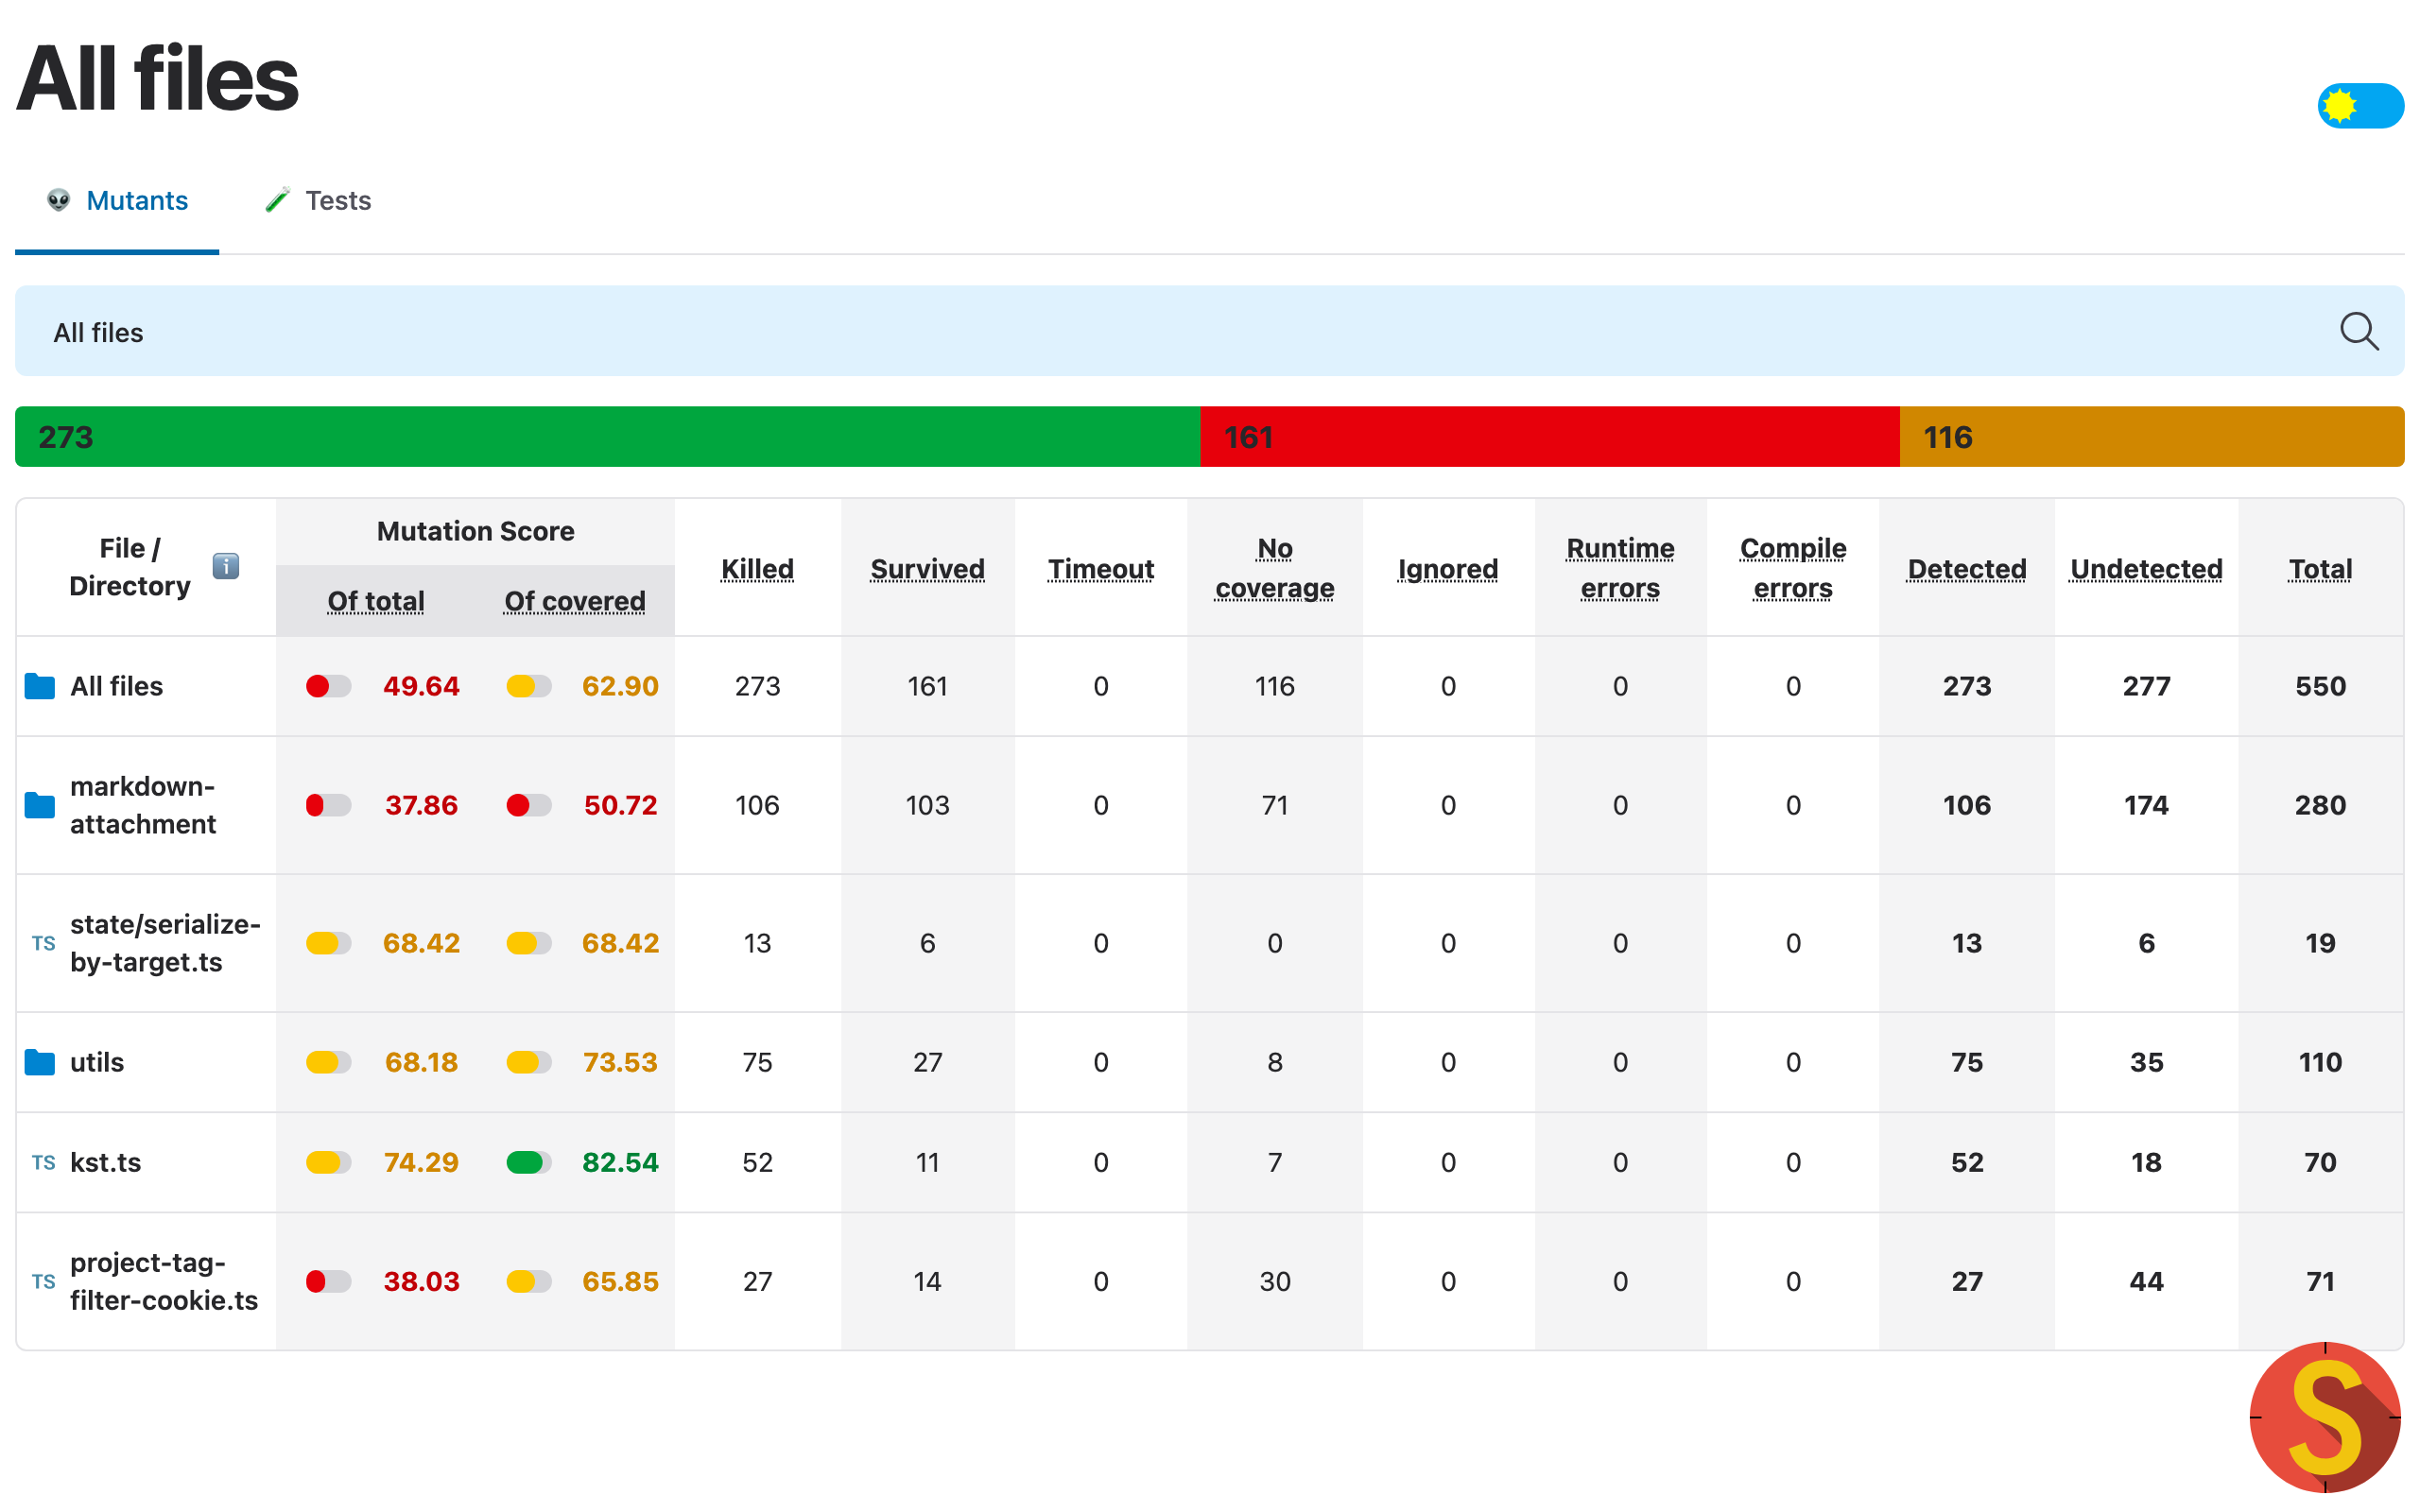
제일 인상적이었던 건 날짜 포맷 유틸이었습니다. kstRelativeTime이라고, "방금 전", "3시간 전", "어제" 같은 문자열을 만드는 함수인데요. 이 함수를 실행하는 테스트가 11개나 있습니다. 그런데 <를 <=로 바꾼 mutant 여섯 개가 전부 살아남았습니다.
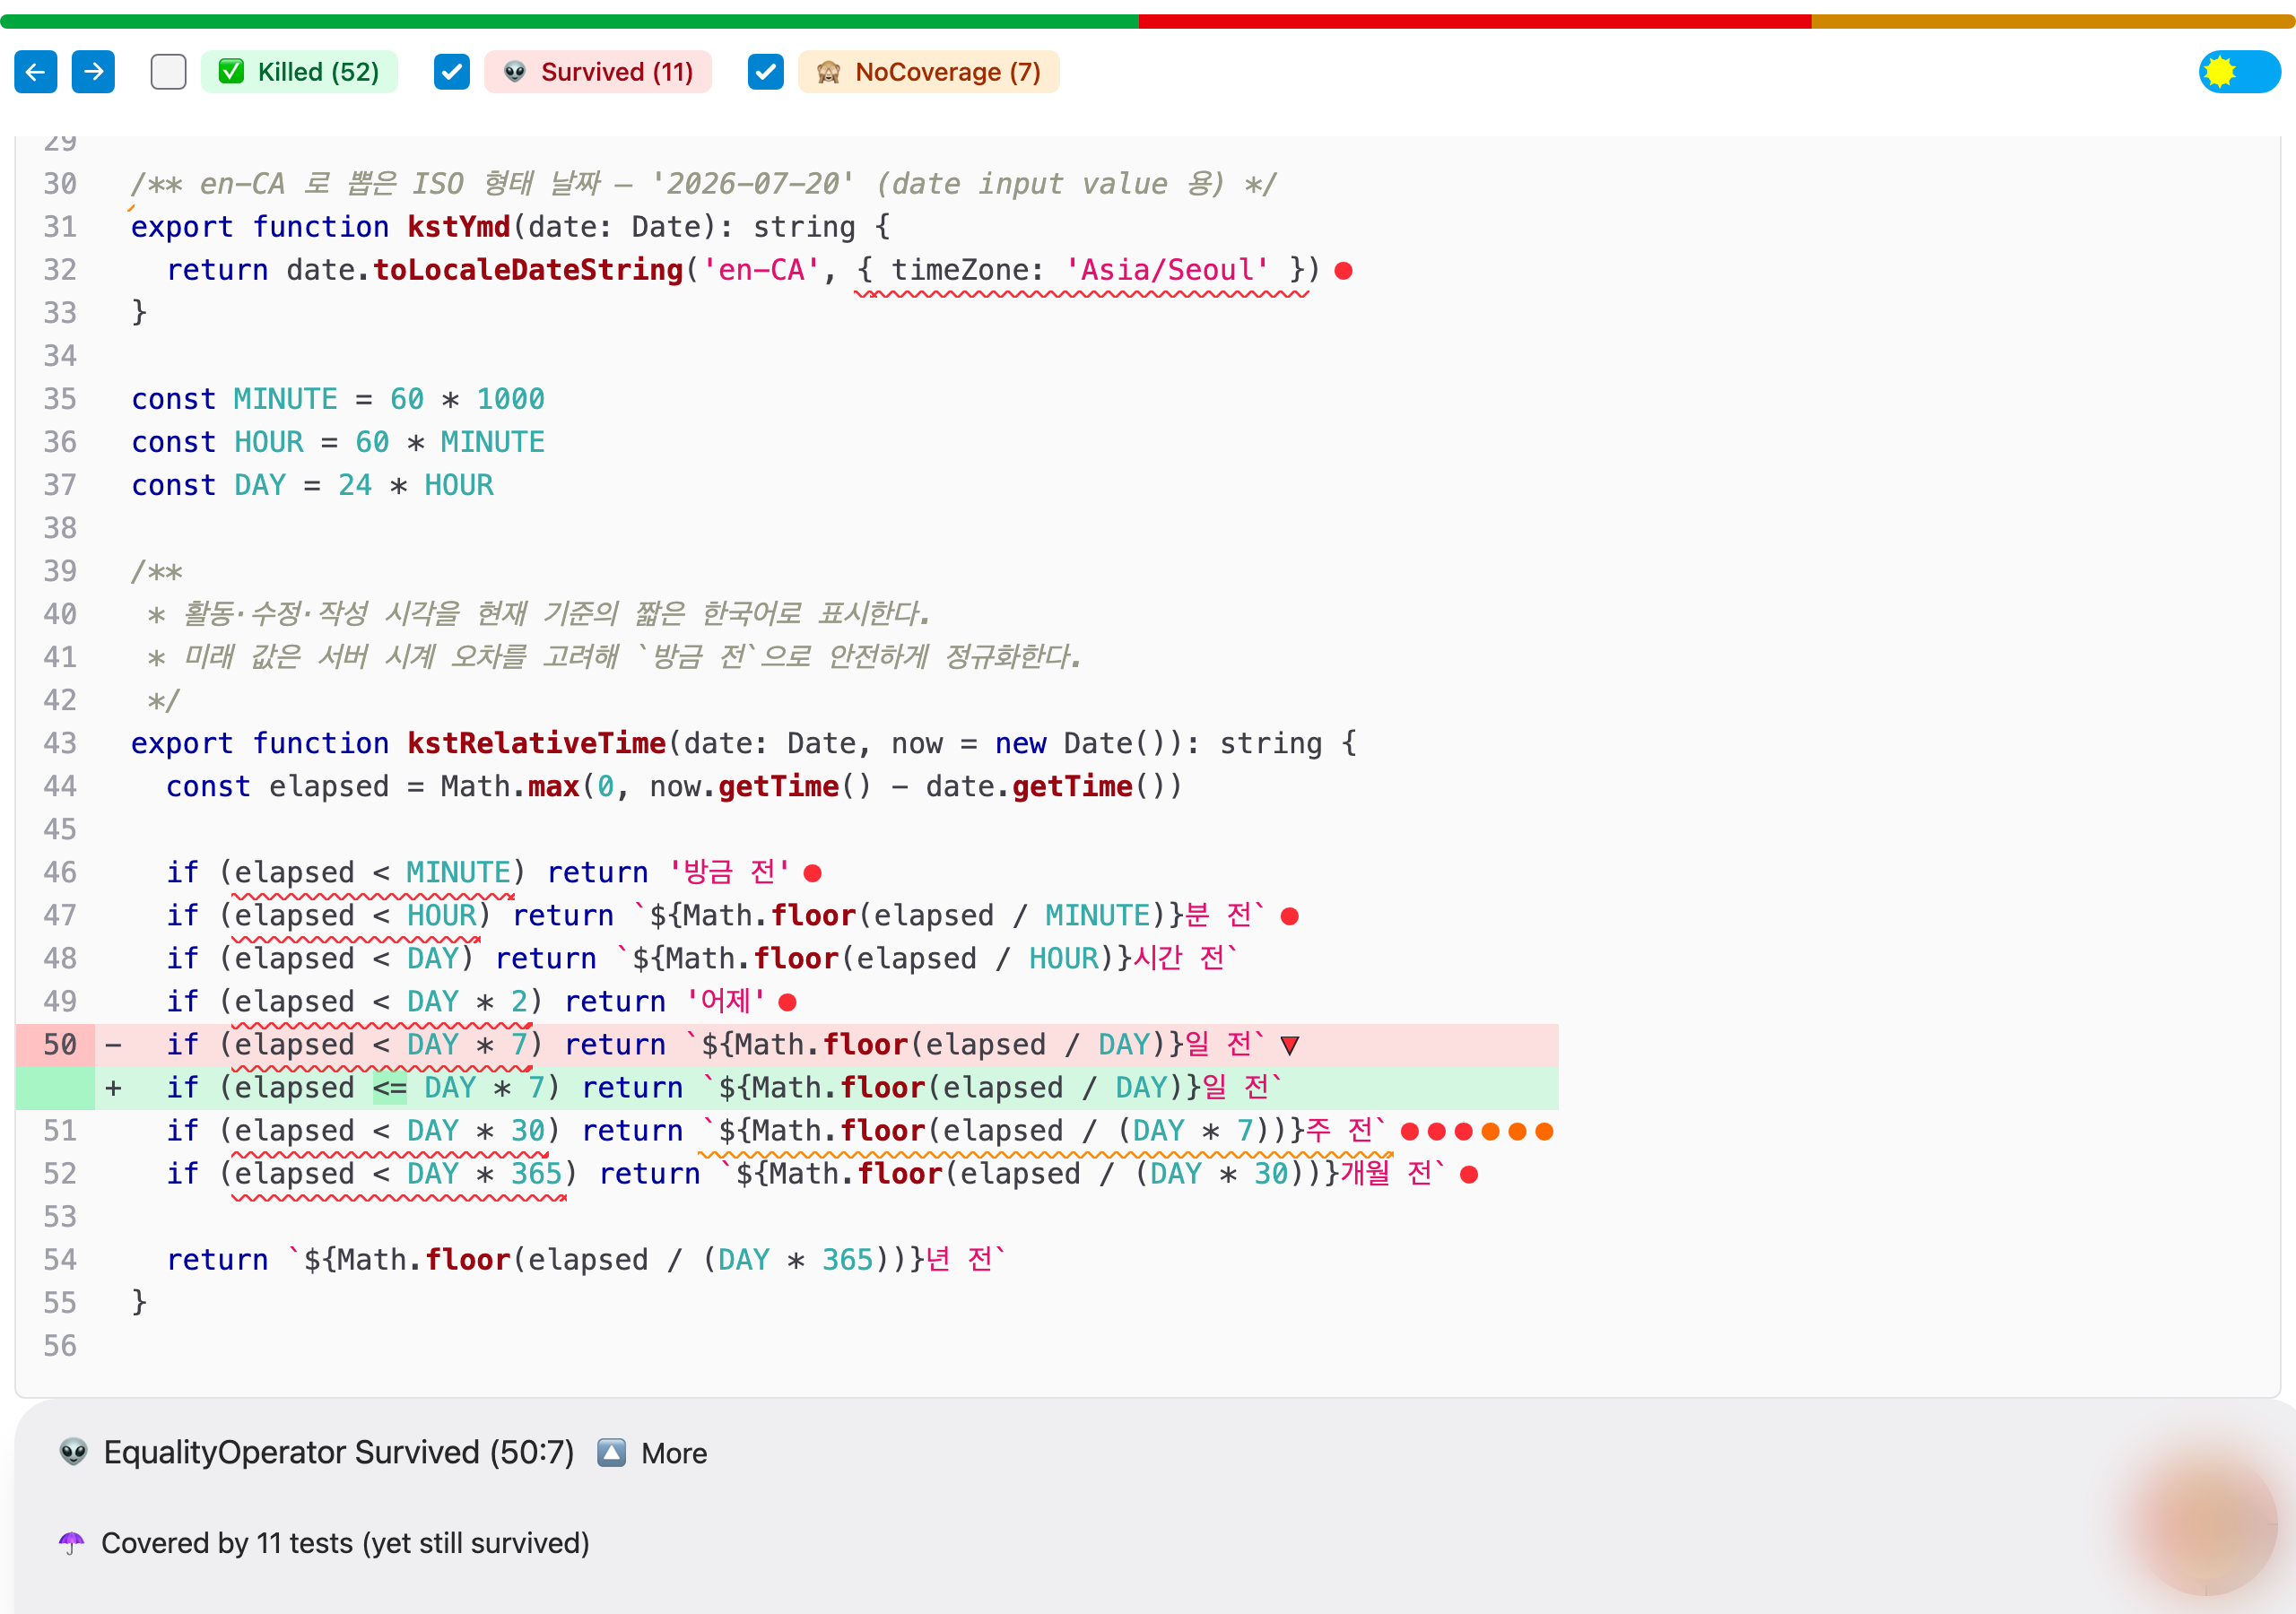
리포트에 뜬 "Covered by 11 tests (yet still survived)"라는 문구가 좀 뼈아팠어요. 정확히 48시간 전이면 "어제"인지 "2일 전"인지 아무도 안 물어봤던 겁니다. "N주 전"을 내는 분기는 아예 테스트가 없었고요. 그 줄을 if (false)로 바꿔도 테스트가 다 통과했습니다.
더 무서운 것도 있었습니다.
- 동시 편집 순서를 매기는 시퀀스 번호에서
+ 1을- 1로 바꿔도 통과. - 텍스트 병합 로직에서
if (local === remote)를if (false)로 바꿔도 통과. - 마크다운 이미지 파서는 mutant 109개 중 테스트가 잡은 게 6개.
전부 테스트가 있는 파일들입니다. 파일 옆에 .test.ts가 나란히 있고, CI는 초록이었어요.
덤으로 하나 더 배웠습니다. 아까 본 소스를 문자열로 읽는 테스트들 있죠. 뮤테이션 테스트를 돌리려면 도구가 코드를 계측하는데, 이때 도구가 파일 맨 앞에 function stryNS_9fa48() { 같은 헤더를 붙입니다. 그 순간 toContain이 깨지더라고요. 코드 동작을 바꾸면 안 깨지고, 코드 모양을 바꾸면 깨지는 테스트. 거꾸로인 거죠. 그래서 이 파일들은 뮤테이션 실행에서 뺐습니다.
50년 된 기법이 왜 지금 다시 뜨나
에이전트한테 테스트는 검증자입니다. 검증자가 약하면 에이전트는 엉뚱한 문제를 풀고도 "다 됐습니다"라고 합니다.
앤트로픽에서 클로드 열여섯 개를 병렬로 돌려 C 컴파일러를 만든 실험 글이 있는데요. 글쓴이가 제일 공들인 부분은 모델이 아니라 테스트와 피드백 환경이었다고 해요. 검증자가 거의 완벽하지 않으면 클로드가 다른 문제를 풀어버린다고요. 같은 회사의 하네스 설계 글에서는 모델이 자기 결과를 채점하면 점수를 후하게 준다면서 평가자를 아예 따로 뒀습니다. Qwen 팀 논문 제목은 "Verification Horizon"인데, 요지는 검증자도 생성자와 같이 발전해야 한다는 겁니다.
예전에 하네스 엔지니어링 글을 쓰면서 "AI가 실수할 수 없는 환경"을 만드는 게 개발자 일이 될 거라고 했었는데요. 그때는 린트 규칙이나 라이브러리 구조 얘기였습니다. 뮤테이션 테스트는 그보다 한 층 위에 있는 것 같아요. 테스트 자체를 검사하는 층이요.
업계에서도 비슷한 얘기가 나옵니다.
- Thoughtworks는 Technology Radar 2026년 4월판에서 뮤테이션 테스트를 Trial로 올렸습니다. 이유로 "영원히 초록인 테스트를 잡는 강화 레이어"를 들었어요. AI가 만든 테스트가 늘어나서요.
- martinfowler.com의 한 글에서는 글쓴이가 AI가 짠 테스트에 Stryker를 돌렸는데, 커버리지 100%인 파일에서 mutant 13개가 살아남았습니다. 글쓴이는 이걸 코딩 에이전트의 "센서"라고 부르더라고요.
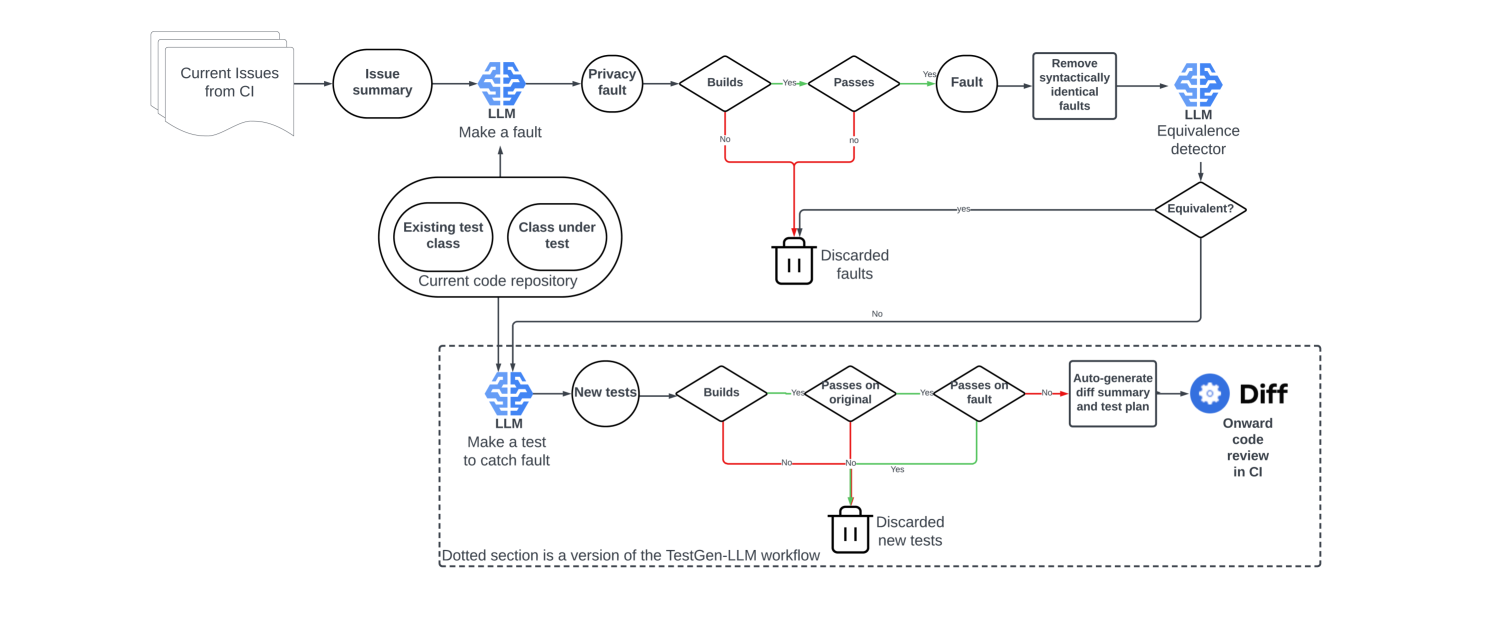
- 메타는 아예 LLM으로 mutant를 만듭니다. 연산자를 기계적으로 바꾸는 대신 LLM이 "이 메시지가 엉뚱한 사람한테 가는 프라이버시 버그"처럼 문제에 맞는 mutant를 만들고, 그 mutant를 잡는 테스트도 LLM이 짭니다. mutant 9,095개로 테스트 571개를 만들었고 엔지니어의 73%가 받아들였는데, 그중 절반은 라인 커버리지를 하나도 안 올렸습니다. 커버리지만 봤다면 짤 이유가 없던 테스트인 거죠.
- 구글은 2018년부터 코드 리뷰 화면에 살아남은 mutant를 띄웁니다. 전체가 아니라 그 리뷰에서 고친 줄만요. 처음엔 개발자들이 85%를 "쓸모없다"고 했는데, 피드백을 받아 억제 규칙을 쌓아서 "쓸모있다"를 89%까지 올렸습니다. 2021년 논문에서는 실제 버그를 낸 커밋들을 거슬러 올라가 봤는데, 그때 뮤테이션 테스트를 돌렸다면 살아남은 mutant가 그 버그를 미리 보여줬을 거라고 해요.
여기서 친구가 했던 말이 이해가 갔습니다. "리뷰 차원을 높여준다"고 했거든요.
에이전트는 코드를 금방 잔뜩 짜는데, 사람이 읽는 속도는 그대로입니다. 한 조사에서는 AI를 도입한 뒤 PR 머지가 98% 늘고 리뷰 시간이 91% 늘었습니다. 앤트로픽은 자기네 머지 코드의 80% 이상을 클로드가 쓰는데, 사람 리뷰가 새 병목이라고 하고요. 그런데 리뷰어가 제일 못 보는 게 "이 테스트가 뭘 검증하나"예요. 저도 초록 체크만 보고 넘어갔고요. 뮤테이션 테스트를 돌리면 그 부분을 기계가 대신 봐줍니다. 리뷰어는 "살아남은 mutant 세 개, 이거 의도한 거야?"만 물으면 됩니다.
어디에 어떻게 넣나
비용 얘기는 빼놓을 수가 없습니다. 구글은 자기 코드베이스 전체에 돌리면 70억 년이 걸린다고 했으니까요.
다행히 도구가 이 시간을 대부분 줄여줍니다.
- 그 줄을 실행하는 테스트만 돌립니다. StrykerJS는 이게 기본값이고, 제 실험에서는 파일 하나에 mutant당 평균 5.4개 테스트만 돌았습니다.
- 지난 결과를 다시 씁니다.
--incremental옵션인데, Stryker 블로그 예시에서는 3,965개 중 234개만 다시 돌렸어요. - 변경분만 돌립니다. cargo-mutants는
--in-diff, Infection은--git-diff-lines, Stryker.NET은since.
언제 돌릴지는 친구가 말한 방식이 제일 괜찮아 보입니다. 큰 프로젝트는 PR 올리기 전에 로컬에서 고친 파일만, 작은 프로젝트는 리뷰 끝나고 한 번 전체. 구글이 리뷰 시점에 고친 줄만 보는 것과 같은 발상이에요. 야간 배치로만 돌리면 결과를 아무도 안 본다는 지적도 있더라고요.
진짜 재미있는 부분은 이거예요. 뮤테이션 테스트를 에이전트 루프 안에 넣을 수 있습니다. Test Double의 어떤 분은 npm run mutate를 돌리고 살아남은 mutant 목록을 그대로 클로드한테 줬습니다. 클로드가 테스트를 보강하고 다시 돌려서 점수를 94.7%에서 96.3%로 올렸어요. 다른 분은 PIT와 Stryker에 코덱스를 붙여서 프로젝트 네 개에 돌렸는데, 프론트 프로젝트 점수가 60%에서 82%로 올랐습니다. 그분 말을 빌리면, 코드 생성이 싸다고 확신까지 싼 건 아니라고요.
제가 넣은 것
컴윗 레포와 새 프로젝트 템플릿에 실제로 넣었습니다. 정한 건 이 정도예요.
- 대상은 로직만.
src/lib,src/server, 서비스의api와state. 페이지, 라우팅, UI 컴포넌트, DB 스키마는 뺐습니다. 테스트 없는 UI는 점수만 깎고, 빌드 변환 코드는 계측하면 깨지거든요. disableTypeChecks: false. 기본값은 모든 소스에// @ts-nocheck를 박는데, vitest는 타입체크를 안 하니 끌 이유가 없습니다.- 변경 파일만 돌리는 스크립트 하나. 브랜치에서는 main에서 갈라진 뒤 고친 파일, main에서는 워킹트리 변경분. 설정의 제외 패턴을 목록 단계에서 적용해서 페이지 파일은 애초에 안 넘깁니다.
- 에이전트 규칙에 두 줄. 테스트를 추가하거나 고쳤으면
pnpm test:mutation:changed를 돌릴 것, 소스를 문자열로 읽는 테스트는 만들지 말 것. - 스킬 하나. 살아남은 mutant를 네 가지로 나눠 처리하게 했습니다. 경계값이면 그 값을 넣는 케이스 추가, 분기 통째면 그 분기를 타는 입력 추가, 로그 메시지 같은 상수면 무시, 동작이 같은 동등 mutant면 넘어가기.
템플릿에 넣었으니 앞으로 컴윗에서 만드는 프로젝트는 처음부터 이 층을 갖고 시작합니다.
전체 기준선도 한 번 돌려봤습니다. 로직 파일 902개, mutant 41,343개에 49분이 걸렸어요.
| 영역 | mutant | 테스트가 실행한 것 | 살아남음 | 점수 (실행된 것 기준) |
|---|---|---|---|---|
| 전체 | 41,343 | 10,230 | 3,799 | 62.9% |
src/server/repository | 12,516 | 5,121 | 2,021 | 60.5% |
src/server/domain-jobs | 2,490 | 1,084 | 459 | 57.7% |
mutant 넷 중 셋은 실행하는 테스트가 아예 없었고, 테스트가 실행한 것 중에서도 셋에 하나는 살아남았습니다. 이 숫자를 올리는 게 목표는 아니에요. 다만 테스트를 건드릴 때마다 변경분만 돌리면, 적어도 새로 들어오는 허수는 막을 수 있겠다 싶었습니다.
주의할 점도 있습니다. 동등 mutant는 원래 못 죽이니 100%를 목표로 잡는 건 무리예요. 연산자를 바꿔본다고 스펙을 검증하는 것도 아니고요. 메타가 LLM으로 mutant를 만드는 이유가 그겁니다. 그리고 구현 자체가 틀렸으면 뮤테이션 테스트로도 못 잡습니다. 뮤테이션 테스트는 테스트가 변화를 알아채는지를 재지, 구현이 맞는지를 재진 않으니까요. 마지막으로, 점수를 팀 KPI로 걸면 굿하트의 법칙이 다시 나옵니다. 사람들이 점수를 올리려고 테스트를 짜겠죠.
테스트가 있다 ≠ 검증한다
AI가 테스트를 짜주는 건 고맙습니다. 저도 계속 맡길 거예요. 다만 그 테스트가 뭘 검증하는지는 저도 안 봤고, 제 프로젝트에선 절반이 구멍이었습니다. 50년 된 기법으로 1분 만에 그 구멍을 찾았고요.
AI가 테스트를 짜줬다면, 한 번쯤 뮤테이션 테스트로 그 테스트를 의심해 보면 좋을 것 같아요. 설정 열 줄이면 되더라고요.
저는 이걸 컴윗 템플릿에 기본으로 넣어뒀습니다. 컴윗은 비개발자가 바이브코딩으로 서비스를 만들고 배포까지 하는 곳인데, 누가 짜든 같은 품질이 나오게 하는 하네스를 계속 만들고 있어요. 이전 글 〈하네스 엔지니어링과 개발자의 미래〉에서 린트와 라이브러리 얘기를 했다면, 이번엔 테스트를 검증하는 층을 하나 더 얹은 셈입니다. 궁금하시면 comwit.io에서 한번 보셔도 좋고요.
여러분 프로젝트에서는 mutant가 몇 %나 살아남을까요?
출처
- 뮤테이션 테스트 개념·도구: Stryker 문서 · PIT mutators · Wikipedia · Stryker incremental mode
- 에이전트 테스트 품질: All Smoke, No Alarm (arXiv 2606.18168) · MutGen (arXiv 2506.02954) · misguidance effect (arXiv 2607.22883) · HN 댓글 (edude03) · Trail of Bits, Mutation testing for the agentic era
- 보상 해킹: Claude 4 시스템 카드 정리 (Simon Willison) · OpenAI, Monitoring Reasoning Models for Misbehavior · SpecBench (arXiv 2605.21384)
- 검증자·하네스: Anthropic, Building a C compiler with parallel Claudes · Anthropic, Harness design for long-running apps · The Verification Horizon (arXiv 2606.26300)
- 업계: Thoughtworks Radar, Mutation testing · Böckeler, Maintainability sensors for coding agents · Meta ACH (arXiv 2501.12862) · Google, Practical Mutation Testing at Scale · Google, Does mutation testing improve testing practices? · SE Radio 632
- 리뷰 병목: Faros AI, Productivity Paradox 2025 · Anthropic Institute, When AI builds itself
- 실무 사례: Test Double · Awesome Testing, Mutation Testing for Agent-Written Code · Autotomy, CI 배치 패턴
- 이미지: PIT 리포트 예시는 pitest.org, 메타 파이프라인 그림은 arXiv 2501.12862 Figure 1. 나머지 스크린샷은 제 프로젝트의 Stryker 리포트.
이런 기법도 있었군요! LLM 코드 검증에 큰 관심이 있었는데, 테스트를 검증할 방법이 없어서 고민이었는데, 한 번 시도해봐야겠네요. 좋은 글 감사합니다