[논문 리뷰] Ablation-CAM - Ablation-CAM: Visual Explanations for Deep Convolutional Network via Gradient-free Localization(2020)
[논문 리뷰]
Paper: Ablation-CAM: Visual Explanations for Deep Convolutional Network via Gradient-free Localization
🔍1. Introduction
Convolutional Neural Network(CNN)는 다양한 Computer Vision Task에서 높은 성능을 보여주고 있음.
- Image Classification
- Object Detection
- Semantic Segmentation
- Image Captioning
- Visual Question Answering
등의 분야에서 활용되고 있고,
이러한 발전은 CNN Architecture의 개선과 Computing Power의 증가 덕분에 가능해짐.
하지만 CNN의 높은 성능에도 불구하고 여전히 중요한 문제가 존재함.
바로 Black-box Problem.
CNN은 높은 정확도로 Prediction을 수행할 수 있지만,
왜 이러한 Prediction을 내렸는지 사람이 직접 이해하기 어려움.
해당 문제는 모델의 Trust와 직접적으로 연결됨.
특히 Healthcare, Finance, Security와 같이 하나의 잘못된 판단이 큰 영향을 줄 수 있는 분야에서는 단순히 높은 Accuracy만으로 모델을 신뢰하기 어려움.
따라서 CNN의 Prediction을 사람이 이해할 수 있도록 모델의 판단 근거를 설명하는 방법이 필요함.
CNN의 판단 과정을 설명할 수 있다면 단순히 모델에 대한 신뢰도를 높이는 것뿐만 아니라 다양한 목적으로 활용할 수 있음.
대표적으로
- Model Failure 분석
- Model Debugging
- Training Data의 Bias 발견
- 잘못 학습된 Feature 확인
등에 사용할 수 있음.
그리고 이런 Visual Explanation을 생성하는 대표적인 방법이 Grad-CAM임.
단, Grad-CAM의 한계
Grad-CAM은 Target Class에 대한 Gradient를 이용하여 각 Feature Map의 중요도를 계산함.
개념적으로는
Input Image
     ↓
    CNN
     ↓
Feature Maps
     ↓
Target Class Gradient 계산
     ↓
각 Feature Map의 Weight 계산
     ↓
Weighted Sum
     ↓
Grad-CAM
과 같은 방식임(Gradient 기반 방식).
Target Class Score에 큰 Gradient를 가지는 Feature Map은 해당 Class Prediction에 중요할 것이라고 보는 것임.
하지만 본 논문 저자들은 이런 Gradient 기반 Feature Importance에 문제가 발생할 수 있다고 함.
Gradient Saturation Problem
CNN의 최종 Output은 Input Image와 이전 Layer들을 거쳐 만들어지는 복잡한 Non-linear Function임.
따라서 Target Class에서 이전 Layer 방향으로 Gradient를 Backpropagation할 때 Gradient Saturation이 발생할 수 있음.
그러니
실제로 중요한 Feature
        ↓
여러 Layer와
Non-linear Function
        ↓
Gradient Backpropagation
        ↓
Gradient가 매우 작아짐
        ↓
Grad-CAM Weight 감소
와 같은 문제가 발생할 수 있다는 것.
실제 Prediction에 중요한 Feature라고 하더라도 Gradient가 작게 나타날 수 있고,
이는 Grad-CAM이 생성하는 Visualization의 품질에 부정적인 영향을 줄 수 있음.
따라서 저자들은 다음과 같은 의문을 제기함.
Feature Map의 중요도를 반드시 Gradient를 이용하여 계산해야 하나?
Ablation-CAM
앞서 소개한 Gradient 기반 문제를 해결하기 위해
본 논문에서는 새로운 Gradient-free Visual Explanation Method인 Ablation-CAM을 제안함.
<Ablation-CAM 아이디어>
: 어떤 Feature Map이 중요한지 알고 싶다면,
해당 Feature Map을 직접 제거한 뒤 Target Class Score가 얼마나 변하는지 확인하자.
여기서 Ablation은 특정 요소를 제거한 뒤 그 요소가 전체 결과에 얼마나 영향을 주고 있었는지를 확인하는 방법을 의미.
Ablation을 통한 Feature Importance 측정
ex. CNN의 특정 Convolutional Layer에서 다음과 같은 Feature Map들이 생성되었다고 가정함.
A¹ A² A³ A⁴ ... Aᴷ원래 모델의 Target Class Score가 다음과 같다고 해보자.
A¹   A²   A³   A⁴
ON   ON   ON   ON

dog score = 0.90
이제 Feature Map 을 제거함.
A¹   A²   A³   A⁴
OFF  ON   ON   ON

dog score = 0.25
Target Class Score가
0.90 → 0.25로 크게 감소함.
= 이 제거되었을 때 모델의 dog Prediction이 크게 영향을 받았구나.
=> 은
dogClass를 Prediction하는 데 중요한 Feature Map이라고 판단 가능
반대로 를 제거했다고 해보자.
A¹   A²   A³   A⁴
ON   OFF  ON   ON

dog score = 0.87
Score가
0.90 → 0.87정도로만 감소했다면,
는
dogPrediction에 상대적으로 중요하지 않은 Feature Map이라고 판단할 수 있음.
Ablation-CAM에서는
i)
Feature Map 제거
       ↓
Target Class Score 크게 감소
       ↓
해당 Feature Map 중요

ii)
Feature Map 제거
       ↓
Target Class Score 거의 변화 없음
       ↓
해당 Feature Map 중요도 낮음
이라는 방식으로 Feature Map의 Importance를 측정함.
Ablation-CAM의 전체적인 구조
전체 과정을 간단하게 표현하면 다음과 같음.
Input Image
      ↓
     CNN
      ↓
Feature Maps 추출

A¹ A² A³ ... Aᴷ
      ↓
Original Target Score 측정
      ↓
A¹ 제거 → Score 측정
A² 제거 → Score 측정
A³ 제거 → Score 측정
         ...
Aᴷ 제거 → Score 측정
      ↓
각 Feature Map의
Importance Weight 계산
      ↓
Weighted Combination
      ↓
Ablation-CAM
Grad-CAM처럼 Gradient를 이용해 Feature Importance를 간접적으로 추정하는 것이 아니라,
Feature Map을 실제로 제거해서 모델의 Prediction이 얼마나 영향을 받는지를 확인하는 방식ㄱ.
Class-discriminative Localization
Ablation-CAM은 Class-discriminative Localization이 가능함.
Class-discriminative하다는 것은
동일한 Input Image에서도 어떤 Class를 Target으로 설정하느냐에 따라 서로 다른 영역을 Highlight할 수 있다는 의미.
ex. 하나의 이미지에 Dog와 Cat이 동시에 존재한다고 할 때
┌───────────────────────┐
│                     │
│    DOG      CAT     │
│                     │
└───────────────────────┘
Target Class를 dog로 설정하면 각 Feature Map을 제거하면서 Dog Score가 얼마나 감소하는지 측정함.
[Target = dog]

Feature Map Ablation
       ↓
Dog Score 변화 측정
       ↓
Dog Prediction에
중요한 Feature Map 탐색
       ↓
Dog 영역 Highlight
반대로 Target Class를 cat으로 설정하면 Cat Score의 변화를 기준으로 Feature Map의 Importance를 다시 계산함.
[Target = cat]

Feature Map Ablation
       ↓
Cat Score 변화 측정
       ↓
Cat Prediction에
중요한 Feature Map 탐색
       ↓
Cat 영역 Highlight
이렇게 같은 Feature Map을 사용하더라도
Target Class에 따라 Importance Weight가 달라질 수 있5고,
결과적으로 서로 다른 Localization Map을 생성할 수 있음.
Guided Backpropagation과 결합
Ablation-CAM은 CAM-based Method이기 때문에 생성되는 Localization Map의 Spatial Resolution이 상대적으로 낮음.
모델이 대략 어느 영역을 중요하게 봤늕지는 확인할 수 있지만
Pixel-level의 세밀한 정보까지 표현하기는 어려움.
저자들은 Grad-CAM과 마찬가지로 Ablation-CAM 역시 Guided Backpropagation과 결합할 수 있다고 설명함.
Ablation-CAM
→ Class-discriminative한 위치 정보

+

Guided Backpropagation
→ Fine-grained Pixel Information

        ↓

High-resolution Localization Map
이를 통해 보다 세밀한 Visual Explanation을 생성할 수 있음.
(단, Ablation-CAM 자체가 Gradient-free라는 것과
Guided Backpropagation을 선택적으로 결합하는 것은 구분할 필요가 있음. )
본 논문의 주요 Contribution은 다음과 같음.
1. Gradient-free Ablation-CAM 제안
Gradient를 사용하지 않고 Feature Map Ablation을 이용해서 Importance를 계산하는
Class-discriminative Localization Method를 제안함.
그리고 논문에서는 이를 CNN-based Architecture에 적용할 수 있는 방법으로 제시함.
2. Grad-CAM의 한계 개선
Gradient Saturation과 같이 Grad-CAM의 Gradient 기반 Visualization에서 발생할 수 있는 문제를 지적하고,
Ablation Analysis를 이용해서 더 Reliable한 Visualization을 생성할 수 있음을 보임.
3. Grad-CAM과의 성능 비교
Subjective Evaluation과 Objective Evaluation을 통해 Ablation-CAM과 Grad-CAM을 비교함.
저자들은 Ablation-CAM이 전반적으로 당시 SOTA 방법인 Grad-CAM보다 좋은 성능을 보였다고 보고함.또한 Grad-CAM에서 수행한 실험을 반복하면서 Ablation-CAM 역시 Class-discriminative한 Explanation을 생성할 수 있음을 평가함.
4. Model Trust 및 Model Selection 활용
Ablation-CAM은 Heatmap 생성뿐만 아니라,
이 모델이 올바른 Image Region을 근거로 Prediction하고 있는지를 분석하는 데 활용할 수 있음.따라서 저자들은 Ablation-CAM을 이용해
- Model에 대한 Trust 평가
- Model의 판단 근거 분석
- Model Selection
등에도 활용할 수 있다고 주장함.
정리해 보자면...
Ablation-CAM의 출발점은 Grad-CAM의 Gradient 기반 Feature Importance에 대한 문제의식.
Grad-CAM은 Gradient를 이용해서 각 Feature Map의 중요도를 계산하지만,
Gradient Saturation 등으로 인해 실제 Feature Importance를 제대로 반영하지 못할 가능성이 있음.
이에 Ablation-CAM은 Gradient를 사용하지 않고,
Feature Map을 하나씩 제거했을 때 Target Class Score가 얼마나 감소하는지를 이용해 Feature Map의 중요도를 측정함.
Feature Map 하나 제거
        ↓
Target Class Score 측정
        ↓
Score가 크게 떨어졌나?
        ↓
YES
        ↓
해당 Feature Map은 중요
Ablation-CAM
: Feature Map이 중요한지 Gradient를 통해 추정하지 말고, 실제로 제거해본 뒤 Prediction이 얼마나 영향을 받는지를 확인하자.
✅2. Related Work
Ablation-CAM은 기존의 여러 Explainable AI 연구를 기반으로 제안됨.
본 논문에서는 관련 연구를 크게 다음과 같은 관점에서 살펴봄.
- CNN Visualization
- Model Trust Evaluation
- Saliency Method의 신뢰성 문제
- Ablation Study
- CAM / Grad-CAM
이러한 연구들의 흐름을 통해 기존 Visualization Method의 한계를 살펴보고,
왜 Feature Map의 중요도를 Gradient가 아닌 Ablation을 통해 측정하려 하는지 설명함.
Visualizing CNNs
i) Deconvolution
CNN을 해석하려는 초기 연구 중 하나로 Zeiler and Fergus의 연구가 있음.
이 연구에서는 Higher Layer의 특정 Neuron Activation을 Input Image 방향으로 다시 추적해서
어떤 Input Pixel들이 해당 Neuron을 활성화시키는 데 영향을 주었는지를 시각적으로 확인하고자 함.
이를 위해 Deconvolution 방식을 사용함.
Input Image
     ↓
CNN Forward
     ↓
Higher-layer Neuron Activation

     ↓ Deconvolution

Input Image 방향으로 추적
     ↓
Neuron Activation과 관련된
Image Region Visualization
CNN 내부의 특정 Neuron이 Input Image의 어떤 영역에 반응하는지를 확인하려는 초기 Visualization Method라고 볼 수 있음.
ii) Saliency Map
이후 Simonyan et al.은 Predicted Class Score에 대한 Input Pixel의 Partial Derivative를 이용해서 Class-specific Saliency Map을 생성함.
Target Class 의 Score를 , Input Image를 라고 하면,
를 계산하는 방식.
- : Target Class 에 대한 번째 Feature Map의 Importance Weight
- : Feature Map을 구성하는 전체 Cell의 개수
- : Target Class 의 Activation Score
- : 번째 Feature Map 의 Spatial Location 에서의 Activation
이 Input Pixel이 조금 변했을 때 Target Class Score가 얼마나 민감하게 변하는지를 측정하는 것.
Gradient의 크기가 큰 Pixel일수록 Target Class Prediction에 민감하게 영향을 미치는 Pixel이라고 판단함.
Input Pixel
     ↓
조금 변화시킴
     ↓
Target Class Score가 크게 변하는가?
     ↓
YES
     ↓
Important Pixel
이를 통해 Image의 각 Pixel이 Prediction에 얼마나 영향을 미치는지 나타내는 Saliency Map을 생성할 수 있음.
Guided Backpropagation
Springenberg et al.은 기존 Backpropagation을 수정해서 Guided Backpropagation을 제안함.
Guided Backpropagation은 Backpropagation 과정에서 전달되는 Gradient를 조절하여 기존 Saliency Map보다 더 선명하고 세밀한 Visualization을 생성함.
Target Class
     ↓
Modified Backpropagation
     ↓
Input Pixel Gradient
     ↓
High-resolution Visualization
하지만 논문에서는 Guided Backpropagation과 Deconvolution의 중요한 한계를 지적함.
두 방법은 High-resolution Visualization을 생성할 수 있지만 Class-discriminative하지 않음.
동일한 Input Image에 대해 서로 다른 Target Class를 선택하더라도
Visualization 결과가 거의 동일하게 나타날 수 있음.
예를 들어 하나의 이미지에 Dog와 Cat이 존재한다고 가정하면,
Target = dog

→ Dog + Cat의 Edge와 Texture가
  전반적으로 Visualization


Target = cat

→ Dog + Cat의 Edge와 Texture가
  거의 비슷하게 Visualization
될 수 있음.
따라서 Visualization이 선명하다고 해서 반드시
해당 Class를 판단한 근거를 제대로 설명한다.고 볼 수는 없음.
Integrated Gradients
Sundararajan et al.은 CNN의 Prediction을 Input Pixel에 Attribution하기 위한 방법으로 Integrated Gradients를 제안함.
Integrated Gradients는 하나의 지점에서 Gradient만 확인하는 대신,
Baseline에서 실제 Input까지 변화하는 경로에서 Gradient를 누적하여 Input Feature의 Contribution을 측정함.
기존 Gradient-based Saliency Method의 한계를 보완하면서 Prediction을 Input Pixel에 Attribution하려는 접근.
Instance Explanation과 Neuron Visualization
앞서 살펴본 방법은 주로 Individual Image Instance에 대한 Explanation을 제공함.
왜 이 Image를 Dog라고 Prediction했을까? 같이 특정 Input에 대한 Prediction을 설명하는 방식.
하지만 CNN을 해석하는 다른 방법도 있는데,
특정 Image에 대한 Prediction이 아니라,
이 Neuron은 일반적으로 어떤 Concept을 학습하고 있는지를 알아보는 것.
Gradient Ascent를 이용한 Neuron Visualization
Simonyan et al.은 특정 Neuron을 최대한 활성화시키도록 Gradient Ascent를 이용해서 Image를 합성함.
특정 Neuron 선택
      ↓
Neuron Activation이 커지도록 Image 수정
      ↓
Gradient Ascent 반복
      ↓
Neuron을 최대한 활성화시키는 Image 생성
이를 통해 특정 Neuron이 어떤 Visual Concept을 표현하고 있는지 분석할 수 있음.
Higher-layer Activation Map의 의미
Zhou et al.은 Higher Convolutional Layer의 Activation Map들이 특정 Object나 Concept에 반응하ㅁ면서
일종의 Object Detector처럼 동작할 수 있음을 보여줌.
CNN의 Higher Layer로 갈수록
일반적인 Edge나 Texture 뿐만 아니라, Semantic한 Concept을 표현할 수 있다는 것.
Lower Layer
→ Edge / Texture

        ↓

Higher Layer
→ Object / Semantic Concept
=> CNN 내부의 Feature Map 자체가 의미 있는 Visual Information을 포함하고 있음을 보여줌.
Trust Evaluation
Explainability가 필요한 이유 중 하나는 Model에 대한 Trust를 평가하기 위함임.
Lipton et al.은 Deep Learning Model이 실제 환경에서 활용되기 위해서는
높은 Accuracy도 중ㅇ요하지만 Interpretability와 Trustworthiness가 필요함을 강조함.
또한 Ribeiro et al.은 Human Study를 수행해서
Explanation이 제공되었을 때 사용자가 Classifier를 신뢰할 수 있는지를 평가함.
Visual Explanation의 목적은 단순히 보기 좋은 Heatmap을 만드는 것보다는 이 모델의 판단을 진짜 신뢰해도 되는지를 사람이 판단한ㄹ수 있도록 돕는 것임.
그래서 Visualization은 Model의 Prediction뿐만 아니라 Model의 판단 근거를 검증하는 수단으로 활용될 수 있음.
Unreliability of Saliency Methods
기존 Gradient-based Saliency Method가 항상 신뢰할 수 있는 Explanation을 제공하는 것은 아니라는 연구들도 등장함.
Adebayo et al.과 Kindermans et al.은 Gradient-based Method의 신뢰성에 문제를 제기함.
본 논문에서는 그 주요 원인 중 하나로 Gradient Saturation을 언급함.
CNN의 Output은 여러 Layer와 Non-linear Function을 거쳐 생성됨.
이 과정에서 Backpropagation되는 Gradient가 매우 작아질 수 있음.
실제로 중요한 Feature
        ↓
여러 Non-linear Layer
        ↓
Gradient Backpropagation
        ↓
Gradient가 매우 작아짐
        ↓
낮은 Importance로
평가될 가능성
Gradient가 작다고 해서 해당 Feature가 실제 Prediction에 중요하지 않다고 단정할 수 없음.
그리고 이런 문제는 Gradient를 Feature Importance로 사용하는 Grad-CAM과 직접적으로 연결됨.
Ablation Studies
Ablation-CAM의 핵심 아이디어와 직접적으로 연결되는 또 다른 연구 흐름이 Ablation Analysis임.
Ablation은 특정 요소를 제거한 뒤 Model의 Output이나 Performance가 얼마나 변화하는지를 확인하여 해당 요소의 중요성을 평가하는 방식임.
Neuron Ablation
Morcos et al.은 개별 Neuron을 Ablation하여 Network Output이 특정 Neuron에 얼마나 의존하는지를 분석함.
이 연구에서 중요한 결과 중 하나는
Class Selectivity가 Neuron Importance를 잘 예측하지 못한다는 것.
어떤 Neuron이 특정 Class에 매우 강하게 반응한다고 해서 해당 Neuron이 Network 전체 Performance에 반드시 중요한 것은 아님.
따라서
특정 Class에 강하게 반응한다는 것과
실제로 Model Prediction에 중요한 역할을 한다는 건 서로 다른 개념이라는 것.
Class-specific Ablation
Zhou et al.은 이러한 연구를 확장해서
Highly Selective Unit의 Ablation이 Model Performance에 어떤 영향을 주는지 분석함.
흥미롭게도 Highly Selective Unit을 제거하더라도 Overall Accuracy에는 거의 영향을 미치지 않을 수 있음.
하지만 특정 Class만 살펴보면 해당 Class의 Accuracy가 크게 감소할 수 있다는 것.
=> 특정 Unit은 Network 전체 Performance보다
특정 Class Prediction에 중요한 역할을 할 수 있음.
=> Ablation-CAM의 key point와 연결됨
특정 Feature Map을 제거한 뒤 Target Class Score가 얼마나 변하는지를 확인하면
해당 Feature Map이 Target Class에 얼마나 중요한지 알 수 있지 않을까?
CAM
Ablation-CAM은 특히 두 가지 Visualization Method인 CAM과 Grad-CAM으로부터 많은 영향을 받음.
먼저 Class Activation Mapping(CAM)은 CNN의 Final Convolutional Layer에 존재하는 Feature Map들을 이용하여 Class-discriminative Localization Map을 생성함.
CAM의 기본적인 형태는 다음과 같음.
- : Final Convolutional Layer의 번째 Feature Map
- : Target Class 에 대한 번째 Feature Map의 Weight
Feature Maps

A¹   A²   A³   ...   Aᴷ
↓    ↓    ↓          ↓
w₁   w₂   w₃   ...   wₖ

        ↓

Weighted Sum

        ↓

CAM
CAM에서는 이 Weight를 Target Class의 Trained Linear Classifier Weight에서 가져옴.
근데
CAM은 Class-discriminative Visualization을 생성할 수 있지만 Architecture에 제약이 존재함.
- Final Convolutional Layer 이후에 Global Average Pooling(GAP)을 사용하는 CNN Architecture를 대상으로 함.
=> Fully Connected Layer를 사용하는 다른 CNN Architecture나 Image Captioning, Visual Question Answering과 같은 Task에는 그대로 적용하기 어려움.
그리고 이런 Architecture Constraint를 해결하기 위해 등장한 방법이 Grad-CAM.
Grad-CAM
Grad-CAM은 CAM을 일반화해서 특정 Architecture에 제한되지 않고 다양한 CNN을 설명할 수 있도록 제안됨.
CAM에서는 학습된 Linear Classifier Weight를 사용했지만,
Grad-CAM에서는 Gradient를 이용해ㅓ서 Feature Map의 Weight를 계산함.
Target Class 에 대한 번째 Feature Map의 Importance Weight는 다음과 같이 계산됨.
먼저 는
Feature Map 의 위치 가 변할 때 Target Class Score 가 얼마나 변하는가를 나타냄.
- : Feature Map에 존재하는 전체 Cell의 개수
- : Target Class 의 Activation Score
- : 번째 Feature Map의 Spatial Location 에서의 Activation
- : Target Class 에 대한 Feature Map 의 Importance
Grad-CAM에서는 Feature Map의 모든 Spatial Location에 대해 합한 뒤 평균을 계산하고
Gradient를 Feature Map의 Importance를 나타내는 값으로 사용함.
하지맞ㄴ Grad-CAM 도 몇 가지 한계를 가짐.
1. Gradient Saturation
첫 번째 문제는 Gradient Saturation.
특히 Model이 특정 Prediction에 대해 높은 Confidence를 가지고 있는 경우에도 Gradient가 작게 나타날 수 있음.
[Model Prediction]
dog = Very High Confidence

        ↓

Gradient Saturation

        ↓

Gradient가 작아짐

        ↓

Feature Importance가
제대로 반영되지 않을 가능성
그렇기에 Grad-CAM이 Highly Confident Decision에 대해 Faithful한 Explanation을 제공하지 못하는 경우가 있다고 논문에서 말함.
2. Object의 일부 영역만 Highlight
Grad-CAM이 Image에 존재하는 Object 전체가 아니라 상대적으로 작은 일부 영역만 Highlight하는 경우가 있음.
때문에 사용자가 Model의 판단 근거를 확인하고 Model을 신뢰하는 데 충분하지 않을 수 있음.
3. 동일한 Object의 Multiple Occurrence 문제
저자들은 Grad-CAM이 동일한 Class의 Object가 Image에 여러 개 존재하는 경우 일부 Instance를 놓칠 수 있다고 지적함.
같은 Class의 Object가 여러 개 존재하더라도,
일부 Object만 Highlight될 수 있다는 것.
그래서 Ablation-CAM은
CAM의 기본적인 구조는 유지하면서 Feature Map의 Weight를 계산하는 방식을 변경한 방법이라고 볼 수 있음.
CAM 계열의 최종 Visualization은 기본적으로 Feature Map의 Weighted Combination으로 만들어짐.
그래서 중요한 건각 Feature Map의 Importance Weight를 어떻게 계산할 것인가?임.
이를 방법별로 비교하면 하단과 같고,
| Method | Feature Map Weight |
|---|---|
| CAM | Trained Linear Classifier Weight |
| Grad-CAM | Gradient |
| Ablation-CAM | Feature Map Ablation에 따른 Target Class Score 변화 |
Ablation-CAM에서는 Grad-CAM처럼 Gradient를 통해 Feature Map의 Importance를 추정하는 대신,
Feature Map을 실제로 제거했을 때 Target Class Score가 얼마나 감소하는지를 이용해서 Feature Map의 Importance를 직접 평가하고자 함.
✅3. Motivation
기존 시각화 기법들은 대부분 출력 클래스 노드(Output Class Node)에서 역전파되는 Gradient에 의존함.
그러나 출력 클래스 노드는 입력 이미지와 이전 Convolutional Layer들을 거쳐 만들어지는 복잡한 비선형 함수이기 때문에,
Gradient를 기반으로 한 방법에는 몇 가지 문제가 발생할 수 있음.
i) Gradient Saturation 문제
Gradient 기반 방법은 Gradient Saturation 문제의 영향을 받을 수 있음.
= 역전파되는 Gradient의 크기가 매우 작아지는 현상.
이 경우 시각화 기법이 이미지에서 실제로 중요한 영역을 제대로 찾아내지 못할 수 있음.
(Gradient Saturation에 대해서는 논문의 Section 5에서 보다 자세하게 다룰 예정)
ii) Grad-CAM의 Feature Map 중요도 계산 문제
Grad-CAM은 특정 Decision Node에 대해 각 Feature Map이 얼마나 중요한지를 계산하기 위해,
Feature Map의 개별 Cell에 대한 Gradient를 사용함.
Feature Map 가 있을 때 Grad-CAM은 각 위치의 Gradient를 계산하고,
이를 Global Average Pooling해서 해당 Feature Map의 Weight를 구함.
Feature Map k
      ↓
각 Cell에 대한 Gradient 계산
      ↓
Gradient들을 하나의 값으로 Aggregation
      ↓
Feature Map k의 중요도 α_k^c
위와 같은 방식.
하지만 이런 방식에서는
공간적으로 작은 영역에만 활성화되는 Feature Map의 영향이
최종 Saliency Map에서 희석될 수 있음.
Chattopadhyay et al.의 Grad-CAM++에서는 이런 문제를 해결하기 위해
개별 Cell의 Gradient를 단순 평균하는 대신,
각각에 Weight를 적용해 Gradient를 결합함.
그러나 논문에서는 여기에도 근본적인 문제가 있다고 지적하고 있음.
각 Cell의 Gradient는 해당 개별 Cell이 특정 Decision에 얼마나 기여하는지를 나타내는 값.
따라서 이러한 Cell 단위의 Gradient들을 Aggregation하여 Feature Map 전체의 중요도를 결정하는 것은 적절하지 않을 수 있다는 것.
그래서 Cell의 중요도를 나타내는 Gradient를 모아서 Feature Map 전체의 중요도라고 판단해도 되는가에 대한 의문을 제기하게 됨.
Gradient의 Spatial Information 문제
또한 저자들은 역전파된 Gradient가 Feature Map이 가지고 있던 Spatial Information을 유지하지 못하는 현상을 발견했음.
논문의 Fig. 2에서는 VGG의 마지막 Convolutional Layer에 존재하는 437번째 Feature Map을 예시로 보여주고 있음.
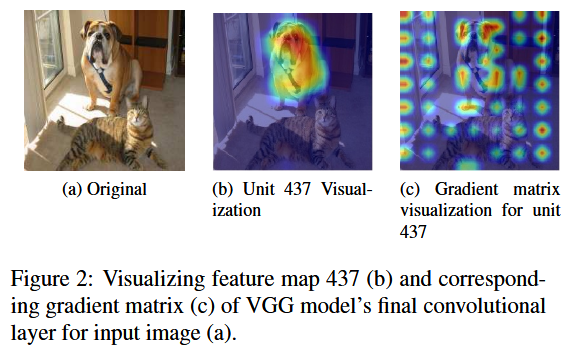
해당 Feature Map은 이미지에서 개의 몸통 부분(Body Portion)에 강하게 Activation됨.
하지만 이 Feature Map에 대해 Gradient를 역전파해 확인했을 때,
저자들은 Activation이 발생한 공간적 위치와 Backpropagated Gradient 사이에 Spatial Correlation이 존재하지 않는 현상을 발견함.
= Feature Map에서는 분명 개의 몸통 부분에 반응하고 있지만,
역전파된 Gradient는 이러한 공간적 정보를 제대로 반영하지 못한다는 것.
이런 현상을 Fully Connected Layer가 존재하는 Network에서 발견했고,
Inception이나 ResNet과 같이 Fully Connected Layer가 없는 Network에서는 이러한 현상이 나타나지 않았다고 설명함.
(또한 저자들은 아는 한, 이러한 현상을 보고한 것은 본 연구가 최초라고 언급하고 있음. )
그러면 Activation이 아닌 Gradient를 보는 게 적절한가?
CNN은 최종적인 Prediction을 만들기 위해 Network 내부에서 전달되는 Activation에 의존하고 있음.
실제 CNN의 Decision 과정은 다음과 같이 이루어지는데,
Input Image
    ↓
Convolution
    ↓
Activation
    ↓
Convolution
    ↓
Activation
    ↓
...
    ↓
Prediction
기존의 Visualization Technique들은 모델의 Decision을 이해하기 위해
Gradient (= 학습된 함수의 기울기(Slope))를 분석한다는 것.
근데 이런 접근이 직관적이지 않다고 보았음.
CNN은 Activation을 이용해서 Decision을 내리는데,
왜 CNN의 Decision을 설명하기 위해 Gradient를 사용해야 하는 것인가
그래서 Gradient를 통해 Feature Map의 중요도를 간접적으로 추정하는 대신,
실제 Activation이 Prediction에 얼마나 영향을 미치는지를 직접 측정하는 방법을 생각해봄.
Ablation을 이용한 Feature 중요도 측정
Morcos et al.은 학습된 Network에서 개별 Neuron의 중요성을 분석하기 위해 Ablation Analysis를 수행했음.
여기서 Ablation이란 특정 Unit의 Activation 값을 0으로 설정해서 해당 Unit을 제거한 것과 같은 상태를 만드는 것을 의미함.
Morcos et al.의 연구에 따르면,
일반화 성능이 좋은 Network는 특정 하나의 Neuron에 크게 의존하지 않음.
따라서 개별 Unit을 Ablation하더라도 전체 Network Performance에는 큰 영향을 미치지 않는 경우가 많았음.
그러나 해당 연구에서는 개별 Unit의 Ablation이 특정 Class의 성능에 어떠한 영향을 미치는지는 고려하지 않았음.
반면 Zhou et al.은 특정 Feature Map Unit 하나를 제거하는 것만으로도 특정 Class의 Accuracy가 크게 감소할 수 있음을 보였음.
= 전체 Network의 성능에서는 특정 Feature Map의 제거가 큰 영향을 주지 않는 것처럼 보이더라도,
특정 Class에 대해서는 해당 Feature Map이 매우 중요할 수 있다는 것.
[전체 Network 관점]

Feature Map 제거
      ↓
전체 Accuracy 변화가 작을 수 있음


[특정 Class 관점]

Feature Map 제거
      ↓
특정 Class의 Score가 크게 감소할 수 있음
Ablation Drop을 Feature Map의 Weight로 사용
Fig. 1에서는 특정 Unit들을 Ablation했을 때
Output Class Node의 Activation Score가 어떻게 변화하는지를 보여주고 있음.
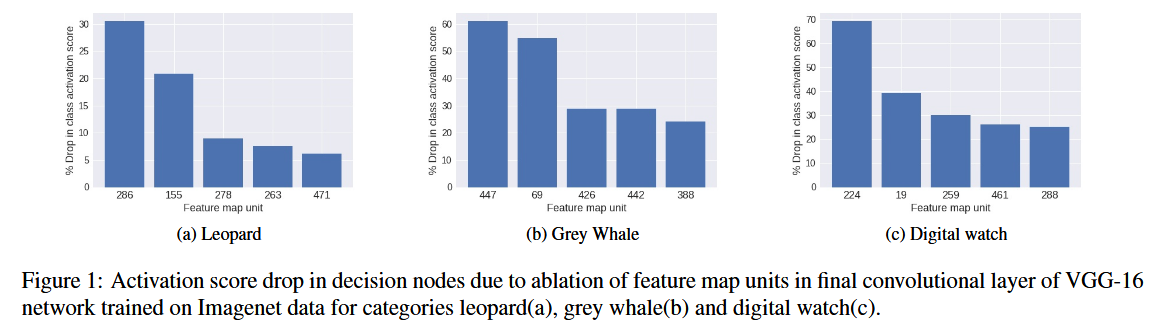
논문에서는 특정 Feature Map을 Ablation했을 때 발생하는 Class Score의 감소량(Ablation Drop)을
해당 Feature Map이 특정 Class에 얼마나 중요한지를 나타내는 지표로 보았음ㅁ.
Target Class의 Score가 크게 감소한다면,
해당 Feature Map은 그 Class를 판단하는 데 중요한 역할을 하고 있다고 볼 수 있는 것.
반대로 Feature Map을 제거했음에도 Class Score가 거의 변하지 않는다면,
해당 Feature Map은 해당 Class의 Prediction에 상대적으로 중요하지 않다고 볼 수 있는 거고.
그렇기에 Ablation-CAM에서는 기존 Grad-CAM에서 사용하던 Global Average Pooled Gradient를 Feature Map의 Weight로 사용하는 대신,
Feature Map을 직접 Ablation했을 때 발생하는 Class Score의 감소량을 Weight로 사용할 수 있다고 제안히고 있음.
[Grad-CAM]

Feature Map
    ↓
Gradient 계산
    ↓
Global Average Pooling
    ↓
Feature Map Weight


[Ablation-CAM]

Feature Map
    ↓
해당 Feature Map Ablation
    ↓
Network의 Output 변화 측정
    ↓
Target Class Score의 감소량
    ↓
Feature Map Weight
정리해 보자면,
Ablation-CAM은 기존 CAM 기반 시각화 방법에서 Gradient를 이용해 Feature Map의 중요도를 결정하는 방식에 문제를 제기함.- Gradient 기반 방법은 Gradient Saturation의 영향을 받을 수 있고,
개별 Cell의 Gradient를 Aggregation해서 Feature Map 전체의 중요도를 결정하는 것이 적절하지 않을 수 있다는 것.
또한 저자들은 일부 Network에서 Backpropagated Gradient가 Feature Map의 Spatial Information과 충분한 상관관계를 보이지 않는 현상을 관찰하기도 함.
★ 이에 Ablation-CAM은 다음과 같은 관점에서 접근함.
특정 Feature Map이 정말 Target Class의 Prediction에 중요하다면,
해당 Feature Map을 제거했을 때 Target Class Score가 크게 감소해야 함.따라서 Feature Map의 중요도를 Gradient를 통해 간접적으로 계산하는 대신,
Feature Map을 직접 Ablation하고 그에 따른 Target Class Score의 감소량을 측정하여 Feature Map의 Weight를 결정하는 것이 Ablation-CAM의 Core Motivation!
✅4. Approach
이미지 분류(Image Classification)를 위해 학습된 CNN을 이용해서 입력 이미지 의 Localization Map을 생성하는 상황을 생각해볼 수 있음.
먼저 이미지 를 모델에 Forward Pass해서
특정 Class 에 대한 Class Activation Score 를 얻음.
마지막 Convolutional Layer의 번째 Feature Map을 라고 할 때,
가 에 대한 비선형 함수라고 가정할 수 있음.
Feature Map 의 Activation이 정상적으로 존재하는 상태에서 얻은 함수의 출력값이 .
Input Image I
      ↓
     CNN
      ↓
Final Convolutional Layer
      ↓
A¹, A², ..., Aᵏ, ...
      ↓
Class c Activation Score = yᶜ
이제 가 Class 의 판단에 얼마나 중요한지를 알아보기 위해 Feature Map 의 모든 Activation Cell 값을 0으로 설정함.
번째 Feature Map을 Ablation한 뒤 동일한 이미지 에 대해 다시 Forward Pass를 수행함.
[기존]

A¹, A², ..., Aᵏ, ...
              ↓
             CNN
              ↓
             yᶜ

[Ablation]

A¹, A², ...,  0, ...
              ↓
             CNN
              ↓
yᶜ_k번째 Unit을 Ablation하면 Class 의 Activation Score는 감소할 수 있으며, 이때 얻은 Score를 라고 정의함.
따라서
- : Feature Map 가 존재할 때의 Class Activation Score
- : Feature Map 가 제거되었을 때의 Class Activation Score
가 됨.
이때 는 Feature Map 가 존재하지 않는 상태의 함수값이므로, 에 대한 Baseline 역할을 함.
Ablation을 이용한 Effective Slope
Feature Map 를 제거했을 때 발생하는 변화를 이용하면 다음과 같이 Slope를 정의할 수 있음.
여기서
- : Feature Map 를 제거했을 때 발생한 Class Activation Score의 감소량
- : Feature Map 의 Norm
을 의미함.
= 가 존재하는 상태와 존재하지 않는 상태 사이의 출력 변화를 이용해서
해당 Feature Map이 Class 에 미치는 영향을 측정하는 방식.
저자들은 이렇게 계산한 Effective Slope가
Grad-CAM에서 Gradient를 통해 얻는 Instantaneous Slope보다 Feature Map의 중요도를 나타내기에 더 적절하다고 주장함.
Grad-CAM에서는 특정 지점에서의 Gradient를 이용하기 때문에
Gradient Saturation이나 Gradient Explosion의 영향을 받을 수 있음.
Gradient Saturation이 발생하면
실제로 중요한 Filter임에도 Gradient가 매우 작아져 중요하지 않은 것처럼 판단될 수 있음.
반대로 Gradient Explosion이 발생하면
실제로는 가치가 크지 않은 Filter임에도 매우 높은 중요도를 가지는 것처럼 판단될 수 있음.
Ablation-CAM은 Gradient 대신 Feature Map을 실제로 제거했을 때 발생하는 출력의 변화를 사용하므로, 저자들은 이러한 Saturation 및 Explosion 문제의 영향을 받지 않는다고 설명함.
Feature Map의 Importance 계산
실제 Ablation-CAM에서는 Equation (2)의 Slope를 그대로 사용하지 않고 약간 변형된 값을 사용함.
그 이유는 Feature Map의 Norm인
가 분자인 에 비해 매우 큰 값을 가지기 때문임.
따라서 Equation (2)를 그대로 사용할 경우 Slope가 지나치게 작은 값을 가지게 됨.
이에 저자들은 Feature Map 가 Class 에 얼마나 중요한지를 다음과 같이 정의함.
그리고 이 값은 매우 직관적으로 해석할 수 있음.
Feature Map 를 제거했을 때 Class 의 Activation Score가 원래 Score에 비해 얼마나 감소했는지를 나타내는 비율.
ex.원래 Class Score가
이고 를 제거한 후
이 되었다면,
이 됨.
=> 해당 Feature Map을 제거했을 때 Class Activation Score가 기존 값의 30%만큼 감소했으므로, 이 감소 비율을 의 중요도로 사용하는 것.
Feature Map Aᵏ 존재
        ↓
     yᶜ = 10

Feature Map Aᵏ 제거
        ↓
     yᶜ_k = 7

        ↓

Score Drop = 3

        ↓

Importance

wᶜ_k = 3 / 10 = 0.3
Ablation-CAM 생성
각 Feature Map의 Importance 를 구했다면,
Grad-CAM과 유사하게 Activation Map과 해당 Weight를 선형 결합해서
최종 Localization Map을 생성함.
A¹ × w¹ᶜ
A² × w²ᶜ
A³ × w³ᶜ
...
Aᵏ × wᵏᶜ

      ↓

모두 더함

      ↓

ReLU

      ↓

Ablation-CAM
의 과정으로 최종 Heatmap을 생성함.
여기서 ReLU를 사용하는 이유는 Positive Drop을 가지는 Unit만 유지하기 위해서임.
특정 Feature Map을 제거했을 때 Class Score가 감소했다면
이므로
가 됨.
이는 해당 Feature Map이 Class 의 Prediction에 긍정적으로 기여하고 있었다는 것을 의미함.
반대로 Feature Map을 제거했는데 오히려 Class Score가 증가한다면 해당 Weight는 음수가 될 수 있교,
최종 ReLU를 통해 이러한 음의 영향은 제거함.
Grad-CAM과 마찬가지로 최종적으로 생성된
을 원본 이미지 크기로 Resize해서 이미지에서 Class 의 판단에 중요한 영역을 Localization함.
저자들이 아는 한, 이런 방식으로 Feature Map을 직접 Ablation해서 CAM의 Weight를 계산한 것은 본 연구가 최초라고 설명함.
Class Activation Score를 사용하는 이유는?
Ablation-CAM에서는 한 가지 중요한 선택을 함.
Feature Map을 Ablation하기 전 후의 변화를 측정할 때,
Softmax Layer가 반환하는 Confidence Score의 감소량을 사용하지 않음.
대신 정규화되지 않은 Class Activation Score(Unnormalized Class Activation Score)의 감소량을 사용함.
사용함
→ Softmax 이전의 Class Activation Score

사용하지 않음
→ Softmax 이후의 Confidence Score
왜냐하면
Softmax Confidence가 다른 Class의 Activation Score에도 영향을 받기 때문.
ex. Class 자체의 Activation Score가 변하지 않더라도
다른 Class의 Activation Score가 증가하면
Softmax를 통과한 Class 의 Confidence는 감소할 수 있다는 것.
Class c의 Activation Score
→ 그대로임

다른 Class의 Activation Score
→ 증가함

        ↓
     Softmax
        ↓

Class c의 Confidence
→ 감소할 수 있음
따라서 Confidence의 감소만 관찰하면 실제로 Class 자체의 Score가 감소한 건지,
아니면 다른 Class의 Score가 증가했기 때문에 상대적으로 Confidence가 감소한 것인지 구분하기 어려움.
★반면 Unnormalized Class Activation Score의 감소를 사용하면 관심 대상인 Class 자체의 변화에만 집중할 수 있음.
(저자들은 실제로 Confidence Score의 감소를 이용한 방법도 실험했지만, 이 경우 생성된 Visualization의 신뢰도가 더 낮았다고 설명함.)
Integrated Gradients와의 비교
Ablation-CAM의 접근 방식은
Gradient Saturation 문제를 해결하고자 한다는 점에서 Integrated Gradients와 비슷함.
Integrated Gradients도 Gradient Saturation 문제를 해결하기 위해 Baseline을 설정하고,
Baseline에서 실제 입력까지 변화하는 과정의 Gradient를 누적함.
하지만 두 방법에서 사용하는 Baseline에는 중요한 차이가 있겠지.
Integrated Gradients: 일반적으로 모든 입력, Class 및 Filter에 대해 Black Image와 같은 공통 Baseline을 사용함.Ablation-CAM: 해당 Feature Map의 Activation을 직접 0으로 만드는 것을 Baseline으로 사용함.
[Integrated Gradients]

Black Image
    ↓
공통 Baseline
    ↓
실제 Input까지 변화


[Ablation-CAM]

특정 Feature Map Aᵏ
    ↓
Aᵏ = 0
    ↓
해당 Filter를 제거한 상태가 Baseline
=> Ablation-CAM의 Baseline
: 이미지와 Filter에 따라 달라지는 Natural Baseline이라고 설명함.
또한 Integrated Gradients와 Ablation-CAM에는 Visualization이 이루어지는 공간에서도 차이가 있음.
Integrated Gradients: Pixel-space Visualization TechniqueAblation-CAM: Feature Map을 기반으로 Visualization을 생성함.
저자들은 이런 특성으로 인해
Ablation-CAM이 Noise-free하고 Class-discriminative한 Visualization을 생성할 수 있다고 설명함.
Guided Ablation-CAM
Ablation-CAM으로 생성된 Heatmap은 Class Prediction과 관련된 이미지 영역을 강조할 수 있지만,
Guided Backpropagation처럼 세밀한 Fine-grained Detail까지 표현하지는 못함.
이를 보완하기 위해 저자들은 Guided Ablation-CAM을 제시함.
= Guided Grad-CAM과 동일한 방식
Ablation-CAM과Guided Backpropagation Visualization을 Pointwise Multiplication하여 생성함.
Ablation-CAM
(Class 관련 위치 정보)

        ×

Guided Backpropagation
(Fine-grained Detail)

        ↓

★ Guided Ablation-CAM
이렇게 두 Visualization을 결합하며
Ablation-CAM이 제공하는 Class-discriminative Localization 정보와 Guided Backpropagation이 제공하는 세밀한 이미지 Detail을 함께 표현할 수 있음.
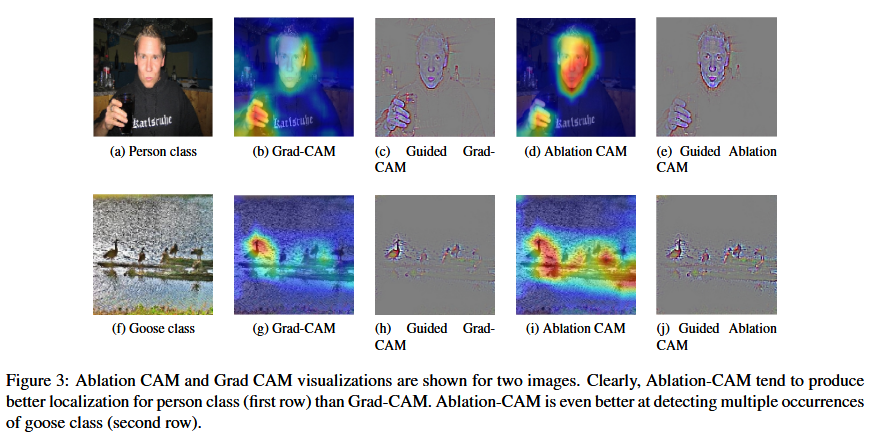
논문의 Figure 3(d)(i)와 Figure 3(e)(j)에서는 각각 Ablation-CAM과 Guided Ablation-CAM으로 생성한 Visualization 결과를 보여줌.
정리해 보자면,
★Ablation-CAM은 Gradient를 이용해서 Feature Map의 중요도를 간접적으로 계산하는 대신,
Feature Map을 실제로 제거한 뒤 Target Class Score가 얼마나 감소하는지를 직접 측정하는 것.
Feature Map 의 중요도는 다음과 같이 정의함.
Feature Map 를 제거했을 때 Target Class의 Activation Score가 얼마나 감소했나?를 해당 Feature Map의 중요도로 사용하는 방식.
그리고 각 Feature Map에 이 Weight를 적용해서
로 최종 Ablation-CAM을 생성함.
전체적인 흐름은 다음과 같이 정리할 수 있음.
Input Image
    ↓
Forward Pass
    ↓
Original Class Activation Score yᶜ
    ↓
Final Conv Layer의 Feature Map 추출
    ↓
Feature Map Aᵏ 하나를 0으로 설정
    ↓
다시 Forward Pass
    ↓
Ablated Class Activation Score yᶜ_k
    ↓
Score Drop 계산

wᶜ_k = (yᶜ - yᶜ_k) / yᶜ

    ↓
모든 Feature Map에 대해 반복
    ↓
Σ wᶜ_k Aᵏ
    ↓
ReLU
    ↓
Resize
    ↓
Ablation-CAM
결국 Grad-CAM과 Ablation-CAM의 가장 큰 차이는 Feature Map의 Weight를 어떻게 계산하는가에 있다는 것.
[Grad-CAM]
→ Gradient를 이용해 Feature Map의 중요도를 추정함

[Ablation-CAM]
→ Feature Map을 직접 제거하고
   Target Class Score의 감소량으로 중요도를 측정함
✅5. Case for Ablation-CAM
Grad-CAMVisualization 은 종종 관심 영역(Region of Interest)의 일부만 강조하는 경우가 있음.
=> 사람이 Visualization을 확인했을 때 모델의 판단을 충분히 신뢰하기 어려울 수 있음.
그리고 저자들은 Ablation-CAM이 이런 Grad-CAM의 한계를 어느 정도 극복할 수 있다고 주장함.
Grad-CAM보다 완전한 영역을 Localization
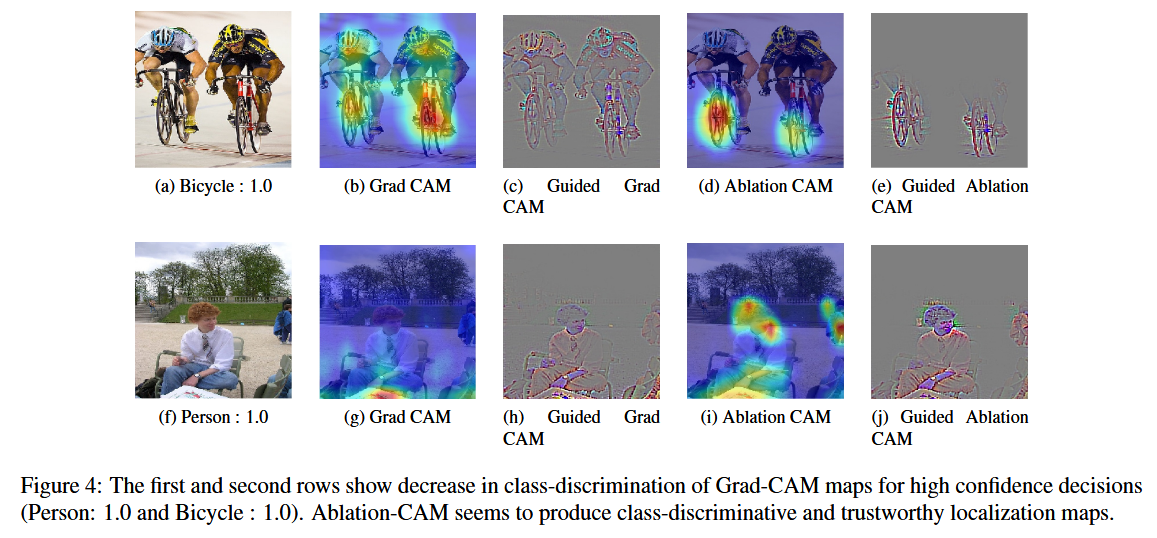
Figure 3(b)와 Figure 3(d)는 각각 Person Class에 대해 Grad-CAM과 Ablation-CAM으로 생성한 Localization Map을 보여줌.
논문에 따르면 Grad-CAM은 Person에 해당하는 영역 중 일부만 강조하는 반면,
Ablation-CAM은 Person에 해당하는 영역을 보다 완전하게 강조함.
Input Image
     ↓
Target Class = Person

Grad-CAM
     ↓
Person 영역의 일부만 강조

Ablation-CAM
     ↓
Person 영역을 보다 완전하게 강조
따라서 저자들은 Ablation-CAM이 Grad-CAM보다 더 완전하고 신뢰할 수 있는 Explanation을 제공하며, 모델에 대한 Trust Evaluation에 더 적합한 도구가 될 수 있다고 설명함.
동일한 Class의 여러 Object를 찾는 문제
저자들이 지적하는 Grad-CAM의 또 다른 한계
: 하나의 이미지에 동일한 Object가 여러 번 등장하는 경우, 모든 Object를 제대로 강조하지 못할 수 있다는 점.
그리고 위 Figure 3에서는 이미지에 동일한 Goose Class 객체가 여러 개 존재하는 사례를 보여주는데,
Figure 3(g)의 Grad-CAM과 Figure 3(i)의 Ablation-CAM을 비교했을 때,
Ablation-CAM이 이미지에 존재하는 여러 Goose Instance를 더 잘 찾아내고 있음.
Backpropagated Gradient의 높은 Variance
저자들은 이런 차이가 발생하는 원인 중 하나로 Backpropagated Gradient의 높은 Variance를 지적함.
Backpropagated Gradient는 Class Node가 학습한 비선형 함수의 Slope에 의존함.
그렇기 때문에 Gradient 값이 위치에 따라 크게 달라질 수 있고,
그 결과 이미지의 일부 Pixel이 지나치게 강조될 수 있음.
Backpropagated Gradient
        ↓
일부 Pixel에 매우 큰 값 발생
        ↓
해당 Pixel이 지나치게 강조됨
        ↓
나머지 Pixel의 중요성이 상대적으로 억제됨
        ↓
불완전한 Heatmap
=> 일부 Pixel이 과도하게 강조되면서
Heatmap의 나머지 영역이 상대적으로 Suppress될 수 있다는 것임.
반면 Ablation-CAM은 Gradient를 사용하지 않는 Gradient-free Method!!!
그렇ㄱ이에 Pixel에 보다 균일한 강조가 이루어지는 것이고,
결과적으로 더 나은 Visualization을 생성할 수 있다고 설명함.
Grad-CAM이 실패하는 상황에서의 Ablation-CAM
이후 저자들은 Grad-CAM이 실패하지만 Ablation-CAM은 안정적으로 동작하는 상황을 실험적으로 보여주면서 Ablation-CAM의 필요성을 설명함.
실험에서는 ImageNet으로 Pretrained된 VGG-16 Network를 사용하고,
이를 Pascal VOC 2007 Dataset에 Fine-tuning함.
Pascal VOC 2007을 이용한 해당 실험은 Multi-label Classification Problem으로 설정되어 있기에,
모델의 마지막 Layer에는 Sigmoid Activation Function을 사용함.
또한 Visualization의 Class-discrimination 능력을 평가하기 위해,
서로 다른 두 Class의 Instance가 최소 하나씩 포함되어 있는 이미지만 선택함.
= 하나의 이미지 안에 여러 Class가 존재할 때 Visualization이 각각의 Class를 제대로 구분해서 설명할 수 있는지를 확인하려는 것.
Sigmoid Saturation과 Grad-CAM의 문제
특정 입력에 대해 모델이 어떤 Class를 매우 높은 Confidence로 예측하는 상황을 생각할 수 있음.
Sigmoid Function은 하단과 같은 형태를 가짐.
모델이 특정 Class에 대해 매우 높은 Confidence를 가지면,
해당 Class Node는 Sigmoid Curve에서 출력이 1에 가까운 영역에 위치하게 됨.
[Sigmoid]

Output
1.0 |                         ________
    |                     ___/
    |                  __/
    |               __/
0.5 |-------------/
    |          __/
    |       __/
0.0 |______/
    +------------------------------ Input

                                ↑
                         Saturation Region
                         Gradient ≈ 0
이 영역에서는 Sigmoid의 Slope가 거의 0에 가까워지는 Saturation이 발생함.
=> 이 됨.
Grad-CAM은 Visualization을 생성하기 위해
Output에서 Feature Map 방향으로 Backpropagation되는 Gradient를 사용함.
따라서 Class Node가 Saturation 영역에 위치하면 Backpropagating Gradient가 매우 작아지게 됨.
특정 Class에 대한 높은 Confidence
↓
Sigmoid 출력 ≈ 1
↓
Sigmoid Saturation
↓
Gradient ≈ 0
↓
Backpropagating Gradient 감소
↓
Grad-CAM의 Class-discrimination 능력 감소
↓
관련 영역 Localization 실패
Gradient가 Vanish하게 되면
Grad-CAM으로 생성한 Localization Map이 Class-discrimination 특성을 잃고,
해당 Class와 관련된 영역을 제대로 Localization하지 못할 수 있음.
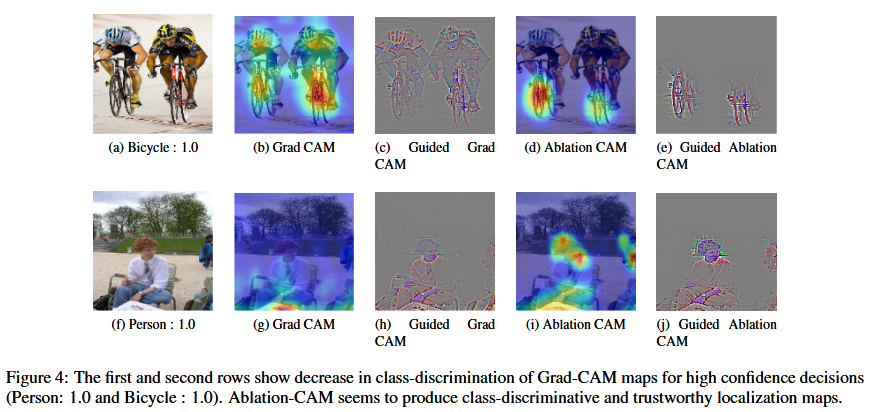
Figure 4(b), (c), (g), (h)의 Grad-CAM Visualization에서 이러한 현상을 확인할 수 있음.
Grad-CAM은 보통 Sigmoid 이전 값을 사용하는데?
여기서 한 가지 고려해야 할 부분이 있음.
일반적으로 Grad-CAM Visualization은 Sigmoid나 Softmax를 적용한 이후의 Normalized Score가 아니라,
Sigmoid 또는 Softmax 적용 이전의 Unnormalized Node를 기준으로 생성한다는 것.
그렇게 되면 앞에서 설명한 Sigmoid Saturation 문제가 Grad-CAM에 직접 적용되지 않는 것처럼 보일 수 있음.
하지만 저자들은 Sigmoid 이전의 Unnormalized Node 역시 이전 Layer들의 복잡한 비선형 함수(Complex Nonlinear Function)라는 점을 지적함.
따라서 Sigmoid 이전의 Node를 사용한다고 하더라도
이전 Layer에서 발생하는 Gradient Saturation으로부터 완전히 자유롭지 않다고 설명함.
왜 실험에서는 Normalized Node를 사용했을까
그렇다면 저자들은 왜 실험에서 Sigmoid를 적용한 Normalized Node를 사용했을까?
이유는 Saturation이 발생하는 영역을 명확하게 알 수 있기 때문.
Sigmoid의 경우 출력값이 1에 가까워질수록 Saturation이 발생한다는 것을 명확하게 알고 있음.
반면 Unnormalized Node는
이전 Layer들의 복잡한 비선형 함수이기 때문에
어떤 영역에서 Gradient가 Saturation되었는지를 직접 시각화하거나 사전에 예측하기 어려움.
=> Sigmoid의 Normalized Node를 이용해서
Gradient Saturation이 발생하는 상황을 의도적으로 관찰하고,
이를 통해 Grad-CAM이 Gradient Saturation으로 인해 실패할 가능성이 있음을 보여주는 사례를 제시하는 것.
Ablation-CAM은 Gradient를 사용하지 않음
반면 Ablation-CAM은 Feature Map의 중요도를 계산할 때 Gradient를 사용하지 않음.
특정 Feature Map 를 직접 제거하고,
Feature Map 제거 전후의 Class Activation Score를 비교함.
따라서 Class Node의 Gradient가 Saturation되어 매우 작아지는 상황에서도 Feature Map의 중요도를 계산할 수 있음.
[Grad-CAM]

Class Score
    ↓
Gradient
    ↓
Saturation 발생 가능
    ↓
Gradient ≈ 0
    ↓
Visualization 문제 발생 가능


[Ablation-CAM]

Feature Map 제거
    ↓
Class Score 변화 직접 측정
    ↓
Gradient 사용 X
    ↓
Gradient Saturation의 영향 X
그래서 이런 이유로 Ablation-CAM이 Gradient Saturation 상황에서도 보다 Robust하게 동작하며,
Figure 4(d), (i)와 같이 높은 품질의 Visualization을 생성한다고 설명함.
정리해 보자면...
Grad-CAM이 실패할 수 있는 사례를 제시하고,
Ablation-CAM이 이러한 상황에서 보다 Robust하게 동작할 수 있음을 보여줌.
Grad-CAM의 문제점으로 크게 세 가지를 꼽음.
- 관심 영역의 일부만 강조할 수 있음
- 동일한 Class의 여러 Instance를 모두 강조하지 못할 수 있음
- Gradient Saturation으로 인해 Class-discrimination 능력을 잃을 수 있음
특히 Gradient 기반 Visualization에서는 Backpropagated Gradient가 비선형 함수의 Slope에 의존하기 때문에
일부 Pixel이 지나치게 강조되거나,
Saturation으로 Gradient가 Vanish할 수 있음.
★반면 Ablation-CAM은 Gradient를 사용하지 않고
Feature Map을 직접 제거했을 때 발생하는 Class Activation Score의 변화를 측정함.
따라서 Ablation-CAM이 이러한 Gradient 관련 문제에 보다 Robust하고,
Grad-CAM보다 완전하고 신뢰할 수 있는 Visualization을 제공할 수 있다고 주장함.
✅6. Experiments and Results
본 실험에서는 Ablation-CAM에 대한 객관적(Objective) 평가와 주관적(Subjective) 평가를 모두 수행하고,
그 결과를 Grad-CAM과 비교함.
실험에는 ImageNet으로 Pretrained된 VGG-16과 Inception-v3 모델을 사용함.
또한 Section 6.4와 6.5에서는 Grad-CAM 논문의 일부 실험을 동일하게 반복해서
Ablation-CAM이 Grad-CAM과 유사한 Visualization 능력을 가지고 있음을 확인했음.
6.1 Empirical Evaluation of Ablation-CAM
Ablation-CAM을 객관적으로 평가하기 위해
기존 Grad-CAM 연구에서 사용된 평가 방법을 활용함.
각 이미지 에 대해 먼저 Grad-CAM 또는 Ablation-CAM과 같은 Visualization Technique을 이용해서
Class-conditional Localization Map, 즉 Heatmap을 생성함.
이 Heatmap은 해당 Class를 판단하는 데 가장 중요한 영역을 강조함.
이후 Visualization Technique이 실제로 얼마나 유의미한 영역을 강조했는지를 평가하기 위해 Explanation Map을 생성함.
Explanation Map은
원본 이미지에서 Visualization Technique이 강조한 일부 영역만 남겨놓은 이미지임.
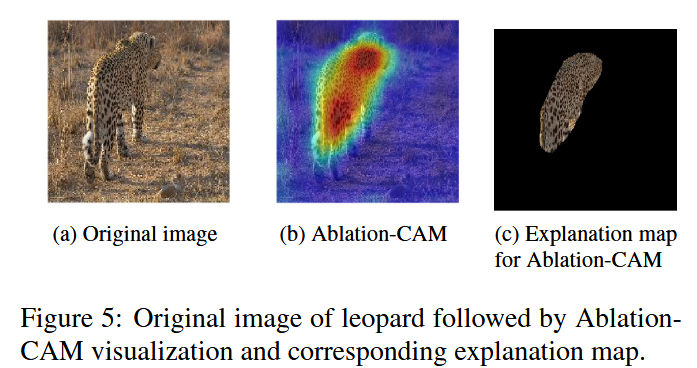
위 Figure 5에서는 그 과정을 보여줌.
Leopard 이미지에 Ablation-CAM을 적용한 후,
Ablation-CAM이 중요하다고 판단한 영역만 원본 이미지에서 유지햐서 Explanation Map을 생성함.
상위 20% Pixel만 이용한 Explanation Map
저자들은 Localization Map에서 중요도가 가장 높은 상위 20% Pixel만 유지해서 Explanation Map을 생성함.
나머지 80% Pixel은 모두 0으로 설정함.
이렇게 생성한 Explanation Map과
원본 이미지를 Point-wise Multiplication해서
실제 평가에 사용할 이미지를 생성함.
Figure 5(c)가 이러한 방식으로 생성된 Explanation Map의 예시임.
논문에서는 20%뿐만 아니라 상위 30%, 50% Pixel을 유지하는 경우도 실험했고, 유사한 결과를 얻었다고 설명함.
왜 Pixel 수를 동일하게 유지하는 것인가
Grad-CAM++와 달리 저자들은 비교하는 두 Visualization Technique에서 동일한 비율의 Pixel을 유지하도록 설정함.
Ablation-CAM과 Grad-CAM 모두 정확히 상위 의 Pixel만 사용한 것.
이렇게 하는 이유
: 더 넓은 영역을 Highlight한 방법이 무작정 유리해지는 걸 방지하기 위해.
[방법 A]
→ 중요한 영역을 정확하게 찾음
→ 적은 Pixel 강조

[방법 B]
→ 이미지 대부분을 강조함

Pixel 수를 제한하지 않으면
→ 방법 B가 더 많은 정보를 남겼다는 이유만으로
  좋은 결과를 얻을 수 있음
=> 동일한 Pixel 수를 유지함으로써,
주어진 Pixel 수 안에서 어떤 Visualization Technique이 더 관련성 높은 정보를 선택했는지를 비교할 수 있도록 함.
Ablation-CAM과 Grad-CAM의 평가 Metric
Ablation-CAM과 Grad-CAM으로 생성한 Explanation Map의 성능을 하단 Metric을 이용하여 비교했고,
Average Drop in ConfidenceAverage Drop in Activation ScorePercent Increase in ConfidencePercent Increase in Activation ScoreWin % in ConfidenceWin % in Activation Score
ImageNet Validation Set에서 VGG-16과 Inception-v3 모델을 이용해 실험했음.
1 & 2. Average Drop in Confidence & Activation Score
좋은 Class-conditional Explanation Map이라면
모델이 Decision을 내리는 데 필요한 Object의 중요한 부분 대부분을 포함하고 있어야 함.
따라서 원본 이미지 전체를 입력했을 때와 비교하여 Explanation Map만 입력했을 때 모델의 Output Score가 크게 감소하지 않는 것이 좋은 결과임.
그리고 논문에서는 이걸 이용해서
Ablation-CAM과 Grad-CAM의 Visualization을 비교했음.
Average Drop
: Explanation Map만 모델에 입력했을 때 발생하는 모델 Score의 평균 감소율.
- : 원본 이미지 (i)를 입력했을 때 Class (c)의 Output Score
- : Explanation Map을 입력했을 때 Class (c)의 Output Score
- : Dataset에 포함된 전체 이미지 수
그리고
인 경우에는 를 사용해서 Score 감소량을 0으로 처리함.
Explanation Map을 넣었는데 오히려 Score가 증가한 경우에는 Average Drop에 음수 값으로 반영하지 않음.
Average Drop은 낮을수록 좋은 결과라는 것.
VGG-16 결과
VGG-16의 ImageNet 2012 Validation Data에 대한 결과는 하단과 같음.
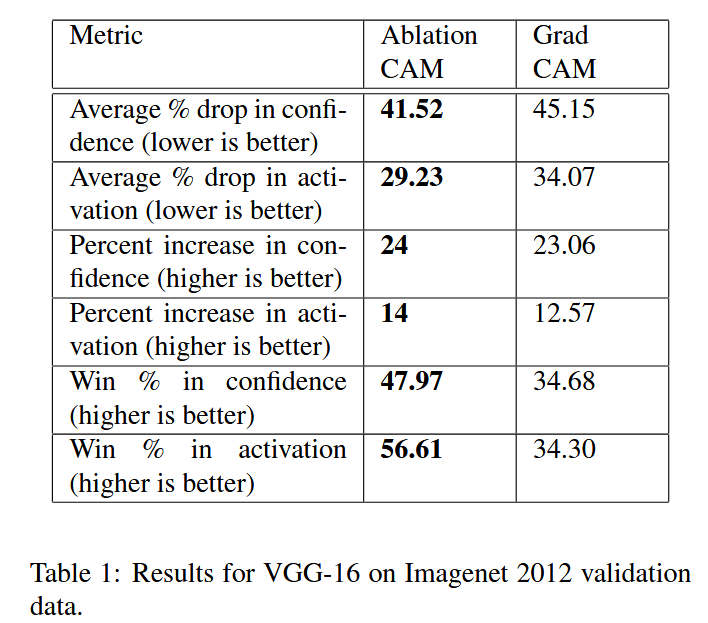
VGG-16에서는 모든 Metric에서 Ablation-CAM이 Grad-CAM보다 좋은 결과를 보임.
특히 Explanation Map만 입력했을 때 발생하는 Confidence와 Activation Score의 감소율이 Grad-CAM보다 낮았음.
저자들은 이를 통해 Ablation-CAM이 동일한 수의 Pixel을 이용하면서도
Class Prediction에 더 관련성 높은 정보를 포함하는 영역을 선택하고 있다는 것을 보여줌.
Inception-v3 결과
반면 Fully Connected Layer가 없는 Inception-v3에서는 두 방법의 성능 차이가 크지 않았음.
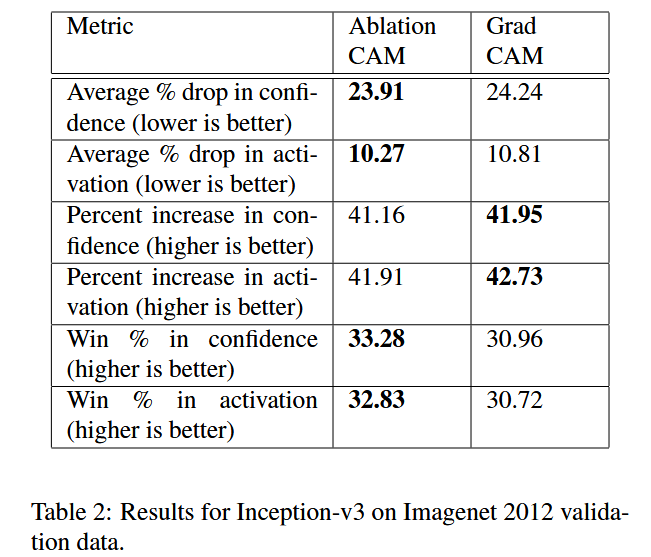
앞에서 언급했듯,
Fully Connected Layer가 없는 모델에서는 Grad-CAM이 사실상 CAM과 유사해지고 Final Linear Classifier의 Weight를 사용하게 되기 때문에 Ablation-CAM과의 성능 차이가 크지 않다고 설명함.
따라서 전체적으로는 Ablation-CAM이 VGG-16에서 Grad-CAM보다 더 좋은 성능을 보였지만,
Inception-v3에서는 두 방법이 비슷한 성능을 보임.
3 & 4. Percent Increase in Confidence & Activation Score
Explanation Map을 원본 이미지 전체 대신 모델에 입력했을 때,
오히려 Output Confidence 또는 Activation Score가 증가하는 경우도 존재함.
그리고 논문에서는 이런한 현상이 좋은 Explanation Map에서 자주 발생할 것으로 예상함.
모델의 판단과 관련성이 낮은 배경이나 불필요한 정보를 제거하고 중요한 영역만 남겼기 때문에 오히려 Target Class Score가 증가할 수 있다는 것임.
이를 측정하기 위해 다음 Metric을 사용함.
여기서 는 Indicator Function으로,
이면 1을 반환하고, 그렇지 않으면 0을 반환함.
= 전체 Dataset 중 Explanation Map을 입력했을 때 Score가 증가한 이미지의 비율을 계산하는 Metric.
= 높을수록 좋은 결과.
5 & 6. Win % in Confidence & Activation Score
앞선 Metric에 추가해서,
논문에서는 Dataset의 각 이미지에 대해 두 방법 중 어떤 방법이 더 작은 Score Drop을 발생시켰는지 계산함.
이거를 Win %로 표현하는데,
ex. 특정 이미지에서
Ablation-CAM Explanation Map
→ Score Drop = 15%

Grad-CAM Explanation Map
→ Score Drop = 30%
이라면 해당 이미지에서는 Ablation-CAM이 Win한 것으로 계산함.
한 Visualization Technique이 다른 Technique보다 더 작은 Output Score 감소를 만들어낸 이미지의 비율을 의미함.
(이 값 또한 높을수록 좋은 결과)
Table 1에서 Ablation-CAM은 VGG-16에 대해 50%가 넘는 사례에서 Grad-CAM보다 좋은 결과를 보임을 확인할 수 있음.
논뮨에서는 여기서 Positive Drop만 고려하고 Negative Value는 모두 0으로 설정했다고 설명했음.
6.2 Evaluation Using Axiomatic Approach
Sundararajan et al.은 Attribution Method를 평가하기 위한 Axiomatic Approach를 제안함.
좋은 Attribution Method가 만족해야 할 두 가지 성질로 다음을 제시함.
- Sensitivity
- Implementation Invariance
Sensitivity
Ablation-CAM은 각 Feature Map에 대해 Baseline을 설정하고 실제로 해당 Feature Map을 제거해서 Output의 변화를 측정하는 것임.
따라서 각 Feature Map 입력에 대해 Sensitivity를 만족한다고 설명함.
또한 순간적인 Gradient를 사용하는 대신
Ablation을 통해 일종의 Discrete Gradient를 계산한다고 볼 수 있음.
[Grad-CAM]
→ 한 지점에서의 Gradient

[Ablation-CAM]
→ Feature Map 존재 / 제거 상태의 차이
→ Discrete Gradient와 유사
한편 Ablation-CAM은 Implementation Invariance 특성을 위반하는 것처럼 보일 수 있음.
왜냐하면 Ablation-CAM Visualization이
중간 Convolutional Layer의 Feature Map 크기에 의존하기 때문임.
기능적으로는 동일한 두 Network라도 중간 Feature Map의 크기가 다를 수 있기에,
내부 구현이 달라지면 Visualization 결과도 달라질 가능성이 있음.
그럼에도 논문에서는 Ablation-CAM이 Integrated Gradients와 같은 Pixel-space Technique과 비교했을 때
더 좋은 Localization과 Noise-free하면서 Class-discriminative한 Visualization을 제공한다고 주장함.
6.3 Subjective Evaluation of Ablation-CAM
Section 6.1에서는 Ablation-CAM의 Faithfulness에 대한 객관적 평가를 수행했음.
이번에는 Ablation-CAM으로 생성한 Explanation이
사람에게 얼마나 신뢰성 있게 느껴지는지를 평가하기 위해 Subjective Evaluation을 수행하고,
Grad-CAM과 비교함.
실험에서는 먼저 VGG-16이 좋은 성능을 보이는 Category를 사용하기 위해
Validation Dataset에서 F1-score가 가장 높은 Class들을 선택했음.
이렇게 선택된 Class들을 이용해소 총 250개의 이미지를 구성함.
- Class당 50개 이미지
- 총 5개 Class
- 전체 250개 이미지
각 이미지에 대해 Grad-CAM과 Ablation-CAM의 Localization Map을 각각 생성함.
Human Subject Experiment
생성된 Localization Map을 Deep Learning에 대한 사전 지식이 없는 10명의 Human Subject에게 보여줌.
각 사람에게 Class Label과 함께 두 개의 Visualization을 제공하고 다음 질문을 함.
어떤 Map이 해당 Class의 Object를 더 잘 Highlight하는가?
만약 두 Localization Map이 매우 비슷하다고 판단될 경우에는 same을 선택할 수도 있도록 함.
또한 어떤 Visualization이 Grad-CAM이고 어떤 것이 Ablation-CAM인지에 대한 정보는 참가자에게 제공하지 않음.
Subjective Evaluation 결과
각 이미지에 대해 예를 들어 10명의 참가자 중
- 3명 → Grad-CAM 선택
- 5명 → Ablation-CAM 선택
- 2명 → Same 선택
했다고 가정하면 각각의 Normalized Score는 가 됨.
따라서 하나의 Option이 얻을 수 있는 최대 Score는 .
실험 결과 Ablation-CAM의 Score는 이었고,
Grad-CAM은 을 기록함.
나머지 는 same으로 평가됨.
논문에서는 이런 Empirical Study 결과가
Ablation-CAM Visualization이
Grad-CAM으로 생성한 Visualization보다 사람에게 더 신뢰할 수 있는 것으로 평가되었다는 강한 근거를 제공한다고 설명함.
6.4 Ablation-CAM for Model Selection
이번에는 반대로 서로 다른 두 모델에 대해 Ablation-CAM Visualization을 비교함.
논문에서는 Grad-CAM 연구에서 사용한 실험을 활용해서
Generalization Performance가 더 좋은 모델이 더 좋은 Ablation-CAM Visualization을 생성하나?라는 가설을 확인함.
이를 위해 VGG-16과 AlexNet의 Ablation-CAM Visualization을 비교함.
ImageNet Classification에서 Top-1 Error는
VGG-16: 28.41AlexNet: 43.45
=>VGG-16이 더 좋은 성능을 보임.
=> 많은 이미지에서 VGG-16의 Visualization이
AlexNet보다 Object의 관련 영역을 더 잘 Highlight할 것이라고 예상함.
이때, 동일하게 맞힌 이미지만 사용
Visualization의 품질과 모델 Prediction Accuracy의 영향을 분리하기 위해,
본 실험에서는 두 모델이 모두 동일한 Prediction을 한 이미지들만 Ground Truth로 사용했음.
또한 ImageNet에서 동일한 5개 Class를 선택함.
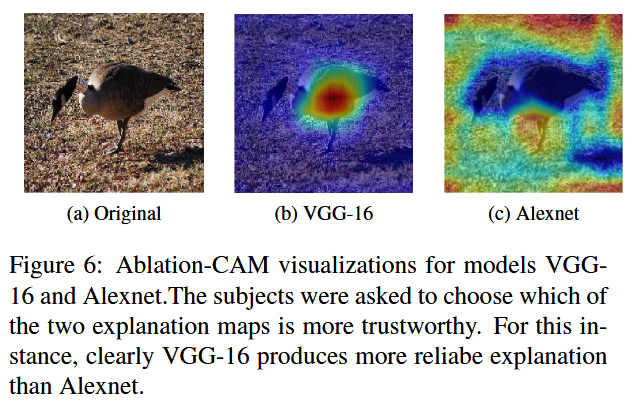
Figure 6에서는 VGG-16과 AlexNet이 생성한 Ablation-CAM Visualization을 비교함.
Human Subject 10명에게 두 Visualization의 신뢰도를 평가하도록 했고 평가 기준은 하단과 같음.
: 첫 번째 Visualization이 두 번째보다 명확하게 더 신뢰할 수 있는 경우
: 첫 번째 Visualization이 약간 더 신뢰할 수 있는 경우
: 두 Visualization의 신뢰도가 비슷한 경우
: 두 번째 Visualization이 더 신뢰할 수 있는 경우
으로 설정했음.
참가자들은 어떤 Visualization이 VGG-16이고 어떤 게 AlexNet인지 알지 못했음.
또한 VGG-16과 AlexNet Visualization이
첫 번째 Option에 등장하는 순서를 Random하게 변경함.
Model Selection 결과
Human Subject가 부여한 평균 Score: .
이는 저자들의 평가 기준에서 AlexNet보다 VGG-16이 생성한 Visualization이 명확하게 더 신뢰할 수 있는 방향의 결과임.
위 Figure 6에서도 AlexNet의 Visualization은 이미지의 관련 없는 영역까지 Highlight하는 반면,
VGG-16은 Object에 보다 집중된 Visualization을 생성하는 사례를 보여줌.
이를 통해 Ablation-CAM이
모델의 성능을 비교하거나 Model Selection을 보조하는 데 활용될 수 있음을 확ㄱ인할 수 있었음.
6.5 Evaluating Class Discrimination
좋은 Visualization Technique이 가져야 할 중요한 특성 중 하나는 Class Discrimination임.
Class Discrimination
: 한 이미지에 둘 이상의 Category Object가 존재할 때,
특정 Class를 선택하면 그 Class와 관련된 영역만 선택적으로 Visualization할 수 있어야 함.
특정 Object Category에 대한 Visualization이 다른 Category의 일부까지 함께 Highlight한다면,
해당 Visualization은 모델에 대한 사용자의 해석을 방해할 수 있다는 것.
Pascal VOC 2007을 이용한 Class-discrimination 평가
Class-discrimination을 평가하기 위해
ImageNet으로 Pretrained된 VGG-16을 Pascal VOC 2007 Dataset으로 Fine-tuning함.
이후 Validation Set을 이용해서 Visualization을 생성함.
VOC 2007 Validation Set에서 정확히 두 개의 Category를 포함하는 이미지를 선택함.
각 이미지에 대해 두 Category 각각을 Target으로 해서
Guided Ablation-CAM Visualization 두 개를 생성함.
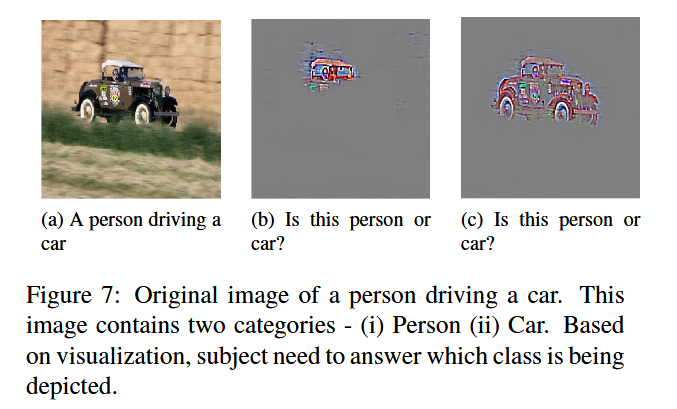
Figure 7의 예에서는 한 이미지에
Person, Car 두 Category가 존재함.
따라서 같은 이미지에 대해
-
Target = Person
→ Person에 대한 Guided Ablation-CAM -
Target = Car
→ Car에 대한 Guided Ablation-CAM을 각각 생성함.
Human Evaluation
생성된 두 Visualization을 10명의 Human Subject에게 보여주고
두 Object Category 중 어떤 것이 Visualization에 의해 Highlight되고 있는지 물어봄
또한 두 Object가 모두 Highlight되고 있다고 판단하는 경우 "both"를 선택할 수 있도록 함.
총 50개의 이미지-Category Pair를 평가했고,
논문에서는 both를 선택한 경우를 잘못된 응답으로 처리햤다고 함.
(왜냐하면 Class-discriminative Visualization이라면 하나의 Target Class를 설명할 때 해당 Class만 선택적으로 Highlight해야 하기 때문)
Class-discrimination 결과
Guided Ablation-CAM의 경우
Human Subject가 Visualization의 Target Category를 정확하게 식별한 비율은 였음.
반면 Guided Grad-CAM에서는 를 기록함.
따라서 Guided Ablation-CAM이 Guided Grad-CAM보다 더 높은 Class-discrimination 능력을 보였다고 할 수 있음.
정리해 보자면,
Ablation-CAM은 Grad-CAM 대비
객관적 평가와 주관적 평가를 모두 수행함.
객관적 평가에서는 Localization Map에서 동일하게 상위 20% Pixel만 남긴 Explanation Map을 생성한 뒤,
해당 이미지만 모델에 입력했을 때 Target Class의 Score가 얼마나 유지되는지를 측정함.
VGG-16에서는 Ablation-CAM이 Grad-CAM보다 전반적으로 더 좋은 결과를 보였고,
Fully Connected Layer가 없는 Inception-v3에서는 두 방법의 성능 차이가 크지 않았음.
Axiomatic Evaluation에서는 Ablation-CAM이 Sensitivity를 만족하지만,
중간 Feature Map에 의존하기 때문에
Implementation Invariance를 위반할 가능성이 있음을 논의함.
또한 Human Subject를 이용한 주관적 평가에서는 Ablation-CAM Visualization이 Grad-CAM보다 더 신뢰할 수 있는 것으로 평가되었음.
마지막으로 Ablation-CAM은 모델 간 Visualization 비교와 Class-discrimination 평가에도 활용되었고,
저자들은 이를 통해 Ablation-CAM이 Localization뿐만 아니라
모델에 대한 Trust Evaluation과 Model Selection에도 활용될 수 있음을 보여주고자 함.
전체적인 실험 구조를 정리하면 다음과 같음.
✅7. Limitations of Ablation-CAM
1.
Ablation-CAM은Grad-CAM보다 Visualization 생성에 더 많은 연산 시간이 필요함.
그 이유는 각 Feature Map을 하나씩 Ablation한 뒤,
이에 따른 Class Activation Score의 감소를 확인해야 하기 때문.
다만 논문에서는 실험에서 사용한 것처럼 적절한 Multiprocessing을 적용하면
이런 생성 시간 차이를 상당히 줄일 수 있다고 설명함.
2. 모델 구조에 따라
Ablation-CAM성능 향상이 크지 않을 수 있다는 것.
Table 2에서 ResNet-50이나 Inception-v3처럼 Fully Connected Layer가 없는 모델에서는
Ablation-CAM이 Grad-CAM보다 약간 더 좋은 수준에 그침.
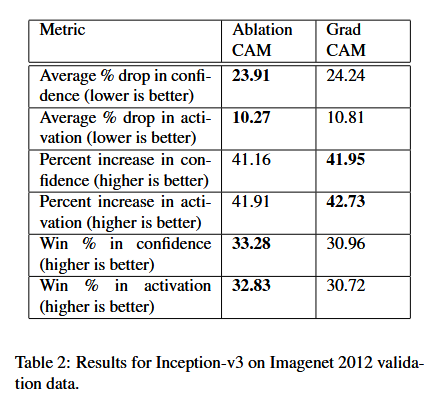
이런 모델에서는 Grad-CAM이 본질적으로 CAM과 유사하게 동작하고,
Output Node는 마지막 Convolutional Layer의 Global Average Pooled Feature Map들의 선형 결합으로 구성됨.
그래서 이런 경우, Ablation-CAM은 다른 CAM 방법들과 비슷한 수준으로 동작함.
이에 논문에서는 마지막 Convolutional Layer 바로 뒤에 Decision Node가 위치하지 않는 Image Captioning과 같은 Task에서는 Ablation-CAM이 더 좋은 성능을 보일 수 있다고 설명함.
🔚8. Conclusion
본 논문에서는 CNN 기반 모델의 개별 Decision을 설명하기 위해
Class-discriminative Localization Map을 생성하는 새로운 방법인 Ablation-CAM을 제안함.
기존 방법들과 달리 Ablation-CAM은 Gradient-free 방식임.
객관적 및 주관적 평가를 통해 Ablation-CAM이 기존 Grad-CAM보다 좋은 성능을 보임을 확인했고,
추가 실험을 통해 하단과 같은 특성을 확인했음.
- Class-discriminative한 Visualization을 생성할 수 있음
- 모델에 대한 Trust 형성에 활용할 수 있음
- Model Selection을 보조하는 데 활용할 수 있음
향후 연구에서는 Ablation-CAM을 Vision Task뿐만 아니라 Reinforcement Learning, Natural Language Processing 등의 Non-vision Task에 적용해서 Explanation을 생성할 계획이라고 함.
Ablation-CAM은 Feature Map을 직접 제거했을 때 발생하는 Class Score의 감소량을 이용하여 Feature Map의 중요도를 계산하는 Gradient-free CAM 기법.
다만 Feature Map을 하나씩 Ablation해야 하므로,
Grad-CAM보다 연산량이 크고,
일부 모델 구조에서는Grad-CAM대비 성능 차이가 크지 않다는 한계가 있음.
