Paper: Score-CAM - Score-CAM: Score-Weighted Visual Explanations for Convolutional Neural Networks
🔍1. Introduction
기존 CNN 설명 방법
CNN의 예측 과정을 시각적으로 설명하는 방법은 크게
- Gradient-based
- Perturbation-based
- CAM-based
방식으로 구분할 수 있음.
1. Gradient-based Method
- Target class의 gradient를 입력 이미지까지 역전파해서 예측에 중요한 영역을 찾는 방식
ex.Saliency Map - Gradient를 가공해서 시각화를 개선한 여러 방법이 제안됐지만, 생성된 Saliency Map에 noise도 많고 품질이 낮을 수 있다는 한계 존재.
2. Perturbation-based Method
- 입력 이미지의 일부를 가리거나 변형한 뒤, 모델의 prediction 변화를 관찰하는 방식
- 특정 영역을 제거했을 때 Target class score가 크게 감소한다면, 해당 영역이 모델 판단에 중요한 부뷴이라고 해석할 수 O.
- Gradient에 의존하지는 않지만, 많은 Forward Pass가 필요해 계산량이 크다는 한계 O
ex.RISE
3. CAM-based Method
- Convolution layer에서 생성된 Activation Map들을 가중합해서 Target class의 중요 영역을 시각화하는 방식
- : Class 에 대한 번째 Activation Map의 중요도
- : 번째 Activation Map
=> CAM 계열 방법: 각 Activation Map의 중요도 를 어떻게 계산하는지가 중요 point
CAM의 한계와 Grad-CAM
기존 CAM은 Class-specific localization이 가능하지만 모델 구조에 제약 존재.
특히 Convolution layer 이후 Global Average Pooling(GAP) 구조가 필요하기 때문에 다양한 CNN 구조에 바로 적용하기 어려움.
=> Grad-CAM은 이런 문제를 해결하기 위해
Gradient를 이용해 Activation Map의 중요도(weight)를 계산함.
이를 통해 특정 구조에 의존하지 않고 다양한 CNN에 적용할 수 있게 됨.
하지만 Score-CAM 저자들은 여기서 문제를 제기함.
: Gradient가 Activation Map의 중요도를 측정하는 가장 적절한 방법이 맞나?
- Gradient는 현재 입력 주변에서 feature가 조금 변화했을 때 Target class score가 얼마나 민감하게 변하는지를 나타내는 Local Sensitivity Measurement임.
- 따라서 저자들은 Gradient 대신 각 Activation Map이 실제 모델의 예측에 얼마나 기여하는지를 직접 측정하는 방법을 제안함.
Score-CAM
Score-CAM은 Gradient를 사용하지 않는 CAM 기반 시각적 설명 방법임.
각 Activation Map을 이용해 입력 이미지를 Masking한 뒤 모델에 다시 입력하고,
이때 얻어진 Target class의 Forward Passing Score를 해당 Activation Map의 중요도로 사용함.
i) Grad-CAM 방식
방식으로 Activation Map의 중요도 계산
ii) Score-CAM 방식
방식으로 중요도 계산.
=> Score-CAM: Perturbation-based Method와 CAM-based Method의 특징을 연결한 방법이러고 할 수 있음.
Contributions
-
Gradient-Free Visual Explanation Method인 Score-CAM 제안
- Gradient 대신 Forward Passing Score를 이용해 Activation Map의 중요도를 계산
- Perturbation-based Method와 CAM-based Method를 연결
-
정량적 평가
- Average Drop / Average Increase
- Deletion Curve / Insertion Curve
- Score-CAM이 Target class의 판단 근거를 효과적으로 찾을 수 있음을 확인
-
Visualization 및 Localization 성능 평가
- 기존 CAM 기반 방법들과 비교하여 시각화 및 Localization 성능을 평가
-
Model Debugging에 활용
- 모델이 잘못된 예측을 수행했을 때, 어떤 영역을 근거로 판단했는지 분석하는 Debugging Tool로 활용 가능
Score-CAM
: Activation Map의 중요도를 Gradient로 계산하지 않고, 해당 Activation Map이 Target class prediction에 미치는 영향을 Forward Pass를 통해 직접 측정하는 Gradient-Free CAM 방법.
✅2. Background
Score-CAM을 이해하기 위해서는 먼저 기존 CAM과 Grad-CAM이 Activation Map의 중요도를 어떻게 계산하는지 알아야 함.
CAM 계열 방법 기본 idea
: Convolution Layer에서 생성된 여러 Activation Map 중 어떤 Channel이 Target Class 예측에 중요한지를 계산하고,
이를 가중합해서 중요 영역을 시각화하는 것.
CAM (Class Activation Mapping)
CAM은 마지막 Convolution Layer의 Activation Map을 가중합하여 특정 Class를 판단하는 데 중요한 영역을 찾는 방법임.
Convolution Layer에서는 여러 개의 Activation Map이 생성됨.
A¹ → 특정 Feature에 반응

A² → 특정 Feature에 반응

A³ → 특정 Feature에 반응

...

Aᵏ → 특정 Feature에 반응
각 Activation Map은 입력 이미지에 대한 서로 다른 Spatial Information을 가지고 있음.
이때 중요한 건,
각 Activation Map이 Target Class 예측에 얼마나 중요한가?임
그리고 CAM에서는 이걸 Global Pooling 이후 Fully Connected Layer의 Weight를 이용해서 판단함.
CAM 수식
논문에서는 CAM을 다음과 같이 정의함.
여기서,
- : Class 에 대한 최종 CAM
- : Class 에 대한 번째 Activation Map의 중요도
- : 마지막 Convolution Layer의 번째 Activation Map
CAM에서는 를 다음과 같이 정의함.
Global Pooling 이후 Classifier에서 사용하는 FC Layer Weight를 그대로 Activation Map의 중요도로 사용하는 것.
구조를 보면,
Convolution Layer

A¹   A²   A³   ...   Aᵏ
│    │    │          │
↓    ↓    ↓          ↓

Global Pooling

│    │    │          │
↓    ↓    ↓          ↓

FC Layer
w₁   w₂   w₃   ...   wₖ

        ↓

Class Score
이때 FC Layer의 가 해당 Activation Map의 중요도를 나타낸다고 보는 것.
CAM 한계
하지만 CAM에는 큰 문제가 있음.
= 특정 Network Architecture를 요구한다는 것.
CAM을 사용하려면 기본적으로
Convolution Layer
↓
Global Pooling
↓
FC Layer
↓
Classification
구조가 필요함.
왜냐하면 Activation Map의 중요도 를 처럼
Global Pooling 이후 FC Layer의 Weight로 정의했기 때문.
근데 모든 CNN이 이런 구조를 가지는 것은 아님.
ex. VGG처럼 Global Pooling이 없거나,
Global Pooling 이후 여러 개의 FC Layer가 존재하는 구조에서는
어떤 FC Weight를 Activation Map의 중요도로 사용해야 하는지 정의하기 어려움.
= CAM은 Architecture-sensitive하다는 한계가 있다는 것.
Grad-CAM
이러한 CAM의 구조적 제약을 해결하기 위해 등장한 것이 Grad-CAM.
Grad-CAM의 main idea
: FC Layer의 Weight를 사용할 수 없다면, Gradient를 이용해서 Activation Map의 중요도를 계산하자.
따라서 CAM과 달리 특정 Global Pooling 구조를 요구하지 않기 때문에,
더 다양한 CNN Architecture에 적용 가능.
Grad-CAM 수식
Grad-CAM은 다음과 같이 정의됨.
CAM과 최종적인 형태는 거의 동일함.
차이는 를 계산하는 방법에 있다는 것.
Grad-CAM에서는
로 계산.
여기서,
- : Target Class 의 예측값
- : Layer 의 번째 Activation Map
- : 해당 Activation Map에 대한 Target Class Score의 Gradient
- : Global Pooling Operation
[구조]
Target Class Score Yᶜ
↓
Backpropagation
↓
각 Activation Map에 대한 Gradient 계산
↓
Global Pooling
↓
αₖᶜ 계산
↓
Activation Map의 Weight로 사용
CAM vs Grad-CAM
결국 두 방법의 가장 중요한 차이는 Activation Map의 중요도 를 어떻게 정의하는가에 있음.
| Method | Activation Map의 Weight |
|---|---|
| CAM | FC Layer Weight |
| Grad-CAM | Gradient |
| Grad-CAM++ | Gradient의 조합 |
CAM에서는
Grad-CAM에서는
를 사용함.
Grad-CAM++ 역시 기본적인 구조는 동일하지만,
여러 Gradient 정보를 조합하여 를 계산한다는 차이가 있음.
근데 Gradient가 정말 중요도를 의미하는 것인가
Gradient를 사용하면서 CAM의 Architecture 제약은 해결할 수 있었음.
하지만 Score-CAM 논문에서는 여기서 다시 문제를 제기함.
Gradient가 정말 각 Activation Map의 Importance를 제대로 나타내는가?
Gradient는 기본적으로
이므로,
Activation Map 가 현재 지점에서 조금 변했을 때 Target Class Score 가 얼마나 변하는지를 나타냄.
=> Gradient는 해당 Feature에 대한 Local Sensitivity를 측정하는 값이라고 볼 수 있음.
하지만
현재 지점에서 변화에 민감하다는 것과
해당 Feature가 실제 예측에 크게 기여했다는 것이 정말 같은 의미인가?라는 의문이 생김.
그래서 Score-CAM 저자들은 이 둘을 구분함.
[Grad-CAM]

Gradient
↓
Local Sensitivity
↓
Activation Map Importance
대신 Score-CAM에서는
Activation Map이 강조하는 Feature를
실제 Input에 반영

↓

Forward Pass

↓

Target Class Confidence 변화 측정

↓

Activation Map Importance
방식을 사용함.
이를 논문에서는 이후 Increase of Confidence라는 개념을 통해 정의함.
Score-CAM
: Gradient 기반의 Local Sensitivity 대신,
해당 Feature가 Target Class Confidence에 실제로 얼마나 기여하는지를 이용해
Activation Map의 Importance를 측정하는 것.
2.1. Gradient Issue
앞에서 Grad-CAM은 각 Activation Map의 중요도를 Gradient를 이용해 계산한다고 했음.
Gradient가 큼
↓
해당 Activation Map이 중요함
↓
Target Class 예측에 크게 기여함
이라고 해석하는 것.
논문에서는 Gradient 기반 중요도의 문제를 크게 두 가지로 설명함.
- Saturation
- False Confidence
1. Saturation
Deep Neural Network에서 Gradient는 Saturation 문제로 인해 매우 작아지거나 0이 될 수 있음.
논문에서는 대표적으로
i) Sigmoid의 Saturation
ii) ReLU의 Zero-gradient Region
을 언급함.
i) Sigmoid
Sigmoid에서는 입력값이 매우 크거나 작아지면 함수가 포화되면서 Gradient가 거의 0이 됨.
Neuron이 실제 예측에 영향을 주고 있음

        ↓

하지만 Activation이 Saturation 영역에 존재

        ↓

Gradient ≈ 0

        ↓

Grad-CAM에서는 중요하지 않은 Feature처럼 평가될 수 있음
ii) ReLU
ReLU 역시 입력이 음수인 영역에서는
이므로 Gradient가 사라짐.
=> 실제 Network 내부에서 어떤 Feature가 예측에 영향을 주고 있더라도,
Gradient만 이용하면 그 중요도를 제대로 표현하지 못할 가능성이 있음.
Gradient는 시각적으로 Noise가 발생할 수 있음
이런 문제 때문에
또는
와 같은 Gradient가 시각적으로 Noisy하게 나타날 수 있음.
이는 입력 Feature의 중요도를 Gradient로 계산하는 기존 Saliency Map에서도 나타나는 문제라고 설명함.
논문에서는 Figure 4를 통해 Gradient가 시각적으로 Noise를 포함할 수 있음을 보여줌.
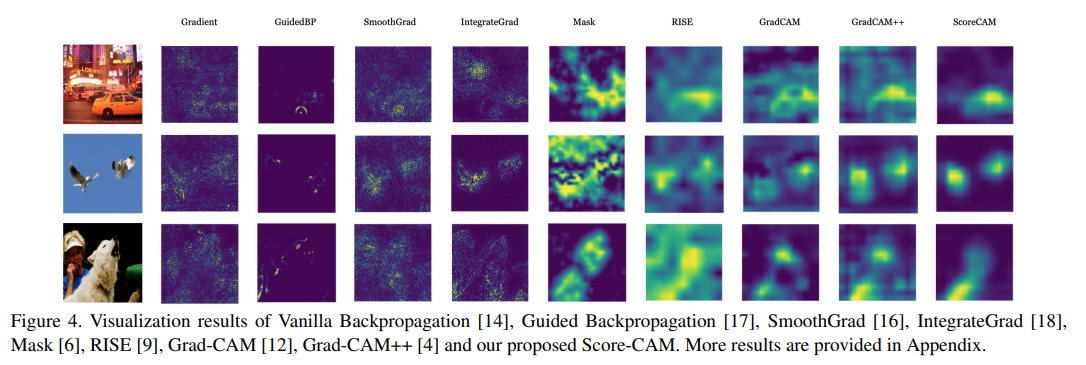
Gradient가 항상 안정적인 Feature Importance를 제공하는 것은 아님.
2. False Confidence
Score-CAM 논문에서 지적하는 또 다른 문제는 False Confidence임.
Grad-CAM은 다음과 같이 여러 Activation Map을 가중합함.
따라서 두 Activation Map 가 있고,
라면 자연스럽게
가 나타내는 영역이 가 나타내는 영역보다 Target Class 에 더 중요하다고 해석하게 됨.
Aᵢ → Weight = 0.035
Aⱼ → Weight = 0.021
라면,
Aᵢ가 Aⱼ보다
Target Class 예측에 더 중요할 것이다.
라고 생각하는 것.
!! 하지만 논문에서는 실제로 그렇지 않은 Counterexample이 존재한다고 지적함.
Figure 2 실험
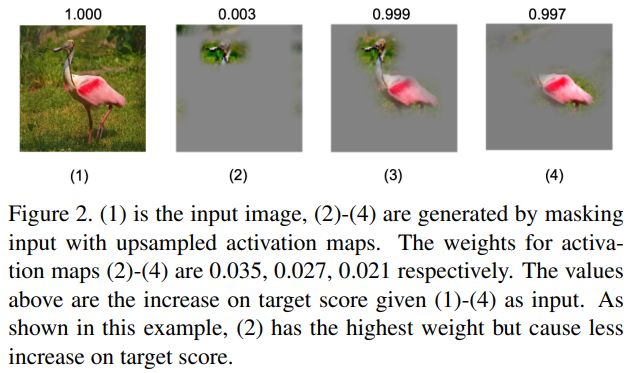
이를 확인하기 위해 저자들은 Activation Map을 이용해 직접 Input을 Masking함.
과정은 하단과 같음.
Activation Map

↓

Input Image 크기로 Upsampling

↓

Activation Map을 Mask처럼 사용

↓

Input × Activation Map

↓

해당 영역만 강조된 이미지를 Model에 입력

↓

Target Class Score 변화 측정
Activation Map이 가리키는 영역을 실제 Model에 넣었을 때
Target Score가 얼마나 증가하는지 직접 확인한 것.
Figure 2에서는 다음과 같은 Activation Map들이 사용됨.
Activation Map (2)
Weight = 0.035

Activation Map (3)
Weight = 0.027

Activation Map (4)
Weight = 0.021
Grad-CAM의 관점에서는 이니까
당연히
(2)가 가장 중요

↓

(3)

↓

(4)가 가장 덜 중요
하다고 판단하게 됨.
그런데 실제 Target Score 확인해보면
Activation Map을 이용해 Input을 Masking한 다음에
실제로 Model에 Forward Pass해보면 이런 순서가 유지되지 않았음.
특히 논문에서 다룬 예시에서는
머리 부분을 나타내는 Activation Map이 가장 높은 Weight를 받았지만,
실제 Target Score의 증가는 가장 작았디는 것.
이를 논문에서는 False Confidence 문제로 설명함.
왜 이런 문제가...
논문에서는 이런 현상이
- Gradient에 적용되는 Global Pooling
- Network 내부의 Gradient Vanishing
등으로 인해 발생할 수 있다고 설명함.
Grad-CAM에서는 Activation Map 전체의 Gradient를 Global Pooling해서 하나의 값으로 만듦.
이 과정에서 Activation Map의 실제 기여도를 정확하게 나타내지 못할 가능성이 있다는 것.
Score-CAM 저자들이 지적하는 포인트는 다음과 같음.
[Grad-CAM]

Activation Map
↓
Gradient 계산
↓
Global Pooling
↓
Weight αₖᶜ
↓
Feature Importance라고 간주
하지만 실제로는
Gradient Weight가 높음

≠

해당 Feature가 Target Score를 많이 증가시킴
일 수 있다는 것.
=> Score-CAM에서는 Gradient를 이용해 간접적으로 중요도를 추정하는 대신,
Activation Map이 나타내는 영역을 실제 Input에 반영하고,
이를 Forward Pass했을 때 Target Class Score가 얼마나 변하는지를 직접 측정하자.
Activation Map

↓

Upsampling

↓

Input Masking

↓

Forward Pass

↓

Target Class Score 측정

↓

Activation Map Importance 결정
이 아이디어가 다음 Section에 나오는 Increase of Confidence와 Score-CAM의 main Weight 계산 방식으로 이어지는 것.
정리해 보자면,
- Grad-CAM은 Gradient를 이용해 각 Activation Map의 중요도를 계산함.
- 하지만 Gradient는 Sigmoid Saturation이나 ReLU의 Zero-gradient Region 때문에 Vanishing될 수 있음.
- Gradient 자체가 Noisy하게 나타날 수도 있음.
- Grad-CAM에서는 Gradient Weight가 큰 Activation Map을 더 중요하다고 판단함.
- 하지만 Figure 2에서는 높은 Weight를 받은 Activation Map이 실제 Target Score에는 더 적게 기여하는 False Confidence 현상이 나타남.
- => Gradient 기반 Weight와 실제 Feature Contribution이 일치하지 않을 수 있다는 것.
- Score-CAM은 이를 해결하기 위해 Activation Map으로 Input을 Masking하고,
Forward Pass를 통해 Target Class Score의 변화를 직접 측정하는 방향을 제안함.
✅3. Score-CAM: Proposed Approach
앞에서 Grad-CAM의 주요 문제를 다음과 같이 봤음.
Activation Map
↓
Gradient 계산
↓
Gradient를 기반으로 Weight 계산
↓
Activation Map의 중요도 결정
하지만 앞에서 살펴본 것처럼
- Gradient Saturation
- Gradient Vanishing
- Noisy Gradient
- False Confidence
등의 문제가 발생할 수 있다는 것.
특히 Gradient Weight가 크다고 해서 해당 Activation Map이 실제 Target Class 예측에 크게 기여한다고 보장할 수 없음.
그래서 Score-CAM에서는 Gradient를 아예 사용하지 않음.
대신 해당 Activation Map이 나타내는 영역을 실제 Input에 반영한 뒤,
Forward Pass를 수행했을 때 Target Class Score가 얼마나 증가하는지를 이용해 중요도를 계산함.
3.1. Methodology
Score-CAM의 main idea = Increase of Confidence
계속 언급했듯, 기존 Grad-CAM에서는
처럼 Gradient를 이용해 Activation Map의 Weight를 계산했지만,
Score-CAM에서는
이 Activation Map이 나타내는 영역만 보여줬을 때
Target Class Score가 얼마나 증가하는지를 기준으로 바꿈.
[Grad-CAM]

Gradient
↓
Weight


[Score-CAM]

Forward Score 변화
↓
Weight
★ Increase of Confidence
먼저 논문에서는 일반적인 Increase of Confidence를 정의함.
함수 가 있고,
입력은 라고 하고,
비교 기준이 되는 Baseline Input을 라고 함.
특정 Feature 가 Output 에 얼마나 기여하는지를 다음과 같이 정의함.
- : 해당 Feature의 Contribution
- : Baseline Input
- : 관심 Feature를 선택하기 위한 Mask
- : Hadamard Product, Element-wise Multiplication
특정 Feature를 반영했을 때 Output이 Baseline보다 얼마나 변했는지를 직접 측정하는 것.
(논문에서는 DeepLIFT와 Grad-CAM++의 Average Drop / Increase in Confidence에서도 이와 비슷한 개념이 사용됐다고 설명함.)
Channel-wise Increase of Confidence
Score-CAM에서는 이 아이디어를 CNN의 각 Activation Map 단위로 확장함.
Convolutional Layer 의 Activation을 이라 하고,
그 중에 번째 Channel의 Activation Map을
라고 함.
Score-CAM에서는 의 중요도를 다음과 같이 정의함.
여기서 Mask 는
로 생성함.
Activation Map Aₗᵏ
↓
Input Image 크기로 Upsampling
↓
0~1 범위로 Normalization
↓
Mask Hₗᵏ 생성
↓
Original Input에 Mask 적용
↓
Model Forward Pass
↓
Target Class Score 측정
이 과정을 통해 각 Activation Map이 Target Class에 얼마나 기여하는지 계산함.
이걸 논문에서는 Channel-wise Increase of Confidence, CIC라고 부름.
왜 Activation Map을 Upsampling하는 거냐면,
CNN 내부의 Activation Map은 일반적으로 Input Image보다 공간 해상도가 작음.
ex.
Input Image
224 × 224
↓
CNN
↓
Activation Map
7 × 7
처럼 될 수 있음.
근데 Activation Map을 Input Mask로 사용하려면 두 크기가 같아야 함.
따라서
를 수행해서 Input 크기로 확대함.
7 × 7 Activation Map
↓
Upsampling
↓
224 × 224 Mask
이렇게 만들어진 Activation Map은
해당 Channel이 Input Image의 어느 영역에 반응했는지 나타내는 Mask 역할을 할 수 있음.
RISE와 비슷해 보이는데...
이 부분은 앞에서 살펴본 RISE와 상당히 비슷해 보임.
RISE도
Mask 생성
↓
Input × Mask
↓
Forward Pass
↓
Target Score 측정
방식을 사용했음.
하지만 Mask를 만드는 방법에 중요한 차이가 있음.
RISE
Random Binary Mask 생성
↓
Upsampling + Random Shift
↓
Input에 적용
↓
수많은 Random Mask의 결과를 종합
RISE에서는 Monte Carlo Sampling을 써서 Random Mask를 직접 생성함.
반면
Score-CAM은
CNN 내부 Activation Map
↓
Upsampling
↓
Normalization
↓
Input Mask로 사용
Score-CAM은 별도의 Random Mask를 만들지 않고
CNN이 이미 추출한 Activation Map 자체를 Mask로 활용하는 구나.
Smoothing with Normalization
단순한 Increase of Confidence에서는 관심 Feature를 선택하기 위해 Binary Mask를 사용할 수 있음.
ex.
관심 영역→1나머지 영역→0
처럼 만드는 것.
다만 Score-CAM에서는
하나의 Pixel보다 특정 Image Region을 설명하려고 하기 때문에
Binary Mask가 적절하지 않을 수 있다고 설명함.
그래서 Activation Map의 값을 범위로 Normalize함.
따라서 Activation 값은
작은 Activation→0에 가까운 값큰 Activation→1에 가까운 값
으로 변환됨.
=> 딱 잘라 영역을 제거하는 Binary Mask 대신
Smooth Mask를 만들 수 있음.
Score-CAM 전체 과정
이제 각 Activation Map의 CIC Score를 이용해 최종 Score-CAM을 생성함.
Score-CAM은 다음과 같이 정의됨.
형태 자체는 CAM이나 Grad-CAM과 매우 비슷.
차이는 Weight 를 어떻게 구하느냐에 있음.
Score-CAM에서는
로 정의함.
Activation Map으로 Masking한 Input을 실제 Model에 넣었을 때
Target Class Score가 얼마나 증가했는지를 해당 Activation Map의 Weight로 사용함.
Grad-CAM에서는
Score-CAM에서는
가 됨.
좀 쉽게 말하자면
Grad-CAM: Gradient를 보니까 이 Channel이 중요할 것 같구만Score-CAM: 그럼 이 Channel이 보는 영역을 실제로 Model에 넣어보자.
오 Target Score 많이 올라간다.
이거 진짜 중요한 Channel이었네...방식의 접근...
Algorithm 1
논문의 실제 Score-CAM Algorithm을 순서대로 보면 다음과 같음.
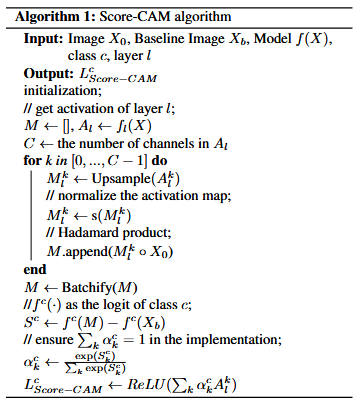
Step 1. Activation Map 추출
선택한 Convolutional Layer 에서 Activation Map을 얻음.
Input X
↓
CNN Forward
↓
선택한 Conv Layer
↓
Aₗ¹, Aₗ², Aₗ³, ... , Aₗᶜ
Step 2. 각 Activation Map Upsampling
각 Channel의 Activation Map을 Input 크기로 확대함.
Step 3. Normalize
Activation Map을 범위로 변환함.
Step 4. Input Masking
Mask와 Original Input을 Element-wise Multiplication함.
따라서 Channel마다 하나의 Masked Image가 만들어짐.
Channel 1 → Masked Image 1

Channel 2 → Masked Image 2

Channel 3 → Masked Image 3

...

Channel C → Masked Image C
Step 5. Forward Pass
생성된 Masked Images를 Model에 입력함.
Masked Image 1 ─┐
Masked Image 2 ─┤
Masked Image 3 ─┤
...             ├→ Model → Target Class Scores
Masked Image C ─┘
각 Activation Map에 대응되는 Target Class Score를 얻음.
Step 6. Baseline과 비교
논문의 CIC 정의에서는
형태로 Baseline Score를 빼줌.
"Masked Input의 Target Score - Baseline Input의 Target Score"를 계산하는 것.
Step 7. Weight Normalization
실제 Algorithm에서는 각 Channel의 Score에 Softmax를 적용해서 Weight를 정규화함.
따라서
이 되도록 만듦.
Step 8. Activation Map 가중합
마지막으로 계산된 Weight와 원래 Activation Map을 가중합함.
여기서 ReLU를 사용하는 이유
: Target Class에 Positive Influence를 주는 Feature에만 관심이 있기 때문.
(Grad-CAM과 동일)
전체 Pipeline
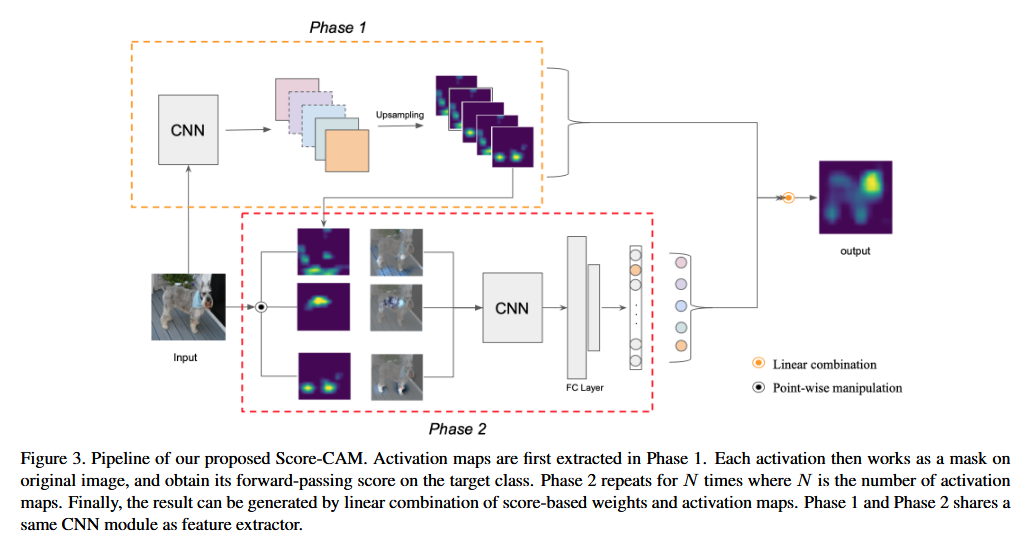
결국 Score-CAM 전체 과정은 다음처럼 정리할 수 있음.
Input Image
    │
    ▼
CNN Forward Pass
    │
    ▼
Activation Maps
Aₗ¹, Aₗ², ..., Aₗᶜ
    │
    ▼
각 Activation Map Upsampling
    │
    ▼
[0, 1] Normalization
    │
    ▼
Input × Activation Map
    │
    ▼
Masked Images 생성
    │
    ▼
각 Masked Image Forward Pass
    │
    ▼
Target Class Score 측정
    │
    ▼
각 Activation Map의 Weight αₖᶜ 계산
    │
    ▼
Weighted Sum
    │
    ▼
ReLU
    │
    ▼
Score-CAM
3.2. Normalization on Score
여기서 어떤 Score를 Weight 계산에 사용할 것인가도 다룸.
Neural Network의 Raw Output인 Pre-softmax Logit
: Forward Pass마다 값의 범위가 일정하지 않음.
[Pre-softmax]

Class A → 12.3
Class B → 4.2
Class C → -1.7
처럼 절대적인 크기의 범위가 정해져 있지 않음.
=> 서로 다른 Forward Pass의 Relevance를 비교할 때 Raw Logit을 그대로 사용하는 것보다
Softmax를 적용한 상대적인 Output 값을 사용하는 게[ 적절하다고 설명.
Logit

↓

Softmax

↓

Probability

↓

고정된 범위에서 비교
그래서 Score-CAM에서는 이러한 이유로 Post-softmax Score를 Weight로 사용함.
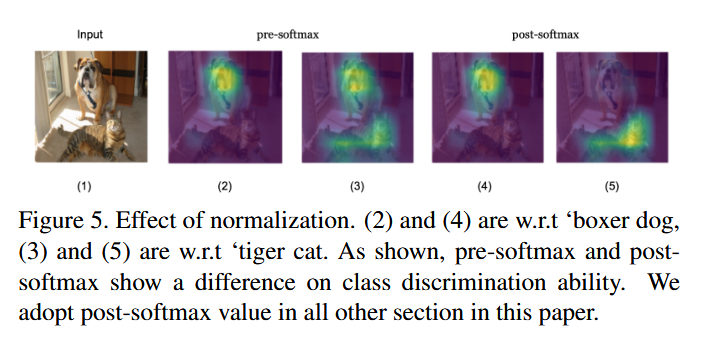
논문에서는 Softmax 적용 여부가 실제 Class Discrimination에 영향을 준다는 것도 실험함.
하나의 Image에
Dog와 Cat이 같이 존재하는 상황에서
Model은 해당 Image를 dog으로 예측함.
Target Class를 dog으로 설정하면
- Pre-softmax Score-CAM
- Post-softmax Score-CAM
모두 Dog 영역을 잘 Highlight함.
하지만 Target Class를 cat으로 설정했을 때 차이가 발생함.
Pre-softmax
Target = Cat
↓
Dog + Cat 영역을 모두 Highlight
Post-softmax
Target = Cat
↓
Cat 영역을 더 잘 구분해서 Highlight
Softmax를 적용한 Score가 서로 다른 Class를 구분하는 Class Discrimination Ability를 개선했다고 설명함.
=> 논문의 나머지 실험에서는 Post-softmax Score를 사용함.
그래서 Score-CAM의 가장 Key Point
: Weight를 계산하는 방법
CAM 계열을 비교하면
| Method | Activation Map Weight |
|---|---|
| CAM | FC Layer의 Weight |
| Grad-CAM | Gradient의 Global Average Pooling |
| Grad-CAM++ | Positive Gradient 기반 개선된 Weight |
| Score-CAM | Masked Input의 Forward Score |
Score-CAM도 최종적으로는
라는 CAM 구조를 유지는 하지만
Gradient로 중요도를 추정하지 않고, Activation Map이 나타내는 영역을 실제로 Model에 넣어 Target Class Score를 직접 확인한다는 점이 주요한 차이임.
정리해 보자면
- Score-CAM은 Gradient-free CAM 방식임.
- Activation Map의 중요도를 Gradient가 아닌 Increase of Confidence로 측정함.
- 각 Activation Map을 Input 크기로 Upsampling하고 로 Normalize해서 Mask로 사용함.
- 해당 Mask를 Original Input에 적용한 뒤 다시 Forward Pass함.
- 이때 Target Class Score의 변화를 이용해 Activation Map의 Weight를 결정함.
- 따라서 RISE처럼 Perturbation + Forward Score 개념을 사용하지만, Random Mask가 아닌 CNN 내부 Activation Map을 Mask로 사용한다는 차이가 있음.
- 최종적으로 Weight가 적용된 Activation Map들을 가중합하고 ReLU를 적용해서 Score-CAM을 생성함.
- 논문에서는 Pre-softmax Logit보다 Post-softmax Score가 Class Discrimination에 유리하다고 보고 이후 실험에서 Post-softmax 값을 사용함.
- 한 문장으로 요약하자믄, Gradient로 중요하다고 추정하지 말고, 해당 영역을 실제로 보여준 뒤 Model의 Score가 어떻게 변하는지 직접 확인하자
✅4. Experiments
Score-CAM이 실제로 좋은 설명 방법인지 여러 관점에서 검증해 보았음.
- 시각적으로 설명이 잘 되는지
- 실제로 중요한 영역을 찾는지
- 객체 위치도 잘 찾는지
- 설명 방법 자체가 모델에 의존하는지
- 실제 디버깅에도 사용할 수 있는지
를 순서대로 평가함.
실험 환경
- 실험에서는 PyTorch Model Zoo에서 제공하는 Pre-trained VGG16을 Base Model로 사용.
- Dataset은 ILSVRC2012 Validation Set
=ImageNet Classification Validation Dataset을 이용해 Score-CAM을 평가함.
Input Pre-processing
입력 이미지는 먼저 224X224X3 크기로 Resize함.
그 다음 Pixel 값을 범위로 변환함.
이후 ImageNet에서 일반적으로 사용하는 Mean과 Standard Deviation을 이용해 Normalize함.
- Mean은 이고,
- Standard Deviation은 .
각 RGB Channel에 대해
를 적용한다고 보면 됨.
Original Image

↓

Resize
224 × 224 × 3

↓

Pixel Scaling
[0, 255] → [0, 1]

↓

ImageNet Normalization

Mean
[0.485, 0.456, 0.406]

Std
[0.229, 0.224, 0.225]

↓

VGG16 Input
이외에는 추가적인 Pre-processing을 수행하지 않음.
왜 이렇게 실험을 여러 개 하냐면
XAI에서는 단순히 Heatmap이 사람 눈에 그럴듯하게 보인다고 해서 좋은 Explanation이라고 할 수 없으니까.
=> 논문에서는 시각적 비교 + @ 로, 여러 평가 방법을 사용함.
4.1. Qualitative Evaluation via Visualization
먼저 저자들은 Score-CAM이 생성한 Saliency Map을 기존 XAI 방법들과 시각적으로 비교함.
비교 대상에는 총 8개의 SOTA 방법 포함.
- Gradient-based Method
- Perturbation-based Method
- CAM-based Method
로 구성됨.
이 실험에서 확인하려는 것은 크게 두 가지.
1. Saliency Map이 얼마나 Noise 없이 명확하게 객체의 중요한 영역을 보여주는지
2. Target Class가 달라졌을 때 해당 Class에 맞는 영역을 구분해서 보여주는지
4.1.1. Class Discriminative Visualization
먼저 Fig. 4에서는 여러 XAI 방법이 생성한 Saliency Map을 시각적으로 비교함.
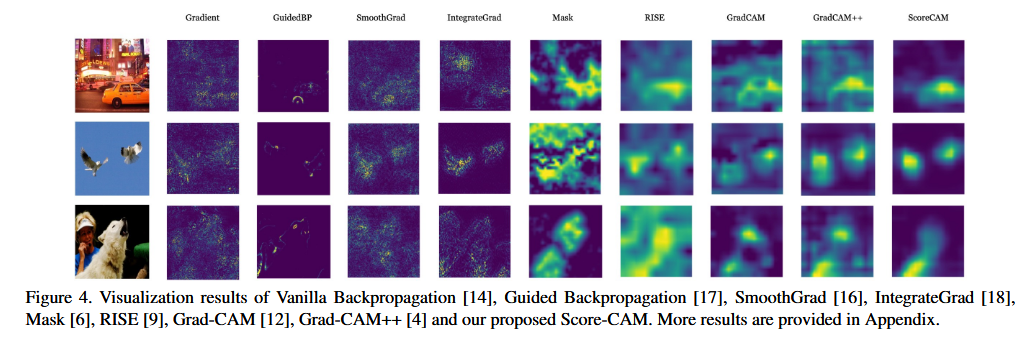
논문의 결과에 따르면 Score-CAM은
- Mask
- RISE
- Grad-CAM
- Grad-CAM++
등과 비교했을 때
Random Noise가 더 적은 Saliency Map을 생성함.
또한 Gradient-based Method와 비교했을 때도 더 Smooth한 결과를 생성한다고 설명함.
특히 Score-CAM은 Gradient를 사용하지 않기 때문에
앞에서 언급했던 Noisy Gradient의 영향을 직접적으로 받지 않음.
Class Discriminative
Heatmap이 깔끔한 것만 중요한 게 아니라,
Score-CAM은 Class Discriminative Ability도 가져야 함.
Class Discriminative
: 같은 이미지라도 어떤 Class를 설명하느냐에 따라 서로 다른 영역을 Highlight할 수 있는 능력
ex. 한 이미지 안에
Dog              Cat

🐶               🐱
이 같이 존재한다고 하자.
Target Class가 dog이면
███
🐶               🐱
Dog 영역을 설명해야 하고,
Target Class가 cat이면
                 ███
🐶               🐱
Cat 영역을 설명해야 함.
그리고 모델이 이 Class를 판단할 때 어떤 영역을 근거로 사용했는지를 구분해야 한다는 것.
그리고 Fig. 6에서 확인해봄.
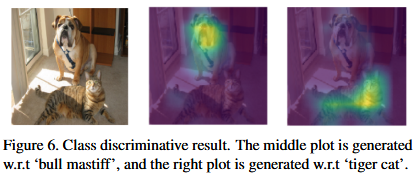
VGG16이 하나의 Input Image에 대해
bull mastiff: 49.6%tiger cat: 0.2%
의 Confidence를 출력함.
=> 모델은 해당 이미지를 bull mastiff라고 상당히 강하게 판단하고 있고,
tiger cat에 대한 Confidence는 매우 낮음.
Score-CAM을 각각의 Class에 대해 생성하면
Target = bull mastiff
        ↓
Dog 영역 Highlight


Target = tiger cat
        ↓
Cat 영역 Highlight
처럼 각 Target Class에 대응하는 위치를 각각 찾아낼 수 있었음.
중요한 건 tiger cat의 Prediction Probability가 겨우 0.2%였는데,
그럼에도 불구하고 Target Class를 tiger cat으로 지정하면 Cat과 관련된 영역을 설명할 수 있었음.
왜 Score-CAM은 Class Discrimination이 가능한 것인가
Score-CAM에서 각 Activation Map의 Weight는 Target Class 에 대한 Score를 이용해서 계산함.
Activation Map Aₗᵏ
        ↓
Mask 생성
        ↓
Input에 적용
        ↓
Forward Pass
        ↓
Target Class c의 Score 확인
        ↓
αₖᶜ 결정
이므로
Target Class가 바뀌면 같은 Activation Map이라도 Weight가 달라질 수 있음.
ex.
                    Dog Target    Cat Target

A¹ : Dog 얼굴          높음           낮음
A² : Cat 얼굴          낮음           높음
A³ : Background        낮음           낮음
처럼 될 수 있음.
따라서 최종적으로
에서 가 달라지면 가 달라지고, 결과적으로 다른 영역이 Highlight됨.
이게 Score-CAM의 Class Discriminative Ability.
정리해 보자면
- Score-CAM은 기존 방법보다 상대적으로 Noise가 적고 Smooth한 Saliency Map을 생성함.
- 단순히 Object 위치를 찾는 것이 아니라 Target Class에 따라 다른 영역을 Highlight할 수 있는 것.
- Fig. 6에서
bull mastiff는 49.6%,tiger cat은 0.2%의 Confidence였지만 두 Class에 대한 영역을 각각 구분해서 설명할 수 있었음.
(각 Activation Map의 Weight가 Target Class Score와 직접 연결되어 있기 때문)
4.1.2. Multi-Target Visualization
다음으로 저자들은 하나의 Image 안에 같은 Class의 Object가 여러 개 존재하는 상황을 평가함.
ex.
Dog        Dog        Dog

🐶         🐶         🐶
처럼 동일한 Class 객체가 여러 개 존재한다고 생각하면 됨.
좋은 Explanation Method라면 Dog 하나만 찾는 게 아니라,
Target Class에 해당하는 여러 Object를 모두 Highlight할 수 있어야 함.
Fig.7에서는 Grad-CAM, Grad-CAM++, Score-CAM의 Multi-object Localization 성능을 비교함.
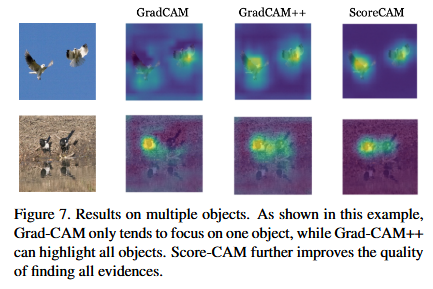
결과적으로
- Grad-CAM: 하나의 Object에 집중하는 경향 O
- Grad-CAM++: 여러 Object를 찾을 수 있음
- Score-CAM: 여러 Object를 찾으면서 더 집중된 Saliency Map 생성 가능
그렇다면 Score-CAM은 왜, 어떻게 여러 객체를 찾을 수 있는 것인가
Score-CAM에서는 각 Activation Map의 중요도를 Target Class Score를 이용해 결정함.
따라서 동일 Target Class와 관련된 여러 영역이 존재한다면 각 영역에 반응하는 Activation Map들이 모두 높은 Response를 받을 수 있음.
ex.
A¹ → 왼쪽 Dog에 반응
A² → 가운데 Dog에 반응
A³ → 오른쪽 Dog에 반응
이라고 하면
각 Activation Map으로 Masking한 Input이 모두 dog Score를 높인다면,
A¹ → 높은 α₁
A² → 높은 α₂
A³ → 높은 α₃
를 받을 수 있음.
그러면 최종적으로
가 합쳐지면서 여러 Dog 영역이 하나의 Saliency Map에 나타나게 됨.
논문 표현대로
Target Class와 관련된 모든 Evidence가 Response를 얻고,
Linear Combination을 통해 결합되는 것임.
정리해 보자면
- Score-CAM은 하나의 객체뿐만 아니라 동일 Class의 여러 객체를 동시에 Highlight할 수 있음.
- Score-CAM과 달리 Grad-CAM은 여러 객체 중 하나에 집중하는 경향이 나타남.
- Grad-CAM++과 Score-CAM은 모두 Multi-object Localization이 가능함.
- 하지만 논문의 정성적 비교에서는 Score-CAM의 Saliency Map이 Grad-CAM++보다 더 Focused하게 나타남.
(이는 Target Class와 관련된 여러 Activation Map이 각각 높은 Score를 받을 수 있고, 이들이 최종적으로 가중합되기 때문.)
4.2. Faithfulness Evaluation via Image Recognition
4.1에서는 결과를 사람의 눈으로 비교했음.
그런데 이게 문제가 있음.
사람이 평가한다는 것은 결국 사람의 주관이 개입된 정성적인 평가라는 것임.
그래서 4.2에서는 훨씬 중요한 질문을 던짐.
Score-CAM이 중요하다고 Highlight한 영역이 실제 CNN의 Prediction에도 정말 중요한가?
그리고 이거를 논문에서는 Faithfulness 관점에서 평가함.
Faithfulness란?
XAI에서 Faithfulness
: 설명 결과가 실제 모델의 판단 과정을 얼마나 충실하게 반영하는가
ex. Score-CAM이 자동차 이미지에서
앞 범퍼를 매우 중요한 포인트로 잡았다고 하면,
실제로 앞 범퍼 영역만 Model에 보여줬을 때 자동차 Class Score가 어느 정도 유지되어야 함.
반대로 아무 상관없는 영역을 중요하다고 표시했다면 해당 영역만 보여줬을 때 Score가 크게 떨어질 것임.
따라서
Explanation이 중요하다고 한 영역
          ↓
그 영역을 실제 Input으로 사용
          ↓
Model Prediction 확인
          ↓
Score가 잘 유지됨
          ↓
Faithful Explanation
이라고 판단할 수 있음.
Saliency Map으로 Input Masking
논문에서는 Original Input에 Saliency Map을 Point-wise Multiplication함.
개념적으로는
형태.
Original Image
      ×
Saliency Map
      ↓
중요 영역이 남은 Input
      ↓
CNN
      ↓
Target Class Score
그리고 이 Target Class Score가 Original Image의 Score와 얼마나 달라지는지를 확인함.
논문에서는 원래 생성된 Saliency Map을 그대로 곱하지 않고 약간 수정함.
Image Pixel 중 50%를 Muting함.
Saliency Map을 기준으로 상대적으로 덜 중요한 Pixel들을 제거해서 중요 영역의 영향력을 확인함.
설명 방법이 중요하다고 판단한 영역을 제한적으로 남겼을 때도 Prediction을 얼마나 잘 유지하는가?를 보는 게 중요
i) Average Drop
첫 번째 평가 지표는 Average Drop.
- : 평가 Image 수
- : Original Image에서 Class 의 Prediction Score
- : Explanation 영역을 Input으로 사용했을 때 Class 의 Prediction Score
ex.
Original Image에서 이었는데,
Score-CAM이 중요하다고 한 영역만 남기니까 이 됐을 때,
Drop은 임.
원본 Confidence
80%

↓

중요 영역만 남김

↓

Confidence
60%

↓

25% Drop
이 발생한 것.
Average Drop은 낮을수록 좋음
좋은 Explanation이라면 정말 중요한 영역을 남겼기 때문에 Original Prediction Score가 크게 떨어지지 않아야 하는 것.
그러니,
Average Drop ↓
=
중요 영역만 남겨도
Prediction이 잘 유지됨
=
좋은 Explanation
으로 해석 가능
ii) Increase in Confidence
두 번째 지표는 Increase in Confidence(Average Increase)
(여기서 Sign은 조건이 참이면 1, 아니면 0을 반환하는 Indicator Function.)
(인지 확인하는 것.)
Explanation 영역만 보여줬더니 오히려 Original Image보다 Target Class Confidence가 증가했는지를 측정하는 것.
[Original Image]
Dog Score = 70%
↓
[중요 영역만 남겼을 때]
Dog Score = 85%
↓
Increase!
가 되는 경우.
왜 이런 일이 가능하냐면
Original Image에는
Target Class와 무관하거나 방해가 되는 Background가 포함되어 있을 수 있기 때문임.
Explanation이 정말 핵심적인 영역을 잘 찾았다면
불필요한 영역을 제거한 후 오히려 Target Score가 증가할 수도 있음.
Average Increase는 높을수록 좋음
Average Increase ↑
=
설명 영역만 사용했을 때
Confidence가 증가하는 Image가 많음
=
좋은 Explanation
으로 해석 가능
실험 Dataset
이 실험에서는 ImageNet ILSVRC2012 Validation Set에서 2,000장의 Image를 Random Sampling해서 평가함.
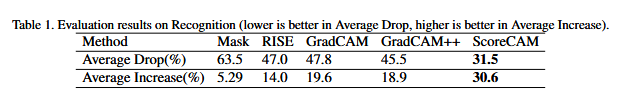
Score-CAM은 기존 Perturbation-based 및 CAM-based Method보다 두 지표에서 좋은 성능을 보였음.
그리고 여기서는 Gradient-based Method는 Visual Property가 다르기 때문에 비교하지 않았다고 힘.
이 결과가 중요한 이유는 Score-CAM이 단순히 사람이 봤을 때 중요해 보이는 Object 영역을 찾는 게 아니라
실제로 CNN이 Classification에 사용하고 있는 Discriminative Region을 찾고 있다는 근거가 되기 때문임.
iii) Deletion & Insertion
저자들은 RISE 논문에서 제안한 Deletion / Insertion Metric도 사용함.
(앞에서 RISE 구현하면서 직접 해봤던 평가 방식과 같은 아이디어.)
논문에서는 Pixel을 한 번에 전체 Image의 1%씩 제거하거나 추가함.
Step Size는 0.01
0%
↓
1%
↓
2%
↓
3%
↓
...
↓
100%
순으로 진행.
논문에서는 제거 또는 추가할 Pixel 값을 각각 0 또는 1로 설정하는 방식을 사용했다고 설명함.
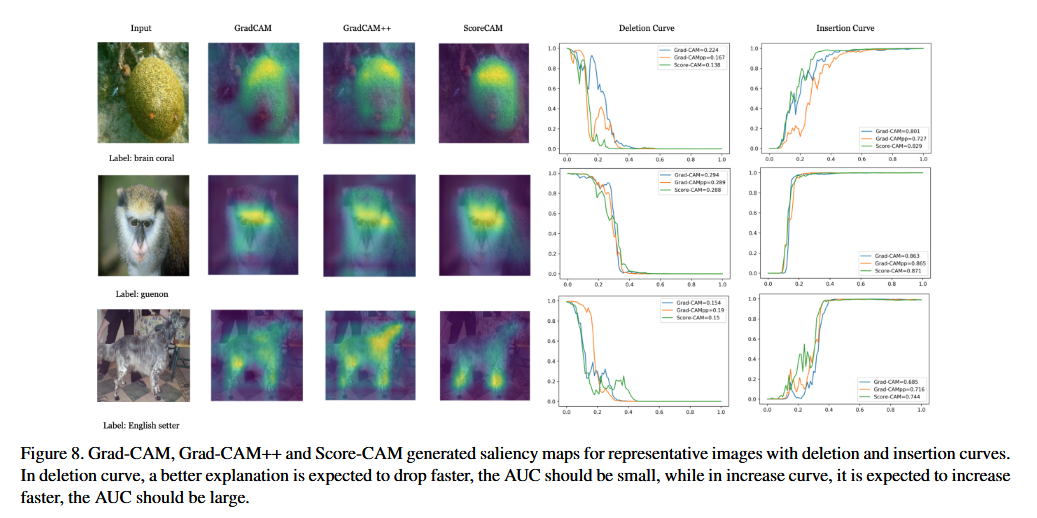
Fig. 8에서,
이렇게 실제 진행했음을 확인할 수 있고,
ImageNet에서 Random Sampling한 2,000장의 평균 결과를 하단 Table 3에서 확인할 수 있음.
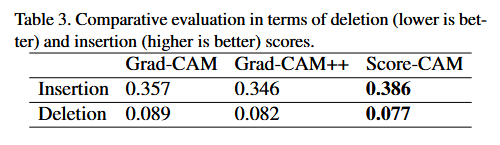
Score-CAM은 Gradient-based CAM Method들과 비교했을 때 Deletion과 Insertion 모두에서 더 좋은 결과를 보였음을 확인 가능.
Average Drop/Increase와 Deletion/Insertion 차이
각 차이를 이해하는 게 중요한데,
i) Average Drop / Increase
특정 Explanation 영역을 남긴 결과를 기준으로 평가함.
Original
   ↓
중요 영역만 남김
   ↓
Prediction 비교
상대적으로 한 번의 결과를 비교하는 방식.
ii) Deletion / Insertion
Pixel을 중요도 순서대로 조금씩 제거하거나 추가하면서
Prediction 변화 전체를 Curve로 측정함.
0%
↓
1%
↓
2%
↓
...
↓
100%

Prediction 변화 전체 측정
=> Saliency Ranking 자체가 얼마나 올바른지를 좀 더 세밀하게 평가할 수 있음.
| Metric | 좋은 Explanation |
|---|---|
| Average Drop | 낮을수록 좋음 ↓ |
| Average Increase | 높을수록 좋음 ↑ |
| Deletion AUC | 낮을수록 좋음 ↓ |
| Insertion AUC | 높을수록 좋음 ↑ |
4.3. Localization Evaluation
앞에서(4.2)는
Score-CAM이 중요하다고 표시한 영역이 실제 Classification Score에 영향을 주는지를 평가했음.
이번에는
Score-CAM이 중요하다고 표시한 영역이 실제 Target Object의 위치와 얼마나 잘 일치하는지,
Localization Ability를 정량적으로 평가함.
Pointing Game
기존 XAI 연구에서는 Saliency Map의 Localization 성능을 평가하기 위해 Pointing Game이라는 방법을 사용함.
Saliency Map에서 가장 값이 큰 위치
를 하나 찾음.
그리고 이 점이 Ground Truth Bounding Box 안에 들어가는지 확인함.
Ground Truth Bounding Box
┌─────────────────────────┐
│                       │
│         Object        │
│           ★          │
│                       │
└─────────────────────────┘

★ = Saliency가 가장 높은 Pixel

→ Bounding Box 내부
→ 성공
반대로
             ★  ← Max Saliency

┌─────────────────────────┐
│                       │
│         Object        │
│                       │
└─────────────────────────┘

→ Bounding Box 외부
→ 실패
로 판단한다는 것.
Pointing Game 한계
문제는 Saliency Map 전체에서 딱 한 점만 본다는 것.
예를 들어 다음 두 Saliency Map을 생각해보면,
[Method A]

Bounding Box
┌──────────────────┐
│ ████████████████ │
│ ████████████████ │
│ ████████████████ │
└──────────────────┘

→ 대부분의 Saliency가 객체 내부


[Method B]

Bounding Box
┌──────────────────┐
│        ★       │
│                 │
└──────────────────┘

░░░░░░░░░░░░░░░░░░
↑ 실제 Saliency 대부분은 배경
Method B에서도 우연히 가장 높은 Pixel 하나만 Bounding Box 안에 있으면 Pointing Game에서는 성공한 걸로 평가되는 것.
하지만 실제 Explanation Quality는 A가 훨씬 좋아 보임.
그래서 Score-CAM 논문에서는
최댓값 하나만 보지 말고, Saliency 전체가 얼마나 Object 영역 안에 집중되어 있는지를 보자고 제안함.그리고 그걸 논문에서는 Energy-based Pointing Game이라고 부름.
Energy-based Pointing Game
Energy-based Pointing Game을 통해서 알고 싶은 건
Saliency Map 전체 Energy 중 몇 %가 Ground Truth Bounding Box 내부에 존재하는지임.
먼저 Ground Truth Bounding Box를 이용해서 Binary Mask를 생성함.
[Ground Truth]

┌────────────────────┐
│          0       │
│    ┌──────────┐   │
│    │  Object │   │
│    │    1    │   │
│    └──────────┘   │
│          0       │
└────────────────────┘
Bounding Box 내부는 1
외부는 0으로 설정함.
그 다음 Saliency Map과 Bounding Box Mask를 곱함
그 후 이 Binary Mask와 Saliency Map을 Point-wise Multiplication함.
Saliency Map
      ×
Bounding Box Mask
      ↓
Bounding Box 내부의 Saliency만 남음
따라서 Target Object 내부에 존재하는 Saliency Energy를 계산할 수 있음.
논문에서는 다음 Metric을 사용함.
분모는 사실상 Saliency Map 전체 Energy.
=> 더 직관적으로 쓰면
Ex. 전체 Saliency Energy가 100
그중 Ground Truth Bounding Box 안에 들어간 Energy가 70이라면
이라서 70%가 됨.
전체 Saliency = 100

┌─────────────────────┐
│                   │
│   ┌─────────────┐  │
│   │█████████████│  │
│   │█████████████│ ← 70
│   └─────────────┘  │
│  ░░░              │ ← 30
└─────────────────────┘

Object 내부 = 70
Object 외부 = 30

Proportion = 70%
높을수록 좋은 Localization이 되는 것.
기존 Pointing Game과 차이가 뭔지 정리하자면,
| Pointing Game | Energy-based Pointing Game |
|---|---|
| 가장 높은 Pixel 하나만 확인 | Saliency Map 전체를 확인 |
| Max Point가 Box 내부인지 평가 | 전체 Saliency 중 Box 내부 비율 측정 |
| Hit / Miss 형태 | 연속적인 비율로 평가 |
| Saliency 전체 Noise를 충분히 반영하지 못함 | 배경 Noise까지 평가에 반영 |
기존과 달리 Energy-based 방식은
제일 중요한 점 하나를 맞혔는지가 아니라,
중요하다고 했던 것들이 진짜로, 실제로 객체 안에 얼마나 집중되어 있는 건지를 보는 것
Image도 선별적으로
논문에서는 Dataset도 따로 Filtering함.
ILSVRC Validation Set을 확인해보니 Object가 Image 대부분을 차지하는 경우가 많았음.
예를 들어 Object Bounding Box가 Image의 90%를 차지한다고 해보ㅕ면 하단과 같은 양상인데,
┌─────────────────────────┐
│ ┌─────────────────────┐ │
│ │                   │ │
│ │       Object      │ │
│ │                   │ │
│ └─────────────────────┘ │
└─────────────────────────┘
이런 Image에서는 Saliency가 대충 어디에 생겨도 Bounding Box 안에 들어갈 가능성이 높음.
그러면 Localization 성능을 제대로 비교하기 어렵게 될 것임.
그래서 논문에서는
★ Object가 전체 Image의 50% 이상을 차지하는 Image를 제외함.
추가적으로 편의를 위해 Target Class에 Bounding Box가 하나만 존재하는 Image만 사용함.
그리고 최종적으로 ILSVRC2012 Validation Set에서 500장의 Image를 Random Sampling하여 평가함.
Localization 결과
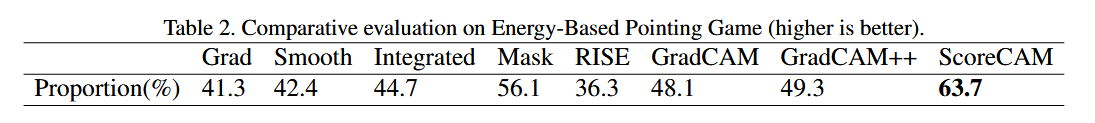
Score-CAM은 기존 방법보다 높은 성능을 기록함.
특히 Score-CAM Saliency Map Energy의
60% 이상이 Ground Truth Object Bounding Box 내부에 존재했다고 보고함.
그리고 이게 앞의 Qualitative Evaluation에서 주장했던
Score-CAM의 Saliency Map에는 Noise가 상대적으로 적다는 결과를 뒷받침한다고 봄.
배경에 Noise가 많았다면 Bounding Box 밖의 Energy가 증가해서 이 지표가 낮아졌을 것이기 때문.
Guided BackProp은 비교하지 않았는데?
논문에서는 Guided BackPropagation은 비교 대상에서 제외함.
왜냐하면 Guided BackProp의 결과가 일반적인 Heatmap이라기보다는
Edge Detector와 유사한 형태로 나타나기 때문이라고 설명함.
따라서 Energy 기반 Saliency Localization Metric으로 직접 비교하기 적절하지 않다고 판단했음.
Bounding Box 평가 한계
저자들도 이 평가 방법이 완벽하지 않다는 점을 인정함.
Bounding Box는 실제 Object의 정확한 모양을 표현하지 못함.
Bounding Box

┌─────────────────────┐
│                   │
│       🐶          │
│                   │
└─────────────────────┘

Box 내부에는
Object가 아닌 Background도 포함됨
따라서 실제로는 Segmentation Label을 사용하는 것이 더 정확하다고 설명함.
논문에서는 이를 Future Work로 남김.
정리해 보자면
- 기존 Pointing Game은 Saliency Map에서 가장 높은 Pixel 하나가 Bounding Box 내부에 있는지만 평가함.
- Score-CAM 논문에서는 이걸 확장해서 Energy-based Pointing Game을 사용함.
- 전체 Saliency Energy 중 Ground Truth Bounding Box 내부에 존재하는 비율을 측정함.
- 높을수록 Target Object에 Saliency가 잘 집중되어 있다는 의미.
- 공정한 평가를 위해 Object가 Image의 50% 이상을 차지하는 Image는 제외했음.
- Target Class Bounding Box가 하나인 Image만 고려하고, 총 500장을 Random Sampling함.
- Score-CAM은 Saliency Energy의 60% 이상을 Ground Truth Bounding Box 내부에 집중시켰다고 보고함.
- 저자들은 이를 Score-CAM이 상대적으로 Noise가 적다는 추가적인 근거로 해석함.
- 다만 Bounding Box에는 Background도 포함될 수 있으므로 저자들은 Segmentation Label 기반 평가가 더 정확할 것이라고 인정O.
4.4. Sanity Check
앞의 실험들은 Score-CAM이
- 객체를 잘 찾고
- Prediction에 중요한 영역을 찾고
- Noise도 적다는 것을 보여줬음.
그런데 이 Saliency Map이 정말 CNN이 학습한 내용을 설명하는 게 맞을까?
왜냐하면 Heatmap이 아무리 그럴듯해도
Model Parameter와 상관없이 비슷한 결과가 나온다면 모델의 판단을 설명한다고 볼 수 없기 때문임.
왜 Sanity Check가 필요하냐면,
논문에서 인용한 연구에서는 Visual Assessment만으로 Saliency Method를 평가하면 오해할 수 있다고 지적했음.
일부 Saliency Method는 Model이나 Data-generating Process와 거의 무관하게 비슷한 Visualization을 생성할 수 있다는 것.
ex.
잘 학습된 CNN

↓

🐶 얼굴 Highlight
가 나왔다고 할 때,
사람이 보면 모델이 강아지 얼굴을 보고 판단했다고 생각함.
근ㄷ- CNN의 Parameter를 Random하게 초기화했는데도
Random CNN

↓

🐶 얼굴 Highlight
가 거의 동일하게 나온다면?
이건 문제가 있는 것.
Random Network는 강아지를 학습한 적이 없는데도
같은 Explanation이 나온 것이기 때문임.
따라서 이 Explanation은 CNN의 학습된 판단 근거보다
Image 자체의 Edge나 Texture 같은 특성을 보여주고 있을 가능성이 있음.
Model Parameter Randomization Test
논문에서는 Model Parameter Randomization Test를 사용함.
비교 대상은
1. Trained Model

vs

2. 동일 Architecture의
   Randomly Initialized Untrained Model
(Architecture 자체는 똑같지만 Parameter가 다름. )
VGG16
│
├─ Trained Weights
│      ↓
│   Score-CAM A
│
└─ Random Weights
       ↓
    Score-CAM B
좋은 Explanation Method라면 두 결과가 달라져야 함.
왜냐하면 모델이 학습한 Feature Representation 자체가 달라졌기 때문임.
결과
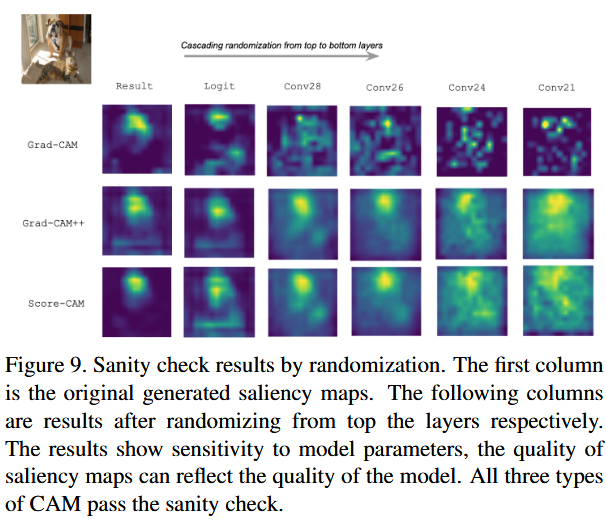
Fig. 9에서 Score-CAM은 Grad-CAM과 Grad-CAM++처럼 Sanity Check를 통과함.
Model Parameter 변경
        ↓
Internal Feature 변경
        ↓
Score-CAM 결과도 변경
되는 모습을 보였다는 것.
따라서 Score-CAM의 Explanation이 Model Parameter에 Sensitive하다는 것을 확인함.
=> Score-CAM이 Input Image 자체의 구조만 보여주는 게 아니라
실제 Model의 학습 상태를 반영하고 있다는 근거가 됨.
정리해 보자면,
- Heatmap이 사람 눈에 그럴듯하다는 것만으로 좋은 XAI라고 할 수 없음.
- Explanation이 실제 Model을 설명한다면 Model Parameter가 바뀌었을 때 Explanation도 바뀌어야 함.
- 그리고 이를 확인하기 위해 Trained Model과 Randomly Initialized Model의 Score-CAM 결과를 비교함.
- Score-CAM은 Model Parameter 변화에 민감하게 반응했음.
- 따라서 Grad-CAM, Grad-CAM++과 마찬가지로 Model Parameter Randomization Sanity Check를 통과함.
4.5. Applications
마지막으로 저자들은 Score-CAM을 Visualization Tool뿐만 아니라
Model Analysis / Debugging Tool로 사용할 수 있다고 주장했음.
문제의식
: 기존 Visual Explanation 연구들은 Object를 얼마나 잘 Localization하는지에 너무 집중하고 있고,
정작 Model 자체를 분석하는 도구로서의 XAI 활용 가능성은 상대적으로 덜 다뤘다는 것.
Score-CAM은
-
모델이 어디를 봤는지도 알려주지만, -
모델이 왜 이상하게 판단했는지 -
모델이 제대로 학습되고 있는지 -
Dataset에 Bias가 존재하는지?를 분석하는 데도 활용할 수 있다고 설명함.
i) Model의 학습 상태 분석
Model의 Classification Performance가 좋지 않은 초기 상태에서도
Score-CAM이 어느 정도 Localization을 수행할 수 있었음.
하지만 Classification Performance가 개선될수록
[학습 초기]

Object ███░░
      ░░░░
  ░░      ░

→ Noise 많음


[학습 진행]

Object █████
       █████
        ░

→ Noise 감소


[성능 향상]

Object █████
       █████

→ 중요한 영역에 집중
되는 경향을 관찰함.
Classification Performance가 좋아질수록
Saliency Map의 Noise가 감소하고 중요한 영역에 집중된다는 것이에 저자들은 Saliency Map의 Noise가
Model의 Classification Performance에 대한 하나의 Hint가 될 수 있다고 주장함.
ii) Model Convergence 판단
한 단계 더 나아가서
Model을 계속 Training하면서 Score-CAM을 생성한다고 생각해보면,
Epoch 1
↓
Score-CAM A

Epoch 10
↓
Score-CAM B

Epoch 20
↓
Score-CAM C

Epoch 30
↓
Score-CAM C와 거의 동일
학습이 진행되면서 Saliency Map이 변화하다가 어느 순간부터 거의 변하지 않는다면,
Model이 Converge했을 가능성이 있다는 Hint로 사용할 수 있다고 제안함.
다만 논문에서는 이를 엄밀한 Convergence Criterion으로 제시하는 것이 아니라
Model 학습 상태를 분석하기 위한 Hint로 제안하는 수준.
iii) Wrong Prediction 분석
Score-CAM은 Model이 왜 잘못된 Prediction을 했는지 분석하는 데도 사용할 수 있음.
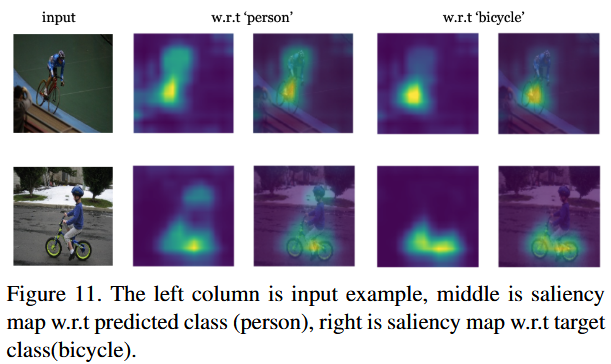
위 Fig. 11에서 실제 사례를 보여주는데,
Ground Truth Label은 bicycle인데
Model은 person으로 잘못 Classification함.
이에 저자들은 두 Target Class에 대해 각각 Score-CAM을 생성함.
Target = bicycle
        ↓
Score-CAM


Target = person
        ↓
Score-CAM
두 결과를 비교하면 Model이 왜 person으로 잘못 판단했는지 분석할 수 있음.
iv) Dataset Bias 분석
논문에서는 Fig. 11의 Misclassification 원인을 Training Dataset의 상관관계와 연결함.
Training Set의 많은 bicycle Image에는
Person과 Bicycle이 같이 등장함.
따라서 Model 입장에서는 학습 과정에서
Bicycle, Person이 자주 같이 등장하는 상관관계를 학습할 수 있음.
그 결과 Bicycle Image를 Classification할 때
실제 Bicycle 자체뿐만 아니라 Person 영역에도 강하게 의존하게 될 수 있다는 것...
Fig. 11에서는 person 영역이 Model을 방해하는 가장 큰 Distractive Region으로 나타났고,
결국 Model이 bicycle을 person으로 잘못 예측함.
=> Score-CAM을 통해
잘못된 Prediction 발견
        ↓
Target별 Score-CAM 비교
        ↓
Model이 의존한 영역 확인
        ↓
Training Dataset 확인
        ↓
Person과 Bicycle이 자주 함께 등장
        ↓
Dataset Bias / Spurious Correlation 발견
과 같은 분석이 가능하다는 것.
★ 그리고 이게 XAI의 실질적인 활용 목적과 연결됨.
Model Misclassification
        ↓
Explanation 생성
        ↓
잘못된 판단 근거 발견
        ↓
Dataset / Training 문제 분석
        ↓
Model 개선
으로 이어질 수 있기 때문임.
특히 자동차 같은 Safety-critical AI 관점에서도 이런 방향이 중요함.
예를 들어서 객체 인식 모델이 보행자 자체가 아니라 특정 배경이나 도로 환경에 과도하게 의존하고 있다면,
단순 Accuracy만으로는 그 문제를 발견하기 어려울 수 있다는 것.
Score-CAM과 같은 Explanation을 이용하면
모델이 실제로 어떤 Visual Evidence에 의존하고 있는지 분석하는 Debugging 관점으로 확장할 수 있음.
🔚5. Conclusion
본 논문에서는 기존 CAM 계열 방법의 한계를 개선하기 위해
새로운 Visual Explanation Method인 Score-CAM을 제안함.
Score-CAM의 가장 Main Idea는
Activation Map의 중요도를 계산할 때 Gradient를 사용하지 않는 것.
기존 Grad-CAM 계열에서는
Activation Map
      ↓
Gradient 계산
      ↓
Channel Importance αₖᶜ 계산
      ↓
Weighted Sum
방식을 사용했음.
하지만 앞에서 살펴봤듯 Gradient 기반 Weight에는
- Gradient Saturation
- Gradient Vanishing
- Noisy Gradient
- False Confidence
등의 문제가 발생할 수 있음.
특히 Gradient Weight가 높다고 해서
해당 Activation Map이 실제 Target Class Prediction에 크게 기여한다고 항상 볼 수 없다는 것
= Score-CAM 논문의 문제의식.
그래서 Score-CAM은
Score-CAM은 Gradient 대신 Increase in Confidence를 Activation Map의 Weight 설계에 사용함.
이 Activation Map이 나타내는 영역을 실제로 모델에게 보여줬을 때 Target Class Score가 얼마나 변하는지를 직접 측정함.
전체적인 흐름은 하단과 같음.
Input Image
      ↓
CNN Forward
      ↓
Activation Maps 추출
Aₗ¹, Aₗ², ..., Aₗᶜ
      ↓
각 Activation Map Upsampling
      ↓
[0, 1] Normalization
      ↓
Input에 Mask로 적용
      ↓
Masked Input 생성
      ↓
다시 Forward Pass
      ↓
Target Class Score 측정
      ↓
Activation Map Weight αₖᶜ 계산
      ↓
Activation Maps Weighted Sum
      ↓
ReLU
      ↓
Score-CAM
따라서 기존 Grad-CAM
:Gradient가 크니까 이 Activation Map이 중요할 것이라고 Gradient를 통해 중요도를 추정했다면,
Score-CAM
: 이 Activation Map이 보는 영역을 실제로 입력해보자.
Target Score가 높게 나오네?
=> 이 Activation Map은 중요하구나.
(이렇게 Forward Score를 이용해 중요도를 직접 평가하는 것)
★ Gradient-Free Visual Explanation
이런 구조 덕분에 Score-CAM은 Gradient에 대한 의존성을 제거해셔
를 계산할 필요가 없음.
대신 Activation Map 의 중요도를 해당 Activation Map으로 생성한 Masked Input의 Target Class Response를 이용해 결정함.
최종적인 Score-CAM의 형태는 기존 CAM 계열과 동일하게
의 Linear Combination 구조를 사용하지만,
를 어떻게 계산하는지가 기존 CAM 계열과 가장 큰 차이!!!
Score-CAM을 기존 CAM 계열과 비교하면
| Method | Channel Weight 계산 방법 | Gradient 필요 |
|---|---|---|
| CAM | FC Layer Weight | X |
| Grad-CAM | Gradient Global Average Pooling | O |
| Grad-CAM++ | Positive Gradient 기반 Weight | O |
| Score-CAM | Masked Input의 Target Class Score | X |
Score-CAM의 가장 Key Point
: 최종 CAM 생성 공식 자체라기보다는 Channel Weight를 정의하는 방식
Future Work
논문에서는 앞으로
다른 CAM Variant에서 사용되는 서로 다른 Weight Representation 사이의 관계를 탐구할 것이라고 설명함.
CAM 계열 방법들을 보면 최종적인 구조는 대부분
로 비슷함.
결국 가장 중요한 차이는
에 있음.
[CAM]
FC Weight
   │
   ▼
  αₖᶜ


[Grad-CAM]
Gradient
   │
   ▼
  αₖᶜ


[Grad-CAM++]
Positive Gradient
   │
   ▼
  αₖᶜ


[Score-CAM]
Forward Target Score
   │
   ▼
  αₖᶜ
따라서 저자들은 향후 이러한 서로 다른 Weight Representation들이 어떤 관계를 가지며, 어떤 방식이 Activation Map의 실제 중요도를 가장 잘 표현하는가를 탐구할 필요가 있다고 봄.
