Paper: CAM: Learning Deep Features for Discriminative Localization
🔍1. Introduction
최근 연구에서, CNN의 여러 Conv Layer에 존재하는 Convolution Units이
Object Location에 대한 어떠한 Location 정보를 받지 않았음에도,
실제로는 Object Detector처럼 동작한다는 사실을 밝힘.
= Classification에서 한 이미지에 대해 예를 들어 고양이라는 Class Label만 주고, Bounding Box 이런 거 전혀 알려주지 않았음에도,
CNN 내 마지막 Conv Layer의 Feature Map에서 고양이가 있는 위치만 강하게 활성화되고 있었다는 것.
물론, Convolution Layer에서는 뛰어난 Object Localization 능력이 나타나지만,
Classification을 위해 Fully Connected Layer를 사용하는 순간, 이런 위치 정보는 사라지게 됨.
즉, 마지막 Feature Map에 어디서 뭐가 발견되었는지 등의 정보가 다 들어 있는데,
FC Layer는 다 Flatten 시켜서 n차원 벡터로 만들어 버림.
이렇게 되면, Spatial Information(공간 정보)이 다 없어져 버림.
최근 Network In Network(NIN), GoogLeNet 같은 Fully Convolutional Network 구조가 제안되었고,
이런 모델들은 Fully Connected Layer를 제거해서,
파라미터 수를 줄이면서도 높은 성능을 유지하도록 설계됐음.
- NIN에서는
GAP(Global Average Pooling)를 사용했음.
-GAP: 네트워크 구조적인 정규화 진행해서, 학습 과정에서의 Overfitting 방지함.
추가적으로, GAP(Global Average Pooling)의 장점은 단순 과적합 감소뿐 아니라,
Localizaiton도 유지하고, Feature 해석도 가능하며, CAM 생성도 가능함.
즉, GAP이 생각보다 더 중요한 역할을 한다는 것임.
실제로 네트워크 구조를 살짝만 수정하면,
CNN은 Final Layer까지도 Object Localization을 그대로 잘 유지할 수 있음.
- 기존 CNN:
Conv>FC>Softmax - CAM:
Conv>GAP>Softmax
네트워크는 단 한 번의 Forward Pass만으로 다양한 작업에서 분류에 중요한 이미지 영역을 쉽게 찾아낼 수 있음.
(원래 해당 작업을 위해 학습되지 않은 경우에도 가능. )
하단 figure. 1에서 확인할 수 있듯,
Brushing teeth 사진에서는 Heatmap이 사람이 아니라 칫솔에 활성화 되어 있음.
Cutting trees 사진에서는 Heatmap이 사람이 아니라 전기톱에 활성화 되어 있음.
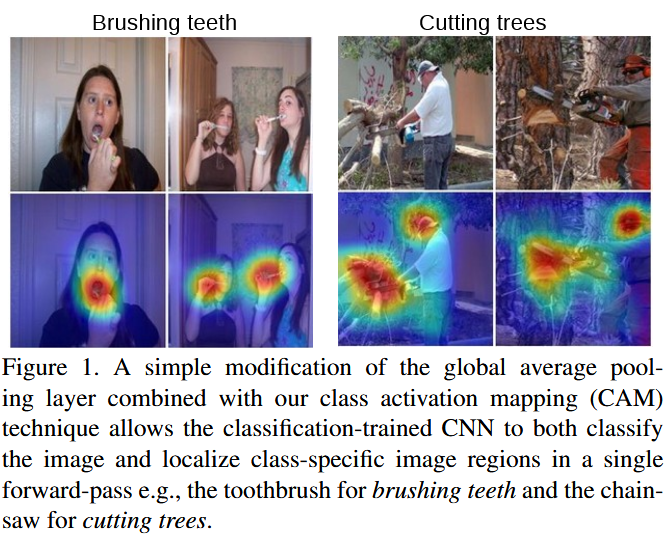
즉, CNN은 행동을 이해할 때, 사람보다 사람이 상호작용하고 있는 Object가 더 중요하다는 것을 스스로 학습한 것임.
그리고 Bounding Box를 이용해 완전 지도학습된 AlexNet이 기록한 성능과 매우 유사한 성능을 보였음.
(Bounding Box 하나도 안 써도 비슷한 성능을 냈기 때문. )
1.1. Related Work
합성곱 신경망(CNN)은 다양한 컴퓨터 비전(Visual Recognition) 분야에서 뛰어난 성능을 달성해 왔음.
본 연구에서는 적절한 네트워크 구조를 사용하면 이런 객체 위치 추정 능력을 단순한 Localization을 넘어, CNN이 분류를 위해 실제로 어떤 이미지 영역을 사용하는지까지 정확하게 식별할 수 있음을 보이고자 함.
그리고 본 논문에서는 CAM과 관련된 기존 연구를 크게 두 가지 분야로 구분함.
1. Weakly-supervised Object Localization
2. CNN 내부 표현의 Visualization
CAM은 이 두 분야를 연결해서,
CNN이 Object를 어디에서 찾는지뿐만 아니라,
Classification을 위해 이미지의 어떤 영역을 중요하게 사용했는지까지 확인하고자 함.
Weakly-supervised Object Localization은
학습 과정에서 Object의 Bounding Box를 제공하지 않고,
Image-level Class Label만으로 Object의 위치를 찾는 방법임.
일반적인 Object Detection에서는
- Image
- Class Label
- Bounding Box를 함께 제공하지만,
Weakly-supervised Object Localization에서는
- Image
- Class Label만 제공함.
또한, 기존 연구에서는 하단과 같은 방법들이 사용되었음.
- 이미지의 특정 영역을 하나씩 Masking하고,
해당 영역을 가렸을 때 CNN의 Classification Score가 크게 감소하는지 확인함. - 이미지를 여러 Candidate Region으로 나눈 후,
Multiple-Instance Learning과 CNN Feature를 이용해 Object가 포함된 영역을 추정함. - 이미지를 서로 겹치는 여러 Patch로 나누고,
각각을 CNN에 입력해 Class Score가 높게 나타나는 위치를 찾음.
(예를 들어 이미지에서 고양이 얼굴을 가렸을 때,
CNN의 고양이 Classification Score가 크게 감소한다면,
CNN이 고양이를 판단할 때 얼굴 영역을 중요하게 사용했다고 볼 수 있는 것. )
다만 기존 방법들은 몇 가지 한계가 있었음.
- 실제 Localization 성능을 정량적으로 충분히 평가하지 않은 경우가 있었음.
- End-to-End 방식으로 학습되지 않았음.
- Masking이나 Overlapping Patch를 이용하기 때문에,
Object 위치를 찾기 위해 CNN을 여러 번 Forward Pass해야 했음. - 따라서 대규모 Dataset이나 실제 환경에 적용하기에는 계산량이 큼.
반면 CAM은 End-to-End 방식으로 학습되며,
이미지를 CNN에 단 한 번 Forward Pass하는 것만으로
Classification 결과와 Object Localization 결과를 함께 얻을 수 있음.
- 기존 방식: Image Region을 여러 번 변경하며 CNN 반복 실행
- CAM 방식:
Image>CNN 1회 Forward Pass>Classification + CAM
즉, CAM은 기존 Weakly-supervised Localization 방법보다 구조가 단순하고, 빠르며, 대규모 Dataset에 적용하기 쉬움.
✅2. Class Activation Mapping
CAM(Class Activation Map)
: CNN이 특정 Class를 분류할 때,
실제로 이미지의 어떤 영역을 중요하게 사용했는지를 나타내는 Heatmap
ex. CNN은 이미지를 고양이로 분류하는 거.
CAM은 고양이의 귀, 눈, 얼굴처럼, 고양이 Class를 구분하는 데 중요했던 영역을 강조함.
2.1. CAM의 전체 구조
CAM에서 사용하는 CNN 구조는 하단과 같음.
Input Image
    ↓
Convolution Layers
    ↓
Last Convolutional Feature Maps
    ↓
Global Average Pooling
    ↓
Fully Connected Layer
    ↓
Softmax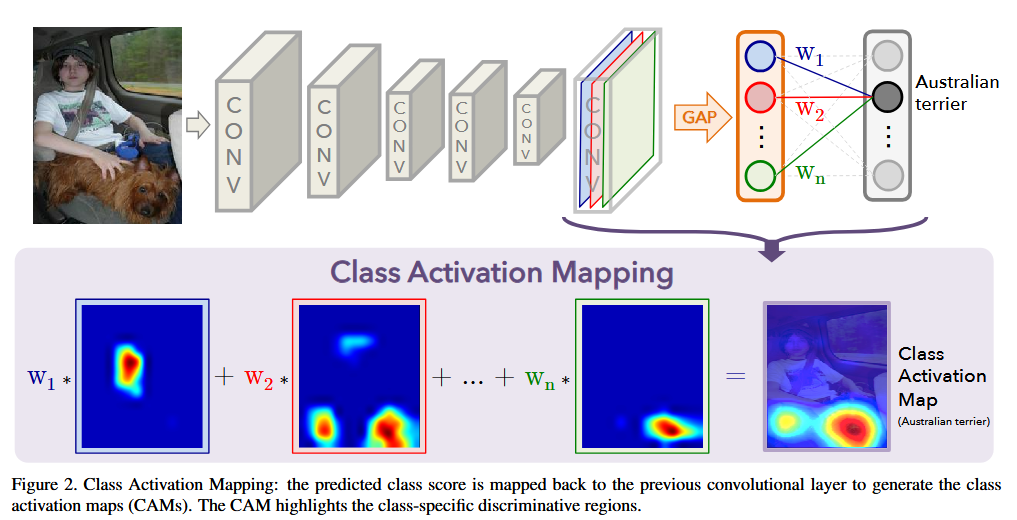
기존 CNN처럼 마지막 Conv Feature Map을 모두 Flatten한 뒤
큰 Fully Connected Layer에 입력하지 않음.
대신 마지막 Conv Layer의 각 Feature Map에 GAP를 적용해서,
Feature Map 하나를 하나의 값으로 변환해서 최종 Classifier에 입력함.
ex. 마지막 Conv Layer의 출력 크기가
14 × 14 × 1024라고 한다면,
이는 크기가 14 × 14인 Feature Map이 1024개 존재한다는 의미.
그리고 각 Feature Map에 GAP를 적용하면 다음과 같이 변환되게 됨.
14 × 14 × 1024
        ↓ GAP
1024-Dimensional Feature Vector
즉, 1024개의 Feature Map이 각각 하나의 평균값으로 변환되고,
이 값들이 최종 Classifier의 입력으로 사용되는 것.
★ CAM에서 말하는 Fully Connected Layer는 기존 CNN의 거대한 FC Layer와 다름.
★ Feature Map을 Flatten한 결과가 아니라, GAP로 얻은 값과 Class를 연결하는 최종 선형 분류 계층임.
2.2. Class Weight 의미
최종 Fully Connected Layer에는
각 Feature Map과 Class를 연결하는Weight가 존재함.
Class 와 번째 Feature Map 사이의 Weight를
라고 정의함.그리고 이 Weight 는
번째 Feature Map이
Class 를 예측하는 데 얼마나 중요한지를 나타냄.
ex. 고양이 Class에 대한 Weight를 생각하면
- 고양이 귀를 감지하는 Feature Map → Weight 높게
- 고양이 눈을 감지하는 Feature Map → Weight 높게
- 자동차 바퀴를 감지하는 Feature Map → Weight 낮거나 음(-)으로
=> Weight의 크기에 따른 의미는 하단과 같음.
- 가 큰 양수
: 해당 Feature Map이 Class의 Score를 높임- 가 0에 가까움
: 해당 Class 예측에 거의 영향을 주지 않음- 가 음수
: 해당 Feature Map이 Class (c)의 Score를 낮춤
2.3. Feature Map과 GAP 정의
마지막 Conv Layer의 번째 Feature Map을 다음과 같이 정의함.
- : Feature Map 번호
- : Feature Map 내부의 Spatial Location
- : 번째 Feature Map의 위치에 존재하는 Activation Value
ex. 10번째 Feature Map의 3행 5열 값이 7이라면 다음과 같음.
번째 Feature Map에 GAP를 적용한 결과를 라고 하면,
논문에서는 다음과 같이 표현함.
정확한 Global Average Pooling은 Feature Map의 모든 값을 더한 뒤
Spatial Size로 나누어 평균을 계산함.
다만 논문에서는 모든 Feature Map에 공통으로 적용되는 상수항을 생략해서
합의 형태로 단순하게 표현한 것.
라는 것
: 번째 Feature Map이 이미지 전체에서
얼마나 강하게 활성화되었는지를 나타내 주는 하나의 값.
2.4. Class Score 계산
Class 에 대한 Softmax 이전의 Score를 라고 하면,
하단과 같이 계산됨.
각 Feature Map의 GAP 결과 에
해당 Class의 Weight 를 곱하고
모두 합산하는 방식.
ex. 고양이 Class Score는 개념적으로 하단과 같이 계산됨.
Cat Score
=
Cat Weight 1 × GAP(Feature Map 1)
+
Cat Weight 2 × GAP(Feature Map 2)
+
...
+
Cat Weight k × GAP(Feature Map k)
이렇게 계산된 는 Softmax를 통해
최종 Class Probability 로 변환됨.여기서 는 Softmax 이전의 Raw Score, 즉
Logit임.
ex. 최종 Linear Layer에서 각 Class의 Score, 즉 Logit을 계산하는데,
- 고양이 Score
- 강아지 Score
- 자동차 Score
이거를 softmax가 클래스별 확률로 바꿔주는 것.
- 고양이: 82%
- 강아지: 15%
- 자동차: 3%
근데 Softmax 자체는 CAM을 만드는 핵심 요소는 아님.
실제 CAM 계산에는 주로 Softmax 이전의 Class Score와 Linear Layer Weight를 사용함.
논문에서는 Bias Term을 0으로 설정했는데,
일반적인 Class Score는 하단과 같이 Bias를 포함할 수 있음.
다만 Bias는 이미지의 모든 Spatial Location에 동일하게 적용되는 상수기 때문에,
어떤 위치가 중요한지를 계산하는 데 직접적인 도움을 주지는 않음.그리고 Classification 성능에도 거의 영향을 주지 않았기 때문에
CAM 유도 과정에서는 Bias를 제외한 것.
2.5. CAM 계산식 유도
↓앞에서 정의한 두 식 ↓
그리고 를 Class Score 식에 대입하면 하단과 같음.
이어서 합산 순서를 바꾸면 하단과 같이 표현할 수 있음.
여기서 Class 에 대한 CAM을 라고 정의함.
이 식이 CAM의 핵심 계산식!
위 식을 풀어서 설명해 보자면,
특정 위치 에서 다음 과정을 수행하는 것임.
- 모든 Feature Map의 위치 Activation을 가져옴.
- 각 Activation에 Class 에 해당하는 Weight를 곱함.
- 모든 Feature Map에 대한 결과 합산.
개념적으로 고양이 Class의 특정 위치에 대한 CAM 값은 다음과 같음.
이 연산을 Feature Map의 모든 위치에 수행하면
2차원 형태의 CAM Heatmap이 생성됨.
2.6. CAM 값과 Class Score 관계
CAM의 모든 Spatial Location을 더하면
해당 Class의 Score가 됨.가 높은 위치
= 해당 Spatial Location의 Activation이
이미지가 Class 로 분류되는 데 크게 기여했다는 의미.
ex. 고양이 CAM에서 귀 부분의 값이 높다면,
CNN이 고양이라고 판단할 때 귀 영역을 중요한 근거로 사용했다는 뜻.
즉, CAM은 Object 위치만을 표시하는 것이 아니라,
★특정 위치★가 ★Class Score★에 ★얼마나 기여했는지★를 나타내 주는 것.
2.7. CAM의 직관적 의미
CNN의 각 Feature Map은 서로 다른 Visual Pattern을 감지한다고 볼 수 있음.
ex. 각 Feature Map은 하단과 같은 패턴에 반응할 수 있음.
- Edge
- Color
- Texture
- 동물의 눈
- 동물의 얼굴
- 특정 Object Part 등...
shallow한 Conv Layer에서는 Edge나 Texture와 같은 단순한 패턴에 반응하고,
deep한 Conv Layer에서는 얼굴이나 Object Part처럼
더 복잡하고 의미 있는 패턴에 반응함.
=> 란
: 번째 Visual Pattern이
이미지의 어느 위치에 존재하는지를 나타내는 Map.
그리고 CAM
: 이런 Feature Map들을
Class별 Weight를 사용해서 가중합한 결과.
ex.
Cat CAM
=
Ear Pattern Feature Map × High Weight
+
Eye Pattern Feature Map × High Weight
+
Fur Pattern Feature Map × High Weight
+
Wheel Pattern Feature Map × Low Weight
그렇기에 Class마다 중요하게 사용하는 Feature Map과 Weight가 다르고,
결과적으로 서로 다른 CAM이 생성됨.
2.8. CAM Upsampling
마지막 Conv Layer의 Feature Map은
Input Image보다 낮은 Spatial Resolution을 가짐.
ex.
Input Image: 224 × 224
CAM: 14 × 14
따라서 생성된 CAM을 Input Image와 동일한 크기로 Upsampling해줘야 함.
14 × 14 CAM
      ↓ Upsampling
224 × 224 Heatmap
      ↓
Original Image와 Overlay
그리고
Upsampling된 CAM을 원본 이미지 위에 오버레이하면
CNN이 특정 Class를 예측할 때 중요하게 본 영역을 시각적으로 확인할 수 있는 것임!
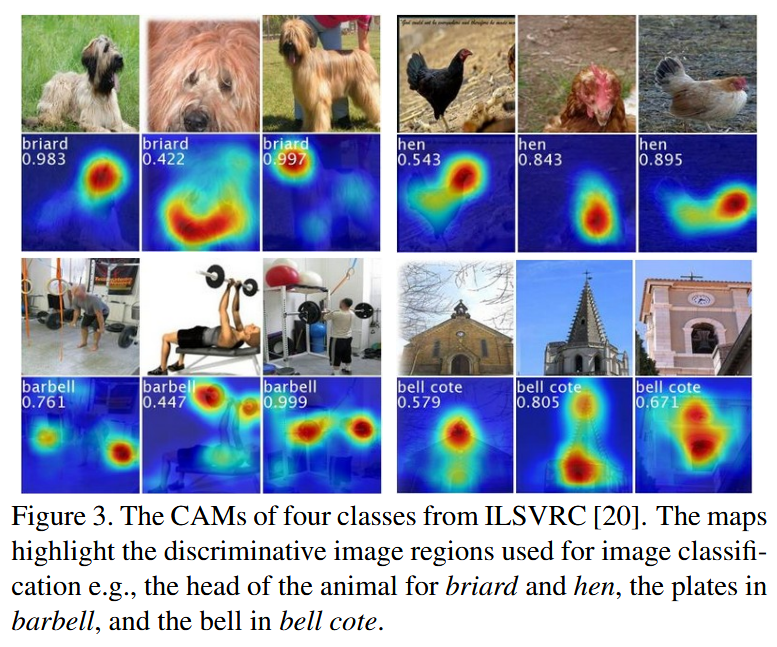
다만 CAM의 실제 정보는 낮은 해상도의 마지막 Conv Feature Map에서 생성되기 때문에,
Upsampling하더라도 세밀한 경계 정보가 새롭게 생기는 것은 아님.
그래서 CAM Heatmap은 비교적 거칠게 나타날 수 있음.
2.9. Class-Specific CAM
CAM은 하나의 이미지에서 항상 동일하게 생성되는 것이 아님.
같은 이미지여도 어떤 Class를 기준으로 계산하는지에 따라
서로 다른 CAM이 생성됨.
CAM 계산식은 하단과 같음.
같은 이미지에서는 Feature Map 가 같더라도,
선택한 Class 가 달라지면 Weight 가 달라짐.따라서 최종 CAM도 달라짐.
하단 Figure. 4에서는 하나의 건물 이미지에 대해
서로 다른 Class를 기준으로 CAM을 생성함.
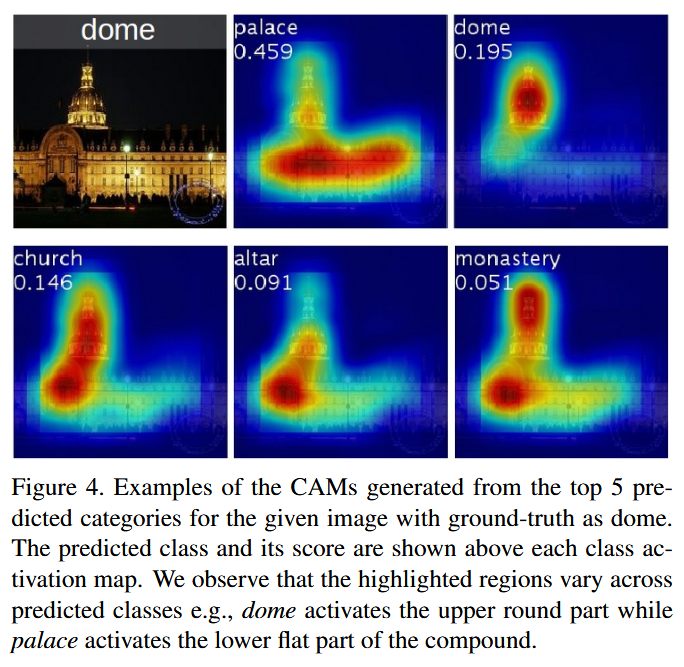
DomeClass
: 건물 위쪽의 둥근 지붕 강하게 강조PalaceClass
: 건물 아래쪽의 넓고 평평한 구조 강조ChurchClass
: 교회와 관련된 건축적 특징 강조MonasteryClass
: 수도원으로 판단하는 데 필요한 다른 영역 강조
=> CNN이 동일한 이미지에서도
Class마다 서로 다른 판단 근거를 사용하구나.
CAM은
이미지 전체의 일반적인 중요도를 나타내는 게 아니라,
특정 Class에 종속된 Class-Specific Explanation을 제공함.
2.10. GAP vs. GMP
기존 Weakly-supervised Object Localization 연구에서는
GMP(Global Max Pooling)을 사용하기도 했음.
하지만 GAP와 GMP는 Localization 관점에서 서로 다른 특성을 가짐.
i) GMP(Global Max Pooling)
=Feature Map에서 가장 큰 Activation 값 하나만 사용.
ex. Feature Map 값이 하단과 같다면,
10 0 0 0GMP의 결과는,
GMP = 10나머지 위치가 모두 0이더라도 최댓값 10만 사용되기 때문에
최종 Score에는 문제가 없음.
그렇기에 GMP를 사용하는 네트워크는
객체 전체를 찾을 필요 없이 가장 판별적인 한 부분만 찾아도 됨.
ex. 강아지 분류할 때 얼굴만 강하게 활성화해도
충분히 높은 Class Score를 얻을 수 있는 것
Dog Face: Strong Activation
Dog Body: Low Activation
Dog Legs: Low Activation
Background: Low Activation
=> GMP는 객체 전체가 아니라
가장 특징적인 일부 영역만 강조하는 경향이 있음.
ii) GAP(Global Average Pooling)
= Feature Map 전체의 평균값 사용.
ex. 하단 두 Feature Map을 비교해보면,
Feature Map A
10  0  0  0
Feature Map B
10 9 8 7Feature Map A는 한 위치만 강하게 활성화되어 있지만,
Feature Map B는 여러 위치가 넓게 활성화되어 있음.
그러니 평균값은 Feature Map B가 더 높음.
GAP를 사용하는 네트워크
: Class Score를 높이기 위해 한 부분만이 아니라
객체의 여러 판별적 영역을 함께 활성화하도록 학습됨.
GMP
: 가장 판별적인 한 부분만 찾아도 충분
GAP
: 여러 판별적 부분을 넓게 찾아야 평균값이 높아짐
∴ GAP
: 객체의 일부분이 아니라
객체가 차지하는 전체 범위를 더 넓게 찾도록 유도함.
Classification Performance
GAP≈GMPLocalization Performance
GAP>GMP
GMP도 가장 판별적인 부분을 이용해
객체가 어떤 Class인지 맞히는 것은 잘할 수 있음.
=> Classification 성능은GAP와 유사함.- 다만
GMP는 객체의 일부분만 강조하는 경향이 있기에
객체의 전체 위치를 찾는 Localization에서는 불리함.- 그리고
GMP와 달리,GAP는 객체의 여러 부분이 함께 활성화되도록 유도함.
더 넓고 정확한 Object Localization 가능.
GMP
: 객체를 구분할 수 있는 가장 강한 특징이 어디인지 집중
GAP
: 객체를 구성하는 판별적인 특징들이 전체적으로 어디에 분포하는지에 집중
=> CAM에서는 객체 전체의 범위를 더 잘 포착할 수 있는 GAP 사용.
✅3. Weakly-supervised Object Localization
이제 CAM의 Weakly-supervised Object Localization 성능 평가.
실험은 ILSVRC 2014 Benchmark를 이용해서 진행.
평가는 크게 두 단계로 이루어짐.
- CAM을 적용해도 기존 CNN의 Classification 성능이 유지되는지
- Bounding Box 없이도 Object Localization이 가능한지
즉, CAM이 단순히 Heatmap만 그리는 게 아니라,
실제 Localization에서도 효과적인지 검증.
3.1. Setup
실험에는 대표적인 CNN Architecture인
AlexNetVGGNetGoogLeNet
을 사용함.
그리고 기존 네트워크는 하단과 같이
마지막 Convolution Layer 이후
여러 개의 Fully Connected Layer를 이용하여 Classification을 수행하지만,
[Original CNN]

Convolution Layers
↓
Flatten
↓
Fully Connected Layer(s)
↓
Softmax
↓ CAM에서는
이런 거대한 Fully Connected Layer들을 제거하고,
Global Average Pooling(GAP)을 적용한 뒤,
최종 Classification을 위한 하나의 Linear Fully Connected Layer만 남김.
[CAM]

Conv
↓
Global Average Pooling
↓
Fully Connected (Linear Classifier)
↓
Softmax
★ CAM은 Fully Connected Layer를 완전히 제거한 게 아니라,
기존 여러 Fully Connected Layer를 제거하고,
Class별 Weight를 학습하기 위한 마지막 Linear Layer만 유지한 구조.
Mapping Resolution
: 마지막 Convolution Layer Feature Map의 Spatial Resolution
(논문에서 새롭게 등장하는 개념)
ex.
[Input Image]

224 × 224
↓
[Last Conv Feature Map]

7 × 7 이라면,
=> [Mapping Resolution]
: 7 × 7논문에서는 Mapping Resolution이 클수록
Localization 성능이 좋아지는 걸 발견함.
∵ Feature Map 해상도가 높을수록
- 객체의 위치를 더 세밀하게 표현할 수 있고
- CAM 역시 더 정밀하게 생성되기 때문.
그래서 논문에서 기존 CNN의 마지막 Layer 일부를 제거했음(= Network Modification).
★"아 근데 이렇게 Layer를 줄이면, 표현력 떨어지는 것 아닌가?"
★맞음. 다만, 본 CAM 논문 목표는 Classification 최고 성능이 아니라, Localization이기 때문에,
Classification 성능이 좀 떨어지더라도, Layer를 줄인 것
[Network Modification]
i) AlexNet
[Original]
...
Conv5
↓
Pool5
↓
FC
↓
Softmax
↓
[CAM]
...
Conv5
↓
3×3 Conv (1024)
↓
GAP
↓
Softmax
Mapping Resolution
13 × 13
ii) VGGNet
Pool5 이후 Layer 제거
↓
14 × 14
Mapping Resolution 확보
iii) GoogLeNet
Inception4e 이후 Layer 제거
↓
14 × 14
Mapping Resolution 확보
이후 모든 Network에 대해
3 × 3 Convolution
↓
1024 Feature Maps
↓
GAP
↓
Softmax
추가
그리고 ILSVRC의 약 130만 장의 학습 이미지 이용
=> 1000-Class Classification으로 Fine-tuning
최종적으로
AlexNet-GAPVGGNet-GAPGoogLeNet-GAP세 가지 모델 구축.
Comparison Models
Classification에서는 하단 모델들과 비교함.
Original AlexNetOriginal VGGNetOriginal GoogLeNetNetwork in Network (NIN)
Localization에서는
Original GoogLeNetNINBackpropagation-based LocalizationGoogLeNet-GMP와 비교함.
여기서 GoogLeNet-GMP는
GAP 대신 GMP(Global Max Pooling) 사용한 모델.
=> GAP가 정말 GMP보다 Localization에 유리한지 검증해보자.
평가 지표
Classification과 Localization 모두
ILSVRC에서 사용하는
Top-1 ErrorTop-5 Error그대로 사용.
Classification은 Validation Set에서 평가했고,
Localization은 Validation Set, Test Set 모두에서 평가했음.
3.2. Results
먼저 CAM을 적용했을 때 기존 CNN의 Classification 성능이 유지되는지 확인했음.
이후 Bounding Box 없이도 Object Localization이 가능한지 평가했음.
i) Classification
먼저 CAM 구조가 기존 CNN의 Classification 성능을 크게 저하시키지 않는지 확인했음.
하단 Table. 1에서 확인할 수 있듯,
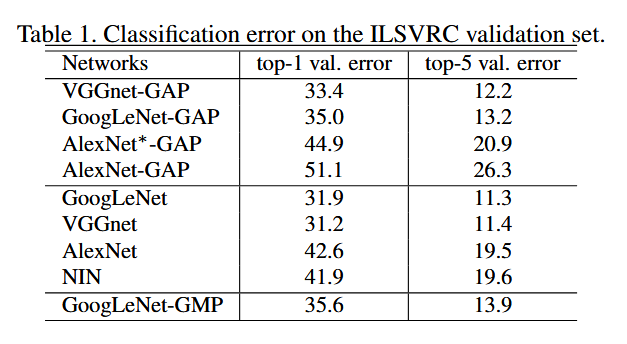
기존 Network에서 마지막 Layer 일부를 제거하고 GAP를 적용하면서,
대부분의 Network에서 약 1~2% 정도의 Classification 성능 감소만 발생했음.
즉,
- Mapping Resolution을 높이기 위해 마지막 Layer 일부를 제거했음.
- 그럼에도 Classification 성능은 대부분 유지됐음!
다만 AlexNet은 다른 Network보다 성능 감소가 상대적으로 크게 나타났음.
=> GAP 바로 앞에 Convolution Layer를 두 개 추가한 AlexNet*-GAP를 제안했음.
그 결과 AlexNet*-GAP은 기존 AlexNet과 거의 비슷한 Classification 성능을 보였음.
즉, CAM 구조는 기존 CNN의 Classification 성능을 크게 떨어뜨리지 않으면서도 Localization 기능을 추가할 수 있었음.
그리고 GAP와 GMP(Global Max Pooling)의 Classification 성능도 비교했는데, 실험 결과,
- GoogLeNet-GAP
- GoogLeNet-GMP
두 모델의 Classification 성능은 거의 동일했음.
즉,
[Classification]

GAP ≈ GMP
라는 결과를 확인했음.
논문에서는 Localization 성능을 높이기 위해서는
우선 Classification 성능이 충분히 좋아야 한다고 설명함.
Localization은 단순히 Bounding Box만 잘 찾는 문제가 아니라,
- Object Category를 맞춰야 하고
- Bounding Box도 정확해야 하기 때문임.
그래서 Classification이 틀리면 Localization도 자동으로 실패하게 되는 것.
=> CAM 구조가 Classification 성능을 유지했다는 것
: Localization에서도 매우 중요한 의미.
ii) Localization
이제 CAM을 이용하여 실제 Object Localization 성능을 평가했음.
CAM은 Heatmap만 생성하기 때문에,
먼저 Heatmap으로부터 Bounding Box를 생성해야 했음.
Bounding Box 생성 과정은 매우 단순.
- CAM에서 최대 Activation의 20% 이상인 영역만 남김.
- 남은 영역 중 가장 큰 Connected Component를 선택했음.
- 해당 영역을 감싸는 Bounding Box를 생성했음.
Top-5 Localization 평가를 위해,
예측한 Top-5 Class 각각에 대해 Bounding Box를 생성했음.
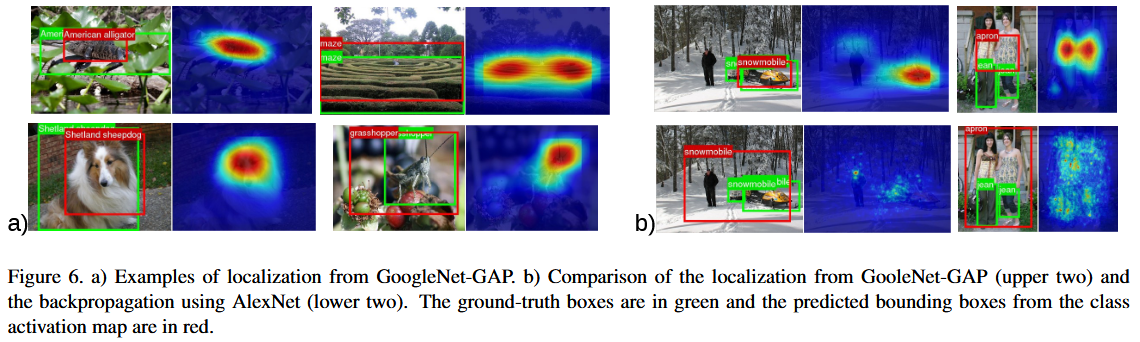
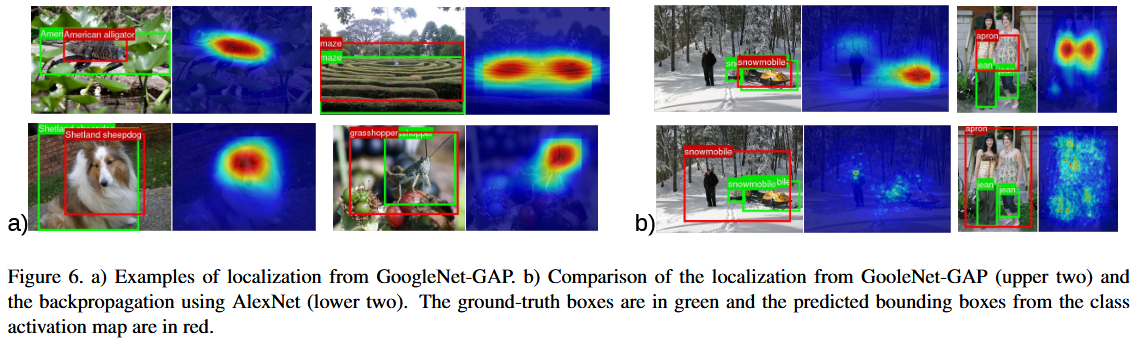
그리고 Figure 6. (a)는 이런 방법으로 생성된 Bounding Box 예시를 보여줌.
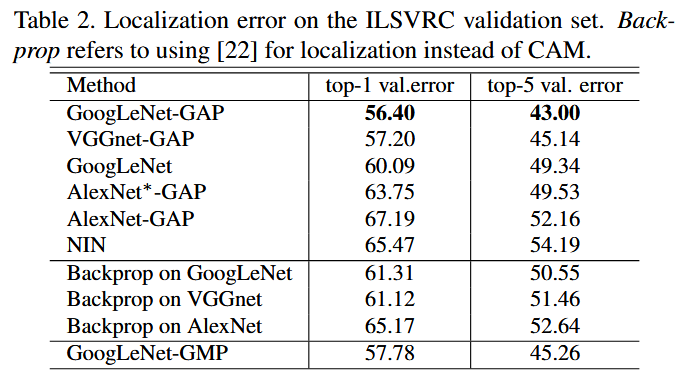
Localization 결과는 하단 Table 2에 정리되어 있음.
실제 출력 예시는 하단 Figure. 5에서 확인 가능.
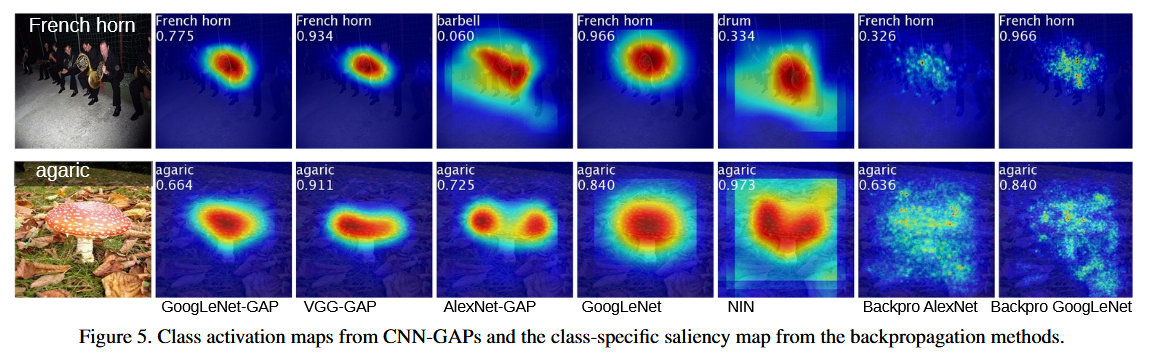
실험 결과,
모든 CAM 기반 Network가
기존 방법보다 더 좋은 Localization 성능을 보였음.
특히 GoogLeNet-GAP이 가장 낮은 Localization Error를 기록했음.
[Top-5 Localization Error]

GoogLeNet-GAP

43%
그리고 제일 놀라운 건,
이 Network가 Bounding Box Annotation을 단 한 장도 사용하지 않았음에도
이 정도 Localization 성능을 달성했다는 것!=
Weakly-supervised Learning만으로도
상당히 정확한 Object Localization이 가능했음을 보여줬음.
또한 CAM은 기존 Backpropagation 기반 Localization 방법보다도
더 좋은 성능을 보였음.하단 Figure 6. (b)를 보면, Backpropagation은 객체 주변 전체가 넓게 활성화되는데,
CAM은 실제 Object 영역을 훨씬 정확하게 강조하는 것을 확인할 수 있음.
그리고,
기존 GoogLeNet과 GoogLeNet-GAP도 비교했음.
- Classification 성능은 Original GoogLeNet이 조금 더 좋았지만,
- Localization 성능은 GoogLeNet-GAP이 훨씬 뛰어났음.
=> 가장 큰 이유는 Mapping Resolution
Original GoogLeNet의 마지막 Feature Map은
7 × 7 이었음근데 CAM에서는
14 × 14Feature Map을 사용했음.
=> 더 높은 Spatial Resolution을 사용했기에
객체 위치를 훨씬 세밀하게 표현할 수 있었음.
GAP와 GMP도 Localization 성능도 비교했음.
- Classification에서는
GAP ≈ GMP 였지만,
- Localization에서는
GAP > GMP 였음.이것도 앞에서 언급했던 것처럼,
GMP는 객체의 가장 판별적인 한 부분만 활성화하는 반면,
GAP는 객체의 여러 판별적 영역을 함께 활성화하도록 학습되기 때문임.
=>GAP가 Object의 전체 범위를 더 잘 찾는다는 사실을 실험으로 다시 한번 확인한 것.
추가적으로 ILSVRC Test Set에서도 성능을 평가했음.
Validation Set보다 조금 다른 Bounding Box 선택 전략을 적용하여
Top-5 Localization 성능을 측정했음.
그 결과,
GoogLeNet-GAP은
[Top-5 Localization Error]

37.1% 를 기록했음.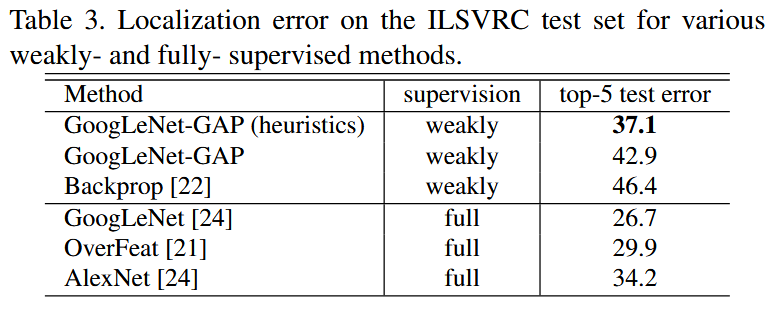
특히 Bounding Box를 이용하여 완전 지도학습한
[AlexNet]
34.2% 와 매우 근접한 성능.
Bounding Box Annotation 없이도
완전 지도학습 모델에 근접하는 Localization 성능 달성한 것
= 이번 CAM 논문의 가장 큰 성과.다만,
같은 GoogLeNet 구조를 사용하는 Fully-supervised Model과 비교하면
아직 Localization 성능 차이는 존재했음.=> CAM은 Weakly-supervised Localization의 가능성을 보여주었지만,
완전 지도학습을 완전히 대체할 수준은 아님을 언급함.
✅4. Deep Features for Generic Localization
앞선 Section에서는 CAM을 이용해서
Weakly-supervised Object Localization이 가능함을 확인했음.
이번에는, CAM으로 학습한 Feature가 다른 다양한 Computer Vision Task에서도
일반적인 Deep Feature(Generic Feature)로 활용될 수 있는지 확인했음.
기존 연구에서는 AlexNet의
FC6, FC7 Feature가 다양한 Vision Task에서 매우 좋은 Generic Feature로 사용된다는 사실이 알려져 있었음.
=> ImageNet으로 학습한 CNN을 그대로 가져와
다른 Dataset에서도 Feature Extractor처럼 사용하는 Transfer Learning이 매우 효과적이었음.
=> 본 논문에서는
GoogLeNet-GAP 또한
ImageNet Classification만 학습했지만,다른 Dataset에서도 충분히 좋은 Generic Feature가 될 수 있는지 확인했음.
그리고 기존 CNN과 달리,
어떤 영역을 보고 분류했는지까지 함께 설명할 수 있다는 장점이 있음.
=> GAP Layer의 출력을 Feature Vector로 사용한 뒤,
새로운 Dataset마다 Linear SVM을 학습하면서 Classification을 수행했음.
★ 단 이때, CNN 전체를 다시 학습한 게 아니라,
ImageNet에서 학습된 GoogLeNet-GAP을 그대로 Feature Extractor처럼 사용했다는 것임.
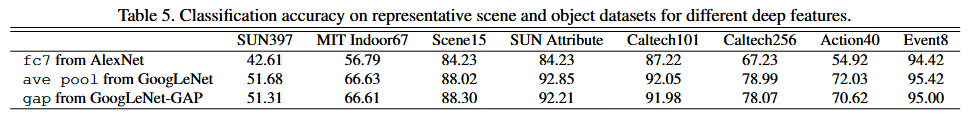
평가는 다음과 같은 다양한 Dataset에서 수행했음.
Scene ClassificationIndoor Scene RecognitionObject ClassificationAction RecognitionEvent Recognition등
총 여러 개의 대표적인 Vision Benchmark를 사용했음.
실험 결과,
GoogLeNet-GAP은
기존 AlexNet의 FC7 Feature보다 더 좋은 성능을 보였음.
또한 Original GoogLeNet과도 거의 비슷한 성능을 유지했음.
=> CAM을 적용했다고 해서
Generic Feature의 성능이 크게 감소하지 않았음.
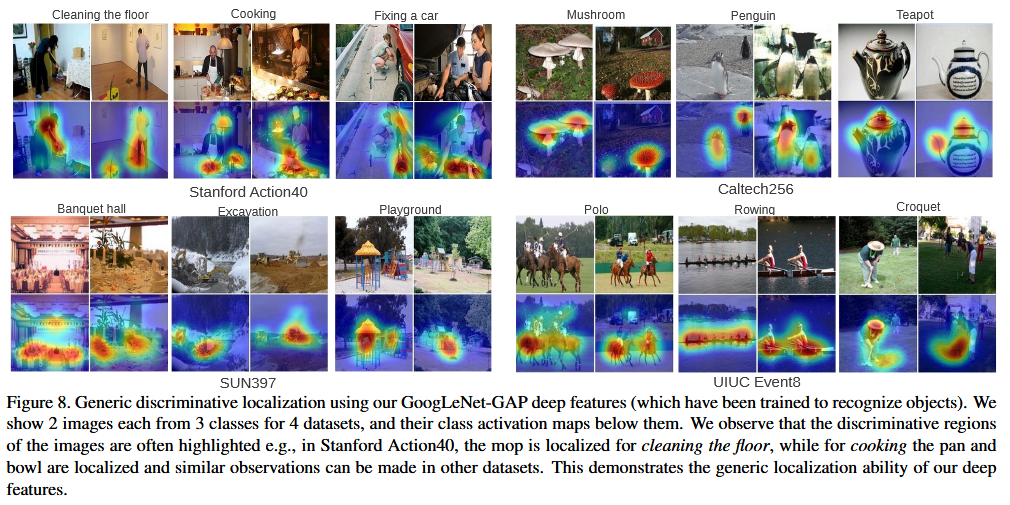
또한,
CAM으로 생성한 Heatmap 역시
새로운 Dataset에서도
분류에 중요한 영역을 정확하게 강조했음.
=> ImageNet에서 학습한 Localization 능력이
다른 Dataset에도 자연스럽게 Transfer됐음을 보여줬음.
★★ GoogLeNet-GAP은 Object Localization만 가능한 모델이 아니라,
- Generic Feature로도 우수한 성능을 보였고,
- Localization 능력도 함께 유지했으며,
- 다양한 Vision Task에 그대로 활용 가능한 Deep Feature임을 입증한 것!
4.1. Fine-grained Recognition
이번에는 CAM의 Localization 능력을 Fine-grained Recognition* 문제에 적용했음.
*Fine-grained Recognition
: 서로 매우 비슷한 객체들을 세부적으로 구분하는 Classification Task.
ex.
새 품종 분류견종 분류자동차 모델 분류등
일반적인 Classification보다 객체 간 차이가 매우 작기 때문에,
객체의 세부적인 특징을 정확하게 봐야 함.
i) CUB-200-2011 Dataset
실험에는 CUB-200-2011 Dataset을 사용했음.
이 Dataset은
- 총 200종의 새(Bird Species) 로 구성되어 있음.
- 전체 이미지 수: 11,788장
- 학습 이미지: 5,994장
- 테스트 이미지: 5,794장으로 구성
또한 이 Dataset은 Bounding Box Annotation도 함께 제공하기 때문에,
CAM이 실제로 새의 위치를 얼마나 잘 찾는지도 함께 평가할 수 있었음.
ii) Baseline 성능
먼저 Bounding Box를 전혀 사용 안 하고
원본 이미지만 입력해서 Classification을 수행했음.
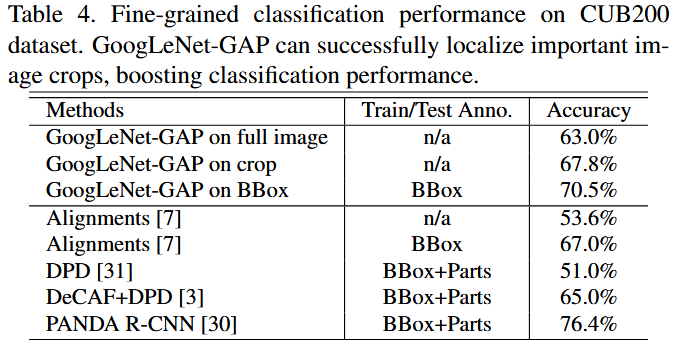
그 결과,
GoogLeNet-GAP은 63.0% Accuracy를 기록했음.
반면,
학습과 테스트 모두에서 Ground Truth Bounding Box를 사용하면
Accuracy가 70.5%까지 증가했음.
=> Bounding Box 이용해서
새가 있는 부분만 Crop하면
Classification 성능이 크게 향상됐음.
(Fine-grained Recognition에서는
배경보다 객체 자체의 세부 특징이 훨씬 중요하기 때문. )
iii) CAM 이용한 Bounding Box 생성
Ground Truth Bounding Box가 없는 경우를 위해,
본 논문에서는 CAM을 이용해
자동으로 Bounding Box를 생성했음.
과정은 하단과 같음.
Original Image
        ↓
GoogLeNet-GAP
        ↓
CAM 생성
        ↓
Thresholding
        ↓
Bird Bounding Box 생성
        ↓
Bounding Box 영역 Crop
        ↓
GoogLeNet-GAP 재입력
        ↓
Classification
= CAM으로 먼저 새의 위치를 찾고,
찾은 영역만 잘라서(Crop)
다시 CNN에 입력하는 방식.
iv) 결과
위 방법 적용 결과,
Accuracy가
63.0%

↓

67.8% 까지 향상됐음.
Ground Truth Bounding Box(70.5%)보다는 낮았지만,
Bounding Box Annotation을 전혀 사용하지 않았다는 점을 고려하면
상당한 성능 향상이었음.
= CAM이 생성한 Bounding Box만으로도
배경을 제거하고
객체에 집중해서 분류 성능을 높일 수 있었음.
v) Localization 성능 평가
저자들은 CAM이 실제로 새를 얼마나 잘 찾는지도 평가했음.
평가는
IoU(Intersection over Union)
기준을 사용했고,
IoU ≥ 0.5를 만족하면
Localization 성공으로 판단했음.
그 결과,
GoogLeNet-GAP은
41.0%의 Localization Accuracy를 기록했음.
반면,
무작위(Random Chance)로 Bounding Box를 선택했을 경우
성능은 5.5%에 불과했음.
=> CAM은 단순히 우연히 객체를 찾은 것이 아니라,
실제로 새의 위치를 상당히 정확하게 찾아내고 있었음을 확인했음.
하단 Figure. 7에서는 이러한 Localization 결과를 시각적으로 보여주고 있음.
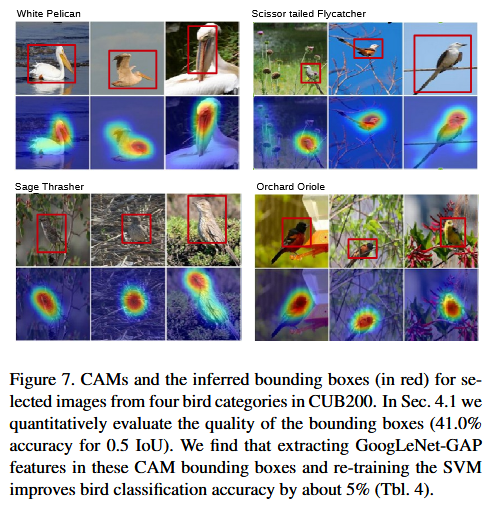
Fine-grained Recognition에서는
객체 간 차이가 매우 작기 때문에
객체가 있는 부분만 집중해서 보는 것이 매우 중요했음.
CAM은 Bounding Box Annotation 없이도
객체 위치를 자동으로 추정할 수 있었고,
이를 이용해서 이미지를 Crop한 후 다시 분류함으로써
Accuracy를 63.0% → 67.8%까지 향상시켰음.
CAM은 Heatmap 생성만 하고 끝나는 게 아니라,
Localization 결과를 다시 Classification에 활용해서 성능까지 향상시킬 수 있음을 보여준 응용 사례라고 볼 수 있음!
4.2. Pattern Discovery
이번에는 CAM을 이용해서
Object를 찾는 것뿐만 아니라,
이미지 속에서 공통된 Visual Pattern이나 Concept를 발견할 수 있는지 확인했음.
ex. CAM이
자동차, 사람, 새 같은 객체뿐만 아니라,
Text, Scene, 추상적인 개념(Concept)도 찾아낼 수 있는지 실험했음.
실험 방법은 이전과 동일했음.
GoogLeNet-GAP의 GAP Layer 출력을 Feature로 사용하고,
새로운 Task마다 Linear SVM을 학습한 뒤,
CAM을 이용해서 중요한 영역을 시각화했음.
이번 실험은 새로운 CNN을 학습한 것이 아니라,
ImageNet으로 학습된 GoogLeNet-GAP을 그대로 이용해서
Visual Pattern을 발견하는 게 목적이었음.
논문에서는 총 네 가지 Pattern Discovery 실험을 수행했음.
i) Scene에서 중요한 Object 찾기
= Discovering informative objects in the scenes
첫 번째 실험은
Scene Classification에서
CNN이 어떤 Object를 보고 장면(Scene)을 판단하는지 확인했음.
SUN Dataset의 Scene Category를 이용해서
각 Scene에 대한 Linear SVM을 학습하고, CAM을 생성했음.
실험 결과,
CAM이 높은 Activation을 보인 영역은
대부분 해당 Scene을 대표하는 Object와 일치했음.
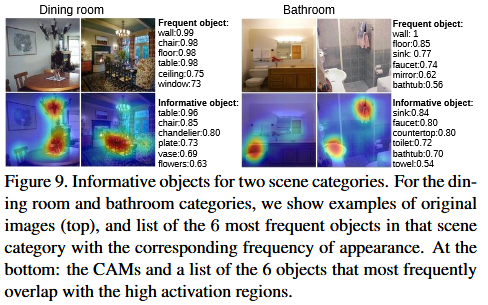
ex.
Bedroom→침대Kitchen→싱크대Library→책장등과 같이,
Scene을 판단하는 데 중요한 Object를 자연스럽게 강조했음.
CAM은 무작정 Scene을 분류하는 게 아니라,
왜 해당 Scene이라고 판단했는지도 함께 설명할 수 있었음.
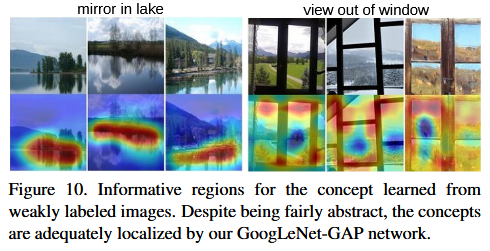
ii) Weakly-labeled Image에서 Concept Localization
= Concept localization in weakly labeled images
두 번째 실험에서는
Object보다 더 추상적인 Concept도 찾을 수 있는지 확인했음.
학습 데이터에는 Bounding Box가 없었고,
이미지 Caption에 포함된 짧은 문장을 이용해서
Concept Detector를 학습했음.
ex.
"Snow Mountain"

"Red Car"

"Blue Sky"
같은 문장이 Caption에 포함돼 있으면
Positive Sample로 사용했음.
반대로
관련 문장이 없는 이미지는
Negative Sample로 사용했음.
그 후 CAM을 생성한 결과,
객체 이름뿐 아니라
이러한 추상적인 Concept와 관련된 영역도
정확하게 강조하는 것을 확인했음.
CAM은 Object Detection뿐만 아니라
추상적인 의미(Semantic Concept)까지 Localization할 수 있었음.
iii) Weakly supervised text detector
세 번째 실험은
Bounding Box Annotation 없이
이미지 속 Text를 찾는 실험이었음.
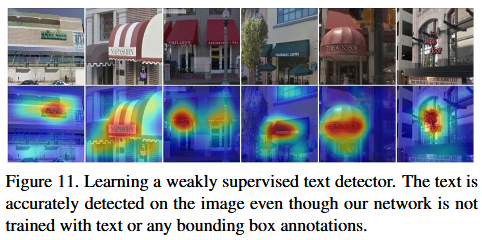
Google Street View 이미지 중
Text가 포함된 이미지를 Positive,
일반 Outdoor Scene 이미지를 Negative로 사용해서
Text Detector를 학습했음.
그 결과,
Bounding Box 없이도
CAM이 Text가 위치한 부분을 정확하게 강조했음.
CAM은 글자 위치도 효과적으로 Localization할 수 있었음.
iv) Interpreting visual question answering
= Visual Question Answering(VQA)
마지막으로
Visual Question Answering(VQA)*에도 CAM을 적용했음.
*VQA
: 이미지와 질문이 함께 주어졌을 때
적절한 답을 예측하는 Task.
ex.
Q."What color is the bus?" 라면모델은
A. "Red" 처럼 답을 예측해야 함.본 논문에서는 CAM을 이용해서
모델이 답을 예측할 때
이미지의 어떤 부분을 참고했는지 시각화했음.
하단 Figure. 12를 보면,
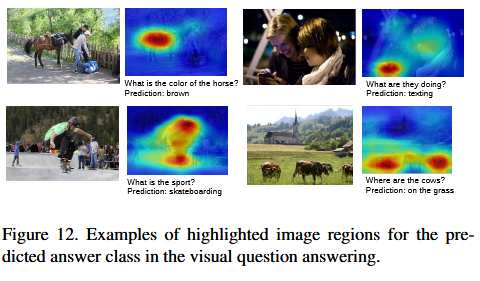
예측한 답과 관련된 영역을 CAM이 정확하게 강조하는 것을 확인할 수 있음.
VQA에서도 CAM을 이용하면
모델의 판단 근거를 사람이 이해할 수 있게 설명할 수 있었음.
CAM은 Object Detection에만 국한되지 않고,
다양한 Computer Vision Task에서 모델의 판단 근거를 설명할 수 있는 범용적인 Localization 기법이구나!
✅5. Visualizing Class-Specific Units
지금까지 CAM은
이미지의 어떤 위치를 보고 분류했는지를 설명하는 방법이었음.
이번 Section에서는 한 단계 더 나아가,
CNN 내부의 어떤 Unit이 특정 Class를 담당하는지를 분석했음.
기존 연구에서는
CNN의 Convolution Unit이
TextureMaterialObject PartObjectScene등 다양한 Visual Concept를 학습한다는 사실이 알려져 있었음.
그리고 Network가 깊어질수록
Unit들은 점점 더 의미 있는 Semantic Pattern을 학습하게 됨.
(초기 Layer는 Edge, Corner 같은 단순한 특징을 학습하지만, 깊은 Layer에서는 강아지 얼굴, 자동차 바퀴, 소파, 창문 같은 의미 있는 Object Part를 학습하게 됨. )
다만, 기존 CNN에서는
Fully Connected Layer 때문에
어떤 Unit이 어떤 Class에 중요한지 직접 확인하기 어려웠음.
이와 달리, CAM에서는
GAP와 Softmax Weight를 이용해서
특정 Class에서 중요한 Unit을 직접 확인할 수 있었음.
논문에서는 이런 Unit을
Class-Specific Unit이라고 정의했음.
Class-Specific Unit
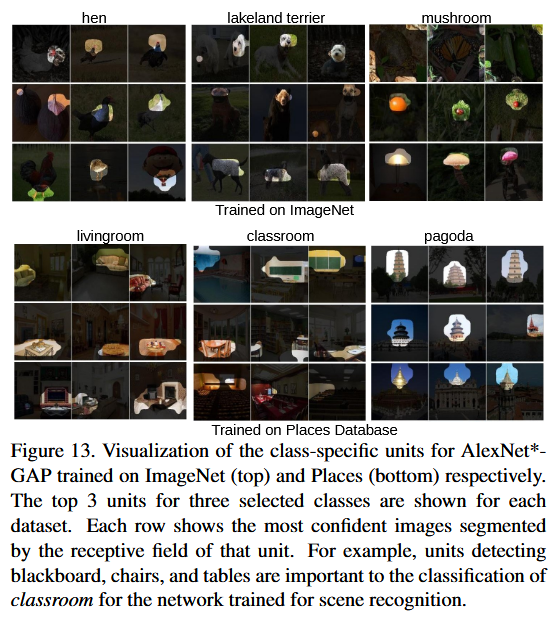
ex. Lakeland Terrier를 분류한다고 할 때,
CAM으로 분석한 결과,
다음과 같은 Unit들이 높은 중요도를 가졌음.
강아지 얼굴을 감지하는 Unit털(Texture)을 감지하는 Unit
=> Lakeland Terrier를 분류할 때는
위와 같은 Unit들이 가장 크게 기여했구나.
ex.Living Room을 분류하는 경우에는
Sofa, Table, Fireplace 같은 Unit들이 중요한 역할을 했음.
=> CNN은 Living Room이라는 하나의 Class를
소파, 테이블, 벽난로 같은 여러 Object Part의 조합으로 이해하고 있구나.
그리고 논문에서 이런 걸
Bag of Words 개념으로 설명했음.
: 각 Convolution Unit은
하나의 Visual Word를 학습하고,
이러한 Word들의 조합으로
최종 Class를 예측한다는 것.
[Dog]

↓

Face Unit

+

Ear Unit

+

Body Fur Unit
or
[Living Room]

↓

Sofa Unit

+

Fireplace Unit

+

Table Unit처럼
여러 Class-Specific Unit이 함께 활성화되어
최종 Classification이 이루어진다고 해석했음.
CAM은 CNN 내부의 어떤 Unit이
특정 Class를 담당하는지도 함께 분석할 수 있구나
= CNN 내부에서 어떤 Semantic Pattern들이
각각 어떤 역할을 수행하는지 직접 확인 가능.
🔚6. Conclusion
본 논문에서는
Global Average Pooling(GAP)을 사용하는 CNN에서
Class Activation Mapping(CAM)
기법을 제안했음.
CAM을 이용하면
Bounding Box Annotation 없이도
Classification만 학습한 CNN이
Object Localization을 수행할 수 있었음.
CAM은 이미지에서 CNN이 특정 Class를 예측할 때 중요하게 사용한 영역을 Heatmap 형태로 시각화함.
=> CNN이 어떤 근거를 바탕으로 판단했는지 직접 확인할 수 있었음.
ILSVRC Benchmark 실험 결과,
CAM 기반 Network는
Bounding Box Annotation 없이도
높은 Localization 성능을 달성했음.
그리고, CAM은
Weakly-supervised Object Localization뿐 아니라,
- Fine-grained Recognition
- Pattern Discovery
- Generic Feature Learning
등 다양한 Vision Task에도 효과적으로 적용될 수 있음을 확인했음.
정리하자면 CAM은,
- Global Average Pooling을 이용하여 Object Localization이 가능함을 처음으로 보였음.
- Bounding Box Annotation 없이 Weakly-supervised Localization을 수행했음.
- CNN이 어떤 영역을 보고 판단했는지 시각적으로 설명할 수 있었음.
- Localization 능력이 다양한 Vision Task에서도 일반화될 수 있음을 보였음.
- 이후 Grad-CAM을 비롯한 다양한 XAI 연구의 기반을 마련했음.
🔖 Reference
https://arxiv.org/abs/1512.04150
https://www.youtube.com/watch?v=aGIEVeaKLgY
https://cumulu-s.tistory.com/37
CAM은 Bounding Box 없이 어떻게 Localization이 가능할까?
CNN은 Classification만 학습했지만,
Object를 맞히려면 객체가 어디 있는지는 스스로 학습할 수밖에 없음.CAM은 이미 존재하는 이 정보를 시각화하는 과정.
그렇기에,
CNN에게 새로운 능력을 부여한 게 아니라,
CNN이 이미 학습한 Localization 능력을
눈으로 볼 수 있게 만든 것.
CAM은 모든 CNN에 사용할 수 있을까?
아님.
CAM은Conv ↓ GAP ↓ FC구조에서만 사용할 수 있음.
따라서
- AlexNet
- VGG
- GoogLeNet-GAP 처럼 GAP가 있는 모델에서만 사용 가능.
기존 ResNet이나 DenseNet도
GAP가 있으므로 CAM 적용이 가능하지만,
중간에 여러 FC Layer가 있는 구조에는 그대로 적용하기 어려움.
CAM의 한계는?
CAM은 구조적인 제약이 매우 큼.
- 반드시 GAP 구조가 필요함.
- 마지막 Conv Layer에서만 CAM 생성 가능함.
- Heatmap 해상도가 낮음.
- Multi-object 상황에서는 정확도가 떨어질 수 있음.
- Fine-grained Localization에는 한계가 있음.
