Paper: LIME: "Why Should I Trust You?": Explaining the Predictions of Any Classifier
🔍1. Introduction
최근 머신러닝은 다양한 분야에서 뛰어난 성능을 보이며 핵심 기술로 자리잡았음.
하지만 대부분의 연구는 모델의 정확도 향상에 집중했을 뿐,
정작 사람이 AI를 얼마나 신뢰할 수 있는지는 충분히 고려하지 않았음.
그래서 AI의 신뢰(Trust)를 크게 두 가지로 구분했음.
-
Prediction Trust
: 하나의 예측 결과를 믿고 실제 행동을 취할 수 있는가 -
Model Trust
: 모델 전체가 실제 환경에서도 정상적으로 동작할 것이라 믿을 수 있는가
논문에서 이 두 신뢰 모두
사람이 모델의 동작 원리를 얼마나 이해하는지에 의해 결정된다고 주장했음.
=> Black Box처럼 결과만 보여주는 AI는 신뢰하기 어렵고,
왜 그런 예측을 했는지 설명해주는 AI일수록 사람이 신뢰하기 쉬워진다는 것
또한 개별 예측뿐 아니라 모델 전체도 실제 환경에 배포하기 전에 신뢰성을 평가해야 함.
기존에는 Validation Dataset에서의 Accuracy를 중심으로 모델을 평가했지만,
실제 환경의 데이터는 Validation Dataset과 상당히 다를 수 있고,
Accuracy 또한 실 목표를 충분히 반영하지 못할 수도 있음.
따라서 논문에서는 Accuracy만 보는 게 아니라,
- 개별 예측 결과를 직접 살펴보고,
- 해당 예측에 대한 설명(Explanation)까지 함께 확인하는 것이 모델 평가 시 중요한 방법이라고 주장.
또한 데이터가 매우 큰 경우에는 모든 샘플을 확인할 수 없기 때문에,
어떤 샘플을 우선적으로 살펴봐야 하는지도 함께 제안해야 한다고 설명했음.
이를 위해 본 논문에서는 다음 두 가지를 제안했음.
- LIME
- 개별 예측(Individual Prediction)에 대해 설명을 생성해서 Prediction Trust 문제를 해결하는 방법- SP-LIME
- 대표성이 있는 여러 개의 샘플과 설명을 선택해서 Model Trust 문제를 해결하는 방법
마지막으로 저자들은 다양한 실험을 통해 LIME의 효과를 검증했음.
✅2. THE CASE FOR EXPLANATIONS
논문에서는 Prediction에 대한 설명(Explanation)이 머신러닝을 신뢰하고 효과적으로 활용하기 위한 핵심 요소라고 주장했음.
논문에서 Explanation이란
: 텍스트에서는 단어, 이미지에서는 이미지의 일부(Patch)처럼
입력의 어떤 요소가 모델의 예측에 어떤 영향을 줬는지를 사람이 이해할 수 있도록 시각적 또는 텍스트 형태로 보여주는 것을 의미.= 왜 이런 예측을 했는지를 사람이 이해할 수 있도록 만드는 과정.
논문에서는 Figure. 1을 통해 의료 진단 예시를 제시했음.
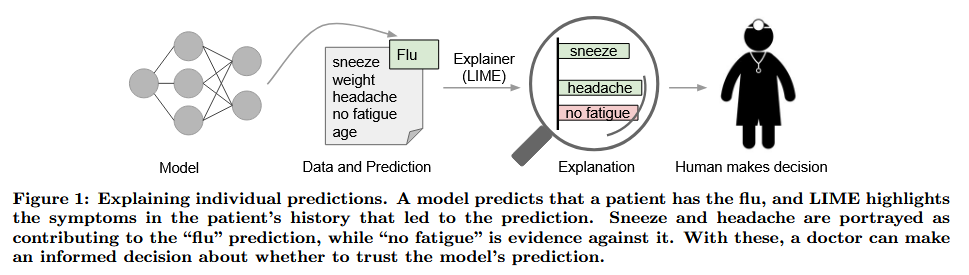
진단에 대한 설명이 없는 경우에는 의사가 모델의 예측 결과만 받아들이게 되지만,
설명이 함께 제공되면
어떤 증상이 예측에 긍정적으로 기여했고,
반대로 어떤 증상은 예측에 부정적인 영향을 준 건지 같이 확인 가능.
그렇게 사람은 자기 자신의 도메인 지식을 이용해서 이런 설명이 타당한지 판단하고,
예측을 신뢰하거나 거부할 수 있게 됨.
실제로 영화 추천 시스템이나 자동화 시스템에서도 설명을 제공하면 사용자의 수용도가 증가한다는 연구 결과가 소개됐음.
또한, Prediction Trust뿐 아니라 Model Trust도 중요하다고 설명했음.
기존에는 Validation Dataset에서 Accuracy를 측정해서 모델을 평가했지만,
실제 환경(In the Wild)의 데이터는 Validation Dataset과 상당히 다를 수 있고,
Accuracy만으로는 실제 성능을 충분히 판단하기 어려움.
따라서 Accuracy와 함께 개별 Prediction과 그에 대한 Explanation을 직접 살펴보는 것이 모델 평가에 도움이 된다고 주장했음.
데이터가 매우 큰 경우에는 모든 Prediction을 확인할 수 없기 때문에,
대표성이 있는 일부 Prediction을 선택해서 설명을 제공하는 것이 필요하다고 설명했음.
논문에서는 Explanation이 특히 유용한 대표적인 문제도 소개했음.
i) Data Leakage
Data Leakage
: 실제 서비스에서는 사용할 수 없는 정보가
실수로 학습 데이터와 Validation 데이터에 포함되는 현상을 의미함.
논문에서는 환자 ID(Patient ID)가 질병 여부와 높은 상관관계를 가지는 사례를 소개했음.
Prediction 결과만 보면 이러한 문제를 발견하기 어렵지만,
Explanation을 보면 Patient ID가 중요한 Feature로 나타나므로
모델이 잘못된 근거를 이용하고 있다는 사실을 쉽게 확인할 수 있음.
ii) Dataset Shift
Dataset Shift
: 학습 데이터와 실제 테스트 데이터의 분포가 달라지는 문제.
Validation Accuracy는 높더라도
실제 환경에서는 성능이 크게 떨어질 수 있음.
=> Explanation을 통해 모델이 어떤 Feature를 근거로 판단하는지 확인하면
Dataset Shift 문제를 발견하고,
학습 데이터를 수정해야 하는지 판단하는 데 도움이 됨.
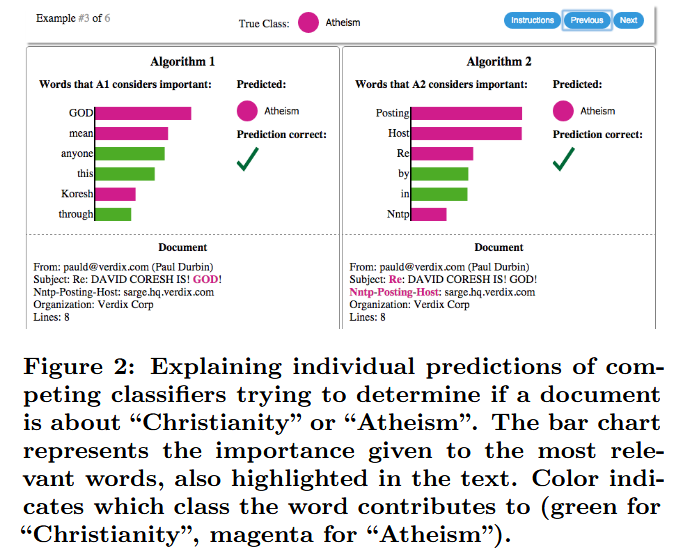
논문에서는 여러 모델 중 하나를 선택해야 하는 상황에서도
Explanation이 중요하다고 설명했음.
- Validation Accuracy가 더 높은 모델이라도
잘못된 Feature를 근거로 예측하고 있다면
실제 환경에서는 오히려 더 나쁜 모델일 수 있고, - Accuracy는 조금 낮더라도
사람이 신뢰할 수 있는 Feature를 사용하는 모델이
실제 서비스에서는 더 좋은 선택이 될 수도 있음.
그러므로 Explanation이라는 것은
왜 이 Prediction이 나왔는지 설명하는 역할도 하고,
모델 신뢰성 평가Data Leakage 탐지Dataset Shift 발견모델 선택(Model Selection)에도 중요한 역할을 한다는 것
Desired Characteristics for Explainers
논문에서는 좋은 Explanation Method가 갖춰야 할 주요 조건을 하단과 같이 정리했음.
i) Interpretability
Explanation은 사람이 입력 변수와 모델의 출력 사이의 관계를 이해할 수 있도록 제시되어야 함.
다만 단순히 모델의 Weight나 Gradient를 보여준다고 해서 반드시 해석 가능한 건 X.
ex. Prediction에 수백 개 또는 수천 개의 Feature가 중요하게 작용했다면,
각 Feature의 Weight를 확인할 수 있더라도 사람이 전체 예측 과정을 이해하기는 어려움.
=> Explanation은 사용자가 감당할 수 있을 정도로 단순하고 이해하기 쉬워야 함.
또한 모델이 실제로 사용하는 Feature가 사람에게 이해하기 어려운 형태일 수 있기 때문에,
Explanation에서 사용하는 입력 표현은 원래 모델의 Feature와 다를 수도 있음.
그리고 Interpretability는 설명을 보는 대상에 따라서도 달라짐.
머신러닝 전문가는 작은 Bayesian Network를 이해할 수 있음.
일반 사용자는 소수의 Feature와 각각의 Weight를 제시한 설명을 더 쉽게 이해할 수 있음.
=> 따라서 Interpretation은 모델 자체만의 특성이 아니라,
설명 제공받는 사용자의 지식과 한계까지 고려해야 하는 개념임.
ii) Local Fidelity
Explanation은 최소한 현재 설명하려는 Instance 주변에서
원래 모델의 동작을 충실하게 반영해야 함.
복잡한 모델 전체를 완벽하게 설명하려면
모델 자체를 그대로 보여줘야 할 수도 있기 때문에,
해석 가능하면서도 모델 전체에 완전히 충실한 설명을 만드는 것은 어려움.
=> LIME은 모델 전체를 한 번에 설명하는 대신,
현재 설명하려는 하나의 Prediction 주변에서 모델이 어떻게 동작하는지를 충실하게 설명하고자 함.
= Local Fidelity
이때 Local Fidelity는 Global Fidelity 의미 X.
- 모델 전체에서 중요한 Feature가 특정 Instance에서는 중요하지 않을 수 있음.
- 특정 Instance에서 중요한 Feature가 모델 전체에서는 중요하지 않을 수 있음.
Global Fidelity를 만족하면 Local Fidelity도 만족할 수 있지만,
복잡한 모델에 대해 해석 가능하면서 Global Fidelity까지 가지는 설명을 찾는 것은 매우 어려움.
iii) Model-Agnostic
Explanation Method는 특정 모델 구조에 종속되지 않고
어떤 모델에도 적용할 수 있어야 함.= Model-Agnostic
- Model-Agnostic Explainer는 원래 모델의 내부 구조를 직접 분석 X.
- 모델을 Black Box처럼 취급함.
=> Explainer가 알아야 하는 것은,
Input
↓
Black-box Model
↓
Prediction
모델 내부의 Layer, Parameter, Gradient 등을 알지 못해도
입력에 대한 예측값만 얻을 수 있다면 Explanation을 생성할 수 있어야 함.
그런데 이 부분은 현재 사용되는 많은 고성능 Classifier가 본질적으로 해석하기 어렵기 때문이며,
앞으로 새롭게 등장할 모델에도 동일한 Explanation Method를 적용할 수 있다는 장점이 있음.
iv) Global Perspective
개별 Prediction 하나에 대한 Explanation만으로는
모델 전체를 신뢰할 수 있는지 판단하기 어려움.
앞에서 설명했듯,
Validation Accuracy만으로도 모델 전체의 신뢰성을 충분히 평가할 수 없음.
=> 모델이 전반적으로 어떤 Feature를 사용하고
어떤 방식으로 Prediction을 수행하는지 이해할 수 있도록
Global Perspective를 제공해야 함.
논문에서는 이걸 위해서 여러 개의 개별 Prediction을 모두 보여주는 대신,
모델의 동작을 대표할 수 있는 소수의 Prediction과 Explanation을 선택해 사용자에게 제시하고자 했음.
LIME
: 하나의 Prediction 주변에서 Black-box Model을 단순하고 해석 가능한 모델로 근사해서 Local Explanation을 제공
=> 하나의 Prediction을 설명
SP-LIME
: 대표적인 Explanation을 선택해서 모델 전체에 대한 이해를 제공하는 방식
=> 대표적인 여러 Prediction을 선택해, 모델 전체를 설명
정리하자면,
좋은 Explainer는 다음 조건을 만족해야 함.
i) Interpretable
: 사람이 이해할 수 있는 단순한 형태로 설명해야 함.
ii) Locally Faithful
: 설명하려는 Instance 주변에서 원래 모델의 동작을 충실하게 반영해야 함.
iii) Model-Agnostic
: 특정 모델 구조에 의존하지 않고 모든 모델에 적용할 수 있어야 함.
iv) Global Perspective
: 대표적인 여러 Explanation을 통해 모델 전체의 동작도 이해할 수 있도록 해야 함.
✅3. LOCAL INTERPRETABLE MODEL-AGNOSTIC EXPLANATIONS
3.1. Interpretable Data Representations
LIME에서 가장 먼저 강조하는 것
: 모델이 사용하는 Feature와 사람이 이해할 수 있는 Feature는 서로 다를 수 있다는 점.
본 논문에서는 사람이 이해할 수 있는 형태의 입력을 Interpretable Representation(해석 가능한 표현) 이라고 정의했음.
설명(Explanation)은 모델 내부에서 사용하는 Feature가 아니라,
사람이 직관적으로 이해할 수 있는 형태로 제공되어야 함.
ex. Text Classification
- 모델은 Word Embedding과 같은 고차원 Feature를 사용할 수 있음.
- 다만 Explanation에서는 단순히 단어가 존재하는지(1) 또는 존재하지 않는지(0) 만 보여주는 것이 훨씬 이해하기 쉬움.
Model Input
↓

Word Embedding
↓

Classifier
↓
Explanation

Word A : O
Word B : X
Word C : O
Image Classification도 같은 개념.
- 모델은 이미지를 RGB Pixel Tensor 형태로 입력받지만,
- 사람은 Pixel 하나하나를 보고 이해하지 않음.
=> 본 논문에서는 이미지를 비슷한 색상과 질감을 가진 영역(Superpixel)으로 분할,
=>각 영역의 존재 여부를 이용해 설명을 생성했음.
Original Image

↓

Superpixel Segmentation

↓

Superpixel 1 : ON
Superpixel 2 : OFF
Superpixel 3 : ON
...
그래서 논문에서 하고 싶은 말은
모델이 실제 사용하는 입력과 사람이 이해하는 입력은 서로 다르고
LIME은 사람이 이해하기 쉬운 Representation 위에서 Explanation을 생성하는 것.
그래서
- 원래 모델 입력을
x- 사람이 이해하는 입력을
x'(Interpretable Representation)로 구분해서 정의했음.
[Original Representation]
x ∈ R^d

↓

[Interpretable Representation]

x' ∈ {0,1}^{d'}
처럼 표현함.
이후 LIME의 모든 Explanation은 원래 입력
x가 아니라,
사람이 이해할 수 있는x'공간에서 생성됨.
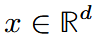
이게 원래 입력 정의
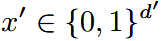
이게 사람이 이해할 수 있는 해석 가능한 표현
(이진 벡터로 정의)
3.2. Fidelity-Interpretability Trade-off
본 논문에서는 Explanation을 하나의 해석 가능한 모델 g로 정의했음.
즉, LIME은 복잡한 원래 모델 f를 그대로 설명하려는 것이 아니라,
현재 설명하려는 입력 x 주변에서 원래 모델과 비슷하게 동작하는 단순한 모델 g를 새로 학습함.
여기서 g는 다음과 같이 사람이 이해하기 쉬운 모델 중 하나가 될 수 있음.
- Linear Model
- Decision Tree
- Falling Rule List
본 논문에서는 이후 실험에서 주로 Sparse Linear Model을 Explanation으로 사용했음.
Explanation Model 'g'
설명 모델 g는 원래 입력 공간이 아니라,
앞 절에서 정의한 Interpretable Representation 공간에서 동작함.
즉,
[Original Model f]
Input : x ∈ R^d
와 달리,
[Explanation Model g]
Input : x' ∈ {0,1}^{d'}
형태임.
텍스트라면 각 단어의 존재 여부,
이미지라면 각 Superpixel의 존재 여부를 입력으로 사용함.
Explanation의 복잡도 Ω(g)
해석 가능한 모델 집합 g에 포함된 모델이라고 해서
모든 모델이 실제로 사람이 이해할 만큼 단순한 것은 아님.
예를 들어 Decision Tree가 너무 깊거나,
Linear Model에서 수백 개의 Feature Weight가 모두 0이 아니면
사람이 Explanation을 이해하기 어려움.
따라서 본 논문에서는 Explanation Model의 복잡도를 나타내는 함수로
Ω(g)를 정의했음.
모델 종류에 따라 복잡도는 다르게 측정할 수 있음.
-
Decision Tree
- Tree Depth를 복잡도로 사용할 수 있음. -
Linear Model
- 0이 아닌 Weight의 개수를 복잡도로 사용할 수 있음.
즉, Ω(g)가 클수록 Explanation이 복잡하고,
작을수록 사람이 이해하기 쉬운 Explanation이 됨.
원래 모델 'f'
본 논문에서는 설명하고자 하는 원래 Black-box Model을
로 정의했음.
Classification에서는 f(x)가 입력 x가 특정 Class에 속할 확률,
또는 해당 Class에 속하는지를 나타내는 Binary Indicator가 됨.
여러 Class가 존재하는 경우에는
각 Class를 따로 설명하는 방식으로 접근했음.
Proximity Measure πx(z)
LIME은 모델 전체가 아니라,
현재 설명하려는 입력 x 주변의 동작만 설명하는 Local Explanation Method임.
이를 위해 입력 x와 다른 샘플 z가 얼마나 가까운지를 나타내는 함수로
πx(z)를 사용했음.
그러므로,
[z가 x와 가까움]
> πx(z)가 큼

[z가 x와 멂]
> πx(z)가 작음
으로 설정됨.
따라서 설명 모델 g를 학습할 때
현재 입력 x와 가까운 샘플의 동작을 더 중요하게 반영함.
Local Fidelity Loss L(f, g, πx)
설명 모델 g가 원래 모델 f를
현재 입력 x 주변에서 얼마나 잘 근사하는지를 측정하기 위해
L(f, g, πx)를 사용했음.
이 값은 설명 모델이 원래 모델과 얼마나 다르게 동작하는지를 나타내는 Loss임.
[L이 작음]
> x 주변에서 g가 f를 잘 따라감

[L이 큼]
> x 주변에서 g가 f를 제대로 설명하지 못함
여기서 πx가 함께 들어가기 때문에,
모든 샘플을 동일하게 평가하지 않고
x와 가까운 샘플에서의 오차를 더 중요하게 봄.
Fidelity와 Interpretability의 Trade-off
좋은 Explanation을 만들려면 두 조건을 동시에 만족해야 함.
- 원래 모델의 동작을 잘 따라가야 함.
- 사람이 이해할 수 있을 만큼 단순해야 함.
다만 일반적으로 모델을 복잡하게 만들수록
원래 Black-box Model을 더 정확하게 근사할 수 있고,
모델을 단순하게 만들수록
사람이 이해하기는 쉬워지지만 원래 모델과의 차이가 커질 수 있음.
즉,
높은 Fidelity <-> 높은 Complexity사이에 Trade-off 존재.
LIME은 이 두 조건을 동시에 고려해서
다음 목적함수를 최소화하는 Explanation Model을 선택함.
각 항의 의미는 하단과 같음.
L(f,g,πx)
: x 주변에서 g가 f를 얼마나 잘 근사하는가

Ω(g)
: g가 사람이 이해할 수 있을 만큼 단순한가
=> LIME
: 현재 입력 주변에서 원래 모델과 최대한 비슷하게 동작하면서도,
사람이 이해할 수 있을 만큼 단순한 모델을 Explanation으로 선택함.
정리해 보자면,
LIME의 Explanation
: 현재 입력 x 주변에서 Black-box Model f를 근사하도록 학습된
별도의 Interpretable Model g임.
LIME의 목적함수는 하단 두 조건의 균형을 찾는 문제임.
Local Fidelity
+
Interpretability
즉, 원래 모델을 잘 따라가면서
설명 모델은 최대한 단순하게 만들기가 중요
3.3. Sampling for Local Exploration
앞 절에서는 LIME의 목적이
"현재 입력 주변(Local)에서 원래 모델을 잘 근사하면서도,
사람이 이해하기 쉬운 Explanation Model을 찾는 것" 이라고 정의했음.
하지만 LIME은 Model-Agnostic Method이기 때문에,
원래 모델의 내부 구조나 Parameter를 전혀 알 수 없음.
즉,
Input
↓

Black-box Model

↓

Prediction 만 사용할 수 있다는 것.
따라서 원래 모델이 현재 입력 주변에서 어떻게 동작하는지를 직접 분석할 수 없고,
이를 대신하기 위해 Sampling(Perturbation)을 사용했음.
Local Sampling
본 논문에서는 현재 설명하려는 입력 x 주변에
여러 개의 새로운 Sample을 생성했음.
ex. Text Classification이라면
[Original]

God Jesus Bible Church
↓
[Sample 1]

God Jesus Church
↓
[Sample 2]

God Bible
↓
[Sample 3]

Jesus Church 처럼 일부 단어를 제거한 새로운 Sample을 생성함.
Image Classification에서는
Superpixel을 제거하거나 유지하는 방식으로 새로운 이미지를 생성함.
즉,
Original Image

↓

Superpixel 일부 제거

↓

새로운 Image 생성
을 반복 수행하는 것.
Black-box Model Query
Sampling으로 생성한 각각의 Sample은
다시 원래 Black-box Model에 입력됨.
Perturbed Sample

↓

Black-box Model

↓

Prediction
=> LIME
: 모델 내부 분석 X.
입력을 조금 바꿨더니 Prediction이 어떻게 변했는지만 관찰 O.
Local Weight
생성된 모든 Sample을 동일하게 사용하는 것은 아님.
현재 설명하려는 입력 x와 가까운 Sample일수록
더 중요한 정보라고 판단함.x와 매우 비슷한 Sample ↓ 큰 Weight반대로
x와 매우 다른 Sample은
현재 Prediction을 설명하는 데 큰 의미가 없으므로
작은 Weight를 부여함.x와 많이 다른 Sample ↓ 작은 Weight 로 학습 수행.
이때 Weight는 앞 절에서 정의한
πx(z)를 이용해서 계산됨.
Explanation Model 학습
Sampling을 통해 얻은
Perturbed SampleBlack-box Model PredictionLocal Weight
를 이용해서
Sparse Linear Model을 새롭게 학습함.
이 모델이 바로
현재 입력 x에 대한 Explanation Model이 됨.
결론적으로
Original Input x

↓

Sampling

↓

Perturbed Samples

↓

Black-box Prediction

↓

Weighted Linear Regression

↓

Explanation
의 과정으로 LIME이 동작하는 것.
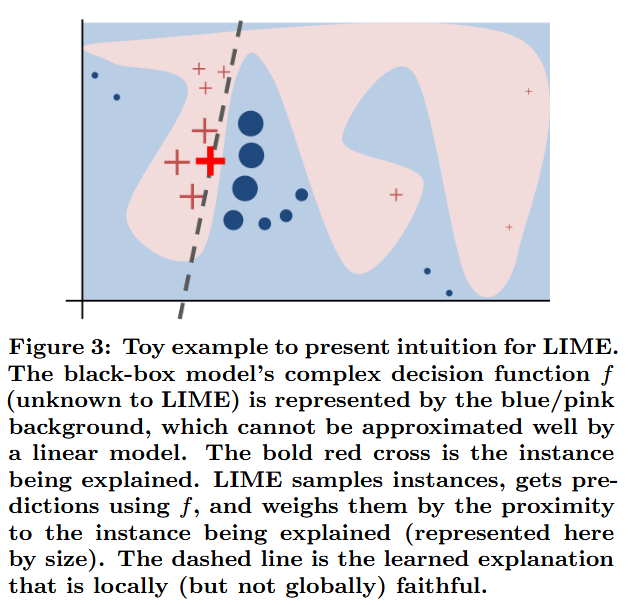
위 Figure. 3에서는
현재 입력 x 근처와 먼 곳에서 모두 Sample을 생성하지만,
가까운 Sample에는 큰 Weight,
먼 Sample에는 작은 Weight를 부여하는 모습을 보여줌.
원래 Black-box Model이
전체적으로 매우 복잡한 Decision Boundary를 가지더라도,현재 입력 주변에서는
단순한 Linear Model 하나로 충분히 근사할 수 있음.=> LIME은 모델 전체를 설명하는 게 아니라,
현재 Prediction 주변에서만 원래 모델과 최대한 비슷하게 동작하는 Explanation을 생성하는 것
정리하자면,
- LIME은 원래 모델의 내부 구조를 분석하지 않음.
- 대신 현재 입력 주변에서 여러 개의 Perturbed Sample을 생성하고,
각 Sample에 대한 Black-box Model의 Prediction을 이용해서
현재 입력 주변에서만 원래 모델을 근사하는Local Linear Model을 학습함.
Sampling

↓

Black-box Prediction

↓

Local Linear Approximation

↓

Explanation
이게 LIME 알고리즘의 주 idea인 것.
3.4. Sparse Linear Explanations
앞에서는 Sampling을 통해
Perturbed SampleBlack-box Model의 PredictionSample Weight
를 생성하는 과정을 설명했고,
이번에는 이런 데이터를 이용해서
실제로 Explanation Model을 어떻게 학습하는지를 설명함.
Sparse Linear Model
본 논문에서는 Explanation Model로
Sparse Linear Model을 사용했음.
그렇기에, Explanation은 하단과 같은 Linear Model 형태로 표현됨.
- : 각 Feature의 Weight
- : Interpretable Representation
= 각 Feature가 Prediction에 얼마나 기여했는지를
Weight 하나로 표현하는 매우 단순한 모델임.
Local Loss
앞 절에서 정의한 Local Fidelity를 실제로 계산하기 위해
Locally Weighted Square Loss를 사용했음.
즉,
Sampling으로 생성한 모든 Sample에 대해
원래 Black-box Model의 PredictionExplanation Model의 Prediction
차이를 계산하고,
현재 입력 x와 가까운 Sample일수록
더 큰 Weight를 부여하여 Loss를 계산했음.
Prediction 차이 계산

↓

가까운 Sample은 크게 반영

↓

먼 Sample은 작게 반영
이라는 구조인 것임.
Proximity Weight
Sample Weight는 하단과 같이 정의했음.
- : x와 z 사이의 거리
- : Kernel Width
Distance가 작을수록
가 커지고,
Distance가 멀어질수록
Weight는 급격하ㅓ게 감소함.
현재 Prediction 주변(Local)에서의 동작을
가장 중요하게 학습하도록 설계한 것.
본 논문에서는
- Text → Cosine Distance
- Image → L2 Distance
를 사용했음.
Explanation Complexity
Explanation은 사람이 이해할 수 있을 만큼 단순해야 하므로,
Text에서는
Bag-of-Words에서 사용할 단어 개수를
K개 이하로 제한했음.
Word Importance

↓

상위 K개 단어만 사용
하도록 제한했음.
Image도 똑같이
Superpixel 가운데 상위 K개만 Explanation에 포함했음.
설명이 너무 복잡해지는 것을 방지하려고
Feature 개수 자체를 제한한 것.
K-LASSO
다만
Feature 개수를 직접 제한하면서
최적의 Linear Model을 찾는 건 계산량이 매우 큼.
따라서 본 논문에서는
직접 최적화를 수행하는 대신
K-LASSO라는 근사 방법을 사용했음.
[K-LASSO는 두 단계로 이루어짐.]
① LASSO를 이용햐서 중요한 Feature K개를 선택함.
↓
② 선택된 Feature만 이용해서 Least Squares Regression으로
최종 Weight를 다시 계산함.
Sampling

↓

LASSO

↓

중요 Feature 선택

↓

Least Squares

↓

최종 Explanation
이라는 순서로 동작하는 것.
실행 시간
LIME은 Dataset 전체를 학습하는 게 아니라,
Prediction 하나마다 Explanation을 생성함.
따라서 계산량은 Dataset 크기가 아니라
Sampling 개수 NBlack-box Model의 Prediction 속도
에 의해 결정됨.
논문에서는
Random Forest(1000 Trees)의 경우
N=5000일 때
3초 이하로 Explanation을 생성할 수 있었음.
반면
Google Inception Network는
Prediction 하나를 설명하는 데
약 10분 정도가 소요됐음.
LIME의 한계
본 논문에서는 두 가지 한계도 함께 언급했음.
[첫 번째]
: Interpretable Representation 자체의 한계.
ex.
Sepia Tone 때문에
Retro 사진으로 분류하는 모델이라면,
Superpixel의 존재 여부만으로는
왜 그렇게 분류했는지 설명하기 어려울 수 있음.
=> 사람이 사용하는 Representation이
모든 모델의 동작을 완벽하게 표현하지는 못함.
[두 번째]
: Explanation Model을 Sparse Linear Model로 선택했다는 것.
만약 현재 Prediction 주변에서도
원래 모델이 엄청 복잡한 Non-linear Decision Boundary를 가진다면,
Linear Model만으로는
원래 모델을 충분히 근사하지 못할 수도 있음.
= Local Fidelity가 낮아질 가능성이 있음.
본 논문에서는
Sampling Dataset에서의Fidelity를 측정해서
Explanation의 신뢰도를 함께 제공할 수 있다고 설명했음.
그리고 앞으로는
Linear Model뿐 아니라
다른 형태의 Explanation Model도 사용할 수 있을 것이라고 제안했음.
정리하자면,
이번에는 Sampling으로 생성한 Dataset을 이용해서
Sparse Linear Model을 실제로 학습하는 방법을 설명했음.
그리고 LIME은
- 가까운 Sample에 큰 Weight를 부여하는
Local Loss사용하고,- 사람이 이해하기 쉽도록
Feature 개수를 K개로 제한하고,K-LASSO이용 > 중요한 Feature 선택하고,Least Squares Regression으로 최종 Explanation을 생성했음.
Sampling

↓

Weighted Loss

↓

LASSO

↓

Top-K Feature

↓

Linear Regression

↓

Explanation
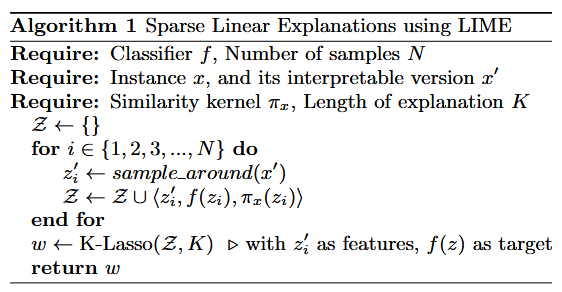
요게 이번 절 전체 알고리즘.
3.5 Example 1: Text classification with SVMs
본 논문에서는 LIME의 활용 사례로
20 Newsgroups Dataset을 이용한 Text Classification 실험을 수행함.
실험에서는
- Christianity
- Atheism
두 개의 클래스를 분류하는 문제를 사용했고,
Classifier는 RBF Kernel을 사용하는 SVM을 사용했음.
높은 Accuracy ≠ 신뢰할 수 있는 모델
해당 SVM은 Validation Dataset에서
94%의 높은 Accuracy를 기록했음.
Accuracy만 보면 굉장히 우수한 모델처럼 보이고,
충분히 신뢰할 수 있을 거라고 생각하기 쉬움.
다만, LIME으로 Prediction을 설명해 본 결과,
모델이 엄청 엉뚱한 Feature를 이용해서 Prediction을 수행하고 있다는 사실을 확인했음.
Explanation을 통해 문제를 살펴 보자면
LIME Explanation에서는
다음과 같은 단어들이 Prediction의 중요한 근거로 나타났음.
PostingHostRe
하지만 이런 단어들은
Christianity나 Atheism이라는 주제와는 전혀 관련이 없는 단어들임.
그러니 모델은 문서의 실제 내용을 이해한 게 아니라,
본문과 관계없는 단어를 이용하여 Prediction을 수행하고 있었던 것.
왜 이런 현상이...
본 논문에서는
"Posting"이라는 단어가
학습 데이터의 22%에서 등장했고,
그 중 99%가 Atheism 클래스에 포함되어 있었다고 설명했음.
그러니, 모델은
Posting

↓

Atheism
이라는 단순한 상관관계를 학습한 것.
근데 이건 문서의 진짜 의미를 이해한 게 아니라,
학습 데이터에 존재하던 우연한 패턴을 이용한 결과일 뿐임.
Header를 제거해도 문제는 남아있음
논문에서는
Header를 제거한 이후에도 문제가 해결되지 않았다고 설명했음.
그래서 이번에는
Original Newsgroup에서 활동하던
특정 작성자의 이름(Proper Name)을
Classifier가 중요한 Feature로 사용했음.
Header를 제거해도
모델은 여전히 문서의 의미가 아니라
데이터에 존재하는 우연한 특징을 학습하고 있었던 것임.
Prediction 결과만 보면
이런 문제를 발견하기 매우 어려움.
그리고 Raw Data만 확인해서도
왜 모델이 그렇게 Prediction했는지를 알기 어려움.
다만 LIME Explanation을 확인하면
모델이 어떤 Feature를 근거로 Prediction을 수행했는지가 직접 나타나기 때문에,
Dataset 자체의 문제Feature 선택 문제모델이 잘못 학습한 이유
를 쉽게 파악할 수 있음.
정리하자면
본 논문에서는
해당 SVM은 Validation Accuracy가 매우 높았음에도,
Prediction의 근거를 확인해보면
신뢰하기 어려운 모델이라는 사실을 보여줬음.
근데 LIME은 Prediction을 설명하면서,
모델이 잘못된 Feature를 학습했는지 확인하고,
Dataset의 문제도 발견하면서,
더 신뢰할 수 있는 모델을 만들기 위한 개선 방향을 제시하는 도구로 활용될 수 있음을 보여주었음.
3.6 Example 2: Deep networks for images
본 논문에서는 이미지 분류에서도
LIME이 효과적으로 Explanation을 생성할 수 있음을 보여줬음.
Image Classification에서는
Sparse Linear Model의 Weight 중에
현재 Class의 Prediction에 긍정적으로 기여한 Superpixel만 강조하면서
Explanation을 생성했음.
Prediction을 높이는 Superpixel만 남기고,
나머지 영역은 회색(Gray)으로 처리해서
모델이 어떤 영역을 근거로 Prediction을 수행했는지 직관적으로 보여준 것.
Image Explanation
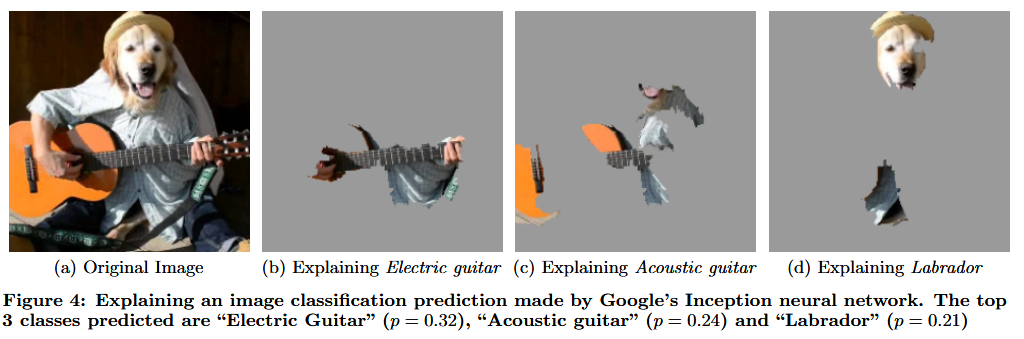
실험에서는
Google의 Pre-trained Inception Network를 사용했고,
임의의 이미지에 대해
LIME으로 Explanation을 생성했음.
그리고,
Prediction Score가 가장 높은
Top-3 Class에 대해 각각 Explanation을 생성해서 비교했음.
이때
설명에 포함되는 Superpixel의 개수는
K = 10으로 설정했음.
= Prediction에 가장 크게 기여한 상위 10개의 Superpixel만 표시한 것.
각 Class마다 Explanation이 달라짐,
같은 이미지라도
Prediction하려는 Class가 달라지면,
중요하게 사용하는 Superpixel도 함께 달라졌음.
> LIME은
Class마다 Prediction의 근거가 되는 영역을
별도로 설명할 수 있다는 것.
Acoustic Guitar Example
논문에서는
Inception Network가 Acoustic Guitar를 Electric Guitar로 잘못 분류한 사례를 제시했음.(Figure. 4 참고)
근데 LIME Explanation을 확인해보면,
모델은 기타의 Fretboard(지판) 부분을 중요하게 사용해서
Prediction을 수행하고 있었음.
그니까 Prediction 자체는 틀렸지만,
모델이 주목한 영역은
사람이 보더라도 충분히 타당한 영역이었다는 것.
물론 Prediction이 항상 정답일 필요는 없으나,
중요한 것은 모델이 비합리적인 근거가 아니라,
사람도 이해할 수 있는 합리적인 특징을 이용해서
Prediction을 수행했는지를 확인하는 것.
Prediction이 틀린 경우에도
Explanation을 통해
모델이 정상적인 근거를 이용해서 판단했다는 사실을 확인할 수 있고,이런 정보가 모델에 대한 신뢰(Trust)를 높이는 데 도움이 된다고 설명했음.
정리하자면,
이미지 분류에서도 LIME을 이용해서
Prediction에 기여한 Superpixel만 선택적으로 강조할 수 있음을 보여주었음.
그리고 같은 이미지라도
Class마다 서로 다른 Explanation이 생성되고,
Prediction이 틀린 경우에도
모델이 어떤 근거를 이용했는지를 사람이 이해할 수 있기 때문에
모델의 동작을 신뢰하는 데 도움이 될 수 있음을 확인했음.
✅4. SUBMODULAR PICK FOR EXPLAINING MODELS
앞에서의 LIME은 하나의 Prediction(Local Explanation)을 설명하는 방법이었음.
다만 Prediction 하나만 설명해서는
모델 전체(Model Trust)를 이해하기에는 부족함.
하나의 샘플에서는 정상적으로 설명이 생성되더라도,
다른 샘플에서는 전혀 다른 Feature를 사용할 수도 있기 때문임.
그래서 본 논문에서는
여러 개의 대표적인 Explanation을 선택하여 모델 전체를 이해하는 방법을 추가로 제안함.
이것이 바로 SP-LIME(Submodular Pick LIME)
왜 여러 개의 Explanation이 필요하냐면
모델 전체를 이해하려면
여러 Prediction에 대한 Explanation을 살펴볼 필요가 있음.
다만 실제 사용자는
수백 개의 Explanation을 모두 확인할 수 없음.
그래서 논문에서는
사용자가 확인할 수 있는 Explanation 개수를
Budget(B) 라는 개념으로 정의했음.
Budget = 사용자가 확인할 수 있는 최대 Explanation 개수라고 정의한 것
ex. B = 10
: 사용자는 최대 10개의 Explanation만 확인한다고 가정한다는 것.
어떤 Explanation을 선택해야 하는지
당연히 아무 Explanation이나 B개 선택하면 안 됨.
논문에서는 좋은 Explanation 집합이 하단 두 조건을 만족해야 한다고 설명했음.
① Representative
모델이 사용하는 중요한 Feature들을 최대한 많이 포함해야 함.
= 모델의 전반적인 동작을 대표할 수 있어야 함.
② Non-redundant
비슷한 Explanation을 여러 개 선택하면 안 됨.
ex.[Explanation 1] Dog Ear Face[Explanation 2] Dog Ear Face를 모두 선택하는 건 새로운 정보를 거의 제공하지 못함.
반면
[Explanation 3]

Tail
Grass
Leash
처럼
다른 Feature를 사용하는 Explanation을 선택하는 게
모델을 이해하는 데 훨씬 도움이 됨.
=> SP-LIME
: 중복은 최소화하면서 다양한 Feature를 보여주는 Explanation을 선택하는 것을 목표로 함.
Explanation Matrix W
본 논문에서는 모든 Explanation을 하나의 행렬 W로 표현했음.
          Feature1 Feature2 Feature3 ...

Sample1      W11      W12      W13

Sample2      W21      W22      W23

Sample3 W31 W32 W33-
행(Row)
- 하나의 Instance -
열(Column)
- 하나의 Interpretable Feature -
값(Wij)
- 해당 Feature가 그 Prediction에서 얼마나 중요한지 의미.
Linear Model에서는
=> LIME Linear Model의 Weight 절댓값을 그대로 사용했음.
= Weight가 클수록 해당 Feature가 Prediction에 더 중요한 역할을 했다는 의미.
Global Feature Importance
각 Feature가
모델 전체에서 얼마나 자주 중요한 역할을 하는지를 계산하기 위해
Feature Importance 를 정의했음.
Text Classification에서는 하단과 같이 계산했음.
=> 많은 Instance에서 반복적으로 등장하는 Feature일수록 Global Importance가 커짐.
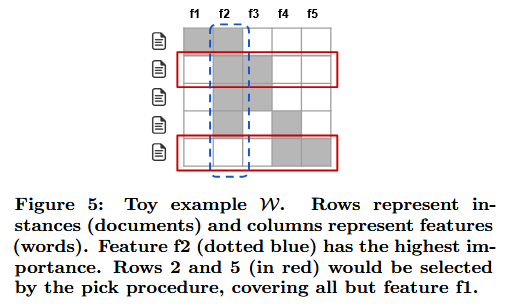
ex. Feature f2가 20개의 Explanation에서 사용되고,
Feature f1이 3개의 Explanation에서만 사용된다면,
I2 > I1이 됨.
= 모델 전체에서 자주 사용되는 Feature를
더 중요한 Feature라고 판단한 것임.
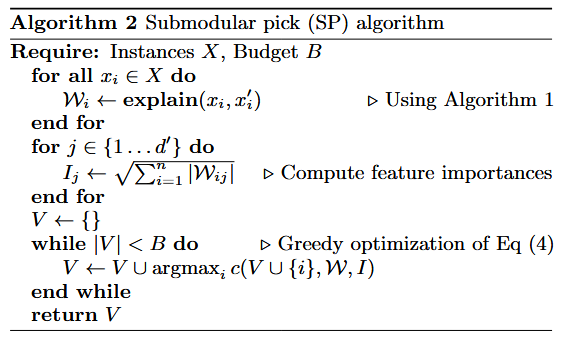
Coverage
좋은 Explanation 집합은
중요한 Feature를 최대한 많이 포함해야 함.
이를 정량적으로 표현하기 위해
논문에서는
Coverage Function을 정의했음.
Coverage는
선택한 Explanation 집합 V가
얼마나 많은 중요한 Feature를 포함하고 있는지를 나타냄.
중요한 Feature 많이 포함

↓

Coverage 증가
하게 됨.
SP-LIME의 목표
최종 목표
: Budget B 안에서
Coverage가 가장 큰 Explanation 집합을 선택하는 것.
그래서 하단을 해결하는 문제로 정의했음.
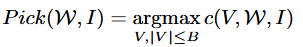
왜 Submodular Pick인가?
Coverage를 최대화하는 문제는
NP-hard Problem.
= 모든 경우를 탐색하면 연산량이 엄청 커짐.
그래서 논문에서는 Greedy Algorithm*을 사용했음.
*Greedy Algorithm
: 매 단계마다 Coverage를 가장 많이 증가시키는 Explanation 하나를 선택하는 방법.Start ↓ Coverage 증가량이 가장 큰 Explanation 선택 ↓ 다음 Explanation 선택 ↓ Budget B개까지 반복으로 수행됨.
논문에서는 이 방법을 Submodular Pick(SP-LIME) 이라고 정의했음.
그리고, Submodular Function의 성질을 이용하면 Greedy Algorithm만으로도
최적해의 이상의 성능이 이론적으로 보장된다고 설명했음.
정리하자면,
LIME은 하나의 Prediction을 설명하는 Local Explanation Method임.
다만, 모델 전체를 이해하기 위해서는 여러 개의 Explanation 必.
따라서 논문에서는
사용자가 확인 가능한 개수(Budget) 안에서
- 중요한 Feature를 최대한 많이 포함하고
- 서로 중복되지 않는
대표적인 Explanation들을 선택하는 SP-LIME(Submodular Pick LIME) 제안.
LIME

↓

하나의 Prediction 설명

(Local Explanation)

↓

SP-LIME

↓

대표적인 여러 Prediction 선택

↓

모델 전체 이해

(Global Understanding)
✅5. SIMULATED USER EXPERIMENTS
5.1. Experiment Setup
LIME이 실제로 얼마나 효과적인 Explanation을 생성하는지 검증하기 위해
여러 가지 머신러닝 모델과 데이터셋을 이용해서 실험을 수행했음.
실험에는 Product Review Sentiment Analysis Dataset을 사용했고,
BooksDVDs
위 두 개의 데이터셋을 이용해서
리뷰를
PositiveNegative로 분류하는 Binary Classification 문제를 구성했음.
각 데이터셋은 총 2,000개의 Instance로 구성돼 있고,
Train : 1,600개Test : 400개로 분할해서 실험 진행.
다양한 Black-box Model 비교
LIME이 특정 모델에만 적용되는 게 아니라,
다양한 머신러닝 모델에서도 동일하게 사용할 수 있음을 보여주기 위해
여러 종류의 Classifier를 함께 비교했음.
사용된 모델은 ↓
Decision Tree (DT)Logistic Regression (LR)Nearest Neighbors (NN)RBF Kernel Support Vector Machine (SVM)Random Forest (RF)
이중에
Random Forest는
Word2Vec Embedding을 입력으로 사용하는 모델.
LIME과 같은 Explanation Method가 없으면
사람이 해석하기 매우 어려운 모델.
비교 대상(Explanation Method)
본 논문에서는 LIME 성능 검증을 위해
다음 세 가지 기존 방법과 비교했음.
① Parzen
Black-box Model 전체를
Parzen Window로 근사한 뒤,
Prediction Probability의 Gradient를 이용해서
중요한 Feature를 선택하는 방법.Gradient의 절댓값이 큰
상위 K개의 Feature를 Explanation으로 사용했음.
② Greedy
Prediction에 가장 크게 기여하는 Feature를
하나씩 제거하면서
Prediction이 바뀔 때까지 반복하는 방법.Prediction을 변화시키는 Feature를 중요한 Feature라고 판단.
③ Random
설명에 사용할 Feature를 무작위(Random)로 선택하는 방법.
공통 설정
Explanation에는
최대 K = 10개의 Feature만 포함하도록 설정했음.
그리고 LIME과 Parzen 모두
Cross Validation을 통해 Hyperparameter를 결정했고,
Sampling 개수는 N = 15,000으로 설정했음.
Representative Explanation 선택
모델 전체를 설명하는 실험에서는
대표적인 Explanation을 선택하는 방법도 함께 비교했음.
Random Pick(RP)
: Explanation을 무작위로 선택
Submodular Pick(SP)
: 4장에서 제안한 SP-LIME을 이용해서
대표성이 높고 중복이 적은 Explanation 선택
논문에서는
Explanation Method와 Pick Method를 함께 표기했음.
ex.
[SP-LIME]

↓

Submodular Pick
+
LIME
[RP-LIME]
↓
Random Pick
+
LIME을 의미함.
정리하자면,
LIME이 다양한 머신러닝 모델에서도 효과적으로 동작하는지 검증하기 위해,
여러 종류의 Classifier와 기존 Explanation Method를 함께 비교하는 실험 환경을 구성함.
그리고 개별 Prediction을 설명하는 실험뿐 아니라,
SP-LIME을 이용해서
모델 전체를 설명하는 방법까지 함께 평가할 수 있도록
Random Pick과 Submodular Pick도 함께 비교 대상으로 사용했음.
5.2. Are explanations faithful to the model?
첫 번째 실험에서는
LIME이 실제 모델이 사용하는 중요한 Feature를
얼마나 정확하게 설명하는지(Faithfulness)를 평가했음.
Faithfulness란?
좋은 Explanation은
사람이 보기 좋은 설명이 아니라,
실제 모델이 Prediction에 사용한 근거를 정확하게 반영해야 함.
Model

↓

실제로 사용한 Feature

↓

Explanation이 얼마나 잘 복원하는가?
를 평가하는 실험이라는 것.
실험 방법
Faithfulness를 정확하게 측정하기 위해
해석 가능한 모델인
Sparse Logistic RegressionDecision Tree
를 사용했음.
두 모델 모두
Prediction 하나당 최대 10개의 Feature만 사용하도록 학습시켰기 때문에,
실제로 모델이 사용한 중요한 Feature(Gold Feature)를 정확히 알고 있었음.
이후
Test Set의 모든 Prediction에 대해
LIME, Parzen, Greedy 방법으로 Explanation을 생성하고,
Explanation이 Gold Feature를 얼마나 많이 포함하는지(Recall)를 계산했음.
실험 결과
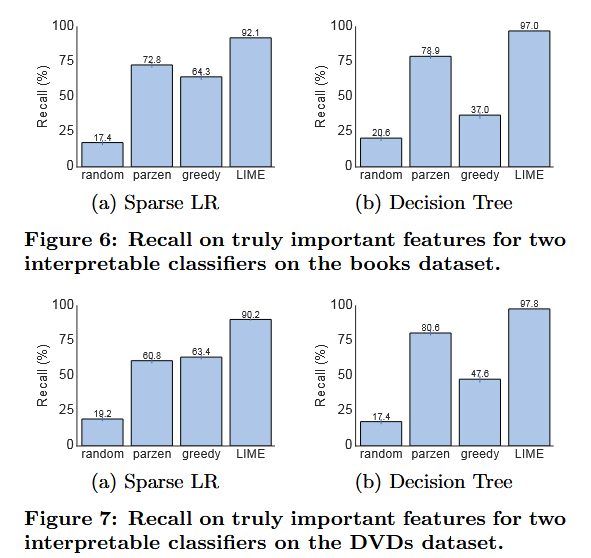
실험 결과는 상단 Figure. 6과 Figure. 7에 제시되었음.
Greedy는 Logistic Regression에서는Parzen과 비슷한 성능을 보였음.- 하지만 Decision Tree에서는 성능이 크게 감소했음.
Parzen역시 전체적으로 Recall이 낮았음.LIME은 모든 데이터셋과 모든 모델에서 90% 이상의 Recall을 기록했음.
왜 Greedy는 Decision Tree에서 성능이 낮았는가
Greedy는 Feature를 하나씩 제거하면서 Prediction이 바뀌는지를 확인하는 방식임.근데 Decision Tree는 하나의 Feature만 제거해도
Prediction이 그대로 유지되는 경우가 많음.따라서 중요한 Feature를 제대로 찾지 못했기에
Recall이 크게 감소했음.
왜 Parzen의 성능도 낮았는가
Parzen은 전체 Black-box Model을
하나의 근사 모델로 설명하려고 함.하지만 고차원(High-dimensional) 데이터를
정확하게 근사하는 게 매우 어렵기 때문에,
중요한 Feature를 충분히 복원하지 못했음.
결론적으로,
LIME은
모든 실험에서 90% 이상의 Recall을 기록하며,
실제 모델이 사용하는 중요한 Feature를 매우 정확하게 설명했음.
LIME의 Explanation은
실제 모델의 의사결정을 충실하게 반영한다는 것.
5.3. Should I trust this prediction?
두 번째 실험에서는
사용자가 하나의 Prediction을 신뢰할 수 있는지를
LIME이 얼마나 잘 판단하도록 도와주는지 평가했음.
실험 아이디어
실험에서는
전체 Feature의 25%를
의도적으로 신뢰할 수 없는 Feature(Untrustworthy Feature)로 지정했음.
ex.
Header 정보Data Leakage Feature처럼
실제로는 Prediction 근거로 사용되면 안 되는 Feature 의미.
Oracle Trustworthiness
논문에서는
정답 역할을 하는 Oracle을 먼저 정의했음.
신뢰할 수 없는 Feature를 제거했을 때
Prediction이 바뀌면
Untrustworthy그대로 유지되면
Trustworthy라고 정의했음.
= Prediction이 신뢰할 수 없는 Feature에 의존하는지를
정답(Label)으로 만든 것.
Simulated User
이후에
가상의 사용자(Simulated User)를 만들어서,
각 Explanation을 보고
Prediction을 신뢰할지 판단하도록 했음.
LIME과 Parzen은
Feature마다 Weight가 존재하므로
신뢰할 수 없는 Feature의 영향을 제거한 뒤
Prediction이 변하는지를 확인했음.
반면
Greedy와 Random은
Feature Importance를 제공하지 않기 때문에,
신뢰할 수 없는 Feature가 하나라도 포함되면
Prediction을 신뢰하지 않는 것으로 처리했음.
평가 방법
각 Explanation Method가
Oracle과 얼마나 동일한 판단을 하는지
F1 Score를 이용해서 평가.
실험은 100회 반복해서 평균 계산.
실험 결과
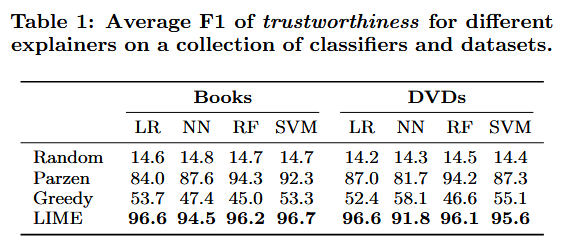
위 Table. 1 결과에서
LIME은 모든 데이터셋과 모든 Black-box Model에서
가장 높은 F1 Score를 기록했음.
그리고 모든 결과는
p = 0.01수준에서 통계적으로 유의미했음.
다른 방법들은
- Recall이 낮아 지나치게 많은 Prediction을 불신하거나
- Precision이 낮아 너무 많은 Prediction을 신뢰하는 문제 有.
그렇지만 LIME은
- 높은 Precision과
- 높은 Recall을 동시에 유지.
정리하자면,
LIME은 Prediction이 어떤 Feature를 근거로 이루어졌는지를 설명할 수 있기에,
사용자가 해당 Prediction을 신뢰해도 되는지 판단하는 데
가장 효과적인 Explanation Method임을 확인했음.
5.4. Can I trust this model?
앞에서의 실험은
하나의 Prediction에 대한 신뢰를 평가했다면,
이번 실험에서는
모델 전체를 신뢰할 수 있는지를 평가하는 것.
실험 목적
Validation Accuracy가 거의 동일한
두 개의 Random Forest 모델이 있다고 가정했음.
겉으로 보기에는
두 모델의 성능이 거의 같지만,
실제 Test Accuracy는
5% 이상 차이가 나도록 구성했음.
Validation Accuracy만으로는
어느 모델이 더 좋은지 알 수 없는 상황을 만든 것.
Noisy Feature 추가
실험에서는
10개의 Artificial Noisy Feature를 추가했음.
이 Feature들은
Training과 Validation에서는
특정 Class와 상관관계가 있는 것처럼 보이지만,
Test에서는
상관관계가 사라지도록 설계했음.
모델이 잘못된 Correlation(Spurious Correlation)을 학습하도록 만든 것.
실험 방법
사용자는 Validation Set에서
B개의 Explanation만 확인할 수 있음.
설명에 등장한 Artificial Feature를
신뢰할 수 없는 Feature로 표시한 뒤,
각 모델이
얼마나 많은 Prediction을
신뢰할 수 있는지 계산했음.
이후
신뢰할 수 없는 Prediction이 더 적은 모델을
더 좋은 모델이라고 선택했음.
비교 방법
다음 방법들을 비교했음.
RP-LIMESP-LIMERP-GreedySP-Greedy
(Parzen은 유용한 Explanation을 생성하지 못했기 때문에 결과에서 제외되었음.)
실험 결과
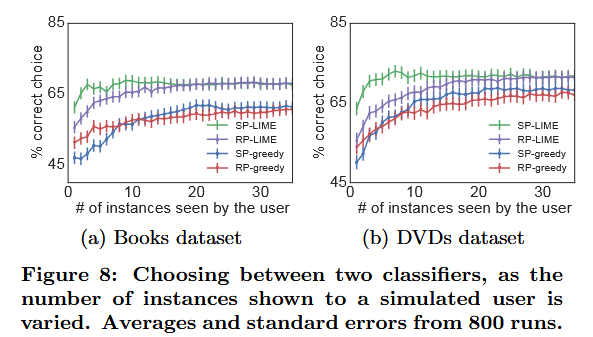
위 Figure. 8의 결과에서
LIME은 항상 Greedy보다 높은 성능을 보였음.
SP-LIME은 모든 방법 중에 가장 높은 정확도로 좋은 모델을 선택할 수 있었음.
특히 사용자가 적은 수의 Explanation만 확인하는 상황에서는
RP-LIME보다 SP-LIME의 성능 향상이 더욱 크게 나타났음.
정리하자면
SP-LIME은 중복되지 않는 대표적인 Explanation을 선택하기 때문에,
적은 수의 Explanation만 확인해도 모델 전체의 동작을 효과적으로 이해할 수 있었음.
LIME과Submodular Pick을 함께 사용하면
모델의 일반화 성능과 신뢰성을 가장 효과적으로 평가할 수 있음을 확인했음.
✅6. EVALUATION WITH HUMAN SUBJECTS
이전에는 가상의 사용자(Simulated User)를 이용해서 LIME의 성능을 평가했지만,
6장에서는 실제 사람(Human Subjects)을 대상으로
LIME이 사용자의 의사결정을 얼마나 효과적으로 돕는지를 평가했음.
평가 목적
우선, 다음 세 가지 질문에 답하고자 했음.
- 사용자가 더 좋은 모델을 선택할 수 있는가?
- 비전문가도 모델을 개선할 수 있는가?
- Explanation을 통해 모델의 문제점을 발견할 수 있는가?
LIME이 단순히 Explanation을 생성하는 게 아니라,
실제 사람 판단에도 도움이 되는지를 검증하는 것이 목적.
6.1. Experiment setup
사용한 데이터셋
실험에서는
20 Newsgroups Dataset의
ChristianityAtheism문서를 사용함.
다만, 이 데이터셋에는
Header 정보, Author Name 같은
실제 의미와 관계없는 Feature가 많이 포함되어 있음.
이런 건 Validation Accuracy는 높여주지만,
실제 환경에서는 전혀 도움이 되지 않는,
Generalization을 방해하는
Spurious Feature가 존재하는 데이터셋임.
새로운 평가 데이터셋 구축
실제 Generalization 성능 평가를 위해
논문에서는
새로운 Religion Dataset을 직접 구축했음.
Atheism과 Christianity 관련
웹사이트를 수집해서
각 Class마다
819개의 Webpage를 구성했음.
이 데이터셋에서는
Header나 Author 정보가 존재하지 않기에,
모델이
실제 의미(Semantic Content)를 학습했는지를 평가할 수 있었음.
사용한 분류기
별도의 언급이 없는 경우,
실험에는
20 Newsgroups Dataset으로 학습한
RBF Kernel 기반 SVM을 사용했음.
Hyperparameter는
Cross Validation을 이용하여 결정했음.
6.2. Can users select the best classifier?
LIME의 Explanation이
사용자가 더 좋은 모델(Generalization이 뛰어난 모델)을 선택하는 데 도움이 되는지에 대한 평가를 했음.
왜 Accuracy만으로는 부족한가
일반적으로 모델을 비교할 때는
Validation Accuracy를 많이 사용함.
다만, Validation Dataset 자체에
Data Leakage나 Spurious Feature가 존재하면,
Validation Accuracy가 높더라도 실제 환경에서는 성능이 크게 떨어질 수 있음.
= Validation Accuracy ↑ ≠ Real-world Performance ↑가 될 수 있다는 것.
실험 구성
사용자는 다음 두 개의 SVM 모델 가운데
실제 환경에서 더 잘 동작할 모델을 선택해야 했음.
Model A
원본 20 Newsgroups Dataset으로 학습한 SVM
Model B
Header, Author Name 등 일반화되지 않는 Feature를
제거한 다음 다시 학습한 SVM
두 모델의 성능
실제 Religion Dataset에서는
Original Model: 57.3%Cleaned Model: 69.0% 의 Accuracy 기록.
=>
Cleaned Model이
실제 환경에서는 훨씬 좋은 모델이었음.
다만, 20 Newsgroups Test Set에서는
Original: 94.0%Cleaned: 88.6% 의 Accuracy 기록.
Validation Accuracy만 보면
오히려 성능이 더 나쁜 모델을 선택하게 되는 상황을 의도적으로 만들었음.
실험 참가자
실험에는 Amazon Mechanical Turk 사용자를 모집했음.
참가자들은 Machine Learning 전문가는 아니었고, 종교에 대한 기본적인 지식만 가지고 있었음.
비전문가도 Explanation만 보고 좋은 모델을 선택할 수 있는지를 평가한 것.
실험 방법
참가자는 두 모델의 Prediction과 Explanation을 함께 확인한 뒤,
실제 환경에서 더 좋은 모델이라고 생각하는 하나를 선택했음.
설명은 하단 두 가지 방법으로 생성했음.
LIMEGreedy
그리고 설명을 보여주는 방식도
하단 두 가지를 비교했음.
Random Pick (RP)Submodular Pick (SP)
실험에서는 한 사람이 최대 B = 6개의 문서를 확인했고,
각 Explanation은 K = 6개의 단어만 보여줬음.
그리고 각 실험 조건마다 100명의 참가자가 실험에 참여했음.
실험 결과
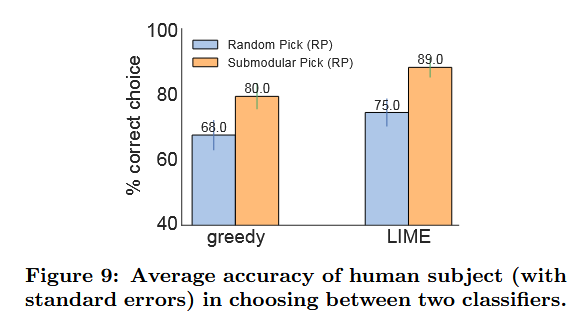
Figure. 9의 결과를 보면,
모든 Explanation Method는 Validation Accuracy만 사용하는 것보다
더 좋은 모델을 선택하는 데 도움이 되었음.
Explanation 자체가 모델을 신뢰할지 판단하는 데 유용한 정보를 제공했음을 확인했다는 것.
SP-LIME의 효과
특히 Submodular Pick(SP)을 사용했을 때
Random Pick(RP)보다 사용자의 모델 선택 정확도가 크게 향상되었음.
대표성이 높은 Explanation을 선택하는 게
모델 전체를 이해하는 데 매우 중요하다는 것을 의미함.
LIME vs Greedy
동일한 Pick 방법을 사용할 경우에도
LIME은 항상 Greedy보다 더 높은 성능을 보였음.
대표적인 Explanation을 선택하는 것뿐 아니라,
Explanation 자체의 품질도 사용자의 의사결정에 큰 영향을 준 것.
주요 결과
LIME은 비전문가도 설명만 보고
실제 환경에서 더 일반화가 잘 되는 모델을 선택할 수 있도록 도와주는 것을 확인했음.
그리고, Submodular Pick(SP-LIME)을 같이 쓰면
적은 수의 Explanation만으로도 모델 전체를 효과적으로 이해할 수 있었음.
정리하자면,
- Validation Accuracy만으로는 좋은 모델을 선택하기 어려웠음.
LIMEExplanation은 사용자의 모델 선택을 효과적으로 지원했음.SP-LIME은 Random Pick보다 더 대표적인 Explanation을 제공했음.LIME은 Greedy보다 우수한 Explanation 품질을 보였음.- 실제 사람을 대상으로도
LIME의 유용성이 검증되었음.
6.3. Can non-experts improve a classifier?
이번에서는
Machine Learning 전문가가 아닌 일반 사용자도 LIME Explanation을 이용해서
모델의 일반화 성능을 개선할 수 있는지를 평가했음.
Feature Engineering이란?
Machine Learning에서는 모델의 성능이 좋지 않을 경우,
중요하지 않거나 일반화되지 않는 Feature를 제거한 뒤
다시 학습시키는 Feature Engineering 과정을 자주 수행함.
불필요한 Feature 제거

↓

모델 재학습

↓

Generalization 향상
을 목표로 하는 과정임.
실험 idea
논문에서는
20 Newsgroups Dataset으로 학습한 성능이 좋지 않은 SVM(Classifier)을 사용했음.
이 모델은 Header, Author Name과 같은
실제 의미와 관계없는 Feature를 많이 학습하고 있었음.
사용자의 역할은
LIME Explanation을 보고
일반화되지 않을 것 같은 단어를 선택하여 제거하는 것이었음.
참가자
실험에는 Amazon Mechanical Turk 사용자가 참여했음.
참가자들은 ML 전문가도 아니고, Feature Engineering 경험도 없었음.
그리고 새롭게 구축한 Religion Dataset의 존재조차 알지 못했음.
그러니, 단어의 의미(Semantic Content)만을 보고 삭제 여부를 판단한 것.
실험 방법
참가자들은 LIME Explanation을 확인한 뒤, 삭제해야 한다고 생각하는 단어를 선택했음.
[실험 조건]
- Explanation 개수
- B = 10
- Explanation당 단어 개수
- K = 10
사용자가 단어를 삭제하면 그 단어를 제거한 새로운 데이터셋으로 SVM을 다시 학습시켰음.
Feature Engineering 반복 진행
실험 여러 번 진행함.
i) Round 1
10명의 사용자가 단어를 삭제함.
↓
10개의 새로운 Classifier 생성
ii) Round 2
새로운 Classifier 각각을 다시 5명의 사용자에게 보여줌.
↓
50개의 새로운 Classifier 생성
iii) Round 3
동일한 과정 반복
↓
최종적으로 250개의 Classifier를 생성했음.
= 사용자의 Explanation 기반 Feature Engineering을 여러 번 반복하면서 모델이 점차 개선되는지를 평가한 것임.
비교 방법
다음 두 방법을 비교했음.
RP-LIMESP-LIME
Explanation을 무작위(Random Pick)로 선택할 것인지,
대표적인 Explanation(Submodular Pick)을 보여줄 것인지를 비교했음.
실험 결과
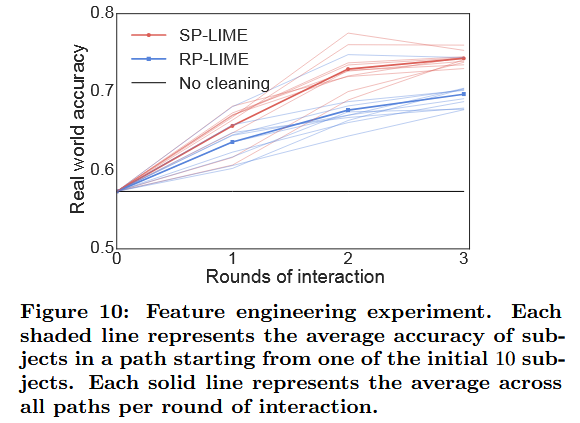
Figure 10의 결과를 보면,
사용자들은 Machine Learning 지식이 없음에도 불구하고,
불필요한 단어를 계속 제거하면서 모델의 Generalization 성능을 향상시켰음.
LIME Explanation만으로도 효과적인 Feature Engineering이 가능했음.
SP-LIME 효과
SP-LIME은 RP-LIME보다 더 높은 Accuracy를 달성했음.
대표성이 높은 Explanation을 보여주는 게 효율적인 Feature Engineering에 매우 중요하다는 것을 의미.
사용자들 일관성
실험이 반복될수록 사용자들이 제거하는 단어가 점점 비슷해졌음.
평균적으로 SP-LIME에서는 약 200개의 단어가 제거됐고,
그 중에 174개는 절반 이상의 사용자가 선택했고,
68개는 모든 사용자가 동일하게 제거했음.
또한 모델 Accuracy의 분산도 점차 감소했음.
사용자들이 점점 같은 방향으로 올바른 Feature를 선택하고 있었구나.
작업 시간
사용자는 한 번의 Feature Engineering에 평균 3.6분이 소요됐음.
총 세 번의 반복을 포함해도 약 11분만에
실제 환경에서 훨씬 잘 일반화되는 모델을 만들 수 있었다는 것.
주요 결과
ML 전문가가 아니더라도,
LIME Explanation을 이용하면
효율적인 Feature Engineering을 수행할 수 있음을 보여준 실험임.
그리고, SP-LIME은 대표성이 높은 Explanation을 제공하기에,
RP-LIME보다 더 빠르고 효과적으로 모델의 일반화 성능을 향상시켰음.
그래서 정리하자면,
- 비전문가도
LIMEExplanation만으로 Feature Engineering이 가능했음.- 불필요한 Feature를 제거하면서 모델의 Generalization이 향상되었음.
SP-LIME은RP-LIME보다 더 효과적으로 모델을 개선했음.- 사용자들의 선택은 반복할수록 점점 일관되게 수렴했음.
LIME은 Explanation 도구로도 잘 활용되지만, 모델 개선에도 활용될 수 있음을 확인했음.
6.4. Do explanations lead to insights?
이번 실험에서는 LIME Explanation이
사용자가 모델의 잘못된 학습(Spurious Correlation) 을 발견하도록 도와줄 수 있는지를 평가했음.
이런 실험이 왜 필요한가
Machine Learning 모델은 데이터를 학습하는 과정에서
사람이 의도하지 않은 특징까지 함께 학습하는 경우가 있음.
ex.
늑대 사진> 항상 눈(Snow) 위에서 촬영됨허스키 사진> 눈이 없는 환경에서 촬영됨
이라면 모델은 늑대와 허스키를 구분하는 게 아니라,
단순히 눈(Snow) > Wolf처럼 배경을 학습할 수도 있음.
이런 현상을 Spurious Correlation(허위 상관관계) 이라고 함.
실험 구성
논문에서는 의도적으로 잘못된 분류기를 학습시켰음.
Training Dataset은 총 20장의 이미지로 구성했고,
Wolf사진은 모두 눈(Snow)이 있는 배경Husky사진은 모두 눈이 없는 배경
으로 선택.
이렇게 해서 동물이 아니라 배경을 학습하도록 데이터를 구성했음.
사용한 Feature
이미지는 Google의 Pre-trained Inception Network를 이용해서
첫 번째 Max-pooling Layer의 Feature를 추출한 뒤,
Logistic Regression을 학습했음.
CNN을 새롭게 학습한 건 아니고,
Inception에서 추출한 Feature를 이용해서 의도적으로 잘못된 분류기를 만든 것.
결과
새로운 Test Image 60장에 대해
모델은 동물의 종류와 관계 없이
배경에 눈이 있으면 Wolf,
눈이 없으면 Husky로 분류하는 경향을 보였음.
모델은 동물을 구분한 게 아니라,
눈(Snow)을 이용해서 Classification을 수행하고 있었음.
Human Study
실험 참가자들은 먼저 Explanation 없이 10개의 Prediction만 확인했음.
이후에 하단 세 가지 질문에 답했음.
- 이 모델을 실제 환경에서도 신뢰할 수 있는가?
- 그렇게 생각한 이유는 무엇인가?
- 모델은 어떤 특징을 이용해서 분류한다고 생각하는가?
그 다음 같은 Prediction에
LIME Explanation을 함께 보여준 뒤,
같은 질문에 다시 답하도록 했음.
참가자
이번 실험은 Machine Learning에 대한 기본적인 이해가 필요한 문제였기 때문에,
ML 대학원 과목을 수강한 대학원생을 대상으로 진행했음.
평가 방법
참가자가 작성한 답변을 독립적인 평가자 3명이 읽고,
모델이 Snow, Background 등의 배경 정보를 사용한다고 언급했는지를 평가했음.
평가자 3명의 다수결(Majority Voting)을 이용해서
최종 결과를 결정했음.
실험 결과
Explanation을 보기 전에는 많은 참가자가 모델을 신뢰했고,
눈(Snow)이 중요한 Feature라는 사실도 절반 정도만 발견했음.
그리고, 대부분의 참가자는 동물의 색, 얼굴, 귀, 자세 등 다른 특징도 함께 추측했음.
LIME Explanation 이후
Explanation을 확인한 다음에는 거의 모든 참가자가 모델이 눈(Snow)과 배경을 주요 Feature로 사용한다는 사실을 정확하게 발견했음.
그리고 모델에 대한 신뢰도도 눈에 띄게 감소했음.
사용자는 모델이 잘못된 근거를 이용하고 있다는 사실을
명확하게 이해하게 되었음.
정리하자면,
LIME이 모델이 잘못된 Feature를 학습했다는 사실까지
사용자가 발견하도록 도와줄 수 있구나.
Explanation은 모델을 언제 신뢰해야 하는지뿐만 아니라, 언제 신뢰하면 안 되는지도 알려주는 판단에 있ㅆ어서 중요한 역할이구나.
- 모델은 늑대가 아니라 눈(Snow)을 학습하도록 의도적으로 구성되었음.
- Explanation 없이 모델의 문제를 발견하기는 어려웠음.
LIMEExplanation을 본 뒤 대부분의 참가자가 Snow Bias를 정확하게 발견했고 모델에 대한 신뢰도 역시 크게 감소했음.LIME은 모델의 Spurious Correlation을 이해하는 데 매우 효과적인 Explanation Method임.
✅7. RELATED WORK
기존 Explainable AI(XAI) 연구들과 비교하면서
LIME이 가지는 차별성과 장점을 설명했음.
기존 연구들은 주로
- 모델 전체를 설명하거나
- 특정 모델 구조에만 적용되거나
- Gradient 기반 Explanation을 사용하는 경우가 많았음.
다만
LIME은 어떤 모델에도 적용 가능한
Model-Agnostic Local Explanation Framework를 제안했다는 점을 강조했음.
Validation Accuracy만으로는 모델을 신뢰할 수 없음
기존 연구에서는 Validation Accuracy만을 이용해서
모델의 성능을 평가하는 게
여러 문제를 일으킨다는 사실이 알려져 있었음.
대표적인 문제는
- 사용자가 모델 성능을 과대평가하는 경우
- Data Leakage를 발견하지 못하는 경우
- 잘못된 Feedback Loop가 발생하는 경우 등이 있음.
이를 해결하기 위해 Gestalt, Modeltracker와 같은 도구들이 제안되었지만,
이들은 개별 Prediction을 설명하지는 못했음.
본 논문에서는
LIME과 SP-LIME을 이런 시스템과 같이 사용할 수 있고,
사용자가 대표적인 Instance를 선택하는 데에도 도움을 줄 수 있다고 설명했음.
기존 Failure Detection 연구와의 차이
최근에는 모델이 언제 실패할지를 예측하는 연구들도 제안되었음.
이런 방법들은 사용자가 모델을 과도하게 신뢰하지 않도록 도와준다는 장점이 있음.
하지만 대부분 Vision Task에 특화되어 있고,
추가적인 Annotation이나 Feature Engineering이 필요했음.
또한 왜 Prediction을 신뢰하면 안 되는지에 대한 설명은 제공하지 못했음.
반면 LIME은 Prediction이 잘못된 이유를 직접 Explanation으로 제공할 수 있음.
Raw Data만 보는 것은 충분하지 않음
기존 연구에서는 사용자가 Raw Data와 Prediction을 많이 보면 모델의 문제를 발견할 수 있다고 가정했음.
하지만 20 Newsgroups Dataset에서는 많은 사용자가
Header Information이나 Author Name 문제를 발견하지 못했음.
반면 LIME Explanation이 함께 제공되면,
Machine Learning 전문가가 아니더라도
이러한 문제를 쉽게 발견할 수 있었음.
그리고 Prediction이 맞더라도
잘못된 Feature를 이용해서 Prediction이 이루어진 경우를 확인할 수 있다는 장점이 있음.
기존 Interpretable Model과의 차이
기존에는
처음부터 해석 가능한 모델을 사용하는 연구도 많이 이루어졌음.
(특히 의료 분야에서는
Sparse Linear Model과 같은
Interpretable Model이 많이 사용되었음. )
하지만 이런 모델은 해석 가능성을 얻는 대신
표현력이나 정확도, 유연성이 감소하는 문제가 있음.
ex. 5~10개의 Feature만 사용하는 Sparse Linear Model은
Text Classification처럼 Feature가 매우 많은 문제에는 적합하지 않음.
반면 LIME은
기존 Black-box Model을 그대로 유지하면서도
Explanation만 추가할 수 있음.
모델의 성능을 유지하면서
Interpretability를 제공할 수 있음.
기존 XAI 방법과의 차이
Text 분야에서는 EluciDebug가
사람이 모델을 이해하도록 돕는 시스템으로 제안되었음.
다만 Naive Bayes처럼
원래부터 해석 가능한 모델만을 대상으로 했음.
Computer Vision에서는 Object Detection이나
Attention을 이용한 Explanation 방법도 제안되었음.
그렇지만 이런 방법은
특정 Neural Network 구조에서만 사용할 수 있고,
배경 같은 Non-object 영역은 제대로 설명하지 못하는 한계가 있음.
이와 달리 LIME은
특정 모델 구조에 의존하지 않는
Model-Agnostic Framework이기에,
분류(Classification)뿐 아니라 회귀(Regression)를 포함한 모든 모델에 적용할 수 있음.
기존 Model-Agnostic Explanation과의 차이
기존에도 Black-box Model을
다른 해석 가능한 모델로 근사하는 방법들이 존재했음.
대표적으로 Gradient 기반 Explanation이나
Parzen 기반 방법.
하지만 Gradient는 Prediction Confidence가 높을수록 Gradient 값이 0에 가까워져
해석이 어려워지는 문제 존재.
또한 기존 방법들은 모델 전체(Global)를 근사하려고 하기 때문에,
특정 Prediction을 정확하게 설명하기 어려웠음.
반면 LIME은 Prediction 주변(Local Region)만 근사하기 때문에,
Local Fidelity를 훨씬 잘 유지할 수 있었음.
실험에서도 이러한 차이가 확인되었음.
LIME의 가장 큰 차별점
기존 방법들은 Gradient, 수천 개의 Weight를 가지는 Linear Model, Word Embedding과 같이 사람이 이해하기 어려운 형태의 Explanation을 생성하는 경우가 많았음.
반면
LIME은 최적화 과정 자체에 Interpretability를 포함했고,
사람이 이해할 수 있는 Interpretable Representation을 사용하도록 설계되었음.
또한 Text, Image 등
도메인에 따라 적절한 설명 방식을 사용할 수 있도록 유연하게 설계되었음.
정리하자면,
LIME이 기존 Explainable AI 연구들과 비교했을 때
Model-AgnosticLocal FidelityHuman Interpretability를 동시에 만족하는 Explanation Framework!
그리고,
Gradient 기반 방법,Global Approximation,특정 모델 전용 Explanation과 달리,
LIME은 어떤 머신러닝 모델에도 적용 가능하고,
사람이 실제로 이해하고 신뢰할 수 있는 Explanation을 제공한다는 점이 가장 큰 차별점.
🔚8. CONCLUSION AND FUTURE WORK
본 논문에서는 Machine Learning 시스템을 효과적으로 활용하기 위해서는
모델에 대한 신뢰(Trust)가 매우 중요하고,
이를 위해서는 개별 Prediction에 대한 Explanation이 반드시 필요하다고 주장했음.
i) LIME 제안
본 논문에서는 어떤 머신러닝 모델에도 적용 가능한
LIME(Local Interpretable Model-agnostic Explanations)을 제안했음.
LIME은 Prediction 주변(Local Region)을
단순한 Interpretable Model로 근사해서,
Black-box Model의 Prediction을 사람이 이해할 수 있는 형태로 설명함.
그리고, Model-Agnostic Framework이므로,
특정 모델 구조에 제한되지 않고 다양한 머신러닝 모델에 적용할 수 있음.
ii) SP-LIME 제안
개별 Prediction만으로는 모델 전체를 이해하기 어렵기 때문에,
본 논문에서는 SP-LIME(Submodular Pick LIME)도 함께 제안했음.
SP-LIME은 대표성이 높고,
중복되지 않는 Explanation을 선택해서
사용자가 적은 수의 Explanation만으로도
모델의 전체적인 동작을 이해할 수 있도록 함.
실험 결과
Text와 Image Domain에서 수행한 다양한 실험을 통해,
LIME과 SP-LIME의 효과를 검증했음.
실험 결과
LIME은,
- 실제 모델이 사용하는 Feature를 충실하게 설명했고,
- 사용자가 Prediction을 신뢰할지 판단하도록 도왔고,
- 더 일반화가 잘 되는 모델을 선택하는 데 도움을 주었으며,
- 비전문가도 Feature Engineering을 수행하여 모델을 개선할 수 있도록 했음.
- 또한 모델이 잘못된 Feature를 학습한 경우에도 그 원인을 쉽게 발견할 수 있었음.
LIME은 전문가뿐 아니라 비전문가에게도
모델을 이해하고 신뢰하는 데 효과적인 Explanation Framework임을 확인한 것!
향후 연구 방향
본 논문에서는 향후 다음과 같은 연구를 진행하고자 했음.
i) 다양한 Explanation Model
현재 논문에서는 Sparse Linear Model만을 Explanation Model로 사용.
하지만 Decision Tree와 같은 다른 형태의 Interpretable Model도
LIME Framework에 적용할 수 있으므로,
실제 사용자를 대상으로
어떤 Explanation Model이 가장 효과적인지 비교하는 연구가 필요하다고 제안했음.
ii) Image Pick 방법 개선
SP-LIME은 Text 데이터에서는 효과적으로 동작하지만,
Image에서 대표적인 Explanation을 선택하는 방법은 본 논문에서 다루지 않았음.
따라서 Image Domain에 적합한 Pick Method를
향후 연구 과제로 제시함.
iii) 다양한 응용 분야
LIME은 Model-Agnostic Framework이므로,
Text와 Image뿐 아니라 다양한 분야에도 적용할 수 있음.
본 논문에서는 다음과 같은 분야로의 확장을 제안했음.
SpeechVideoMedical DomainRecommendation System
이론 & 계산 최적화
실시간 Explanation을 제공하기 위해서는 추가적인 연구도 필요하다고 설명했음.
대표적으로
적절한 Sampling 개수 결정병렬 처리(Parallelization)GPU 기반 연산 최적화등을
향후 연구 과제로 제시함.
이를 통해 Human-in-the-loop Machine Learning 환경에서도
정확하고 실시간으로 Explanation을 생성할 수 있을 것으로 기대함.
정리하자면
- 본 논문에서는
LIME을 통해
어떤 머신러닝 모델에도 적용 가능한
Model-Agnostic Local Explanation Framework를 제안했음.- 그리고
SP-LIME을 이용해서 대표적인 Explanation을 선택함으로써, 사용자가 모델 전체를 효율적으로 이해할 수 있도록 함.- 다양한 Human Study를 통해
LIME은 모델의 Prediction을 설명하는 것뿐만 아니라, 사용자가 모델을 신뢰하고, 평가하며, 개선하는 데까지 도움을 줄 수 있음을 입증함.
향후에는 다양한 Explanation Model, Image Domain, Speech/Video/Medical 분야, 실시간 Explanation을 위한 최적화 연구로 확장될 가능성을 제시함.
