[논문 리뷰] MobileNets - MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications (2017)
[논문 리뷰]
Paper: MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications
🔍1. Introduction
기존 CNN: 기술이 발전될 수록 더 깊고 더 복잡한 신경망을 만들어서 정확도(accuracy)를 높이는 것이 일반적인 트렌드였음.
다만, 실질적으로 모델 size와 속도가 중요한 환경에서는 효율적이지 못하다는 문제가 존재했음.
모바일 및 embedded vision application에서 적용할 수 있는 매우 작고, 지연 시간이 낮은 모델을 구축해야함.
→ 본 논문에서 효율적인 신경망 아키텍처와 2set의 하이퍼 파라미터를 소개하고자 함.
✅2. Prior Work
작고 효율적인 신경망을 설계하고자 하는 양상이 최근 들어 보이고 있음.
그래서 주로
1. 사전에 학습된 신경망을 압축하거나 (ex. pruning, quantization)
2. 직접 작은 신경망을 학습시키는 방식으로 진행되고 있음 (ex. SqueezeNet, MobileNet)
MobileNets는 주로 지연 시간(latency)을 최적화하는 것과 신경망 크기를 작게하는 것에 중점을 둠.
또한, MobileNets는 주로 Depthwise Separable Convolution(깊이별 분리 합성곱)으로 구성되고, 이후 Inception 모델에서도 사용되어서, 처음 몇 개의 레이어에서 연산량을 줄이는 데에 사용됨.
✅3. MobileNet Architecture
Depthwise Separable Convolution
깊이별 분리 합성곱
Standard
표준 Convolution Layer는 input으로 DF X DF X M 크기의 피처맵 F를 받고, DF X DF X N 크기의 피처맵 G를 생성함.
- DF: 입력 피처맵 가로/세로 크기(정사각형 형태)
- M: 입력 채널 수(입력 깊이)
- N: 출력 채널 수(출력 깊이)
표준 Convolution Layer는 크기가 DK X DK X M X N 인 합성곱 커널 K로 매개변수화 됨.
- DK: 커널의 가로/세로 크기(정사각형 형태)
- M: 입력 채널 수(입력 깊이)
- N: 출력 채널 수 (출력 깊이)
표준 Convolutional 연산량
: DK X DK X M X N X DF X DF
- DK X DK: 커널의 크기
- M: 입력 채널 수
- N: 출력 채널 수
- DF X DF: 입력 피처맵의 공간적 크기(가로x세로)
MobileNet
MobileNet은 위 입력/출력 채널 수, 커널 크기 요소 및 상호작용을 다루기 위해, 깊이별 분리 합성곱을 사용함.
이를 통해서 출력 채널 수와 커널 크기 간 상호작용을 분리해서 연산량을 줄여서, 연산에서의 효율성을 높임.
깊이별 분리 합성곱은 두 개의 층으로 구성됨.
1. Depthwise Convolutions(깊이별 합성곱)
: 입력 채널 당 하나의 필터 적용
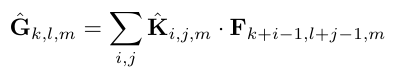 ↑ 깊이별 합성곱 공식
- Gk,l,m: 출력 피처맵 G의 좌표 (k,l,m) 값
- Ki,j,m: 깊이별 합성곱 커널 K의 좌표 (i,j,m) 값
- Fk+i-1,l+j-1,m: 입력 피처맵 F의 좌표(k+i-1,l+j-1,m) 값
깊이별 합성곱 커널 K의 크기: DK X DK X M
깊이별 합성곱의 계산 비용: DK X DK X M X DF X DF
표준 합성곱과 비교했을 때, 출력 채널 N과의 상호작용이 없기 때문에, 계산 효율 ↑
2. Pointwise Convolutions(포인트 합성곱)
: 1x1 합성곱으로, 깊이별 합성곱 층의 출력을 선형 결합하여 새로운 출력 생성
깊이별 합성곱 공식이 정말 효율적이긴 하나, 입력 채널을 필터링하는 역할만 하기에, 새로운 feature를 생성하기 위해 채널을 결합하지는 못함.
때문에, 포인트 합성곱을 추가해서, 깊이별 합성곱의 출력을 선형 결합해서 새로운 출력을 생성해야 함.
+ MobileNet에서 padding은 주로 포인트 합성곱보다 깊이별 합성곱에서 주로 쓰임
3. Depthwise Separable Convolution(깊이별 분리 합성곱)
: 깊이별 합성곱 & 포인트 합성곱 조합
깊이별 분리 합성곱 계산 비용: DK X DK X M X DF X DF + M X N X DF X DF
(깊이별 합성곱과 포인트 합성곱의 계산량을 합한 것임)
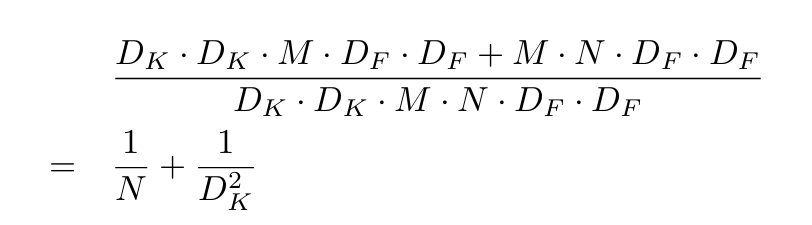 ↑ 표준 합성곱 대비 계산량 감소가 이루어짐을 확인할 수 있음
MobileNet은 3x3 크기의 깊이별 분리 합성곱을 사용하여, 표준 합성곱 대비 8~9배의 연산량을 감소시킴.
단, 정확도는 살짝 감소하지만, 높은 효율성을 보임.
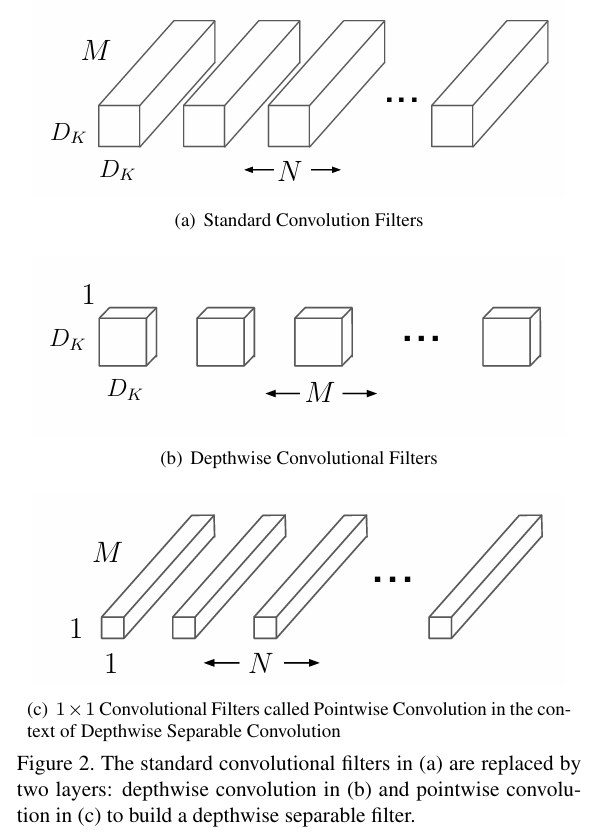 ↑ 표준 합성곱/깊이별 합성곱/포인트 합성곱 구조
Network Structure and Training
MobileNet은 앞서 언급한 "깊이별 분리 합성곱"을 기반으로 설계되었음.
단, 첫 번째 층은 예외적으로 full convolution(전체 합성곱) 사용
= 입력 채널 간의 상관관계 학습 + 초기 데이터 주요 정보 추출 & 효율적 처리
→ 이후 층에서 계산량 줄이기 위해서 깊이별 분리 합성곱 사용
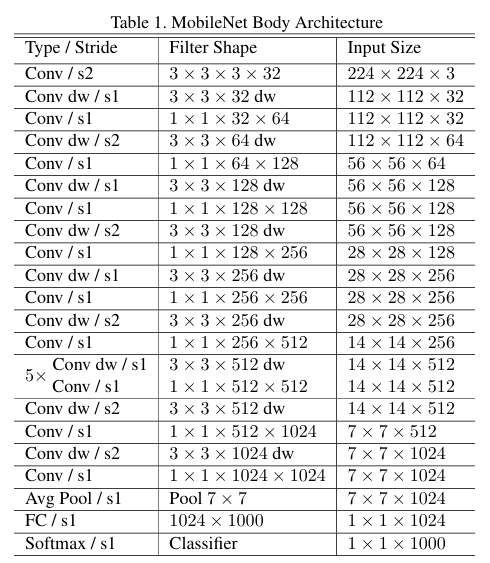 ↑ MobileNet 아키텍처
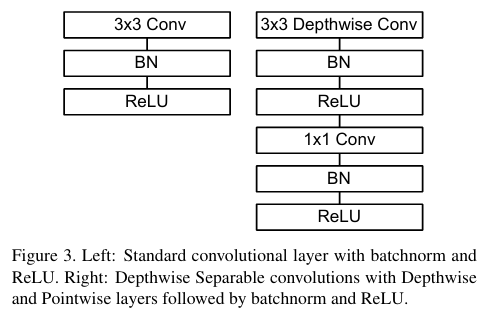 ↑ 왼쪽: 표준 합성곱 층 with 배치 정규화(BatchNorm) & ReLU 활성화 함수
오른쪽: 깊이별 분리 합성곱(깊이별 합성곱과 포인트 합성곱 조합)
각 합성곱 층 뒤에 배치 정규화 & ReLU 추가
신경망의 연산량을 단순히 낮게 잡는 것이 아닌 효율적인 연산을 구현할 수 있도록 해야 함.
MobileNet 구조는 대부분의 연산을 "Dense 1×1 Convolution"으로 수행하며,
메모리 재정렬(reordering-일반적인 합성곱 연산에서는 필요한 절차) 없이 일반 행렬 곱셈(GEMM: General Matrix Multiply) 함수로 구현할 수 있습니다.
→ 아주 효율적인 구현 가능!
또한, MobileNet의 경우 TensorFlow에서 RMSprop 알고리즘과 Asynchronous Gradient Descent(동시 작동하지 않는 경사 하강법)을 사용하여서 학습됨.
더불어, 대형 모델에서의 학습과 달리, MobileNet과 같은 소형 모델은 과적합 문제가 덜 발생하기 때문에,
정규화(regularization) & 데이터 증강(data augmentation) 기법을 적게 사용함. (모델을 복잡하게 하지 않아도 안정적이고 효율적인 학습이 가능하다는 것)
Width Multiplier: Thinner Models
폭 조정 계수를 통해서 더 경량화된 모델을 구현함.
본래 MobileNet 모델이 충분히 작고 지연 시간(latency)도 적은 모델이지만, 경우에 따라 더 작고, 지연 시간도 더 적은 모델이 필요함.
→ 폭 조정 계수(Width Multiplier)라는 파라미터를 도입하게 됨.
Width Multiplier α가 주어지면, 입력 채널 수 M은 αM으로, 출력 채널 수 N은 αN으로 줄어들게 됨.
따라서 깊이별 분리 합성곱 연산 비용
: DK X DK X αM X DF X DF + αM X αN X DF X DF
이렇게 정의됨.
(이때, α값은 0<α<=1)
Width Multiplier를 통해서 연산 비용과 파라미터 수를 제곱으로 줄일 수 있음.
따라서 더 소형의 모델을 구현할 수 있는 것.
Resolution Multiplier: Reduced Representation
해상도 조정 계수를 통해서 더 축소된 표현 가능.
신경망의 연산 비용을 줄이기 위해서 Resolution Multiplier도 하이퍼 파라미터로 작용할 수 있음.
Resolution Multiplier은 input image에 적용되어서, 각 신경망 층에서 feature map의 크기도 같은 비율로 줄임.
폭 조정 계수 α & 해상도 조정 계수 ρ 적용 시, 주요 신경망 층에서 깊이별 분리 합성곱 연산 비용
: DK X DK X αM X ρDF X ρDF + αM X αN X ρDF X ρDF
(이때, ρ값은 0<ρ<=1)
Resolution Multiplier를 통해서 연산 비용을 ρ^2비율로 줄일 수 있음.
따라서 더 효율적으로 모델 축소를 구현할 수 있는 것.
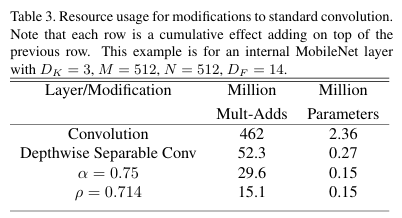 ↑ 앞서 소개된 각종 경량화 방법들(깊이별 분리 합성곱, 폭 조정 계수, 해상도 조정 계수)이 한 층에 순차적으로 적용되었을 때의 연산량과 파라미터 수가 누적해서 어떻게 변화하는지 확인할 수 있음
✅4. Experiments
본 실험에서는 먼저 깊이별 합성곱의 효과 & 신경망 폭을 줄이는(신경망 층 수를 줄이는 대신) 방법을 비교하고,
그 후, 폭 조정 계수, 해상도 조정 계수 상관 관계를 알아보고자 함.
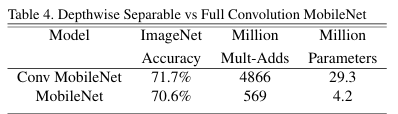 ↑ 해당 표를 통해서 전체 합성곱(Full Convolution)을 사용했을 때보다, 깊이별 분리 합성곱(Depthwise Separable Convolution)을 사용했을 때, 연산량과 파라미터 수가 아주 크게 감소한 것을 확인할 수 있음. 동시에 정확도는 1.1% 가량 감소하는 양상을 보임.
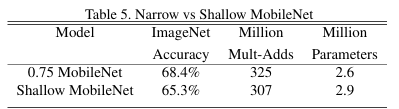 ↑ 해당 표를 통해, 폭 조정 계수(Width Multiplier)를 적용한 thinner한 모델과, 층 수를 줄여서 shallower하게 만든 모델을 비교할 수 있음. 결과적으로, 연산량과 파라미터 수가 비슷할 때, MobileNets를 thinner하게 만드는 것이 shallower하게 만드는 것보다 정확도(accuracy)가 3.1% 가량 높은 것을 확인할 수 있음.
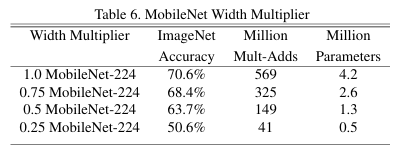 ↑ 해당 표를 통해, 폭 조정 계수(Width Multiplier)를 MobileNets에 적용했을 때, 조정 계수 값에 따른 trade-off 관계를 확인할 수 있음. 정확도(accuracy)가 폭 조정 계수 α가 줄어들수록 점차 감소했으며, α=0.25로 너무 작아지면 모델 크기도 너무 작아짐.
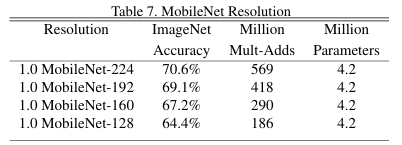 ↑ 해당 표를 통해, 해상도 조정 계수(Resolution Multiplier)를 모델에 적용했을 때의 조정 계수 값에 따른 trade-off 관계를 확인할 수 있음. 해상도가 감소할수록 정확도(accuracy)가 점차 줄어드는 것을 확인할 수 있음.
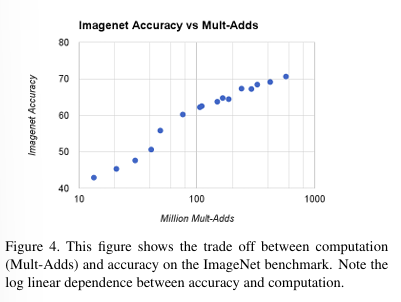 ↑ 해당 자료를 통해, 연산량(Mult-Adds)과 정확도(accuracy) 간의 trade-off 관계를 확인할 수 있으며, 선형 로그의 형태를 보임을 알 수 있음.
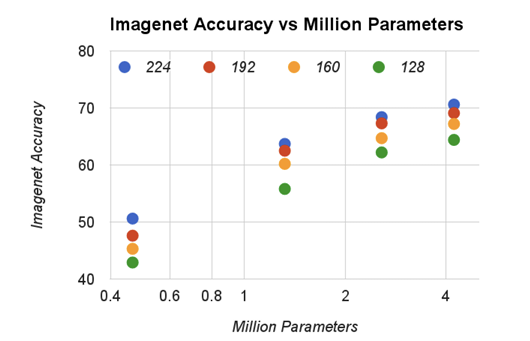 ↑ 해당 자료를 통해, 파라미터 수와 정확도(accuracy) 간의 trade-off 관계를 확인할 수 있음. color로 표현된 것이 입력 해상도이며, 파라미터가 작은 모델에서도 입력 해상도를 적절히 설정해서 준수한 성능을 얻을 수 있음.
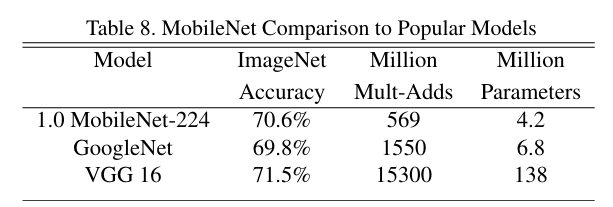 ↑ MobileNet을 GoogleNet과 VGG16과 비교한 결과. 우수한 수준의 정확도를 유지하며 더 적은 연산량/파라미터를 보이는 것을 확인할 수 있음.
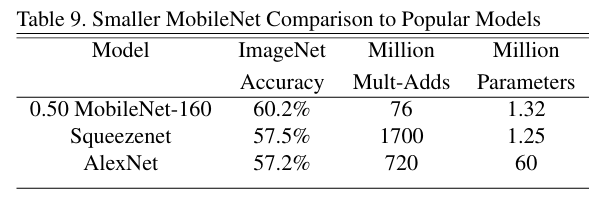 ↑ 폭/해상도 조정 계수로 축소된 MobileNet 모델의 결과. 타 모델에 비해 높은 정확도/적은 연산량/파라미터를 보임.
Fine Grained Recognition
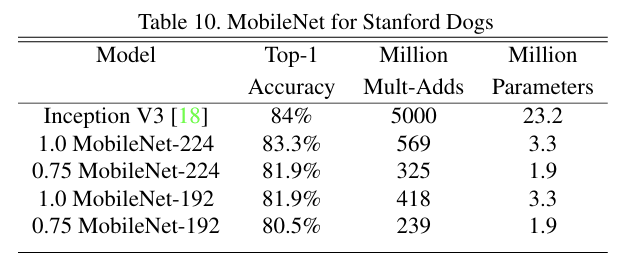 MobileNet을 Fine Grained Recognition(촘촘한, 세세한, Recognition)에 적용한 결과, MobileNet은 Inception V3와 비슷한 정확도를 보였고, 연산량과 파라미터 부분에서는 확실하게 좋은 성능을 냄.
Large Scale Geolocalizaton
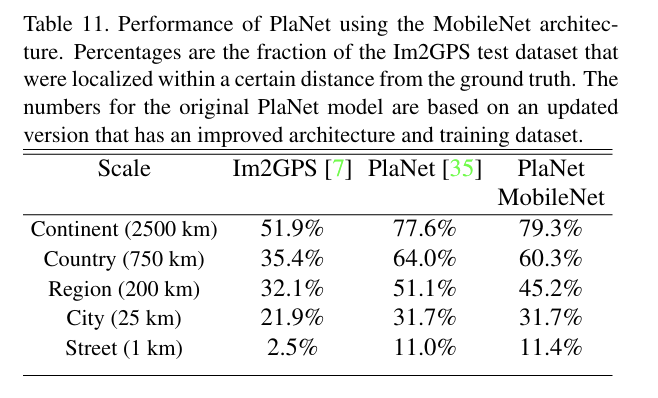 PlaNet: 사진이 지구 어디에서 찍혔는지 분류하는 모델.
이를 MobileNet으로 다시 학습한 결과, 연산량과 파라미터 수가 본 모델보다 확연히 줄어든 것을 확인할 수 있음.
Face Attributes
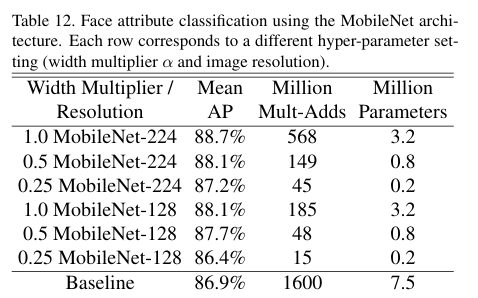
MobileNets은 얼굴 속성 분류 작업에서도 활용되었음.
얼굴 속성 분류 작업에서 MobileNet과 distillation(증류)를 조합하여, classifier를 효율적으로 축소함과 동시에 기존 모델의 1% 수준에 불과하는 연산량을 보임.
Object Detection
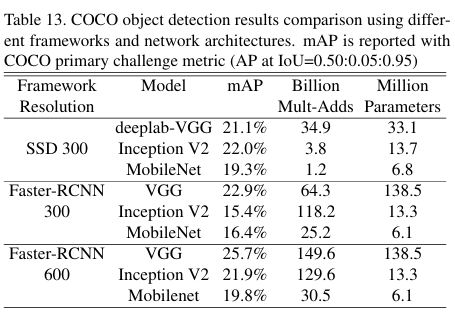
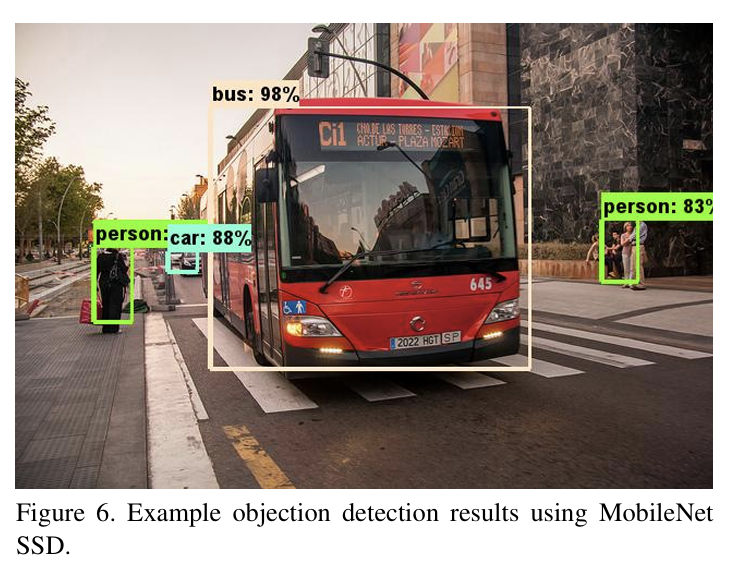 MobileNets은 객체 탐지에서도 좋은 성능을 보임.
특히, VGG와 Inception V2와 비교한 결과, MobileNEt이 정확도가 조금 떨어지지만, 연산량/파라미터 측면에서 타 모델 대비 뛰어난 성능을 보임.
Face Embeddings
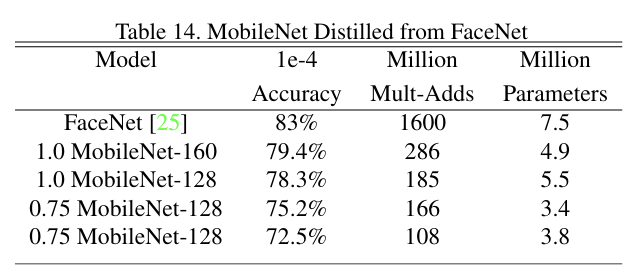 FaceNet: 최첨단 얼굴 인식 모델.
Mobile FaceNet: MobileNet을 기반으로한 모바일 FaceNet 모델.
결과적으로, Mobile FaceNet 모델이, FaceNet의 성능과 비슷한 정확도(accuracy)를 보이며 연산량/파라미터 면에서 훨씬 더 가벼운 모델을 만들어 냄을 확인할 수 있음.
🔚5. Conclusion
본 논문에서는 깊이별 분리 합성곱(Depthwise Separable Convolutions)을 기반으로 MobileNet을 소개했음.
MobileNet은 효율성을 극대화하고자 만든 모델로(정확도보다는 확실히 효율성), 다양한 조정 계수 설정과 작업을 통해 기존보다 더욱 경량화된 모델을 생성하고자 함.
특히, 본 논문의 Experiments 단계에서 MobileNet이 적절한 정도의 정확도를 유지하며, 연산량과 파라미터는 확실히 줄일 수 있음을 보여줬음.
이렇게 MobileNet이 타 모델들에 비해 경량화 & 효율성 부분에서 뛰어난 모델임을 확인할 수 있었음.
