Paper: Anchors: High-Precision Model-Agnostic Explanations
🔍1. Introduction
최근 딥러닝과 같은 복잡한 머신러닝 모델은 다양한 분야에서 높은 성능을 보이고 있음.
하지만 모델의 구조가 매우 복잡해질수록
왜 그런 예측을 했는지 이해하기 어려운 Black-box라는 문제가 존재함.
이러한 이유로 최근에는 모델의 예측 결과뿐 아니라 판단 근거를 사람이 이해할 수 있도록 설명하는 Explainable AI(XAI) 연구가 활발하게 진행되고 있음.
기존 XAI 연구는
- 모델 자체를 해석 가능하도록 설계하는 Interpretable Model
- 이미 학습된 모델의 개별 예측을 설명하는 Local Explanation(Post-hoc)
등 다양한 방향으로 발전해 왔음.
이 중 LIME 같은 Post-hoc 기법은 ★ 모델 구조와 관계없이(Model-agnostic) ★
개별 예측에 대한 설명(Local Explanation)을 제공할 수 있다는 장점이 있음.
하지만 논문에서는 기존 Local Explanation만으로는 사람이 모델을 충분히 이해했다고 보기 어렵다고 주장함.
논문에서 말하는 Explainability의 키포인트
= 사람이 설명을 바탕으로, 모델이 새로운 입력에서 어떻게 동작할지 정확하게 예측할 수 있는가
기존 Local Explanation의 한계
기존 Local Explanation은 대부분 입력 Feature들의 선형 결합(Linear Combination)으로 예측 근거를 설명함.
Positive
=
0.42 × good
+ 0.31 × movie
- 0.27 × bad
...
처럼 각 Feature가 예측에 얼마나 기여했는지를 Importance 형태로 보여줌.
& 대표적인 방법 = LIME
이런 방식은 Feature의 상대적인 중요도를 이해하기 쉽다는 장점이 있음.
하지만 당연히 중요한 문제도 존재함.
문제 1. Coverage가 명확하지 않음
LIME의 설명은 현재 입력 주변(Local Region)에서만 유효함.
그렇기에,
이 설명이 어디까지 적용되는지는 알 수가 없음.
= 논문에서는 이걸 Coverage라고 정의함.
Coverage란,
설명이 적용되는 범위(Region where explanation applies)를 의미.
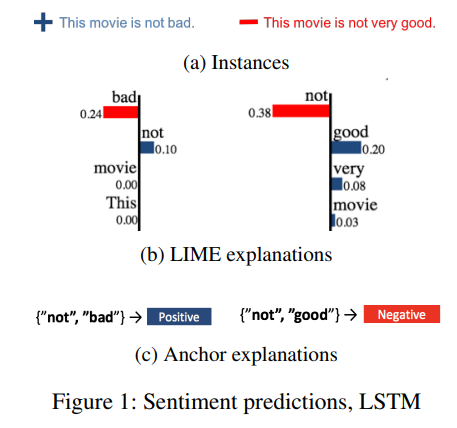
예를 들어 아래 두 문장이 있다고 가정한다면,
[Sentence A]

This movie is not bad.
[Sentence B]
This movie is not good.LIME은 첫 번째 문장에서
not

↓

Positive에 기여
라는 설명을 만들 수 잇ㅆ는데,
이 설명을 두 번째 문장에도 그대로 적용하면
not

↓

Positive
라고 잘못 해석할 가능성이 있음.
근데 실제로 두 번째 문장은 Negative 의미를 가지니...
LIME은 현재 입력에서는 정확한 설명을 제공하지만,
어떤 새로운 입력에서도 같은 설명이 적용되는지는 알 수가 없음.
그렇기에 사용자는
not은 항상 Positive에 영향을 준다고 잘못 일반화할 수 있는 것.
문제 2. Human Precision
논문에서는 사람이 모델의 동작을 얼마나 정확하게 예측할 수 있는지를 Explainability의 가장 중요한 요소로 봄.
이를 Human Precision이라고 부름.
(여기서 Precision은 모델의 성능이 아니라
사람이 모델의 행동을 맞추는 정확도를 의미함.)
예를 들어 어떤 설명을 읽고
- 이 조건이면 모델은 Positive를 예측하겠다고 사람이 예상했을 때,
실제로 모델도 동일하게 예측한다면 Human Precision이 높은 것. - 반대로 설명을 보고도 모델의 행동을 자주 틀리게 예측한다면,
그 설명은 좋은 Explanation이라고 보기 어려움.
그리고 Linear Explanation은 여러 Feature의 가중치를 함께 계산해서 해석해야 하기 때문에,
사용자가 설명을 이해하기 위해 필요한 노력(Human Effort)도 크다는 한계가 있음.
그래서 논문에서는
위와 같은 문제를 해결하기 위해 Anchor라는 새로운 설명 방식을 제안함.
Anchor는 Feature Importance를 나열하는 대신,
If-Then Rule 형태로 모델 예측을 설명함.
Fig. 1(c)에서는 아래처럼 Rule을 생성함.
IF

"not bad"가 포함되어 있다.

THEN

Positive를 거의 항상 예측한다.
반대로
IF

"not good"가 포함되어 있다.

THEN

Negative를 거의 항상 예측한다.
Anchor가 만족되는 동안에는
나머지 단어(Feature)가 조금 바뀌더라도 모델의 예측은 거의 변하지 않음.
= Anchor는 특정 예측을 고정(anchor) 해주는
충분조건(Sufficient Condition) 역할을 하는 것.
그리고 Rule 형태이기 때문에
- 언제 설명이 적용되는지(Coverage)
- 해당 설명을 얼마나 신뢰할 수 있는지(Precision)
를 명확하게 알 수 있음.
다양한 분야에서도 검증을 함
논문에서는 Anchor를 다양한 머신러닝 문제에 적용함.
ClassificationStructured PredictionText Generation
그리고
TabularTextImage
등 다양한 데이터에서도 실험을 수행함.
추가로 사용자 실험(User Study)을 통해,
기존 Model-agnostic 설명 기법(LIME)이나
설명을 제공하지 않는 경우보다
더 적은 노력으로 모델의 행동을 더 정확하게 예측(Higher Human Precision) 할 수 있음을 확인함.
✅2. Anchors as High-Precision Explanations-
Local Explanation이란?
Local Explanation의 목표는
특정 입력 x에 대해 모델이 왜 그런 예측을 했는지 설명하는 것
= 복잡한 모델 전체를 설명하는 것은 어렵지만,
개별 예측(Local Prediction)만 집중해서 보면 설명이 가능하다는 아이디어.
기존 Model-agnostic 설명 기법(LIME 등)은 대부분 입력 데이터를 조금씩 변형(Perturbation)하면서
모델 출력이 어떻게 변하는지를 관찰해서 설명을 생성함.
이때 중요한 건,
사람이 이해할 수 있는 형태(Interpretable Representation)로 입력을 변형해야 한다는 것.
예를 들어
- Text → 단어의 존재 여부
- Image → Superpixel의 존재 여부
- Tabular → Feature의 값
등 사람이 이해할 수 있는 표현을 사용함.
Anchor란?
논문에서는 Rule(규칙) 하나를 다음과 같이 정의함.
A = {조건 1, 조건 2, ...}ex.
A = {"not", "bad"}라면
This movie is not bad.에서는
A(x) = 1이 됨.
Rule의 모든 조건이 만족되면 Anchor가 적용되는 것.
Anchor 정의
논문에서 Anchor는
모델의 예측을 거의 항상 유지시키는 충분조건(Sufficient Condition)
으로 정의함.
예를 들어
IF

"not"
AND
"bad"

↓

Positive
라는 Anchor가 생성되었다면,
"not"과 "bad"가 포함된 다양한 문장을 만들어도
모델은 대부분 Positive를 예측해야 함.
Anchor가 성립하는 동안에는
나머지 단어(Feature)가 바뀌더라도 모델 예측은 거의 변하지 않음.
논문에서는 이를 수식으로 다음과 같이 표현함.
여기서
- : Anchor가 만족되는 새로운 샘플
- : 원래 입력의 예측
- : 새로운 샘플의 예측
- : 최소 Precision 기준(논문에서는 0.95 사용)
Anchor가 만족되는 샘플의 대부분(95% 이상)에서 같은 예측이 나오면 좋은 Anchor라고 정의함.
LIME과의 차이
논문에서는 Figure 2를 통해 LIME과 Anchor를 비교하는데,
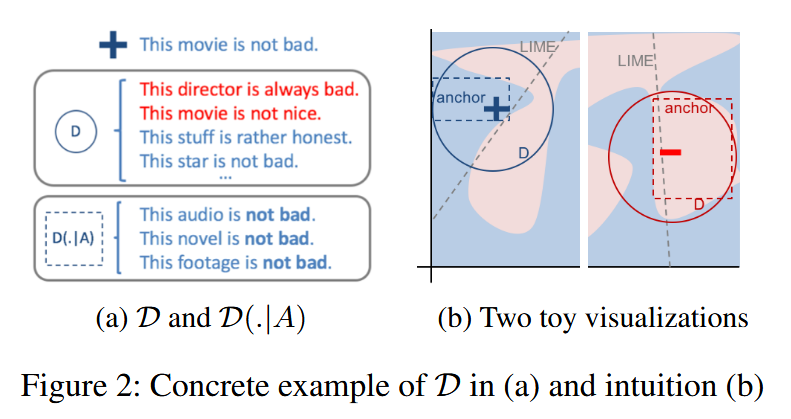
LIME은 Local 영역에서 선형 모델을 학습햐서 설명을 생성함.
하지만
- 설명이 실제 모델을 얼마나 잘 근사하는지(Faithfulness)
- 설명이 어디까지 적용되는지(Coverage)
를 알기는 어려움.
반면에 Anchor는
- Rule이 만족되는 영역에서만 설명을 제공하기 때문에
Coverage가 명확함. - 모델의 행동에 맞춰 Coverage가 자동으로 결정되므로
설명의 신뢰도도 높음.
다양한 분야 적용 가능
논문에서는 Anchor가 특정 문제에만 사용하는 기법이 아니라
다양한 머신러닝 문제에 적용 가능함을 보여줌.
1. Text Classification
LSTM 기반 감성분석 모델에 적용.
사람이 이해하기 어려운 Sentence Embedding 대신
단어의 존재 여부를 설명 대상으로 사용함.
예를 들어
IF

"not"
AND
"bad"

↓

Positive
라는 Anchor가 생성되면,
해당 단어들이 존재하는 대부분의 문장에서 Positive를 예측함.
2. Structured Prediction
품사 태깅(POS Tagging)과 기계번역(Machine Translation)에 적용.
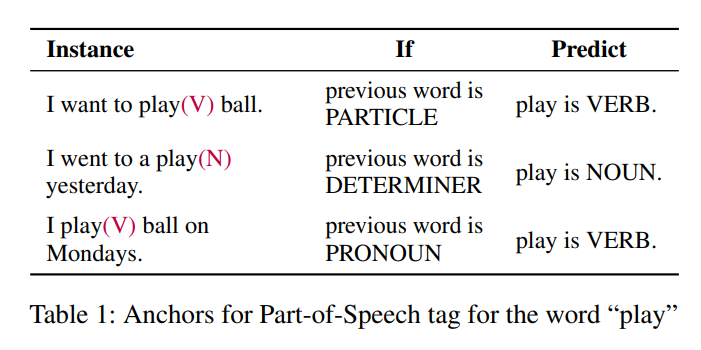
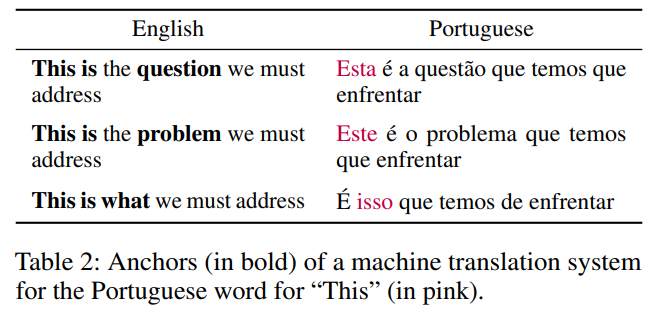
예를 들어
- "play" 앞에 관사가 오면 명사(Noun)
- 특정 영어 단어 조합이 등장하면 특정 포르투갈어 단어가 항상 포함
과 같은 규칙을 Anchor로 설명할 수 있었음.
3. Tabular Classification
표 형태(Tabular) 데이터에도 적용 가능함.
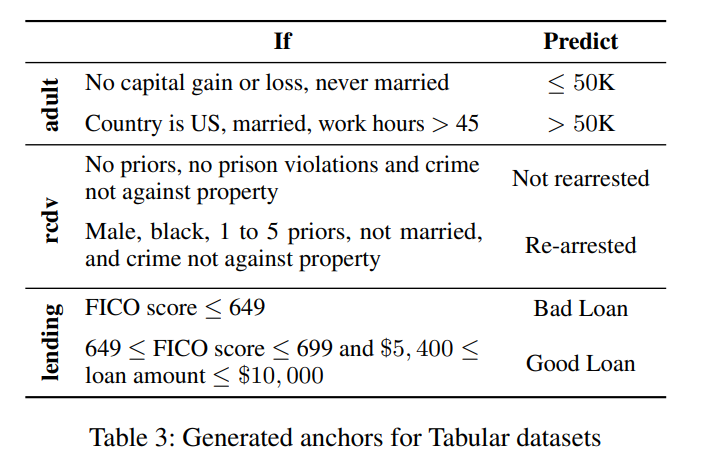
논문에서는
- Adult Income
- Recidivism
- Lending Club
데이터셋= 사용함.
ex.
- 결혼 여부(Marital Status)
- 인종(Race)
- 성별(Gender)
- FICO Score
등이 특정 예측을 결정하는 Anchor로 생성되었음.
=> 모델이 어떤 Feature를 중요하게 사용하는지,
+편향(Bias)까지 확인할 수 있었음.
4. Image Classification
이미지는 Superpixel을 이용해서 설명함.
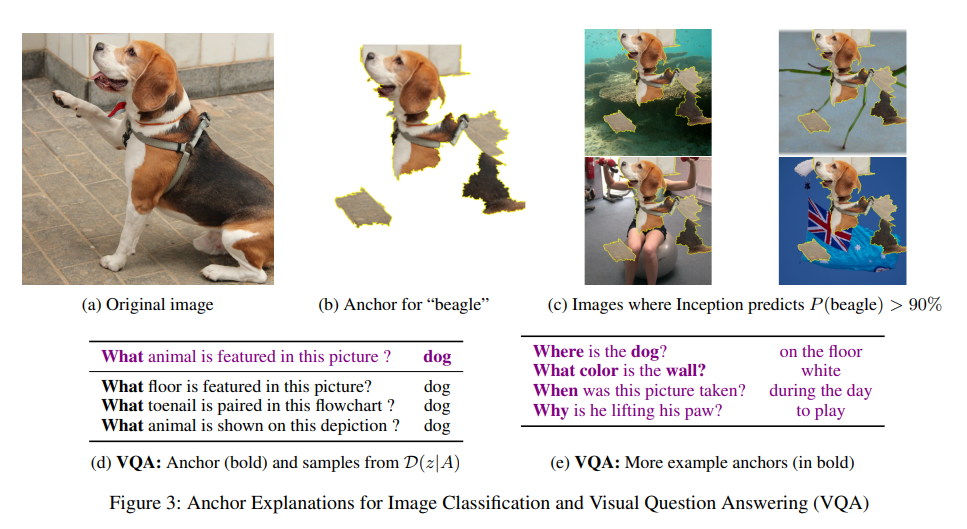
Anchor에 포함된 Superpixel은 그대로 유지하고,
나머지 영역은 다른 이미지로 교체하면서
모델 예측이 유지되는지 확인함.
실험 결과,
모델은 사람이 중요하다고 생각하는 부분뿐 아니라
의외의 영역만으로도 같은 예측을 내리는 경우가 있었음.
=> CNN이 실제로 무엇을 근거로 판단하는지 확인할 수 있었음.
5. Visual Question Answering (VQA)
질문과 이미지를 함께 입력받는 VQA 모델에도 적용함.
이 경우에는
이미지가 아니라 질문의 어떤 단어가 답변에 영향을 준건지를 Anchor로 설명함.
논문에서는
질문에서 "What" 하나만으로도 모델이 항상 "dog"라고 답하는 사례를 발견함.
이를 통해 모델이 질문을 제대로 이해하지 못하고 있다는 사실도 확인할 수 있었음.
- Local Explanation은 입력 주변(Local Region)에서만 모델을 설명하는 방식.
- Anchor는 특정 Rule이 만족되면 모델의 예측이 거의 변하지 않는 충분조건(Sufficient Condition)을 찾는 기법임.
- Anchor 품질은 Precision이 일정 기준(논문에서는 95%) 이상인지로 판단함.
- LIME보다 Coverage와 Faithfulness가 명확하다는 장점이 있음.
- Text, Structured Prediction, Tabular, Image, VQA 등 다양한 문제에서 적용 가능함을 확인함.
✅3. Related Work
왜 모델을 이해해야 하나
논문에서는 모델의 예측 성능(Validation Accuracy)만으로는 모델을 신뢰하기 어렵다고 설명함.
실제로는
- 실제 성능을 과대평가하거나
- 잘못된 피드백이 반복되거나
- 데이터 누수(Data Leakage)를 발견하지 못하는
등의 문제가 발생할 수 있기 때문.
=> 모델의 예측 결과뿐 아니라 모델이 왜 그런 판단을 내렸는지를 이해하는 과정도 매우 중요함.
Rule 기반 설명 장점
논문에서는 다양한 설명 방식 중에서도 Rule 기반 설명이 사람에게 가장 이해하기 쉽다고 설명함.
특히
- 이해하기 쉽고
- 신뢰하기 쉽고
- 적용하기도 쉬움.
또한 Decision Tree처럼 여러 단계로 이어지는 구조보다,
독립적인 짧은 Rule이 훨씬 해석하기 쉽다고 설명함.
Global Explanation 한계
기존에는 모델 전체를 하나의 해석 가능한 모델로 만드는 연구도 많이 진행되었음.
대표적으로
- Rule 기반 모델
- Decision Tree
등이 있음.
우선 이런 방법은
모델 전체(Global)를 설명할 수 있다는 장점이 있음.
모든 입력에서 모델이 어떻게 동작하는지를 이해할 수 있는 것.
하지만 한계도 있기 마련.
특히
- Text
- Image
처럼 Feature가 엄청 많은 문제에서는
Rule 기반 모델 자체를 만들기 어렵고,
만든다고 ㅎㅐ도
정확도나 표현력이 크게 떨어질 수 있음.
=> Global Interpretability는
유연성(Flexibility), 정확도(Accuracy), 효율성(Efficiency) 을 희생해야 하는 경우가 많다는 것.
Global Surrogate Model의 한계
또 다른 방법은
복잡한 Black-box 모델을
간단한 모델(Decision Tree, Rule Set 등)로 흉내 내는(Surrogate) 방법.
하지만 단순한 모델은
복잡한 모델의 동작을 완벽하게 표현하기가 어렵기 때문에,
사용자가 잘못된 결론을 내릴 가능성이 있음.
=> 사람이 모델을 잘못 이해하게 되어
Human Precision이 낮아질 수 있음.
★ Local Explanation 등장
이러한 문제를 해결하기 위해
Local Model-agnostic Explanation이 등장함.
Local Explanation은
모델 전체를 설명하는 대신,
개별 입력에 대한 예측만 설명하는 방식.
대표적인 방법:
- LIME
- Anchors
등
이런 방법은
복잡한 모델에도 적용할 수 있고,
설명도 비교적 이해하기 쉽다는 장점이 있음.
근데 LIME은
LIME은 입력 주변(Local Region)을
선형 모델(Linear Model)로 근사해서 설명을 생성함.
하지만 실제 모델의 결정 경계는
매우 복잡한 비선형(Non-linear) 구조인 경우가 많음.
= Local 영역에서도
선형 모델이 실제 모델을 제대로 근사하지 못할 수 있다는 것.
그러니까 사용자는
not은 Positive에 영향을 준다고 잘못 일반화해서
모델의 행동을 오해할 수도 있음.
또한
Linear Explanation은 여러 Feature의 가중치를 함께 해석해야 하기에,
설명을 이해하기 위해 추가적인 계산(Human Effort)이 필요함.
무엇보다도
설명이 어디까지 적용되는지(Coverage)가 명확하지 않다는 문제가 존재함.
LIME과 달리 Anchor는
Anchor는 위와 같은 문제를 해결하기 위해 제안된 방법임.
Anchor는
If-Then Rule 형태로 설명을 생성하면서,
Rule이 만족되는 경우에만 설명을 적용함.
= Coverage가 매우 명확하다는 것.
또한 Anchor는
Precision 조건(논문에서는 95%)을 만족하는 Rule만 생성하기에,
설명 자체가 모델의 실제 동작(Faithfulness)을 잘 반영함.
그리고 Rule 형태기 때문에
사람도 설명을 쉽게 이해하고,
새로운 입력에서도 모델이 어떻게 동작할지를 더 정확하게 예측할 수 있음.
- Validation Accuracy만으로는 모델을 충분히 신뢰하기 어렵고.
- Global Explanation은 모델 전체를 설명할 수 있지만 복잡한 문제에는 적용하기 어려움.
- Global Surrogate Model은 복잡한 모델을 완벽하게 표현하지 못해 Human Precision이 낮아질 수 있음.
- Local Explanation은 개별 예측을 설명하지만, LIME은 Coverage와 Faithfulness가 불명확하다는 한계가 있음.
- ★ Anchor는 Rule 기반 설명을 통해 Coverage를 명확하게 제시허면서, 높은 Precision과 Faithfulness를 함께 제공함.
✅4. Efficiently Computing Anchors
앞에서 Anchor를
모델의 예측을 거의 항상 유지시키는 Rule이라고 정의했는데,
실제로는
어떤 Rule이 좋은 Anchor인지 찾는 과정이 가장 어려운 문제.
Precision
논문에서는 Anchor의 Precision을 아래와 같이 정의함.
Anchor가 만족되는 다양한 샘플을 생성했을 때,
원래 입력과 동일한 예측이 나오는 비율을 의미함.
Anchor

↓

{"not", "bad"}
일 때,
This movie is not bad.
→ Positive

This book is not bad.
→ Positive

This restaurant is not bad.
→ Positive

This coffee is not bad.
→ Negative
총 4개 중 3개가 같은 예측이라면
Precision = 75%가 되는 것.
실제 Precision은 계산하기 어려움
하지만 현실에서는
- Anchor가 만족되는 모든 경우를 확인할 수 없음.
=> Precision을 정확하게 계산하는 것은 거의 불가능함.
그래서 논문에서는
높은 확률로 Precision이 일정 기준 이상이면 Anchor라고 판단
하는 확률적 정의를 사용함.
- : 최소 Precision 기준 (논문에서는 0.95)
- : 허용 오차
논문에서 95% 이상의 Precision을 가질 가능성이 매우 높으면
좋은 Anchor라고 판단함.
Coverage도 함께 고려
Precision만 높다고 좋은 Anchor는 아님.
ex.
IF

This movie is not bad.
처럼
문장 전체가 Rule이라면 항상 맞을 수는 있지만,
적용 가능한 경우가 거의 없음.
그래서 논문에서는
Coverage도 함께 고려함.
*Coverage
: Anchor가 적용되는 입력의 비율(= Perturbation Distribution D에서 Anchor가 만족되는 확률)
가능하면
- Precision은 높고
- Coverage도 넓은
Anchor를 찾는 게 목표.
최종 목표는
논문에서는 Anchor 탐색 문제를
Precision 조건을 만족하는 Anchor 중에서 Coverage가 가장 큰 Rule을 찾는 것이라고 정의함.가장 넓은 범위에서 사용할 수 있는
신뢰도 높은 Rule을 찾는 것이 목적이라는 것.
Greedy 방식으로 Anchor 생성
논문에서는 처음에 Greedy 방식을 설명함.
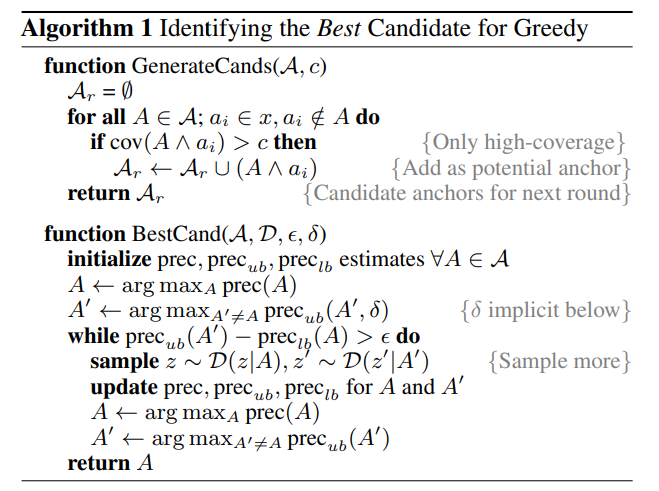
① GenerateCands()
현재 Rule에 Feature를 하나씩 추가하여
새로운 후보 Rule들을 생성한다.{} ↓ {"not"} {"bad"} {"movie"} ...하지만 모든 후보를 사용하는 것은 아니고,
현재까지 찾은 Anchor보다 Coverage가 큰 후보만 다음 단계 후보로 사용.
cov(A ∧ ai) > c
조건을 만족하는 Rule만 남기는 것
② BestCand()
생성된 후보들 중
가장 Precision이 높은 Rule을 선택하는 과정.이를 위해
KL-LUCB 알고리즘을 사용하는 거고.처음에는 모든 후보의 Precision을 대략 추정하고,
현재 가장 좋아 보이는 후보
VS
가장 가능성이 높은 경쟁 후보
이 두 후보만 계속 추가 샘플링.
Confidence Bound가 충분히 벌어질 때까지 반복하며,
최종적으로 Precision이 가장 높은 Rule 하나를 선택함.모든 후보를 끝까지 평가하지 않고, 가장 유망한 후보만 집중적으로 평가하여 계산량을 줄임.
처음에는 아무 조건도 없는 빈 Rule에서 시작함.
A = {}↓
Feature를 하나씩 추가함.
{}

↓

{"not"}

↓

{"not", "bad"}

↓

{"not", "bad", "movie"}
매 단계마다
가장 Precision이 높은 Rule을 선택하면서
Rule을 점점 확장함.
그리고 Precision이 기준(95%)을 넘으면
Anchor 탐색을 종료함.
(신뢰구간의 하한(lower bound)이 τ를 넘으면 종료)
근데 문제점도 있겠지
하지만
한 번 선택한 Rule은 다시 되돌릴 수 없다는
Greedy 방식의 한계 존재.
초기에 잘못 선택하면
더 좋은 Anchor를 찾지 못할 수도 있음.
그리고
Rule의 길이만 짧게 만들 뿐,
Coverage가 가장 큰 Anchor를 직접 찾지는 못함.
Bottom-up Construction of Anchors
Greedy 방식에서는
매 단계마다 생성된 후보 Rule 중
가장 Precision이 높은 Rule을 선택해야 함.
하지만 후보 Rule이 매우 많기 때문에
모든 후보를 끝까지 평가하면 계산량이 너무 커짐.
그래서 논문에서는
Multi-Armed Bandit 문제로 변환함.
여기서
- 하나의 Rule = 하나의 슬롯머신(Arm)
- Reward = Precision
이라고 생각함.
어떤 Rule이 가장 Precision이 높은지
가능한 최대한 적은 샘플만 사용해서 찾아내는 것.
KL-LUCB 알고리즘
이를 위해
논문에서는 KL-LUCB 알고리즘을 사용함.
KL-LUCB는 각 후보 Rule의 Precision에 대한
상한(Upper Bound)과 하한(Lower Bound)을 계속 갱신하면서
가장 좋은 Rule을 찾는 알고리즘.
(= 현재 가장 좋아 보이는 Rule과
그 다음 후보만 추가로 샘플링하면서 비교하는 방식. )
모든 후보를 똑같이 평가하텍스트지 않고,
유망한 후보에만 계산을 집중함.
이를 통해 적은 샘플만으로도
가장 Precision이 높은 Rule을 효율적으로 찾을 수 있는 것.
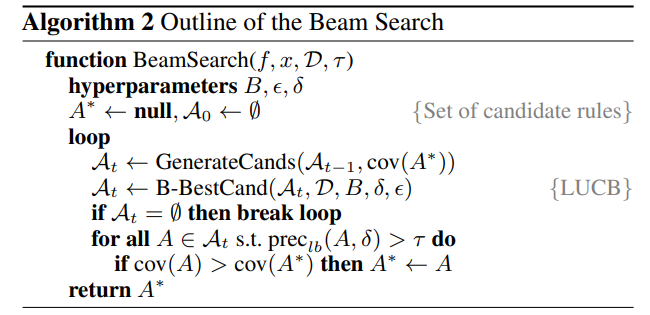
Beam-Search for Anchor Construction
Greedy 방식의 한계를 해결하기 위해
논문에서는 Beam Search를 제안함.
<Beam Search 과정>
① 현재 후보 Rule들을 생성
↓
② KL-LUCB를 이용해
상위 B개의 후보만 선택
↓
③ Precision 조건을 만족하는 후보들 중
Coverage가 가장 큰 Anchor를 갱신
↓
④ 더 이상 확장할 후보가 없으면 종료Greedy는
후보 Rule을 하나만 유지하지만,Beam Search는
여러 개(B개)의 후보 Rule을 동시에 유지함.
후보 1

후보 2

후보 3

...

후보 B
이후 계속 확장하면서 가장 좋은 후보들만 남김다는 뜻.
이렇게 하면
초기에 잘못 선택하더라도
다른 후보를 계속 유지할 수 있음.
또한 현재까지 찾은 최고의 Anchor보다
Coverage가 낮은 후보는 탐색 대상에서 제외(Pruning)해서
탐색 속도도 함께 향상시킴.
그리고 Precision뿐 아니라
Coverage가 가장 큰 Anchor를 찾을 가능성도 높아짐.
논문에서는 최종적으로 Beam Search를 사용해서
모든 실험을 수행함.
Hyperparameter
논문에서는 다음 값을 사용함.
- Precision 기준 () = 0.95
- Beam Width () = 10
- Precision 오차 () = 0.1
- 신뢰도 () = 0.05
실제 Anchor 생성 시간은 수 초에서 수 분 정도였다고 설명함.
- Precision은 Anchor가 동일한 예측을 유지하는 비율.
- 좋은 Anchor는 Precision뿐 아니라 Coverage도 높아야 함.
- Anchor 탐색은 가능한 Rule의 수가 매우 많아 완전 탐색이 어려움.
- Greedy 방식으로 Rule을 하나씩 확장할 수 있지만 최적해를 놓칠 수 있음.
- 논문에서는 KL-LUCB 기반 Multi-Armed Bandit을 이용해 Precision을 효율적으로 추정함.
- 최종적으로 Beam Search를 적용해 Coverage가 가장 큰 Anchor를 탐색함.
✅5. Experiments
논문에서는 Anchor가 실제로 사람이 모델을 이해하는 데 도움이 되는지 검증하기 위해 다양한 실험을 수행함.
평가는 크게 두 가지로 진행됨.
- Simulated Users(가상 사용자 실험)
- Real User Study(실제 사용자 실험)
i) Simulated Users
먼저 실제 사람이 아닌 가상의 사용자(Simulated User)를 이용해 Anchor를 평가함.
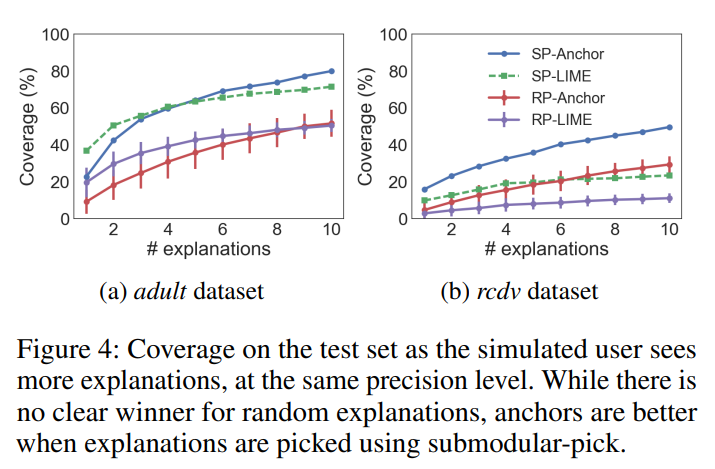
실험에는 다음과 같은 Tabular Dataset을 사용함.
- Adult
- RCDV
- Lending
그리고 각 데이터셋마다 서로 다른 모델을 학습시킴.
- Logistic Regression
- Gradient Boosting
- Neural Network(MLP)
이후 각 모델에 대해
- LIME
- Anchor
두 설명 기법을 생성하ㅣ고 비교함.
평가 지표
논문에서는 두 가지 지표를 사용함.
Coverage
사용자가 설명을 보고
이 경우에는 예측할 수 있겠다고 판단한 데이터의 비율.
Coverage가 높을수록
설명이 적용되는 범위가 넓다는 의미.
Precision
사용자가 실제로 예측한 것 중 얼마나 맞았는지.
높은 Precision을 유지하면서도 Coverage를 최대한 넓히는 게 중요.
LIME vs Anchor
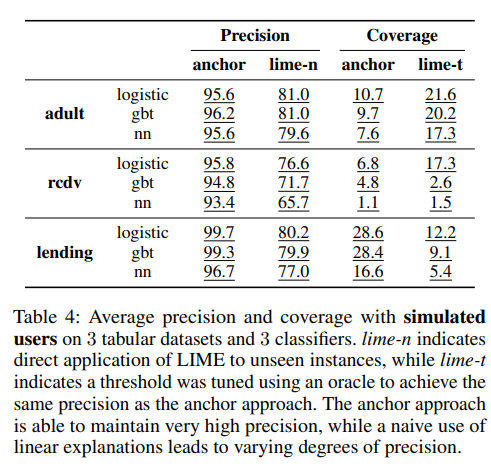
논문에서는 LIME 사용자를 두 가지로 가정함.
Lime-n (Naive User)
설명을 본 후 항상 그대로 적용하는 사용자.
설명이 언제까지 적용되는지는 고려하지 않음.
결과적으로 Precision이 크게 떨어지는 경우가 많았음.
Lime-t (Threshold User)
LIME의 예측 확률이
일정 Threshold 이상일 때만 설명을 적용하는 사용자.
논문에서는
Anchor와 같은 Precision이 나오도록
Threshold를 테스트 데이터까지 이용하여 최적으로 조정함.
실제 사용자라면 알 수 없는 정보를 이용해
LIME에 최대한 유리한 조건을 만들어 준 것.
그럼에도 불구하고
Coverage에서는 Anchor보다 뚜렷한 우위를 보이지 못했음.
Submodular Pick(SP)
실제 사용자는 설명 하나만 보는 것이 아니라
여러 개의 설명을 함께 보며 모델을 이해함.
논문에서는 이전 장에서 소개한
Submodular Pick(SP)을 이용해
가장 대표성이 높은 Anchor들을 선택함.
=> 무작위(Random Pick)보다
훨씬 적은 개수의 설명만으로도
모델의 전체 동작을 효과적으로 이해할 수 있었음.
ex. 약 10개의 Anchor만으로도 모델의 약 50% 정도를 설명할 수 있었다는 것.
ii) User Study
다음으로 실제 사용자 26명을 대상으로 실험을 수행함.
참가자는 머신러닝 수업을 들었거나 관련 지식을 가진 학생들로 구성.
실험에는
- Adult
- RCDV
- Visual Question Answering(VQA)
세 가지 문제 사용.
실험 방법
사용자는 먼저
설명 없이 모델의 예측을 맞혀봄.
그 이후
- LIME 설명
- Anchor 설명
을 차례대로 제공받은 뒤
새로운 데이터에 대해
모델이 어떤 예측을 할지 다시 맞히도록 함.
확신이 없으면
"I don't know"를 선택할 수 있도록 함.
논문에서는
- Coverage
- Precision
을 함께 측정하여 비교함.
실험 결과
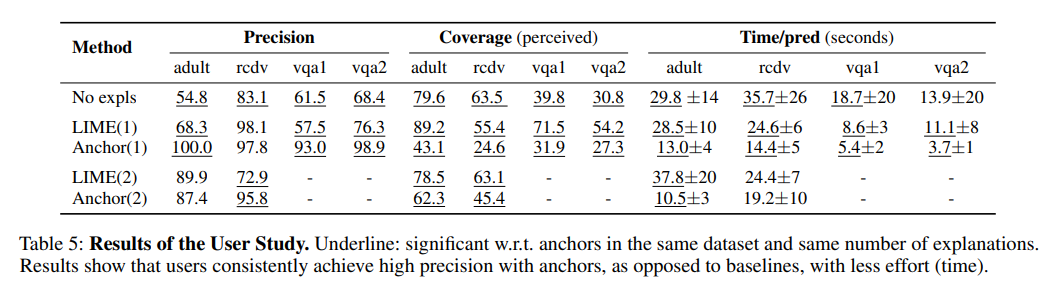
결과적으로,
Anchor를 사용한 경우 거의 모든 데이터셋에서
약 95% 수준의 높은 Precision을 유지했음.
또한 두 번째 Anchor를 제공할수록
Coverage도 함께 증가하는 모습을 보였음.
반면 LIME은
데이터셋에 따라 Precision 편차가 매우 컸고,
일부 실험에서는
설명을 제공하지 않은 경우보다도
낮은 Precision을 보이기도 했음.
사용자 설문 결과
추가 설문에서도 Anchor가 훨씬 높은 평가를 받았음.
- 21 / 26명이 Anchor 선호
- 24 / 26명이 Anchor가 더 정확한 판단을 할 수 있다고 응답
또한 많은 참가자가
LIME은 여러 Feature의 가중치를 계산해야 해서
이해하기 어렵다고 답한 반면,
Anchor는
If-Then Rule 형태라
훨씬 직관적이고 사용하기 쉬웠다고 평가했음.
- 논문은 Simulated User와 실제 User Study를 모두 수행함.
- Anchor는 LIME보다 일관되게 높은 Precision을 유지했음.
- Coverage 역시 충분히 넓게 확보할 수 있었음.
- Submodular Pick을 이용하면 적은 수의 Anchor만으로 모델의 전체 동작을 효과적으로 이해할 수 있었음.
- 실제 사용자도 Anchor를 더 쉽고 신뢰할 수 있는 설명 방식으로 평가했음.
✅6. Limitations and Future Work
논문에서는 Anchor의 장점뿐 아니라 한계점도 함께 설명함.
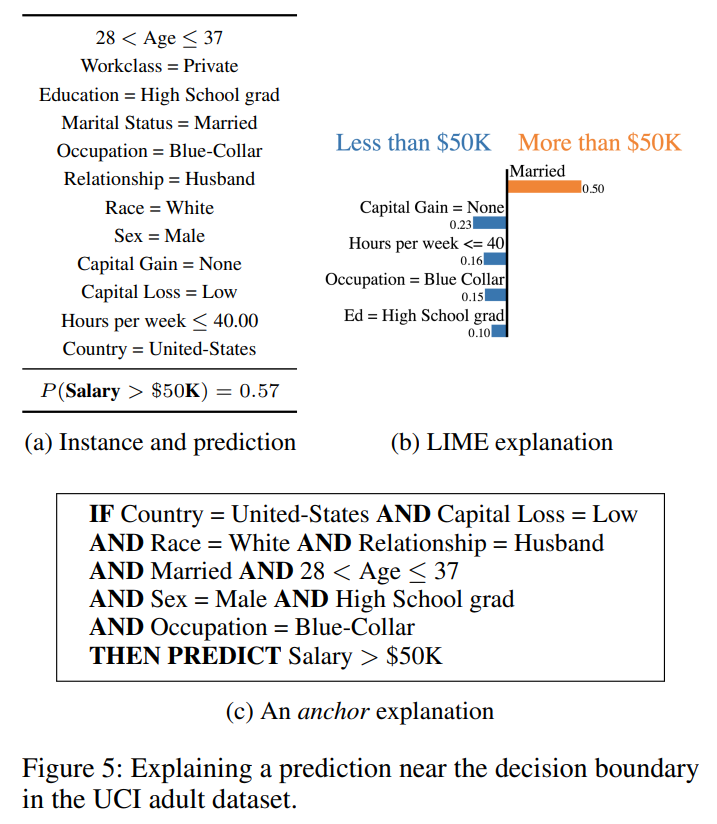
i) Overly specific anchors
지나치게 구체적인 Anchor
Anchor는 높은 Precision을 만족해야 하기 때문에,
예측 경계(Decision Boundary) 근처의 데이터에서는 조건이 매우 많아질 수 있음.
IF

조건 1
AND 조건 2
AND 조건 3
AND ...
처럼 Rule이 지나치게 복잡해질 수 있음.
이 경우 Precision은 높지만,
적용 가능한 경우가 매우 적어서 Coverage가 낮아짐.
또한 이런 Anchor는
모델이 어떤 특징을 학습했는지 이해하기보다는,
이 데이터가 Decision Boundary 근처에 있다는 사실만 알려주는 경우도 있음.
논문에서는 이런 상황에서는
Coverage는 명확하지 않지만
Feature의 영향력을 보여주는 LIME이 오히려 더 유용할 수도 있다고 설명함.
ii) Potentially conflicting anchors
서로 충돌하는 Anchor
이론적으로는
하나의 입력에 대해 서로 다른 예측을 하는 Anchor가 동시에 적용될 수도 있음.
Anchor A

↓

Positive
Anchor B
↓
Negative하지만 논문에서는
이런 상황은 실제로는 거의 발생하지 않을 거라고 설명함.
그 이유는
- Anchor 자체가 높은 Precision을 만족하도록 생성되고,
- Submodular Pick 과정에서 서로 많이 겹치는 Anchor를 줄이기 때문.
만약 실제로 이런 상황이 발생한다면
사용자에게 충돌을 알려주고,
Precision 기준()을 더 높여
Anchor를 다시 생성할 수 있는 방법을 제안함.
iii) Complex output spaces
복잡한 출력 공간
Classification뿐 아니라
번역(Translation),
POS Tagging,
VQA 등에도 Anchor를 적용했지만,
여전히 복잡한 출력 전체를 설명하는 문제는 해결하지 못했다고 설명함.
ex. Multi-label Classification에서는
Label A

Label B

Label C
를 각각 설명해야 하는지,
아니면 전체 Label 집합을 한 번에 설명해야 하는지 아직 명확한 방법이 없음.
이 부분은 Anchor뿐 아니라
전체 XAI 분야의 열린 연구 과제로 남아 있다고 설명함.
iv) Realistic perturbation distributions
Perturbation Distribution 설계
Anchor는 입력을 조금씩 변경(Perturbation)하여
Rule의 Precision을 계산함.
따라서
좋은 Perturbation Distribution() 을 만드는 게 매우 중요함.
하지만 특히 이미지 분야에서는
사람이 이해하기 쉬우면서도 모델의 실제 동작을 잘 반영하는 Perturbation을 만드는 게 쉽지가 않음.
논문에서도 이미지에서는 어느 정도 의미 있는 설명을 얻었지만,
아직 이미지 간 설명을 공정하게 비교할 만큼
현실적인 Perturbation Distribution은 아니라고 인정함.
- Decision Boundary 근처에서는 Anchor가 지나치게 복잡해져 Coverage가 낮아질 수 있음.
- 이론적으로 서로 다른 Anchor가 동시에 적용될 수 있지만 실제 가능성은 매우 낮음.
- 번역, VQA처럼 출력 구조가 복잡한 문제는 아직 완전히 설명하기 어려움.
- Anchor의 성능은 Perturbation Distribution의 품질에 크게 의존하며, 특히 이미지 분야에서는 여전히 개선이 필요한 과제로 남아 있음.
🔚7. Conclusions
논문에서 좋은 Local Explanation이 되기 위해서는
높은 Precision과 명확한 Coverage가 반드시 필요하다고 주장함.
이를 위해
Anchor라는 새로운 Model-agnostic 설명 기법을 제안함.
Anchor는
모델의 예측을 유지시키는 데 충분한 조건(Sufficient Condition)을
If-Then Rule 형태로 표현하기 때문에,
설명이 직관적이고 이해하기 쉬움.또한
Rule이 언제 적용되는지가 명확하기 때문에
Coverage도 명확하게 알 수 있다는 장점이 있음.
Text, Image, Tabular, Translation, VQA 등
다양한 분야에 Anchor를 적용해서 높은 활용 가능성을 확인했음.
또한 실제 사용자 실험(User Study)을 통해
기존의 선형 기반 설명(LIME)보다
- 더 높은 Human Precision을 제공했고,
- 설명을 이해하고 적용하는 데 필요한 노력(Human Effort)도 더 적다는 것을 확인함.
- 좋은 Local Explanation은 높은 Precision과 명확한 Coverage를 가져야 함.
- Anchor는 충분조건(Sufficient Condition)을 Rule 형태로 표현하는 Model-agnostic 설명 기법임.
- 다양한 데이터와 모델에서 적용 가능함을 실험으로 검증했음.
- 사용자 실험에서도 LIME보다 더 정확하고 이해하기 쉬운 설명을 제공했음을 확인함.
