Paper: An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
🔍1. Introduction
자연어처리(NLP)에서 Transformer는 거의 표준.
Self-attention 기반 Transformer 모델은 NLP에서 완전히 자리 잡음.
방식은 간단함:
→ 대규모 텍스트 데이터로 pre-train
→ 작은 task에 fine-tune
ex) BERT, GPT류 모델이 대표적
확장성도 좋아서 요즘엔 100B+ 파라미터짜리 초거대 모델도 무리 없이 학습됨
모델 크기 커지고, 데이터도 커지는데도 성능 한계는 아직 안 보임
→ 이게 Transformer의 무서운 점
그런데 Vision 쪽은 아직 CNN...
이미지 분류/탐지 등에서는 여전히 Convolution 기반 CNN이 표준.
LeNet → AlexNet → ResNet으로 이어졌고,
최근 들어서는 CNN + Attention 조합 시도 O
ex) Non-local networks, DETR 등
어떤 건 아예 convolution을 버리고 self-attention으로 대체한 것도 있음
하지만…
이들 대부분은 attention 연산이 특수해서 GPU/TPU에서 학습 비효율적
→ 결국 ResNet류가 대규모 이미지 인식에서 여전히 SOTA 잡고 있음
그래서 ViT가 제안됨
“CNN 없이도 Transformer만으로 이미지 분류 잘 되지 않을까?”
→ 이게 ViT 논문의 핵심 출발점
NLP처럼 Transformer를 이미지에 직접 적용해보기로 함
이미지를 작은 패치(16x16)로 나눔
각 패치를 Flatten + Linear Embedding
위치 정보 붙이고 → NLP처럼 Transformer에 입력함
마지막 [CLS] 토큰으로 분류함
패치를 마치 "단어 token"처럼 보는 접근 방식임!
+Transformer는 이미지에 바로 적용하면 작은 데이터에서는 불리하지만, 데이터가 크면 CNN 없이도 충분히 SOTA 달성 가능했음!
✅2. Related work
Transformer는 원래 NLP에서...
Transformer는 원래 기계번역용(machine translation)으로 처음 나옴
이후 GPT, BERT 등으로 발전하면서 NLP 전 분야에서 사용.
기본 전략
: 큰 텍스트 코퍼스로 self-supervised pre-training하고, 이후, task-specific 데이터로 fine-tuning
ex.
- BERT: 마스킹된 단어 예측 (denoising)
- GPT: 다음 단어 예측 (language modeling)
Transformer는 구조 자체가 매우 범용적이라서 이미지에도 적용하고픈 욕심이 생긴 것!
하지만 이미지가 텍스트보다 훨씬 더 복잡한 구조
텍스트는 1D 시퀀스지만, 이미지는 2D...
Self-attention을 픽셀 단위로 하면? → 연산량이 픽셀 수의 제곱
→ 현실적인 입력 크기에서는 불가능
그래서 많은 연구들이 self-attention을 이미지에 적용하기 위해 근사화(approximation) 시도함!
예를 들어,
-
Local Attention 방식
: 픽셀마다 전체가 아닌 근처(local)만 attention함
-> 이후 연구들: CNN처럼 local한 multi-head attention으로 대체
= CNN을 완전히 대체할 수 있지만, 여전히 local 구조에서만 의미 있음 -
Sparse Attention 방식
: 전체 픽셀을 연결하는 대신, 선택적으로 sparse하게 연결
→ 연산량 줄이면서 global attention 흉내냄 -
Axial Attention 방식
: attention을 행(row) → 열(column) 순서대로 적용
위 방법들이 대부분 성능은 좋지만, 실제 하드웨어에서는 복잡한 구현과 느린 연산이라는 치명적 단점 O
ViT와 가장 비슷한 기존 연구
1) 입력 이미지를 2x2 작은 패치로 나눔
2) full self-attention 적용함
-> 구조는 ViT와 거의 유사
단, Cordonnier는 작은 해상도 이미지에만 적용 가능.
ViT는 더 큰 해상도까지 확장 가능.
무엇보다 ViT는 대규모 pre-training + transfer 전략으로 SOTA 성능을 입증했다는 점에서 차별화됨
추가적으로, CNN+attention 조합 연구나, image GPT도 있었음.
다만, ViT는 이 모든 흐름을 종합한 확장판이라고 보면 됨.
ViT는 기존의 다양한 시도들(CNN+attention, local/sparse/axial attention 등)과는 달리
아무 구조적 편향 없이
Transformer를 이미지에 그대로 적용해도
대규모 pre-train만 잘 하면 SOTA 찍을 수 있다는 걸 보여준 것!
✅3. Method
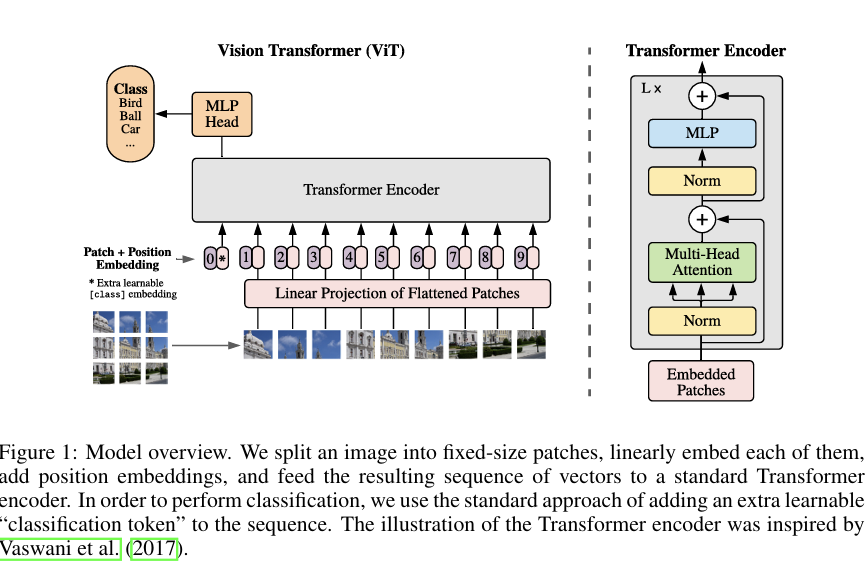
Vision Transformer(ViT) 구조
= “Transformer 원형에서 최대한 손 안 댐”
NLP에서 쓰던 그냥 Transformer 구조 거의 그대로 가져옴.
→ 기존에 잘 최적화된 NLP용 코드/라이브러리 바로 재활용 가능
→ 별다른 복잡한 설계 없이도 잘 돌아감
VISION TRANSFORMER (VIT)
NLP는 1D 시퀀스(단어들),
이미지는 2D 구조…
그래서 ViT 처리 방식은?
1) 이미지를 작게 자름
→ ex: 16x16 크기의 패치로 나눔
→ 원본 이미지가 H×W×C면
→ 총 패치 수는 N = HW / P²개
→ 각 패치 크기는 P×P×C
2) 각 패치를 1D로 펼침(flatten)
→ (P×P×C) 벡터로 만듦
→ 그리고 Linear Projection으로 D차원으로 매핑
→ 이게 Patch Embedding
3) [CLS] 토큰 붙임
→ BERT처럼, 전체 시퀀스 앞에 학습 가능한 [class] 벡터 하나 추가
→ 최종 분류 결과는 이 토큰의 출력으로 결정함
4) Position Embedding 더함
→ 위치 정보를 보존하기 위해 1D learnable positional embedding 사용
→ 실험상 2D-aware embedding 써도 성능 차이 거의 없음
결과적으로, 최종 입력 시퀀스:
[CLS] + Patch_1 + Patch_2 + … + Patch_N + Positional Info
Transformer Encoder 구성
: 입력 시퀀스는 그대로 Transformer Encoder에 들어감
내부 구성은 완전 NLP용과 동일:
- Multi-head Self Attention → MLP Block 반복
- 각 블록 앞에 LayerNorm, 뒤에 Residual 연결
- MLP는 2-layer 구조 + GELU activation
출력 중 [CLS] 토큰 벡터만 뽑아서 → 분류용 MLP Head에 연결
- Pre-training 시에는 MLP 2-layer
- Fine-tuning 시에는 Linear Layer 하나만 사용
CNN과 ViT의 inductive bias 차이
CNN은 이미지 구조를 너무 잘 앎:
- Local receptive field
- Translation equivariance
- 2D spatial 구조 내장됨
근데 ViT는?
- Global attention만 있음
- 공간 정보는 Patch 분할 + Position embedding에만 일부 반영됨
→ 나머지는 전부 학습을 통해 스스로 터득해야 함
그래서 작은 데이터셋에서는 성능이 밀릴 수밖에 없음
대신, 데이터가 충분히 크면 ViT가 오히려 더 유리
Hybrid 구조도 지원
이미지 패치 대신, CNN feature map을 Transformer 입력으로 쓰는 방식도 실험함
- CNN으로 먼저 이미지를 feature map으로 바꿈
- 그걸 다시 패치처럼 나눠서 flatten → Linear Projection
- 이걸 Transformer에 넣는 방식
입력 시퀀스를 만들 때, 패치 크기를 1x1로도 가능함.
이렇게 하면 사실상 feature map을 한 픽셀씩 flatten한 것.
→ ViT의 입력 구성과 Positional Embedding 붙이는 방식은 동일하게 적용 가능
이런 Hybrid 구조는 CNN과 Transformer 장점 조합하려는 시도라고 보면 됨...
FINE-TUNING AND HIGHER RESOLUTION
Pre-training → Fine-tuning이 기본 전략
ViT는 보통 대규모 데이터셋 (ImageNet-21k, JFT-300M 등)에서 pre-train 함
그 다음에, 다운스트림 task에 fine-tuning함 (ex. CIFAR-100, Flowers-102 등)
Fine-tuning 시에는 해상도를 높이는 게 이득.
pre-training은 보통 224×224 이미지 해상도에서 진행하는데,
fine-tuning할 때는 해상도를 더 크게 (ex. 384×384, 512×512) 해도 됨
→ 실제로 성능 향상 효과 O
단, 패치 크기(P)는 고정이므로
이미지 해상도가 커지면 → 패치 수 N도 같이 증가함
→ 결과적으로 Transformer 입력 시퀀스 길이가 길어짐.
이때, Pre-training 때 학습된 position embedding은 시퀀스 길이에 맞춰져 있음
→ 길이가 달라지면 위치 정보가 꼬일 수 있음
해결 방법:
2D 보간(interpolation)
- 기존 position embedding을 이미지 상 위치 기준으로 2차원 보간
- 고해상도 이미지에서도 자연스럽게 위치 정보를 이어받게 함
이게 ViT 구조에서 유일하게 “2D 이미지 구조를 고려한 부분”...
ViT는 CNN처럼 2D 구조를 내장하고 있지 않음
하지만 "패치 나누기 + position embedding 보간"
→ 이 두 지점에서만 약간의 inductive bias가 들어감
그 외에는 모든 공간 정보를 모델이 스스로 학습해야 하는 것.
✅4. Experiments
실험 단계에서는 ViT의 성능을 다양한 측면에서 평가함
→ 특히 다음 세 가지 모델 비교에 중점 둠:
1) ResNet (CNN 기반)
2) ViT (순수 Transformer 기반)
3) Hybrid (CNN + Transformer 혼합)
- 다양한 크기의 데이터셋으로 pre-training 수행
- 다양한 벤치마크 task에 전이 학습 후 평가
- 연산량(컴퓨팅 비용) 대비 성능도 비교함
- Self-supervised ViT 실험도 일부 수행
SETUP
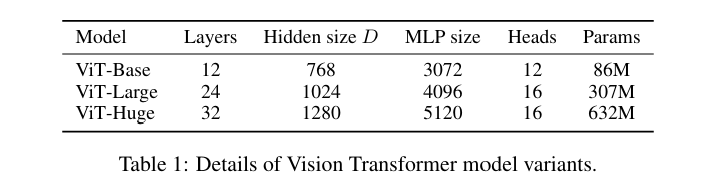
모델 구성: ViT / ResNet / Hybrid
ViT 모델 구성
BERT처럼 Base / Large / Huge 모델로 나눔
패치 크기 작아질수록 시퀀스 길이 길어짐 → 연산량 증가
ResNet (Baseline CNN)
기존 ResNet 쓰되, 다음과 같이 수정함:
BatchNorm → GroupNorm으로 교체
Weight Standardization 적용
→ 이걸 “ResNet (BiT)”이라 부름 (Big Transfer 기반)
Hybrid 모델 (CNN + ViT)
CNN으로 먼저 feature map 생성.
그걸 패치처럼 나눠서 ViT에 넣음
실험에서는 두 가지 방식 시도:
ResNet Stage 4 출력 사용
Stage 3 확장 후 사용 → 더 긴 시퀀스(4배) → 더 비쌈
성능 측정 방식
-
Fine-tuning Accuracy
전체 파라미터를 학습해서 최종 성능 측정 -
Few-shot Accuracy
미세조정 없이, feature만 고정하고 선형 분류기만 학습
→ 정규화된 최소제곱 회귀로 계산
→ 빠르게 평가할 때 사용
대부분 fine-tuning 성능을 중심으로 보고,
few-shot은 부가적인 확인용으로 활용함
COMPARISON TO STATE OF THE ART
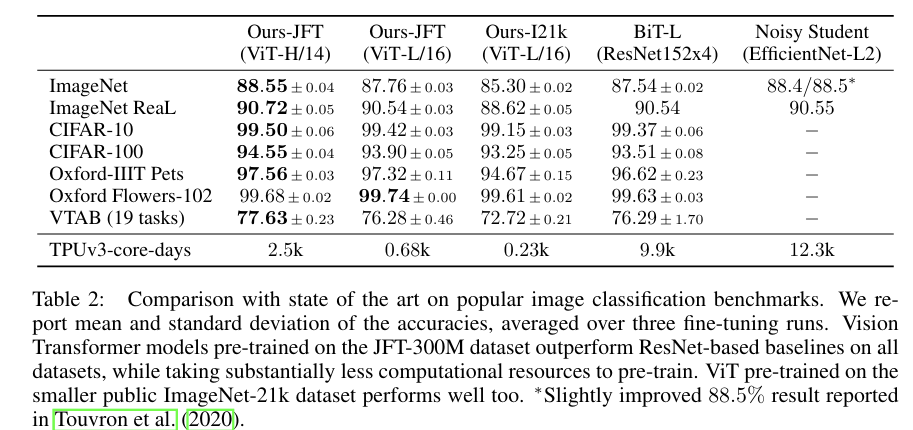
비교 대상: ViT vs 기존 SOTA 모델들
ViT 측 모델
-
ViT-H/14: Huge 모델 + 14×14 패치
-
ViT-L/16: Large 모델 + 16×16 패치
→ 모두 JFT-300M으로 사전학습
비교 대상
BiT-L (Big Transfer)
- 큰 ResNet 계열 모델
- ImageNet-21k or JFT-300M에서 supervised pre-training
Noisy Student (EfficientNet 계열)
- ImageNet + JFT-300M 기반
- 반쯤은 semi-supervised 방식 (라벨 일부 없음)
- 당시 ImageNet 기준 최고 성능
VTAB (19개 전이 학습 task) 결과를 task 유형별로 나눠서 분석
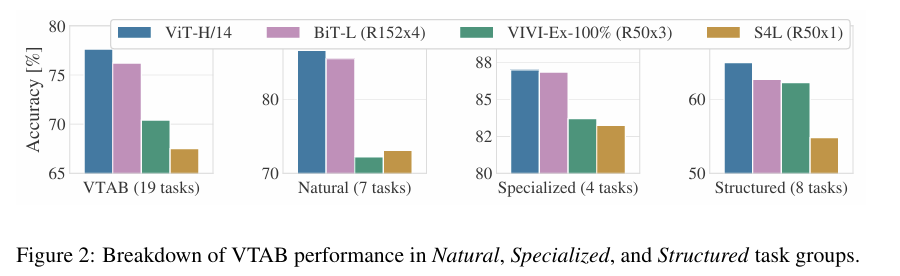
전반적으로 ViT가 더 강력함
특히 Natural, Structured task에서는 확실한 우위
PRE-TRAINING DATA REQUIREMENTS
ViT는 CNN보다 vision inductive bias가 약함
→ 대신 데이터 규모가 매우 중요함
→ 그래서 “데이터 크기에 따라 성능이 어떻게 달라지는지”를 실험함
실험 대상 모델
- ViT-B (Base)
- ViT-L (Large)
실험 구성
작은 데이터셋에서는 정규화 세팅(weight decay, dropout, label smoothing) 조절함
→ 적은 데이터에서도 최대 성능 끌어냄
즉, 작은 데이터 → 작은 모델이 유리함
큰 모델의 성능은 대규모 데이터에서만 진가 발휘
또한, 랜덤 서브셋 실험 (9M / 30M / 90M / 300M) 진행
정규화나 하이퍼파라미터 조정 없이
→ 모델 자체의 본질적인 특성만 보기 위해 진행
- 학습은 early stopping 사용
- 성능 측정은 full fine-tune 대신 few-shot accuracy로 비교 (계산량 절감)
결과적으로,
→ 동일 연산량 기준에서도 CNN은 작은 데이터에 강함
→ ViT는 데이터 많아야 generalization 제대로 배움
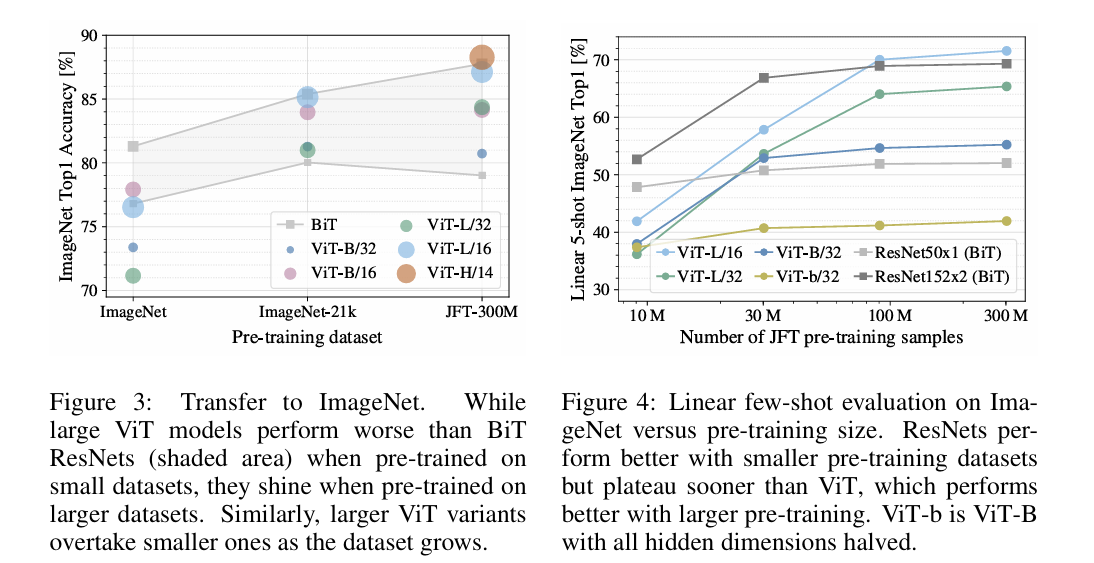
- ViT는 데이터 사이즈가 클수록 훨씬 강해짐
- CNN은 작은 데이터에서도 비교적 안정적
- Pre-training 데이터가 충분하다면 ViT는 구조적 bias 없이도 SOTA 가능
SCALING STUDY
모델 크기 vs 성능 vs 연산비용
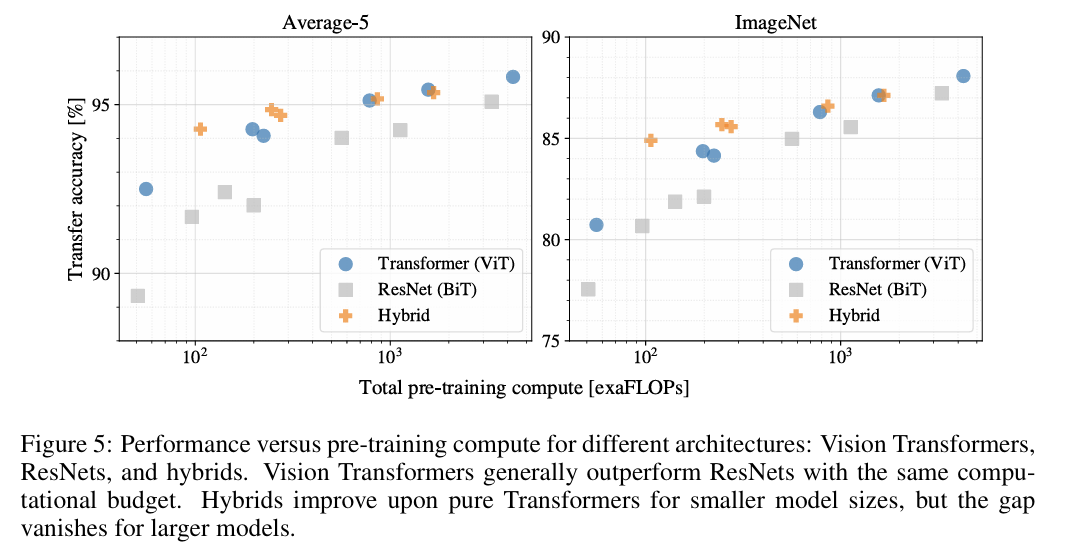
1) ViT가 ResNet보다 연산 효율이 훨씬 좋음
같은 성능을 달성할 때, ViT는 ResNet보다 2~4배 적은 compute로 달성 가능
특히 큰 모델일수록 이 차이가 더 커짐
2) 작은 모델에서는 Hybrid가 ViT보다 조금 나음
연산량이 적을 때는 Hybrid 구조가 약간 더 우수함
CNN이 local feature를 잘 추출해주기 때문
하지만, 모델이 커지면 ViT 단독이 더 나음
일정 규모 이상 커지면 Hybrid의 장점은 사라짐
ViT가 순수하게 더 좋음...
심지어, ViT는 아직도 scaling 여지가 남아 있음
실험 범위 내에서는 성능 포화 현상(saturation)이 안 보임
→ 더 키우면 더 좋아질 가능성 있음
INSPECTING VISION TRANSFORMER
ViT는 CNN처럼 계층별로 feature map을 만들진 않음
→ 대신, 입력 패치에 대한 embedding과 self-attention을 통해 정보를 통합함
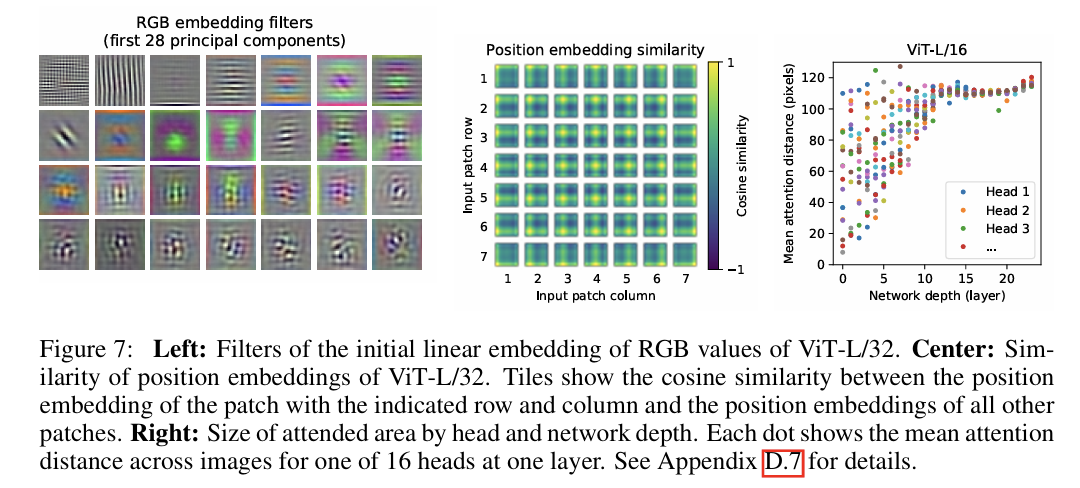
1) 패치 임베딩(Embedding)이 뭘 학습했는가?
2) 포지션 임베딩은 어떻게 공간 정보를 반영하는가?
3) Attention head는 어디를 보고 있는가?
Patch Embedding 분석 (Figure 7 - 좌측)
첫 번째 layer는 패치를 flatten → Linear projection으로 임베딩함
이 weight들을 PCA로 시각화해보면…
→ 실제로 저차원 이미지 기본 구조를 잡는 basis function처럼 보임
(예: Gabor 필터 같은 느낌)
즉, ViT도 CNN처럼 초반 layer에서 edge, texture 같은 기초 구조부터 학습하는 듯함
Position Embedding 분석 (Figure 7 - 중앙)
위치 정보를 위한 learnable 1D position embedding을 시각화함
결과적으로...
가까운 패치일수록 비슷한 위치 임베딩을 가짐
+행(row), 열(column) 구조가 나타남
그리드가 커지면 사인파(sinusoidal-like) 구조도 등장함
이 덕분에 hand-crafted 2D-aware embedding을 굳이 쓰지 않아도 되는 이유임
→ 모델이 알아서 2D 공간 구조를 학습함
Attention 시야 분석 – 얼마나 넓게 보는가? (Figure 7 - 우측)
Self-attention은 원래 전 영역을 동시에 볼 수 있음
→ 근데 ViT는 실제로 그렇게 쓰고 있을까?
각 attention head가 얼마나 넓은 범위까지 attention을 보내는지 측정함
→ CNN의 receptive field 크기랑 유사한 개념
깊은 층: attention 거리 점점 커짐 = 더 넓게 통합함
Hybrid 모델: attention이 전체적으로 더 국소적임
→ CNN이 이미 low-level feature를 뽑아줬기 때문
✅ ViT는 CNN 없이도 초기부터 global 정보 통합 가능함
→ CNN보다 정보 전달이 빠르고 넓음
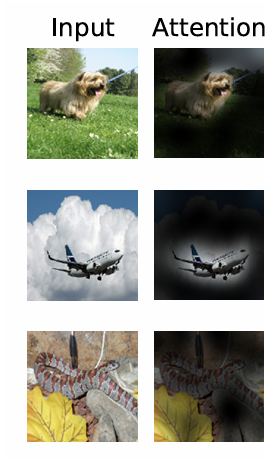
[CLS] 토큰에서 나가는 attention을 이미지 상에 시각화
→ 어떤 영역을 “중요하게 봤는지” heatmap으로 보여줌
ViT는 의미 있는 이미지 영역(예: 객체, 특징 부위 등)에 attention 집중함
classification에 필요한 정보만 뽑아보는 경향 강함
SELF-SUPERVISION
ViT도 BERT처럼 학습할 수 있을까?
→ ViT에도 Masked Patch Prediction을 적용해봄
(= BERT의 Masked Language Modeling 방식 차용)
입력 이미지에서 일부 패치를 mask 처리했음.
모델은 이 패치들의 내용을 예측하도록 학습됨
→ 이미지에 BERT 스타일의 학습 전략 도입한 셈
결과적으로,
Self-supervised만으로도 +2% 향상.
But, 아직 supervised pre-training보다는 약 4% 낮음
한계점...
ViT는 CNN보다 inductive bias가 약하기 때문에
→ self-supervised일수록 더 많은 데이터 / 더 정교한 방법이 필요할 수 있음
아직은 preliminary 수준 실험이고,
→ 향후 contrastive learning 방식 (SimCLR, MoCo 등)도 적용해볼 계획
🔚5. Conclusions
“Transformer를 이미지 인식에 직접 써도 잘 된다”
기존 Vision 연구들은 대부분 CNN 구조 안에 attention만 부분 도입
ViT는 아예 CNN 없이, Transformer만으로 구성된 이미지 분류 모델임.
유일한 이미지 전처리 요소는 "패치 분할"!
“Simple한 구조 + 대규모 pre-training”만으로
ImageNet, CIFAR, VTAB 등에서 SOTA 찍음
성능만 좋은 게 아니라, 학습 비용도 CNN보다 상대적으로 낮음
앞으로 더 큰 모델, 다양한 태스크, 더 나은 학습 전략으로 발전할 여지가 큼!
