Paper: XLNet: Generalized Autoregressive Pretraining for Language Understanding
🔍1. Introduction
자연어 처리(NLP, natural language processing)분야에서 unsupervised(비지도 학습 기반) representation learning은 매우 성공적으로 활용되고 있음.
일반적으로, 이러한 방법들은 먼저 large-scale의 unlabeled text corpus들을 활용해서 pre-training하고, 그 다음에 다양한 downstream tasks에 맞게 fine-tuning을 진행한다.
대표적인 pre-training 방식으로는 AR(autoregressive, 자기회귀) language 모델링과 AE(autoencoding, 오토인코딩) 기반 모델링이 있음.
AR(autoregressive)
AR language modeling은 autoregressive model(자기회귀 모델)을 이용하여, text corpus의 확률 분포를 추정하는 방법임.
특정 text sequence x= (x1, ..., xT)가 주어졌을 때, AR 모델링은 forward/backward 확률 분해를 활용해서 시퀀스의 likelihood를 factorize함.
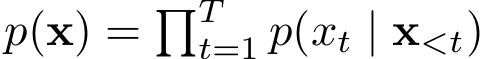 ↑forward 확률 분해
xt 이전의 단어들만을 기반으로 계산
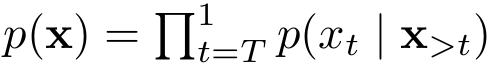 ↑backward 확률 분해
xt 이후의 단어들만을 기반으로 계산
AR language model의 경우 uni-directional(단방향) context만 encode하기 때문에, deep bidirectional context를 modeling하는 것은 어려움.
하지만, downstream language understanding tasks에서는 bidirectional context information이 대개 요구되기에,
AR language model과 효과적인 pre-training 간의 gap이 발생하게 됨.
AE(autoencoding)
반대로, AE(autoencoding) 기반 pre-training의 경우 density estimation(확률 분포 추정)을 하지 않고, corrupted(손상된) input으로부터 원래 데이터를 reconstruct(복원)하는 것을 목표로 함.
대표적인 예시가 BERT임!
이 경우, input된 token sequence에서 일부를 [MASK] token으로 대체하고, 이걸 모델이 origin token으로 recover하도록 하는 방식.
이를 통해 BERT는 bidirectional(양방향) contexts를 기반으로 복원이 가능함.
다만, BERT는 문제가 있음.
1. pre-train과 fine-tune 간 불일치 문제가 존재함. 사전학습 할 때랑 실제 간 데이터 차이가 있다는 것.
2. predicted tokens를 independent하게 처리함. 근데 실제 환경에서는 long-range dependency가 많아서, 독립적으로 assume하는 것이 적합치 않음.
이러한 장단점을 고려하여,
본 논문에서는 XLNet을 제안하고자 함.
이는 AR과 AE modeling의 장점을 결합하며 단점은 보완하는 generalized autoregressive method임.
- 기존 AR model처럼 단방향 context 학습이 아닌, all possible permutations of the factorization order에 log likelihood를 최대화 함. 따라서 양방향 context 고려 가능.
- 앞서 BERT의 경우, pre-train과 fine-tune 간 불일치 문제가 존재한다고 했는데, 이 문제를 해결함. Data corruption을 하지 않는다고 함.
- Transformer-XL의 Segment Recurrence(반복) 및 Relative Encoding 기법을 적용함. 이는 긴 text sequence의 performance를 향상시킴.
- 다양한 벤치마크에서 높은 성능을 기록함.
✅2. Proposed Method
(1) Background
기존 AR language modeling과 BERT의 pre-trainig 방식을 비교해보고자 함.
AR language modeling
주어진 text sequence x=[x1, ..., xT]에 대해서 AR language modeling은 forward autoregressive factorization을 사용해서 pre-training을 하고, 이때 likelihood를 maximizing하는 방식으로 학습됨.
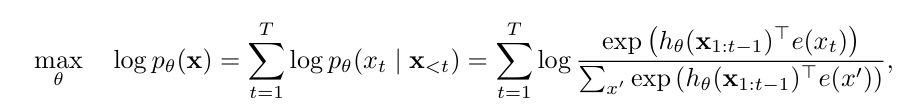
- hθ(x_1:t-1): context representation. RNN/Transformer 기반 신경망 모델이 만들어놓은 벡터.
- e(x): 단어 x의 embedding 벡터.
BERT
BERT의 경우 denoising autoencoding 방식을 사용함. text sequence 입력 시 특정 비율(ex. 15%)의 단어를 [MASK]로 대체하여 corrupted data를 만듦. 그리고 이 corrupted data를 복원하는 것이 목적.
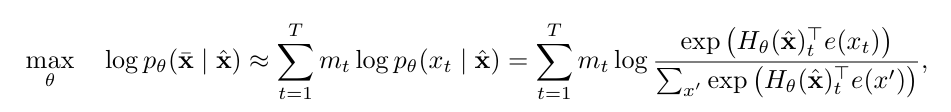
- m_t: 값이 1이면 단어 x_t가 masking된 것.
- Hθ(x): Transformer를 통해 변화된 hidden vectors의 시퀀스임.
Pros and Cons between AR & BERT
- Independence Assumption
: BERT 식 '≈'에서 볼 수 있듯, 이건 masked token들을 independent하다고 가정하고 assumption하는 것.
다만, AR의 경우, 확률 분포를 직접 factorization하여 학습하기에, 따로 가정하지 않고 자연스럽게 modeling 가능. - Input Noise
: BERT에서는 [MASK]를 포함한 데이터로 학습하지만, 실제 downstream task에서는 [MASK]가 없음. pre-train과 fine-tuning 시 데이터 분포가 달라서 문제가 됨(성능 저하 가능).
다만 AR의 경우 input corruption을 하지 않기에, 문제가 발생하지 않음. - Context dependency
: AR language model의 hθ(x_1:t-1)은 이전 단어(왼쪽/단방향이기에)만 참고해서 context 구성하기에 양방향 context 파악 불가.
단, BERT는 Hθ(x)t를 통해 양방향 context 파악 모두 가능.
(2) Objective: Permutation Language Modeling
그럼 앞서 비교한 AR language model과 BERT의 장점을 결합해서 보완해 보고자 함.
permutation language modeling
AR 모델의 장점을 유지하며, 양방향 context 학습이 가능하도록 설계.
길이가 T인 sequence x에 대해, T!개의 factorization order(순서)가 존재하게 됨.
이를 통해 양방향 context를 자연스럽게 학습할 수 있는 것.
Z_T를 길이가 T인 index 시퀀스의 all possible permutations의 집합이라고 정의해보자.
- Z_T: t번째 요소
- Z<t: t-1개의 요소
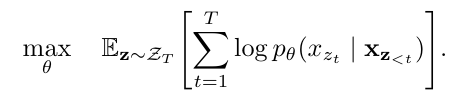
그러면 permutation language modeling objective function(순열 언어 모델링 목적 함수)수식이 상단처럼 표현되는데,
주어진 text sequence x에 대해 특정 factorization 순서 z를 sampling함. 그리고 likelihood pθ(x)를 분해(decompose)하여 학습 진행함.
모델 파라미터인 θ는 모든 factorization에서 공유되고, 각 단어 x_t는 sequence 내에서 모든 다른 가능한 element와 함께 나오기 때문에, bidirectional context 학습이 가능함.
그리고 AR 모델 framework에 fit하기 때문에, 자연스럽게 independence assumption 및 pre-train & fine-tuning discrepancy 문제도 해결할 수 있게 됨.
특히 Permutation Language Modeling의 경우, 단순 입력 시퀀스 순서를 바꾸는 게 아닌, 확률 factorization order 순서를 조정하는 것이 핵심임.
입력 시퀀스 자체의 원래 순서는 바뀌지 않고, Transformer에서 위치 인코딩 & attention mask 잘 사용해서 학습이 이루어짐.
(3) Architecture: Two-Stream Self-Attention for Target-Aware Representations
앞서 permutation language modeling 방식의 장점을 확인했지만, 기존 transformer에 단순 적용하려면 문제가 생김.
일반적인 Transformer에서는 Softmax 함수를 사용해서 next-token 확률 분포를 모델링함.
수식으로 표현하면 하단과 같은데,
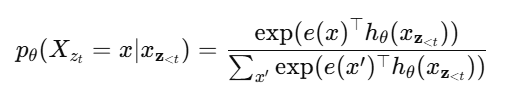
hθ(x_z<t)는 transformer network의 hidden representation이고, proper한 masking을 적용하여서 학습된 값임.
다만, hθ(x_z<t)의 경우 z_t에 depend 하지 않음. 이렇게 되면 모~든 위치에서 same distribution을 predict하게 되니, 특정 target position에 최적화된 representation 학습이 어려움.
이를 해결하기 위해, next-token distribution을 re-parameterize(재 매개변수화)하여 target position을 반영하기로 함.
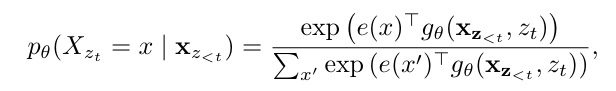
- gθ(x_z<t, z_t): new type of representation. target position z_t를 추가 input으로 받음
Two-Stream Self-Attention
gθ(x_z<t, z_t)을 어떻게 설계할 것인가에 대한 문제를 해결하기 위해, target position z_t에 "stand"해서 context information을 수집하고자 함.
z_t를 기준으로 x_z<t를 attention을 통해 반영하는 방식으로 말이다.
다만, transformer 구조에서는 target token 예측 시의 요구사항이 모순되어 상충됨.
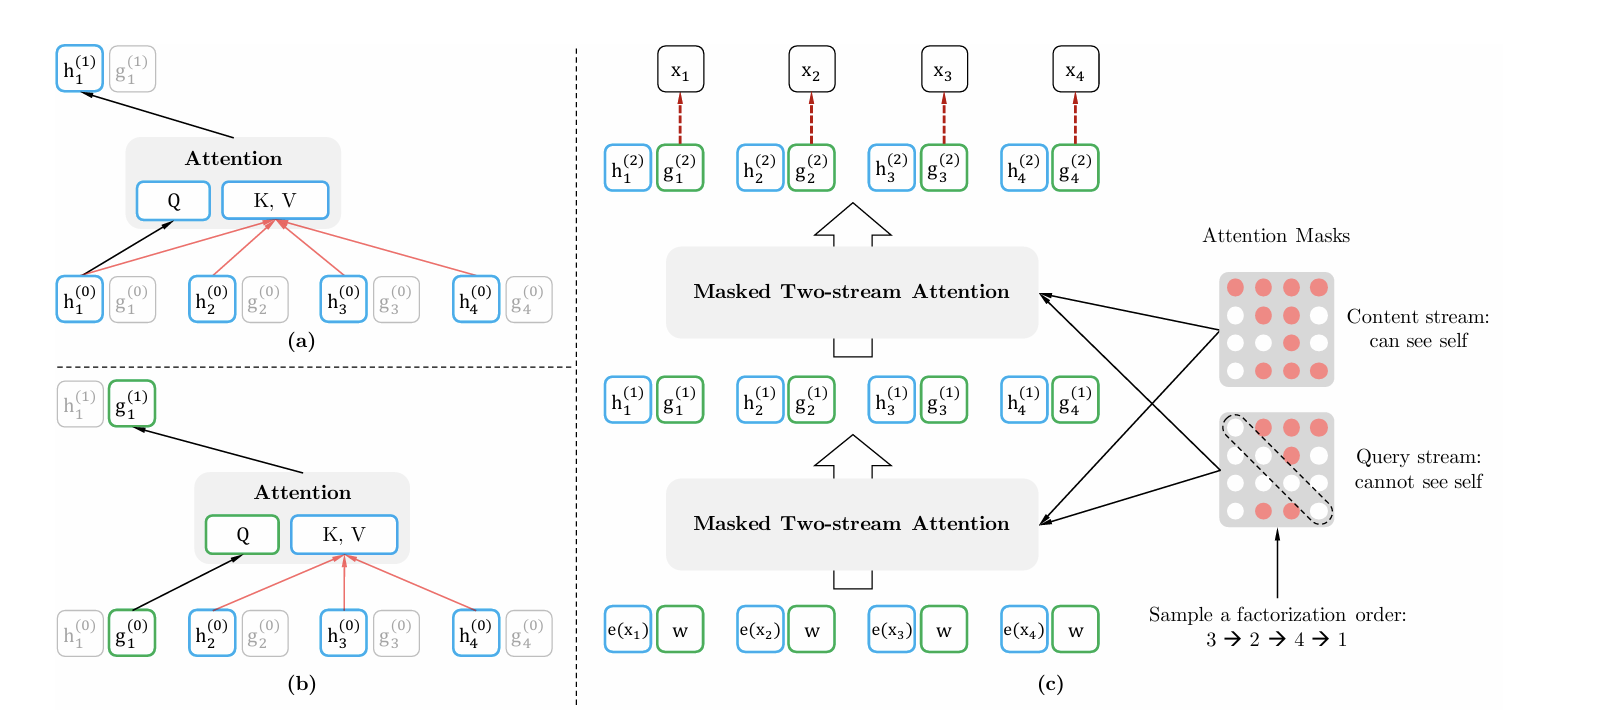
따라서, XLNet에서는 두 개의 서로 다른 hidden representation을 사용함.
(1) Content Representation: hθ(x_z<t)
- 기존 transformer의 hidden states와 같은 역할
- context와 target x_zt 둘 다 포함(전체 context 포함)
(2) Query Representation: gθ(x_z<t, z_t)
- context x_z<t, dnlcl z_t만 포함하고, x_zt는 포함 X (타켓 token 제외하고, 위치/context 정보만 활용)
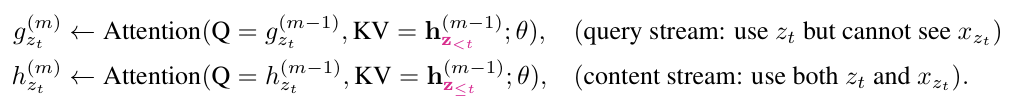
two-stream의 XLNet 구조는 위와 같음.
- Q, K, V:쿼리(Query), 키(Key), 값(Value)
- 상단 식: Query stream은 타겟 단어를 모르는 상태에서 context 기반 예측
- 하단 식: Content stream은 전체 context 고려
Partial Prediction
Permutation Language Modeling은 optimization 난이도가 높고, 학습 속도 저하를 일으키는 문제가 있음. 이를 해결하고자 Partial Prediction 기법을 적용함.
전체 token을 예측하는 것이 아니라, 일부 token만 예측하도록 설계하는 것.
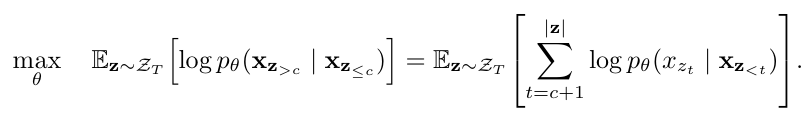
입력 시퀀스 z를 하단 두 부분으로 나눔.
(1) non-target subsequence: z<=c
- 이건 non-target이라 그냥 입력으로만 사용
(2) target subsequence: z>c
- 이것을 예측 대상으로 설정
non-target subsequence z<=c를 조건으로, target subsequence z>c의 log-likelihood를 최대화 하는 것이 목적.
왜 z>c가 타겟?
: 주어진 순열에서 가장 긴 context 포함하고 있기 때문.
즉, target subsequence가 풍부한 문맥 정보를 가진 상태에서 예측할 수 있도록 함
hyperparameter K를 사용하여 일부 token만 사용하도록 함.
전체 token 中 1/K개 token만 prediction 대상으로 설정.
→ 선택되지 않은 token이 굳이 query representation계산할 필요 X
→ 속도 상승 및 메모리 절감
(4) Incorporating Ideas from Transformer-XL
XLNet의 object function은 AR framework를 따르기에, SOTA AR 언어 모델인 Transformer-XL을 pre-training framework에 통합함.
Transformer-XL에서
(1) relative positional encoding
(2) segment recurrence mechanism
위 기법을 참고하여, 시퀀스 내 단어 간 관계 학습(1), 이전 segment 정보 재사용(2)에 반영하였음.
특히 둘 중 segment recurrence mechanism 적용 방식에 대해 하단과 같이 정의함.
긴 sequence s를 두 개의 segment로 분리함.
(1) ~x = s_1:T
(2) x = s_T+1:2T
첫 번째 segment에서 학습된 hidden 상태를 cache하여 저장하고, 두 번째 segment 학습 시 이전 hidden 상태를 재사용해서 성능 향상을 이뤄냄
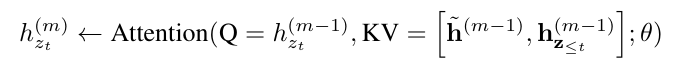
그리고 위치 encoding이라는 것은 original sequence 내의 실제 위치에 따라 결정되기에, 학습된 표현 재사용이 쉬움.
또한, 이전 segment 정보의 캐싱을 통해 다음 segment에서 context 정보 활용 가능함.
따라서 모델이 좀 더 긴 context 학습이 가능하도록 유도됨.
(5) Modeling Multiple Segments
많은 downstream task에서는 multiple input segment가 필요함.
XLNet의 경우 pre-training 단계에서 BERT의 방식을 따르고 하단과 같이 훈련 진행함.
(1) BERT처럼 두 개의 segment random sampling
(2) 두 segment를 연결해서 하나의 sequence로
(3) 같은 context에서 가져온 segment의 경우, 기존 학습 memory 재사용
입력 형식은 BERT와 동일
[CLS, A, SEP, B, SEP]
- CLS: 문장 전체 대표 토큰 (classification token)
- SEP: 문장 구분 토큰
- A, B: 두 개의 세그먼트
단, XLNet-Large의 경우 NSP(Next Sentence Prediction)을 object로 사용하지는 않음.
(일관된 성능 향상이 없어서)
Relative Segment Encodings
BERT는 각 word embedding에 absolute segment encoding을 추가하는 방식임.
즉, 단어의 위치뿐만 아니라, 그 단어가 어떤 세그먼트(A or B)에 속해 있는지도 같이 encoding함.
XLNet은 Transformer-XL의 relative positional encoding 개념을 확장하여
세그먼트도 relative segment encoding함.
시퀀스 내에서 두 위치
i와 j가 같은 세그먼트에 속하는지 여부만 고려함.
이를 통해 모델 일반화 성능 향상 및 2개 이상의 segment가 필요한 task에도 적용 가능하게 함.
(6) Discussion
BERT와 XLNet 모두 Partial Prediction을 수행함. 전체 sequence의 일부 token만을 예측 대상으로 설정하여 학습하는 방식.
partial prediction을 통해 BERT와 XLNet 모두에서 최적화 난이도를 낮추는 역할을 함.
다만 BERT는 independence assumption으로 인해, 예측 대상 간의 관계를 학습할 수 없음.
XLNet의 경우, permutation language modeling을 사용하기에, BERT의 단어 간 dependency 파악 한계를 극복함.
결과적으로, XLNet의 training signals는 BERT보다 더 dense하기에, 더 많은 관계 학습이 가능함.
✅3. Experiments
Pretraining and Implementation
- pre-trainig dataset: BERT와 동일한 BooksCorpus + Wikipedia(13GB) 외에 추가로 더 large dataset 사용.
- XLNet-Large에서 BERT-Large와 같은 하이퍼파라미터 사용.(따라서 두 모델 크기 비슷)
- 공정한 비교를 위해 BERT와 같은 조건에서 학습한 version도 만듦.
- recurrence(순환) mechanism 도입을 통해,
bidirectional data input pipeline 사용. - Partial Prediction 상수 K = 6 설정.
Fair Comparison with BERT
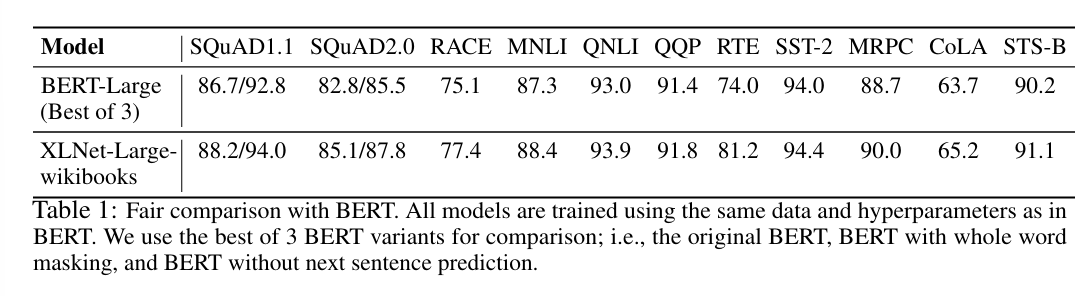
BERT와 XLNet의 성능을 Fair Comparison함.
결과적으로, 동일한 데이터/학습 방법을 사용했으나, XLNet이 모든 dataset에서 BERT보다 성능 향상을 이뤄냄.
Comparison with RoBERTa: Scaling Up
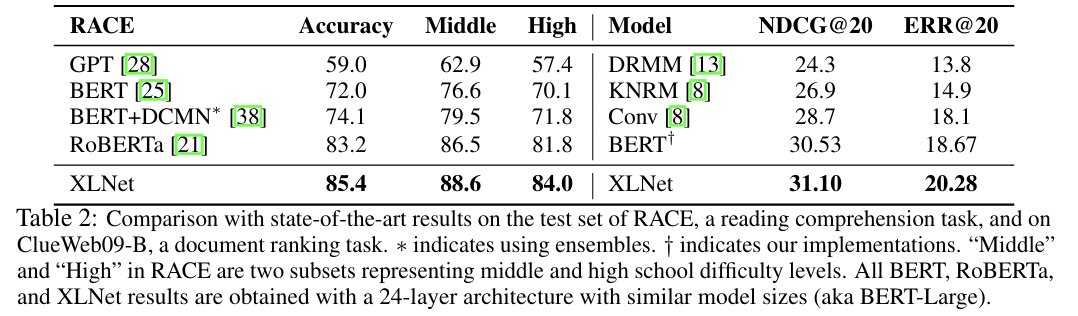 ↑ RACE, ClueWeb09-B 비교. 독해/문서 랭킹 평가
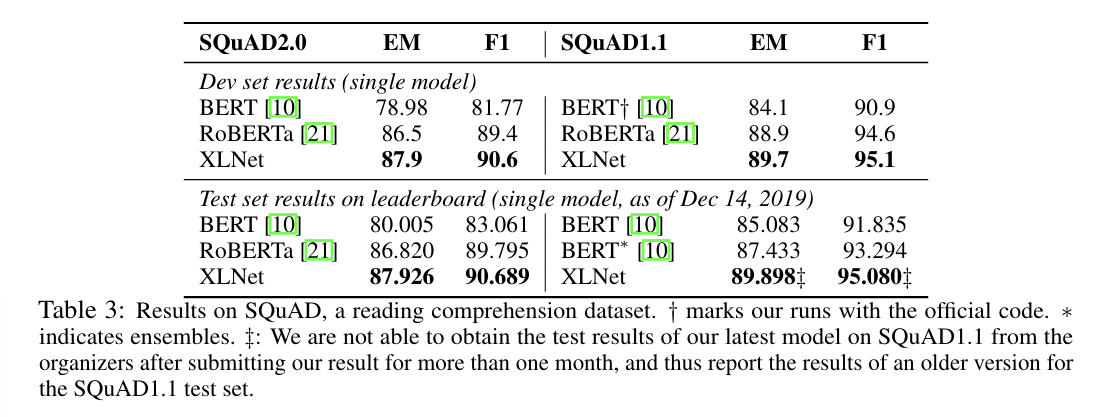 ↑ 질의응답 평가(SQuAD)
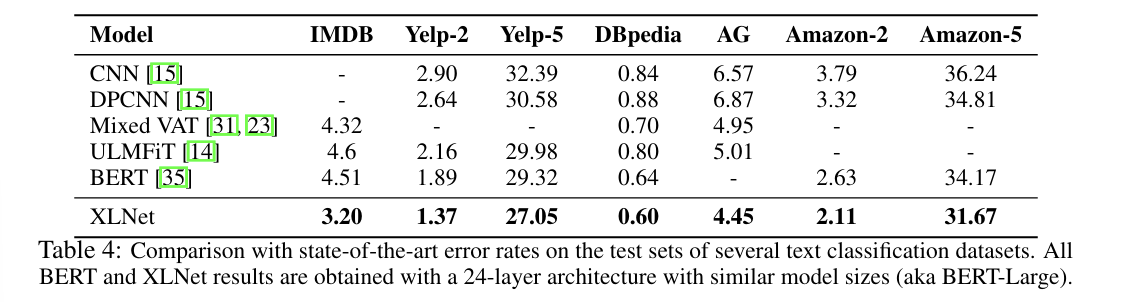 ↑ 텍스트 classification 평가. 같은 모델 크기 조건에서 XLNet이 더 좋은 성능을 도출함.
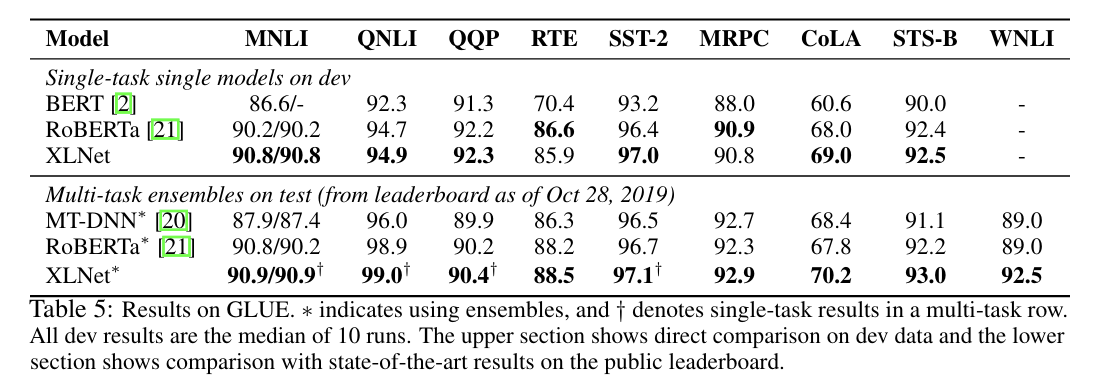 ↑ 자연어 이해 평가(GLUE)
결과적으로 XLNet이 BERT/RoBERTa보다 대부분 task에서 더 높은 성능을 기록함.
(1) Explicit(명시적) Reasoning task에서 XLNet의 성능 향상이 더 큼을 확인할 수 있었음. (ex. SQuAD/RACE)
longer context에서의 이해가 중요한 부분인데, XLNet이 이 부분에서 강점을 보임.
(2) supervised examples이 풍부한 classification task에서도 XLNet은 우수한 성능을 보임.(ex. MNLI, Yelp, Amazon)
Ablation Study
XLNet의 각 요소가 성능에 어떤 영향을 미치는지 확인하기 위한 실험.
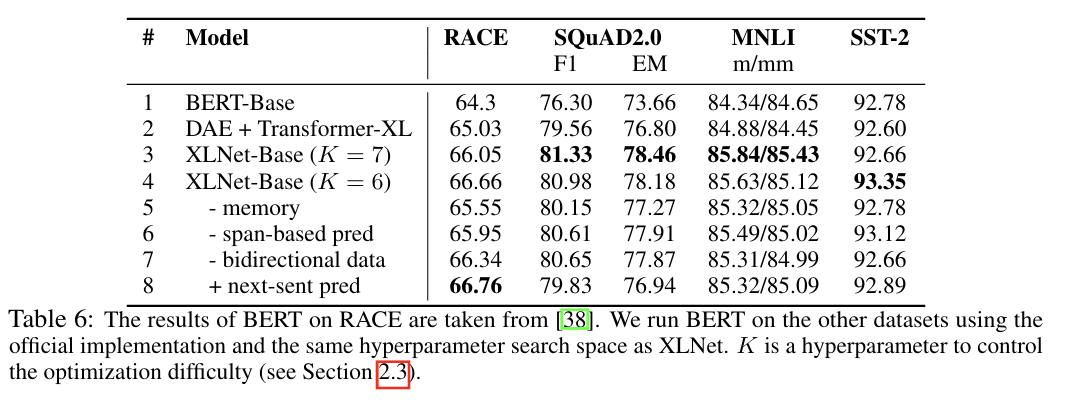
결과적으로 Transformer-XL과 Permutation Language Modeling이 성능 향상에 큰 기여를 함.
더불어, 메모리 캐싱 제거 시에 긴 context 처리 능력이 저하되는 것을 보였고, span-based 예측 및 Bidirectional Input Pipeline이 중요함.
마지막으로 BERT의 NSP(Next Sentence Prediction)는 XLNet에서 필요하지 않음을 확인할 수 있었음.
🔚4. Conclusions
XLNet은 generalized AR pretraining 방법으로, Permutation Language Modeling을 objective로 하여, AR과 AE 방식의 각 장점을 결합한 모델임.
XLNet의 neural architecture는 AR objective에 최적화되도록 만들어졌고,
이를 위해, Transformer-XL과 Two-Stream Attention Mechanism을 통합하여 설계하였음.
다양한 task에서 기존 모델보다 높은 성능 향상을 이루어 내었음.
