1. AI, ML, DL의 정의
1. AI
주어진 환경/데이터를 인지, 학습, 추론을 통해 목표를 달성하도록 예측, 행동 선택, 계획하는 시스템이다.
2. ML
AI 범주 내에서 데이터로부터 학습하여 목적을 달성하는 접근 방법론이다.
3. DL
ML 범주 내에서 신경망 함수를 사용한 학습 방법론이다.
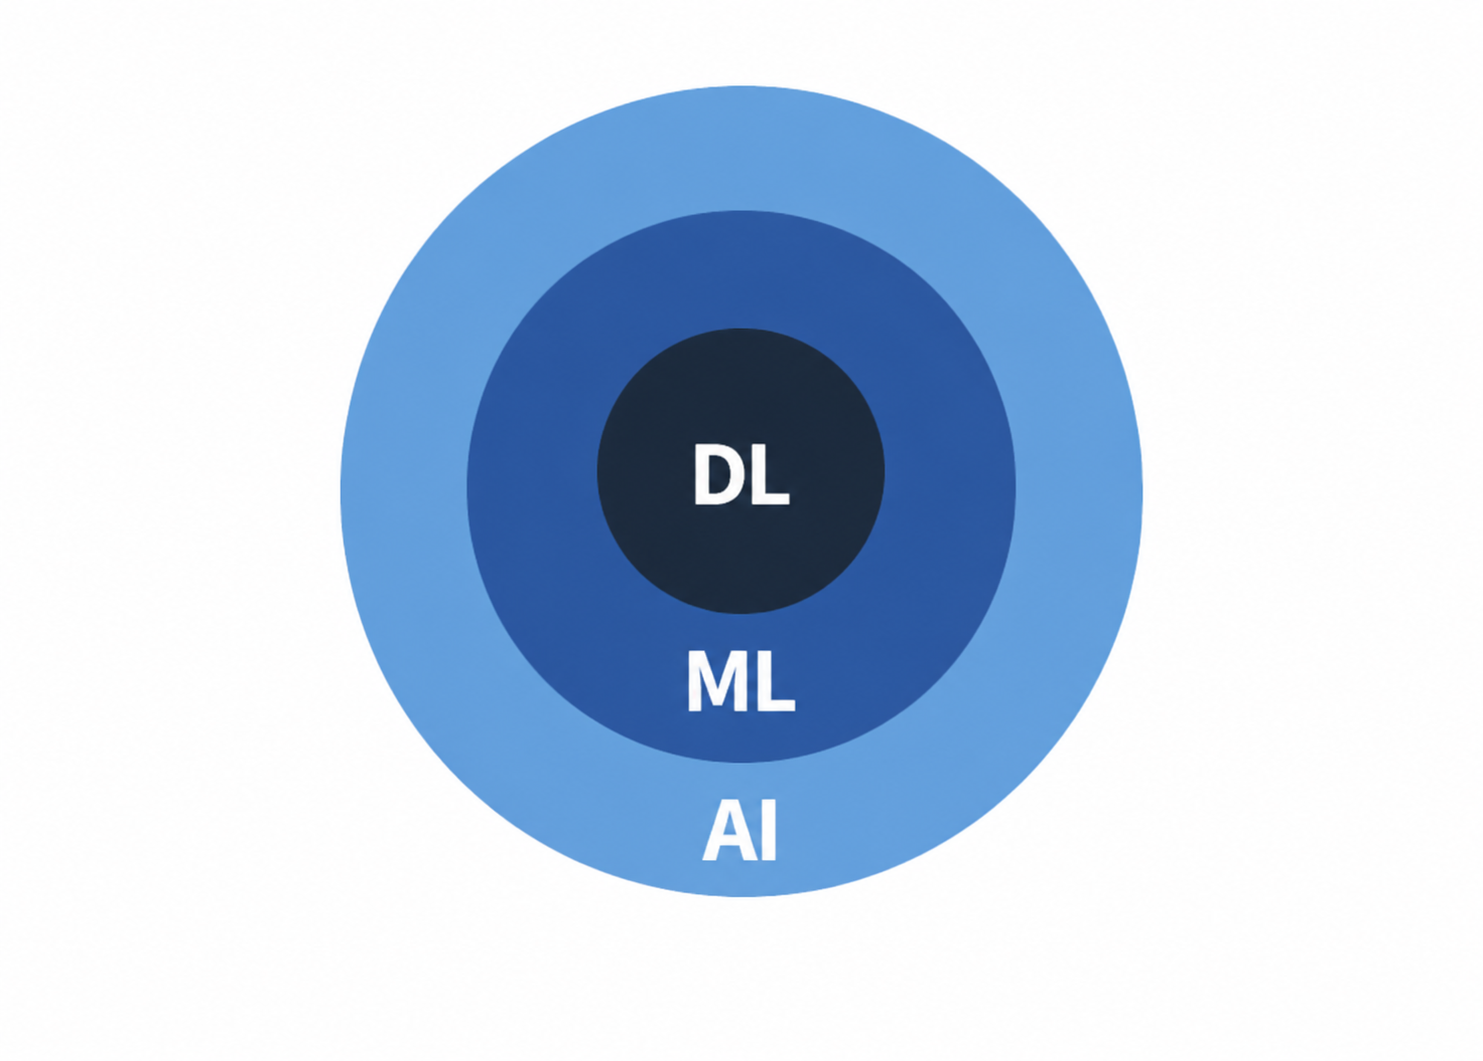
AI - ML의 (ML이 아닌 AI 시스템)예시
- 규칙 기반 시스템
- 휴리스틱 기반 (최적화) 알고리즘
2. 데이터, 모델, 학습
1. 데이터 구성요소
💡데이터가 왜 중요할까?
- 머신러닝은 규칙을 직접 코딩하지 않고, 데이터에서 규칙을 학습한다.
- 데이터의 분포와 관계가 머신러닝의 학습 결과를 결정한다.
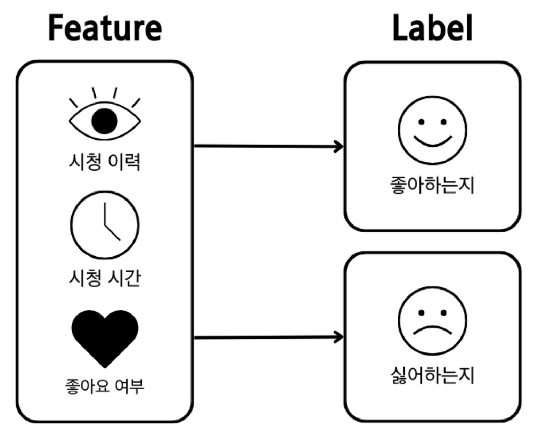
Feature (특성)
- 모델이 예측에 사용하는 입력정보이고, 예측, 판단의 근거 및 단서이다.
Label (목표값)
- 모델이 예측하려는 정답이며 학습의 목표값이다.
2. ML 실생활 예시
- 유튜브 추천
Feature: 각 영상들의 정보 (크리에이터, 조회수, 좋아요 수 등), 사용자 정보(시청 이력, 구독 채널 등)Label: 영상에 대한 사용자 피드백 (시청 여부, 좋아요 클릭 여부 등)
- 스팸메일 분류
Feature: 메일 제목, 발신자, 단어 빈도 등Label: 스팸 / 정상
3. 단일 피쳐 기반 학습
1. 1D 피쳐 기반 학습
1D = 1차원이며, Feature가 하나일 때 머신러닝이 학습하는 가장 단순한 형태이다.
예
- 입력
Feature: 교육연수 - 목표값
Label: 실제 소득
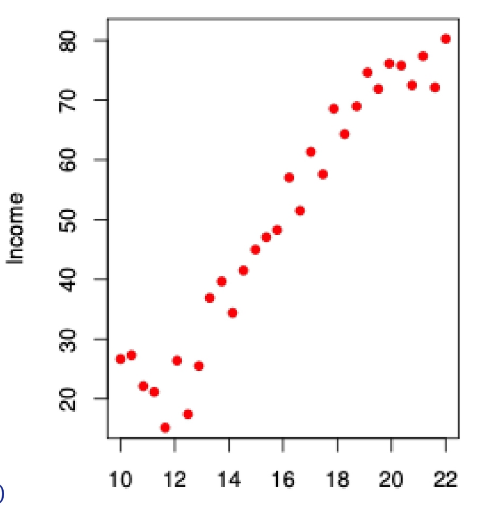
데이터 표현
데이터 = (교육연수, 소득) 30개
즉, 교육연수와 소득이 한 쌍으로 이루어진 데이터가 30개 있다는 뜻이다.
관계 표현
실제 소득 = 교육연수로 예측한 소득 + 오차
- 실제 소득: 실제로 관측된 값
- 예측한 소득: 교육연수를 기준으로 예상한 값
- 오차: 경력, 직업, 개인차처럼 교육연수만으로 설명되지 않는 부분
그래프 해석
- 빨간 점: 실제 데이터
- 파란 선: 교육연수와 소득 사이의 실제 관계
- 교육연수가 늘어날수록 소득도 대체로 증가한다
- 실제 데이터는 개인차 때문에 선과 정확히 일치하지 않는다
2. 모델과 가설 공간
1. 가설 공간
데이터를 설명하기 위해 사용할 수 있는 모든 후보 모델의 집합이다.
선형 가설 공간
- 직선 형태의 모델들로 구성된다.
- 기울기와 절편이 다른 여러 직선이 후보가 된다.
예시:
예측 소득 = 기울기 × 교육연수 + 절편
비선형 가설 공간
- 직선이 아닌 곡선 형태의 모델도 포함한다.
- 복잡한 데이터 관계를 표현할 수 있다.
- 곡선 함수나 신경망 등이 해당한다.
2. 모델
가설 공간에 포함된 후보 중 학습을 통해 선택된 하나의 함수이다.
예시:
예측 소득 = 3 × 교육연수 + 5
위 함수가 여러 후보 중 가장 적합한 것으로 선택되었다면, 이 함수가 현재의 모델이다.
4. 학습이란
1. 학습
주어진 데이터에서 정답을 가장 잘 맞출 수 있도록 모델의 규칙을 조금씩 조정해가는 과정이다.
데이터 D → 가설공간 F → 선택된 모델 f
학습에 필요한 3가지
- 데이터
- 학습할 예시들
- 입력과 정답 쌍으로 된 정답 모음
- 가설 공간
- 선택할 수 있는 모든 후보 함수들의 집합
- 이 중에서 가장 좋은 함수를 찾아야함
- 선택 기준
- 어떤 함수가 더 좋은지 판단하는 척도
- 예측값과 실제값의 차이를 측정
학습 과정
- 가설공간에서 하나의 함수를 선택한다.
- 그 함수로 데이터의 모든 예시를 예측한다.
- 손실함수로 틀린 정도를 계산한다.
- 더 적게 틀리도록 함수의 파라미터를 조정한다.
- 반복하여 최적의 모델을 완성한다.
2. 데이터 → 가설공간 → 선택된 모델
학습은 데이터가 제시한 문제에 대해, 가설공간에 있는 여러 후보 함수 중 가장 잘 맞는 함수를 선택하는 과정이다.
데이터가 문제를 제시
- 교육연수와 소득처럼 입력값과 정답값이 주어진다.
- 데이터는 두 값 사이에 어떤 관계가 있는지 보여준다.
예시:
- 교육연수 12년 → 소득 2200만 원
- 교육연수 16년 → 소득 3500만 원
가설공간이 후보 함수를 제공
- 가설공간에는 여러 후보 함수가 존재한다.
- 예를 들어 직선 형태의 함수들이 후보가 될 수 있다.
예측 소득 = 기울기 × 교육연수 + 절편
- 기울기와 절편이 다른 여러 직선이 각각 하나의 후보 함수이다.
학습이 최적의 함수를 선택
- 각 후보 함수로 데이터의 소득을 예측한다.
- 예측값과 실제값의 차이를 계산한다.
- 오차가 가장 작은 함수를 선택한다.
- 선택된 함수가 학습된 모델이다.
학습 전과 학습 후
- 학습 전: 여러 후보 함수 중 어떤 함수가 좋은지 모르는 상태
- 학습 후: 데이터에 가장 잘 맞는 하나의 함수가 선택된 상태
5. 복수 피처 기반 학습
1. 2D 피처 기반 학습
두 개의 Feature를 사용하여 하나의 Label을 예측하는 학습 방식이다.
예시
Feature 1: 교육연수Feature 2: 경력Label: 실제 소득
하나의 데이터는 다음처럼 구성된다.
(교육연수, 경력, 소득)
예를 들어,
(교육연수 16년, 경력 5년, 소득 5000만 원)
은 한 사람의 교육연수와 경력, 실제 소득을 나타낸다.
2. 1D와 2D의 차이
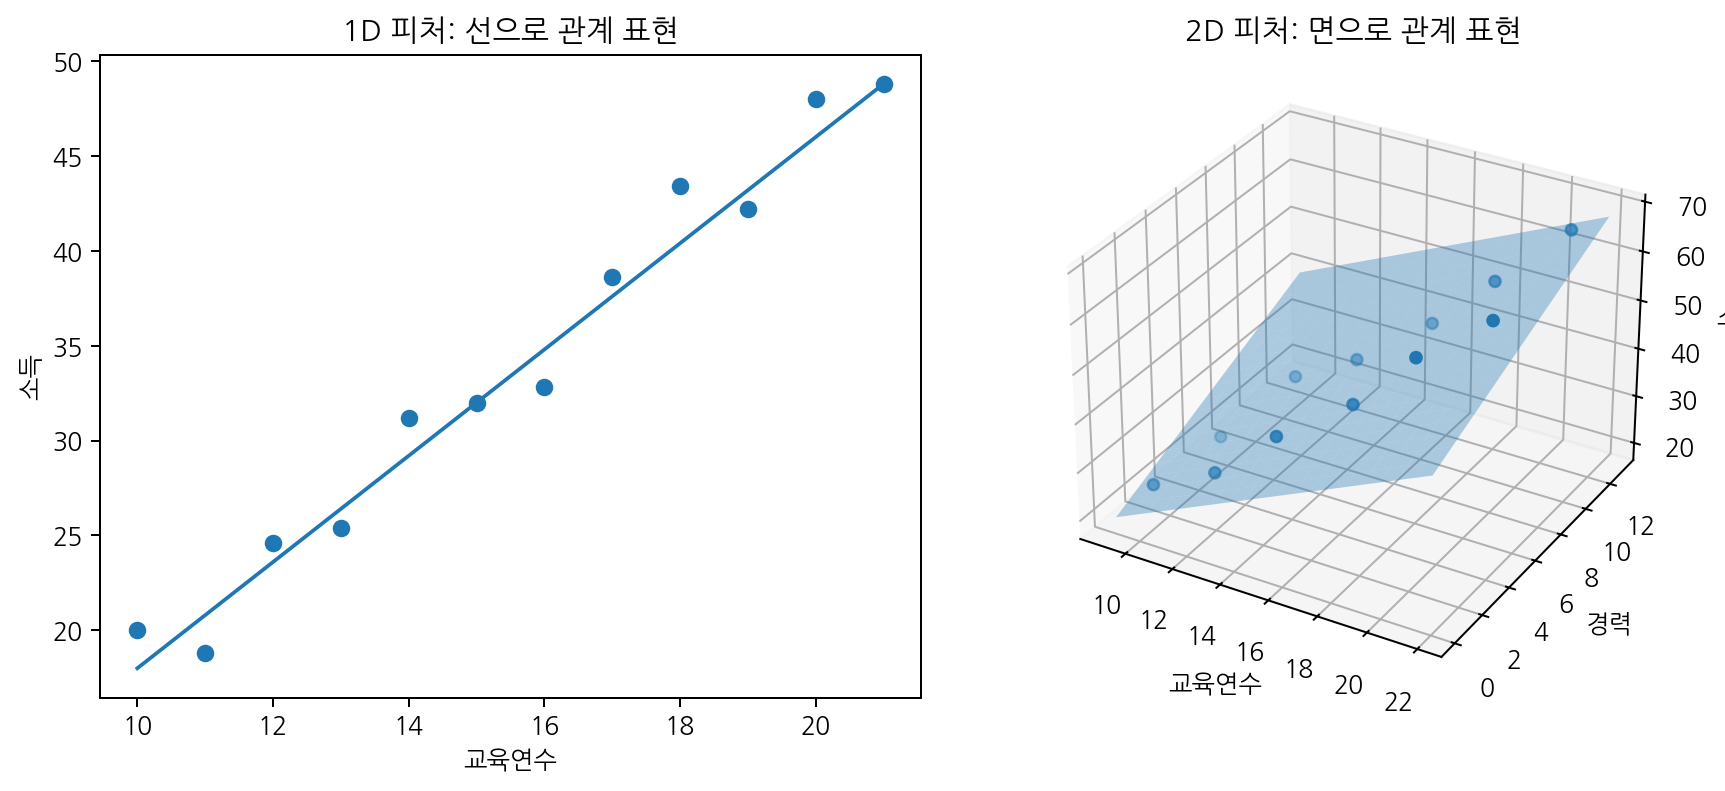
1D 피처 기반 학습
입력값이 하나이므로 다음 관계를 학습한다.
교육연수 → 소득
그래프에서는 데이터의 관계를 선으로 표현한다.
2D 피처 기반 학습
입력값이 두 개이므로 다음 관계를 함께 학습한다.
교육연수 + 경력 → 소득
그래프에서는 두 입력값과 소득의 관계를 면으로 표현한다.
여기서 2D는 Feature가 2개라는 의미이다.
그래프 자체는 소득 축까지 포함하므로 3차원으로 보인다.
3. 그래프 해석
- 점: 실제로 관측된 데이터
- 면: 모델이 예측한 소득
- 점과 면 사이의 차이: 예측 오차
실제 데이터는 사람마다 다르므로 모든 점이 면 위에 정확히 놓이지 않는다.
예를 들어 교육연수와 경력이 같더라도 직무, 회사, 지역, 개인 능력 등에 따라 실제 소득은 달라질 수 있다.
4. 모델은 무엇을 학습하는가?
모델은 교육연수와 경력이 소득에 얼마나 영향을 주는지 학습한다.
예측 소득 = 교육연수의 영향 + 경력의 영향 + 기본값
조금 더 구체적으로 표현하면 다음과 같다.
예측 소득 = 가중치1 × 교육연수 + 가중치2 × 경력 + 절편
가중치1: 교육연수의 영향가중치2: 경력의 영향절편: 기본값- 학습: 가중치와 절편을 조정하는 과정
5. 학습 과정
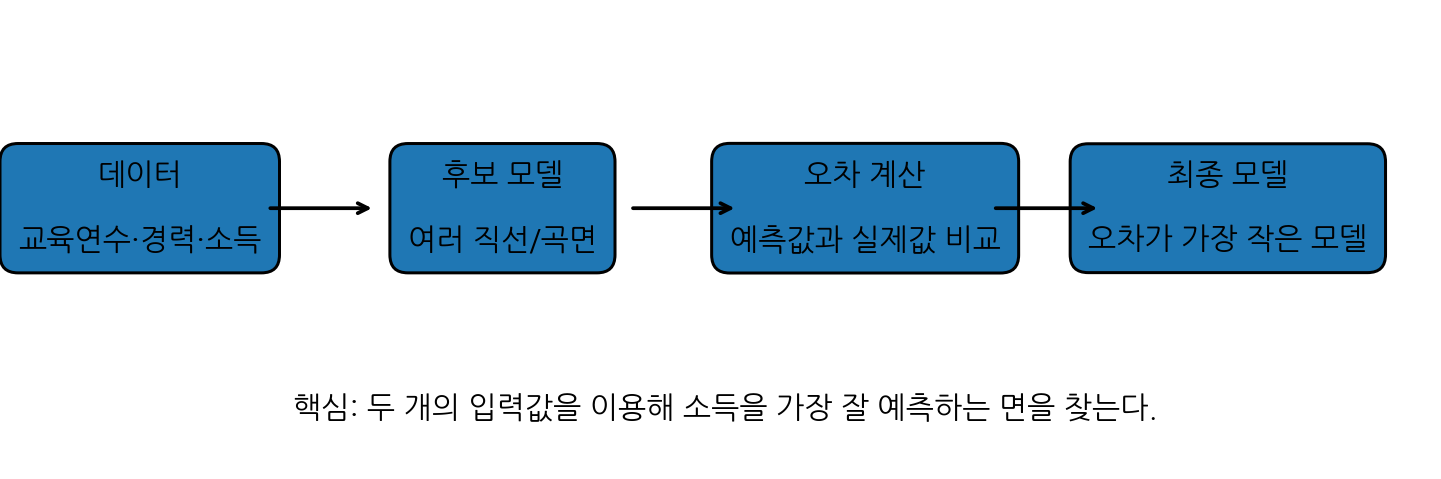
- 교육연수, 경력, 소득 데이터가 주어진다.
- 가설공간에서 여러 후보 모델을 만든다.
- 각 모델의 예측값과 실제 소득을 비교한다.
- 손실함수로 오차를 계산한다.
- 오차가 가장 작은 모델을 선택한다.
6. 왜 함수 f(x)를 학습하는가?
1. 새로운 값 예측
- 학습된 함수
f(x)를 이용하면 새로운 입력값에 대한 결과를 예측할 수 있다. - 예를 들어 교육연수와 경력이 주어졌을 때 예상 소득을 구할 수 있다.
입력값 → 학습된 함수 → 예측값
2. 중요한 피처 파악
- 여러 피처 중 어떤 피처가 결과에 큰 영향을 주는지 확인할 수 있다.
- 반대로 결과와 관계가 적은 피처도 파악할 수 있다.
예시:
- 교육연수가 소득에 얼마나 영향을 주는지
- 경력이 소득에 얼마나 영향을 주는지
3. 입력값과 결과의 관계 이해
- 각 피처가 결과를 증가시키는지 감소시키는지 확인할 수 있다.
- 입력값이 변할 때 결과가 얼마나 변하는지도 파악할 수 있다.
- 단, 모델이 복잡할수록 관계를 해석하기 어려울 수 있다.