1. 지도 학습
1. 지도학습 정의
처음 보는 문제도 잘 푸는 AI 만들기
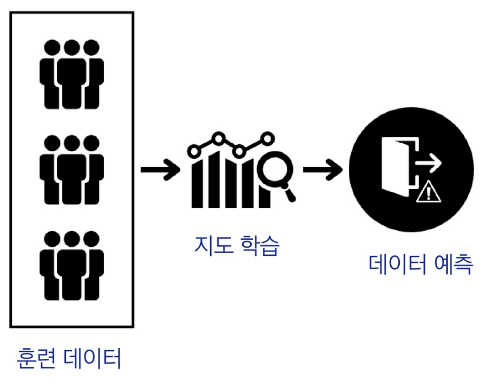
정의: 입력 + 정답을 가지고 예측 규칙을 배우는 방법목표: 훈련 데이터 뿐만 아니라, 처음 보는 데이터에서도 예측 성능 향상
예시
- 어제까지 고객 데이터로 내일 이탈할 고객 미리 알기
- 기존 고객 정보 + 탈퇴 여부 → 내일 이탈할 고객 예측
- 기존 거래 사기 데이터로 새로운 사기 탐지
- 사기인지 아닌지 구분하지 못했던 거래 or 새로운 사기거래 예측
2. 지도 학습의 종류 (회귀 vs 분류)
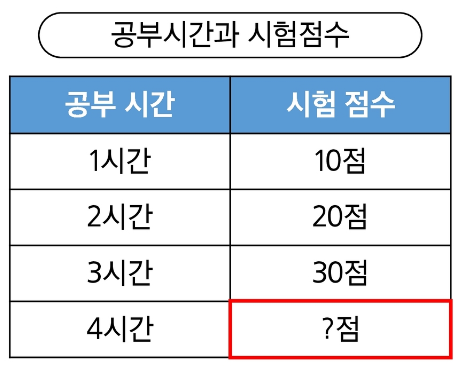
회귀
- 예측하고 싶은 결과값이
숫자일 때 사용한다. - 예시) 가격, 점수, 온도
분류
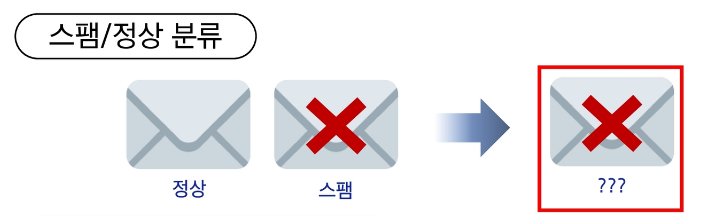
- 예측하고 싶은 결과값이
범주일 때 사용한다. - 예시) 스팸/정상, 질병 유/무
3. 손실 함수
모델의 예측이 정답에서 얼마나 벗어났는지를 하나의 숫자로 나타내는 함수이다.
학습이란, 이 숫자가 작아지는 방향으로 모델을 조금씩 고쳐 나가는 과정이다.
문제 유형에 따라 쓰는 손실이 다르다!!
- 회귀 →
평균 제곱오차 - 분류 →
교차 엔트로피
4. 지도 학습 용어
- 특성
(Feature, x)- 예측에 사용되는 설명 변수이다.
- 예측 함수 f의 input으로 들어가는 변수이다
- 라벨
(Label, y)- 맞춰야 하는 정답이다. (실제값)
- 예측 값
(ŷ)- 학습 과정에서 모델이 내놓은 결과이다. (숫자 또는 범주)
- 오류:
손실 함수로 계산- 예측 값
(y)과 라벨(ŷ)의 차이 →ŷ - y
- 예측 값
2. 회귀
1. 회귀란?
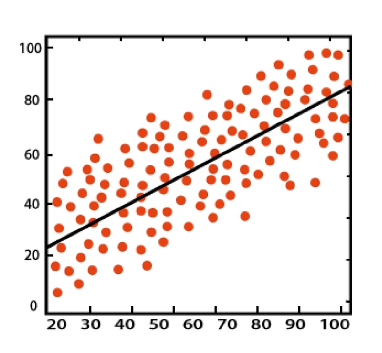
정의: 입력(feature)으로부터 숫자(output)를 얼마나 예측할까? 이다.
특징: 라벨 및 예측 모델의 출력은 연속적인 수치이다.
2. 회귀 오류: 평균 제곱 오차 (MSE)
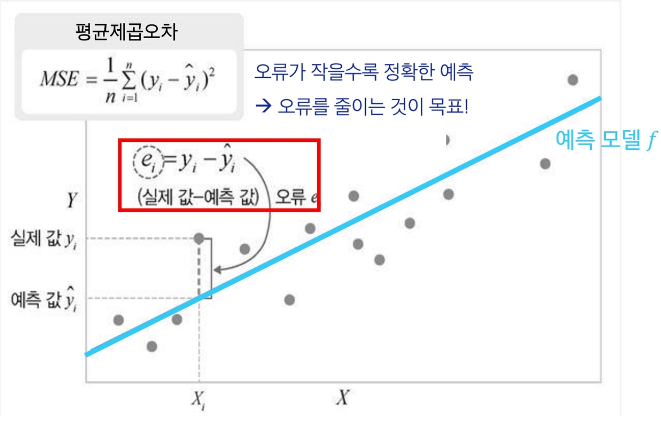
- 모델의 예측 정확도를 숫자로 측정하는 지표가 필요하다.
평균 제곱 오차
- 각 데이터에서 정답
(y)과 예측(ŷ)의 평균 제곱 차이값이다. - 틀린 정도를 제곱해서 더 큰 오류에 패널티를 부여한다. → 전체 평균 오류 수준을 한눈에 볼 수 있다.
3. 회귀 설명력 R² (결정계수)
- Label
(y)의 분산 중에서 Feature로 설명되는 비율이다. - 평균만 쓰는 단순한 예측 보다 모델이 실제 값을 얼마나 더 잘 맞추는지를 0~1 사이 값으로 나타낸다.
- 1에 가까울수록 설명력이 높고 낮을수록 설명력이 낮다.
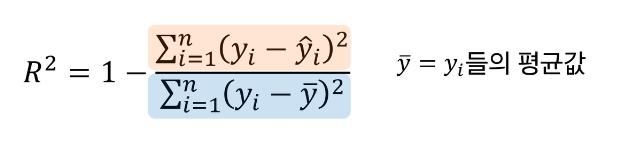
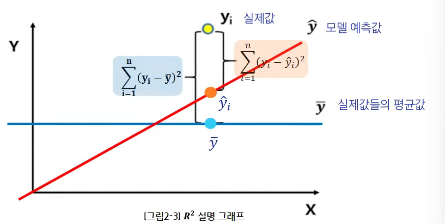
💡 ȳ = yᵢ들의 평균 값이다.
4. MSE vs R²
MSE와 R²는 모두 모델의 정확도를 평가하기 위한 정량적 지표이다.
| 항목 | MSE | R² |
|---|---|---|
| 정의 | 예측값과 실제값 차이의 제곱 평균 | 평균 예측 대비 모델의 상대적 성능 |
| 값 범위 | 0 ~ ∞ (무한대) | 0 ~ 1 |
| 단위 | 실제 데이터 단위² | 단위 없음 |
| 해석 | 절대값, 구체적 오차 크기 | 상대적 비율, 성능 정도 |
| 좋은 값 | 0에 가까울수록 좋음 | 1에 가까울수록 좋음 |
| 장점 | 구체적 오차 크기를 알 수 있음 | 직관적 해석, 모델 간 비교 쉬움 |
| 단점 | 직관적 해석 어려움 | 구체적 오차 크기 모름 |
각 지표는 언제 사용하면 좋을까?
- MSE
- 구체적인 오차 크기가 중요할때, 실제 손실 비용을 계산할 때 사용하면 좋다.
- R²
- 모델 성능을 직관적으로 평가할 때, 여러 모델을 비교할 때 사용하면 좋다.
3. 분류
1. 분류의 정의
정의: 입력 특성(Feature)으로부터 출력이 범주값(카테고리)으로 나타나는 예측 문제이다.
특징: 범주 라벨 (이진/다중)
2. 분류 정확도
분류 모델의 예측 정확도는 어떻게 평가할까?
- 분류 모델은 Label이 범주로 되어있기 때문에 MES나 R²를 사용하기 어렵다.
정확도
- 전체 예측 중에서 올바르게 맞춘 예측의 비율이다.
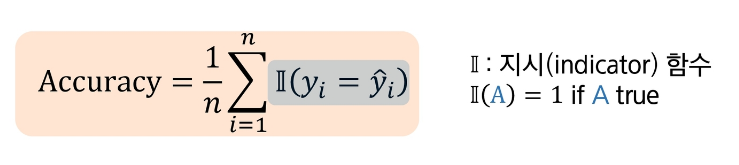
Accuracy = 올바르게 맞춘 개수 / 전체 예측 개수
💡 하지만 정확도는 단순히 전체 중 맞춘 비율만 계산하므로 정확도만 보지말고 다른 지표도 함께 봐야 안전하다!!
3. 혼동 행렬
- 예측과 실제 값 사이의 관계를 행렬 형태로 표현한다.
TP: 실제 양성, 예측도 양성TN: 실제 음성, 예측도 음성FP: 실제는 음성인데 양성이라고 함 (오탐)FN: 실제는 양성인데 음성이라 함 (누락)
- 정밀도
- 양성이라 판정한 것 중 진짜 양성의 비율 =
TP / (TP + FP)
- 양성이라 판정한 것 중 진짜 양성의 비율 =
- 재현율
- 진짜 양성 가운데 잡아낸 예측 양성 비율 =
TP / (TP + FN)
- 진짜 양성 가운데 잡아낸 예측 양성 비율 =
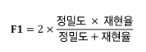
- F-1 score
-
정밀도와 재현율의 조화평균
-
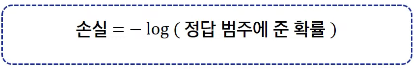
4. 분류 손실: 교차 엔트로피
- 정답에 준 확률이 높을수록 손실이 작아진다.
- 확률이 낮으면 손실이 급격히 커진다.
4. 학습의 목적
1. 학습의 목적
훈련 데이터로 학습한 모델이 새로운 데이터에서도 정확한 예측을 수행하도록 하는 것 이다.
훈련이 잘 되었는지 아닌지 확인하는 방법???
- 학습 모델의 성능 평가는 모델이 처음 보는 (학습에 사용되지 않은) 데이터로 평가한다.
- 훈련 데이터에서 성능이 아무리 좋아도, 새로운 데이터에서 성능이 떨어지면 실전엔 사용할 수 없다.
2. 오버피팅 이란??
훈련 데이터의 우연한 패턴/잡음까지 외워버려서(초록 함수) 훈련에서는 잘 맞지만 테스트에서는 성능이 나빠지는 현상
→ 훈련 오류 급격히 낮음, 테스트 오류 높음/요동
!image.png
오버피팅이 안 좋은 이유
- 표본 의존/불안정
- 훈련 데이터는 모집단의 일부 표본이라 우연한 잡음이 섞인다. 이것에 과하게 맞추어 학습하면 샘플 몇개만 바뀌어도 예측이 크게 흔들림
- 일반화 실패
- 보지 못한 데이터 오류가 커진다.
- 모집단 성능과 격차가 벌어진다.
오버피팅에 대한 오해
오버피팅 ≠ 데이터 분포 변화로 인한 성능 저하
- 분포 변화로 인한 오류
- 훈련 데이터와 테스트 데이터의 분포가 달라져 성능이 떨어지는 현상이다.
- 환경, 계절, 사용자 특성, 센서 변경 등이 원인이 될 수 있다.
- 데이터 분포가 변하면 모델이 오버피팅되지 않았더라도 오류가 증가할 수 있다.
- 오버피팅은 훈련 데이터에는 지나치게 잘 맞지만, 새로운 데이터에서는 성능이 떨어지는 현상이다.
3. 오버피팅 vs 언더피팅
- 오버피팅: 모델이 너무 복잡하다
- 잡음까지 학습한다. (테스트 성능 나쁨)
- 언더피팅: 모델이 단순하거나 학습이 완료되지 않음
- 중요한 패턴을 놓친다. (오류 큼)
백엔드를 학습하는 주니어 개발자입니다.