1. 비지도 학습
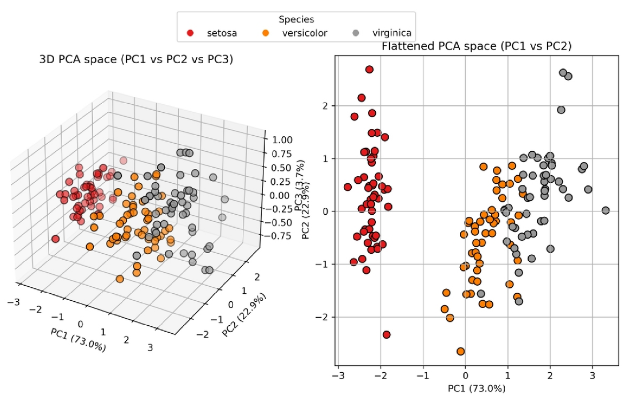
1. 비지도 학습이란?
- 정의: 레이블 (정답) 없이 데이터의 구조/패턴/집단을 찾아내는 학습이다.
- 대표 과제: 군집화, 차원축소, 밀도추정/이상치 탐지 등등
- 출력: 정답 예측이 아니라 구조/요약/표현이다.
2. 비지도 학습 vs 지도 학습
- 지도 학습: 입력 + 라벨 (정답)로 예측 모델을 학습한다.
- 가격 예측, 악성 종양 예측 등
- 비지도 학습: 입력만으로 구조 학습을 한다.
- 고객 세그먼트 등
2. 클러스터링
1. 클러스터링이란?
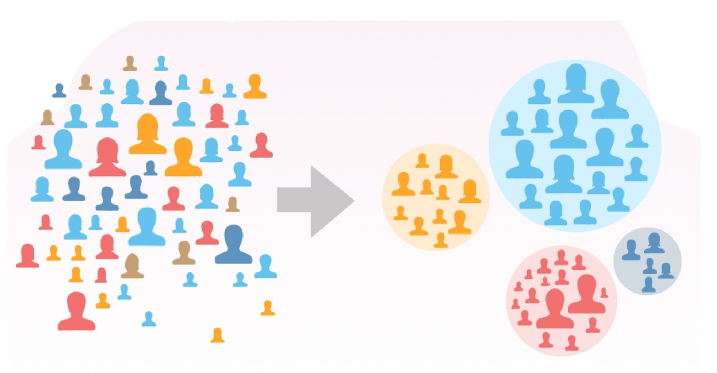
데이터 안에서 하위 집단 (클러스터)을 찾는 기법들의 총칭이다.
집단 내부는 유사, 집단 간은 상이하도록 데이터를 분할한다.
클러스터링 예시
- 마케팅 세그먼테이션
- 다수의 지표 (가구 소득, 직업, 도심 거리 등)를 가진 많은 사람들에 대해 특정 광고/상품에 더 반응할 하위집단을 식별하고자 한다.
- 시장 세분화 작업 자체가 클러스터링에 해당한다.
2. 두 가지 대표 클러스터링 기법
- K-평균 (K-means): K (클러스터 수)를 미리 정해 분할한다.
- 계층적 군집: K를 사전에 고정하지 않는다.
3. K-means 클러스터링
1. K-means 클러스터링
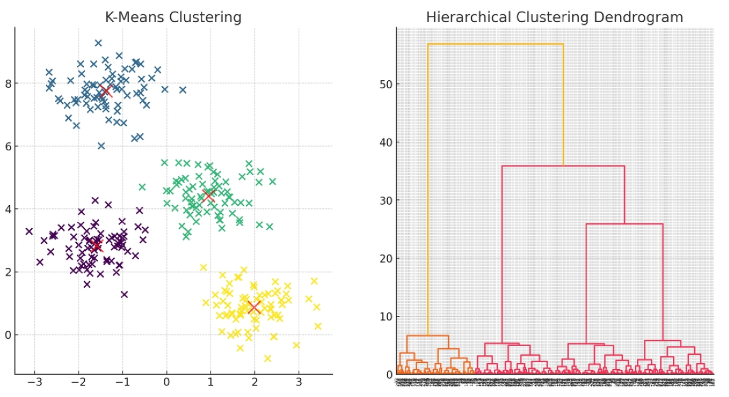
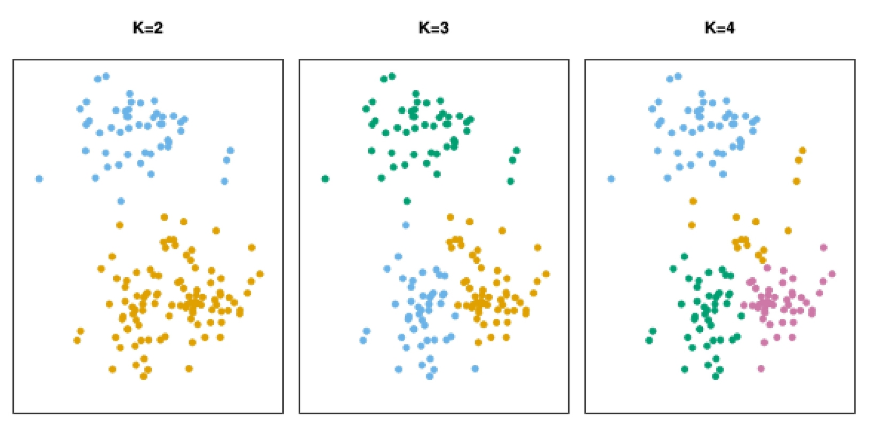
- 패널: K=2, 3, 4에서 각 K-means 결과 (점 색상 = 할당된 클러스터)
클러스터 결과에서 특정 색상은 의미가 없고, 점들이 다른 색이라는 것은 서로 다른 클러스터에 속해있다는 의미이다.
예시
2. K-means 표기 (군집 집합)
K-means는 전체 데이터를 K개의 군집으로 나누는 방법이다.
각 군집은 다음처럼 표현할 수 있다.
C₁, C₂, ..., Cₖ
K: 만들 군집의 개수C₁, C₂, ..., Cₖ: 각각의 군집- 모든 데이터는 반드시 하나의 군집에 속한다.
- 하나의 데이터가 여러 군집에 동시에 속할 수는 없다.
- 서로 다른 군집은 겹치지 않는다.
- 모든 군집을 합치면 전체 데이터가 된다.
3. K-means 알고리즘
- 초기화: 관측치들에 무작위로
1...K클러스터를 임시로 부여한다. - 반복 (할당이 더 이상 바뀌지 않을 때 까지)
- 각 클러스터의 중심 계산
- 각 관측치를 가장 가까운 중심의 클러스터에 재할당 (거리 예 = 유클리드)
K-means 알고리즘 특성
-
중심점과의 평균 거리가 계속 줄어들기 때문에 매 반복마다 결과는 더 좋아진다.
-
하지만 최적 해를 항상 찾는 건 아니다.
→ 초기값에 따라 지역 최솟값으로 수렴 가능하다. (지역 최소값문제라고 부른다.)
┌────────────────────────────┐
│ 1 무작위 클러스터 초기화  │
└────────────────────────────┘
              ↓
┌────────────────────────────┐
│ 2a 중심 계산               │◀──────────┐
└────────────────────────────┘           │
              ↓                          │ 반복
┌────────────────────────────┐           │
│ 2b 클러스터 재배정         │───────────┘
└────────────────────────────┘
              ↓
     클러스터 변화가 없으면 종료
4. K-means 클러스터링에서 초기값의 영향
서로 다른 초기 라벨에서 최종 분할과 목표값 (패널 상단 숫자)이 달라진다.
초기화의 중요성: 여러 번 시도를 권장한다.
4. 계층적 군집
1. K-means 클러스터링 vs 계층적 군집
- K-means는 클러스터 수 K를 미리 지정해야 하는 단점이 존재한다.
- 계층적 군집은 K를 고정하지 않고 전체 구조를 덴드로그램으로 제공한다.
2. 계층적 군집 예시
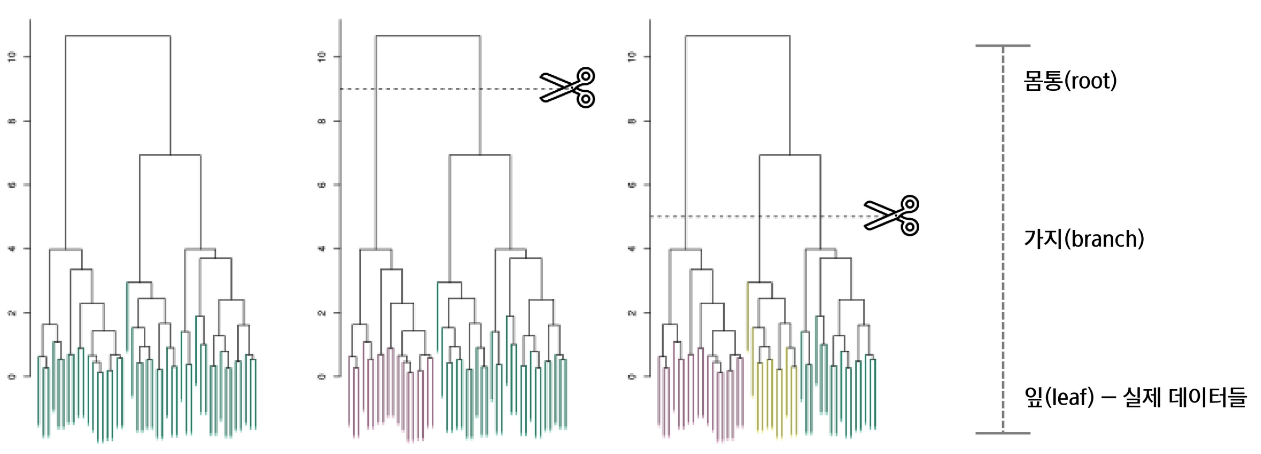
- 덴드로그램에서 수평선 높이 (거리)를 기준으로 가위질하여 K개 군집을 얻는다.
2. K-means 표기 (군집 집합)
K-means는 전체 데이터를 K개의 군집으로 나누는 방법이다.
각 군집은 다음처럼 표현할 수 있다.
C₁, C₂, ..., Cₖ
K: 만들 군집의 개수C₁, C₂, ..., Cₖ: 각각의 군집- 모든 데이터는 반드시 하나의 군집에 속한다.
- 하나의 데이터가 여러 군집에 동시에 속할 수는 없다.
- 서로 다른 군집은 겹치지 않는다.
- 모든 군집을 합치면 전체 데이터가 된다.
3. K-means 알고리즘
- 초기화: 관측치들에 무작위로
1...K클러스터를 임시로 부여한다. - 반복 (할당이 더 이상 바뀌지 않을 때까지)
- 각 클러스터의 중심 계산
- 각 관측치를 가장 가까운 중심의 클러스터에 재할당 (거리 예 = 유클리드)
K-means 알고리즘 특성
-
중심점과의 평균 거리가 계속 줄어들기 때문에 매 반복마다 결과는 더 좋아진다.
-
하지만 최적 해를 항상 찾는 건 아니다.
→ 초기값에 따라 지역 최솟값으로 수렴 가능하다. (지역 최소값 문제라고 부른다.)
┌────────────────────────────┐
│ 1 무작위 클러스터 초기화  │
└────────────────────────────┘
              ↓
┌────────────────────────────┐
│ 2a 중심 계산               │◀──────────┐
└────────────────────────────┘           │
              ↓                          │ 반복
┌────────────────────────────┐           │
│ 2b 클러스터 재배정         │───────────┘
└────────────────────────────┘
              ↓
     클러스터 변화가 없으면 종료
4. K-means 클러스터링에서 초기값의 영향
서로 다른 초기 라에서 최종 분할과 목표값 (패널 상단 숫자)이 달라진다.
초기화의 중요성: 여러 번 시도를 권장한다.
4. 계층적 군집
1. K-means 클러스터링 vs 계층적 군집
- K-means는 클러스터 수 K를 미리 지정해야 하는 단점이 존재한다.
- 계층적 군집은 K를 고정하지 않고 전체 구조를 덴드로그램으로 제공한다.
2. 계층적 군집 예시
- 덴드로그램에서 수평선 높이 (거리)를 기준으로 가위질하여 K개 군집을 얻는다.
!image.png
3. 계층적 군집 알고리즘 (상향식)
처음에는 각 데이터를 하나의 군집으로 보고, 가장 비슷한 군집끼리 하나씩 합쳐가는 방식이다.
┌──────────────────────────────────────┐
│ 1. 각 관측치를 하나의 군집으로 시작 │
│    총 n개의 군집 생성               │
└──────────────────────────────────────┘
                  ↓
┌──────────────────────────────────────┐
│ 2. 모든 군집 사이의 비유사도 계산   │
│    가장 비슷한 두 군집을 병합       │
└──────────────────────────────────────┘
                  ↓
┌──────────────────────────────────────┐
│ 3. 병합 후 남은 군집 사이의         │
│    비유사도를 다시 계산             │
└──────────────────────────────────────┘
                  ↓
          2번과 3번을 반복
                  ↓
┌──────────────────────────────────────┐
│ 최종적으로 하나의 군집이 될 때 종료 │
└──────────────────────────────────────┘
덴드로그램
- 군집이 병합되는 과정을 나무 모양으로 나타낸 그래프이다.
- 낮은 높이에서 합쳐질수록 서로 비슷하다.
- 높은 높이에서 합쳐질수록 서로 차이가 크다.
- 원하는 높이에서 잘라 군집 수를 결정할 수 있다.
4. 계층적 군집의 단계별 진행
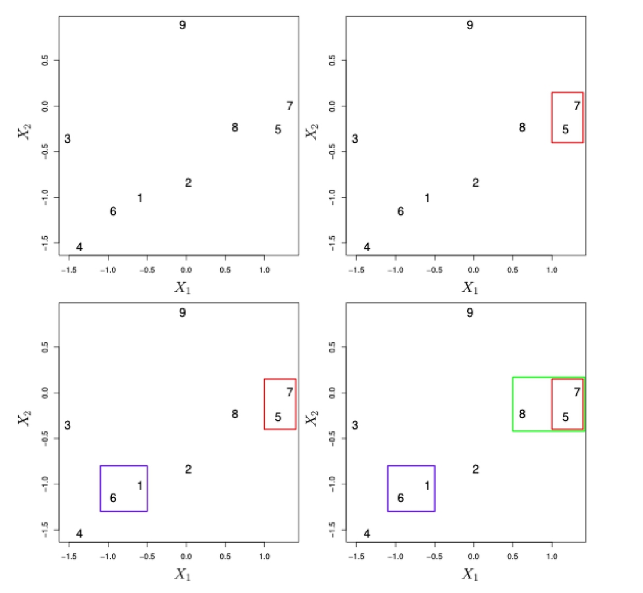
처음에는 각 데이터를 하나의 군집으로 보고, 가장 가까운 군집끼리 순서대로 합쳐간다.
- 각 단계에서 가장 유사한 두 데이터 또는 군집을 병합한다.
- 병합이 진행될수록 군집의 개수는 하나씩 줄어든다.
- 먼저 합쳐지는 데이터일수록 서로 더 유사하다.
- 이러한 병합 과정을 덴드로그램으로 표현할 수 있다.
진행 예시
개별 데이터 → 가까운 데이터끼리 병합 → 작은 군집끼리 병합 → 최종적으로 하나의 군집
이 그림은 계층적 군집이 한 번에 결과를 만드는 것이 아니라, 단계적으로 군집을 합쳐가는 과정임을 보여준다.
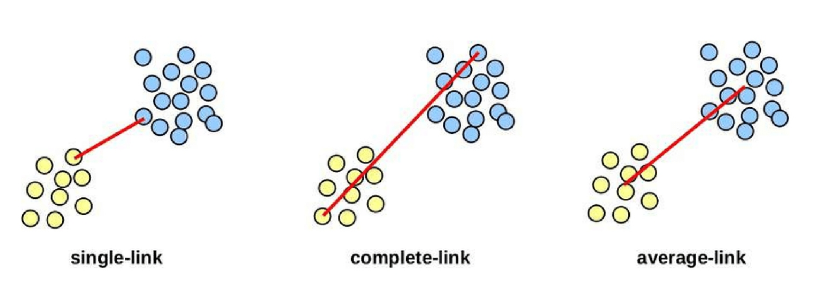
5. 군집 간 거리 측정 방법(Linkage)
두 군집 사이의 거리를 어떤 기준으로 계산할지 결정하는 방법이다.
- Single Linkage(최소 거리)
- 두 군집에 속한 데이터 쌍 중 가장 가까운 거리를 군집 간 거리로 사용한다.
- Complete Linkage(최대 거리)
- 두 군집에 속한 데이터 쌍 중 가장 먼 거리를 군집 간 거리로 사용한다.
- Average Linkage(평균 거리)
- 두 군집에 속한 모든 데이터 쌍의 거리 평균을 군집 간 거리로 사용한다.
5. 클러스터링 시 주의점
- 스케일링
- 클러스터링은 거리 기반이므로 변수의 단위와 크기가 결과에 영향을 준다.
- 변수 간 크기 차이가 크면 표준화 또는 정규화가 필요하다.
- 적절한 클러스터 개수
- 클러스터 개수가 너무 적으면 서로 다른 집단이 합쳐질 수 있다.
- 너무 많으면 하나의 집단이 지나치게 세분화될 수 있다.
- 데이터 구조와 분석 목적에 맞는 클러스터 개수를 선택해야 한다.