1. 테스트 성능 평가
1. 훈련 오류 vs 테스트 오류
- 훈련 오류: 모델을 학습시킨 같은 데이터에 다시 적용해 계산한 오류이다.
- 테스트 오류: 학습에 쓰지 않은 새 관측치에 대해 모델을 적용했을 때의 평균 예측오류이다.
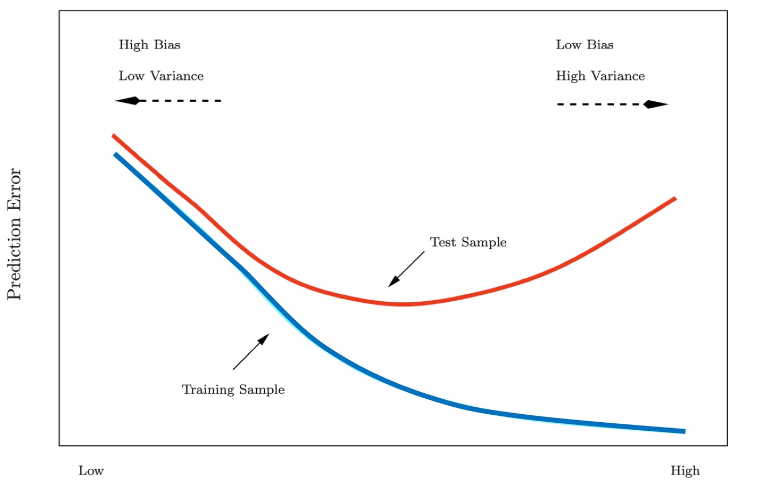
파란색 선 : 훈련 오류
빨간색 선 : 테스트 오류
모델의 복잡도가 증가할수록 훈련 오류는 일반적으로 계속 감소한다.
테스트 오류는 처음에는 감소하지만, 모델이 지나치게 복잡해지면 오버피팅으로 인해 다시 증가할 수 있다. 따라서 보통 U자형에 가까운 형태를 보인다.
궁극적인 목적은 테스트 오류가 가장 낮아지는 적절한 복잡도의 모델을 찾는 것이다.
2. 테스트 예측 오류 계산
- 이상적 케이스: 충분히 큰 별도의 테스트 데이터셋 → 현실에선 구하기 어렵다.
- 현실에서는 테스트만을 위한 데이터를 갖기에 데이터 자체가 부족할 수 있다.
3. 대안
재표본화를 통해 테스트 오류 추정
데이터를 나눠 여러번 훈련 → 평가 를 반복해 테스트 오류를 가늠한다.
2. 검증셋 접근
1. 검증셋 방법
검증셋 (홀드아웃) 방법
- 가용 샘플들을 무작위로 훈련셋과 검증셋으로 분할한다.
- 훈련셋으로 모델 적합, 검증셋으로 예측 후 검증 오류를 계산한다.
- 검증 오류는 보통 정량 반응은 MSE, 범주 반응은 오분류율 (F1-score)을 측정한다.
2. 검증셋 절차
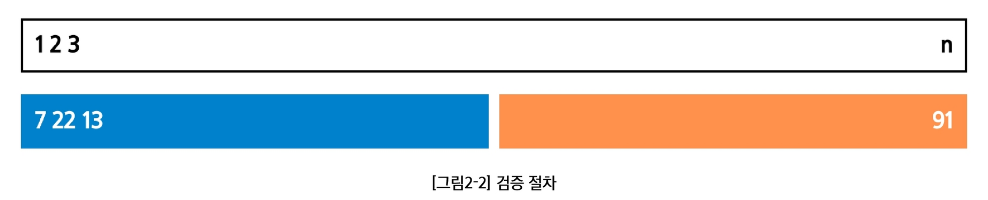
- 데이터 순서 무작위 셔플링 후 두 부분으로 분할한다.
- 파랑 → 훈련셋, 주황 → 검증셋
- 학습은 훈련셋에서, 성능평가는 검증셋에서 수행한다.
3. 검증셋 방법 예시
예시: 자동차 데이터
- 목표: 선형 모델부터 고차항 모델 비교
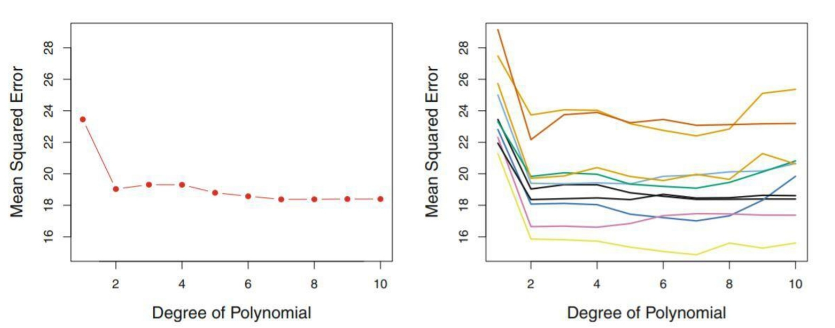
- 392개 데이터를 무작위로 196개 훈련셋 / 196개 검증셋으로 분할한다. (일반적으로 굳이 반으로 나눌 필요는 없다.)
- 좌측 패널: 단 한번 분할 시 MSE 곡선
- 우측 패널: 여러 번 셔플 후 다른 분할의 MSE 곡선들
4. 검증셋 접근 한계
- 어떤 표본이 훈련/검증에 들어가느냐에 따라 검증 기반 테스트 오류 추정치가 매우 가변적이다.
- 검증 접근에서는 훈련셋만으로 모델이 적합하므로, 전체 데이터로 학습했을 때보다 성능이 낮게 추정될 수도 있다.
3. K-겹 교차검증
1. K-겹 교차검증
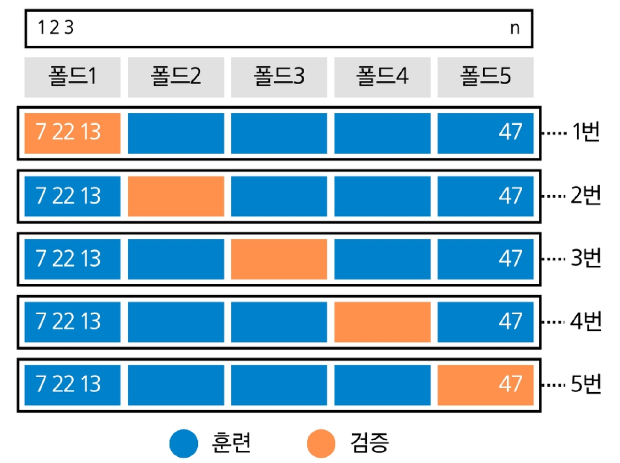
전체 데이터를 크기가 비슷한 K개의 묶음으로 나눈 뒤, 각 묶음을 한 번씩 검증 데이터로 사용한다.
- K개 중 1개 묶음은 검증에 사용한다.
- 나머지 K-1개 묶음은 훈련에 사용한다.
- 이를 K번 반복한다.
- 각 검증 오류의 평균으로 모델 성능을 평가한다.
검증 단계
- 데이터를 셔플한 뒤, 전체 n개의 데이터를 서로 겹치지 않는 K개 그룹으로 나눈다.
- 각 그룹을 한 번씩 검증셋으로 사용하고, 나머지 그룹은 훈련셋으로 사용한다.
- 각 반복에서 MSE를 계산한다.
- K개의 MSE를 평균하여 새로운 데이터에 대한 예측 오류를 추정한다.
2. K-겹 교차검증 오류 계산
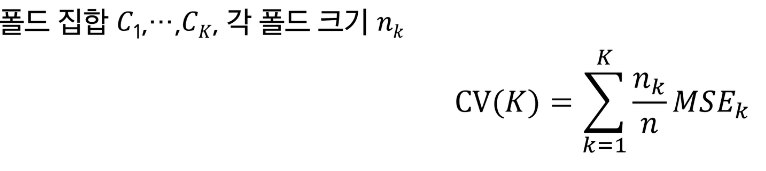
CV(K): K-겹 교차검증의 최종 평균 오류K: 폴드 개수MSEₖ: k번째 폴드에서 계산한 검증 오류nₖ: k번째 폴드의 데이터 개수n: 전체 데이터 개수Σ: 1번부터 K번 폴드까지 모두 더하라는 뜻
최종 오류
= 각 폴드의 MSE × 해당 폴드의 데이터 비율을 모두 더한 값
LOOCV와 10-Fold 교차검증 비교
| 항목 | LOOCV | 10-Fold CV |
|---|---|---|
| 검증 데이터 | 1개 | 전체의 약 10% |
| 반복 횟수 | 데이터 개수 n번 | 10번 |
| 계산 시간 | 오래 걸림 | 비교적 적음 |
| 안정성 | 변동성이 클 수 있음 | 비교적 안정적 |
| 활용 | 데이터가 매우 적을 때 | 일반적으로 많이 사용 |
두 방법 모두 테스트 오류를 추정하는 방법이지만, 보통 10-Fold CV가 계산 효율과 안정성 면에서 더 실용적이다.
백엔드를 학습하는 주니어 개발자입니다.