1. NumPy
NumPy(Numerical Python)는 Python에서 수치 계산과 배열 처리를 빠르게 하기 위한 라이브러리이다.
Python 리스트와 NumPy 배열 차이
Python 리스트
discount = []

for p in price:
    discount.append(p * 0.9)
Python 리스트는 각 요소에 동일한 연산을 바로 적용할 수 없기 때문에 반복문을 사용해 하나씩 처리한다.
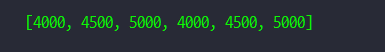
또한 리스트의 * 연산은 숫자 곱셈이 아니라 리스트 반복으로 동작한다.
price= [4000, 4500, 5000]
price*2
출력 결과
NumPy 배열(ndarray)
import numpy as np

price=np.array([4000, 4500, 5000])

price*0.9
NumPy 배열은 배열 전체에 동일한 연산을 적용할 수 있다.
출력 결과
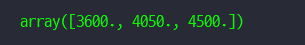
이처럼 반복문 없이 배열 단위의 계산이 가능하다.
NumPy 배열의 특징
1. ndarray (N-dimensional Array)
- NumPy의 핵심 자료구조
- 같은 자료형의 데이터를 저장하는 다차원 배열이다.
예시
arr=np.array([
    [1,2,3],
    [4,5,6]
])
2. 2차원 배열
| 함수 | 설명 |
|---|---|
np.array([[값], [값]]) | 2차원 배열 생성 |
arr.shape | 배열의 행과 열 크기 확인 |
arr.T | 배열의 행과 열 전환 |
배열의 크기 확인
앞서 만든 배열
arr = np.array([
[1, 2, 3],
[4, 5, 6]
])arr.shape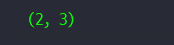
3. reshape()
| 함수 | 설명 |
|---|---|
arr.reshape(행, 열) | 배열의 형태 변경 |
-1 | 전체 원소 개수에 맞춰 크기 자동 계산 |
4. 축(axis) 연산
| 축 | 설명 |
|---|---|
axis=0 | 열 방향으로 계산 |
axis=1 | 행 방향으로 계산 |
5. 2차원 배열 집계 함수
| 함수 | 설명 |
|---|---|
arr.sum() | 전체 합계 |
arr.sum(axis=0) | 열별 합계 |
arr.sum(axis=1) | 행별 합계 |
arr.mean(axis=0) | 열별 평균 |
arr.mean(axis=1) | 행별 평균 |
6. 벡터화 (Vectorization)
- 반복문을 직접 작성하지 않고 배열 전체에 연산을 적용하는 방식
- 내부적으로 최적화된 연산을 수행해 빠른 계산이 가능하다.
예시
arr*27. 집계 함수
배열의 데이터를 계산할 수 있는 다양한 함수를 제공한다.
| 함수 | 설명 |
|---|---|
np.mean() | 평균 |
np.sum() | 합계 |
np.max() | 최대값 |
np.min() | 최소값 |
np.std() | 표준편차 |
8. 조건 필터링 (Boolean Indexing)
배열의 조건을 이용해 원하는 값만 선택할 수 있다.
| 문법 | 설명 |
|---|---|
arr[arr 조건] | 조건에 맞는 값 선택 |
& | AND 조건 |
\| | OR 조건 |
NumPy에서는 여러 조건을 사용할 때 반드시 괄호로 묶어야 한다.
# X
매출 >= 5000 & 매출 <= 15000

# O
(매출 >= 5000) & (매출 <= 15000)
9. 정렬 함수
배열의 값을 정렬하거나 정렬 기준 인덱스를 확인할 수 있다.
| 함수 | 설명 |
|---|---|
np.sort() | 배열 값을 오름차순 정렬 |
np.sort()[::-1] | 배열 값을 내림차순 정렬 |
np.argsort() | 정렬 순서의 인덱스 반환 |
NumPy 배열의 연산 속도
Python 리스트
- 서로 다른 자료형 저장 가능하다.
- 객체에 대한 참조를 저장한다.
- 반복문으로 요소를 하나씩 처리한다.
NumPy ndarray
- 같은 자료형 데이터를 연속된 메모리에 저장한다.
- 벡터화 연산을 통해 빠르게 처리한다.
배열 생성 함수
1. np.array()
리스트를 NumPy 배열로 변환한다.
np.array([1,2,3])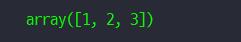
2. np.arange()
일정한 간격의 값을 가진 배열 생성
np.arange(5)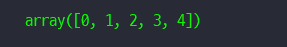
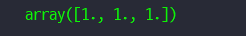
3. np.zeros(), np.ones()
0 또는 1로 채워진 배열 생성
np.zeros(3)
np.ones(3)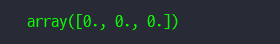
4. np.linspace()
시작값과 끝값 사이를 같은 간격으로 나눈 배열 생성
np.linspace(0,10,5)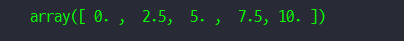
2. Pandas
Pandas는 Python에서 표 형태의 데이터를 쉽게 처리하고 분석하기 위한 라이브러리이다.
- 주로 CSV, Excel 등 테이블 형태의 데이터를 다룰 때 사용한다.
- 내부적으로 NumPy를 기반으로 동작한다.
- 데이터 정제, 변환, 분석 작업에 많이 사용된다.
Pandas의 자료구조
Pandas는 대표적으로 두 가지 자료구조를 제공한다.
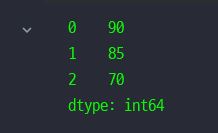
1. Series
하나의 열(column) 형태의 데이터를 저장하는 1차원 자료구조이다.
- 하나의 데이터 타입을 가진 값들의 모음
- NumPy의 1차원 배열과 비슷한 구조
import pandas as pd

scores=pd.Series([90,85,70])

print(scores)
출력 결과
2. DataFrame
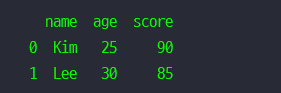
여러 개의 Series가 모여 만들어진 2차원 표 형태의 자료구조이다.
- 엑셀의 표와 같은 구조.
data= {"name": ["Kim","Lee"],"age": [25,30],"score": [90,85]
       }
df=pd.DataFrame(data)

print(df)
출력 결과
CSV 파일 불러오기
- Pandas는 CSV 파일을 DataFrame으로 바로 변환할 수 있다.
import pandas as pd

df = pd.read_csv("titanic.csv") # csv파일을 한줄로 로딩
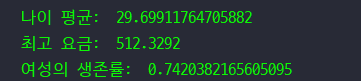
print("나이 평균: ", df["age"].mean())
print("최고 요금: ", df["fare"].max())
print("여성의 생존률: ", df[df["sex"] == "female"]["survived"].mean())
출력 결과
DataFrame 기본 정보 확인
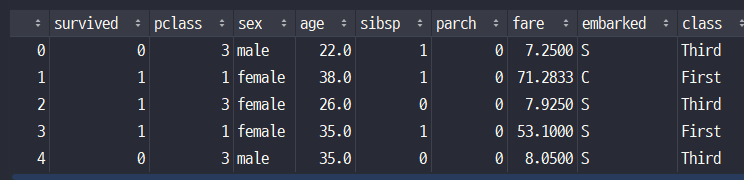
데이터 확인
df.head() # 상위 5개의 데이터 확인df.tail() # 마지막 5개 데이터 확인출력 결과
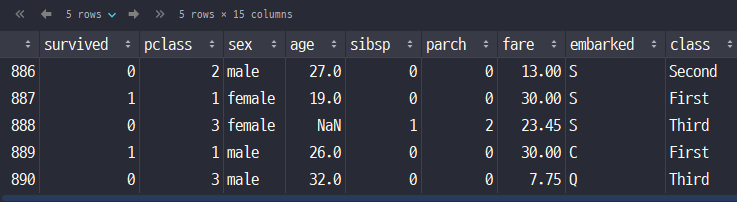
행과 열 확인
df.shape출력 결과
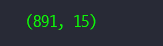
행 개수: 891
열 개수: 15
컬럼 확인
df.columns출력 결과
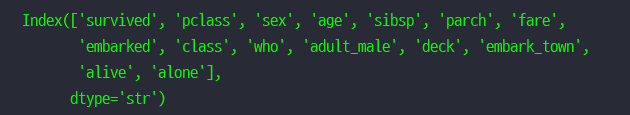
데이터 타입 확인
- 각 컬럼의 자료형을 확인한다.
df.dtypes출력 결과
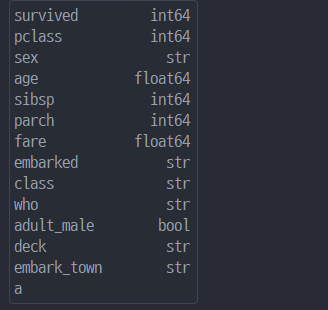
데이터 선택
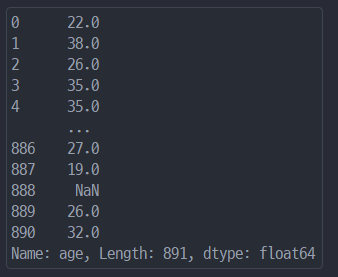
컬럼 선택
df["age"]출력 결과
여러 컬럼 선택
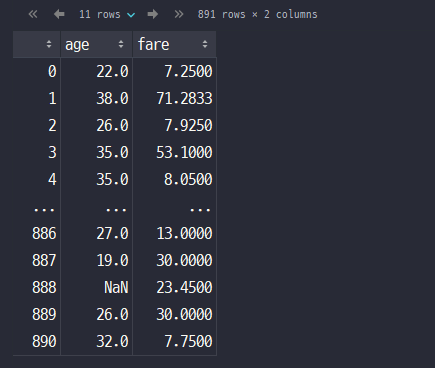
- DataFrame의 형태로 반환된다.
df[["age","fare"]]출력 결과
조건으로 데이터 필터링
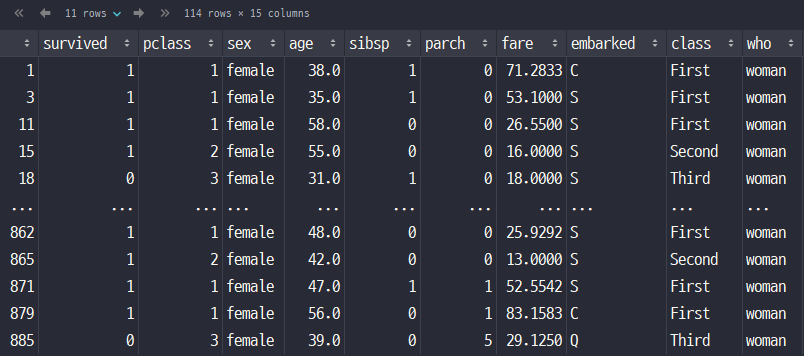
- 조건에 맞는 데이터만 선택할 수 있다.
df[(df["sex"]=="female") & (df["age"]>=30)] # 여성 승객이고, 나이가 30 이상인 데이터출력 결과
데이터 분석 함수
- Pandas는 다양한 집계 함수를 제공한다.
| 함수 | 설명 |
|---|---|
mean() | 평균 |
sum() | 합계 |
max() | 최대값 |
min() | 최소값 |
count() | 개수 |
std() | 표준편차 |
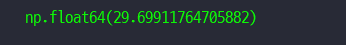
df["age"].mean()출력 결과
groupby()
- 데이터를 특정 기준으로 그룹화하여 분석한다.
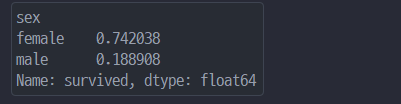
df.groupby("sex")["survived"].mean() # 성별 생존률출력 결과
의미:
- 여성 생존률 약 74%
- 남성 생존률 약 19%
3. NumPy와 Pandas 차이
| NumPy | Pandas | |
|---|---|---|
| 목적 | 수치 계산 | 데이터 분석 |
| 자료구조 | ndarray | Series, DataFrame |
| 데이터 형태 | 배열 | 표 형태 |
| 주요 활용 | 행렬 계산, 수학 연산 | CSV 분석, 데이터 처리 |
NumPy → Pandas 흐름
Python List / Dictionary
          ↓
       NumPy
 (배열 계산, 수치 처리)
          ↓
       Pandas
 (표 데이터 분석)
          ↓
    데이터 분석 / AI


- NumPy: 숫자 배열과 수학 계산에 특화
- Pandas: 표 형태 데이터 처리와 분석에 특화
백엔드를 학습하는 주니어 개발자입니다.