1. 언어 모델이란?
언어 모델은 인간의 두뇌가 자연어를 생성하는 능력을 모방한 모델이다.
- 앞의 문맥을 바탕으로 다음 단어(토큰)를 예측한다.
- 이러한 예측을 반복하여 자연스러운 문장을 생성한다.
예시
나는 맛있는 사과를
-> 여기까지 들어오면 언어모델은 다음 단어 후보에 점수나 확률을 준다.
...
먹는다   0.70
샀다     0.15
좋아한다 0.08
...
위와 같이 가장 가능성이 높은 단어를 골라서 문장을 이어갈 수 있다.
N-gram 언어모델은?
N-gram은 문장에서 연속된 N개의 단어(또는 문자)를 하나의 묶음으로 보는 방법이다.
예시로
나는 맛있는 사과를 먹는다- Unigram(1-gram): 한 단어씩
나는,맛있는,사과를,먹는다
- Bigram(2-gram): 두 단어씩
나는 맛있는맛있는 사과를사과를 먹는다
- Trigram(3-gram): 세 단어씩
나는 맛있는 사과를맛있는 사과를 먹는다
언어 모델에서는 이걸 이용해서 앞의 몇 개 단어를 보고 다음 단어를 예측한다.
SMT의 한계
SMT(Statistical Machine Translation)는 대규모 번역 데이터를 바탕으로
단어 또는 구(phrase)의 번역 확률과 언어 모델의 확률을 조합하여 가장 적절한 번역을 선택하는 방식이다.
입력 문장
↓
단어/구 단위 번역 후보 생성
↓
번역 모델 + 언어 모델로 점수 계산
↓
가장 점수가 높은 문장 선택
하지만 다음과 같은 한계가 있다.
- 긴 문맥을 반영하기 어렵다.
- 단어나 짧은 구 단위의 통계에 많이 의존하기 때문에 문장 전체의 의미를 파악하기 어렵다.
- 언어 간 어순 차이를 처리하기 어렵다.
- 한국어와 영어처럼 문장 구조와 단어 순서가 크게 다른 언어에서는 자연스러운 번역이 어려울 수 있다.
- 자연스러운 문장 생성에 한계가 있다.
- 번역 모델과 언어 모델을 따로 사용하기 때문에 문장 전체를 하나의 모델에서 통합적으로 학습하지 않는다.
→ 이러한 한계를 개선하기 위해 신경망을 이용해 문장 전체의 정보를 학습하는 NMT가 등장하였다.
→ NMT의 대표적인 구조가 Seq2Seq(Encoder-Decoder)이다.
2. Seq2Seq
1. NMT (Neural Machine Translation)
NMT는 인공 신경망을 이용해 기계 번역을 수행하는 방법이다.
- 대표적인 신경망 구조로 Seq2Seq(Sequence-to-Sequence)가 있다.
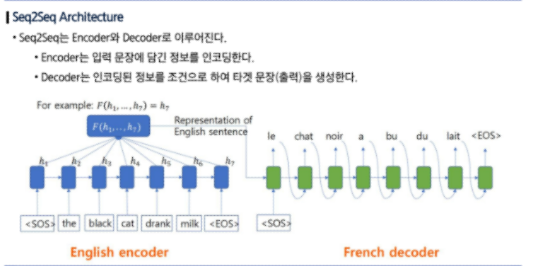
- Seq2Seq는 크게 Encoder와 Decoder로 이루어진다.
- 2014년 Google의 Sequence to Sequence Learning with Neural Networks 논문에서 소개되었다.
2. 번역에서의 문제점
언어마다 문장의 길이가 다를 수 있다.
예시)
- 영어:
the black cat drank milk - 프랑스어:
le chat noir a bu du lait
→ 입력 문장과 출력 문장의 길이가 다를 수 있으므로,
NMT에서는 길이가 다른 시퀀스 간의 매핑을 처리할 수 있어야 한다.
3. Seq2Seq의 핵심 아이디어
Seq2Seq는 보통 2개의 LSTM을 이용한다.
Encoder
- 입력 시퀀스를 순서대로 읽는다.
- 입력 시퀀스를 고정된 차원의 벡터 표현으로 만든다.
- 즉, 문장의 정보를 하나의 벡터에 담는다.
Decoder
- Encoder가 만든 벡터를 입력으로 받는다.
- 이 정보를 바탕으로 출력 시퀀스를 생성한다.
4. Seq2Seq 구조
입력 문장
the → black → cat → drank → milk
                ↓
             Encoder
                ↓
        문장 정보 벡터
                ↓
             Decoder
                ↓
le → chat → noir → a → bu → du → lait
5. Seq2Seq의 다양한 적용
- 요약
- 긴 길이의 문서를 읽고, 짧은 길이의 문장으로 요약된 텍스트를 출력하는 태스크이다.
- 대화
- 사용자의 발화를 기반으로, 맥락에 맞는 대답을 생성하는 태스크이다.
- 코드 생성
- 자연어로 작성된 설명 혹은 명령어를 입력 받아, 그에 대응하는 프로그래밍 코드 혹은 쿼리를 출력하는 태스크이다.
6. Seq2Seq 학습 방법
- 인코더와 디코더가 하나의 통합 네트워크로 연결되어 있다.
- 디코더에서 발생한 오차는 역전파 과정을 통해 입력을 처리한 인코드까지 전달되어 전체 네트워크가
End-to-End로 동시에 최적화된다. - 학습 초반에는 모델의 예측 능력이 떨어져서 학습이 불안정할 수 있다.
Teacher Forcing은 모델이 스스로 예측한 단어 대신 정답 단어를 디코더 입력으로 강제로 넣어줌으로써 훨씬 안정적이고 빠르게 학습을 수행하는 방법이다.
7. Seq2Seq의 토큰 출력 방법
- 토큰을 출력하는 방법 중 하나로, 각 단계에서 가장 확률이 높은 단어를 선택한다.
- 하지만 되돌리기가 불가능한 한계가 있다.
3. Attention
1. the bottleneck problem
- 인코더는 입력 문장 전체를 하나의 벡터로 요약하는데, 마지막
hidden state에 문장의 모든 의미 정보가 담긴다. - 고정 길이의 벡터 하나에 모든 문장의 의미를 압축하다 보니 정보 손실이 생길 수 있는데, 이것을 the bottleneck problem이라 한다.
2. Attention
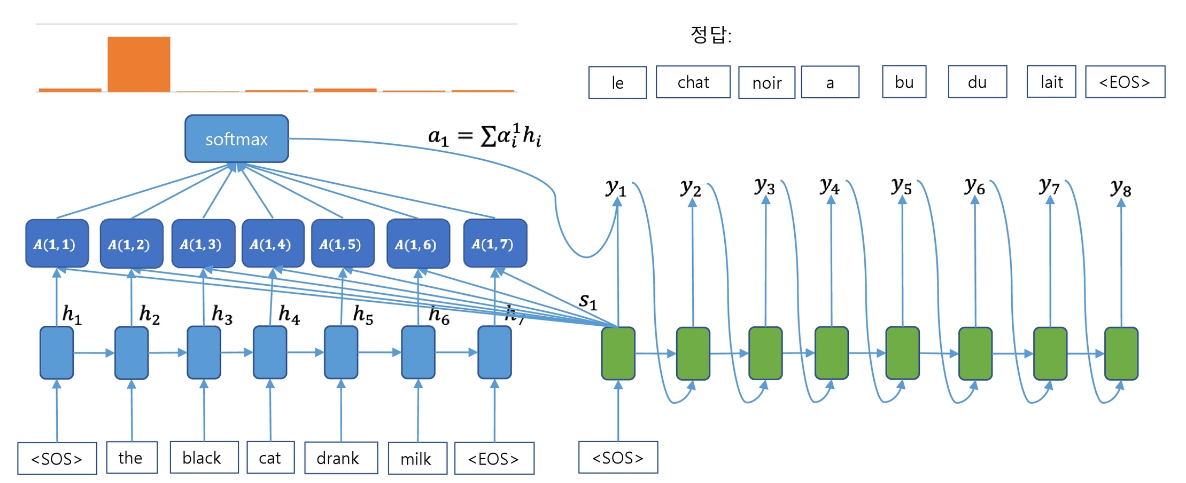
Decoder가 출력 단어를 만들 때 Encoder의 마지막 hidden state 하나만 보는 게 아니라, 입력 문장의 여러 hidden state 중 지금 필요한 부분을 골라서 참고하는 방법이다.
기존 Seq2Seq에서는
the → black → cat → drank → milk
 ↓      ↓      ↓      ↓       ↓
h1     h2     h3     h4      h5
                       ↓
                 마지막 h5만 사용
                       ↓
                   Decoder
입력 문장의 정보를 마지막 hidden state 하나에 압축하여 Decoder에 전달하였다.
하지만 Attention은 출력할 단어와 관련 있는 Encoder의 hidden state에 더 높은 가중치를 주어 참고한다.
Encoder
h1   h2   h3   h4   h5
 \    |    |    |    /
  \   |    |    |   /
   ↓  ↓    ↓    ↓  ↓

Decoder에서 y1 만들기
→ h1~h5 중 필요한 곳에 가중치
→ y1 = "le"

Decoder에서 y2 만들기
→ 다시 h1~h5를 보고 다른 가중치
→ y2 = "chat"

Decoder에서 y3 만들기
→ 다시 h1~h5를 보고 다른 가중치
→ y3 = "noir"
그래서 기존 Seq2Seq와 비교하면:
| 기존 Seq2Seq | Attention |
|---|---|
| 마지막 hidden state 하나에 의존 | 여러 Encoder hidden state를 참고 |
| 긴 문장에서 정보 손실 가능 | 필요한 부분에 더 높은 가중치를 부여 |
| 문장 전체를 하나의 고정된 벡터로 압축 | 출력 시점마다 다른 입력 부분에 집중 |
Attention의 효과
- NMT 성능 향상
- 디코더가 Encoder의 전체
hidden state를 참고하면서, 현재 출력에 필요한 부분에 더 집중할 수 있다.
- 디코더가 Encoder의 전체
- Bottleneck Problem 완화
- 기존 Seq2Seq처럼 입력 문장 전체를 하나의 고정된 벡터에 압축할 필요가 없다.
- Decoder가 Encoder의 여러
hidden states에 직접 접근할 수 있다.
- Vanishing Gradient Problem 완화
- 멀리 떨어진 입력 정보에도 Attention을 통해 직접 접근할 수 있다.
- 정보와 기울기가 전달되는 경로가 짧아져 장기 의존성 학습에 도움이 된다.
- 해석 가능성
- Attention 가중치를 통해 Decoder가 특정 단어를 생성할 때 입력 문장의 어느 부분을 많이 참고했는지 확인할 수 있다.
4. 정리
- 언어 모델
- 앞의 문맥을 바탕으로 다음 단어(토큰)를 예측하여 자연스러운 문장을 생성한다.
N-gram은 앞의 일정 개수 단어만 참고하여 다음 단어를 예측한다.
- SMT
- 단어/구 단위의 번역 확률과 언어 모델을 이용해 가장 적절한 번역을 선택한다.
- 긴 문맥, 언어 간 어순 차이, 자연스러운 문장 생성에 한계가 있다.
- 이러한 한계를 개선하기 위해 NMT가 등장하였다.
- NMT
- 인공 신경망을 이용한 기계 번역 방식이다.
- 대표적인 구조로 Seq2Seq가 있다.
- Seq2Seq
- Encoder가 입력 시퀀스를 읽고 문장 정보를 하나의 벡터로 표현한다.
- Decoder가 Encoder의 정보를 바탕으로 출력 시퀀스를 생성한다.
- 입력과 출력의 길이가 달라도 처리할 수 있다.
Teacher Forcing을 사용하면 학습 시 정답 단어를 Decoder 입력으로 넣어 안정적으로 학습할 수 있다.
- Seq2Seq의 한계
- 입력 문장 전체 정보를 마지막
hidden state하나에 압축한다. - 문장이 길어질수록 정보 손실이 발생할 수 있는데, 이를 Bottleneck Problem이라 한다.
- 입력 문장 전체 정보를 마지막
- Attention
- Encoder의 마지막
hidden state하나만 사용하는 것이 아니라 여러hidden state를 참고한다. - Decoder가 각 단어를 생성할 때 필요한 입력 부분에 더 높은 가중치를 준다.
- Bottleneck Problem과 Vanishing Gradient Problem을 완화하고 NMT 성능을 향상시킨다.
- Attention 가중치를 통해 모델이 입력 문장의 어느 부분에 집중했는지 확인할 수 있다.
- Encoder의 마지막
전체 흐름
언어 모델
→ SMT
→ SMT의 한계
→ NMT
→ Seq2Seq(Encoder-Decoder)
→ Bottleneck Problem
→ Attention으로 필요한 입력 부분에 집중